Perplexity 调研工作流:从问题拆解、证据核验到可交付报告
本文介绍如何用 Perplexity 做产品调研和行业研究的完整工作流,共五步:一、把大问题拆解为可验证的问题清单;二、用 Research 模式做宽搜,明确来源优先级;三、逐条核验引用来源,分为 A/B/C 三档;四、针对证据缺口做定向追问与反证;五、把结果按决策顺序改造成可交付报告,附来源表。文章还指出该流程的边界与五项验收标准,强调 Perplexity 的价值在于把“我觉得”改造成可追踪、可反驳的证据链。
本文介绍如何用 Perplexity 做产品调研和行业研究的完整工作流,共五步:一、把大问题拆解为可验证的问题清单;二、用 Research 模式做宽搜,明确来源优先级;三、逐条核验引用来源,分为 A/B/C 三档;四、针对证据缺口做定向追问与反证;五、把结果按决策顺序改造成可交付报告,附来源表。文章还指出该流程的边界与五项验收标准,强调 Perplexity 的价值在于把“我觉得”改造成可追踪、可反驳的证据链。
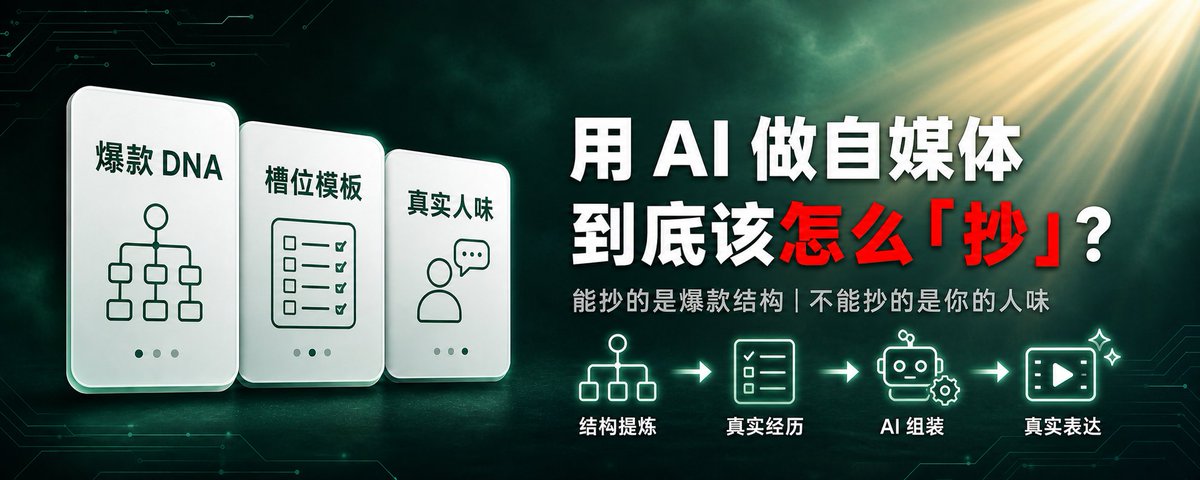
作者通过拆解大量爆款口播稿,总结出可迁移的内容'DNA结构'(钩子造词、三幕递进、爽点、隐喻收尾、示弱信任、时间卡点),并指出用AI做自媒体的正确姿势:AI负责拆解结构、生成可填空模板,用户必须提供真实素材和经历,禁止AI编造示弱内容。核心观点是'结构是技能的,素材是用户的',AI是杠杆,放大的必须是你本来就有的真东西,否则只会产出没有'人味'的高级搬运。
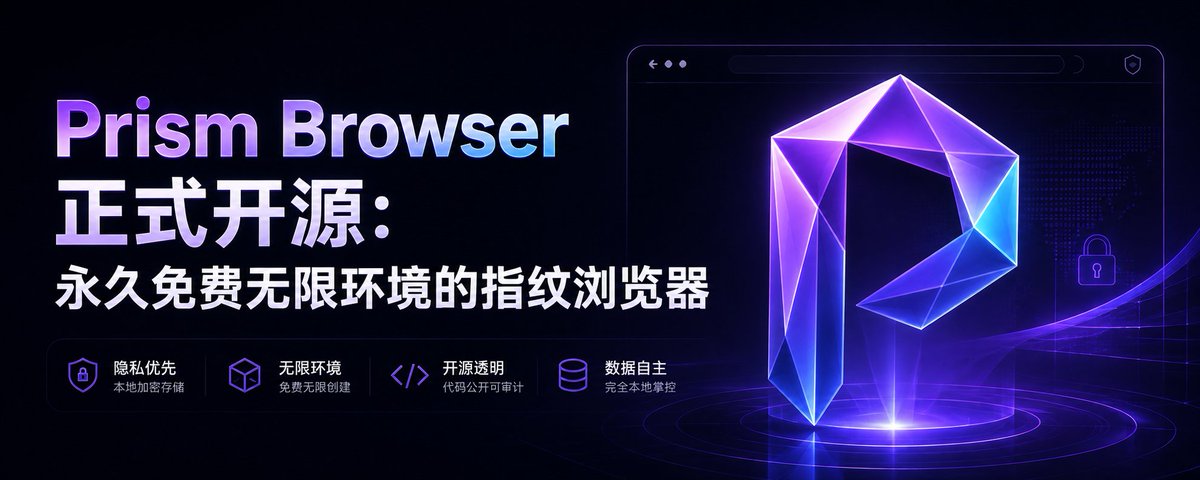
Prism Browser Community 正式开源,提供基于 Chromium 的本地指纹浏览器环境管理,永久免费且环境数量不设限。支持独立配置、代理设置及多种指纹保护,数据本地存储保障安全。Pro 版提供新内核、自动化 API 及 AI 协作功能。
本文介绍了一套基于本地显卡的数字人口播视频生成方案,旨在替代成本较高的云端服务。文章详细讲解了从电脑配置检查、一键启动工作流,到接入 Duix.Avatar 本地数字人、调整动画画风的完整步骤,并分享了如何构建长期复用的工作流及多平台内容变现策略。
文章介绍如何利用WorkBuddy的8个提示词优化电商运营流程,涵盖数据合并、售后整理、异常监控、标题优化、竞品分析、差评统计、广告检查及直播排品,大幅提升效率。
文章介绍了8个Telegram搜索网站,包括Lyzem、tgtw.cc、Teleteg等,帮助用户高效搜索频道、群组和资源,解决Telegram资源难找的问题。
本文分享了作者在20天内将X账号从0做到70K曝光、涨粉900的实战经验。作者总结了一套“夏林果曝光飞轮”方法论,涵盖四个关键关卡:想清楚写给谁、写出有人看的内容、让内容被人看见、靠坚持滚成雪球。文章详细拆解了定位测试、内容创作、封面设计、互动技巧及坚持更新的具体策略,适合新手博主参考复制。
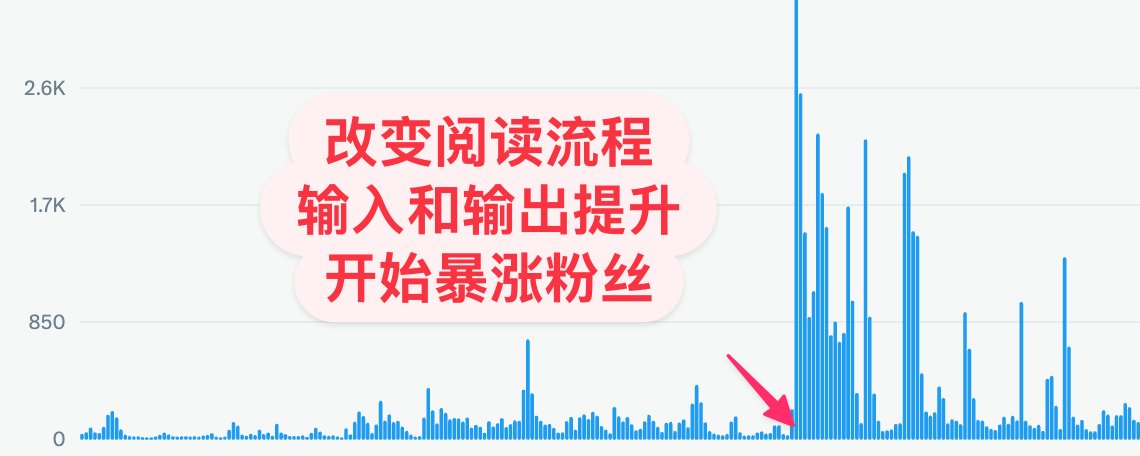
本文介绍了作者“低能量三步法”的阅读流程:通过筛选高质量 Newsletter 换取信息选择权,利用 AI 每天精读 3 篇并归档 97 篇至知识库,最后结合知识库与 AI 辅助实现低能量输出,帮助缓解信息焦虑,提升创作效率。
本文梳理了全球出海市场的划分,包括成熟市场、高增长市场和新兴市场,并分析了北美、欧洲、日韩、东南亚等核心市场的特性。文章提供了进入市场的方法论、增长营销的渠道差异,以及从支付、物流到文化的六层本土化运营策略,最后分享了TikTok、传音、飞书等成功出海案例。
本文分享了使用 3D 导演台制作五人虚拟偶像镜头的实操复盘。作者详细介绍了如何拆解任务,利用导演台管理角色身份、队形和机位,并结合 Seedance 生成动作。文章涵盖了素材准备、角色映射、三种功能性队形设计、机位参数保存及常见错误的修复技巧,旨在提高多人镜头的构图可控性。
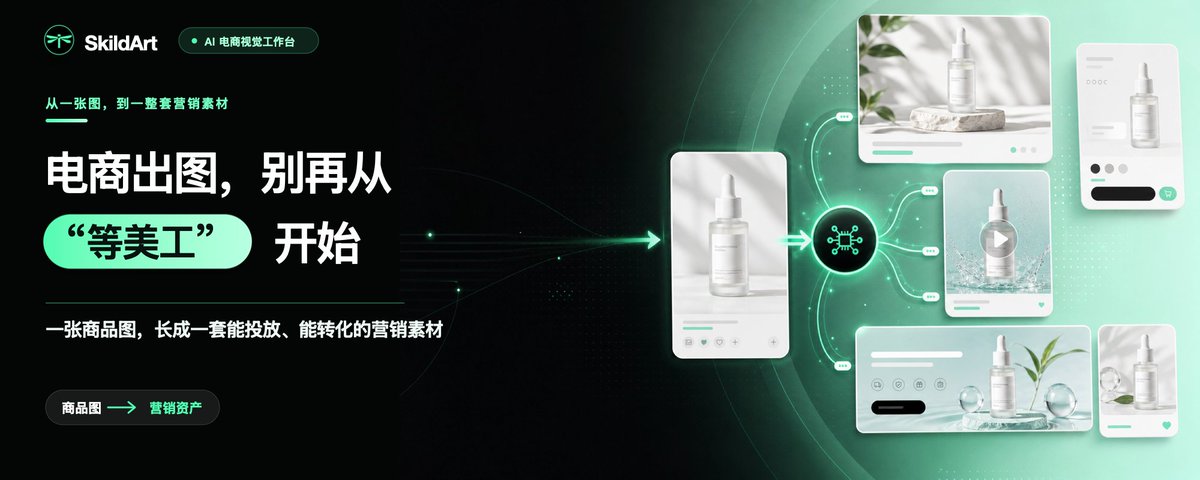
文章介绍了 AI 设计工具 SkildArt,它通过“无限画布 + Agent”模式,帮助电商团队从单张白底图批量生成场景广告、多尺寸适配图及营销视频,解决传统流程中沟通成本高、等待时间长的问题,提升视觉内容生产效率。
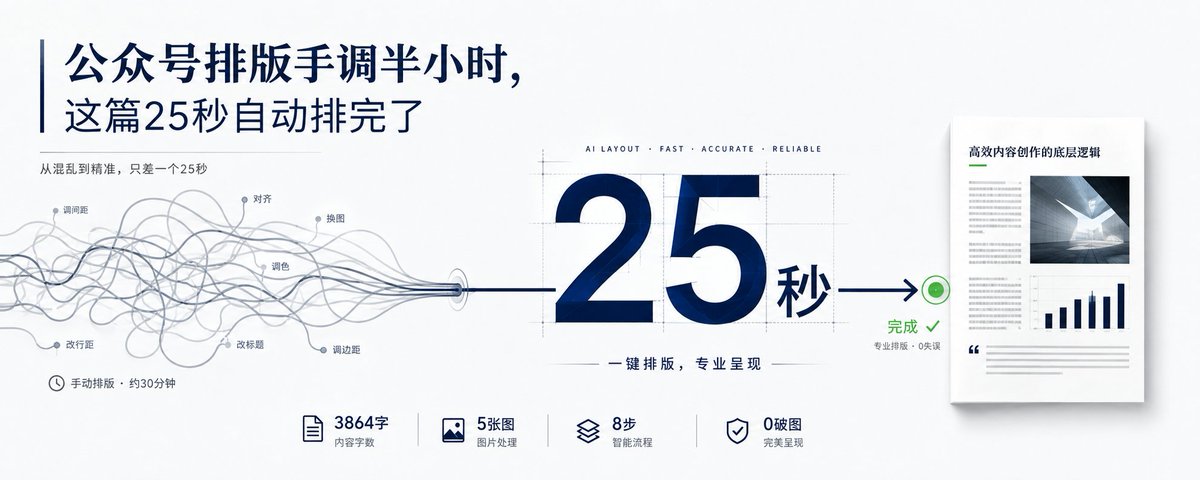
作者分享了一款开源的公众号排版工具,通过一条命令即可将Markdown转换为排版精美的公众号文章,支持多主题切换、图片内嵌、长截图预览及隐私检查,将排版时间从半小时缩短至25秒,极大提升发布效率。
本文详细介绍了如何获取Google Gemini Pro 12个月免费会员的完整流程,包括账号地区设置、网络环境准备、支付方式绑定、Pixel设备验证及自动续费关闭等关键步骤,帮助用户顺利领取权益。
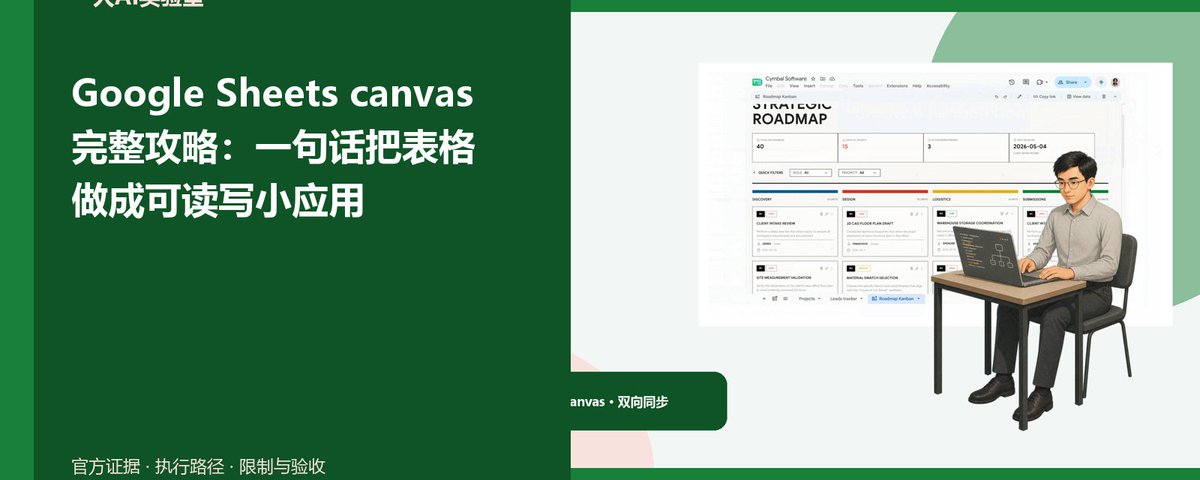
Google Sheets canvas 是基于 Gemini 的交互界面,可通过自然语言生成看板、仪表盘等可读写小应用,实现表格数据的可视化与双向同步。本文详细介绍了其功能差异、使用方法、适用场景及交付检查清单。
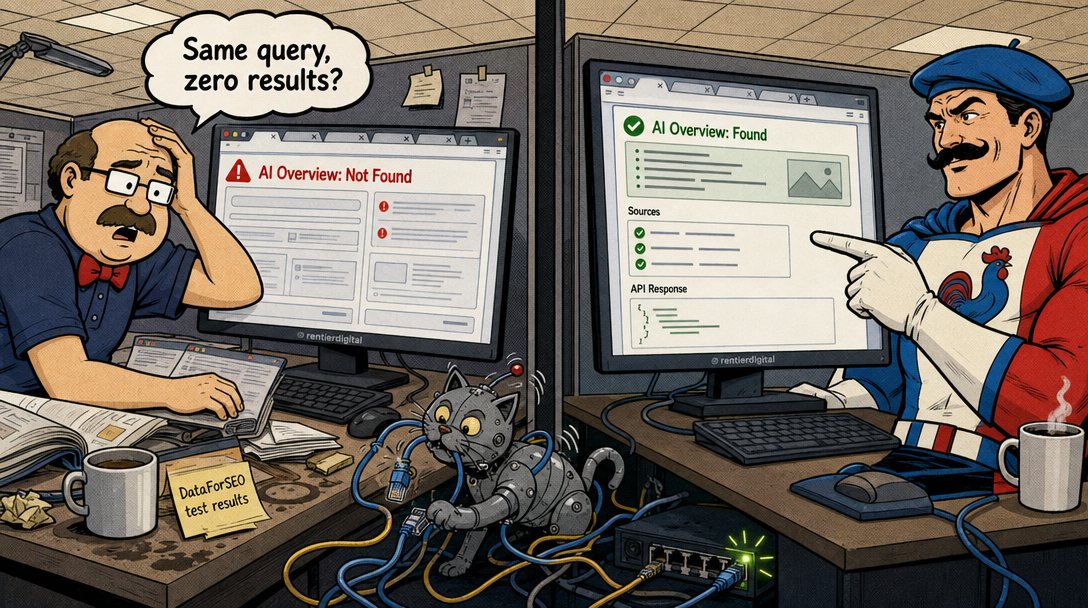
作者对比了SemScraper和DataForSEO两个SERP API在捕获Google AI Overview方面的表现。通过7个查询的并行测试,发现SemScraper在4个有AI Overview的查询中全部捕获,而DataForSEO只捕获了2个。作者认为差异源于抓取时机,而非代码质量,并指出即使最昂贵的企业级工具(如Bright Data)也承认AI Overview捕获是概率问题。此外,文章还讨论了2026年2月和5月Google向追踪机器人提供伪造SERP的事件,强调依赖单一API的风险。最终,作者选择SemScraper,并建议用户不要盲目信任单一数据源。
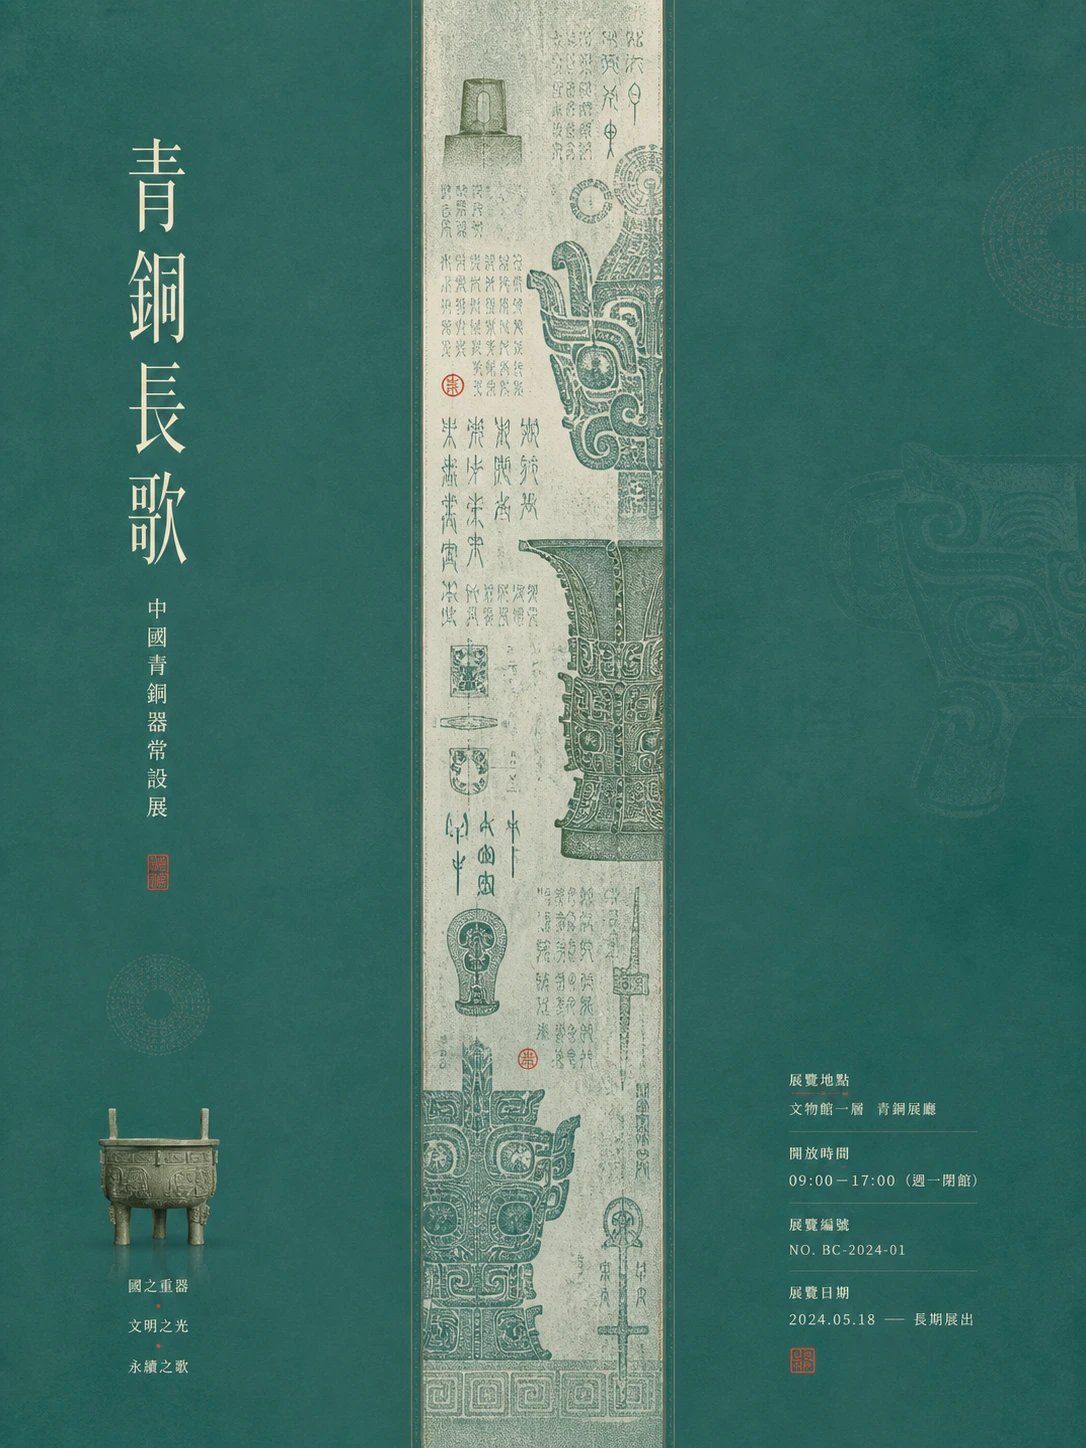
作者分享了一个博物馆海报设计频道,并提交了409个相关海报提示词。文章重点展示了一个通用提示词,通过调整不同主题(如古籍善本特展)来生成具有仪式感和美学的海报。提示词强调大面积底场与窄幅主视觉带的分栏秩序,注重色彩、纹理和文字排版,以营造安静、温润的视觉体验。作者特别提到最喜欢第三张图。
本文是独立开发者 Tw93 对自己从开源 CLI 工具 Mole 到 Mac 付费软件这一过程的复盘与思考。文章分享了 Mole 的诞生背景、AI 时代产生的三类垃圾(编译产物、AI 工具旧版本、模型文件)及其清理策略,强调了产品设计中“不做什么”的重要性,以及从用户反馈中获得的宝贵经验,如对浅色模式、温度单位等细节的反思。作者还分享了手工回复邮件、不急于搭建客服系统、坚持每周更新等产品理念,并总结了做产品的心得:代码能力只占三成,更重要的是理解用户、做好取舍、建立信任。
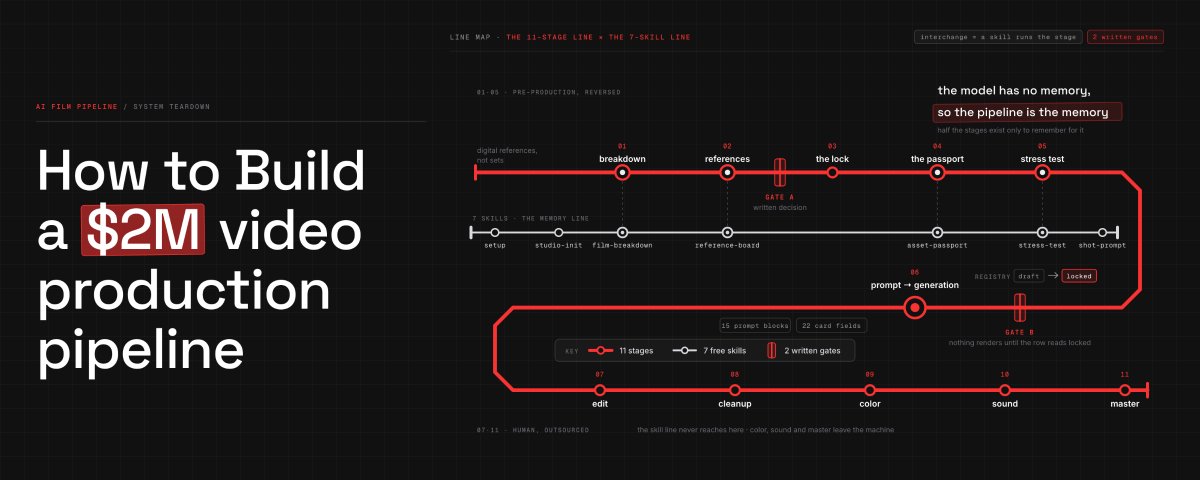
本文详细介绍了使用Higgsfield平台和Seedance 2.5模型构建AI视频制作流水线的方法,包括11个阶段、两个关键门控、角色一致性维护、自动化技能等,旨在帮助导演制作预算数百万美元的AI电影。
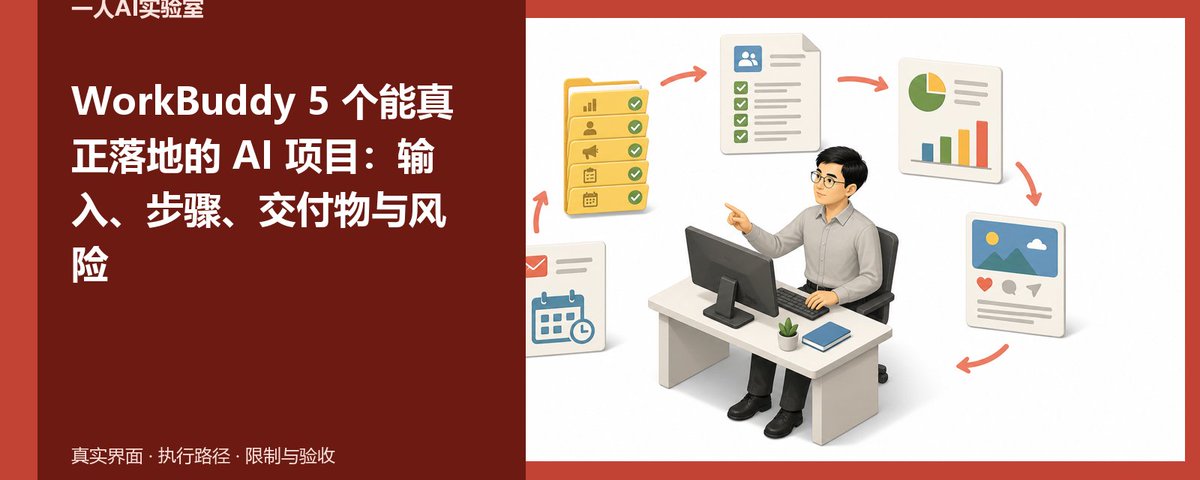
本文分享了5个利用WorkBuddy实现落地获益的一人AI项目,包括文件整理与批量重命名、会议纪要与待办台账、Excel数据分析与可视化报告、小红书内容生产包、每日自动发送资讯简报。每个项目都提供了具体的执行路径和提示词,强调真实输入、人工确认和可复用性。文章还给出了选择首个项目的建议,并提醒保留原始输入、提示词版本和人工确认结果,以确保项目真正落地。
本文由资深IP策划人小晚不在撰写,分享了如何利用AI工具策划和设计具有辨识度的个人IP形象。文章从核心策划思路出发,强调在生成图像前需明确角色定义、个人细节和视觉风格,并通过角色访谈、方向比较、设计简报、主形象生成和传播测试等五轮工作流,系统性地打造IP。同时,文章提供了详细的视觉规范建议和发布前的自检清单,帮助创作者建立长期可用的IP视觉资产系统。
本文作者公布了一段用于生成苏轼一生一镜到底视频的详细提示词,适配 Seedance 2.5 语音生成格式。提示词要求制作30秒电影级人物传记视频,全程无缝长镜头,展现苏轼从少年到暮年的十次转变,涵盖眉山少年、赶考书生、金榜题名、直言官员、乌台诗案囚徒、黄州诗人、翰林学士、杭州太守、流放岭南、海南教育者直至北归智者。视频需包含6句苏轼诗词作为旁白,配合环境音效和背景音乐,并遵循关键执行规则确保人物外貌、服饰、神态随人生阶段流畅变化。
本文是一篇关于 WorkBuddy 积分使用的省钱实操教程。作者详细介绍了 WorkBuddy 标准版每月 70 元、4000 积分的分配与消耗机制,分析了积分消耗快的四个原因,并提供了四个高频工作流(邮件批量处理、跨文档汇总周报、IMA 知识库批量归档、竞品调研)的具体操作步骤和可直接复制的提示词。文章还总结了六条省钱铁律、积分追踪表以及 5 天测试法,帮助用户判断是否值得开通会员,最终实现高效利用积分、节省成本的目的。
本文是一篇面向初学者的 GitHub 实操教程,从 Git 与 GitHub 的区别讲起,详细介绍了 Git 的安装配置、仓库初始化、提交、分支管理、冲突解决、远程仓库操作及 GitHub 协作流程。作者通过一个实际项目案例,演示了从本地开发到推送 GitHub 的完整过程,并强调了版本控制的重要性,不仅适用于程序员,也适用于内容创作者和 AI 使用者。文章内容详实,步骤清晰,适合希望系统学习 Git 和 GitHub 的读者。
本文是知乎AI工具(zhihu-cli)的完整教程,涵盖从注册、配置到使用的全过程。文章首先介绍了如何注册知乎数据开放平台账号并获取Access Secret,然后详细说明了通过uv安装CLI、保存密钥、验证配置的步骤。接着,文章重点讲解了zhihu-search(社区封装)和pyzhihu-cli(非官方客户端)两条路线的能力、安装与配置方法,包括Skill和MCP的集成,以及Codex、Claude Code、Cursor等主流AI Agent的接入方式。最后,文章提供了进阶技巧、常见问题解答和组合工作流建议,帮助用户高效利用知乎内容进行AI研究、选题和内容创作。
本文是WorkBuddy实战教程,详细讲解如何将Markdown文件转换为Word和PDF。作者首先介绍了Markdown作为Agent工作底稿的特性,并强调了先判断文档终态(是否需修改、是否需品牌化)再选择工具的重要性。随后,文章分别演示了使用Pandoc和minimax-docx将Markdown转为Word的路径,以及使用/pdf、pdfkit-py和Kami三种Skill处理PDF的不同场景。最后,作者总结了文档自动化交付链路,并建议将高频、流程固定的路径固化为Skill,以提高效率。
本文分享了作者在公众号和小红书平台上的内容生产全流程经验,重点介绍了如何通过建立风格规格文档和素材库,结合Skills功能搭建从选题到发布的自动化工作流。作者强调提示词是Skills的基础,但复杂规则应放在规格文档中,并指出AI生成内容缺乏曝光的原因在于缺少真实细节,因此需要人工补充个人观点和经历。文章还开源了核心Skills代码,展示了完整的SOP流程,帮助读者从0到1搭建自己的内容创作系统。
作者逸尘分享了他花费一周时间、消耗超100亿Tokens打造的Obsidian超级助手Ailu。Ailu集成了Agent工作台(支持Codex、Claude Code及CC Switch配置)、共生记忆系统、本地预览公众号/飞书/X文章、一键上传文章到各平台等功能。文章详细介绍了Agent工作台的小巧思、记忆系统的设计、本地预览与上传功能的实现原理(包括公众号上传的服务器与Cloudflare Tunnel方案),并宣布Ailu已开源。
本文介绍了使用AI工具生成封面图的方法,重点强调生图模型的重要性(占80%),提示词仅占20%。作者分享了从图片反推提示词的技巧,并展示了自己用GPT Image2生成封面图的流程,同时提供了一套可复用的封面提示词模板。最后对比了国内模型(豆包Seedream5.0、千问Qwen-image3.0)的生成效果,并给出选择建议。
本文探讨了当软件构建成本大幅降低后,产品开发的核心从“能否构建”转向“是否应该构建”。作者以Meta为例,说明其通过借鉴外部成功机制(如Stories、Reels)来理解用户行为,并指出所有软件公司都应建立类似的外部产品实验室。文章强调,关键在于识别功能底层的“机制”(如Pull Request的协作机制),而非简单复制功能。未来,AI将加速这一学习循环,而人类的判断力、品味和对用户行为的深刻理解将变得更加重要。同时,作者警告,构建能力的提升可能导致大量低质量产品涌现,因此严格优先级排序和克制力成为关键技能。