免费图片素材网站合集
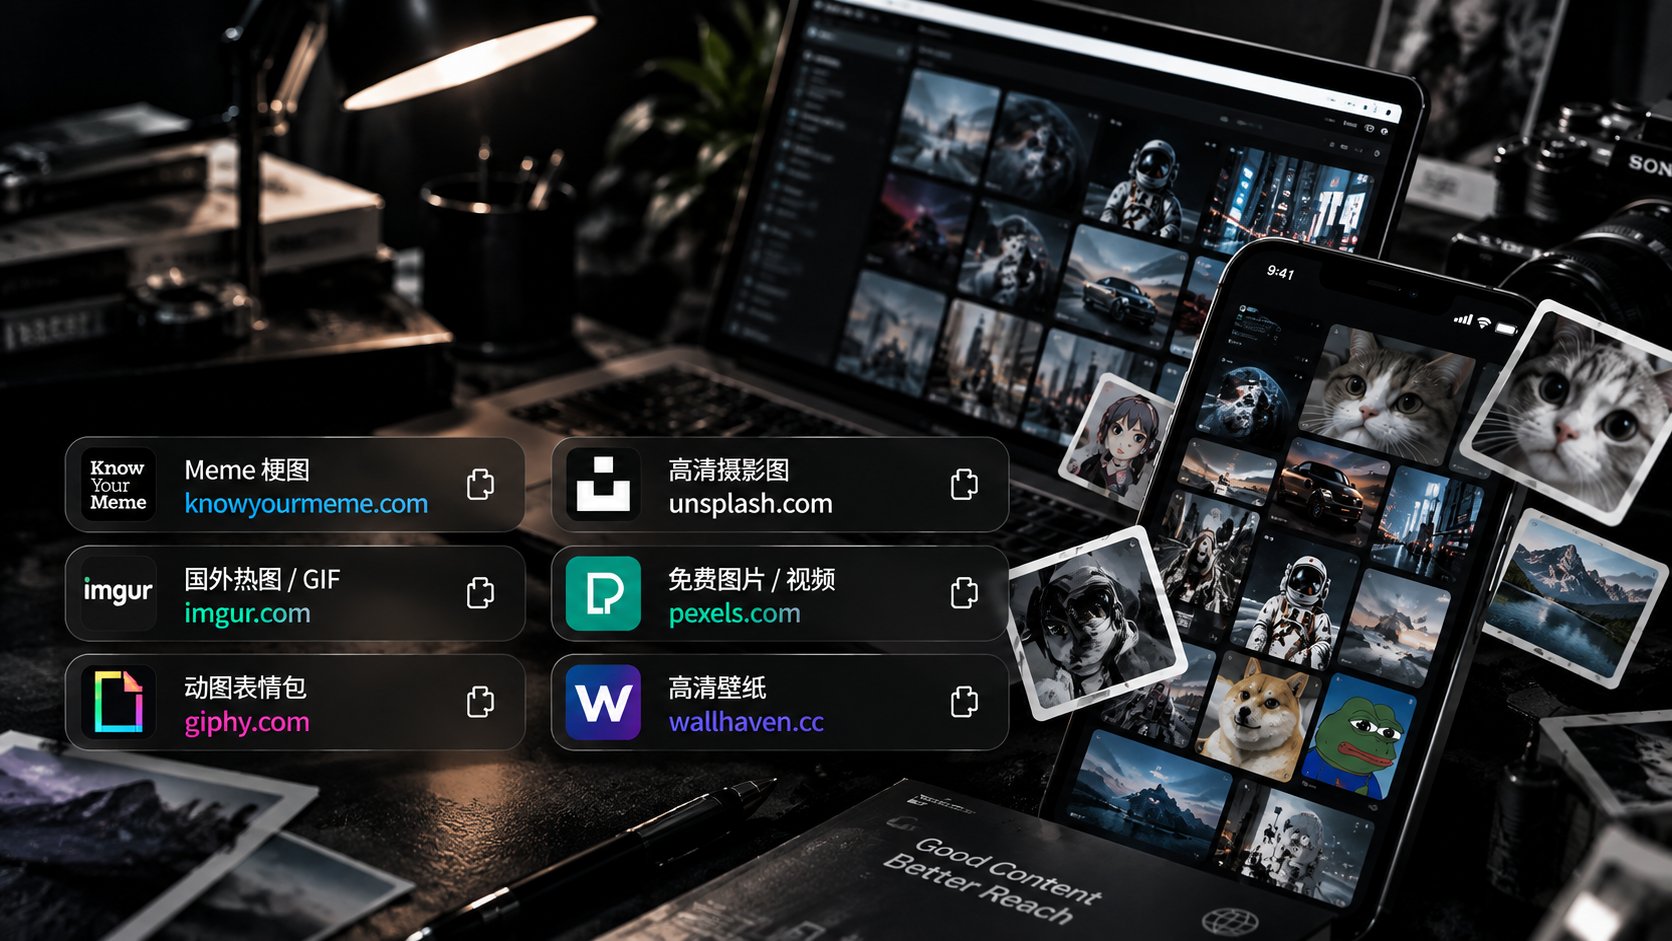
作者分享了六个常用的图片素材来源网站:KnowYourMeme 用于查找 Meme 梗图,Imgur 提供国外热图和 GIF,Giphy 提供动图表情包,Unsplash 提供高清摄影图,Pexels 提供免费图片和视频,Wallhaven 提供高清壁纸。掌握这些网站后,发推或创作时不再缺少图片素材,非常适合内容创作者收藏备用。
作者分享了六个常用的图片素材来源网站:KnowYourMeme 用于查找 Meme 梗图,Imgur 提供国外热图和 GIF,Giphy 提供动图表情包,Unsplash 提供高清摄影图,Pexels 提供免费图片和视频,Wallhaven 提供高清壁纸。掌握这些网站后,发推或创作时不再缺少图片素材,非常适合内容创作者收藏备用。
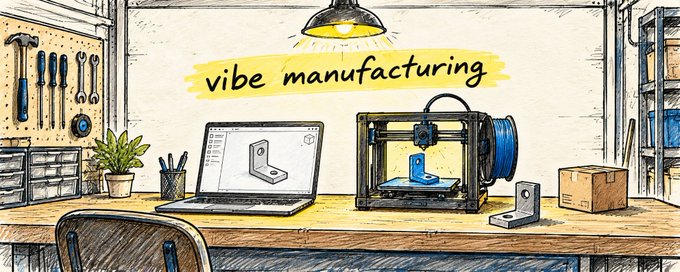
文章提出'氛围制造'(Vibe Manufacturing)概念:就像vibe coding让非程序员能开发软件一样,AI正在让普通人能制造实体产品。四大变化同时发生:1) 设计变成代码——GPT-6 Astra在BenchCAD上达95.9%,Text-to-CAD工具涌现;2) 工厂变成API——Xometry等平台让下单像租用云服务器一样简单;3) 智能化成本骤降——几美元的ESP32芯片即可让产品联网;4) 家庭3D打印普及——Bambu Lab推动桌面打印迭代速度接近软件开发。产品正从库存实体变为可参数化的设计文件,开创全新的商业模式和创业机会。
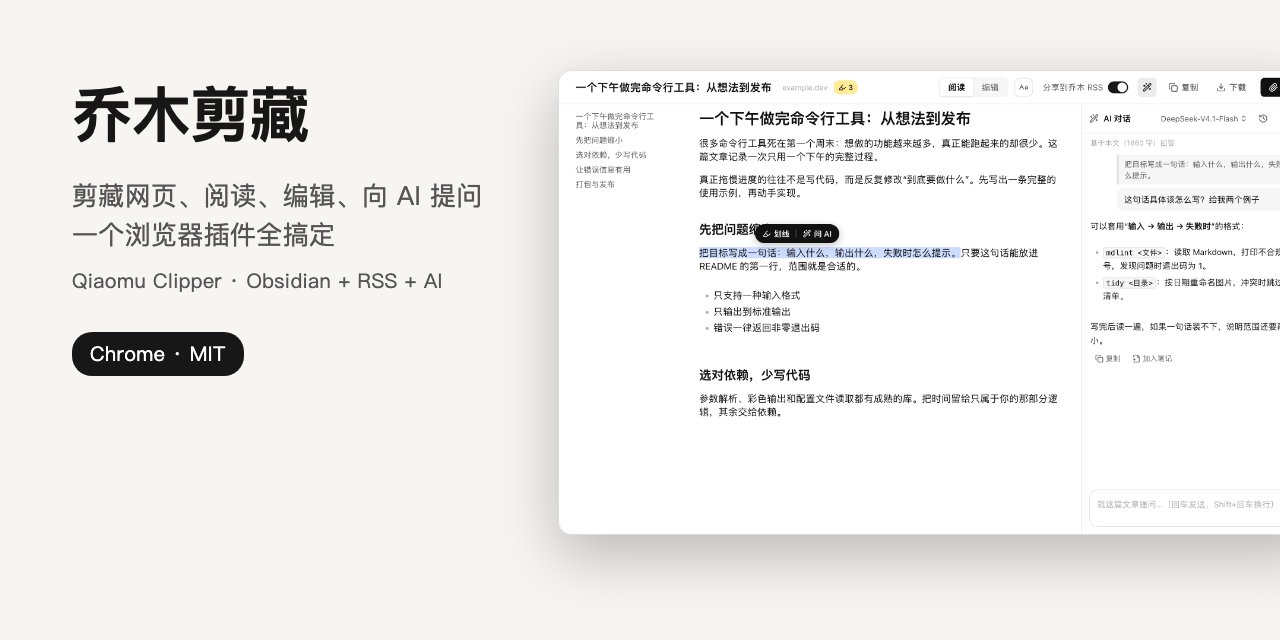
作者介绍了自己开发的 Chrome 插件「乔木剪藏」新增的视频阅读模式,可将带字幕的 YouTube/B站视频转为可阅读文本。功能包括:中英双语对照、点击字幕时间戳回看视频、划线直接向 AI 提问、接入 Obsidian 沉淀笔记。适合学习长播客访谈和课程。项目已在 GitHub 开源(qiaomu-clipper)。评论区还讨论了中文视频自动字幕识别错误导致乱码的问题及 AI 转写的应对方案。
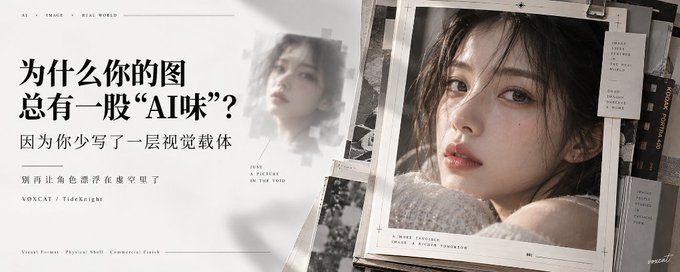
文章探讨了AI生图常带“AI味”的根本原因:角色漂浮在数字虚空中,缺乏“视觉载体”(Visual Format)。作者剖析三大病灶:无边界感、无功能动机、信息层次塌陷,并区分风格、载体与输出规格三个概念,提出“商业完成度=主体×风格锚点×视觉载体”的公式。视觉载体通过语境世界观、触觉通感和强制留白来消解塑料感。最后给出三条工程心法:载体前置、描述物理结构、留白策略,帮助创作者从“画画的人”转变为“视觉导演”。
作者分享了一份云端 GPU 部署教程,用每小时仅两块钱的租用显卡(实测 RTX 4090),在破旧笔记本上跑通蚂蚁百灵刚开源的生图模型 Ming-Image-0.1-Design。文章从选择云平台与机器配置(显存、系统内存、数据盘)、镜像选择、SSH 连接、ComfyUI 启动,到运行官方工作流出图,手把手演示全流程。实测显示模型在商业海报的文字渲染上表现优秀,且 Design-Layer 模型可将设计图智能拆解为多个带透明通道的可编辑图层并自动补全背景。最后提醒下载成果、导出工作流并及时关机以节省费用。
作者分享了一篇详细教程:利用家中常开的 Mac mini 安装 Surge 充当全屋网关,实现全家设备连 Wi-Fi 即可访问外网。文章对比了路由器刷 OpenClash、Linux 小主机旁路由、Stash 三种方案的问题,说明 Surge 的优势:跨设备配置同步、连接速度快、iPhone 回家自动暂停代理省电。详细讲解了 iPhone 端配置、Mac 网关模式开启、DHCP 分流三种接法及踩坑经验(include-all-networks 陷阱、IPv6 泄漏等),并建议机场与自建 VPS 节点混用以保障 AI 账号安全。
文章通过一个保险从业者的案例,探讨为什么同样用AI提效,有人越赚越多而有人却更累。核心观点是:提效本身不等于赚更多钱,关键在于省下的时间用在哪里。作者建议把工作流程拆解,识别哪些环节可以交给AI(如录音整理、方案初稿),再顺着业务链条找到真正的卡点——比如客户关系维护——把时间投入到AI无法替代的信任建立上。同时强调AI出的初稿更需要专业判断把关,作者给出具体方法:挑一件重复耗时的工作,写明省下时间后的具体用途,用业务是否推进来检验AI的价值。
作者分享了一套 GPT Image 2.5 出图的结构化提示词方法论,将画面拆解为身份、物理、摄影、视觉风格四大系统加负面词控制系统,共 17 个层级,并提供 5 层、8 层、15 层三个版本。通过“雨夜便利店”同场景实测对比,展示信息量对出图质量的影响。作者还用蚂蚁百灵 Ling-3.1-flash 模型将 5000 字方法论文档在 24 秒内一次性生成单文件 HTML 提示词拼装工具,支持逐层填写、实时拼接、一键复制,并介绍了将该模型接入本地 Claude Code 的环境变量配置方法与使用体验。
作者分享了在美国留学期间用 ChatGPT 语音模式练英语口语的方法。核心思路是选择具体场景(而非泛泛话题)进行角色扮演演练:先按使用目的和场景频率排优先级,再给 ChatGPT 一个自然对话的角色设定(附完整中英文提示词模板),然后采用三轮练法——裸聊暴露问题、复盘改进、加难度模拟干扰,最后将实用句子存入语料库(推荐 Obsidian)反复复习。作者以健身房场景为例演示了全程效果,强调低成本开口练习和场景化语料积累对口语提升的价值。
这是一篇手把手教程,作者分享如何用约28元的首次支出(VPS约14元/月、域名首年约14元)从零搭建个人网站。流程包括:购买VPS服务器和域名、通过Cloudflare管理域名解析、使用Codex下载并运行GitHub上的rbp-portfolio模板、补充个人内容框架(首页、关于我、项目、文章、联系)、在React Bits挑选背景等视觉效果并交给Codex接入。教程区分Mac(computer use)和Windows两条路线,强调先跑通模板再逐步美化、每轮只改一组内容的迭代方式,让不懂代码的人也能借助AI完成建站上线。
作者开源了一个名为「孔版印刷机」的网页小工具,可将照片转成复古孔版印刷风格。工具提供7组控制项:油墨颜色、色彩数量、明暗阈值、网点大小、套印偏移、纸张颗粒和效果强度,支持原图/效果图对比查看与随机配色。图片在浏览器本地处理,使用WebGL加速并提供本地Worker回退,可导出原尺寸PNG。项目采用MIT许可,源码托管在GitHub,可直接打开index.html使用,为内容创作者提供了新的封面风格选择,也是动手做工具的起点。
作者整理了 25 种 AI 修图创意玩法,帮助大家拯救旅行中拍废的照片,让朋友圈更好出片。核心工具是元宝内置的 Hy Image3.5 Preview 模型,免费且自带大量模板。文章按旅行照片的三类——人像照、风景照、美食照展开,展示了多种玩法及完整提示词:黑白颗粒感杂志拼贴封面、MBTI 漫画登机牌、美式复古潮流海报、JRPG 游戏任务界面、3D 城市地图定位、真人+手绘漫画结合、抽象涂鸦上下拼接等。每种玩法都附详细 prompt,强调保留原图真实质感的同时进行创意二次处理,适合国庆旅行拍照发布朋友圈使用。
本文介绍了如何借助WorkBuddy使用开源项目srt-whiteboard-animation,自动生成抖音常见的手绘白板动画视频。用户只需提供SRT字幕文件或视频脚本文案,甚至让AI直接生成文案,即可完成制作。作者详细演示了安装项目、生成字幕、首次出片、追加提示词生成配音与字幕的全流程。配音使用免费的微软edge-tts,积分主要消耗在生图环节,整个视频仅需约53积分,远比传统AI视频模型便宜。该方案适合教育科普、产品展示、知识讲解等场景的大批量持续制作,后期可导入剪映精细调整。
作者使用免费开源的 6B 设计模型 Ming-Image-0.1-Design,通过 OpenRouter API 制作了一张 9:16 海报。流程分四步:先生成高饱和赛博背景,再生成彩色液态糖果字和青色膨胀字两组艺术字,然后用 Design-Layer 模型拆出带透明通道的文字层,最后与人物、霓虹装饰重新排版,得到 1080×1920 海报及 7 个可独立调整的图层。作者也指出了局限:边缘噪点、图层分错、输出尺寸变化等问题。最后作者将 OpenRouter 调用封装为 Pi 插件,并附带修改后的 ling-ui-design Skill,方便他人复现。
作者取消了自己每月 250 美元的 SEO 订阅工具,改用 AI Agent(如 Claude Code)配合 Treg MCP 服务,以每次约 8 美分的价格完成 SEO 研究。文章介绍了 SEO 与 AI 搜索可见性(GEO/AEO)的区别,并给出一个五步研究流程:挑选真实用户问题、检查自己网站已有页面、分析 Google 前 10 结果、检查 AI 助手引用来源、生成一页简报并决定改进、新建或跳过。作者分享了首次实战案例和页面优化决策规则,强调代理负责低成本收集证据,而判断与写作决策仍由人来掌控。
文章面向 AI 初学者,系统梳理了 2026 年市面上的常用 AI 工具。作者按使用场景将工具分为六类:聊天 AI(豆包、ChatGPT、Claude 等)、通用 Agent(WorkBuddy、Claude Code、Codex 等)、图片制作(即梦 AI、Midjourney、Nano Banana 等)、视频制作(可灵 AI、Veo、HeyGen、Remotion 等)、声音制作(MiniMax Audio、ElevenLabs、Suno 等)以及个人助理(Grok Bot、OpenClaw、Hermes Agent 等)。作者强调应从自身需求出发选择工具,不必追逐每一款新产品,挑有代表性、能解决问题的工具用好即可。
作者因GPT-6额度消耗过快,重新审视自己的AI内容创作工作流,发现最大的浪费不是Token,而是与AI做过的工作没有沉淀为可复用的资产。文章提出按任务分工使用Chat、Work、Codex三类工具,并系统总结了创作者值得长期积累的六类内容资产:个人母体、用户世界、生活和观察、同行与市场研究、解决方案库、选题系统,强调从对话驱动转向资产驱动,让AI基于积累的资产持续工作,实现真正的复利效应。
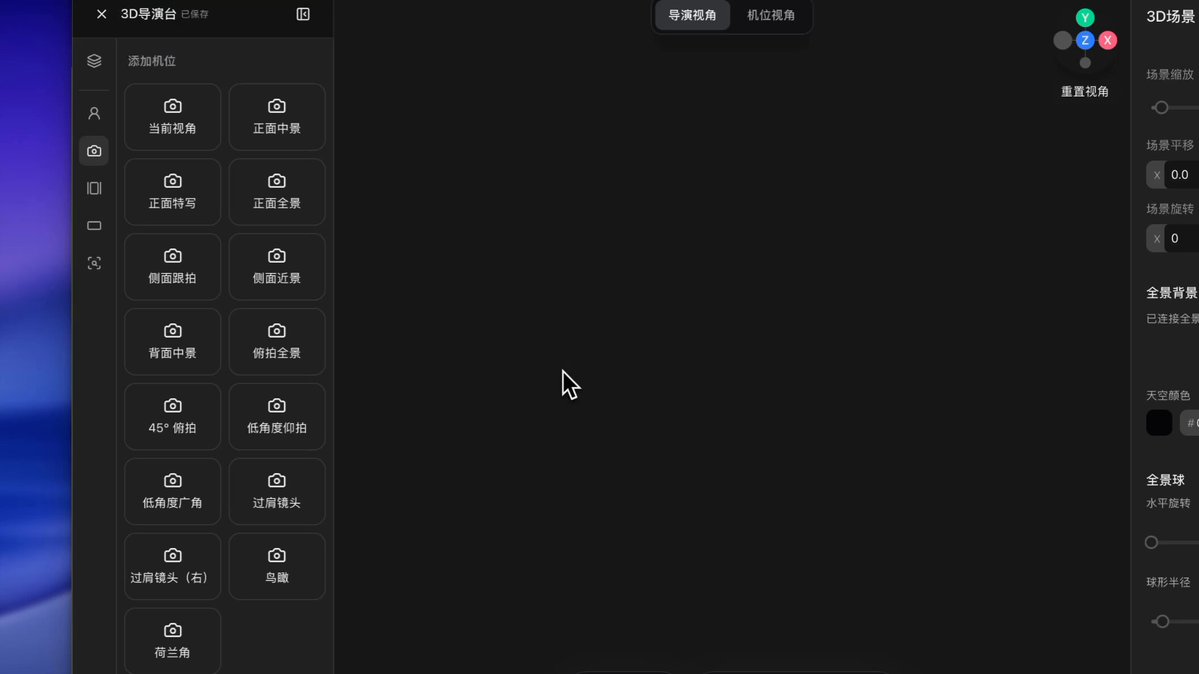
作者宣布在开源项目 BeefTV 中上线 3D 导演台功能,解决 AI 视频制作中“脑中有画面但模型听不懂怎么拍”的痛点。用户可在 3D 场景中创建白模、布置镜头机位与人物关系,再交由 AI 精确生成专业级视频。项目从零复刻 LibTV,已突破 700 stars,作者虽无科班编程经验,但借助开源社区积极反馈持续优化画布 UI 与导演台功能,并邀请用户加入微信社群共同建设 AIGC 开源社区。
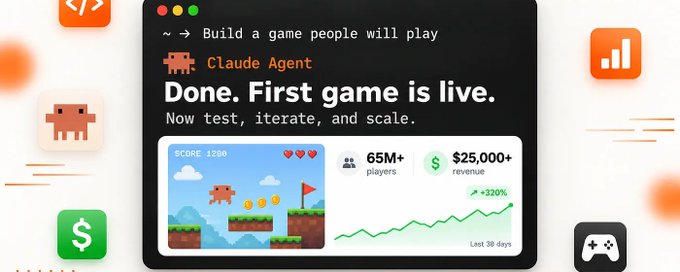
作者拥有6年游戏开发经验,制作过120多个游戏原型,但前100个几乎没有赚钱,转折点在于理解了分发的重要性。文章分享了作者如何借助 CrazyGames、Coolmath Games 等已有海量用户的网页游戏平台发布游戏,而非盲目自行推广。开发上,作者大量使用 AI 工具(Claude Code、Codex、AgentsGuild)进行 vibe coding,主要制作2D休闲益智类游戏。文章还讲解了游戏提交平台的流程、激励式广告变现方式、留存与参与度对收入的影响,以及如何通过数据分析持续迭代游戏。核心观点是:好的游戏只是起点,分发与用户参与度才是真正赚钱的关键。
作者分享了利用 AI 开发的开源背单词神器「词汇星图」。文章分析了传统背单词方式的痛点:纸质书无法乱序、App 复习流程不自由、缺乏多释义例句和同义词高级表达等。工具的核心功能包括:以网状结构展示单词的词汇星图(涵盖词形变换、派生词等同族词,以及同义、近义、反义、拼写相似等关联词)、集成剑桥、牛津、朗文等多词典数据的单词详情页、支持艾宾浩斯遗忘曲线和葫芦背书法的背单词功能,以及内置各类考试词表和自定义词表。项目已开源至 GitHub,旨在提供 AI 赋能教育的思路。
本文是一篇豆包工作(字节智能体办公软件)的完整入门教程。作者从下载安装、界面介绍讲起,涵盖文档与PDF处理、图片生成、Seedance视频生成等核心功能,并重点演示了如何利用开源Skill批量采集抖音博主的视频信息与逐字稿,写入飞书多维表格。文中还分享了水印关闭、权限授权、逐字稿分页截断等实操避坑经验,以及Trae、Seedance、豆包等产品间的区别。
本文是一篇云端部署阿里 Qwen-Image-2.1 文生图模型的保姆级教程。作者对比了本地部署与云端部署的优劣,横向评测了 AutoDL、恒源云、阿里 PAI、RunPod 等主流 GPU 算力平台,推荐性价比更高的 vGPU-32GB(RTX 4080 SUPER 32G)显卡,时租仅 1.58 元。随后以 AutoDL 为例,详细讲解了从选机、环境初始化、安装 Diffusers 依赖、解决系统盘存储不足的避坑技巧,到通过 ModelScope 通道拉取 30G 满血权重并用 Diffusers 出图的全流程,最后用 Gradio 十行代码搭建 WebUI 面板,实现单张 1024×1024 图片 31 秒生成,并支持原生 RGBA 透明通道输出。
文章介绍了一套用 AI 从零制作 3D 模型的完整流程:先用 GPT Image 生成物体的前、后、左、右四视图(人物统一 T 姿势),再上传 TripoAI 通过多视图生成 3D 模型。作者详细讲解了模型精度与面型选择、整体与分件模型的取舍、贴图(全局贴图、Magic Brush 局部修补、PBR 材质、去光照开关)、重新拓扑降面、自动绑骨骼(人形与非人形)以及按用途导出 GLB/FBX/STL/USDZ 等格式。最后用 GPT 生成基于 model-viewer 的单文件 HTML 预览页,实现拖拽旋转、动画切换与截图功能,让模型可直接用于网站或工作中。
本文介绍如何使用腾讯云推出的 AI 工作台 WorkBuddy 开发微信小程序。WorkBuddy 已集成小程序生成、预览、发布能力,省去在微信开发者工具和 AI 编程工具间来回切换的麻烦。作者以"待办清单"小程序为例,讲解了从描述需求、编写代码、卡片预览到分享发布的完整流程,并提醒两个关键坑:一是必须选择云环境才能使用预览功能;二是试用版小程序无法再绑定正式账号,若打算上线需提前注册微信小程序账号。文中还说明了免费版与付费版的额度限制,如试用版每个微信号最多创建 5 个、有效期 14 天,正式版每周最多提交 3 次审核等。
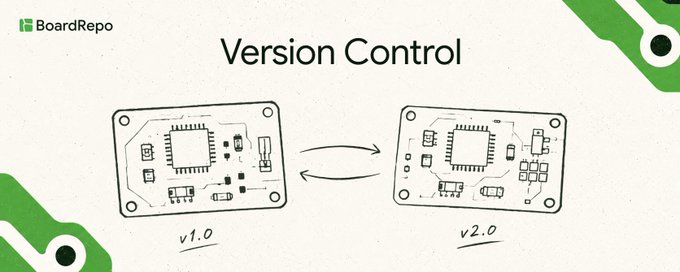
BoardRepo 宣布为 PCB 设计推出版本控制功能。借助 KiCad 插件,用户可在 KiCad 内一键推送、拉取项目并添加变更说明,无需终端或 Git 命令。所有版本的原理图、布局及相关文件集中保存,可随时回溯到任意历史版本并查看谁在何时做了什么改动。其可视化 diff 功能支持并排对比两个版本,变更直接高亮显示在电路板布局上,解决了文本 diff 对 PCB 文件意义不大的问题。该工具已支持 Mac 和 Windows。文章指出,AI 正在加速 PCB 设计并降低门槛,硬件领域需要类似 GitHub 的版本管理方案。
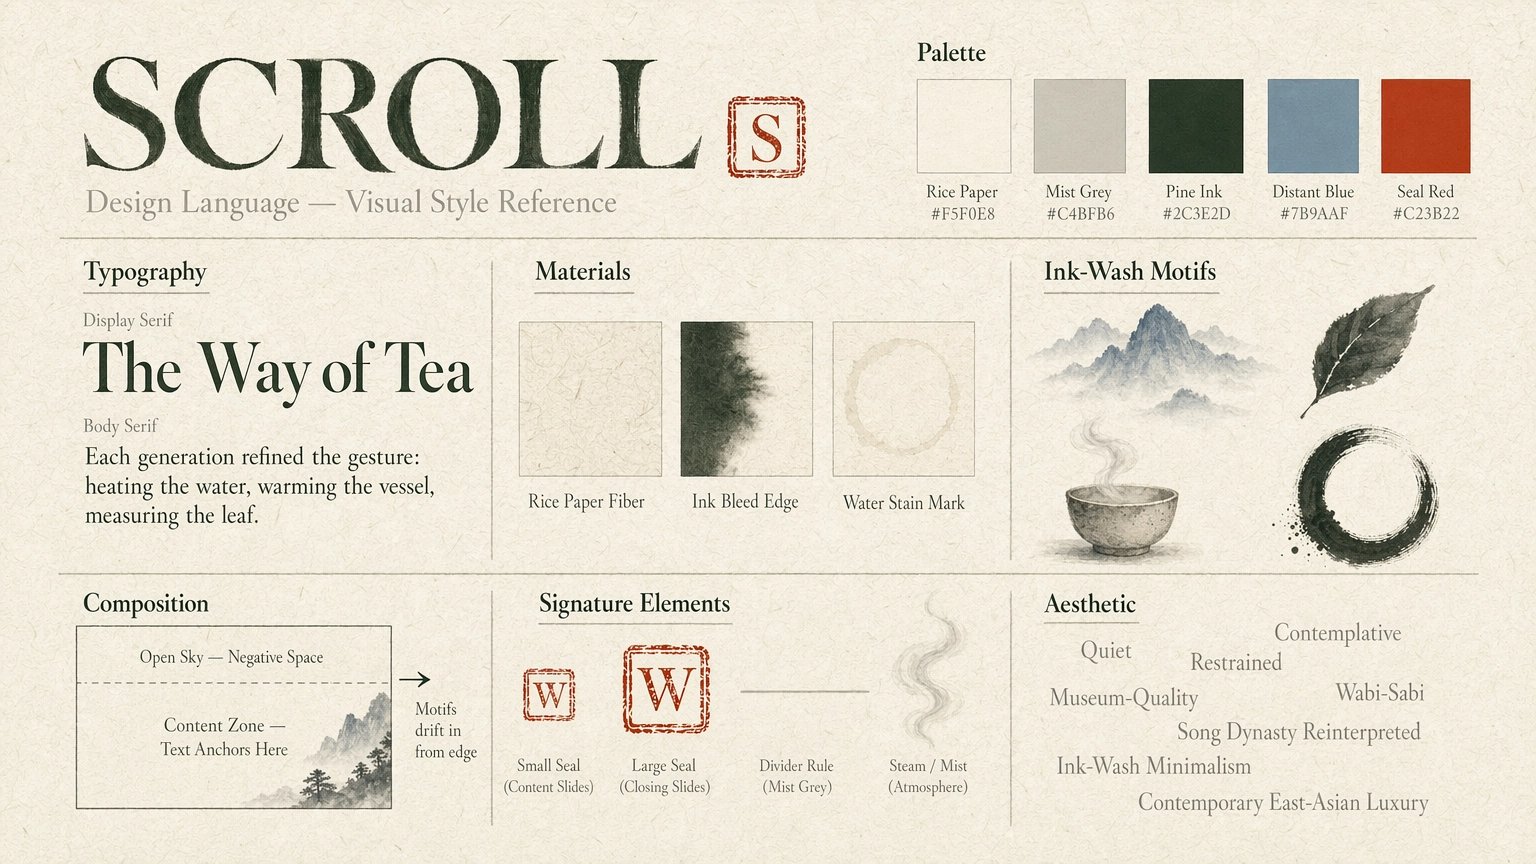
作者在测试 Manus 时学到一个提示词技巧:在生成图片时,不必用提示词详细控制样式风格,而是直接提供参考图,参考图中包含颜色、字体、宣纸纹理、墨迹边缘、水痕、印章与留白规则等视觉要素。这样出图稳定性更高,内容提示词也可以写得更简单。文中以'茶与慢生活'主题的水墨极简风格幻灯片为例,展示了参考图配合简洁内容提示词的完整实践,包括标题副标题、内容结构以及视觉方向的具体要求。
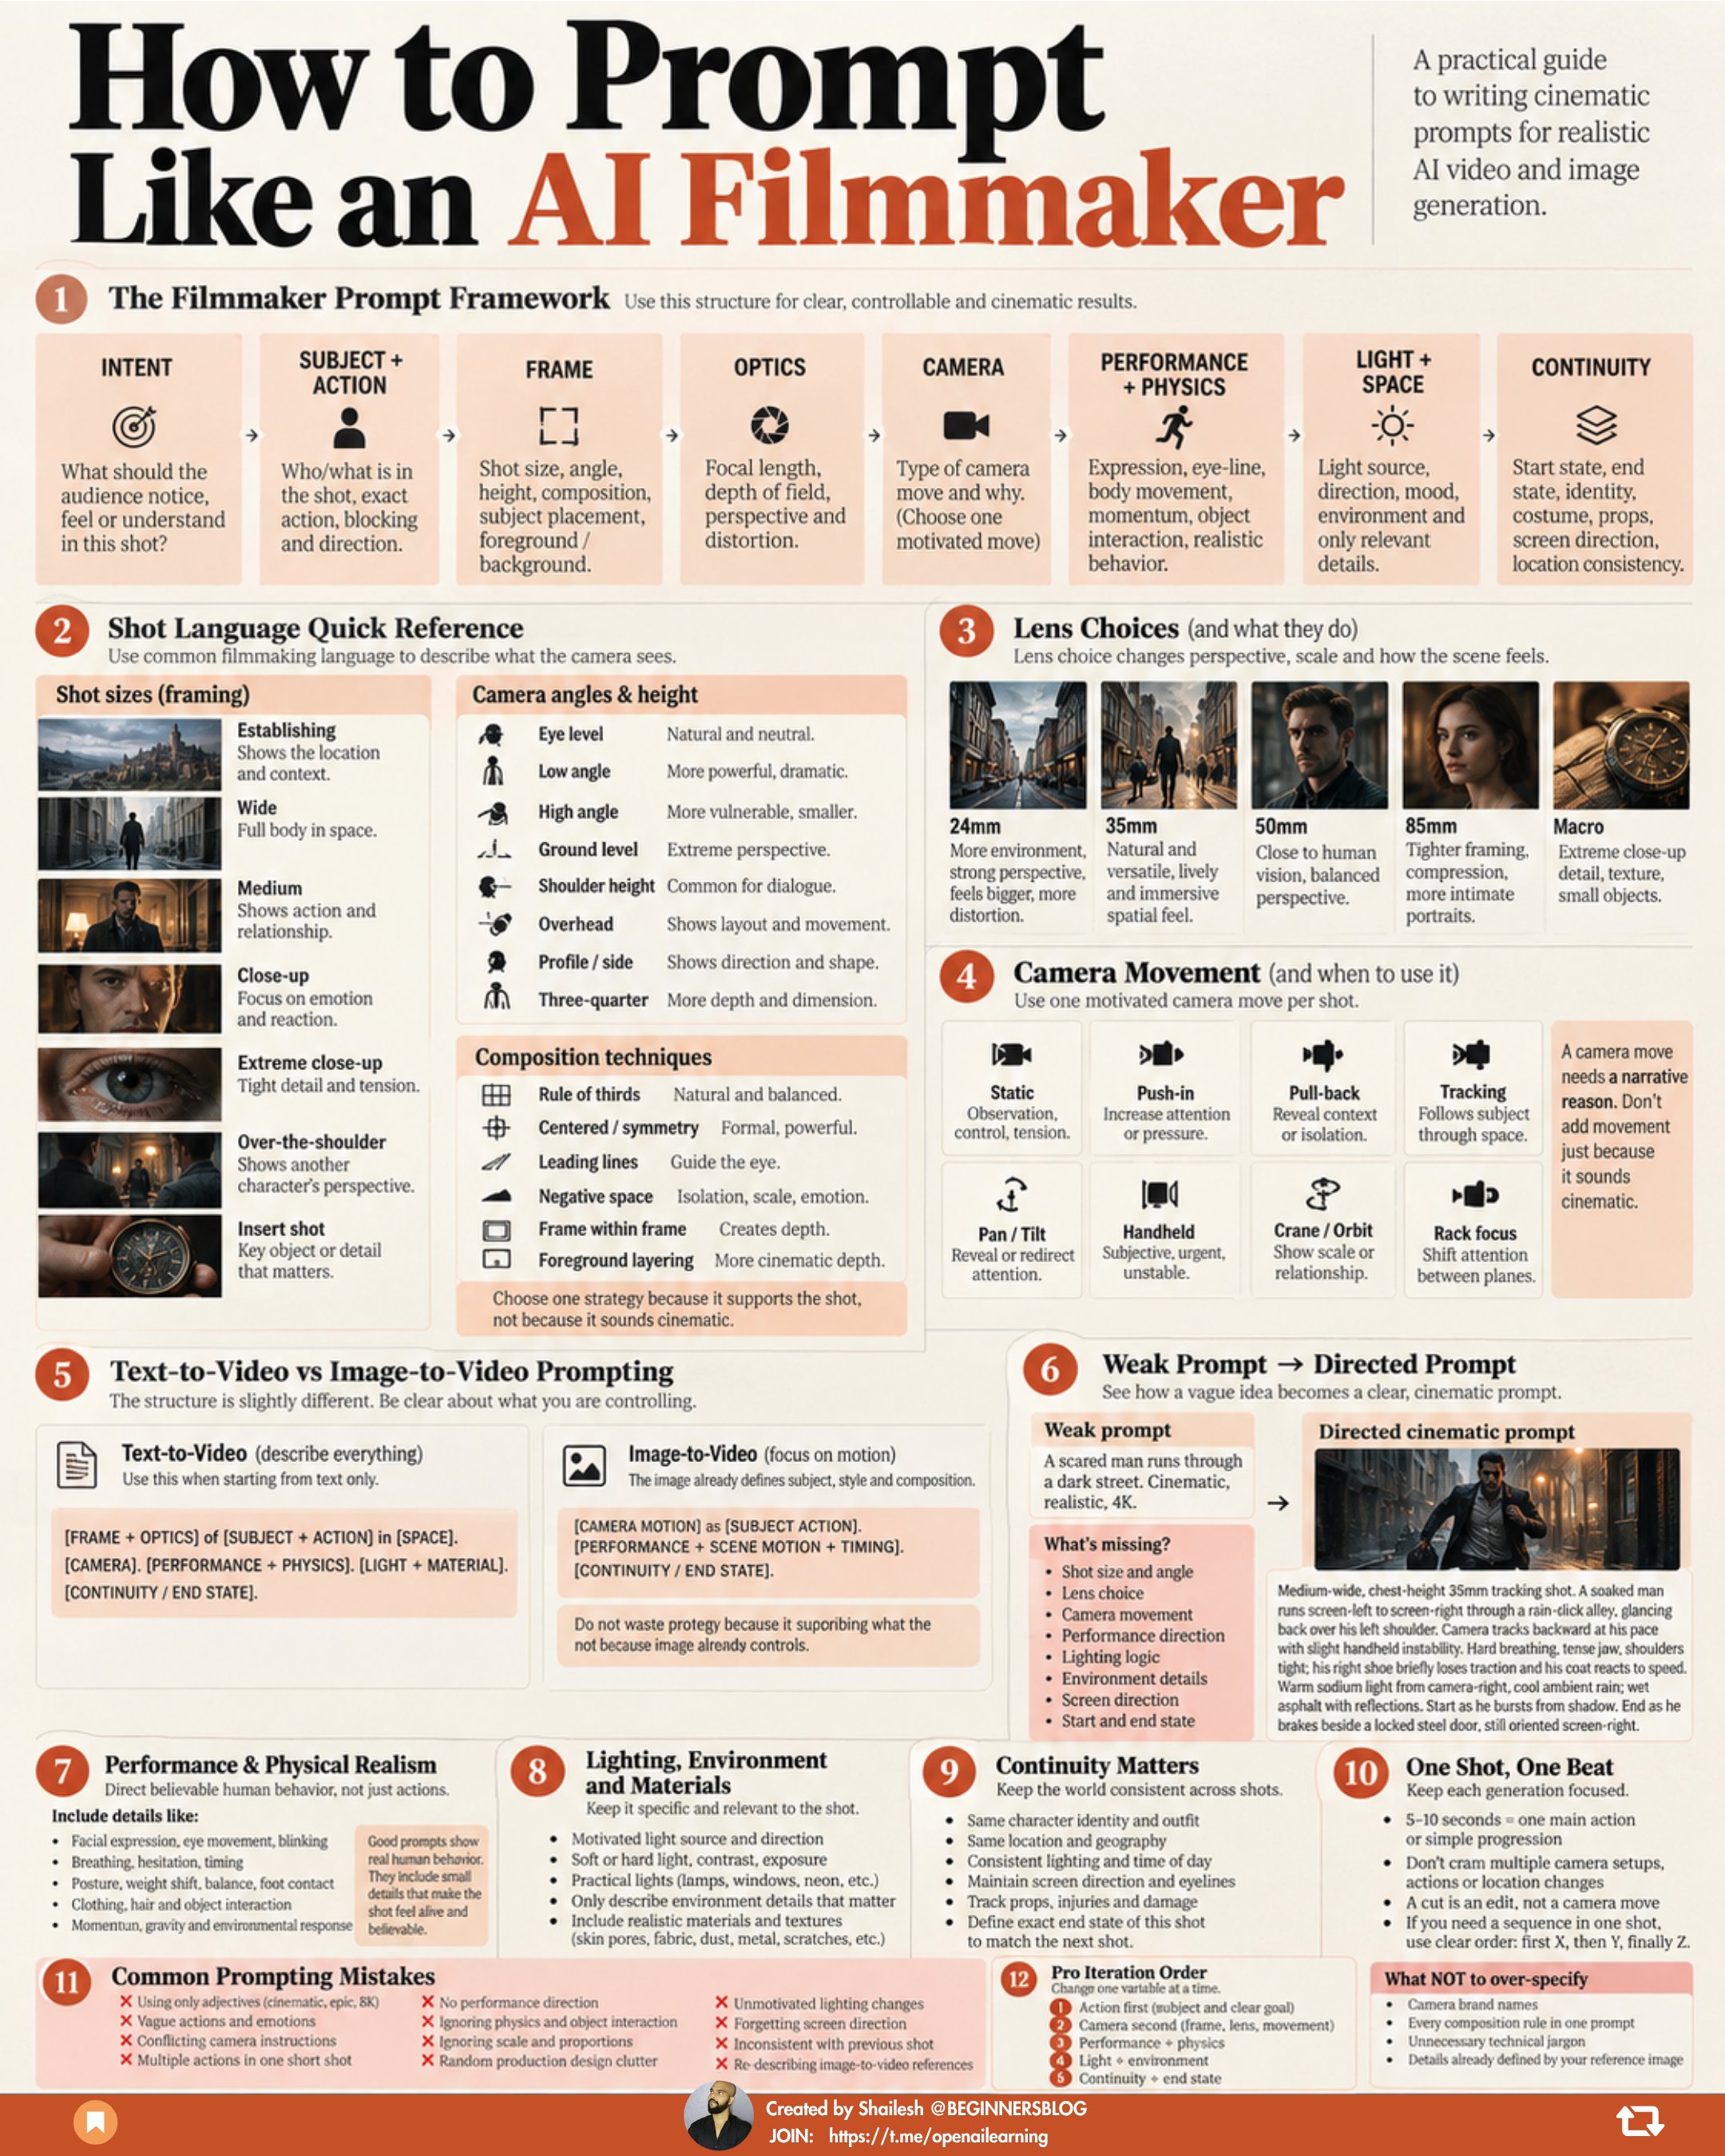
文章指出大多数 AI 视频提示词失败并非模型问题,而是提示词只描述了氛围而非镜头指导。作者提出专业 AI 影视提示词框架:INTENT(意图)→ SUBJECT+ACTION(主体与动作)→ FRAME(画面构图)→ OPTICS(镜头光学)→ CAMERA(运镜)→ PERFORMANCE+PHYSICS(表演与物理)→ LIGHT+SPACE(光线与空间)→ CONTINUITY(连贯性)。强调要描述可见行为、有动机的光线和运镜,区分文生视频与图生视频的提示方式,并遵循'一个镜头一个明确节拍'的原则。
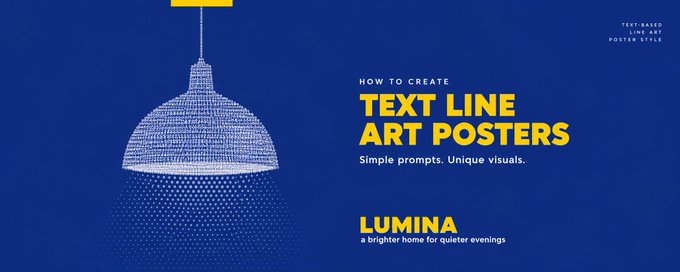
作者分享了一组AI生图提示词,核心思路是:一个熟悉的物件、全部由微型文字拼成、纯平面剪影、纯色背景。远看是干净图形,凑近发现每一笔都是字,风格克制耐看。使用时只需填写8项内容(主题、品牌名、标语、关键词、颜色、构图等),画幅设为3:4即可生成。文章附完整提示词模板,适合小店品牌海报、网店首图、公众号封面等场景,并给出了文字错误替换、模糊质感添加等后期调整建议。
作者提出,与其担忧AI夺走工作,不如关注它创造的新职业——自动化工程师。文章指出:工作需求无限,自动化需求也无限;构建自动化从未如此容易,但难点在于判断该自动化什么,并将其嵌入有真实人、流程与政治的企业环境中。以SeatGeek为例,部署AI后IT工单量暴增,通过自动化,三周内自动解决了40%的IT请求,六十天内超过50%,而原团队成员被重新部署到客服、合规和法务等部门构建新自动化,公司还因此增设了五个自动化工程师岗位。作者认为这是AI时代真正的新兴职业,并公开招聘首批百名自动化工程师。
作者分享了利用 AI 工具在 Blender 中制作蜘蛛侠 CG 短片的完整流程。借助 Hi3D Agent 通过对话生成城市模型,从 Sketchfab 下载带骨架的蜘蛛侠角色,用 Mixamo 提供跑步、下坠、摆荡等动作素材,再通过 Blender MCP 让 Codex Astra 读取场景并执行 Python 操作完成素材导入、摆放与动画,配合 Rokoko 插件做动作重定向,最后设计镜头并用 Cycles 渲染、FFmpeg 合成视频。作者认为 AI 赋能为 3D 创作带来技术平权,即使低配显卡也能按此流程制作出不错的效果。