Wiki 知识库

全部文档 / 标签: 知识管理

195 篇
清除

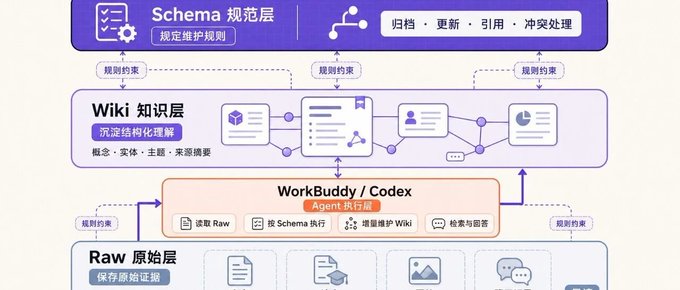
用 Codex + Obsidian 搭建自生长的个人知识库实战

作者基于 Karpathy 提出的 LLM wiki 理论,结合 WorkBuddy/Codex 与 Obsidian,搭建了一套能够自生长的个人知识库系统。文章解释了 LLM wiki 与 RAG 类方案的区别:知识不是每次临时拼装,而是通过 Raw(原始资料)、Wiki(结构化知识)、Schema(规则规范)三层架构持续增量沉淀。Obsidian 以本地化 Markdown、双链和插件生态承担存储底座与人机界面,Agent 负责理解新资料、建页、建链、维护索引与变更日志。文中给出了完整目录模板、详细提示词,介绍了直接搭建、claude-obsidian 插件等多种搭建方法,并分享了模型选型与实战建议。

技术 › 工具与效率 苍何 2026-09-0721.1 KB 117.9K 913 86

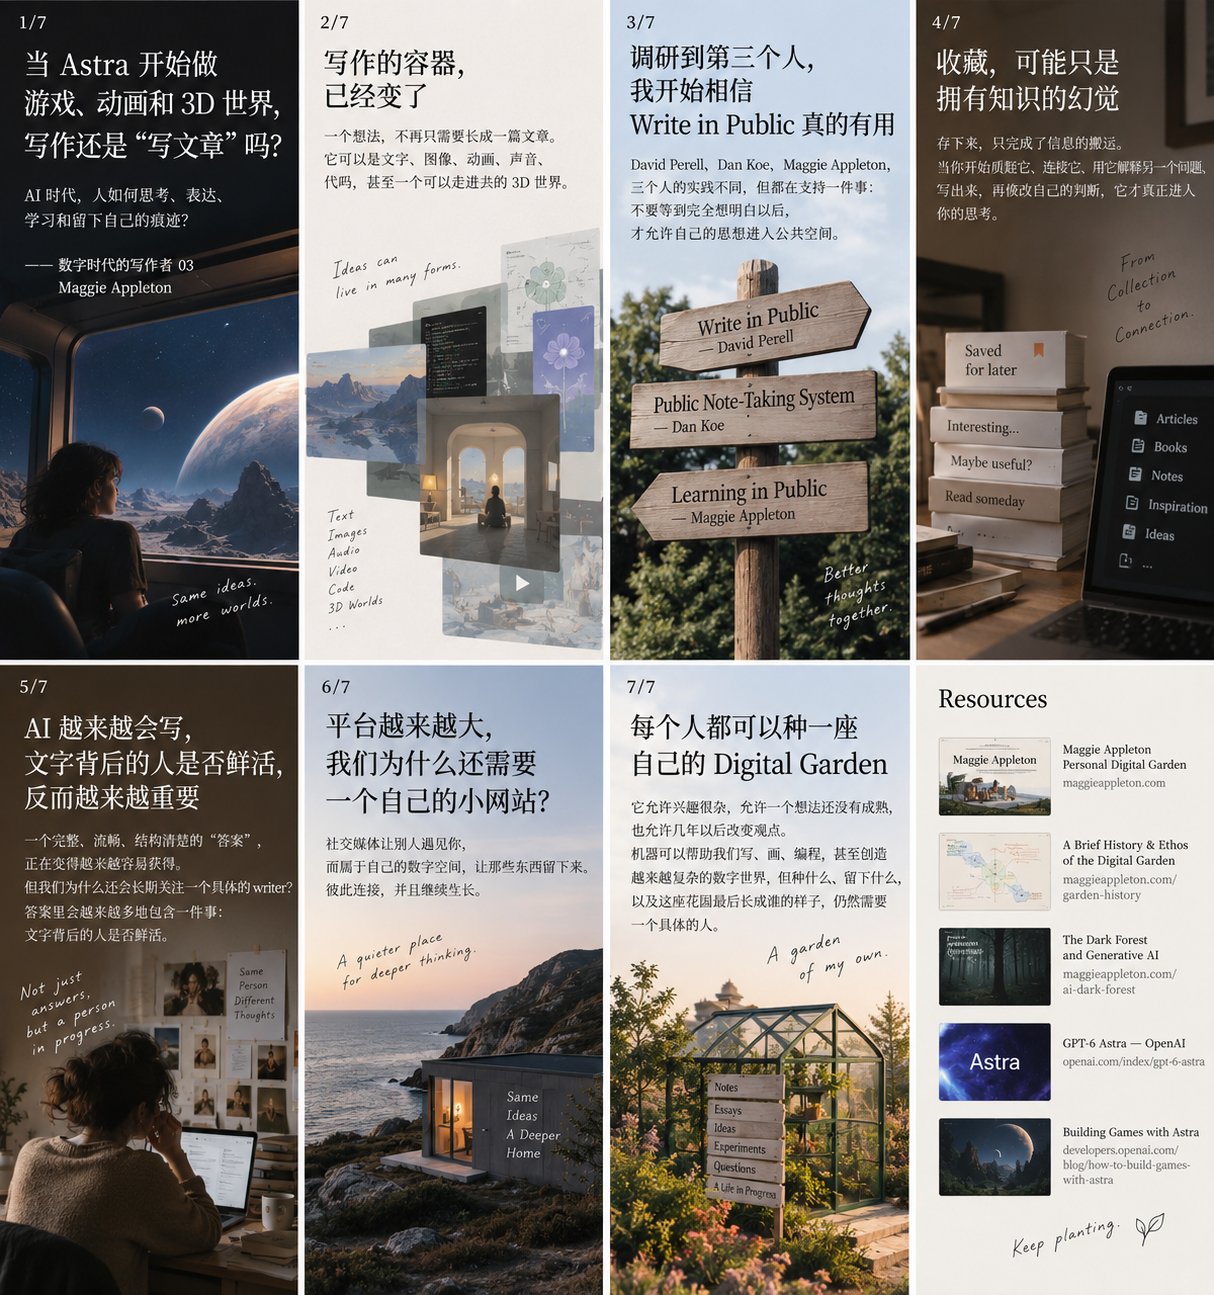
当 GPT-6 Astra 开始做游戏、动画和 3D 世界,写作还是'写文章'吗

文章以 GPT-6 Astra 引发的话题切入,介绍数字时代写作者 Maggie Appleton 及其 Digital Garden(数字花园)实践。作者认为 AI 正在降低动画、游戏、3D 世界等媒介的表达门槛,写作的容器正从 page 走向 world,写作者应先问想法适合长成什么,再选择媒介。文章还总结了 Write in Public、Learning in Public 的价值,对比了收藏式知识管理与花园式照料,指出 AI 时代文字背后鲜活的人越来越重要,并倡导人们搭建属于自己的数字花园,让思想公开生长、彼此连接。
技术 › LLM @Jamee_now 2026-09-069.5 KB 68

2026 我的 Obsidian 完整分享

作者 Jackywine 基于六年重度使用经验,全面分享 Obsidian 知识管理体系的万字长文。文章回顾了自己从疯狂装 47 个插件、反复删库重建的「工具崇拜」弯路,到形成成熟使用方法的历程;汇总并点评了多篇入门教程与论坛精华;介绍了 Obsidian 的创始人故事、本地 Markdown 数据持久性理念、双链优先于分类的核心思想、2500+ 插件生态,以及与 Notion、Logseq、Roam 的对比;最后结合 Karpathy 用 LLM 构建知识库的实践,探讨了 AI Agent 时代 LLM-Wiki 的知识管理新范式。

技术 › 工具与效率 Jackywine 2026-09-0450.5 KB 467.3K 1.1K 77

告别混乱收藏夹!我用 Markdown + 本地 AI 搭建数字大脑

作者分享了自己搭建 AI 个人知识库的完整经验。文章指出收藏资料不等于拥有知识,知识库应帮助找回信息、形成判断并推动行动。作者以 Markdown、JSON 和原始文件为事实源,搭建了包含 raw、notes、wiki、briefs、logs 五层结构的系统,覆盖内容入库、索引检索、AI 引用问答、周报复盘等流程。文章还总结了搭建中的关键原则:原文、AI 总结与个人判断分开,回答必须带引用,先用简单检索验证需求,注意隐私与数据边界,并通过 14 天真实使用验证价值,最终实现从收集到判断的行动循环。

技术 › 工具与效率 浅水虾 2026-09-029.2 KB 2.6K 2 77

开源豆包工作蓝皮书,我们只玩精品~

本文介绍了作者刘聪NLP及其团队继WorkBuddy蓝皮书后,再次开源豆包工作蓝皮书。该蓝皮书基于飞书、豆包生态,从个人提效、自媒体、知识管理、电商和金融五个场景出发,分享使用豆包工作这一Work Agent解决实际办公任务的方法。文章还提到建立Agent Work社区,旨在连接用户、产品方、行业专家和企业实践者,共同测试和探讨Work Agent产品,强调知识沉淀和真实问题解决。

技术 › Agent 刘聪NLP 2026-09-013.6 KB 1.9K 11 35

从0到1,讲讲怎么把 AI 调教成你的私人家教

本文介绍如何利用AI聊天工具(如ChatGPT)作为私人家教,系统学习一门知识。作者以《财务报表分析》为例,详细阐述了六个步骤:设定教学目标、准备学习资料、试听考察、出题考试、保存进度和持续学习。文章强调通过精心设计的提示词模板,让AI了解学习者的基础和目标,制定个性化学习计划,并通过提问、练习和考试确保学习效果。同时,作者也指出AI不能完全替代真人教师,但在知识获取成本趋近于零的时代,为自主学习提供了新的可能。

技术 › LLM 刘屿之外 2026-09-0114.3 KB 30K 211 81

飞书知识库+豆包工作,我把知识管理做成了一键Skill,已开源

作者分享如何用豆包工作在飞书上搭建个人 LLM-Wiki 知识库:先让豆包工作根据 Karpathy 的 LLM Wiki 方法论在飞书中初始化知识空间(原始资料、词条、索引、更新日志四大节点),再批量将文章、提示词教程等素材入库,自动建资料卡、提词条、补双链、更新索引。随后设计了 LLM Wiki 运维 Skill,包含 Ingest、Query、Lint、词条管理、索引日志维护五大功能,任何新对话 @ 一下即可操作。配合定时任务和云电脑每天自动拉取 AI 日报入库,存入的提示词方法论可直接调用来生成视频、做网站。整套 Skill 已开源。

技术 › Skill 刘聪NLP 2026-09-0110.8 KB 2.3K 19 81

别让你的经验烂在硬盘里!七步之内让 AI 把零散资料做成可分享干货

文章介绍了一套用 Agent 将散乱资料整理成可分享干货的七步流程:搭建项目工作台、通过问答生成任务开工单、盘点资料并建立材料索引与缺口记录、制作每个观点都有出处的提纲、生成讲稿/摘要/配图清单、让 AI 扮演审核员逐句核对事实与隐私、最后整理交付包并沉淀可复用模板。作者强调 AI 负责组织信息,人负责提供资料和做决定,通过严格的提示词约束控制幻觉,把硬盘里的零散经验变成真正的个人资产,可用于工作汇报、内容创作和项目复盘等场景。

技术 › Agent 刘屿之外 2026-08-3016.6 KB 8.9K 65 81

万字实战教程|我是如何用WorkBuddy搭建AI培训知识库的

作者分享了用WorkBuddy搭建AI培训知识库的完整实战经验。文章指出收藏夹和搜索无法让AI真正理解业务,核心问题在于保存不等于复用、搜索无法判断内容责任、一次性对话不会积累经验。作者从8份散乱材料复建了一个最小Wiki,设计了原始材料、来源卡、知识页、入口地图和交付物五个核心层,并通过设计一门两小时企业AI入门课来验证知识库的实际价值。文章还总结了AI建库初犯的错误(如未审核就标记live)、课程经验回写机制、定期Lint体检以及自动化来源雷达采集等持续运营方法,强调知识库的复利来自每次取舍都有理由。

技术 › 工具与效率 智见AI-大鹏 2026-08-2919.9 KB 24K 225 90

Dissecting over 1,500 company brains

作者基于帮助团队构建和维护超过1500个公司知识库的经验,总结了七条核心经验:1) 知识库应为AI Agent而非人类设计,让Agent自己重组信息结构;2) 通过MCP和API连接CRM、数据库等外部数据源与知识库本身同等重要;3) 让团队摆脱聊天界面,使用Claude Code、Codex、Cursor等能真正执行工作的工具;4) Notion等外部知识库因更新与工作脱节而失败,知识库必须内嵌于Agent工作流中;5) 除保存成果外,还要记录工作过程——提示词、被否决的方案和判断过程,这些是未来训练Agent的关键数据;6) 共享Slack Agent模式效果不佳;7) 知识库不应绑定单一界面,应实现一个大脑、多个接口。

技术 › Agent Jacob Posel 2026-08-276.2 KB 33K 79 79

成为AI原生公司:从共享技能库开始

本文介绍了企业构建共享AI技能库的实践指南。Agent Skill是可移植的程序性知识包,能教会智能体可靠地执行特定任务。作者指出技能通常由个人创建而未被公司充分利用,共享技能库可将其转变为可版本化、可发现的公司资产,是成为AI原生公司最容易的第一步。文章涵盖了Anthropic推出的开放技能标准格式、安全问题(Snyk研究显示37%的技能存在安全缺陷)、以及私有GitHub仓库和企业级技能注册工具等实施方案。

技术 › Skill Kevin Simback 2026-08-2616.8 KB 22.7K 213 83

Building Self-Correcting Memory in OpenWiki

本文介绍 OpenWiki 如何构建自我修正的记忆系统。传统记忆系统难以发现知识过时,导致记忆漂移和污染。OpenWiki 通过记录 wiki 页面中的事实性声明及其在代码中的支撑证据,并追踪证据版本,在代码变更时将相关声明标记为过时。每次更新前进行确定性的过期检测,由 Agent 在读取页面时重新验证或修正声明,形成自我修正反馈循环。该系统通过 OKF v0.2 格式使声明与溯源信息可移植。评估显示,声明运行时使过时声明从 80 降至 9,幻觉声明从 15 降至 0,且更新成本随代码变更量而非声明总数扩展。

技术 › Agent Colin Francis 2026-08-269.5 KB 54.4K 413 75

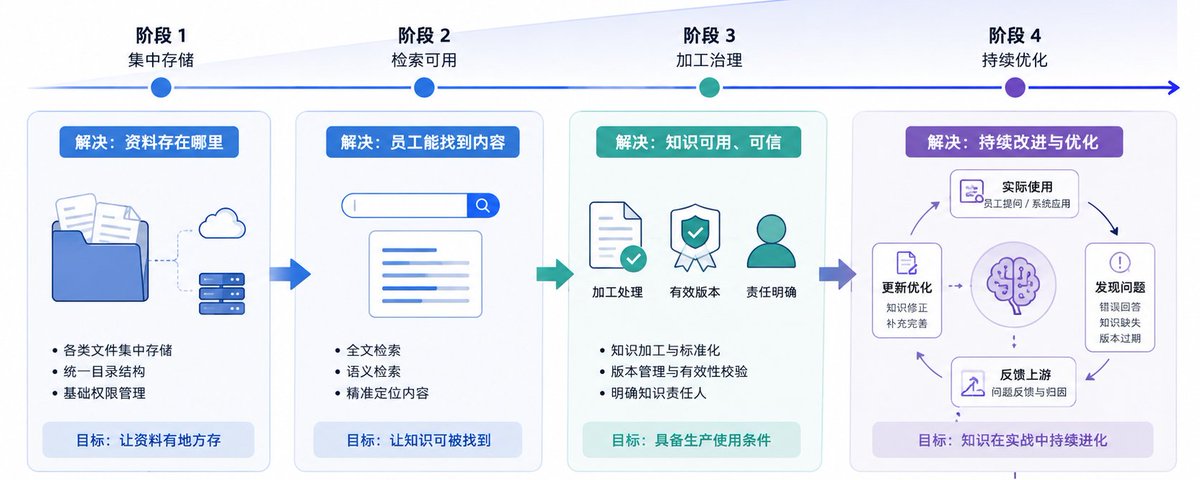
大型企业AI落地的隐性共识:知识工程必须先做扎实

文章指出许多企业AI项目验收后使用率低迷,核心原因是企业知识未能有效管理和利用。作者提出知识工程是大型企业AI落地的必修课:知识入库前需经过校验、清洗、预标注和抽取等准入环节;入库后需进行生命周期管理、版本控制和健康监测。文章还介绍了知识库与知识空间的双层组织方式、细粒度权限控制,以及通过用户反馈形成知识闭环的机制。最后强调项目成败关键在于组织与人的参与,决策者应建立从知识资产到业务结果的评价链。

技术 › Agent 土猛的员外 2026-08-2421.1 KB 9.3K 61 77

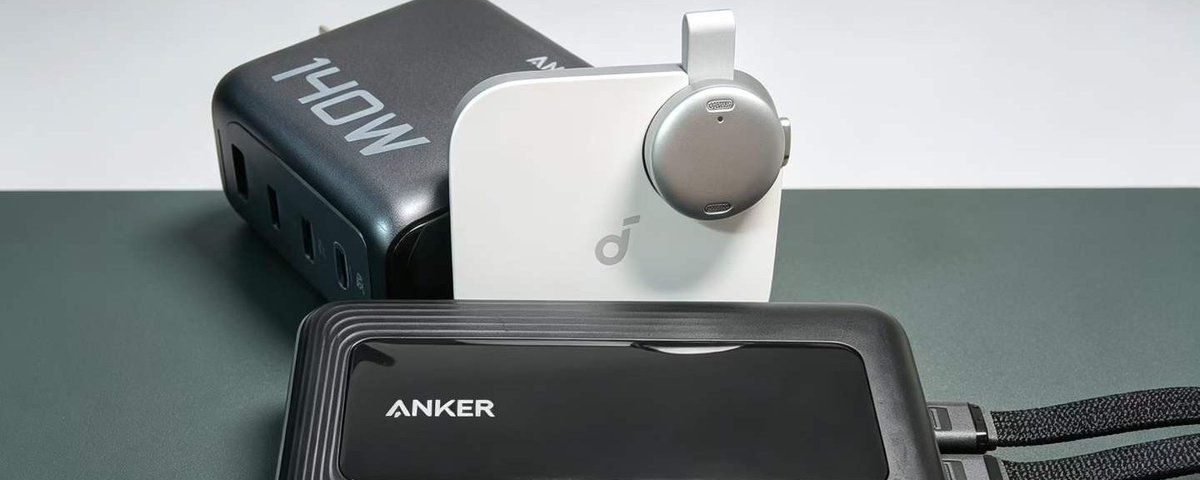
Anker录音豆+飞书:把生活闪念接入内容系统的Skill设计思路

作者分享了自己使用Anker录音豆与飞书妙记构建的recorder-diary Skill。核心观点是录音豆不是prompt入口而是生活入口,能捕捉走路、刷视频时突发的想法。作者将工作流拆为五层:捕捉层负责趁热录音;转写真源层坚持用逐字稿而非AI总结作为真源;语义分流层先判断录音类型(日记、规划、闪念、拆解)再处理,避免任务垃圾;内容加工层将模糊感觉拆成可复用的选题卡;承接层将结果写入Obsidian和仪表盘,确保第二天可见。作者认为AI工作流不应只围着聊天框设计,而应把内容生产的第一步移到想法发生的现场。

技术 › Skill 叫我阿杭 2026-08-2410.7 KB 35.2K 26 81

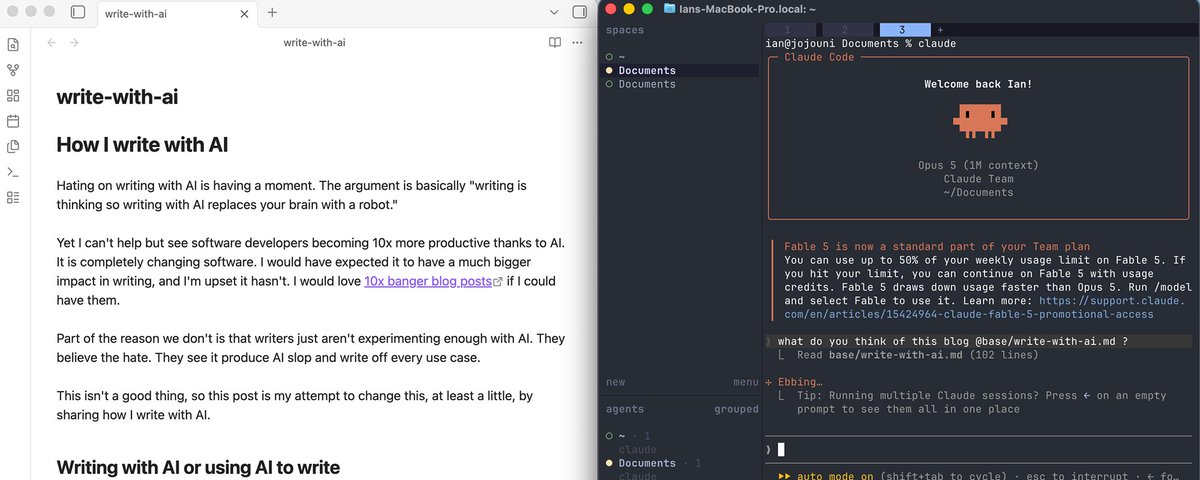
How I write with AI

作者分享了如何借助 AI 进行写作:坚持“用 AI 辅助写作”而非“让 AI 代写”,文字必须出自本人。他用 LLM 加速研究,通过自建的 researcher skill 结合 Exa、Hacker News、内部仓库和 Slack 等工具寻找真实、可引用的案例,并要求来源和引语以抑制幻觉。在草稿阶段,AI 充当文档内搜索和研究伙伴,帮助补充例子、验证事实、发现盲点。他强调写作者应多实验 AI 用法,而非因 AI 垃圾内容而全盘否定。

技术 › Claude Ian Vanagas 2026-08-2411.6 KB 20.2K 141 74

BestBlogs 精选周刊第 109 期:程序员的职业未来

本期周刊围绕「编码工业化之后程序员价值如何重新分配」展开。文章指出编码执行正被 Agent 工业化,但程序员价值不会自动消失或上移,新分水岭在于定义问题、沉淀组织知识、独立验证与承担结果责任。内容涵盖 AI Coding 对就业的影响、生成加速后的治理与验证前置、个人提效被组织摩擦吃掉的现象,以及程序员转向设计会学习的执行系统(如 Harness 插件化、Skill 自动改进等),并强调评价体系与价值流治理必须同步变革。

技术 › Agent ginobefun 2026-08-2329.0 KB 7.2K 2 83

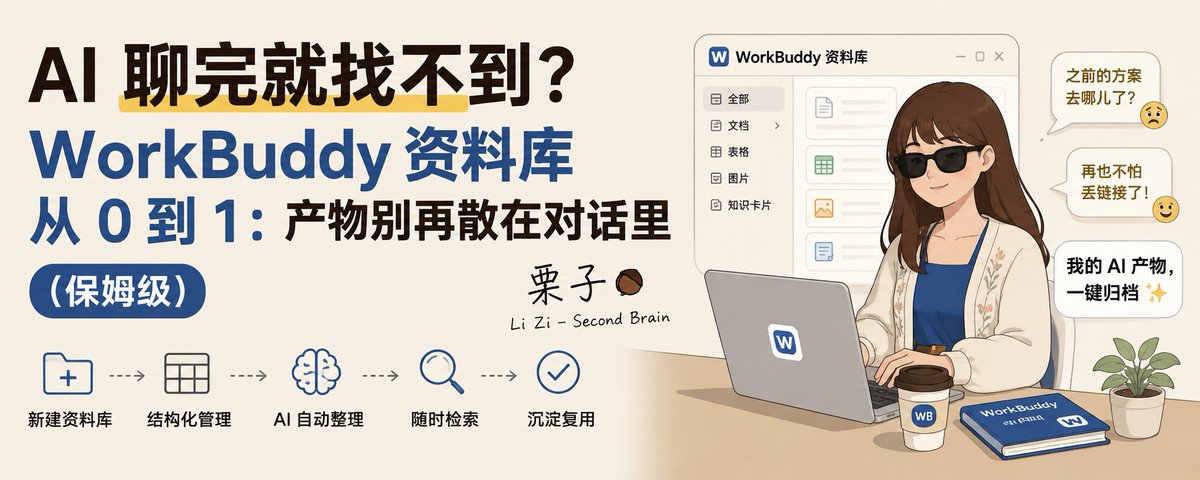
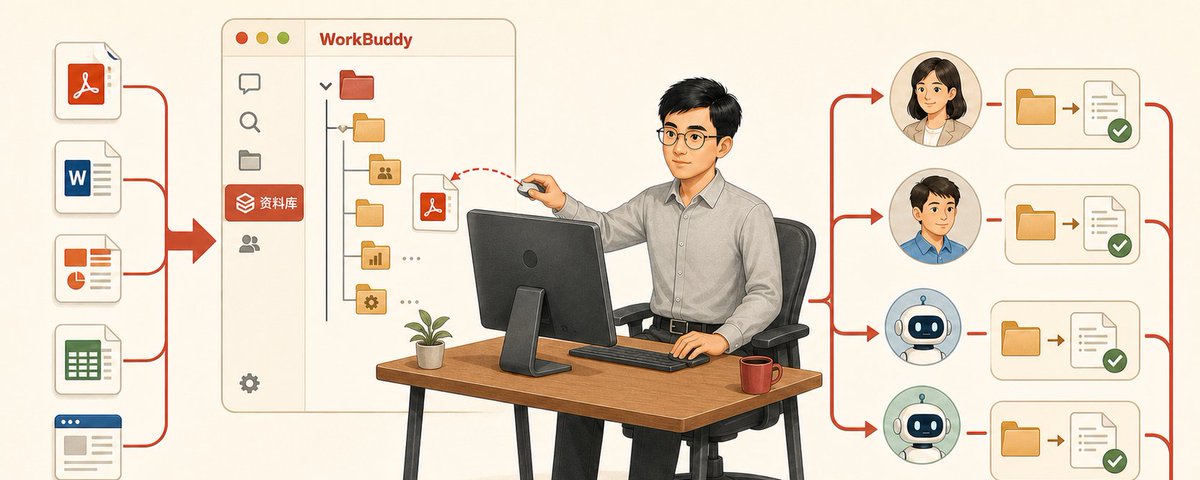
AI 聊完就找不到?WorkBuddy 资料库从 0 到 1:产物别再散在对话里

文章指出 AI 产物散落在对话中导致上下文断裂的问题,并提供 WorkBuddy 资料库的保姆级教程。核心闭环为:资料库 → 添加到任务 → Agent 执行 → 成果回存。内容涵盖三格分区、MD/CSV/HTML 容器分工口诀(改内容改 MD、改数据改 CSV、改样子改 HTML)、发布前人审六项(敏感、修订、归属、发布、积分、容量)、防目录变坟场的三条使用规则,以及用 CSV+HTML 搭建发布日历轻应用的七步实操。

技术 › Agent 沈美丽子 2026-08-2311.2 KB 11.5K 87 76

如何将你已知的任何知识转化为 Claude Skill

本文介绍了五种免费开源的方法,将书籍、文档、视频等已有知识转化为 Claude Skill,实现一次转换、永久调用。核心模式是:让工具完整读取源材料并提取结构和框架,Claude 按需加载,而非每次重新阅读。涵盖工具包括 book-to-skill(将 PDF 教材转为技能,支持按章节问答)、Skill_Seekers(将文档站点、GitHub 仓库转为技能)、/watch 插件(本地转录视频并提取画面回答问题)。文章通过学生备考、认证考试、小商户 POS 系统、自由职业者熟悉客户技术栈等多个真实场景,展示了这些方法的具体用法和价值:节省重复查找时间,让回答基于实际源材料而非通用训练数据。

技术 › Skill Oliver Prompts 2026-08-2214.8 KB 103.7K 77 72

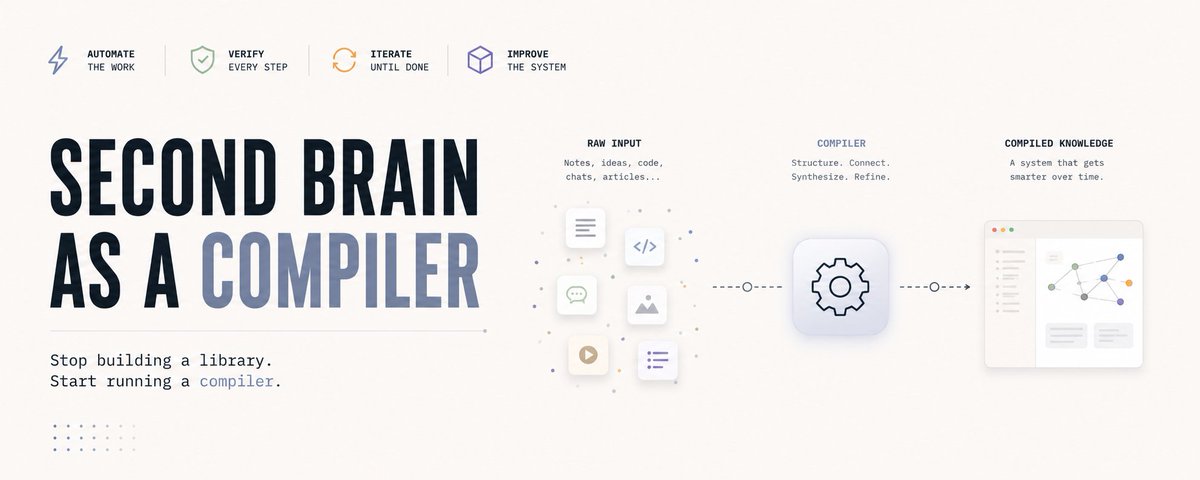
第二大脑不是存储系统,而是编译器

文章介绍了受 Karpathy LLM Wiki 启发的第二大脑新架构:不是把笔记当作检索用的档案柜,而是当作编译器。系统在摄入时一次性编译知识,自动链接、更新、标记矛盾,配合 CLAUDE.md 和每日编译循环,由 Claude 承担维护负担。作者分析了该方案相比 RAG 的架构优势、随时间复利增长的效果,以及源质量依赖、初期密度门槛、需付费版 Claude Desktop 等局限,并附上可直接使用的提示词。

技术 › LLM rvaniaaa 2026-08-218.2 KB 1.5M 841 78

Bypassing Figma & Building a Knowledge Product

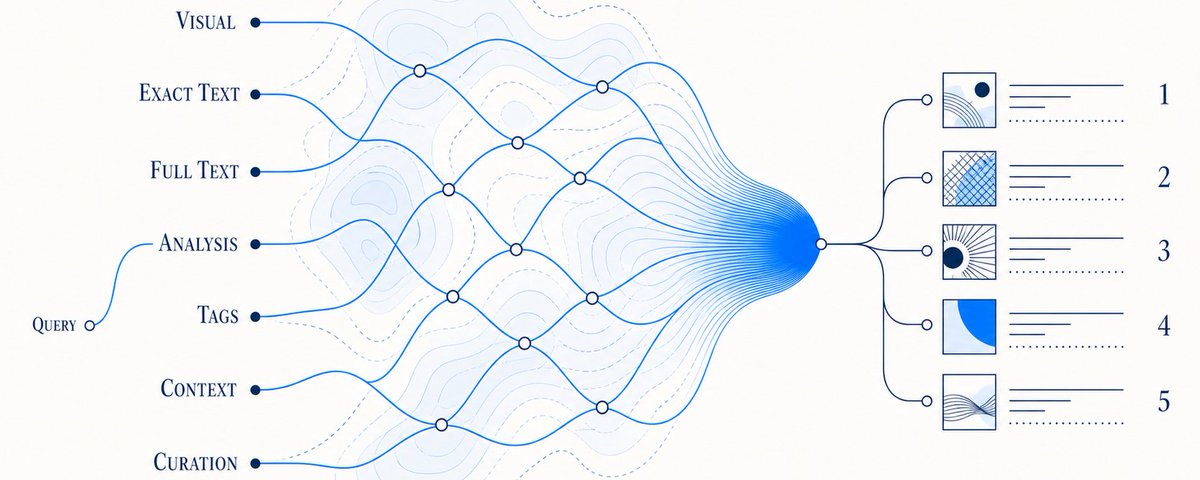
本文介绍了Little Plains团队如何将多年积累的工作室资料转化为可搜索的知识中心,并在此基础上构建了首个产品。文章详细阐述了知识层的构建过程,包括归档、索引、检索系统的设计,以及如何通过视觉搜索、动态聊天和语音三种方式提供公共访问。作者强调了组织知识的重要性,并分享了从传统设计转向代码驱动设计的经验,以及如何区分快速知识与深度知识以优化检索效率。

技术 › 工具与效率 Emmett 2026-08-2032.0 KB 194.9K 165 71

RAG架构详解:检索、增强与生成

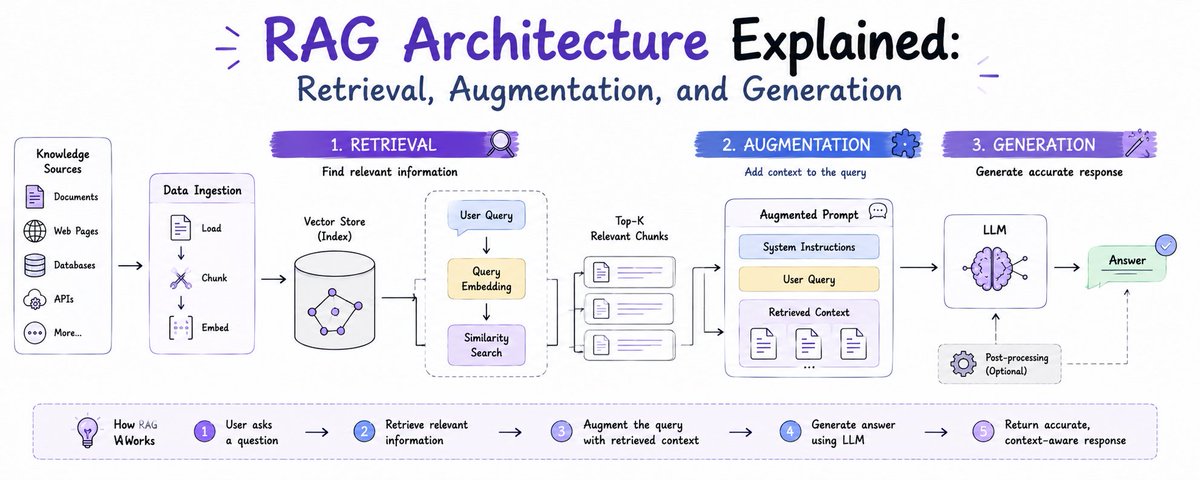
本文深入解析了生产级RAG(检索增强生成)系统的完整架构。文章首先指出LLM的局限性——无法访问私有数据,而RAG通过外部知识检索来弥补这一缺陷。然后详细介绍了系统的两大核心平面:知识平面(离线索引)和运行时平面(在线问答)。知识平面涵盖数据源、解析-分块-嵌入流水线以及向量索引;运行时平面则描述了用户查询、检索重排、LLM生成和答案引用的完整流程。文章还逐步拆解了查询生命周期,包括查询嵌入、Top-K检索、重排增强和生成,并强调了监控指标的重要性。

技术 › LLM Vikas gupta 2026-08-2020.4 KB 260.7K 69 73

我把自己的内容来源系统摊开来,想请大家挑挑问题

作者分享了自己正在搭建的内容创作工作台:从微信群、X、GitHub、YouTube、币安广场等渠道只读采集选题,用一系列 Skill 工具(last30days、content-research-writer、humanizer-zh 等)完成深挖、母稿撰写、中文润色、小红书和公众号改写与配图,目标是形成一条无人值守的内容流水线。作者坦承系统尚不成熟,存在群聊读取不完整、平台访问受限、主观判断影响排序、缺乏发布数据验证等问题,公开征集社区意见,探讨选题来源、偏见规避、自动化与人工把关的边界。

技术 › Skill 六时夜 2026-08-187.4 KB 563 5 69

我把10本橙皮书搬进了WorkBuddy!

作者花叔将自己用agent编写的10本橙皮书(共148章、四十万字)上传到WorkBuddy资料库。文章介绍了选择该平台的原因:国内访问GitHub不便,且资料库面向agent设计,支持HTML/Markdown等AI原生格式,可整书挂入上下文问答,实现'知识复利'。作者还介绍了资料库的可视化编辑、一键分享、轻应用(HTML+CSV搭建可存数据的工作台)、移动端远程接管电脑等功能,认为其有成为'AI时代Office'的势头。

技术 › Agent 花叔 2026-08-1814.4 KB 12.6K 73 74

WorkBuddy 团队知识库完整搭建方法:让资料被团队和 Agent 反复调用

本文详细介绍了使用 WorkBuddy 搭建团队知识库的完整方法,旨在解决团队资料分散、AI 无法有效复用的问题。文章首先区分了团队空间与项目的不同定位,然后分五步进行搭建:选择真实业务创建空间、先搭目录再倒资料、将确认结果回存、按职责分配权限、将空间添加到任务。最后,文章提供了验收标准、边界说明和升级建议,强调通过最小样本跑通闭环,实现资料的有效管理和复用。

技术 › 工具与效率 FlowOps Daily 2026-08-168.1 KB 4.7K 35 79

在 Obsidian 中创建你的第二个自我

本文介绍了如何将 Obsidian 从简单的笔记应用转变为 AI 可读写的记忆层,从而构建一个“第二个自我”系统。作者提出了双层记忆架构:一层为人类保留原始、混乱的思考,另一层为 AI 提供结构化、机器可读的上下文。文章详细展示了文件夹结构(如 00_inbox、01_self 等)以及五个核心提示词,用于将杂乱想法转化为笔记、生成每日记忆日志、更新项目记忆、创建决策记录以及向第二个自我提问。核心观点是:AI 的智能取决于其可访问的上下文,通过自动化笔记维护,Obsidian 能成为真正的工作记忆系统。

技术 › 工具与效率 kocer 2026-08-1513.9 KB 615.5K 199 80

Obsidian 小白完整入门教程(本地知识库)

本文是一篇面向新手的 Obsidian 完整入门教程,详细介绍了 Obsidian 作为本地知识库工具的核心概念、安装方法、界面操作、Markdown 语法、笔记组织方法论以及必备插件。文章强调在 AI 时代建立个人知识库的重要性,并提供了从基础到进阶的实操指南,帮助用户高效构建和管理自己的知识体系。

技术 › 工具与效率 黄小木 2026-08-1526.3 KB 1.5M 3.5K 79

与其由我自己来维护记忆,不如让Agent记住更多

作者分享了为Agent做知识管理的痛点:Skill无法跨项目迁移,知识库虽大但Agent无法自主利用,导致作者需要人工替Agent维护记忆。作者介绍了Alloomi产品,其通过三层架构(记得住、学得会、实践)实现Agent的自进化,并开源了OpenContext工具。作者希望未来的Agent产品能具备自进化能力,帮助用户组织底层记忆。

技术 › Agent 冷酷小猫 IcyCat 2026-08-137.5 KB 13.2K 51 62

Give Hermes A Second Brain With Obsidian

本文介绍如何利用 Obsidian 为 AI 助手 Hermes 构建一个“第二大脑”,使其能够访问工作所需的全部上下文。文章详细说明了从创建空 vault、让 Hermes 自动搭建结构,到通过访谈填充身份文件、设置上下文规则、建立路由表,以及实现捕获模式和夜间编译的完整流程。核心思想是区分原始素材(Raw)和编译知识(Wiki),让 AI 在回答前先读取相关文件,从而减少重复解释、提高回答质量。

技术 › 工具与效率 Tom 2026-08-1313.5 KB 24.6K 60 81

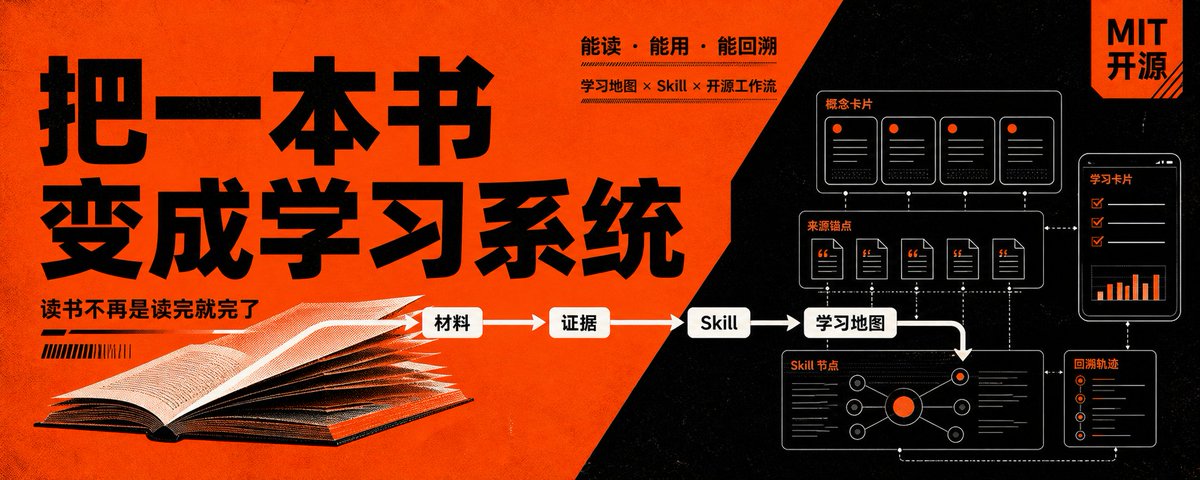
读书不再是读完就完了|我把《纳瓦尔宝典》变成了可调用的学习系统

本文介绍作者如何将《纳瓦尔宝典》转化为一个可调用的个人知识系统,包括构建Markdown证据层、生成学习地图和Skill、部署到Cloudflare Pages等。作者强调摘要、RAG和模仿作者聊天的不足,提出一套从原始材料到可持续交付的完整工作流,并开源了相关代码。文章详细阐述了系统逻辑、实施步骤和实际效果,旨在帮助读者建立自己的知识资产。

技术 › 工具与效率 Su 2026-08-1223.7 KB 39.6K 359 82

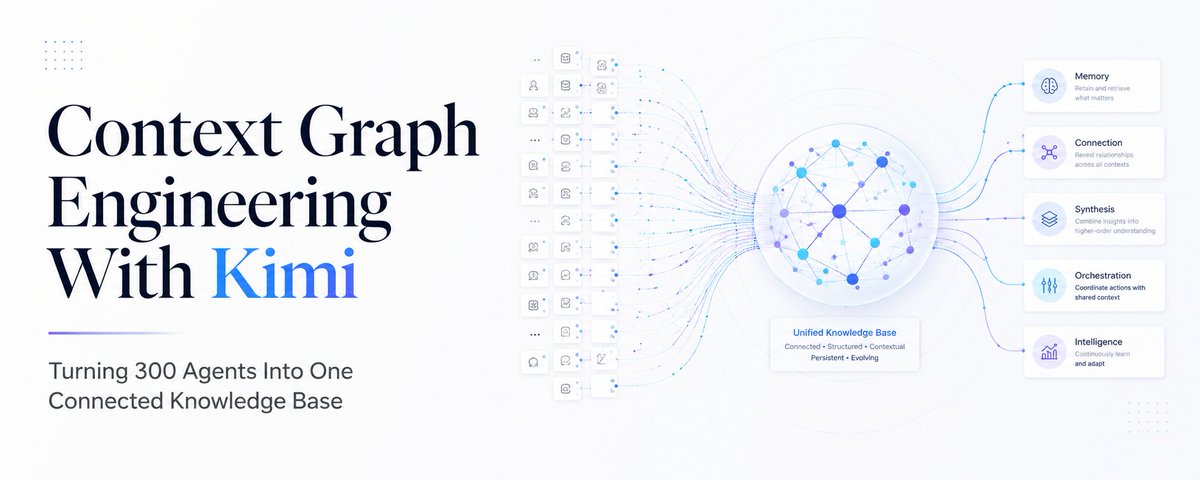
Context Graph Engineering With K3: Turning 300 Agents Into One Connected Knowledge Base

本文介绍了Kimi Agent Swarm如何通过上下文图(Context Graph)将300个并行代理的研究结果整合为单一知识库。文章指出,传统并行代理产生的是分散的答案堆,而Kimi通过将每个实体作为节点、关系作为边,构建可查询、可扩展的图结构,使研究者能发现隐藏联系、提出新问题,并实现知识的持续积累。

技术 › Agent Ricker 2026-08-128.6 KB 838.7K 384 68