RLMs are the new reasoning models
本文探讨了递归语言模型作为一种新的推理范式的重要性。RLM 通过将模型自己的提示视为可检查、切片和递归查询的环境,直接结合了推理和工具使用。文章回顾了推理和工具使用的历史发展,从思维链到 ReAct,再到 OpenAI o1 和 Claude 的工具使用。最新研究显示,RLM 在长上下文、记忆和长推理任务中表现出色,克服了传统单次前向传播的局限。
本文探讨了递归语言模型作为一种新的推理范式的重要性。RLM 通过将模型自己的提示视为可检查、切片和递归查询的环境,直接结合了推理和工具使用。文章回顾了推理和工具使用的历史发展,从思维链到 ReAct,再到 OpenAI o1 和 Claude 的工具使用。最新研究显示,RLM 在长上下文、记忆和长推理任务中表现出色,克服了传统单次前向传播的局限。
这是一份针对计算机科学和数学专业大二学生的机器学习(ML)与强化学习(RL)入门阅读清单。清单分为四个部分:基础(如ResNet、Attention)、AI基础设施(如VAE、BERT、LoRA、Agent)、推理加速(如Linear Attention、Speculative Decoding)以及强化学习(如PPO、DPO、RLHF)。该列表由导师 Mingyang Yi 推荐,旨在帮助本科生构建系统的 AI 知识体系。
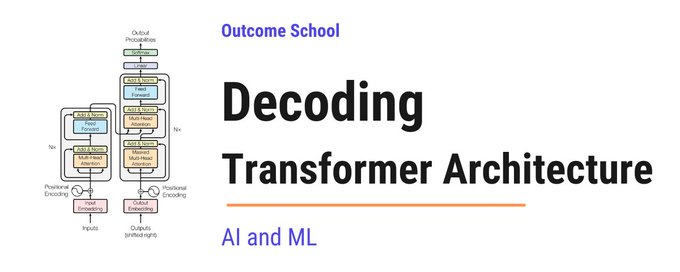
本文深入浅出地解析了 Transformer 架构,它是现代大语言模型(LLM)的核心。文章从宏观视角出发,通过解码的方式,逐一拆解了 Transformer 的关键组件,包括编码器与解码器、分词与嵌入、位置编码、注意力机制(Attention)以及多头注意力等。作者详细解释了该架构如何解决传统模型的“遗忘”和“慢速”问题,实现了并行处理和长距离依赖捕捉,并最后阐述了其强大的原因。
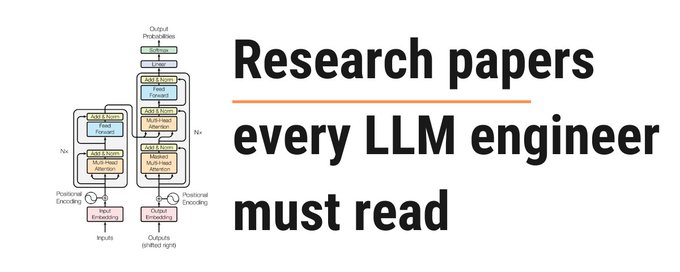
文章列出了每位 LLM 工程师必须阅读的 12 篇核心论文清单,涵盖了从 Transformer 架构、BERT、GPT-3 等基础模型,到扩展定律、Chinchilla 训练法则、RLHF 对齐技术,以及 LoRA 高效微调和 FlashAttention 等工程优化技术。这些论文构成了现代大模型理解、训练和部署的理论基石。
本文深入剖析了信息时代下的「伪学习」困境,指出人类大脑进化滞后于技术发展导致认知效率下降。文章结合神经科学原理,揭示了多任务处理、碎片化信息和即时反馈对大脑记忆机制的损害,并提出了利用「无聊」激活默认模式网络(DMN)的价值。作者提供了一套包含认知节律建立、环境断舍离及深度加工技术的系统性重构方案,旨在帮助读者从信息过载中夺回注意力,实现深度学习。
本文介绍了开发者 arman-bd 开源的微型语言模型 GuppyLM。该模型拥有 900 万参数,核心代码仅 130 行,可在免费 Colab 上 5 分钟训练完成。文章详细拆解了构建流程:利用模板生成 6 万条合成数据、训练 4096 词表的 BPE 分词器、搭建 6 层 Vanilla Transformer 架构以及优化推理环节。该项目旨在通过极简的实现,帮助开发者深入理解语言模型的数据工程、架构设计与训练循环。
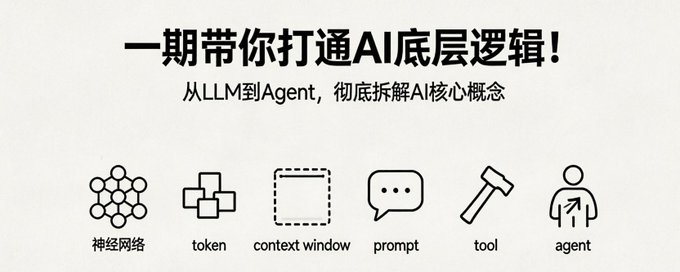
本文是一篇基于工程视角的AI技术硬核解析,旨在厘清从LLM大模型到Agent智能体的核心概念体系。文章深入浅出地拆解了LLM的文字接龙本质、Tokenizer的翻译机制、上下文窗口的容量限制,以及Prompt工程、MCP工具协议和Agent技能的运作原理,帮助读者建立完整的底层技术认知。
本文探讨了在只有 12G 显存的消费级 GPU 上进行大语言模型(LLM)算法研究的可行路线。文章指出资源限制本身可以成为研究的起点,并重新定位了研究方向为对小模型的训练算法与适配方法做贡献。文章详细计算了 12G 显存的实际边界,提出了三条可行路线(训练算法优化、结构改动、RL/推理),并介绍了如何利用 HuggingFace 生态(包括官方 Model Trainer Skill)来搭建实验环境、选择模型以及设计严格的三层验证实验(机制验证、扩展验证、现实落地)。
本文是一篇硬核技术教程,详细记录了如何不依赖任何外部库,仅使用纯 C 语言从零构建一个可用的 GPT(Generative Pre-trained Transformer)模型。文章涵盖了从随机数生成、数据分词、模型架构定义,到手动实现反向传播、Adam 优化器及推理采样的全过程。通过手写矩阵乘法、注意力机制和神经网络层,帮助读者深入理解 LLM 的底层原理。
本文是一份详细的机器学习(ML)工程师学习路径指南。作者首先纠正了被动观看视频的学习误区,提出“两遍学习法”以建立深刻的技术理解。文章明确了ML工程师与数据科学家及研究员的区别,强调工程实现能力。随后,作者将学习路径分为两个阶段:第一阶段利用 3Blue1Brown 的视频构建数学直觉,涵盖神经网络、梯度下降、反向传播及 Transformer 架构;第二阶段(文中截断处未完)预告将通过 Andrej Karpathy 的课程来提升代码实现能力。
本文是对 2025 年大语言模型(LLM)领域发展的深度回顾。主要趋势包括:推理模型的普及(OpenAI o 系列)、Agent 和编码 Agent 的爆发式落地(特别是 Claude Code)、中国开源模型在排行榜上占据主导地位、长任务处理能力的翻倍增长、Google Gemini 的全面崛起以及 OpenAI 领先优势的缩小。此外,文章还涵盖了图像编辑、学术竞赛表现、模型安全与“告密”现象等热点话题,指出 2025 年是 AI 实用化和工具化的一年。
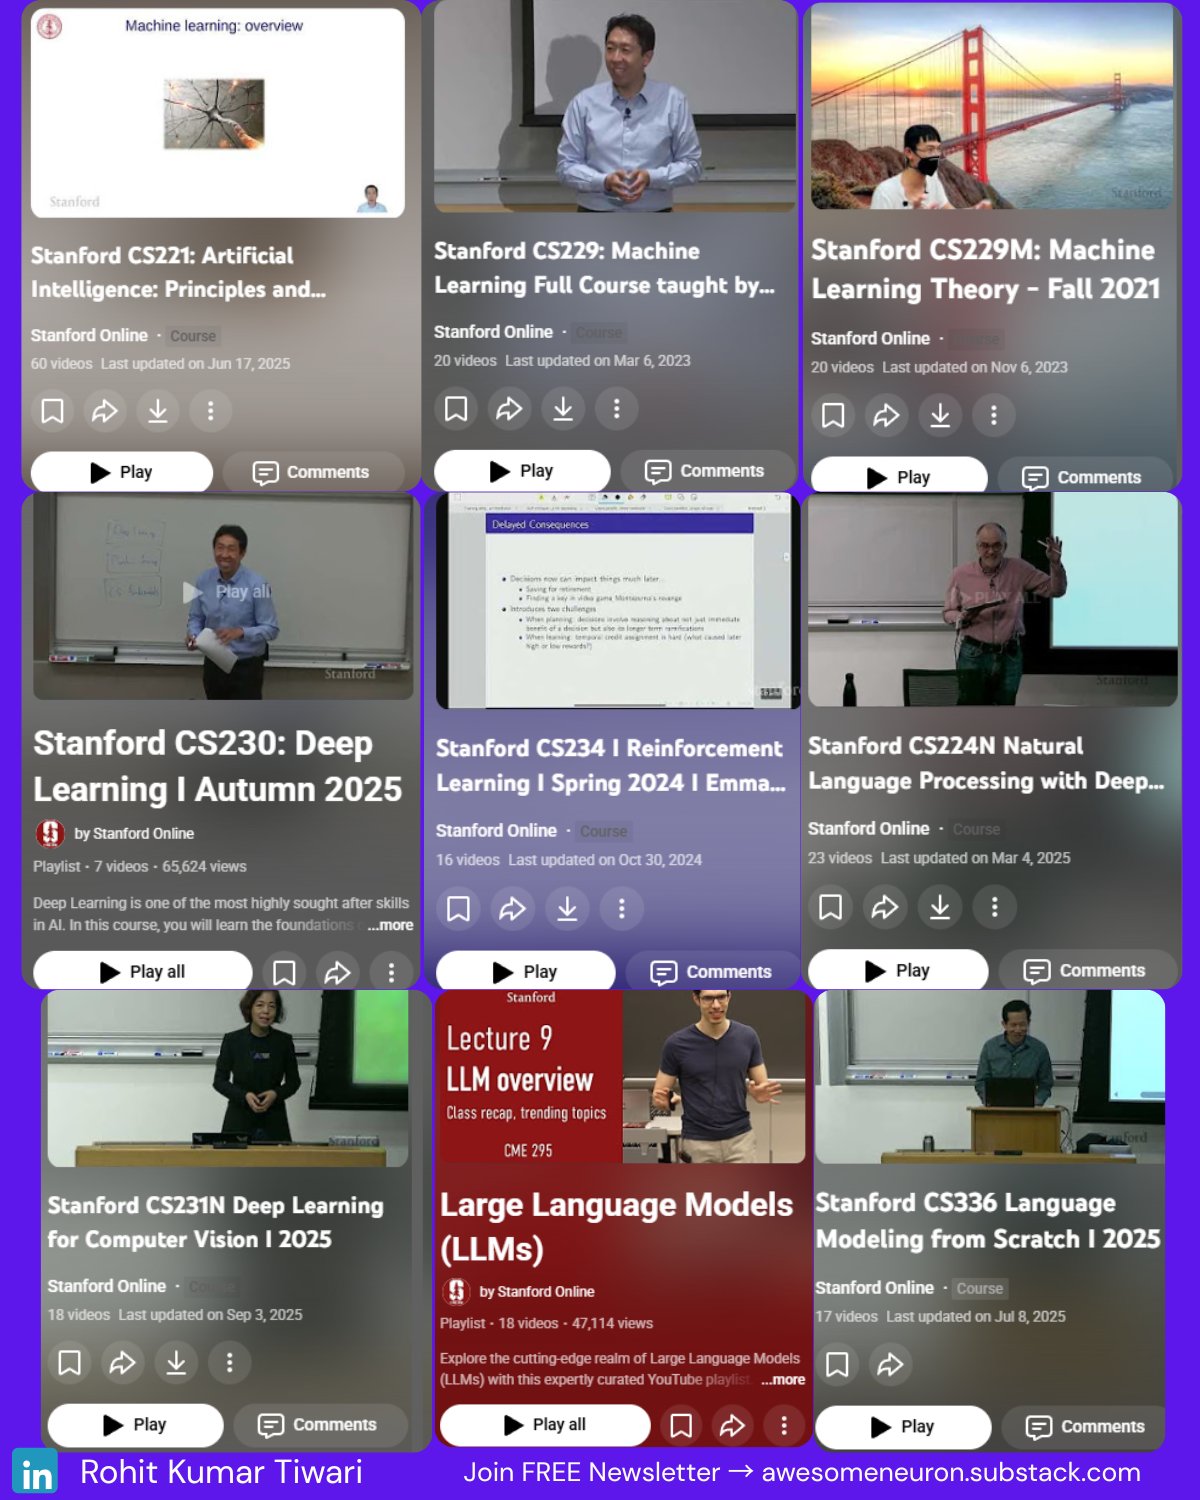
本文列举了斯坦福大学关于人工智能与机器学习的 10 门顶级课程,涵盖了人工智能基础、机器学习、深度学习、强化学习、自然语言处理(NLP)、计算机视觉(CV)、大语言模型(LLMs)及深度生成模型等核心领域,旨在帮助学习者掌握 AI 第一性原理。
本文档详细阐述了一款骨科手术导航与规划系统的开发目的、应用场景及技术栈。该系统旨在通过三维骨骼模型重建与实时导航,提高骨科手术精准度。项目采用C++、Python、C#多语言开发,涉及OpenCV、VTK、TensorFlow等技术,源代码量约40万至60万行,涵盖影像处理、AI识别及高性能可视化等核心功能。