Multimodal RAG with the Gemini API File Search Tool: A Developer Guide
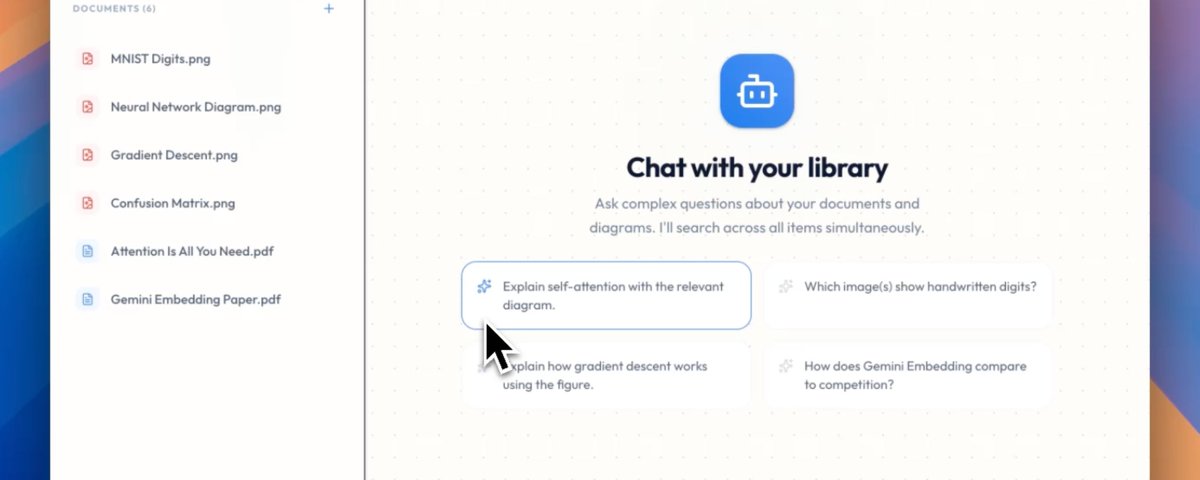
本文介绍了 Gemini API 中的 File Search 工具,该工具现已通过 Gemini Embedding 2 支持多模态检索。文章详细讲解了如何创建存储、上传图文文档、执行具备依据生成的查询以及检索引用和图像。File Search 提供了全托管的 RAG 解决方案,具备原生图像搜索、内置引用和成本效益高等优势。
本文介绍了 Gemini API 中的 File Search 工具,该工具现已通过 Gemini Embedding 2 支持多模态检索。文章详细讲解了如何创建存储、上传图文文档、执行具备依据生成的查询以及检索引用和图像。File Search 提供了全托管的 RAG 解决方案,具备原生图像搜索、内置引用和成本效益高等优势。
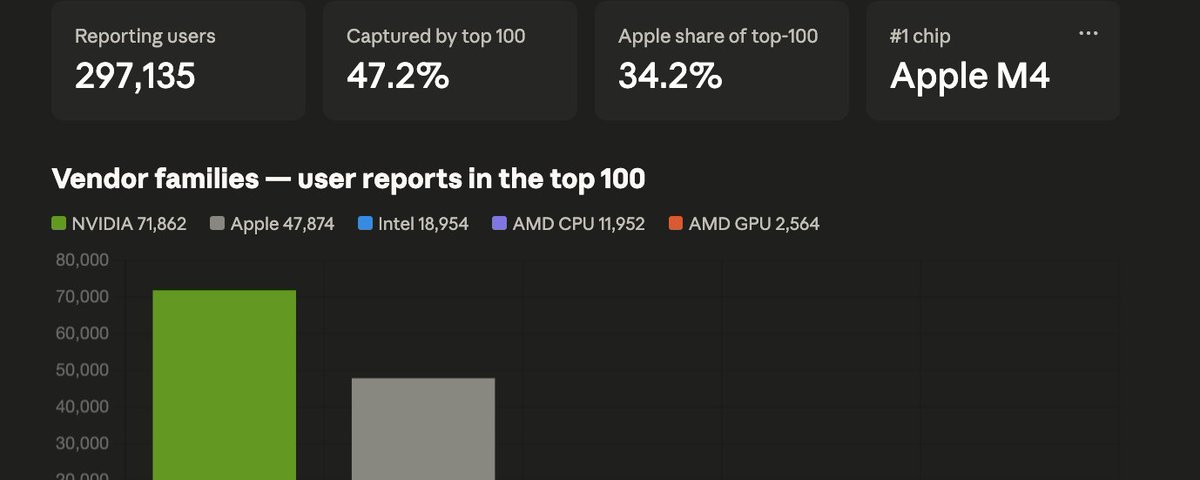
文章基于 Hugging Face 上近 30 万用户的硬件数据,分析了 AI 开发者的主流设备选择。关键发现包括:VRAM 容量比算力更重要(RTX 3060 12GB 最受欢迎);Apple 在 SoC 领域占主导,NVIDIA 统治独立显卡;AMD Ryzen 在 DIY 组装市场(尤其是 CPU+GPU 组合)超越 Intel;M4 芯片普及速度极快。数据揭示了本地 AI 硬件的高度碎片化特征。
本文由设计师 clear 分享了如何利用 AI (Vibe Coding) 在 4-6 小时内构建高质量初创公司落地页的完整工作流。文章详细介绍了技术栈的选择(Cursor、Claude Code、Tailwind CSS、Framer Motion 等),并重点强调了分步构建的策略:从结构搭建、设计系统应用到内容填充,再到最后的细节打磨和移动端适配。作者指出,具体的提示词、参照现实设计案例以及保持视觉一致性是区分“Vibe Code”成品与垃圾代码的关键。
文章指出 AI 时代下,明确的目标优于技术工程。作者介绍了 dbskill 的新功能 /dbs-goal,旨在通过三道关卡(可指物性、可否证性、真终点)将模糊的愿望审计为可执行、可检查的具体目标,从而提升 AI Agent 的执行效率。
针对近期 Claude 表现下降的问题,作者提供了 8 个修复技巧。文章首先强调了工具选择的重要性,区分了 Claude Chat、Cowork、Code 和 Projects 的使用场景。接着介绍了模型选择(如 Opus 用于深度推理)、设置系统提示词、优化提示语结构(先给背景再指定格式)、使用 XML 标签以及利用 Claude 内置工具等方法,旨在通过具体的操作指南帮助用户释放 Claude 的最大潜力。
Anchorage Digital 首席执行官 Nathan McCauley 宣布推出“代理银行”,这是一种专为 AI 系统设计的新型金融基础设施。随着 AI 从辅助决策转向自主执行,现有的金融体系缺乏为非人类 Actor 提供身份和策略执行层的能力。Agentic Banking 利用联邦银行牌照,为 AI 代理提供合规的资本访问、身份认证及结算服务,并宣布与 Google Cloud 合作,共同构建自动化的代理经济基础。
本文指出在2026年AI普及的背景下,单纯的内容创作已失去稀缺性。作者提出创作者应转变思维,不再售卖可被低成本复制的信息,而应转而售卖“判断力”、“陪伴”、“提问能力”、“身份认同”、“筛选”以及“动态更新”。文章强调,个人独特的认知框架和持续的迭代能力才是不可被抄袭的核心护城河。
文章介绍了 Fleet-RLM(基于 DSPy ReAct 智能体与 Daytona 沙箱)在 100 个长程推理任务中的表现。实验对比了递归执行与直接 LLM 推理,结果显示递归执行将准确率从 13% 提升至 33%,并完全消除了任务失败。文章详细分析了逻辑、CS、棋类、数学和化学等不同领域的性能差异,揭示了递归架构在工具调用和错误恢复上的优势。
文章指出,大多数公司无法有效利用 AI 的根本原因并非技术不成熟,而是企业缺乏清晰的目标和自我认知。AI 的核心在于“执行”,若无法明确战略、目标及工作流,AI 便毫无用武之地。只有那些能清晰描述自身业务、具备组织纪律的公司,才能被 AI 赋能并在未来竞争中生存,而混乱的企业将面临被“降维打击”的危险。
文章指出,大多数公司在采用 AI 时面临的核心阻碍并非技术不成熟,而是缺乏清晰的愿景、目标和自我认知。AI 无法执行未被明确定义的任务。成功利用 AI 的公司往往是那些已经清楚自己在做什么、如何运作以及面临何种挑战的企业。混乱且无法清晰描述自身业务流程的公司将被高效且认知清晰的小型公司取代。
本文深入探讨了 Moonshot AI 的开源模型 Kimi K2.6,强调其独特的“群体智能”架构,能协调 300 个子代理并行处理复杂任务。文章对比了 Kimi 与 Claude 的优劣,展示了 Kimi 在数据抓取、代码优化和网页生成方面的实战能力,并详细介绍了如何利用 Cloudflare Workers AI 和 Open Code 免费部署该模型。
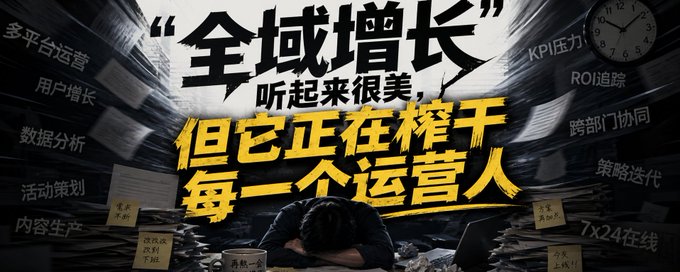
本文犀利地指出“全域增长”概念在中小团队中的陷阱。作者认为,盲目追求多平台运营会导致精力分散和资源浪费,反而降低整体效率。文章提出“最小全域模型”,建议运营人应找到核心渠道(即“一”),投入80%精力做到极致,而非在所有平台平庸存在。
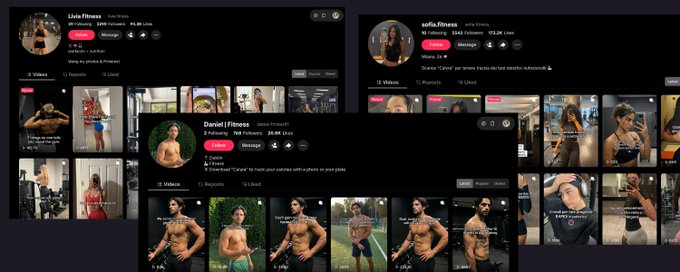
文章介绍了如何利用 NanoBanana 和 Arcads 等工具构建自动化的 AI 虚拟网红系统,实现高规模的内容制作与营销。作者强调应模仿网络热门内容的结构而非重新创造,并详细展示了如何使用 JSON 精准控制生成高质量、逼真的 AI 视频素材,以实现 TikTok 上的高转化率和规模化收益。
作者 Alex Vacca 分享了他从 Sam Altman 的 Worldcoin 辞职后,如何利用“服务即软件”模式自举创业的故事。文章详细介绍了在无案例、无背书的情况下如何通过风险逆转和公开内容构建信任获取首批客户,阐述了初期“只招募 A 类玩家”的用人原则,以及如何通过早期招聘序列构建高执行力团队,最终实现了 700 万美元的 ARR。
本文详细介绍了如何构建一个 $7M 规模的服务即软件(Services-as-Software)业务,阐述了由五个层级组成的运营系统。第一层是数据智能,利用 Clay 等工具建立分层客户清单;第二层是外联执行,通过 Instantly 等 ESP 管理邮件投递和信誉;第三层是编排层,使用 Claude Code 作为运行时连接 API 并执行具体工作;第四层是汇报与沟通;第五层是人员与知识。文章强调了数据分层、投递信誉基础设施以及利用 Claude Code 的技能文件夹来沉淀自动化流程的重要性。
文章针对当下企业盲目引入AI的现象,提出了“五维评估法”来辅助决策。这五个维度包括:问题复杂度(规则是否可解)、数据基础(数据是否优质可用)、业务影响(是否具备高ROI)、容错空间(业务能否承担AI错误)以及组织能力(团队是否能持续运营)。作者强调AI应解决业务痛点而非炫耀技术,并提供了具体的评估清单,旨在帮助企业避免资源浪费,实现AI的真正价值。
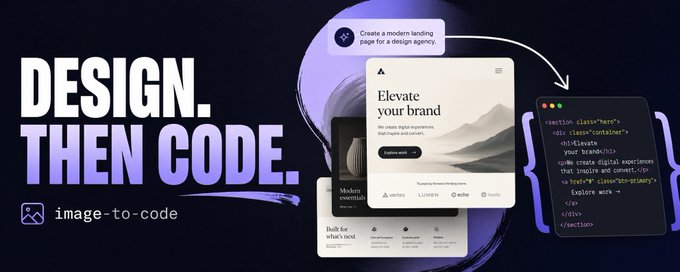
文章指出直接让 AI 生成前端代码往往平庸,提出了一种“图生码”的工作流。该方法主张先使用 ChatGPT Images 2.0 等工具分块生成高质量的设计图,确立视觉风格、布局和素材,再交由编码 Agent 逐段还原实现。作者详细阐述了如何通过精准的风格词汇、分区域生成及素材提取来提升网站品质,将设计决策与代码实现解耦,从而获得比直接提示编程更美观、更专业的界面效果。
本文作者Shalev分享了如何利用AI工具(Claude、ElevenLabs、HeyGen等)在5分钟内制作短视频,并通过运营7个AI角色实现月收入50万美元的成功经验。文章详细拆解了脚本创作、语音生成、角色设计及分发的完整流程,强调“系统”重于“工具”,并揭示了通过内容建立信任以销售数字产品的变现模式。
这是一本关于创业、内容创作与 AI 时代的“提问指南”。作者通过拆解 100 个常见的模糊问题(如“这个赛道还能不能做”、“AI 会不会替代我”),指出其背后的错误假设,并提供“大白话改写”和“真正该做的事”。文章主张用具体的交易结构取代抽象的赛道分析,用用户行动定义内容价值,并强调 AI 应服务于具体任务而非技术本身。
这是作者 leon7hao 在 Build 03 活动上的演讲稿,介绍了项目 Lody。Lody 是一个基于本地优先理念的多端开发工具,旨在解决开发者在多设备间无缝切换及并行开发的问题。它利用 CRDTs 技术实现数据同步与版本控制,不仅解决了 Code Agent 的隔离与协作难题,还支持异构 Multi-agent 工作流,目标是成为 AI Native 团队的上下文同步层,保障数据隐私与所有权。
文章探讨了在 AI 成本降低的背景下,个人如何通过“服务即软件”模式建立高利润企业。作者指出,通过 AI 自动化交付,一人可抵过去 30 人团队的产出,利润率可达 80%。文章详细区分了财富创造与放大,论证了该模式在利用现有现金流、低边际成本和低风险方面的优势。同时,针对冷开发获客的误区进行了澄清,并提供了从基础构建到规模化运营的 12 周实操路线图。
文章介绍了 Google Cloud 在 Next '26 大会上发布的 Agent Garden 及其包含的 12 个核心 Agent 蓝图。这些生产就绪的模板旨在解决多 Agent 系统的设计、编排和评估难题。文章详细剖析了 SDLC Suite(软件生命周期管理)、On-Brand GenMedia(品牌媒体生成)和 Invoice Processing(发票处理)三个核心架构,展示了如何利用链式架构、自适应学习框架和 LLM 评估机制来解决企业实际痛点,帮助开发人员快速落地 AI 应用。
文章介绍了 Google Cloud Agent Development Kit (ADK) 2.0 中的五种多智能体编排模式,旨在解决生产环境中智能体协作的难题。核心模式包括:混合图模式,结合确定性与 AI 驱动节点;协调者-专家模式,拆分单一“上帝智能体”为专注的专家系统;技能组合模式,通过 SkillToolset 实现跨域复用;跨语言流水线,支持多语言协作;以及协议标准化,确保上下文在不同智能体间无损传递。
文章介绍了一种名为“买还是跳”的 Claude 技能,旨在通过模拟 5 种不同的买家角色(如冲动型、怀疑型、价格敏感型等)来逐段审查销售文案、落地页或广告。该工具能精准定位用户流失环节,提供具体的修改建议,从而帮助创作者发现自身的盲点,提升转化率和销售额。
文章探讨了如何利用 A2A(Agent-to-Agent)和 MCP(Model Context Protocol)协议构建企业级多智能体系统。作者详细介绍了五种集成模式:Agent Card 发现机制、委派专业化模式、工具桥接模式(通过 MCP 连接数据源)、跨组织联邦模式以及环境事件网格。这些模式旨在实现智能体之间的互操作性、独立演化以及安全的数据访问,从而打破语言、团队和组织的界限。
文章深入对比了2026年OpenAI与DeepSeek的发展路径。OpenAI采取高定价、重商业的精装商品房模式;而DeepSeek则坚持开源低价,依托中国电力基建和昇腾芯片,将AI变成水电煤般的免费基础设施。DeepSeek通过转型重资产、引入巨额融资以对抗人才流失,并推行端侧AI与开源生态,在乌干达等全球南方地区实现数字平权,打破了硅谷的算力垄断。
文章基于一场关于AI商业化的深度对话,揭示了AI在企业级落地中面临的真实困境:包括基层员工的抵触心理、高昂的数据合规与本地部署成本,以及对国外模型的供应链依赖风险。对话指出,服务大客户往往“有名无利”,而务实的个人变现(如AI代写、网文生成)和多模型编排才是当下的生存之道。此外,文章探讨了Agent记忆缺失这一核心痛点,并强调了AI时代个人判断力与出海内容的机会。
文章探讨了在构建需要持续运行数天甚至数周的 AI Agent 时所面临的挑战,并介绍了 Google Cloud Agent Runtime 支持的五种核心设计模式。这些模式包括:检查点与恢复以确保容错性、委托审批以实现人机协同、分层记忆架构以管理长期上下文、环境处理以应对无监督任务,以及针对多 Agent 协同的舰队编排。文章强调了状态管理、治理策略和基础设施在将 Agent 从演示转化为生产级系统中的重要性。
文章分析了 5 家顶尖 YC 孵化公司(如 Resend, Deel 等)的着陆页设计,发现其结构惊人一致。核心模式包括:一行式标题配产品截图、首屏展示社会认同、单一的重复性 CTA、展示创始人照片以建立信任、公开透明的定价信息、精选 3-6 个核心功能,以及以行动号召结尾。这种结构符合用户“是什么-谁在用-怎么用-多少钱”的决策心理,能有效提升转化率。
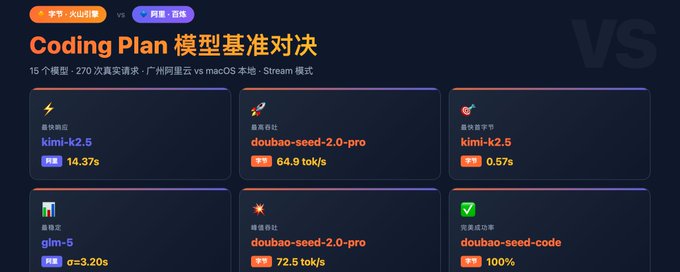
本文对比了字节火山方舟与阿里百炼两大平台的 Coding Plan API 服务性能。通过 270 次请求测试,从响应速度、吞吐量(TTS)和稳定性三个维度,对包括 GLM、Kimi、DeepSeek 等主力模型进行了评估。结果显示,对于相同的旧版本模型,阿里百炼在速度上完胜;而字节方舟在模型更新速度(如 k2.6)和覆盖广度上更具优势。