从孩子学习中英德韩西五门语言的经历观察到的语言习得现象
作者基于孩子学习中英德韩西五门语言的经历,指出背单词只在小词库初期有效,高阶语言能力依赖语境中的可理解输入(i+1),语言是连续的概率分布而非离散符号映射。文章强调AI TTS配音因缺乏情绪与重音理解,不适合作为有声书标准音源,建议使用真人朗读并让AI做辅助工作。同时区分了母语未固化阶段(低龄儿童可通过动画直接建立音画映射)与母语固化阶段(成人需大量可理解输入)的不同学习方法,并鼓励成人学英语三十岁不晚。
作者基于孩子学习中英德韩西五门语言的经历,指出背单词只在小词库初期有效,高阶语言能力依赖语境中的可理解输入(i+1),语言是连续的概率分布而非离散符号映射。文章强调AI TTS配音因缺乏情绪与重音理解,不适合作为有声书标准音源,建议使用真人朗读并让AI做辅助工作。同时区分了母语未固化阶段(低龄儿童可通过动画直接建立音画映射)与母语固化阶段(成人需大量可理解输入)的不同学习方法,并鼓励成人学英语三十岁不晚。
文章系统梳理了 2026 年主流开源 TTS 方案:CosyVoice 2 低延迟流式,适合实时语音 Agent 与数字人;GPT-SoVITS 擅长小样本音色微调与克隆;ChatTTS 拟人口语自然,适合 AI 播客;F5-TTS 与 Breeze-TTS 2 基于流匹配免对齐克隆,稳定性好;Fish Audio Drama 3 情绪表现力全面但算力要求高;MaskGCT 鲁棒性强,可处理气声耳语等极端发音;KittenTTS 2 体积极小,可在 CPU 端侧运行。各方案定位不同,读者可按延迟、音色、表现力与资源需求选型。
作者实测蚂蚁灵波开源的 Ming-3.0-TTS 模型的三种核心能力:Voice Design(用文字描述创造原创音色)、Freeform(导演式指令控制重音、停顿和情绪)以及声音克隆(支持在正文中插入叹气、咳嗽、呼吸等声音事件标签)。文章详细介绍了从 Hugging Face 在线体验到本地部署的完整流程,包括参考音频准备、音色描述写作模板、命令行操作等,并提出判断 TTS 能否进入 AI 视频工作流的五项标准,如音色身份稳定性、重音停顿准确性、声音事件自然度等。
文章介绍了开源项目 VoiceStudio(作者 debpalash),一个纯 Python、AGPL-3.0 协议的本地配音工具,定位为「开源、全程本地的 ElevenLabs 平替」。它支持声音克隆、声音设计、带时间轴对齐的视频配音、语音转写、有声书和批量任务,只需几十秒参考录音即可抽音色,官方支持六百多种语言。项目半年内获得约 6.7 万 Star,桌面端基于 Electron,数据全部留在本地不上传云端,兼容 NVIDIA CUDA 和苹果 Metal,并提供 Local API 和 MCP 供 Claude Code、Codex 等 Agent 调用。文章同时提醒性能受硬件限制、授权需分别确认,以及克隆声音必须取得对方授权。
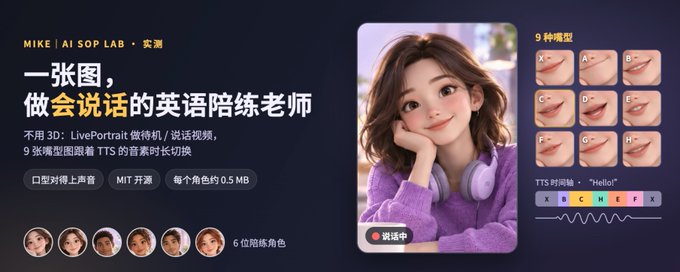
本文介绍了一种轻量级数字人口型同步方案:作者为英语陪练 App 制作了 6 个虚拟老师,每个角色仅需一张图片加约 0.5MB 素材,无需 GPU。核心是利用 Kokoro TTS 合成语音时天然携带的音素时长信息,将 44 个英语音素按视觉相似度合并为 9 种嘴型(viseme),生成时间轴通过响应头传递给前端。文章详细讲解了音素与视位的映射、音量修正停顿、LivePortrait 生成待机视频和嘴型图、以及 canvas 统一渲染等技术细节,实测嘴型偏差中位数约 0.1 秒,60 帧不掉帧。
作者为搭建视频配音工作流,测评并整理了 10 个开源 TTS 项目,按用途分为四组:中文配音带情绪(IndexTTS、VoxCPM、Qwen3-TTS、CosyVoice)、声音克隆与个性化(GPT-SoVITS、Chatterbox)、多人对话与播客(Fish Speech、SoulX-Podcast)、轻量实时(Kokoro、VibeVoice-Realtime)。文章为每个工具提供官方安装命令、可直接复制给 Agent 的提示词、显存配置要求、许可证说明及踩坑经验,强调选型应先看用途和显卡配置,再看 GitHub 星数。
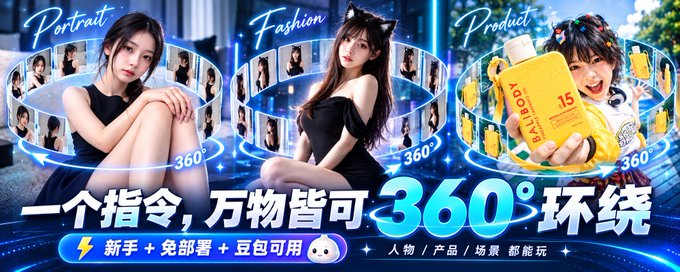
文章介绍了一种简单易上手的AI视频玩法:上传一张图片加一条指令,即可生成360°环绕(Bullet Time)效果的视频。作者展示了旅游、美食、美妆、商业摄影、产品展示、服装穿搭等多个应用场景及商业潜力。实现方法分为两种:一是免部署的Web端方案,使用豆包等可生成视频的模型,配合文中提供的通用短指令和完整10秒详细指令;二是适合进阶用户的ComfyUI本地部署方案,通过加载MiniMax H3 I2V模板和360° Orbit LoRA实现。作者以设计师视角分享了最低门槛、可复用的AI玩法。
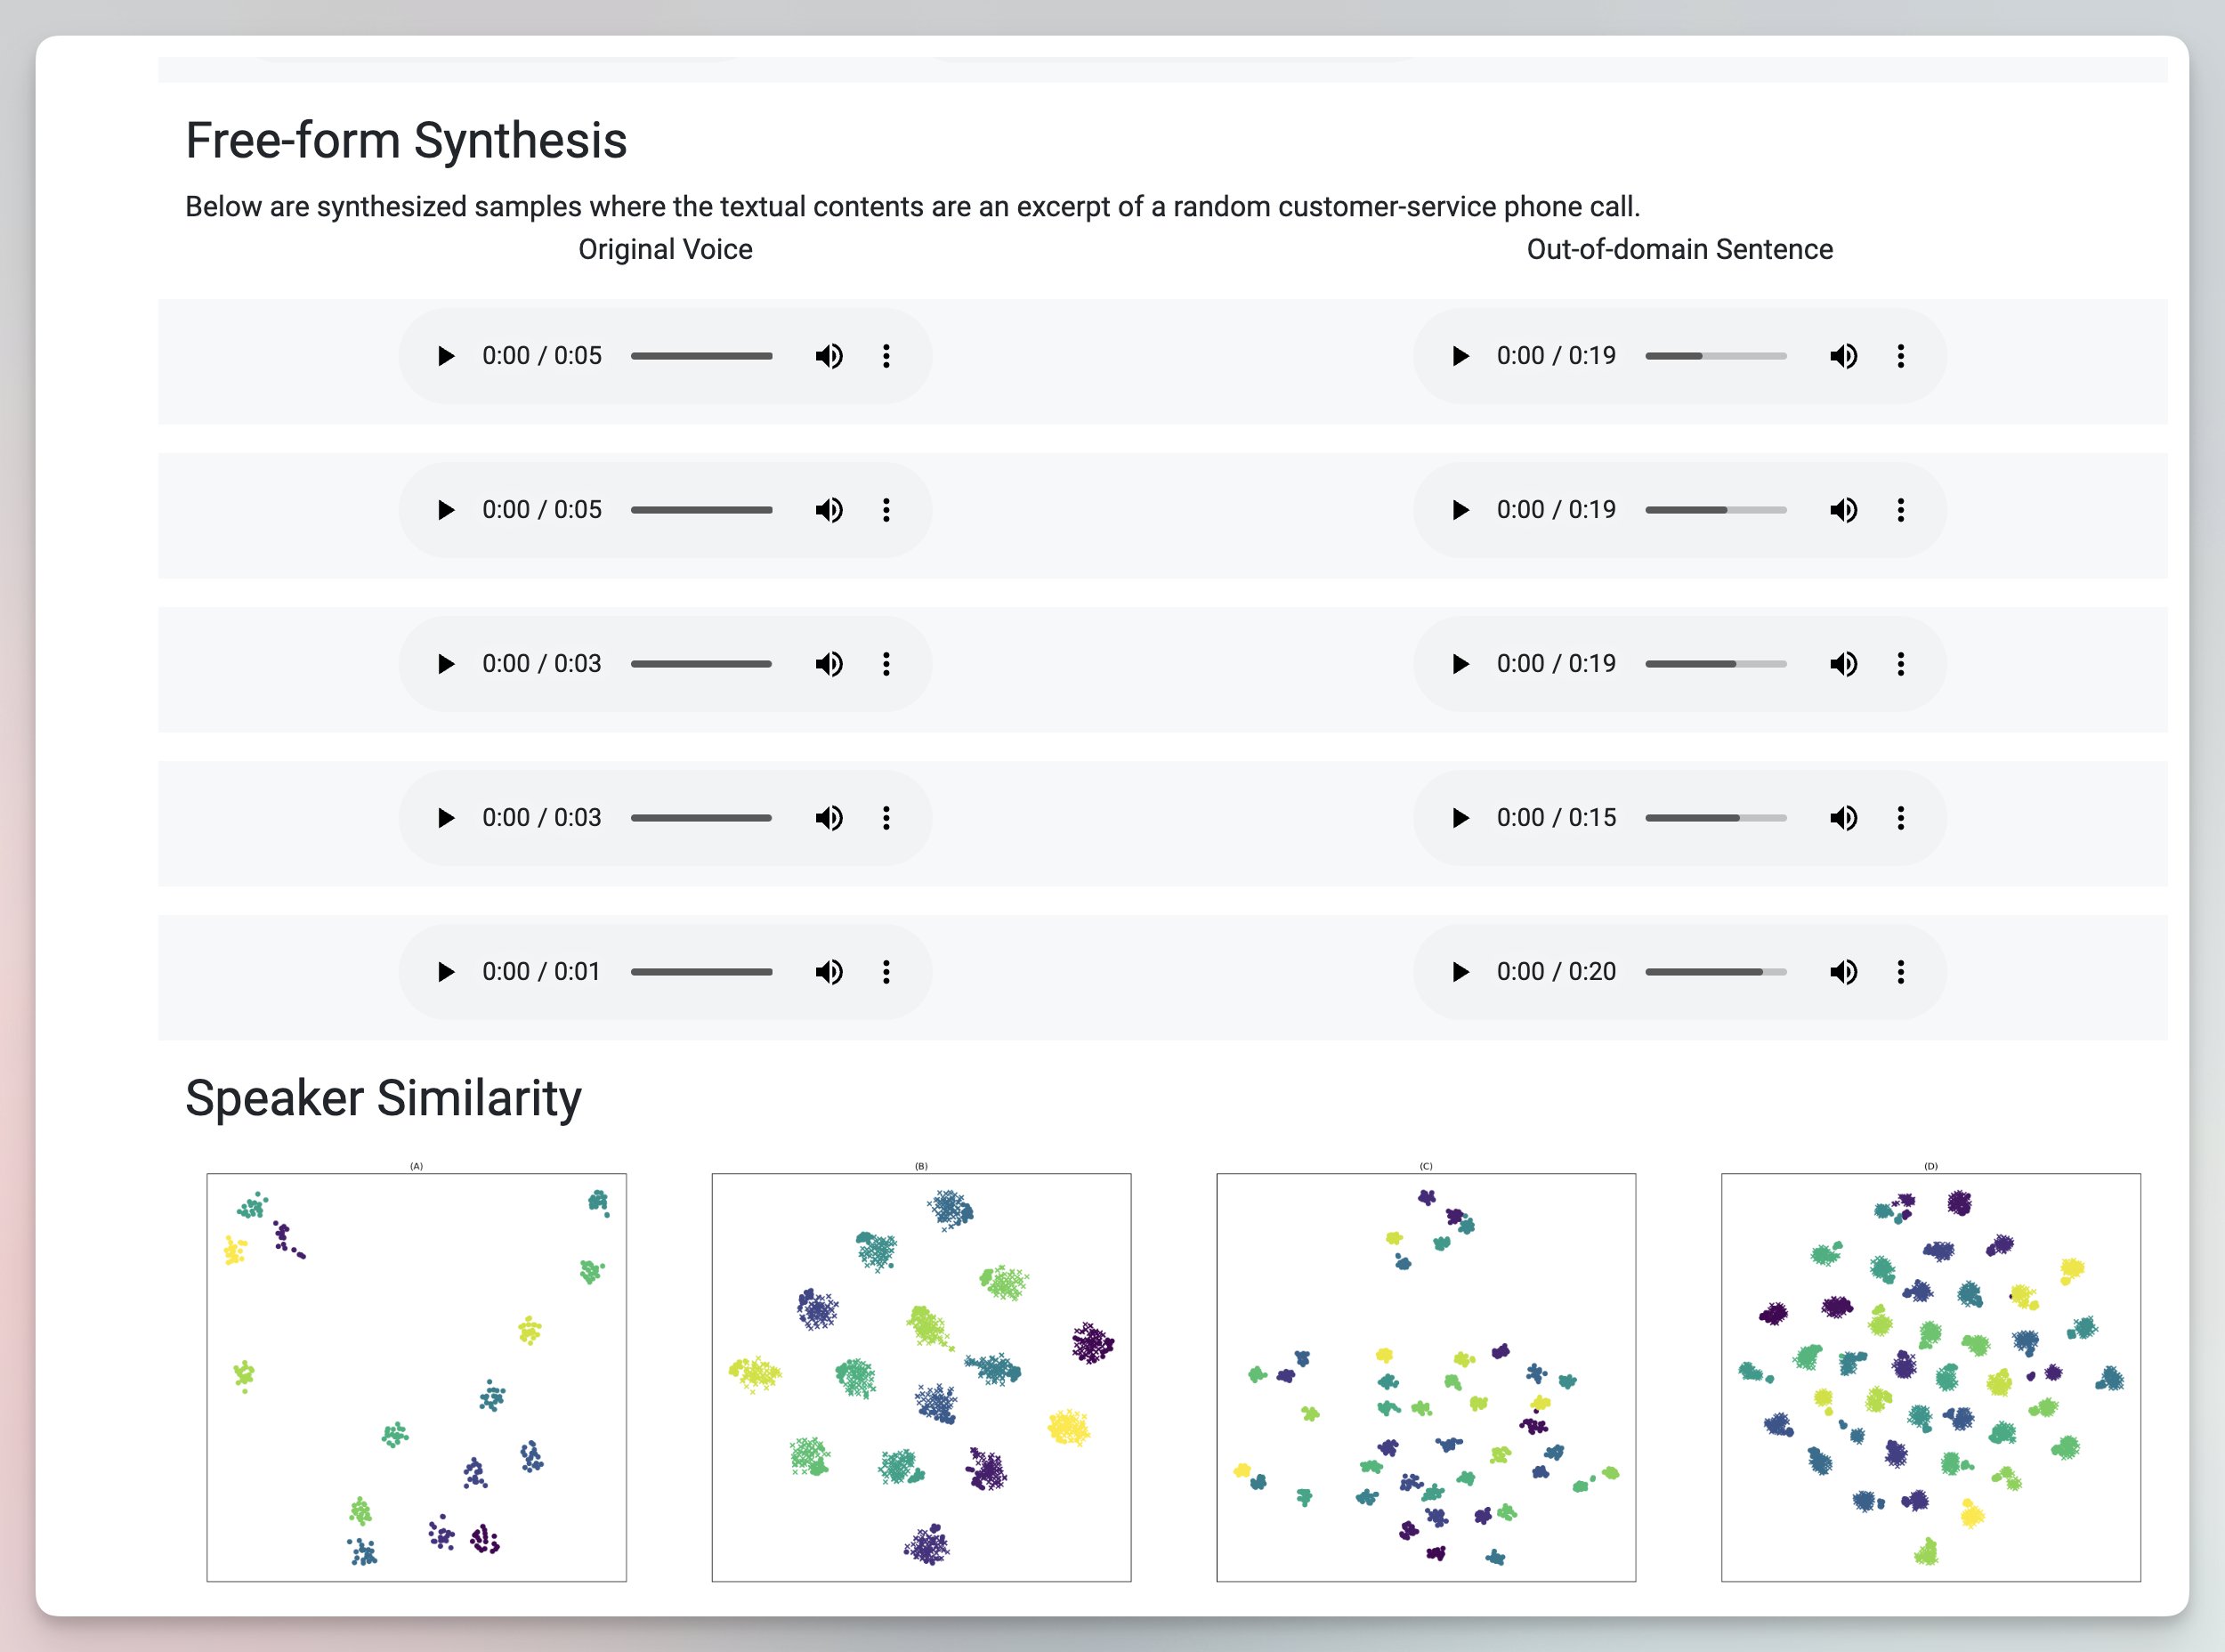
作者发现一个中文语音数据集,包含218人的8万多条语音,情感中性,并带有性别、年龄、母语口音等标注,字音准确率达98%以上,经过专业标注和严格质检。开源TTS模型如F5、Spark、IndexTTS2都需要参考语音,自己录制麻烦,该数据集可以省去这一步。作者是在为Qiaomu Reader开发电子书朗读功能时发现的。文中附有数据集官网地址和语音样例链接。
Cactus Compute 发布了 16.9 MB 的本地语音识别模型 Whistle,纯 CPU 运行、无依赖,与同公司的 Needle 模型共享引擎。作者实测发现:七种欧洲语言(英德法西意荷波)识别准确度高,首 token 仅 5-8 毫秒,解码速度约 1300 token/秒,官方性能数据基本可信。但关键缺陷在于:遇到不支持的语言(如中文、日文)时,模型不会报错也不会返回空,而是硬套进已知语种生成'假词',造成静默污染。文章指出该模型设计目标是端上语音自动化入口而非单纯转写,并提醒中文用户慎用。
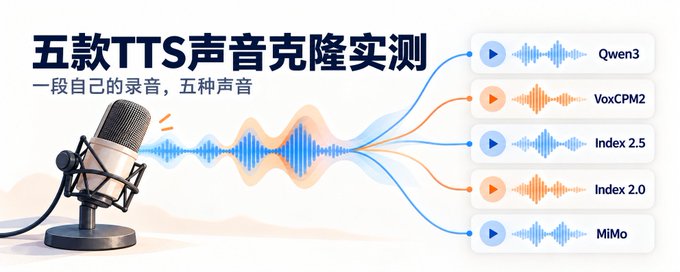
作者用24秒自己的录音实测了Qwen3、VoxCPM2、Index 2.5、Index 2.0和小米MiMo五款TTS工具的语音克隆效果。每款读取相同两篇文案,从音色相似度、语气控制、生成耗时等维度对比。结果显示VoxCPM2和Index 2.0效果最好,是本地方案的首选;Qwen3可用但调节空间有限;小米MiMo通过API云端生成,适合不想本地部署的用户。文章还详细介绍了各工具的界面功能和在RTX 4070 Ti SUPER上的实际等待时间。
本文是一篇详细的接入教程,介绍如何在 Muse 中接入 Fish Audio TTS 服务。作者 TaoBuilds 对比了 Azure(稳定但音色固定)与 Fish Audio(支持声音克隆和特色音色)的差异,并给出六步接入流程:注册 Fish Audio 账号、切换到 Developer 模式、确认每月 8000 点的免费额度、创建 API Key、在 Muse 中关联 Key、编写调用脚本并实测出声,全程约 5 分钟。接通后日常语音仍走免费的 Azure,特色音色和声音克隆则用 Fish Audio 完成。文末提醒注意免费额度用量、不要克隆真人声音公开发布,以及 Key 泄露时的处理方法。
本文详细介绍了火山引擎豆包语音合成模型 2.0 的免费 API 申请与接入流程。作者一步步讲解了注册火山引擎控制台、开通语音合成 2.0 服务领取免费额度、创建 API Key 的方法,并说明音色 ID 与资源 ID 必须配对的规则。文章以 whiteboard-video Skill 为例演示了配置方法,并用 PowerShell 测试接口调用。同时整理了踩坑记录,包括 403 权限错误(需重建 Key)、音色与资源 ID 不配对、Key 泄露处理、Windows 手动安装 FFmpeg 等常见问题,最后提示通过用量统计合理节省免费额度。
文章介绍如何用Higgsfield AI Influencer等工具在10分钟内创建可辨识度高的AI虚拟网红角色并实现变现。核心方法包括:设计具有夸张发型、独特面部特征、复古穿搭和面无表情风格的难忘角色;借用已经验证过的爆款视频格式替换人物;以及创建角色参考图保证多视频中形象一致。作者提供了可直接复制使用的Claude/ChatGPT角色设计提示词、图像生成与编辑提示词,并强调角色要有趣不冒犯、100%原创。完整工作流覆盖从角色设计、图像生成到视频制作的全过程。
文章介绍了 Seed Audio 1.0 影视级配音模型的强大能力。相比传统 TTS,它情绪维度广、精度细,支持动态情绪匹配;无需音色克隆,上传约 15 秒参考音频即可复刻音色;可指定输出时长、语速及停顿,方便后期对轨;支持 20 种语言并适配出海需求,还能演绎人物状态、通过提示词设计音效和配乐。作者建议包含角色介绍与台词分配以提升声音丰富度,但不建议配音中加入音效。应用场景包括广告、短视频、有声小说、漫剧、ASMR 和带货等。
作者第一时间实测了 ElevenLabs v4 语音模型。该模型被官方称为“最有感情”的一代,能读懂语气、节奏和情绪,无需 SSML 即可通过文案直接指挥表演;即时语音克隆仅需10秒音频,专业克隆保真度更高。v4 支持90+种语言(上代70种),中日文提升最大,长篇创作中说话者身份保留更可靠。Turbo 版延迟压至100ms,适合实时语音智能体。API 定价千字 $0.08,10月12日前有促销。作者认为质感起飞,适合短剧、播客、AI配音场景,但中文音色仍偏少,评论区对中文效果评价不一。
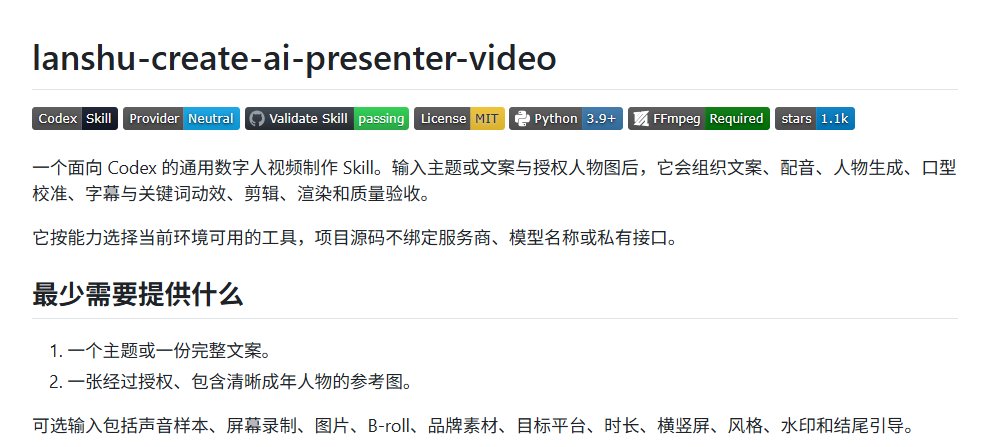
作者分享了一个 GitHub 上两天获得两万多星的开源项目 lanshu-create-ai-presenter-video。该项目只需输入一段文案和一张人脸照片,即可在本地全自动完成 TTS 语音生成、口型对齐、字幕压制、竖屏封面生成及质检,直接输出 1080P 竖屏成片,口型匹配度高,几乎无需手动修改。全程本地运行,避免了网页版工具排队和按分钟收费的限制,适合批量短视频内容创作者使用。
文章展示了使用 Seedance 2.5 视频生成模型创建咖啡品牌商业视频的案例。作者提供了一个详细的英文提示词,描述了从研磨咖啡豆、浓缩咖啡萃取、拉花,到多样生活方式场景(咖啡馆办公、街头滑板、户外早餐、欧式城市漫步)的完整画面。视频呈现暖色调、现代都市美学和高质感商业广告风格,展示了 AI 视频生成在品牌营销内容创作中的应用潜力。
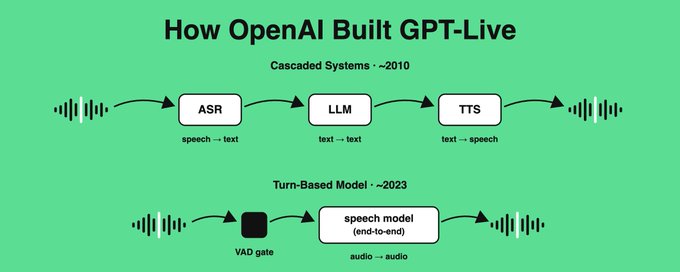
本文深入解析了 OpenAI GPT-Live-1 全双工语音模型的架构原理。文章回顾了语音系统的三代演进:级联设计(ASR+LLM+TTS 串联,存在信息丢失和延迟叠加问题)、轮次式端到端语音模型(保留语气情感但依赖 turn detector,容易不自然)、以及全双工架构(模型同时监听和说话,沉默也是一种 token)。GPT-Live 通过将思考从说话中委托出去,保持语音模型小而快以实现毫秒级响应,同时依赖服务端系统的低延迟优化。文章还讨论了全双工系统的评估方法与实时系统工程经验。
本文汇总了近 30 天(8/16-9/15)语音 agent 领域的重大进展。核心变化包括:OpenAI 推出全双工语音模型 GPT-Live-1 进 API,替代传统 STT-LLM-TTS 三段拼接架构;一波新模型与产品密集发布(Tavus、Soniox、HeyGen、ElevenLabs 等);评测开始'打假',Jarvis Bench 把真人放进排行榜检验模型真实能力;Natera 公司首次公开生产环境语音 agent 的详实数据(成本、延迟、NPS 等);语音正从'对话层'演变为'编排层',成为调度多个 agent 的入口;开源与本地方案(Voicebox 等)蓬勃发展。
本文介绍 Google 最新的语音转文本模型 Gemini 3.5 Transcribe,重点讲解其实时流式端点 gemini-3.5-transcribe-live 如何通过 WebSocket 以亚秒级延迟实现低延迟语音交互。作者以实时辩论代理为例,展示如何结合 Agent Development Kit (ADK) 构建多智能体流水线:在用户仍在说话时流式获取中间转录结果,经 Gemini 3.7 Flash 做意图过滤,后台并行触发 Google Search grounding 检索证据,最后通过 Cloud Text-to-Speech 生成自然语音回复。该模式支持 85+ 语言,适用于会议实时查证、呼叫中心坐席辅助、交互式语音机器人、直播字幕等场景,消除了传统语音应用的等待延迟。
作者对比了Typeless、闪电说、豆包输入法和网易新推出的叭哥说四款AI语音输入法。叭哥说采用双模型架构(ASR语音识别+纠错润色),实现E2E平均1683ms的极速识别,支持小声拾音、专业术语识别、个人词典导入、多语言翻译和粤语识别等功能。文章通过小声嘀咕、长Prompt输入、翻译等多个场景实测,认为叭哥说基本补齐了竞品的短板,并展望语音输入让人机交互回归自然口语表达的未来。
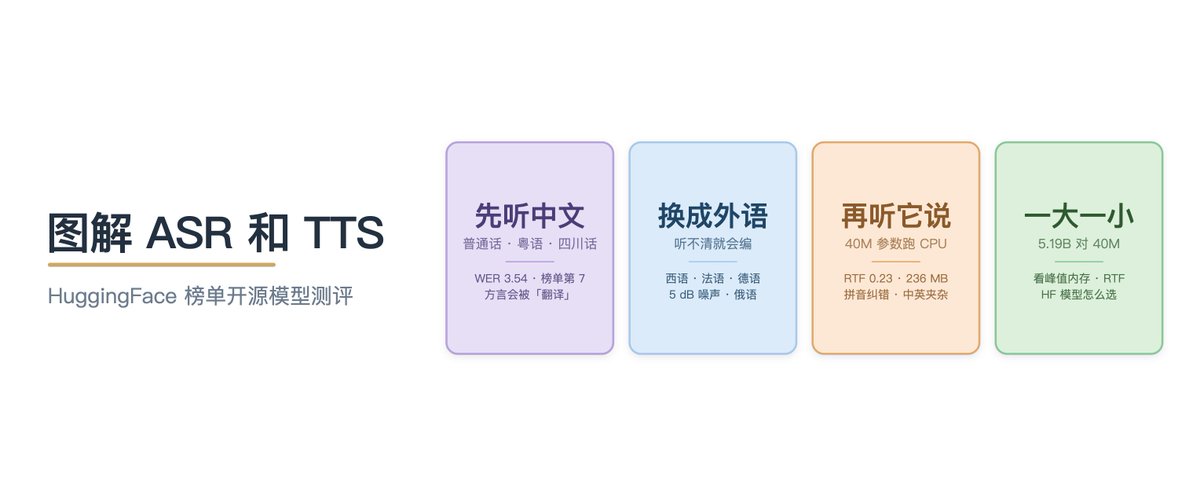
作者实测了 HuggingFace 上多语种榜单第一、可本地部署的开源语音模型 Hojo-ASR-Multi-V1 和 Hojo-TTS-Light-40M。通过普通话、粤语、四川话及多国外语的实际听写测试,发现该 ASR 模型在普通话和粤语表现出色,但在方言虚词、专名和噪声场景下会出错;TTS 小模型在 CPU 上即可快速合成中英夹杂语音。文章还分析了模型体量、内存和 RTF 的关系,并给出不同场景下 ASR/TTS 开源模型的选型建议。
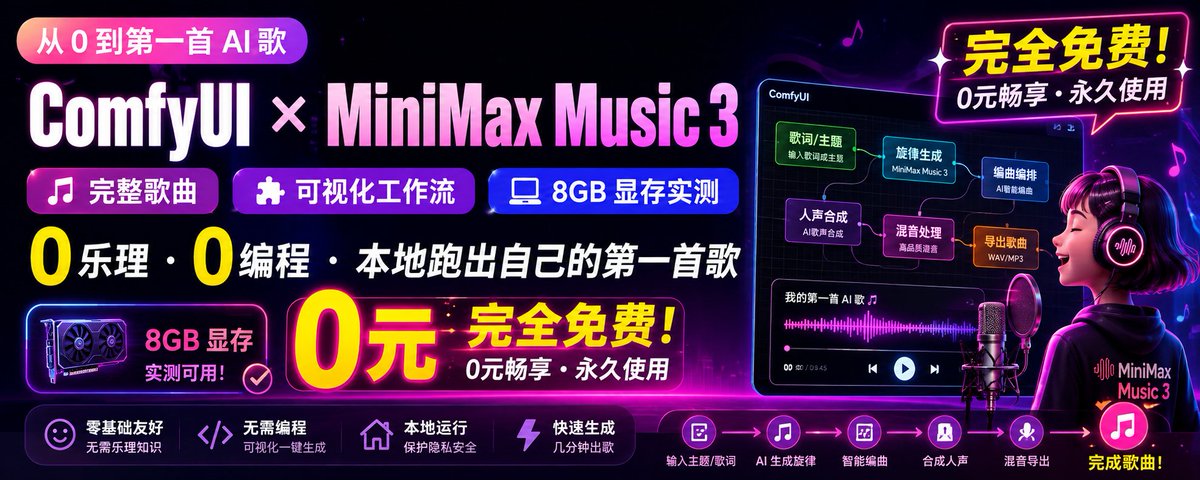
本文是一篇面向零基础用户的 AI 音乐生成实战教程,讲解如何使用 ComfyUI 和开源模型 MiniMax Music 3,在本地电脑上生成最长 5 分钟的完整歌曲(含前奏、主歌、副歌、尾奏)。文章介绍了 ComfyUI 的节点式工作流概念、Comfy Desktop 安装方法、模型三件套下载配置,重点讲解了如何撰写结构化音乐描述和带段落标签的歌词,并附带可直接复制粘贴的中文抒情流行歌曲模板。教程在 RTX 4070 Laptop 8GB 显存环境实测通过,针对低显存给出了 int8 量化模型等优化建议。
Fish Audio 通过重构 S2.1 Pro 语音模型的服务栈,将 GPU 利用率从约 50% 提升至 90% 以上,使原本需要四块 H200 的请求量现在一块即可承载。核心技术包括:针对 TTS decode 小矩阵形状定制的 FP8 CUDA 内核(比 torch.compile-fused cuBLAS 快 2.1–4.3 倍)、Continuous Batching(并发 1 到 64 吞吐量提升约 52 倍,仅增加 37ms 延迟)、Kubernetes 与 Slurm 弹性调度填充空闲算力,以及自建网络与存储基础设施。所有推理变更均需通过正确性与性能双重门槛。这些优化带来的单位经济效益使 Fish Audio 能够将完整的 S2.1 Pro 模型免费开放,并开源了 fish-scales-ops 内核库。
作者榴莲分享了一套以约1元API成本生成2分钟手绘白板/黑板视频的完整自动化流程。流程分为8步:建立系列与项目、编写脚本并拆幕、TTS生成旁白与词级时间、每幕生成一张完整板图、检查安全区与分区、笔迹追踪与渲染、描线填色清场、最终字幕合成。文章对比了六种笔迹实现方案的优劣,采用模型生图+本地渲染的混合方案,可自由切换主题和IP,显著降低重复制作成本。
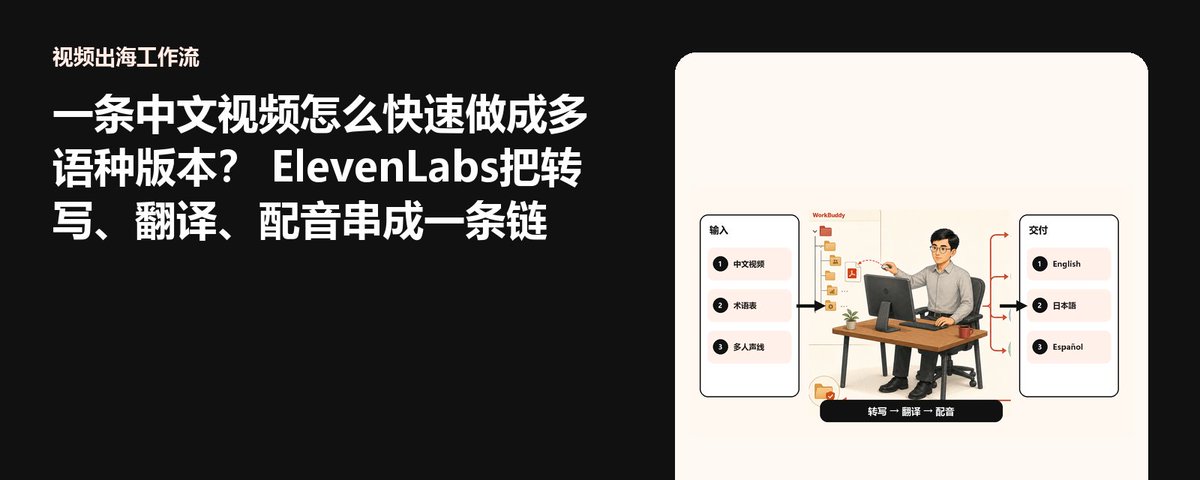
本文介绍如何使用ElevenLabs的Dubbing工具将中文视频快速制作成多语种版本。Dubbing v2支持90多种语言翻译,可保留说话人音色、情绪与背景音。文章详细讲解源视频准备、术语表建立、上传导出流程、转写翻译配音的校对顺序,以及成片验收的五个检查点(信息准确、声音节奏、混音同步等)。建议先用短样片测试,再逐语言扩展,人工负责专有名词与事实核对,适合课程、产品演示和访谈类内容出海。
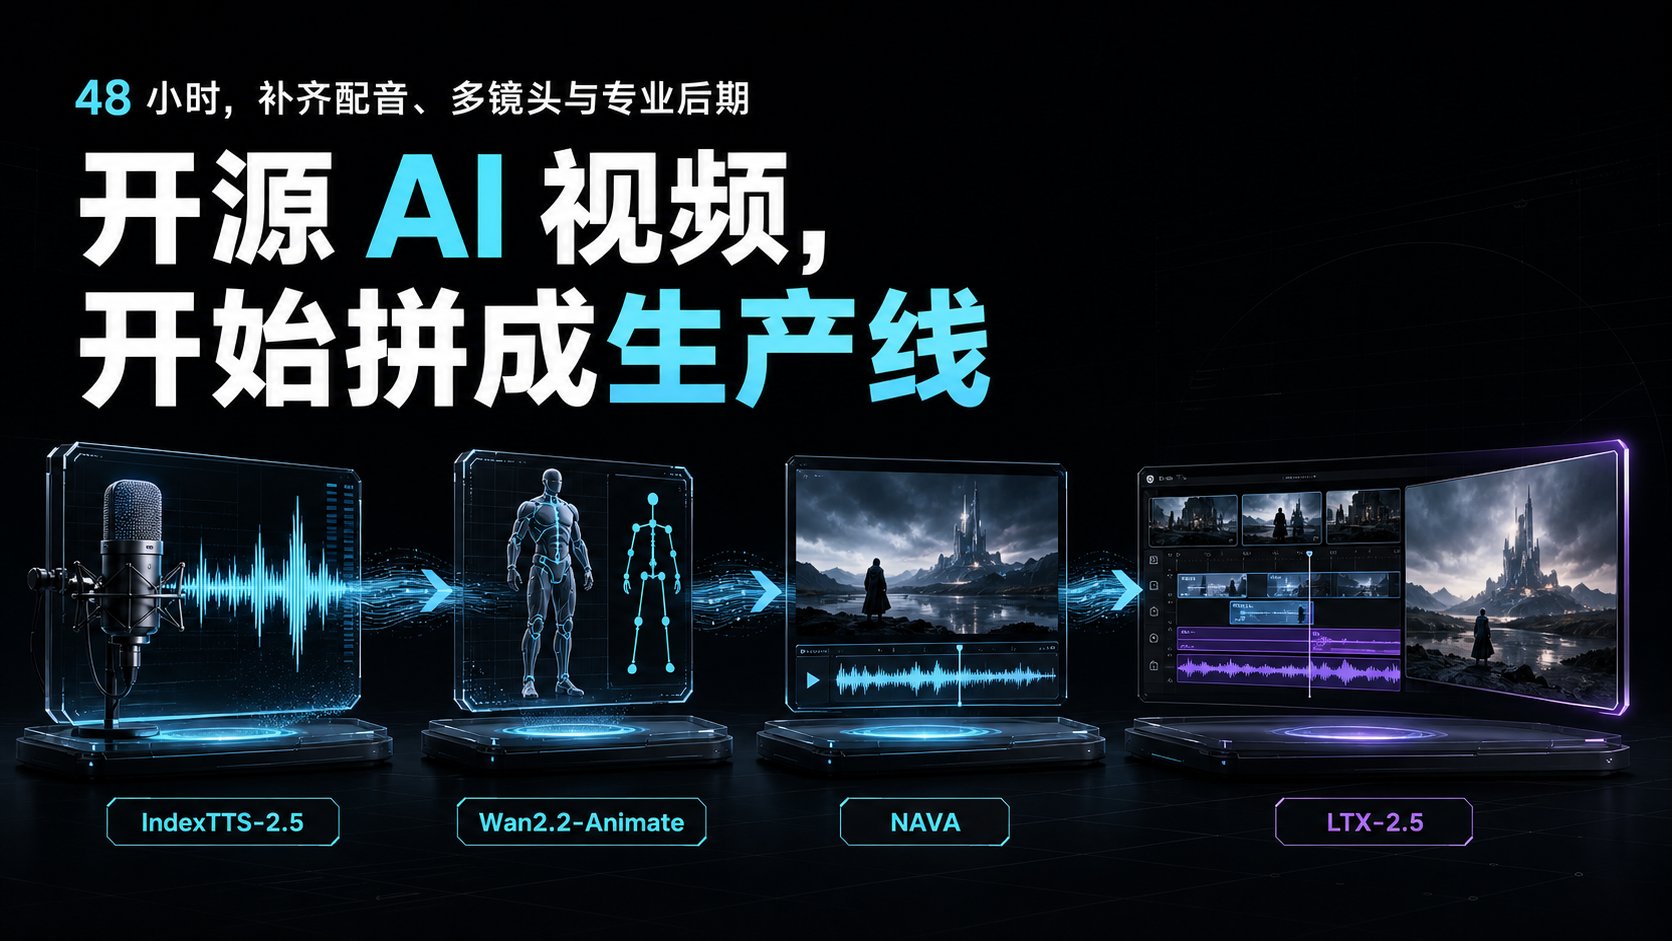
文章介绍了近期开源AI视频和音频工具的密集发布,包括MiniMax H3、IndexTTS-2.5、LTX-2.5、Wan-Animate-2和NAVA等。这些工具覆盖了配音、角色驱动、多镜头和后期制作等环节,标志着开源AI视频从生成短片段向完整生产流水线转变。作者强调了各工具的特点,如IndexTTS-2.5的音色克隆和情绪控制,LTX-2.5的原生多镜头支持,以及NAVA的同步音画能力,并表达了对开源社区活跃度的欣喜。
本文介绍了如何在 HeyGen 中创建高质量的数字分身。只需 15 秒的高质量视频素材,即可生成一个外貌、动作和声音都像你的虚拟形象。文章详细说明了录制前的设备设置、光线要求,以及在录制过程中需要注意的三个关键点:直视镜头、自然手势和保持静止。此外,还分享了利用停顿技巧来增强 Avatar 自然度的小窍门。
本文分享了作者在制作AI视频过程中,从使用MiniMax云端API转向本地部署IndexTTS2的实践经验。作者详细对比了两者在中英混排发音、音频格式、离线能力、声线一致性及成本等方面的优缺点,最终选择了IndexTTS2以保障视频工作流的可控性与稳定性。
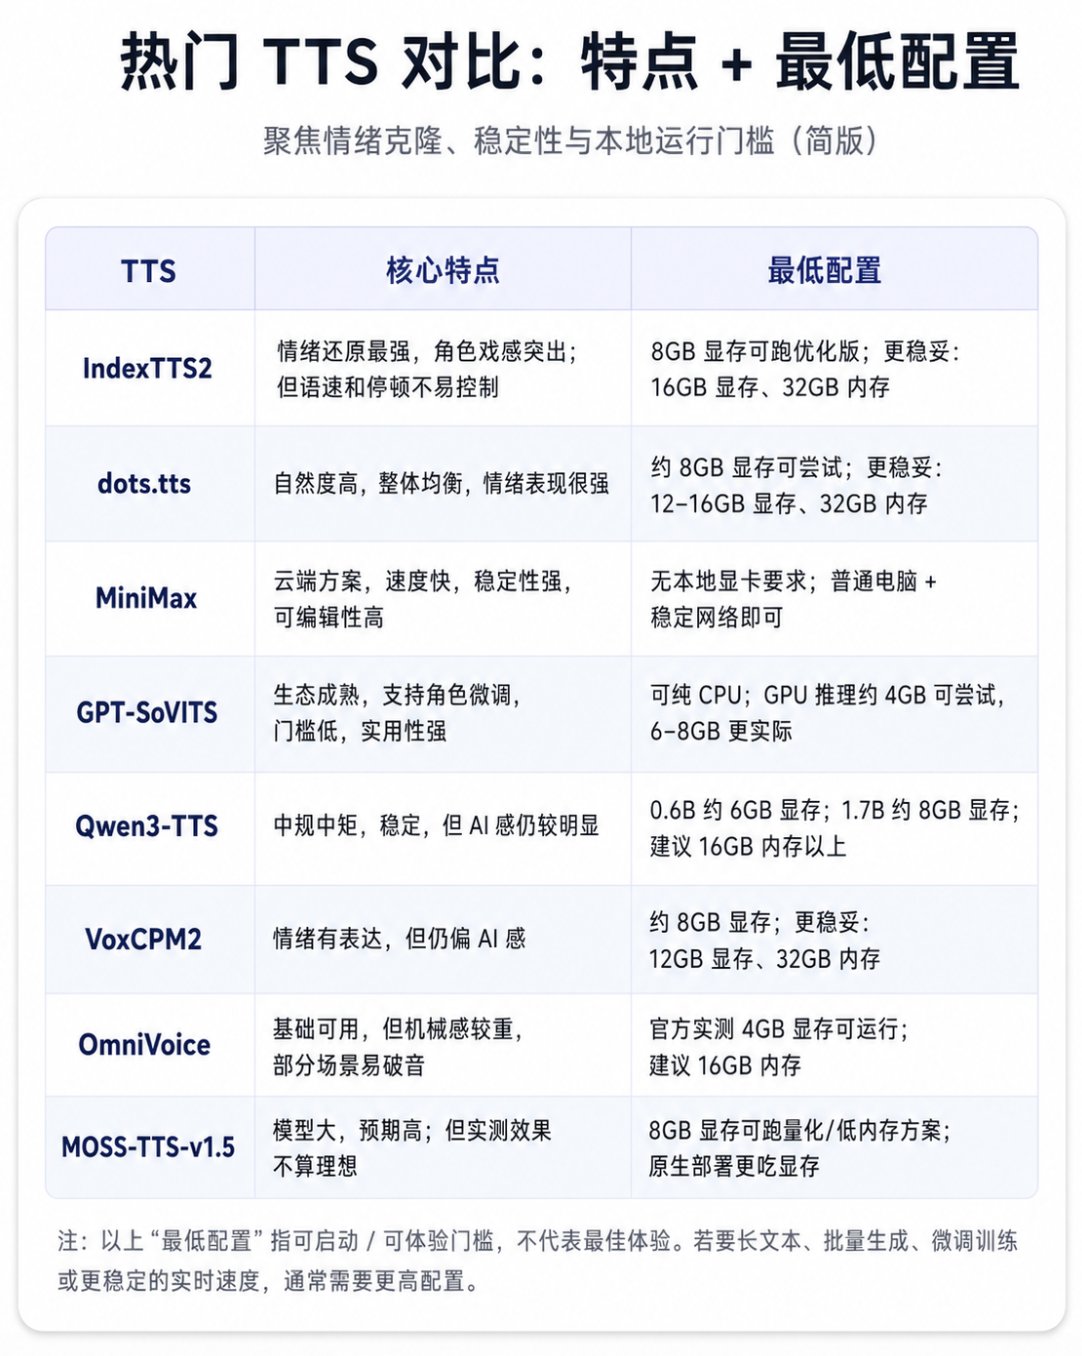
文章评测了多款热门 TTS 工具:IndexTTS2 擅长情绪克隆,dots.tts 表现均衡,MiniMax 省心且速度快,GPT-SoVITS 最实用且门槛低。同时指出了 Qwen3-TTS 等工具的不足,并提供了本地部署的硬件建议。