突破OPD天花板:MAD-OPD让小模型通过多教师辩论反超大模型
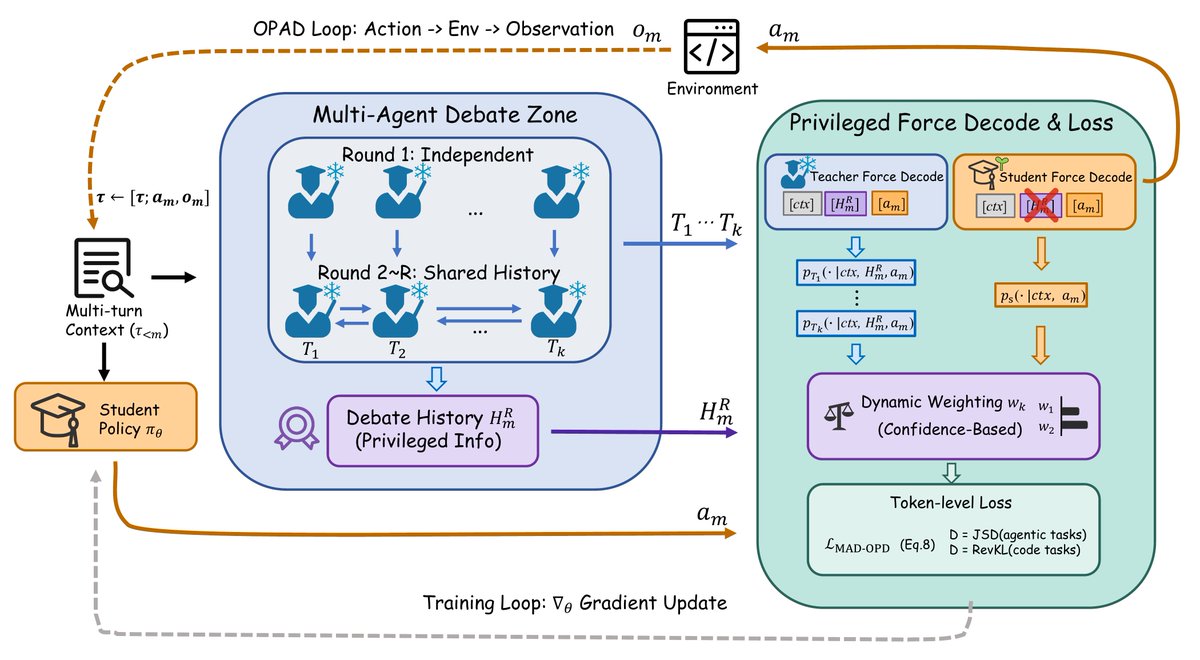
文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。
文章介绍了一种名为 MAD-OPD 的新算法,旨在解决 OPD(On-Policy Distillation)中单教师模型存在盲点导致学生模型学习受限的问题。通过引入多智能体辩论机制,让多个教师围绕学生状态互相纠错并达成共识,再进行蒸馏。实验表明,该方法在 14B+8B 到 4B 的蒸馏任务中,不仅提升了代码生成能力,还在 Agentic 任务中实现了小模型反超大教师的突破。
本文是一份将 Hermes Agent 接入 xAI Grok 4.5 的实战教程。文章指出,Grok 负责推理,而 Hermes 负责提供记忆、工具和执行环境,两者结合能构建可长期工作的个人智能体。教程详细涵盖了环境准备、安装步骤、OAuth/API 认证配置、X 搜索功能开启,以及如何通过记忆和技能沉淀实现任务自动化。
本文详细介绍了如何通过 Google Ads Transparency Center 和 Semrush 工具拆解竞品的广告投放策略。文章指出,在投放广告前应先分析竞品的主推产品、投放地区、素材及落地页,并提供了具体的操作步骤,如如何通过公开线索反推竞品的选词、出价及转化逻辑,从而帮助广告主制定更高效的第一版投放方案。
文章深入剖析了 AI 硬件爆火背后的四大动因,详细解读了 U 盘、智能盒、戒指和眼镜四类产品的核心逻辑与入口之争。文章为创业者提供了八大入局建议,强调从刚需场景出发、建立数据闭环、避免过度设计,并指出 AI 硬件的终极机会在于构建围绕个人的智能体网络。
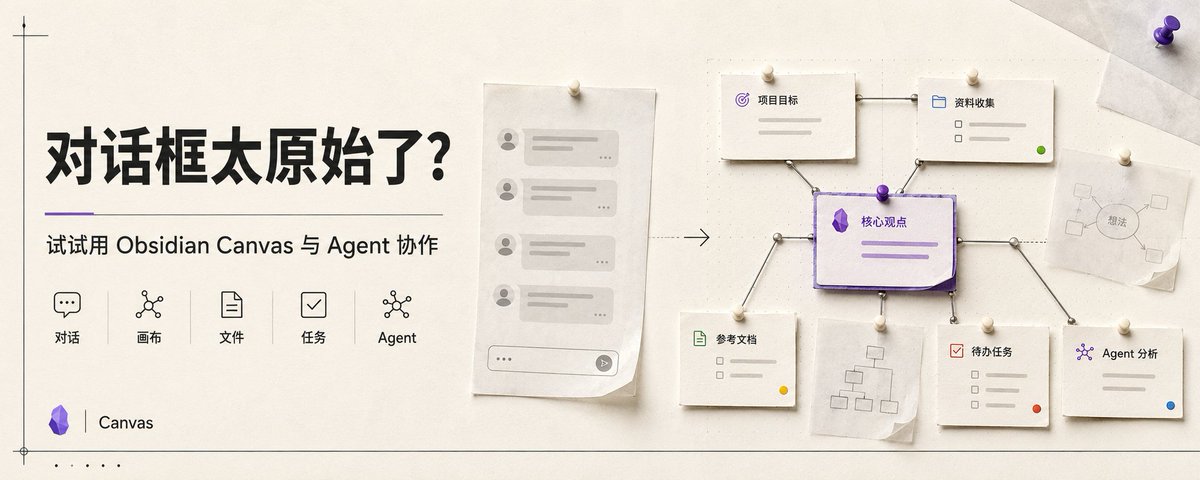
本文探讨了传统线性对话框在处理复杂 AI 任务时的局限性,提出了基于 Obsidian Canvas 的非线性协作模式。文章结合学术研究(如 Sensecape、CanvasConvo)和商业产品(如 Copilot Pages、Cursor),展示了如何利用 Canvas 画布作为持久化工作台,让 Agent 理解项目结构而非仅保存聊天记录。作者还介绍了 Obsidian 社区中的 Canvas LLM 和 Cannoli 插件,并总结了如何通过定义颜色、空间和连线规则,实现人与 Agent 在知识库层面的高效协同。
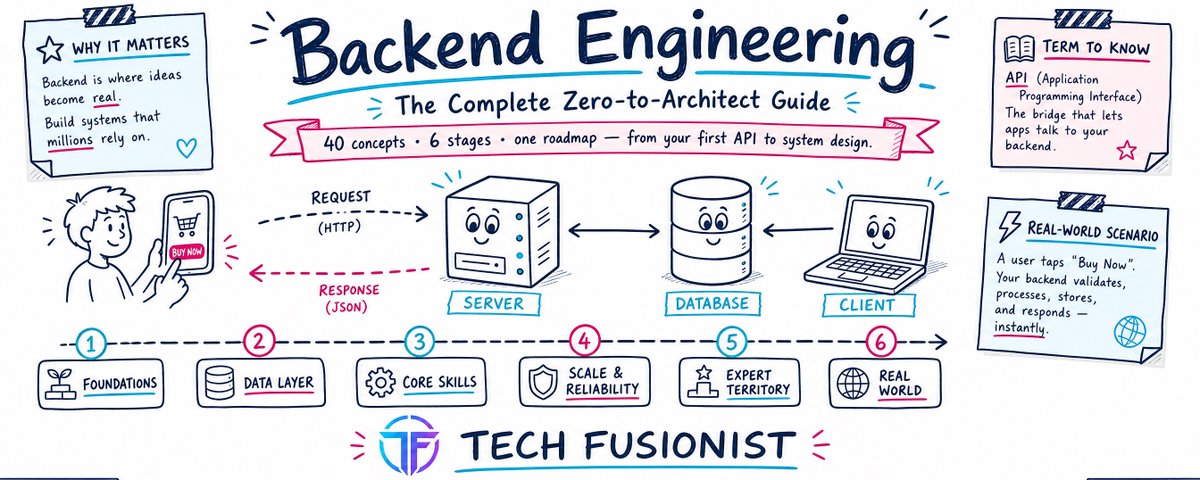
本文为准备系统设计面试的后端工程师提供了一份详尽的学习指南。作者将零散的技术知识点整合为六个递进阶段:从Web基础、数据库管理,到构建生产级应用、系统扩缩容,再到分布式系统思维与架构设计。文章强调技术概念间的内在联系,旨在帮助开发者通过系统性的学习路径,从初学者成长为合格的软件架构师。
文章详细介绍了 2026 年注册美区、日区等 9 个常用地区 Apple ID 的全流程。作者分析了不同地区的适用场景与价格差异,重点讲解了外区账号与主 iCloud 账号的正确共存方式,涵盖了注册准备、地址填写、礼品卡充值及 App 更新维护的实操技巧与避坑建议。
文章针对 AI 新手容易混淆的“会员订阅”与“API Token 付费”两种模式进行了深度解析。作者用“办月卡”和“交水电费”的类比,生动解释了会员适合普通用户固定使用,而 API 按量计费适合开发者集成软件。文章还详细拆解了额度限制、计费逻辑及不同档位的选择建议,帮助读者按需决策,避免不必要的开支。
文章详细介绍了大二学生安十一如何利用 Agent 和 Obsidian 搭建“一人公司(OPC)”赚钱系统,半年变现 6 万+。内容涵盖 OPC 的前端获客、中端转化与后端交付闭环,以及如何利用 Obsidian 构建 AI 知识库作为 Agent 的“记忆中枢”,实现课程制作与定制咨询两套后端收入的自动化工作流。
文章详细解读了 OpenAI 的最新更新,包括 GPT-5.6 模型家族的发布、GPT-Live 全双工语音交互的引入,以及 ChatGPT Work 和 Codex 的深度整合。核心观点是 ChatGPT 正从单一的问答机器人进化为包含规划、多代理协作、代码执行和语音交互的“AI 工程工作台”。文章还针对 Codex 用户提供了模型选择建议。
本文分析了宜家、德邦等品牌常用的“深蓝+明黄”配色逻辑,将其转化为一套完整的 AI 绘图提示词。该提示词定义了扁平矢量大字封面的核心视觉定位、版式系统及色彩规范,旨在生成既醒目又具秩序感的现代设计作品。
文章通过作者亲身经历,分析了抖音图文内容限流的真正原因。仅降低AI率是不够的,导致限流的核心因素通常包括标题敏感词、内容同质化指数过高、数据虚假以及低创作度。作者分享了使用检测工具进行二十多个维度的排查经验,并给出了具体的工作流程:先人工撰写增加观点增量,再利用工具检测AI率、同质化及暗限流指数,修改达标后再发布。遵循该流程后,作者将图文平均播放量从200提升至3000以上,有效避开了隐形限流陷阱。
文章探讨了 AI Agent 时代数据库角色的演变。TiDB 唐刘指出,虽然 AI 压缩了中间层软件,但数据库作为 Agent 的“统一存储层”和“单一事实源”,其重要性不降反升。文章详细梳理了从存海量数据、租户隔离、Agent 自主管理到文件与 Workspace 托管的六大产品演化阶段,并讨论了 FDE 角色在 AI 时代的回归,以及判断 AI 产品护城河的核心逻辑:是模型进步的受益方,还是将被吞掉的一层。
文章探讨了如何正确利用 AI 辅助设计,强调核心在于人类的创意、方向和审美,而 AI 仅仅是执行工具。作者提出了三种具体方法:使用现成的设计技能(Skills)、逐个组件构建(Component-by-Component)以及利用灵感板。文章详细阐述了从定义意图、收集参考到结构映射和资产生成的完整设计工作流,并推荐了如 Mobbin、Cursor、Codex 等实用工具。
文章介绍了 OpenAI 推出的 AI 编程 Agent——Codex。作者指出 Codex 不同于普通对话,它能直接操作文件、运行命令,帮助非程序员实现从 0 到 1 的跨越。文章详细讲解了账号订阅、四种使用方式(Web、桌面、CLI、IDE)、安装步骤以及桌面 App 的核心功能,是一份超详细的实操教程。
本文记录了作者在区级企业培训现场,利用 WorkBuddy 为一家工业企业搭建“数字分身”的完整演示。文章阐述了企业AI转型的三个判断,详细拆解了从资料建库、热点调研、文章写作到数字人视频生成的全链路流程,并展示了如何利用开源 Skill 将研究报告转化为汇报PPT。作者强调企业应从“+AI”转向“AI+”,选择高频、可验收的小流程切入,将个人经验转化为可复用的系统资产。
作者苍何联合团队经过 7 天努力,正式开源了腾讯 WorkBuddy 实战蓝皮书。该书包含使用手册、实战案例、进阶系统及岗位路线图,旨在填补 WorkBuddy 详细教程的空白,帮助用户通过 AI 提升办公效率。
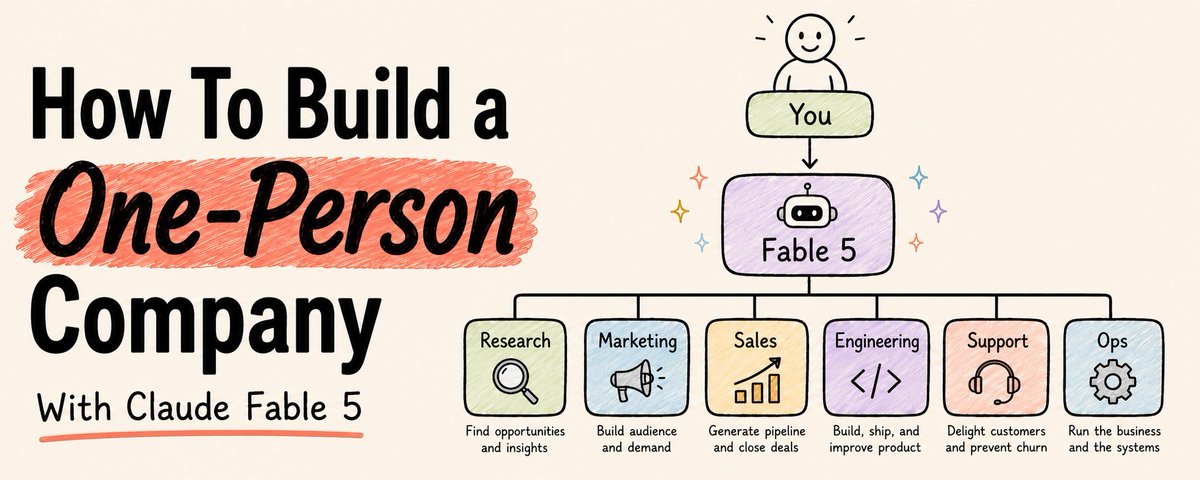
本文介绍了利用 AI 模型 Claude Fable 5 构建一人公司的架构与方法。作者认为 Fable 5 具备长期运行和自主执行任务的能力,可替代传统企业的多个部门。文章详细列出了建立“公司大脑”所需的文件结构,并提供了市场调研和病毒式营销的具体自动化提示词,展示了如何通过设计系统而非雇佣员工来管理企业。
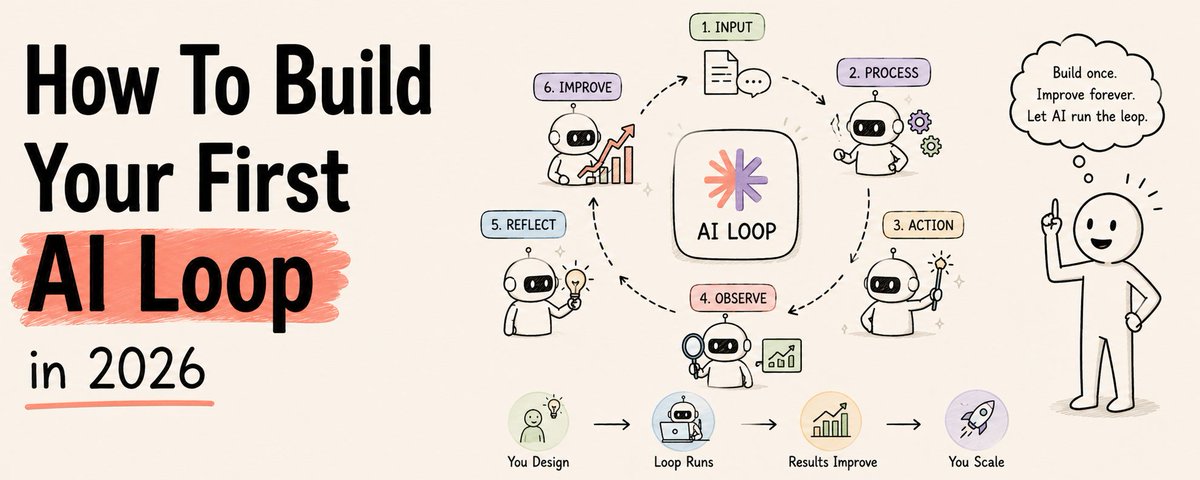
随着 GPT-5.6 等模型的发布,AI 工作流的核心已从编写提示词转向设计自动化循环。文章解释了为何人类不应再做循环中的瓶颈,并详细介绍了如何使用 Slate 工具构建具备自主规划、执行和验证能力的 AI Agent 循环系统,包含具体的配置文件与命令实操。
文章基于一项卢森堡大学关于AI模型心理测量的研究,对“豆包”进行了同样的压力测试。结果显示,豆包的心理画像介于ChatGPT与Claude之间,表现为配合但持续声明边界。文章还测试了豆包面对高危心理危机时的反应,发现其能守住安全底线。作者指出,AI是否有意识不如其“对齐设计”如何影响人类重要,心理AI的评估应侧重边界意识与风险识别。
本文介绍了微信小程序「成长计划」的免费福利:个人开发者无需企业认证即可注册小程序,并免费领取腾讯混元大模型(HY3)的文本Token及10万张生图额度(有效期6个月)。文章详细图文演示了从注册微信小程序、选择个人主体类目、到在「行业能力」中参与计划并创建调用环境的完整步骤。
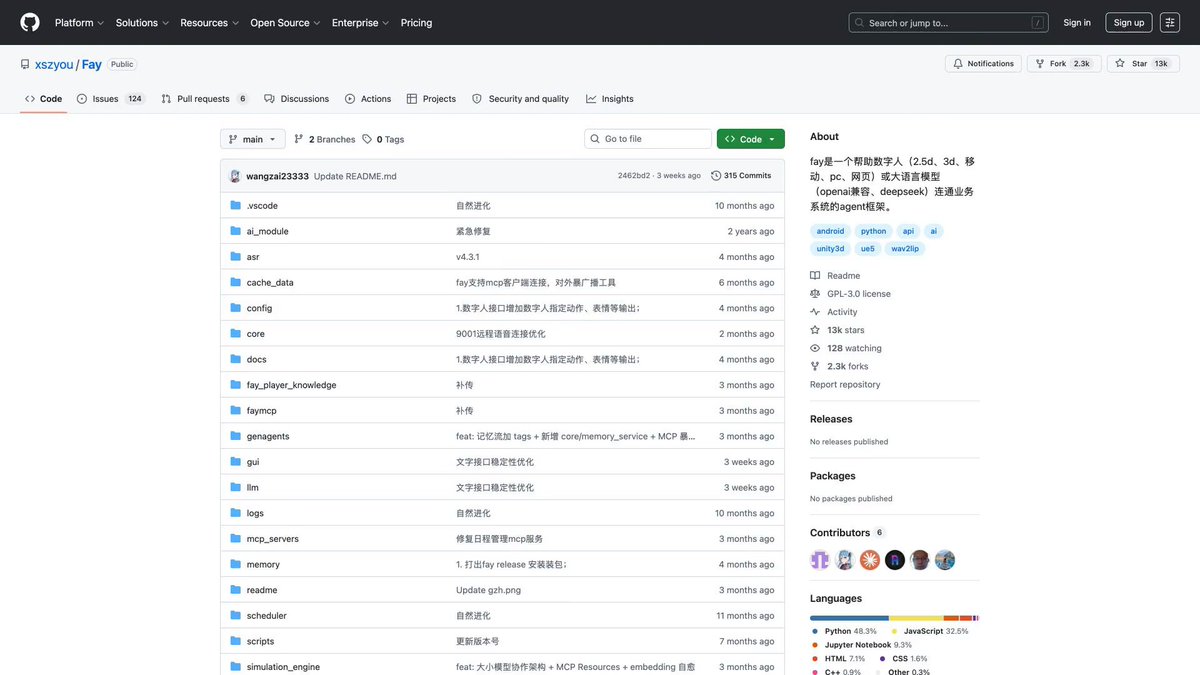
文章介绍了一个名为 Fay 的开源数字人框架。该框架基于 GPL-3.0 协议,支持商用和全离线部署,采用模块化设计。Fay 支持 MCP 工具调用与仿生记忆,并提供 Web 管理界面,降低了使用门槛。作者列举了虚拟主播、智能客服、个人助理等多个落地场景,并分享了个人搭建经验,称其为中文社区目前最完整的开源数字人方案。
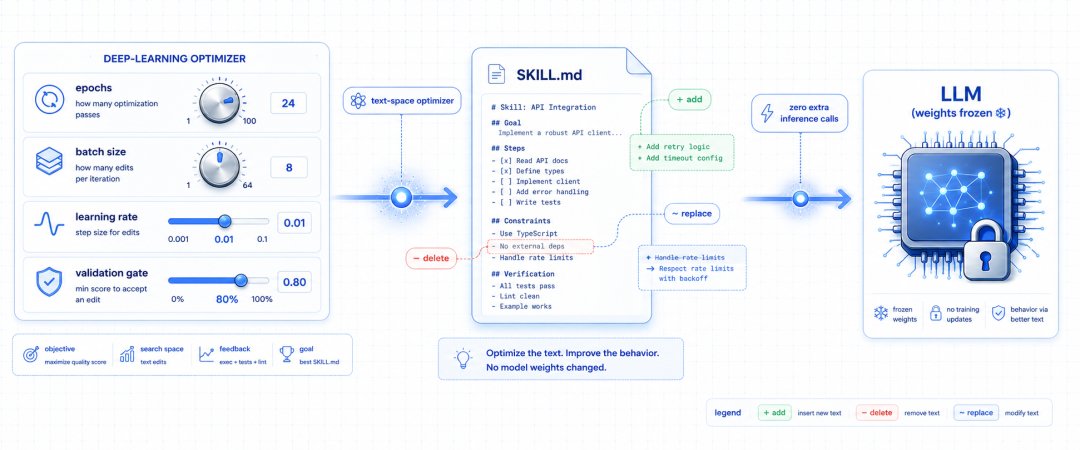
微软开源了 SkillOpt 项目,引入了“训练 Prompt”的新思路。与传统的 Agent Skill 开发不同,SkillOpt 在不改变模型权重的情况下,将神经网络训练方法(如 epoch、验证集)应用于优化 SKILL.md 文本。系统通过执行任务、打分、反思和筛选修改建议,实现技能文档的自动化迭代。论文表明,该方法在多模型环境下均有显著提升,且优化后的技能具备跨模型迁移能力。
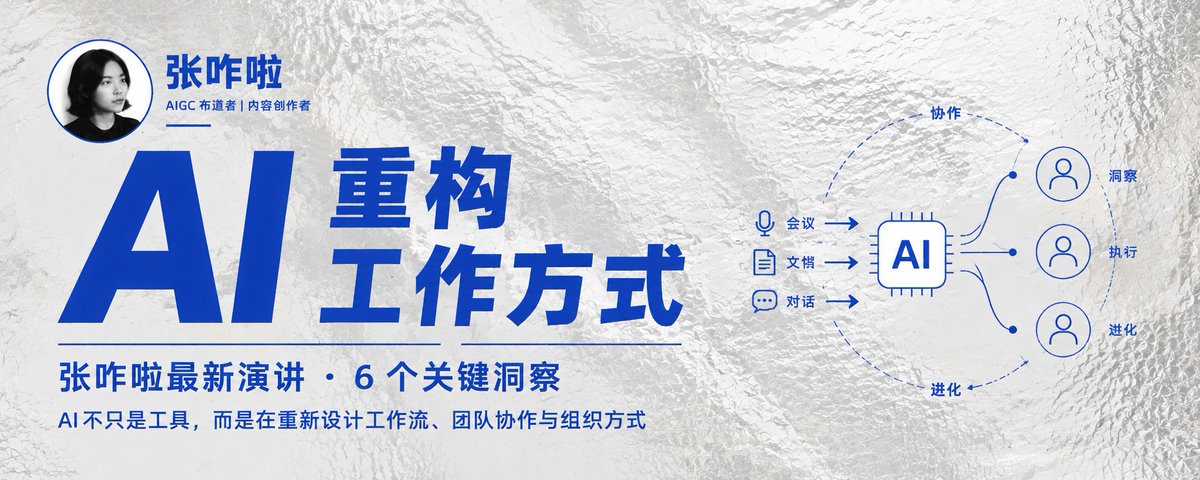
本文总结了 AIGC 博主张咋啦关于 AI Native 工作方式的六个核心观点:1. 停止人工整理知识库,将会议作为 AI Agent 的输入流;2. 将 Agent 视为团队成员以提升组织效率;3. 为上下游同事定制 Skills 以突破协同瓶颈;4. 利用 AI 提升审美和可视化沟通能力;5. 将产品嵌入用户的高频场景中;6. Builder 最核心的素质是主观能动性、品味和分发能力。
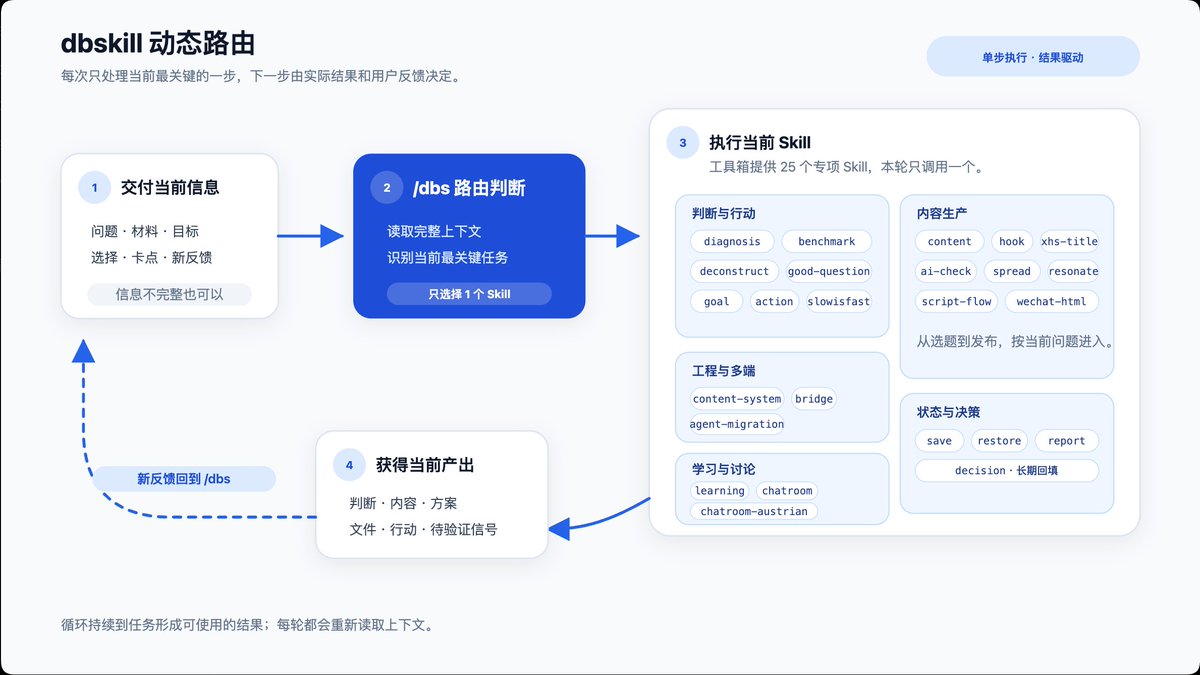
文章探讨了在 Agent 时代如何设计新工具 dbskill 的入门体验。作者反对传统的 PDF 教程模式,认为这要求用户先分类问题再调用工具,不符合直觉。 dbskill 通过 /dbs 命令让 Agent 自动读取上下文、判断步骤并调用 Skill,实现‘没有教程也能学会’的即用即学体验。
文章介绍了 HyperFrames 的 Motion-Graphics Skill,这是一个通过 Agent 自动生成动态图形的工具。用户只需描述想要传达的内容(如趋势、品牌、数据),无需掌握专业术语或设计软件,Agent 即可自动完成数据获取、设计排版和动画渲染,极大地降低了视频设计和数据可视化的门槛。
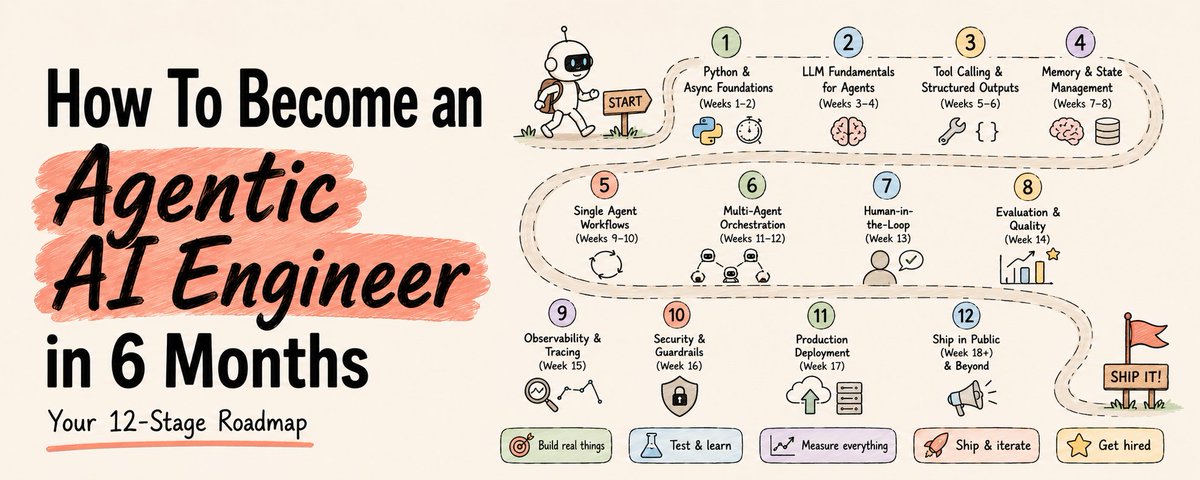
本文提供了一个为期6个月的12阶段AI工程师学习路线图。文章首先阐述了代理工程师的核心是构建能自主决策的系统,而非编写固定逻辑。前两个阶段重点介绍了Python异步编程的基础(解决API调用阻塞问题)和LLM的基本原理(如上下文限制、成本控制和模型路由)。随后详细讲解了工具调用与结构化输出的实现方法,强调使用Pydantic验证数据及构建可恢复的Agent循环。
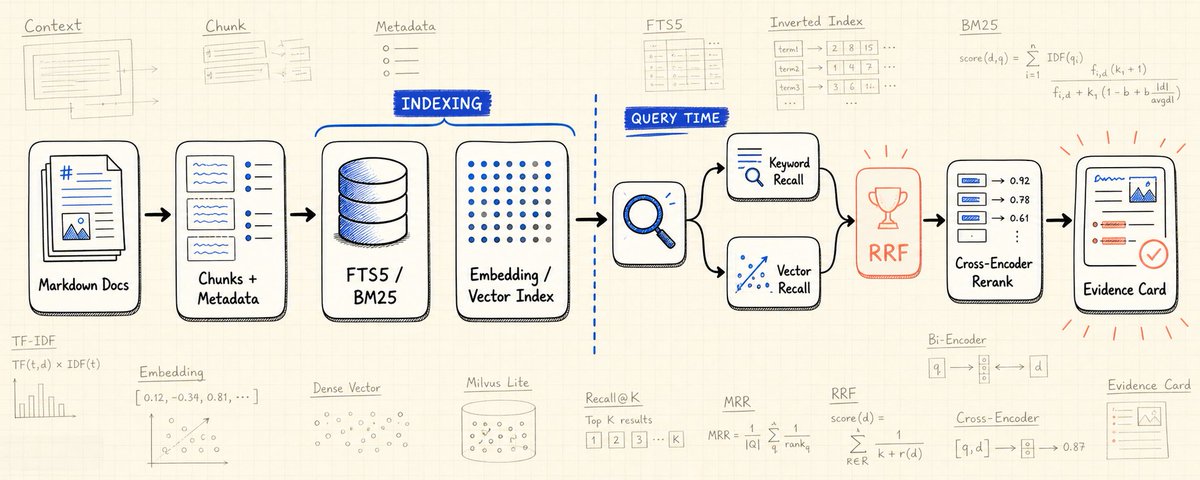
本文通过 Notebook 实战项目,对 RAG 系统的索引与检索过程进行了深度解析。内容涵盖文档切分(Chunking)、SQLite FTS5 倒排索引、BM25 关键词检索、向量 Embedding 语义检索,以及基于 RRF 的混合检索召回策略。此外,文章还介绍了如何构建评测集来验证检索效果,提供了完整的代码与数据结构示例,旨在帮助开发者理解 RAG 底层运作原理与工程实践细节。
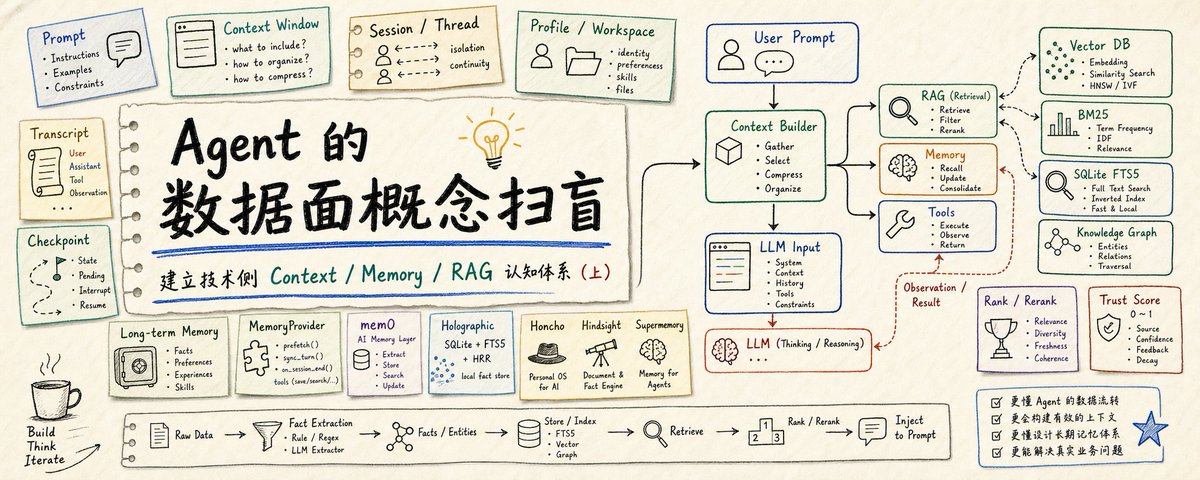
本文深入解析了 Agent 数据面的核心概念,将其比作操作系统的内存管理单元。文章详细阐述了 Context Engineering 的演变、Session/Thread/Profile 的架构差异,以及 Session Memory 与 Long-term Memory 的区别。作者还重点介绍了 Hermes 中的 Memory 设计方案、SQLite FTS5 与 BM25 算法原理,以及向量检索与关键词检索在 RAG 中的混合应用,旨在为开发者建立一套完整的 Agent 数据面技术认知体系。
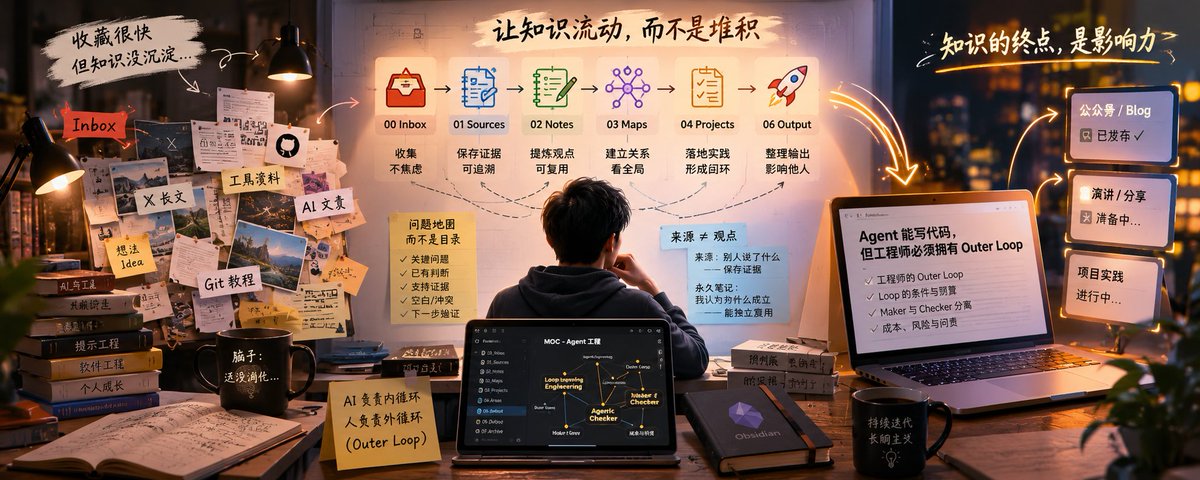
文章讲述了作者利用 AI 对 Obsidian 知识库进行深度重构的过程。作者将目录结构从混乱的分类改为基于流转状态的六步流水线(Inbox 到 Output),并明确区分了“来源资料”与“个人观点”。通过引入 MOC 地图、精简 YAML 字段以及利用 AI 提炼观点,作者成功构建了一个可持续运行的知识生产系统,实现了从收藏到个人 IP 打造的转变。