我是如何从好莱坞视效,开始转型做AIGC的
作者Cara曾参与《西部世界》《哥谭市》等好莱坞剧集的视效制作,回国后在外企视效公司、腾讯游戏工作,2026年7月裸辞All in AIGC。她发现当AI技术门槛降低后,做AIGC最难的不是技术,而是讲故事。文章记录了她用1000元预算试错、建立工作流的过程,并分享了两部作品的经验:《曜曜侠》花费800元、2分18秒,让她认识到短视频需要黄金三秒和强冲突;AI小猫Vlog《莫莫的Vlog》仅用1天、80元完成。她的结论是内容为王,先完成再完美。
作者Cara曾参与《西部世界》《哥谭市》等好莱坞剧集的视效制作,回国后在外企视效公司、腾讯游戏工作,2026年7月裸辞All in AIGC。她发现当AI技术门槛降低后,做AIGC最难的不是技术,而是讲故事。文章记录了她用1000元预算试错、建立工作流的过程,并分享了两部作品的经验:《曜曜侠》花费800元、2分18秒,让她认识到短视频需要黄金三秒和强冲突;AI小猫Vlog《莫莫的Vlog》仅用1天、80元完成。她的结论是内容为王,先完成再完美。
本文系统梳理了 27 种 AI 视频生成中的进阶运镜提示词,包括升降镜头、环绕镜头、POV 视角、风格化镜头及一镜到底等进阶玩法,并附上各家模型的运镜服从度实测:Seedance 质感稳、可灵分镜听话、Kling/Runway 手动精控最强。作者还分享了一个提升电影感的核心技巧:一条镜头只给一个运动方向,配合主体小动作与前景、中景、背景三层视差,并给出标准提示词公式与反面教材自查方法。
作者以致敬抗美援朝的AI音乐短片《茶汤》为例,完整拆解了AI短片制作流程:找对标、拆剧情、写剧本、查参考、做资产、生视频、后期。文中介绍了豆包辅助分析对标视频、ChatGPT写剧本、Gemini换装改图、即梦生成视频、剪映后期剪辑的工具分工,分享了角色与场景资产制作的具体提示词,并对比了海螺H3与Seedance 2.5在画面质感上的差异。文章附有可直接参考的提示词与操作截图,帮助读者从单镜头进阶到完整成片。
作者从 GitHub 合集中挑选热度最高的 82 条 Seedance 2.5 视频生成提示词,来自 39 位 X 创作者,按镜头类型分为 9 类,并附上原作者、原帖链接及 36 条第三方复测结果(21 条复现成功,14 条效果衰减,1 条失败)。为解决分类后仍难以检索的问题,作者使用 EverOS Cloud 将提示词库转为可按语义检索的记忆库,只写两个脚本即可通过中文需求描述快速检索出匹配提示词及复测结论。完整提示词库和脚本已开源在 GitHub,方便读者三步搭建自己的提示词检索系统。
文章探讨如何通过导演思维撰写 AI 视频提示词,让角色表演更有“活人感”。作者指出 Seedance 2.0 之后运镜描述弱化,表情成为重点:不能只用成语描述情绪,而要细化面部与肢体动作,如同导演向演员传达动作和目的。写作流程是将剧情和情绪背景交给 GPT 生成表演细节提示词,再交由 Seedance 2.5 生成。文中给出情侣分手场景的完整提示词示例,并强调台词要写清说话时的情绪与状态,加入口音变化,避免机械感。作者认为 AI 视频制作越来越接近传统电影拍摄。
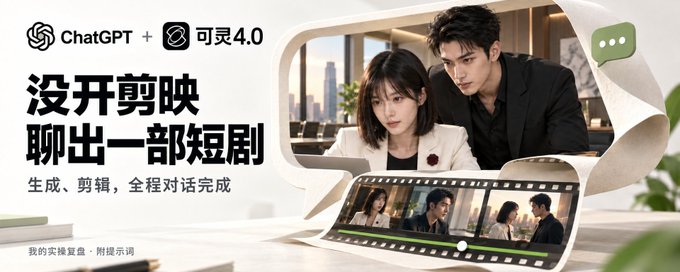
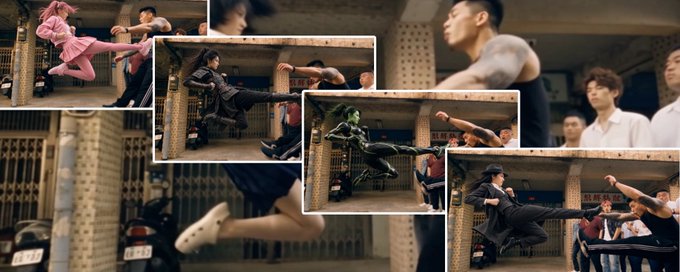
作者用可灵4.0与Seedance 2.5进行五组视频生成对比测试(女团舞、武士打斗、镇妖斗法、森林逃亡、耳机广告),并分析双方效果与成本差异,可灵1080P单价更低。随后作者展示用可灵4.0制作一部都市短剧的完整流程:将可灵MCP/CLI接入Codex,通过GPTS编写剧本,制作白底三栏人物参考图和场景资产,用专业视听语言模板编排视频提示词,再生成、返修和剪辑,全程与AI对话完成,无需剪辑软件。文末附完整提示词和Skill工具推荐。
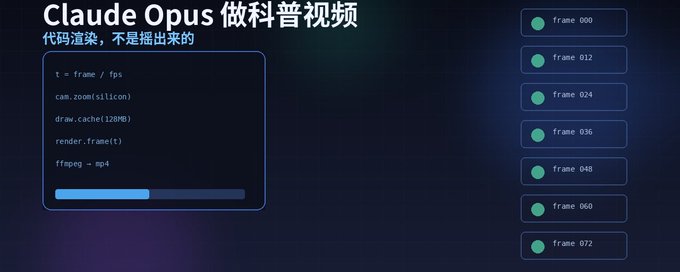
文章介绍了用 Claude Opus 5.5 通过「确定性渲染」制作科普视频的方法:模型编写网页代码,浏览器逐帧截图后用 FFmpeg 合成视频,每帧画面由代码精确计算,可复现、可改稿,尤其适合文字、图表类科普内容。对比像素生成模型(如 Seedance 2.5)的「逐帧梦」方式,代码渲染在确定性和可编辑性上占优,但拍不了真人。文章还算了成本账:一条 12 秒成品约 5 元人民币,并指出三个坑:流式输出等待长、需人工检查渲染帧、需提供品牌素材。结论是视频制作门槛从会用工具转移到能否说清需求。
作者基于半年内的实际作品记录,系统测算AI视频生成成本:只算机器费用,1分钟可用成片约18-115元。文章拆解了成本的四层结构:标价成本、抽卡成本、周边成本和人工成本,并指出人工成本(约700元/分钟)才是AI视频贵的真正原因。文章详细对比了Seedance、MiniMax H3等模型的会员积分与API价格,总结出贵模型不一定花费多、前期准备越足抽卡越少等经验,并给出预演前置、分级用模型、先低清再超分、补镜头不整段重抽等省钱方案,还介绍了新手免费额度与本地开源模型的低成本路径。
作者以视频创作小白的身份,分享了使用 Miora 织影 Agent 制作中国古代猫故事短片《乾红猫》的完整过程。文章详细介绍了从选题找故事、建立故事框架、创建角色卡、拆解分镜到调整细节和剪辑的六个步骤。制作中遇到红猫一致性等 AI 视频生成的常见问题,通过补充角色卡和抽卡方式解决。最终短片 1 分 18 秒,生成 50 段视频,花费约 40 美元。作者认为这类视频 Agent 目前更适合作为创作工作流使用,距离一句话生成短片还有距离。
作者分享了一套将 10 位导演(王家卫、张艺谋、诺兰、韦斯·安德森等)的视觉风格拆解为六维参数(焦段/画幅、构图、光线、色彩、运动、节奏)的方法,用于提升 AI 视频的电影质感。核心思路是把'王家卫风格'等抽象描述翻译成 AI 能理解的具体镜头语言,并提供了可复制的提示词模板和公式:导演六维参数 + 场景 + 镜头运动 + 负面提示词。文末还推荐了几个开源的导演风格库工具。
作者从自己在X上分享的提示词中精选出收藏和点赞最多的30条,整理成可直接复制的合集,涵盖AI视频与人像自拍两大类玩法。视频类包括苹果风产品广告片、一镜十姿时装视频、奢侈品风塑料袋广告、无人机第一视角导览、高奢刺绣广告等;图片类包括黏土定格动画人像、自拍虚拟试穿、杂志大片重绘、和小时候的自己合影、85mm焦外抽离、极端广角人像等。每条附提示词原文、出图效果链接及修改建议,适用工具涉及GPT-Image-2、海螺H3、Seedance 2.0等模型。
文章探讨了AI视频创作中工具与导演思维的关系。作者认为,尽管Vibe Creating等理念降低了技术门槛,让普通人能用自然语言生成视频,但决定作品上限的仍是导演思维:一是动手前清楚知道自己想要什么画面和感受,二是能判断生成结果的对错并明确改进方向。作者以Vibe Coding类比,指出描述与判断越模糊,结果越随机。纯粹玩乐时无需导演思维,但要做出系列作品或商业交付,就必须具备画面感和叙事能力。学习影视理论的意义不在术语,而在构建脑中画面与判断力。
作者精心整理了一份 AI 视觉与影视领域的 59 篇精选文章合集,涵盖 AI 视频生成、AI 生图、数字人、动画制作、ComfyUI 工作流等多个方向。内容包括 Cursor + Remotion 动画制作、Seedance 视频模型玩法、Gemini 3 Flash Image 生图探索、Suno AI 音乐生成、Claude Skill 开发、GPT Image 实测、数字人口播教程、3D 预演台实操等。文章以保姆级教程为主,兼有开源项目与经验分享,适合 AI 视觉与影视创作爱好者系统学习参考。
作者分享即梦AI推出的「样片模式」使用体验:先用480P低成本抽卡试错,满意后原生升清为1080P成片,大幅降低AI视频创作成本。文章通过东方志怪短剧、末日废土3D动画、苹果风产品TVC三个案例对比480P与1080P效果,显示升清后角色细节、材质质感和光影特效显著提升。相比直接1080P直出,样片模式可节省约66%费用。作者认为这标志着AI视频生成首次有了'打草稿'环节,让创作从运气抽卡变为先草稿后成片的正规流程。
作者分享了一套制作AI趣味短片的高效流程:只需一张角色参考图,借助全能参考模式(Seedance 2.0/2.5、Minimax H3等主流模型)即可生成视频。具体四步为:制作角色图、借助AI改写提示词、选择主流视频模型生成、后期剪辑(配乐、调色、变速裁剪)。文章还介绍了账号运营策略,如打造系列内容或提示词账号,以及变现方式,包括平台播放收益、创作者活动、教程商单和广告植入等。
本文是一篇豆包工作(字节智能体办公软件)的完整入门教程。作者从下载安装、界面介绍讲起,涵盖文档与PDF处理、图片生成、Seedance视频生成等核心功能,并重点演示了如何利用开源Skill批量采集抖音博主的视频信息与逐字稿,写入飞书多维表格。文中还分享了水印关闭、权限授权、逐字稿分页截断等实操避坑经验,以及Trae、Seedance、豆包等产品间的区别。
本文介绍一种利用 Codex(GPT 6)与 Seedance 结合制作换装视频的玩法:先用 Seedance 生成基础动作视频,再让 Codex 抽帧分析换装区间,调用生图模型批量替换服装、发型、配饰等元素,保持人物动作与构图不变;随后人工检查并对问题图片局部返修,最后由 Codex 自动完成剪辑拼接,导出 MP4。作者还分享了提示词模板、额度消耗经验及超高速换装视频的变体玩法,全程仅需对话即可完成。
作者beech基于用AI创作视频内容并获得数百万播放量的经验,整理了7份指南:学习AI内容创作基础(七天路线图)、Seedance视频生成提示词技巧、制作完整AI广告的流程、研究前沿创作者、打造AI角色与受众变现、构建内容自动化Agent、以及规划内容支柱策略。作者强调品味(taste)无法靠提示词获得,AI模型越强,创意与创新的空间越大,抓住新模型发布初期的流量红利是关键。
作者分享其为 Adobe Firefly 活动创作的 30 秒 AI 短片《Last Days of Summer》的制作过程,批评当前多数 AI 视频只是“美丽意外的集锦”而非真正的电影。文章总结了八条创作方法论:先用 Firefly Boards 构建世界规则(粉色、70 年代胶片质感),大量生成但只保留能承接叙事的关键帧,克制剪辑、在发现处切镜、让每个镜头保有独立的胶片质感、仅用三句旁白等。核心观点是:生成已不是难点,真正的功力在于知道何时停留、何时剪切、何时留白。
本文整理了 Manus 2.0 发布的 12 个视频生成示例及其完整 Prompt,涵盖动效作品集、游戏预告片、AI 新闻 meme 解说、代码生成的解压视频、材质动画、大模型历史科普、虚构产品发布片、创意混剪、字体动画、新闻解说、p5.js 程序化故事预告等多种类型。作者逐条说明了每个示例所需的工具与环境(如代码执行、渲染导出、TTS、视频模型等),并指出这些 Prompt 也可在支持代码执行和工具调用的 Agent 环境(如 Opus 5.5 或 Sonnet 5.5)中使用,为 AI 视频创作提供了实用的 Prompt 参考。
作者介绍了 Meta 旗下 Muse 模型家族(含视频生成模型 Muse Video),并分享用其制作 3 分钟漫剧的完整方法论。Muse 每次仅生成约 10 秒视频,长剧需拆分 18 个分镜逐段生成再拼接。作者结合漫剧创作六步工作流(剧本→分镜→资产→锁定→逐镜生成→拼接),并从 Seedance 2.5 官方文档和 Higgsfield 开源长片方法论中提炼关键技巧:资产先行、英文描述+中文台词、肯定式画面约束、一镜一种运镜等。文中还记录了中文配音、口型转头等踩坑教训,最终形成'一镜一确认'、平均 50-70 次生成完成一集的可控流程,并给出三层进阶学习路径。
作者分享了一套 AI 生成 2D 游戏角色动画的高成功率工作流。相比直接用 AI 生成 Sprite 常遇到的武器变形、动作不稳定等问题,该方案让各工具各司其职:先准备角色原图,用 Seedance 2.0 Mini 参考图生成包含 Idle/Walk/Run/Attack 四个动作的视频(成本不到 1 美金),再用 Codex + FFmpeg 拆帧,人工筛选每个动作最佳的 12 帧,最后通过 generate2dsprite Skill 自动合成游戏可用的 Sprite Sheet,导入 Godot/Unity 使用。视频模型对连续人体动作的理解明显比直接生成 Sprite 稳定,尤其适合带武器的复杂角色。
作者实测 LibTV 1.5 的五大新功能:剧本原创及改编、角色造型室、导演执导、3D-BOX 和创意片头,并以古装短剧为例完整走了一遍从剧本创作到成片输出的 AI 短剧工作流。文章详细演示了 TV Director 如何统筹剧集规划、角色捏脸设计、分镜优化、3D 场景预演和片头包装,突出各环节既能自动生成又可手动介入修改的灵活性。作者认为这大幅降低了没有专业编剧、导演知识的普通人创作高质量短剧的门槛。
文章展示了使用 Seedance 2.5 视频生成模型创建咖啡品牌商业视频的案例。作者提供了一个详细的英文提示词,描述了从研磨咖啡豆、浓缩咖啡萃取、拉花,到多样生活方式场景(咖啡馆办公、街头滑板、户外早餐、欧式城市漫步)的完整画面。视频呈现暖色调、现代都市美学和高质感商业广告风格,展示了 AI 视频生成在品牌营销内容创作中的应用潜力。
作者从模型能力、产品功能、实测案例三个维度对比AI办公Agent产品WorkBuddy与豆包工作。模型方面,WorkBuddy支持接入DeepSeek、GLM等第三方模型,生态开放;豆包工作封闭,仅用自家Seed系列。生图生视频方面豆包完胜,Seedream 5.0和Seedance 2.5领先。产品功能上WorkBuddy的Skill生态更丰富,免费积分获取途径多、使用成本更低;豆包在手机遥控电脑方面体验更好。实测中两者使用同一Seed2.1 Pro模型,豆包在指令遵循和AI味控制上表现更佳,复杂规划任务耗时更短。文章认为两者各有优劣,选择取决于用户具体需求。
AI 桌面换装视频近期在 Twitter 爆火,作者程序员鱼皮分享了如何复刻这类视频的完整流程。核心方法是使用其开源的「AI 桌面换装视频」生成 Skill:用户只需与 AI 对话回答主角、场景、造型、台词等问题,AI 会自动生成完整的视频提示词,复制到即梦等支持 Seedance 模型的视频工具即可出片,也可直接调用 API 生成。核心原理是让 AI 逐帧分析原版爆款视频,拆解换装镜头的机关细节,生成提示词模板并封装成可复用技能,全程开源到 GitHub。作者强调借助 AI 的 Agent 与视觉理解能力,从拆片到发布几乎全由 AI 完成。
文章介绍如何利用豆包工作(Doubao Work)搭建AI视频创意生产线,解决收藏了大量AI视频却做不出来的问题。作者通过四个步骤演示完整流程:先用目标模式建立AI视频素材库,自动下载并拆解视频到飞书多维表格;再用计划模式拆解参考视频的创意机制(如敦煌飞天Demo的'正常—意外—补救—破绽—装没事'结构);然后修改计划换成原创方向(冰箱小精灵偷吃饼干);最后确认后用Seedream和Seedance模型生成成片。文章总结了目标模式与计划模式的区别、减少动作复杂度等实用技巧,并指出该方法同样适用于报告、PPT、数据表等场景。
作者李岳此前用 Codex 制作的 Seedance 2.5 打斗导演 Skill 提示词效果不理想,转而尝试字节新发布的豆包工作客户端。他利用豆包工作的"目标"功能,把诊断、优化 Skill 并生成 30 秒仙侠国漫打斗视频的复杂长任务交给后台执行,归来时任务已完成,且思考链中有逐项校验。随后他使用"计划"功能让豆包为 Skill 增加智能路由、新手指引和提示词诊断优化,并支持剧情即时调整与在线修改计划文档。作者认为豆包工作的目标和计划功能对复杂任务优势明显,可显著提升工作效率,不足是偶发资源不足。
作者拆解抖音博主陶阿狗君的色卡变装创意视频,并用 AI 完整复刻了制作流程。文章详细介绍了从素材准备(小红书找穿搭参考、模特图、视频截图)到出图的提示词模板,再到使用 Seedance、H3、Wan 3.0 等工具图生视频的完整步骤,并分享了批量出图、单张调整和视频生成的提示词。作者还用 Codex 对话式改图,结合 Hypit 插件和即梦 CLI 打通生图与视频流程,并附带了 3D 地图旅行打卡转场案例。强调拆解优秀视频、逐帧研究转场与穿搭展示的学习方法。
这是一篇面向新手的 AI 视频制作万字教程。作者系统介绍了 AI 视频的基础概念,包括文生图、文生视频、图生视频的区别与选择方法,对比了 Seedance 2.5、MiniMax H3、可灵、Wan 3.0、Veo 3.1 等主流视频模型的特点与费用,并汇总了 LibTV、TapNow、Flova、即梦等聚合平台的特色。教程详细讲解了图生视频的完整制作流程(写故事、定角色、列分镜、生成分镜图、图生视频、剪辑配声),并以《江边告别》为例示范了人物、分镜和视频提示词的写法,帮助读者制作出第一条文生视频和动作迁移视频。