Wiki 知识库

全部文档 / 标签: Jev

69 篇
清除

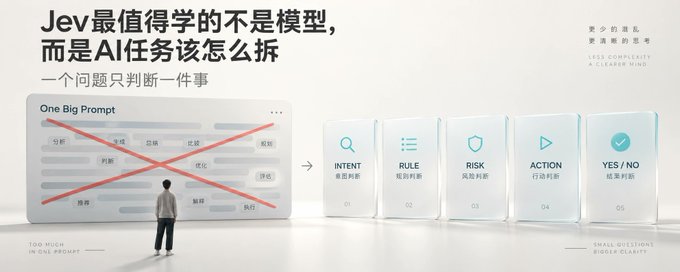
Jev与你有什么关系?它提供了一套AI工作流拆分法

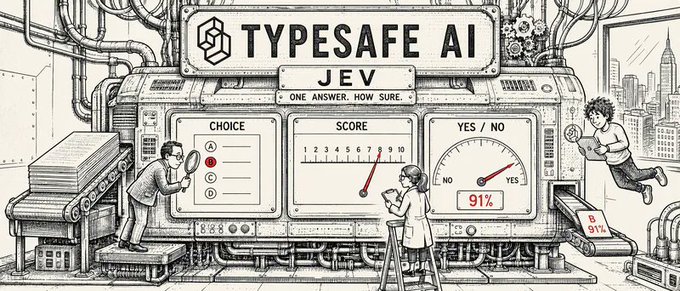
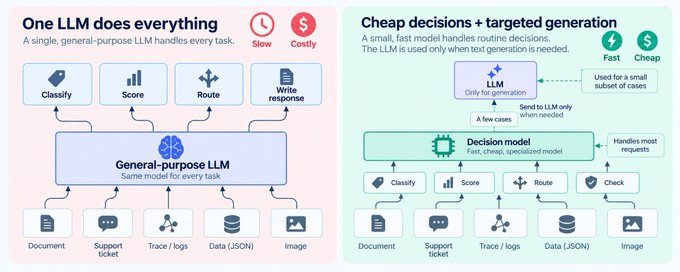
文章介绍了TypeSafe AI于2026年9月发布的Jev模型,一个不做文本生成、只做封闭判断的“System One Model”。它提供三种能力:Choice(选项选择)、Score(等级打分)和Noul(真假概率判断),直接返回类型化结果和概率,省去生成文本的延迟和成本。文章分析了Jev与生成式模型的本质区别,指出类型安全只保证接口格式而非事实正确,概率不等于正确率,并详细说明其在缺陷分诊、Agent路由、发布说明审核等真实场景中的应用方法,以及官方Agent Skill倡导的AI工作流拆分法:代码负责计算和规则,模型只做清楚的语义判断。

技术 › LLM 苏乐 2026-09-2224.6 KB 20.2K 41 85

How to build a signal-based outbound bot with Jev

作者介绍了基于 TypeSafe 发布的 Jev 模型构建信号驱动外呼机器人的方法。Jev 比通用模型快约百倍且成本极低,可为每个销售线索快速打分。作者团队曾用 Claude 做信号驱动 SDR,两周内约到 19 次会议,回复率 12%。文章详细拆解了开源项目 signal-ranker 的架构:watch.py 通过日期文件对比追踪招聘重发、融资等信号,judge.py 负责调用 Jev 评分,policy.py 用纯代码实现门槛与权重,两者分离以便复用已付费的判断结果。支持用 Claude Code 自行拉取线索或使用 yourmax.ai,可放入 Claude Code 或 Codex 终端复现。

技术 › Claude Code Nicolas Finet 2026-09-2225.0 KB 16.8K 153 83

Jev is INSANE for Marketing

本文介绍新型AI模型Jev,它由ChatGPT联合创造者Diogo Almeida创立的TypeSafeAI开发,采用RLCD训练方法,可进行即时决策而非逐字生成回答。Jev提供Choice、Score、Bool三种询问方式,并附带置信度评分,速度提升20-200倍、成本降低400倍。作者展示了如何将Jev实际集成到自己的SaaS产品Virlo中,构建内容研究代理,自动监控TikTok等平台的病毒式视频,分析爆款钩子、格式和角度,并转化为经过数据验证的脚本和创作简报,帮助内容营销人员高效产出热门内容。

技术 › LLM jaffa 2026-09-2221.1 KB 547.4K 765 54

How to use Jev for GTM Automation (Step-by-step guide)

本文介绍 TypeSafe AI 推出的 Jev 模型,它专为校准决策设计,输出概率而非文本。Jev 针对传统 LLM 过度自信、成本高、速度慢的问题,通过三种问题类型(Choice、Noul、Score)返回带置信度的概率结果,开发者可基于置信度阈值设置自动化护栏,实现无人值守运行。作者结合 treg 数据服务,展示了 Jev 在 GTM 自动化中的实战应用,包括欺诈检测与注册用户资格审核(每日 236 个注册仅花费约 $1.21)、以及购买信号分类等场景,并分享了编写评分规则(rubrics)而非传统 prompt 的使用技巧,成本远低于通用聊天模型。

技术 › LLM Jason Zhou 2026-09-2210.6 KB 64.8K 231 82

60个Jev典型案例整理与12个最值得关注案例详解

作者收集整理了60个Jev应用案例,并精选12个典型场景进行详解。这些案例的核心逻辑是:生成模型负责写作与复杂推理,Jev承担分类、筛选、评分和选择,代码执行后续动作,关键节点保留人工复核。案例涵盖品牌提及识别、实体对齐去重、RAG信源筛选、引用核验、网页操作决策、Skill选择、工具风险检查、客服工单分流、官网表达检查、论文引用验证、级联校验信息抽取及文本特征化等多个方向,对理解AI应用的工程化实践具有参考价值。

技术 › Agent 姚金刚 (@yaojingang) 2026-09-224.1 KB 79

Jev 火了:我整理了 20 个真正适合国内用户的用法

文章介绍了近期海外开发者圈爆火的 AI 工具 Jev。它不是生成型模型,而是专注于毫秒级、极低成本的大量小判断,核心能力包括 Choice(选择)、Score(评分)和 Noul(概率判断)。作者整理了 20 个适合国内用户的应用案例:内容创作领域包括小红书标题爆款体检、检测文章 AI 味、筛选海量新闻素材、个性化信息流过滤;企业场景包括客服工单自动分类、销售线索分级、表单自动填写;开发者场景包括代码审查、AI 代码质检、编码 Agent 监工、MCP 集成、Agent 执行前的安全检查、长期运行 Agent 的记忆清理,以及智能家居和浏览器 Agent 操作等。

技术 › LLM 三个三 2026-09-2221.3 KB 69.9K 494 79

面向 coding agent 的 Jev 工程学

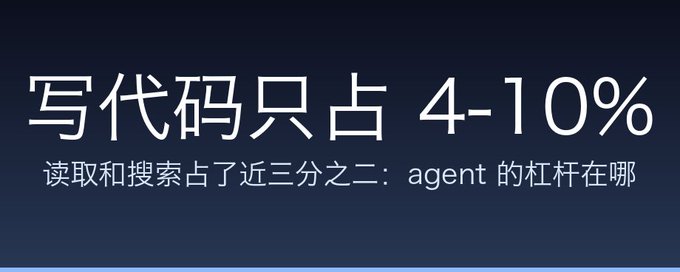
本文基于 Diogo Almeida 的设计笔记,从第一性原理重新审视 coding agent 的设计。作者以「如果没有 KV cache 会怎样设计」为切入点,揭示当前 agent 围绕缓存经济性形成的「只追加对话记录」范式的六大症状:路由失效、工具挤占上下文、压缩有损、子 agent 平庸、重启丢状态、内置能力争论。文章指出 token 主要消耗在读取与搜索而非写代码,并提出以 Jev 决策层为核心的方案:元注意力上下文组装、查询感知压缩、可见性阶梯、可编程权限、安全感知路由与三级工具披露,把上下文当作被有意组装而非偶然累积的对象。

技术 › Harness Engineering yibie 2026-09-2216.5 KB 8.9K 57 83

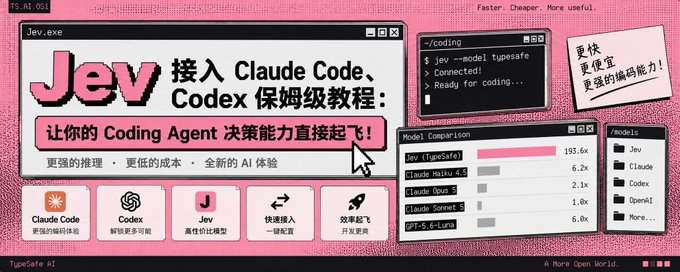
Jev 接入 Claude Code、Codex 保姆级教程:让你的 Coding Agent 决策能力直接起飞!

文章详细介绍了如何在 Claude Code、Codex 等 Coding Agent 中接入 Jev 模型。作者小码哥分享了获取 API Key、设置环境变量、模型价格(成本比其他模型低 40~400 倍)以及 curl 请求测试等步骤。重点讲解了通过官方提供的即插即用 Skill,在 Claude Code 中使用插件市场安装,以及在 Codex、Cursor、Gemini CLI 等工具中用 npx skills 命令安装的方法,还介绍了 Skill 更新和提示词自动安装方式。作者认为 Jev 的特色在于不生成内容,而是帮助做判断、分析和决策,最适合与 Coding Agent 配合使用:Agent 负责干活,Jev 负责判断。新用户可获得 5 美元额度。

技术 › Claude Code 小码哥 2026-09-228.0 KB 342.3K 606 79

全网刷屏的 Jev 模型正式开放!一手实战测评 + 保姆级教程

文章介绍了由前 OpenAI 研究员、ChatGPT 共同发明人 Diogo Almeida 创办的 TypeSafe AI 发布的 Jev 模型。与传统对话式 LLM 不同,Jev 是一个'系统一模型',不生成文字,而是直接返回结构化决策结果(是/否判断、多选一、评分三种原语),采用并行采样和 RLCD 校准决策强化学习,响应速度可快达数百倍、成本低数十倍且结构化输出零错误。文章详细讲解了 Jev 的原理、适用场景(工单分类、Agent 决策中间层、内容审核、实时游戏等),并提供了 Playground、API/SDK、Vercel/Cloudflare 平台及 AI 工具 Skills 接入等保姆级使用教程。

技术 › LLM 程序员鱼皮 2026-09-2223.5 KB 55.8K 276 84

Jev便宜444倍:160年前的经济学正在重演

文章以1865年杰文斯提出的“效率提升反而导致资源消耗增加”的悖论为切入点,解读新发布的AI模型Jev比现有大模型便宜444倍、快近200倍的意义。作者认为判断成本骤降将推动各行业从“抽样”走向“全检”,重演历史上铝、钢铁等价格崩塌后催生全新应用的规律。同时提醒三大代价:缺乏可解释性、判断力外包、责任真空,并指出杰文斯悖论只在需求未饱和时成立。最后建议读者从工作中的具体判断入手思考自动化机会,把人的位置从“做廉价判断”上移到“决定什么值得被判断”。

技术 › LLM Adrian Punk 2026-09-2118.9 KB 110K 149 81

全网爆火的 Jev 究竟是什么?一篇文章为你讲透

文章介绍了爆火的 Jev 模型:一个专门做'判断'的 AI 模型,与传统生成式模型 GPT、Claude 不同,它不做长文生成,而是快速对内容进行分类、打分和分流,类似卡尼曼《思考,快与慢》中的 System 1 快速思维。文章讲解了 Jev 与传统模型的区别、适用与不适用场景(适合规则稳定的判断任务,不适合快速变化的结论),并介绍了通过 TypeSafe AI 官网、OpenRouter、Vercel 等渠道使用的方法,最后通过银行客服分流、交通信号灯动态调度、内容审核筛选、AI Agent 判断层等实际案例说明其应用价值。

技术 › LLM 程序员小灰 2026-09-2112.0 KB 3K 5 78

Jev 这种类型决策模型出现意味着什么?

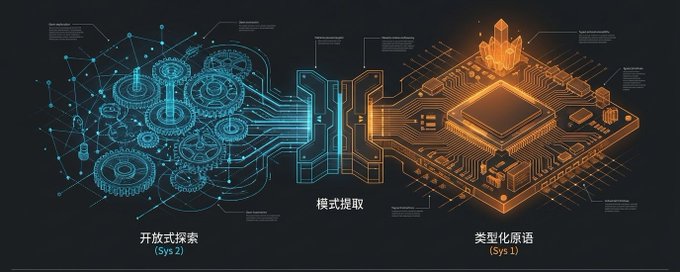
文章探讨 Jev 这类'认知 ASIC'式类型决策模型的意义。作者指出传统 LLM 的直觉只是符号层面的 System 1,与人类根植于具身经验的直觉存在本质断裂;CoT 推理模型则是显式展开的符号 System 2。Jev 将高频、受 Schema 约束的判断从语言生成中剥离,编译为强类型决策原语,实现低延迟确定性收敛,类比 CPU 与 ASIC 的分工。文章进一步论证 Agent 虽有因果介入权却缺乏不可逆的生存代价,无法产生真实品味,因此需构建价值声明治理体系,守住人类主体经验的溯源锚点。

零字废话|Jev 接入Grok Bot 方法及使用场景

文章介绍了如何将 TypeSafe 的轻量分类模型 Jev 接入 Grok Bot:包括申请 API Key、通过安全卡片保存密钥、安装 SDK 并测试调用,最后将流程保存为 Skill 复用。作者强调并非工具越多越好,在自己早期游戏项目中接入 Jev 属于负优化,并给出两个适合的场景:一是 Bot 挂载 Skill 过多时让 Jev 先筛候选(官方测试错误率从16.8%降至7.3%),二是搜索结果排序(正确段落进入前十比例从38%提升到62%)。最后建议判断标准是:多接一个模型到底改变了什么。

技术 › Agent 刘屿之外 2026-09-217.5 KB 27.3K 65 80

保姆级讲解|从0到1带你了解最近爆火的Jev模型到底是什么?

文章介绍了TypeSafe AI推出的专用判断模型Jev及其背后的System One Models理念。与通用大语言模型逐token生成不同,Jev专注于答案范围明确的判断任务,提供Choice(选择)、Score(打分)、Noul(概率判断)三种能力,可并行输出多项判断及概率,大幅降低响应时间和调用成本。作者以电商评论处理为例演示了三个特性的用法,并指出Jev与大语言模型是互补关系:判断、分类、打分等环节交给Jev,复杂推理和内容生成仍由大模型承担。这种专用化思路对Agent系统(Harness)友好,有望开辟AI模型分工的新赛道。

技术 › LLM 金尘马 2026-09-2115.7 KB 137.4K 247 80

Jev 猛蹬教程:通过 Vercel AI Gateway 免费接入 Jev 及 7 个开源应用案例

文章介绍如何通过 Vercel AI Gateway 的 key 免费调用 TypeSafe 的 Jev 模型,无需白名单。作者列举了 7 个开源应用案例:浏览器自动化查找机票、Android 手机自动操作打车、Agent 上下文压缩节省 token、用 Jev 核对任务完成声明的 MCP 工具、PostgreSQL 扩展按语义筛选客户流失记录、工具调用前的自动审批流程、以及多模型自动路由分发任务。最后给出接入教程:登录 Vercel、创建 Gateway key、让编程 Agent 完成调用配置。

技术 › LLM 0x 哆啦A梦 2026-09-218.4 KB 14.1K 75 76

Jev 新手指南:System One 判断型模型入门

本文是 Jev(一个通用 System One 模型)的新手指南。Jev 专为快速、聚焦的判断设计,而非长推理或开放式写作。用户给它提供上下文(状态)和决策表(问题),它返回结构化答案及不确定性概率。答案类型包括 Choice(单选)、Noul(是/否概率)和 Score(有序打分),可一次请求多个互不影响的问题。文章介绍了 Jev Playground 中的六个用例,如支持工单分流、模型路由、Agent 工具调用守卫、智能家居请求等,并强调最终决策应由代码完成:设置阈值、硬规则和权限判断。Jev 适合重复性、答案有界的判断场景,但在算术、计数、日期、对抗性输入等方面表现不均,需谨慎使用。

技术 › LLM elvis 2026-09-215.9 KB 130.3K 927 72

用开源实时 ASR 模型 Confucius4-R2T2 + Jev 平替英语流利说

作者介绍网易有道开源的实时流式 ASR 模型 Confucius4-R2T2 与 Jev 模型组合,可平替英语流利说的口语评测功能。R2T2 是真流式模型,以 160ms 间隔输出且具备 stable prefix 机制,保证已提交文本不被修改;Jev 则快速判断文本层面的漏读、多读和错读类型。两模型均为开源,可在 NVIDIA 显卡本地部署,适合在家朗读练习。作者也指出当前方案仅限文本层面纠错,读音纠错需接入音标识别模型,应对语序跳跃、替换词等复杂场景仍需更深入的声学模型支持。

技术 › LLM WquGuru (@wquguru) 2026-09-212.9 KB 75

新模型 Jev 爆火,5 天挤进 14 万开发者:快 200 倍、便宜 400 倍

文章介绍了发布即爆火的新模型 Jev(TypeSafe 公司出品),它不生成文本,只做判断:路由、分类、打分、审核。相比大模型,它判断速度快 40-200 倍(0.1 秒级),成本便宜约 400 倍,且因输出限定在预定义选项内而不存在幻觉空间。创始人 Diogo Almeida 是前 OpenAI 研究员。文章给出了三条免费或低成本使用方式(OpenJev、官方 waitlist、OpenRouter),并冷静指出官方数据的局限:444 倍提升是评测上限,第三方实测准确率约 68%。Jev 定位为给大模型打配角的 System One 模型,适合 Agent 场景中的高频小判断。
技术 › LLM 路飞 2026-09-207.9 KB 62.4K 76 83

我把 JEV、GrokBot、X 玩到了一起

作者介绍了 TypeSafe 推出的 Jev(业内称 System One),一个快速判断模型:输入状态和固定题目,仅返回选项、分数或概率并带置信度,延迟约 70-500ms。作者将 Jev 与 Grok Bot 结合:Grok Bot 负责抓取时间线、读提及、执行动作等重活,Jev 负责快速分流判断(值不值得管、急不急、是不是广告等)。作者以盯 X 时间线为例,对每条帖子跑四问测试,平均耗时约 235ms,下一步判断 8/8 正确。作者提醒不要神化 Jev,其 confidence 不等于统计准确率,敏感操作仍需人工把关。核心思路:Jev 管判,Grok Bot 管干。
技术 › Agent 蓝哥AI 2026-09-204.4 KB 84.6K 84 74

Jev、System One 模型与计算机使用的未来

文章探讨 Cua 团队基于 TypeSafe 发布的 System One 模型 Jev 的实验。Jev 不做开放式文本生成,而是提供决策接口:输入上下文和候选选项,返回类型化决策(Choice、Score、Noul 三种原语)。作者分析在 computer-use agent 中,表单填写等局部决策并不都需要通用 LLM 完成,可将应用观察状态、构建候选动作,由模型评分选择,再由应用验证执行的循环架构。文中还讨论了纯文本决策模型如何借助 OmniParser 等感知模块将截图转为结构化元素,以及 Kahneman 快慢思维类比在模型分类中的局限。

技术 › Agent Cua 2026-09-2014.4 KB 74.5K 569 76

全网刷屏的 Jev 到底怎么用?8 个能直接抄的案例

本文介绍了 AI 圈新火的模型 Jev——一个不做文本生成、只返回带概率判断的决策模型。文章讲清了它的三种用法(是非判断、选项选择、打分),提供了四种 30 分钟内可上手的接入方式(官方 Skill、Vercel、OpenRouter、SDK),并整理了 8 个可直接复用的真实案例:7 秒订机票、代码审查、工单分流、简历初筛、语义搜索、AI Agent 路由、RAG 重排、动态 UI 拼装等。还总结了 5 个反直觉要点(不写字、零幻觉指格式而非正确性、不会拒绝等)、官方自曝的雷区(不会算术、不懂日期先后、易被提示词注入),以及不适合使用的场景。

技术 › LLM Leaf Yeah! 2026-09-2016.8 KB 131.8K 279 86

别人看发布会我跑数据:六组实验五个开源仓库,Jev 的真实边界全在这

作者通过六组实验和五个开源仓库实测 TypeSafe 发布的 Jev 模型的真实能力边界。Jev 是只回答封闭问题、一次前向返回概率分布的模型。核心结论:Jev 适用于信号在语义中的场景(如泰坦尼克 0.83 AUC),对纯统计信号数据(如哈希 CTR 数据)无效;零样本表现相当于 150-500 条标注数据;最佳用法是作为特征融入已有模型而非单独使用,五个项目均获显著提升。作者还总结了问法即超参数、汇总预警取决于时间尺度、情绪分析无用等六条经验,以及评审循环偏差、真值精度等评测教训。

技术 › LLM Jason Zhu 2026-09-1917.6 KB 7.8K 51 86

Jev 模型从 0 到 1 小白教程

本文介绍了 TypeSafe AI 公司发布的新模型 Jev。Jev 由前 OpenAI 研究员、RLHF 共同发明者 Diogo Almeida 打造,它不会聊天,只做结构化判断,像流水线上的质检员。Jev 通过'填表'方式解决大模型自由文本输出带来的不可控问题,支持单选、评级、判断三种题型,且自带 confidence 置信度,可按把握度决定自动处理、人工确认或转人工。它比同级大模型快约 200 倍、便宜约 400 倍,适合客服分流、内容审核、简历筛选、AI 输出质检和数据清洗等自动化场景。文章还讲解了如何把大问题拆解为具体小问题来使用 Jev。

技术 › LLM 黄小木 2026-09-1913.4 KB 977.9K 1.2K 85

拿到 Jev,然后呢?剔掉虚火之后的一份真实落地清单

TypeSafe AI 于 2026 年 9 月发布的 Jev 是一个只做选择题的 AI 模型(单选、打分、是/否),响应 0.07–0.5 秒、输入价格极低、输出免费。作者梳理了官方数据及 Hacker News 上的质疑,指出“Jev 取代大模型”是伪命题,其合理定位是高频、低价地执行小判断。文章按用途分类整理了已真实跑通的案例:为 AI Agent 当决策器、海量数据分类、高低置信度分流混合架构、实时反应界面和仿真实验,并列举了已接入的商业产品。作者还分享了自己四次失败的集成尝试与两轮实测结论,强调概率校准的重要性。

技术 › LLM huangserva 2026-09-1922.2 KB 552.7K 840 85

Behind Jev: Two Hypotheses About Its Base Model

文章探讨 TypeSafe 公司 Jev 决策 API 背后可能的基础模型架构,提出两种假设:一是 BERT 风格的双向编码器,二是去掉生成循环、直接输出决策概率的因果解码器。作者引用 Archer Hume 基于约一万次 API 调用的逆向分析,认为其可能是带共享状态计算、独立问题分支和直接概率读出的因果 Transformer,甚至可能是 MoE 架构,但其研究无法区分编码器与解码器。文章还通过 OpenJev 等开源项目(基于冻结的 Qwen3.5-4B 权重)证明使用因果模型骨干做直接决策打分在技术上可行,并讨论了因果注意力、前缀缓存等工程优势。作者强调这些都是架构假设,不能确定 Jev 的真实权重来源。

技术 › LLM Roy Chen 2026-09-1911.5 KB 45.6K 123 74

Jev 模型实测:新闻分类任务上的速度、质量与价格三赢

作者分享了使用新模型 Jev 对《人民日报》新闻进行湖北相关元素分类的实测体验。此前该项目一直使用 Gemini Flash Lite 系列,积累约 2.4 万条数据。通过 OpenRouter 上线 Jev 后用相同提示词对比测试:速度上单篇耗时从 3 秒降至 0.35 秒,提升近 10 倍;质量上与 Flash Lite 仅 15% 判断不一致,且差异多源于人名知识库差异,实际正确率约 95%;价格上处理 5 千条数据 30M Token 仅花费 1 美元。作者认为 Jev 代表的分类器大模型在分类场景下实现了速度/质量/价格的不可能三角,极具前景,并计划连夜用于优化生产项目。

技术 › LLM 李不凯正在研究 (@libukai) 2026-09-195.0 KB 75

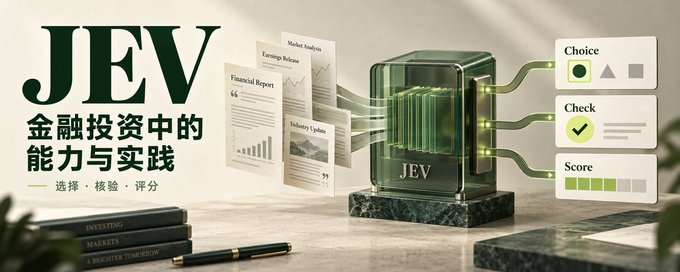
Jev 在金融投资场景中的能力及应用实践

作者围绕新模型 Jev 在金融投资领域的应用做了几千次真实 API 调用测试,估算模型费用约 0.05 美元。文章梳理了推特上多个热门应用案例:交易机器人、价格预测、SEC 公告筛选、期货短线交易、代币风险筛查等,并分析了各自优劣。作者认为 Jev 不适合生成完整研报,更适合作为核验检查步骤:区分预计收入与已实现收入、识别数据口径错误、去重消息、发现交易动作与用户意图冲突等。文章还介绍了 Jev 与主模型配合的流程设计、缓存与成本考量,给出了基于 TypeSafe Playground 的上手实验建议。作者用 104 条合成样本测试,99 条符合预设,提醒速度可试研究辅助但不能承诺交易执行,最后透露正在开发期权策略选择器。

技术 › LLM Z ZW 2026-09-1910.5 KB 81

一文解密 Jev:一个不聊天的模型,为什么突然火了?

TypeSafe AI 于2026年9月发布的 Jev 是一个不做对话和内容生成的专用判断模型,主打低成本、高速度地解决软件中的小型理解判断任务,如工单分类、优先级评分和概率判断,提供 Choice、Score、Noul 三种能力。其极低价格(每百万输入token 0.042美元)和 Vercel、Netlify 的快速接入引发开发者关注。文章分析了其'零幻觉'宣传的真实含义、评测数字的适用边界,并指出 Jev 的价值在于与生成式模型、程序和人分工协作,让软件能以低成本读懂小问题。

技术 › LLM Ray Wang 2026-09-1913.2 KB 19.4K 96 78

火爆全网的Jev到底是什么?

文章介绍了旧金山创业公司 TypeSafe 推出的闭源基础模型 Jev。它不做文本生成,只做判断题、选择题和打分题,输出严格限定在预设选项内,可在约100毫秒内出结果,成本极低。其核心技术是通过 RLCD 强化学习实现概率校准,类似于卡尼曼所说的 System 1 快思考,与传统大模型的慢思考互补。文章展示了社区应用案例,如浏览器 Agent、游戏实时决策、LangChain 工具路由、AI 输出审核等,也指出其在数数、算数、多跳推理和中文上的短板及提示词注入风险,认为 AI 调用正在走向分层架构。

技术 › LLM 泊舟 2026-09-1913.9 KB 134.9K 549 80

Will TypeSafe's Jev change how we build AI applications?

文章分析了 TypeSafe 发布的新模型 Jev——一种只能做分类、评分和路由决策、不能生成文本的'System One'模型。Jev 比通用 LLM 快 40-200 倍、便宜 40-400 倍,通过 RLCD 训练方法实现零样本概率判断。早期独立测试显示其准确率接近 GPT-5.6 等大模型,垃圾邮件分类甚至可媲美有标注训练的分类器。代价是失去了解释能力,无法说明判断理由。作者认为这可能改变 AI 应用架构:用 Jev 做大规模廉价监控评估,用 LLM 判官处理少量样本以获取改进方向信号。

技术 › LLM Aparna Dhinakaran 2026-09-1912.8 KB 15.2K 202 78