Kimi K3 memory savings vs Jevon's paradox
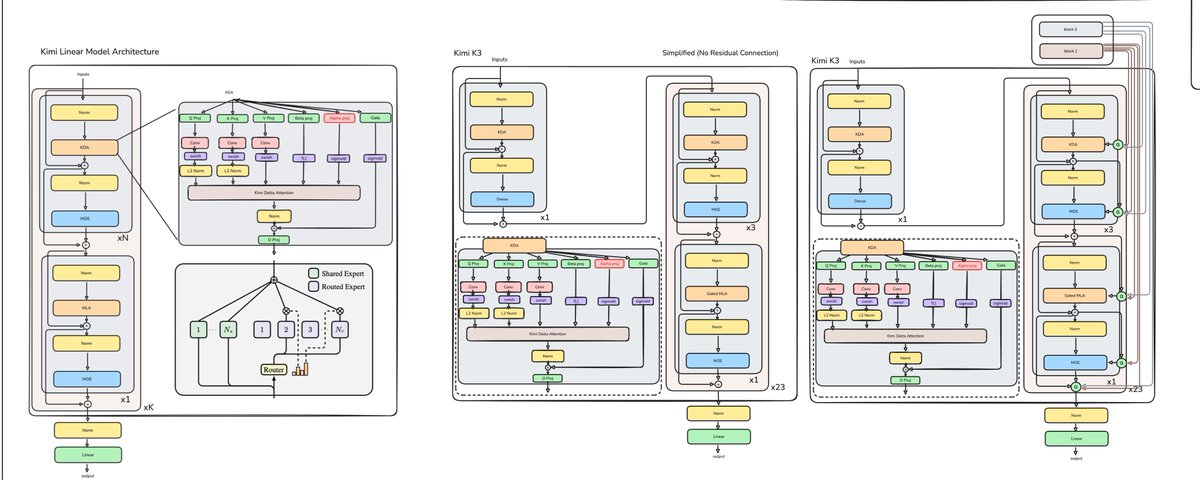
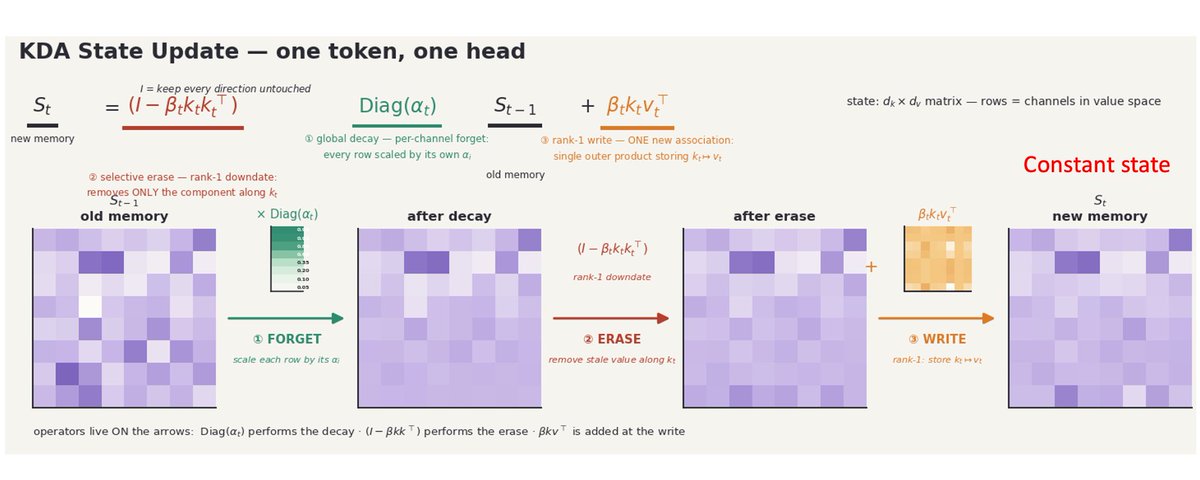
本文深入分析了Kimi K3通过Kimi Delta Attention (KDA)技术实现的内存节省突破,对比了传统MLA和DeepSeek的架构,讨论了其在长上下文场景中的优势及对行业的影响。
本文深入分析了Kimi K3通过Kimi Delta Attention (KDA)技术实现的内存节省突破,对比了传统MLA和DeepSeek的架构,讨论了其在长上下文场景中的优势及对行业的影响。
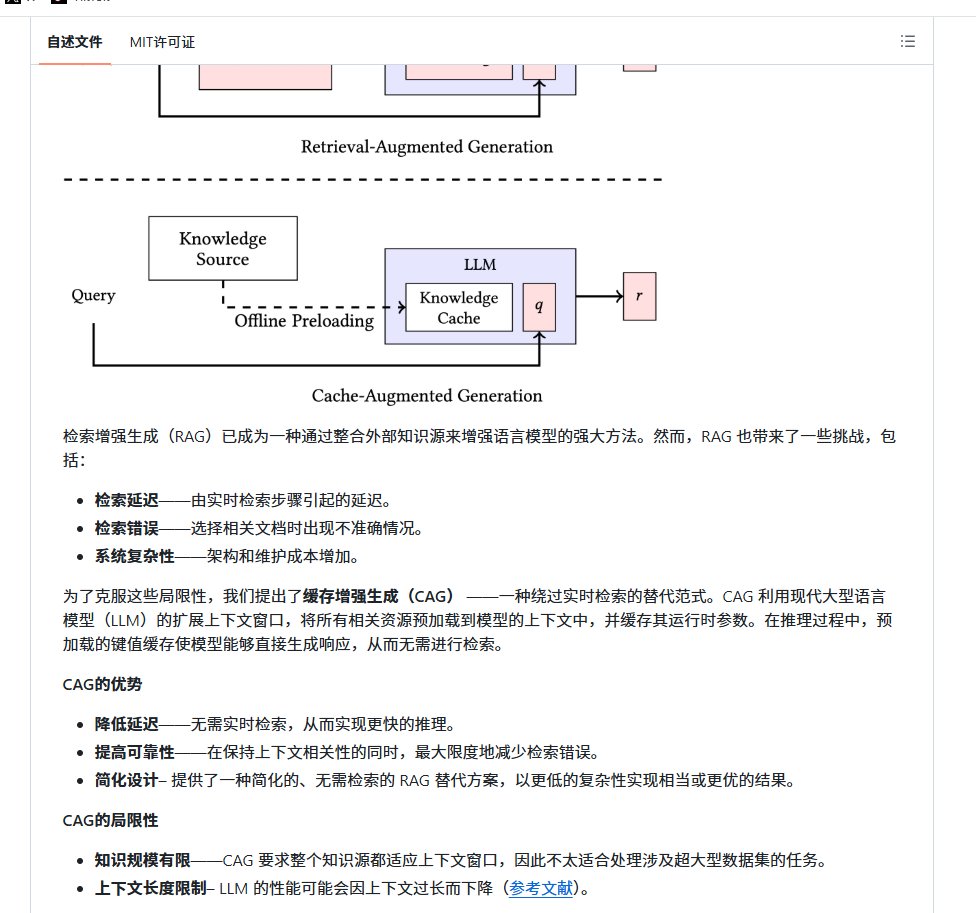
文章介绍了缓存增强生成(CAG)作为一种替代经典RAG流水线的新方案。CAG通过将全部知识预加载到模型上下文并缓存KV Cache,显著提升响应速度,解决检索延迟和召回缺失问题。适用于中短篇幅静态文档,但对大规模或频繁变动数据仍需传统RAG或混合架构。
文章回顾了从 GPT-2 (2019) 到 KimiK3 (2026) 的大语言模型架构演进,重点对比了参数规模从 1.24 亿到 2.8 万亿的巨大跨越。深入解析了 GPT-2 的 Transformer 解码器结构、KV 缓存机制,并探讨了线性注意力机制在降低计算复杂度方面的原理与权衡。
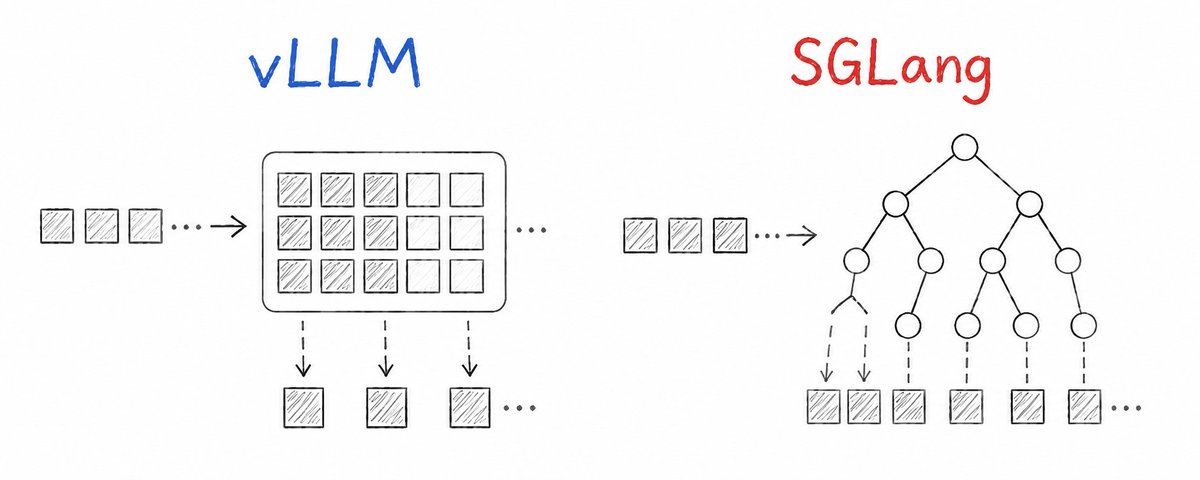
本文深入探讨了 PagedAttention 和 RadixAttention 两种技术。PagedAttention 通过类似操作系统的分页机制管理 GPU 内存,解决 KV Cache 的内部和外部碎片问题,显著提升并发处理能力。RadixAttention 则利用基数树索引缓存的前缀状态,实现跨请求的计算和内存复用,进一步优化推理性能。
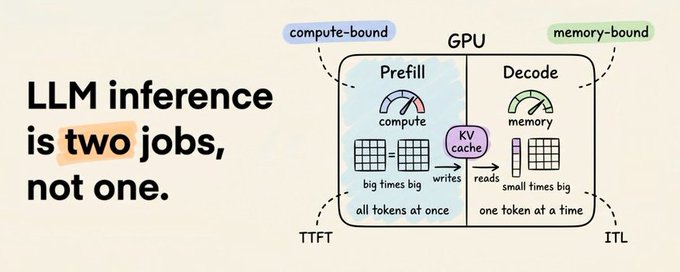
本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。
这是一份关于大语言模型(LLM)的实践指南。文章从基础循环机制出发,详细解释了文本如何转化为 Token,以及 Transformer、注意力机制、KV Cache 和 RoPE 等核心概念的工作原理。作者强调理解模型内部的推理机制(如 Prefill 和 Decode 阶段)对于硬件选型、显存估算和本地部署的重要性。文章涵盖了 Token 化、上下文窗口、量化、模型服务及本地 AI 硬件数学计算等关键主题,旨在为深入理解 LLM 提供直观的基础。
这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。
文章深入探讨了 AI Agent 遗忘信息的根本原因。作者指出,问题通常不在于检索,而在于 KV Cache 在上下文过长时的处理机制。文章对比了 StreamingLLM(仅保留近期信息)与 SnapKV(基于注意力分数保留关键信息)的区别,并解释了模型如何通过“注意力权重”来决定哪些 Token 值得被记忆,从而实现 92% 的压缩比且不丢失关键信息。
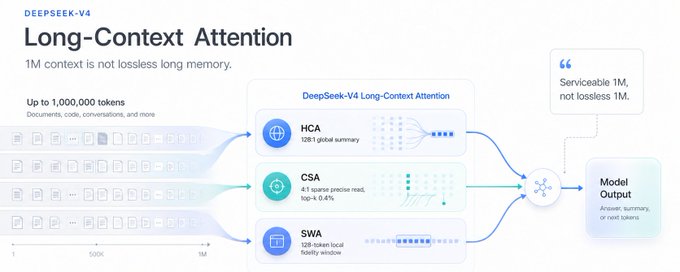
文章深入剖析了 DeepSeek-V4 如何通过 HCA、CSA 和 SWA 三通道并行架构,将 KV Cache 压缩至基线的 2%,从而实现工程上可行的 100 万 token 上下文。然而,这种极致的压缩是有代价的:MRCR 8-needle 测试准确率在 1M 长度下显著下降至 0.59。文章指出,V4 通过牺牲检索精度换取了推理成本的数量级降低,是一种‘有损的 1M’,并明确论证了该设计原理上无法完全替代 RAG 系统。
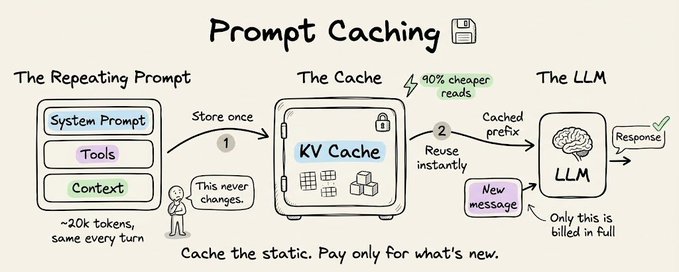
本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。
本文通过本地实验与源码分析,深入解析了大模型的 KV 缓存机制。作者从 Transformer 注意力机制讲起,解释了为何多轮对话会出现 100 倍的加速差异。通过逆向 Claude Code,揭示了 Anthropic 精密的缓存工程策略(前缀匹配、TTL 机制)。最后,给出了具体的 Claude Code 使用姿势(如保护缓存前缀、避免切换模型),帮助用户将 Token 消耗降低 80%,实现同样的套餐多干 3-5 倍的活。
文章深入探讨了LLM中的提示词缓存技术。通过区分静态前缀(如系统指令)和动态后缀(如用户消息),利用KV Cache机制避免重复计算,大幅降低长上下文任务的成本。文章以Claude Code为例,展示了如何通过保持92%的缓存命中率将成本降低81%。同时,强调了Hash缓存的脆弱性,任何微小的前缀变动都会导致缓存失效,并给出了在开发Agent时维持缓存热度的具体工程建议。
文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。