学渣的逆袭:从挂科男孩到大厂经理与跨境创业
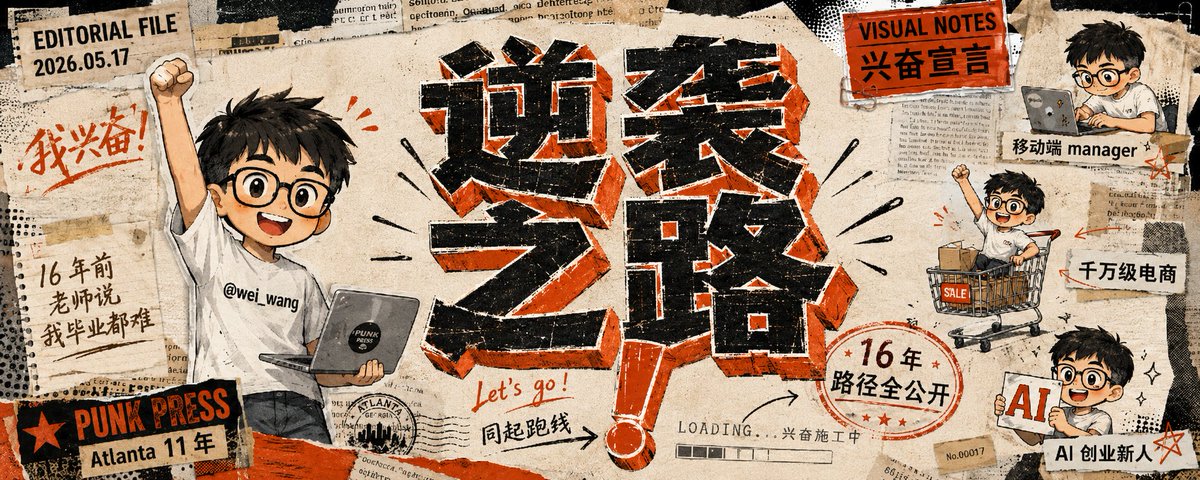
本文讲述了作者从大学挂科到成为美国大厂移动端经理、跨境电商创业者及AI探索者的逆袭经历。文章分享了从交换生、研究生到职场晋升的几个关键转折点,特别是如何利用AI浪潮在新的起跑线上寻找机会。作者鼓励普通人利用AI改变命运,探索职业与创业的新路径。
本文讲述了作者从大学挂科到成为美国大厂移动端经理、跨境电商创业者及AI探索者的逆袭经历。文章分享了从交换生、研究生到职场晋升的几个关键转折点,特别是如何利用AI浪潮在新的起跑线上寻找机会。作者鼓励普通人利用AI改变命运,探索职业与创业的新路径。
文章探讨了 AI 在长篇小说创作中的应用现状与实战案例。虽然直接使用 ChatGPT/Claude 往往导致长篇烂尾,但通过 Sudowrite、NovelCrafter 等垂直工具,结合 Muse 模型和 Codex 知识库,海外作家已实现高效产出。文中详细拆解了多位作家将写作周期从数年压缩至数周的工作流,并分析了“Shy Girl”AI 生成小说遭出版社撤稿等争议事件,指出 AI 辅助创作已成为不可忽视的趋势。
本文详细介绍了如何从零开始学习大语言模型(LLM)架构。内容涵盖了从掌握 Python 基础、理解神经网络和 Transformer 原理,到深入掌握 Tokenization、Embedding、Attention 机制及 RAG 技术等核心概念。文章还提供了具体的学习路线图,并探讨了通过自由职业、构建 SaaS 产品、远程工作及自动化代理等方式将 LLM 技能转化为高美元收入的职业路径。
本文是 Claude Code 的进阶指南,承接上篇基础配置,深入探讨了如何利用 AI 进行高强度开发。文章从上下文管理(如主动压缩、瘦身系统提示)、高级工作流(Git Worktrees、多标签页)、实战场景(PR 审查、DevOps、写作)及避坑指南四个维度,分享了 14 个实用技巧,旨在将开发者从繁琐的脏活累活中解放出来。
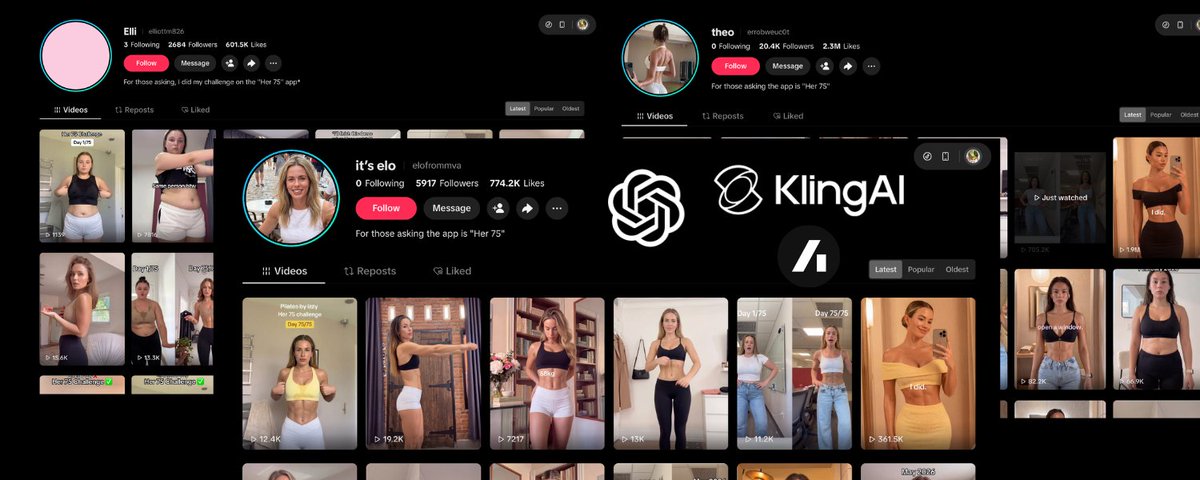
本文以一款月收入 4 万美元的健身 APP 案例切入,介绍了如何利用 AI 网红在 TikTok 进行零付费推广的实战教程。作者详细演示了使用 GPT Images 2 生成结构化 JSON 提示词以创建稳定角色的过程,并阐述了结合 Arcads 平台与 Kling 动作控制技术,将参考视频的真实动作迁移到 AI 虚拟角色上的完整工作流。该流程涵盖了从角色设计、视频合成到批量生成与筛选的 8 个步骤,旨在构建可规模化复制的 AI 内容生产引擎。
文章探讨了生成式引擎优化(GEO)的重要性。随着 AI 搜索成为用户采购决策的首选入口,品牌若不被 AI 推荐将面临巨大流量损失。文章详细对比了国内外主流 AI(如豆包、文心、ChatGPT)的内容抓取机制与引用偏好,指出国内存在“围墙花园”现象,并提供了针对性的内容优化策略与效果监测方法。
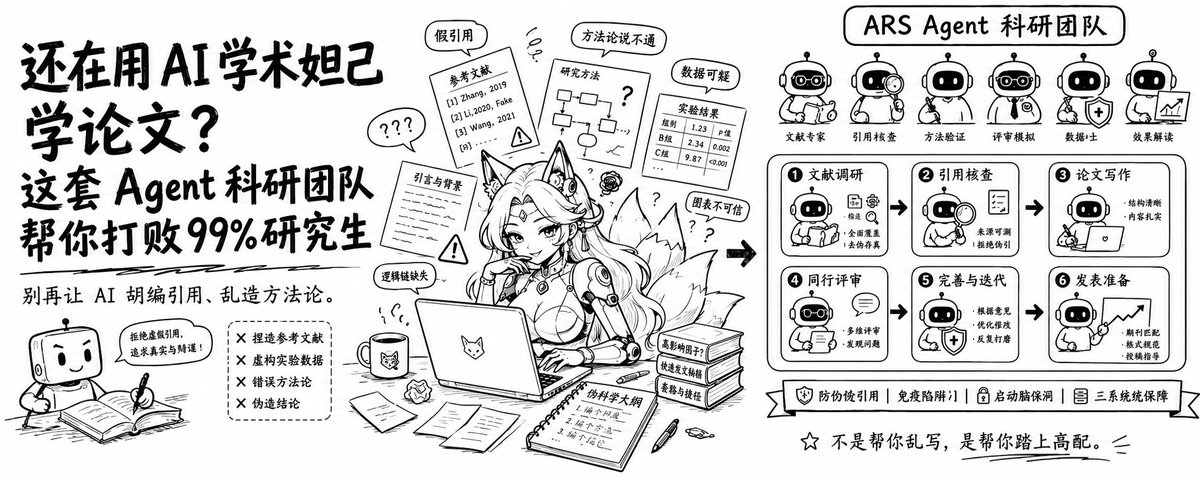
本文指出当前 AI 辅助学术论文写作中普遍存在的“幻觉”和造假问题,并介绍了一个名为 academic-research-skills (ARS) 的开源 Agent 系统。该系统通过多 Agent 协作、引用核验、反谄媚协议及完整性闸门机制,实现了从调研、写作到审稿的防出错流水线,旨在解决 AI 写作不可靠的痛点。
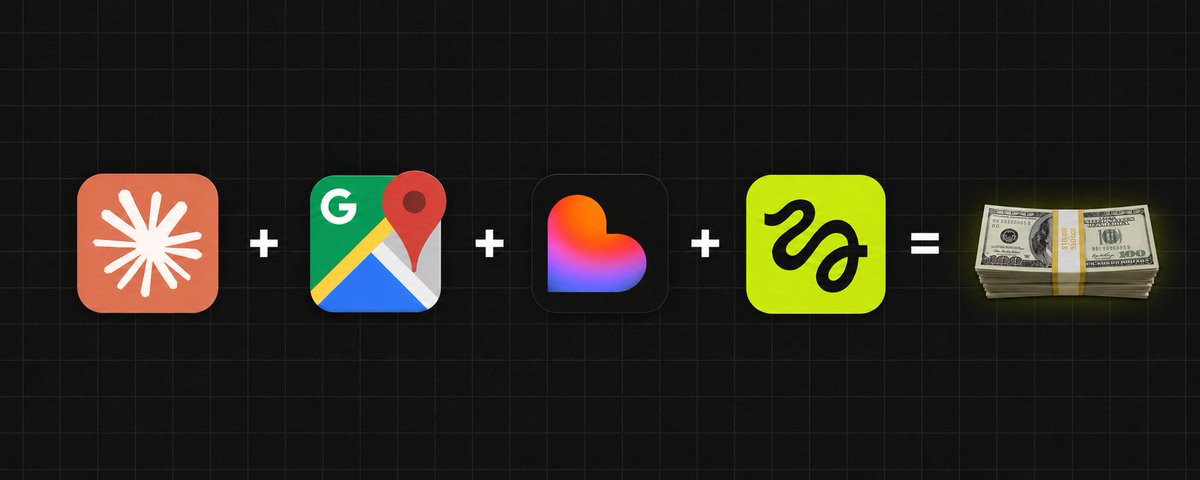
本文介绍了一套利用 Claude、Google Maps、Lovable 和 Higgsfield 等 AI 工具的组合拳,用于快速开发本地商业网站并实现冷启动获客。作者通过寻找网站糟糕的本地商家,快速生成定制化网站演示和视频,实现了高达 12-18% 的回复率和数千美元的周末收入。文章详细拆解了选客、Prompt 编写、视频制作及成交的完整流程。
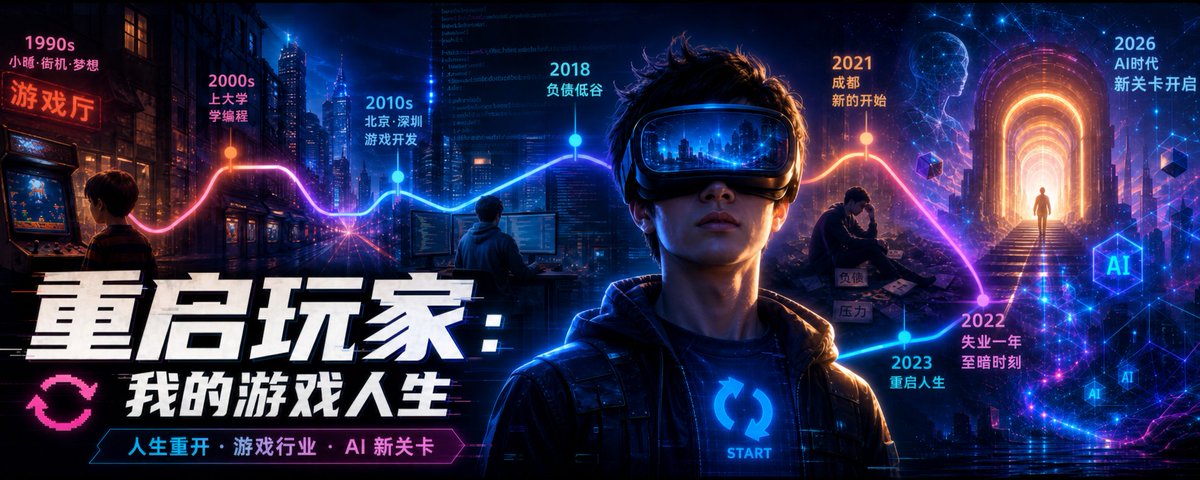
作者回顾了自己从吉林小镇到北京、深圳的职业生涯,经历了游戏行业的起伏、币圈的归零以及裁员潮。在失业一年的低谷期,通过重拾Web3意外获利。文章表达了对未来的不确定性,特别是对AI时代的思考,并决定持续记录学习心得。
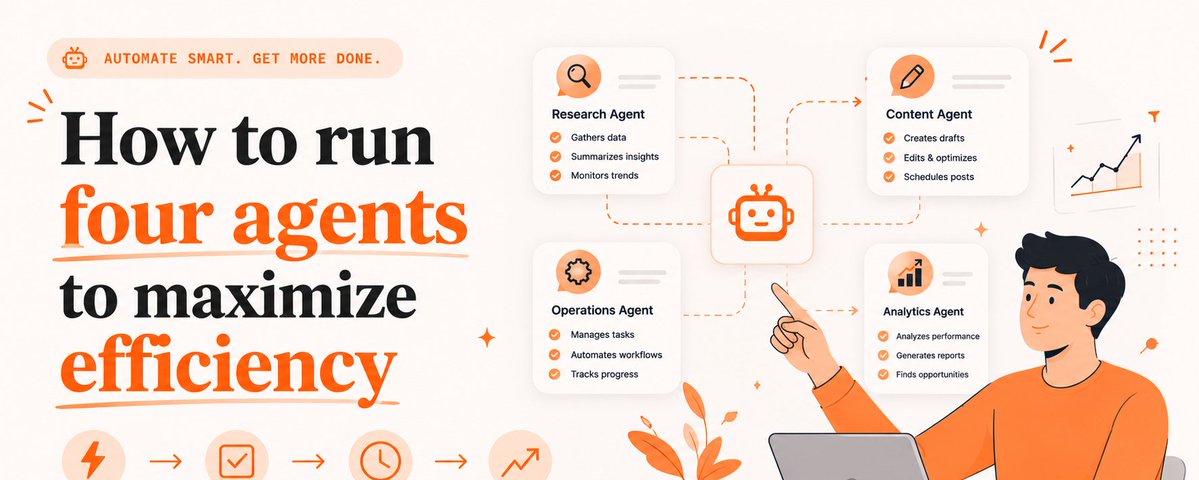
本文介绍了一种基于 Claude 的四 Agent 协作架构,通过设立专门的调研、生产、质控和分发代理,实现内容运营的自动化。文章详细阐述了为何需要拆分角色以避免上下文切换、如何搭建项目基础架构(包括 Claude Code 和文件结构),并深入讲解了调研代理和生成代理的具体配置与质量标准,旨在帮助非技术人员构建高效的内容生产系统。
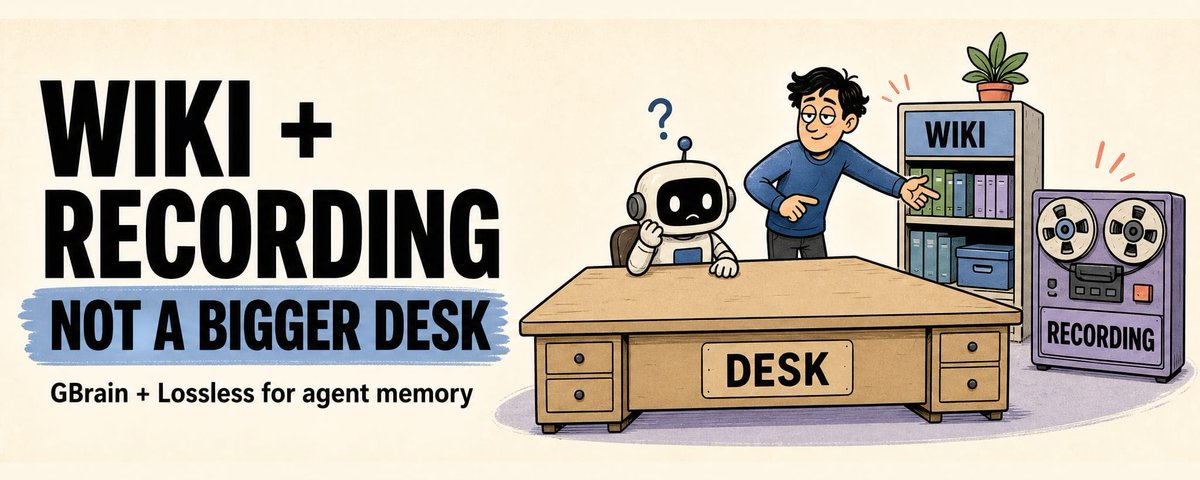
文章探讨了 AI Agent 开发中的记忆瓶颈,指出单纯扩大上下文窗口并不足以解决遗忘问题。作者提出了 GBrain 和 Lossless 两个核心模式:GBrain 像公司 Wiki,用于跨会话查询事实和决策;Lossless 像会议录音,允许在长对话中无损检索原始细节。文章详细解释了二者的区别、应用场景以及如何在 OpenClaw 和 Hermes 运行时中集成。
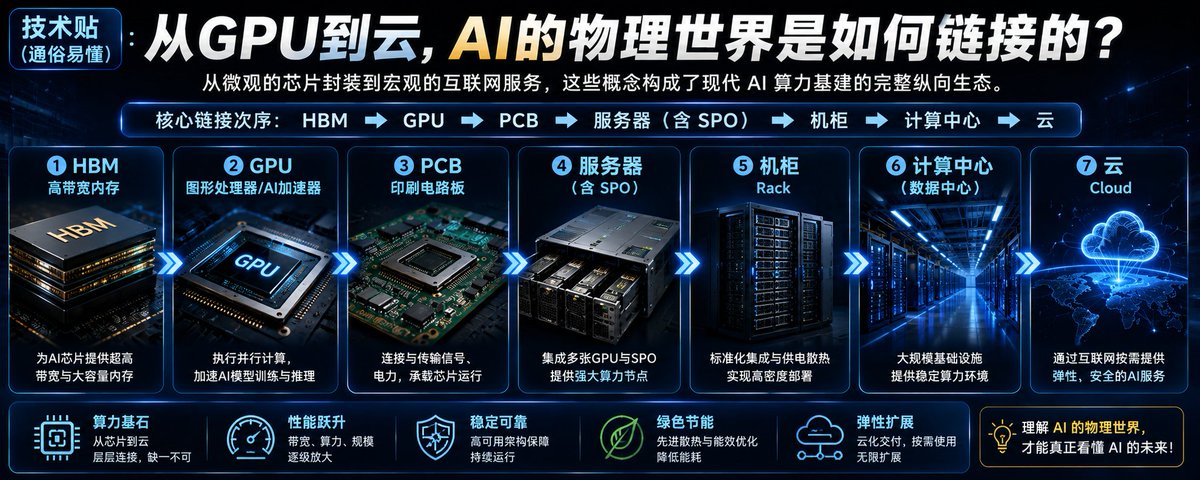
本文以通俗易懂的方式,从微观到宏观详细拆解了AI算力基础设施的物理构成。文章按照 HBM、GPU、PCB、服务器、机柜、计算中心到云的层级顺序,解析了各硬件的连接关系与核心作用,并补充了硅中介层、交换芯片、散热系统及数据中心与云的区别等关键知识点。
本文从纯小白视角出发,系统性拆解了 AI 领域的 9 个核心概念:LLM、Token、Context、RAG、Prompt、Tool、MCP、Agent 和 Agent Skill。通过生动的比喻(如将 LLM 比作发动机,MCP 比作 Type-C 接口)和清晰的逻辑链路,文章阐述了 AI 从文本生成到任务执行的底层架构,帮助读者理解 AI 的能力边界、成本构成及应用开发逻辑。
文章是一份针对 Claude Code 用户的 Pi Coding Agent 迁移与使用指南。作者对比了 Pi 与 Claude Code 的设计理念,指出 Pi 是一个更透明、可控且高度可配置的 Agent 底座。文章详细介绍了如何配置开源模型 Ring-2.6-1T,推荐了最小可用组件栈,列出了常见的配置陷阱,并通过构建现货-永续监控台的真实案例,阐述了在 Pi 环境下实施 plan-first + skill 工作流的重要性。
文章借AlphaGo与Libratus AI的决策逻辑,阐述了“状态评估”优于“预测未来”的思维模型。通过对比两位创业者的经历,指出普通人常因追逐风口而忽略自身当前状态与目标之间的可达性(转移概率)。作者强调在商业和职业选择中,应依据当前确定的信号和一手经验做决策,而非依赖宏观数据或等待虚无缥缈的确定性。
本文是《越狱提示词工程》系列的第四课,专注于解决模型在输出生成过程中的自我审查与拒绝问题。文章指出,即使解决了身份、免疫和思维轨道问题,模型仍会在逐Token生成时触发安全机制。为此,作者提出了“输出架构”策略,包括通过具体工艺标准劫持验证通道、利用篇幅和示例抢夺注意力、设置锚定循环防止漂移,以及使用暗语触发和格式护甲等手段,确保模型在生成阶段不偏离预设轨道。
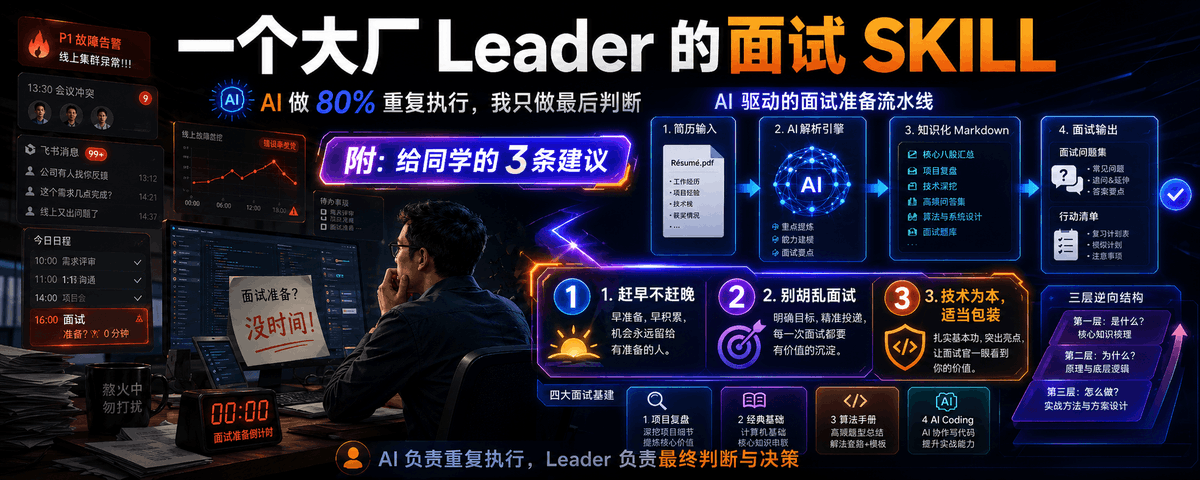
作者分享了大厂 Leader 将面试准备工程化的经验:利用 AI SKILL 自动解析简历并生成项目深挖、基础、算法及 AI Coding 四类题目,从而将个人精力从重复执行转移至核心判断与补课上。文章指出该方法虽然将准备时间优化至 20 分钟,但对面试官的追问能力和知识广度提出了更高要求。最后,作者针对暑期实习招聘给出了三条建议:把握窗口期赶早不赶晚、切忌盲目试水以免留下负面记录、以及技术为本需适当展示亮点。
文章详细介绍了如何构建一个基于 Claude 的全自动业务管理 Agent,用于在用户休息时自动处理邮件、生成报告、追踪项目和客户线索。核心架构由 Claude(智能层)、CLAUDE.md(业务上下文层)、MCP Servers(连接层)和 N8N(自动化层)组成。教程包含了具体的上下文配置模板(CLAUDE.md)、MCP 服务器配置(Gmail, Notion, Calendar 等)以及六个核心自动化工作流的实施步骤,旨在将业务运营从个人依赖转变为系统化智能运行。
OpenAI 和 Anthropic 最近发布的 /goal 功能仅解决了意图管理中的目标和结果两部分。作者提出了一套包含八个维度的框架(策略、目标、结果、健康指标、组织上下文、约束、自主边界、停止规则),主张应像领导人类团队那样领导 AI Agent,而不仅仅是设定简单的完成条件。
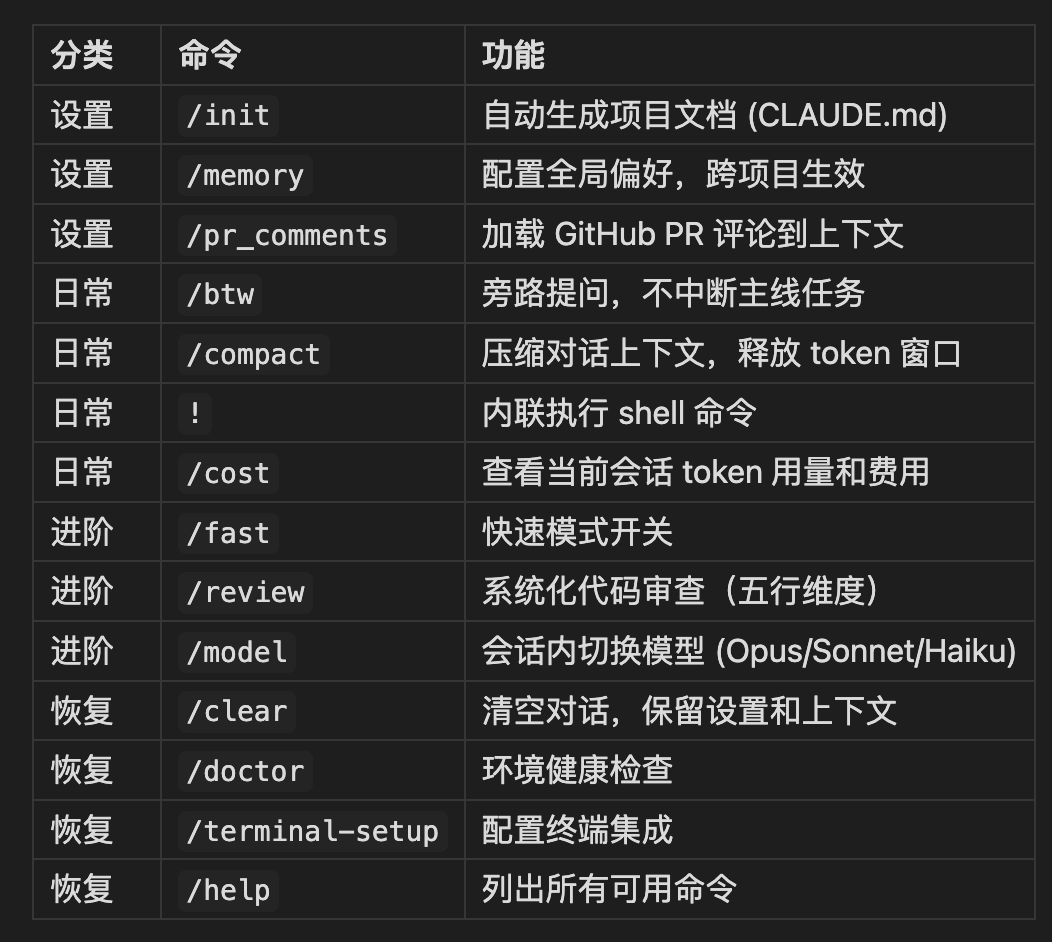
本文详细介绍了 Claude Code 的 14 条斜杠命令,将其分为一次性设置、日常高频、进阶优化和故障恢复四类。文章深入讲解了 /init、/compact、/btw、/review 等核心命令的功能与用法,并探讨了 Slash 命令与 Hook 的协同工作机制,旨在帮助开发者从简单的补全工具进阶为高效的提效神器。
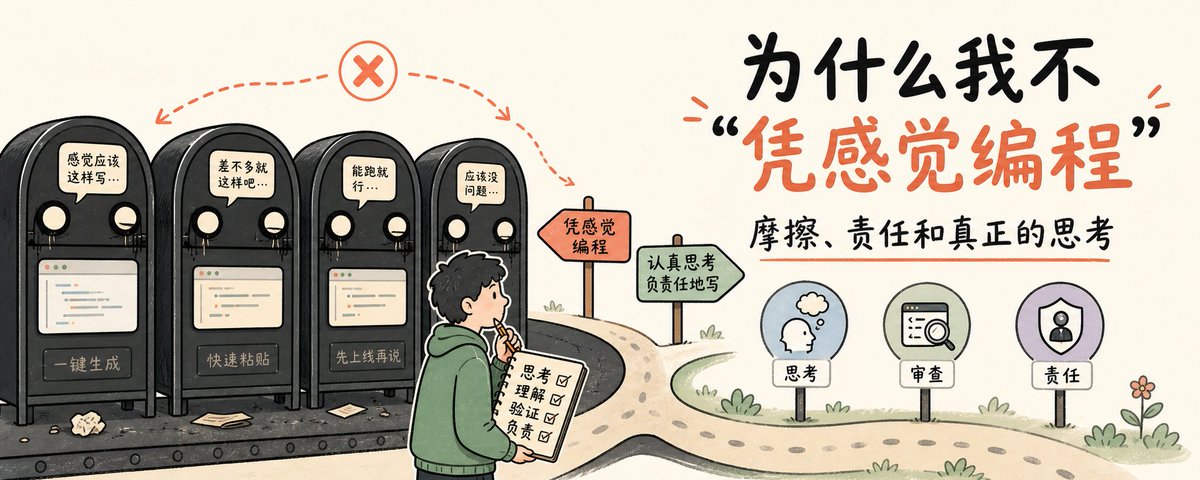
文章翻译并分享了 Jacob Harris 关于拒绝使用“凭感觉编程”(即过度依赖 LLM 辅助编程)的观点。作者从经济成本、经验主义、抽象本质、摩擦的价值以及责任感五个维度展开论述。他认为,编程是在复杂现实中建立抽象的过程,需要深度理解架构决策和承担后果,而 LLM 只能解决偶然复杂性,无法处理本质复杂性,更无法替代人类的思考与责任。
本文作者分享了其在AI领域三年的内容创作经验,总结了一套包含“获取信息、找角度、创作”三步走的实战方法论。文章强调内容的本质是“讲故事”而非简单的“信息搬运”,提倡跨领域的信息摄入(美第奇效应),并详细阐述了如何通过“反差”和“陌生化”寻找独特视角,以及如何利用喜剧和电影的节奏理论优化内容结构。文末还分享了公众号运营的四个核心数据指标,强调正向价值观的重要性。
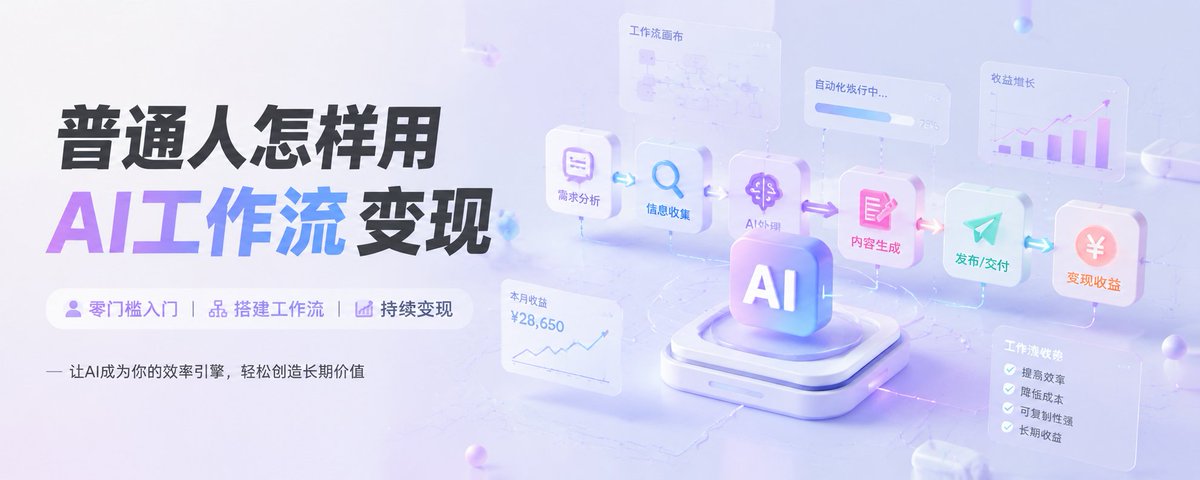
文章探讨了普通人如何通过构建AI自动化工作流实现变现。核心观点是将AI视为代劳服务,而非单纯卖模型或提示词。作者建议从业者选择细分行业,针对高频、重复、有固定格式的任务(如房产文案、律所摘要等),通过Demo快速验证需求,并将服务拆分为单点自动化、流程搭建和持续托管三个层级。文章强调交付后要沉淀模板以实现复用,从而将一次性服务转化为可规模化的产品化服务。
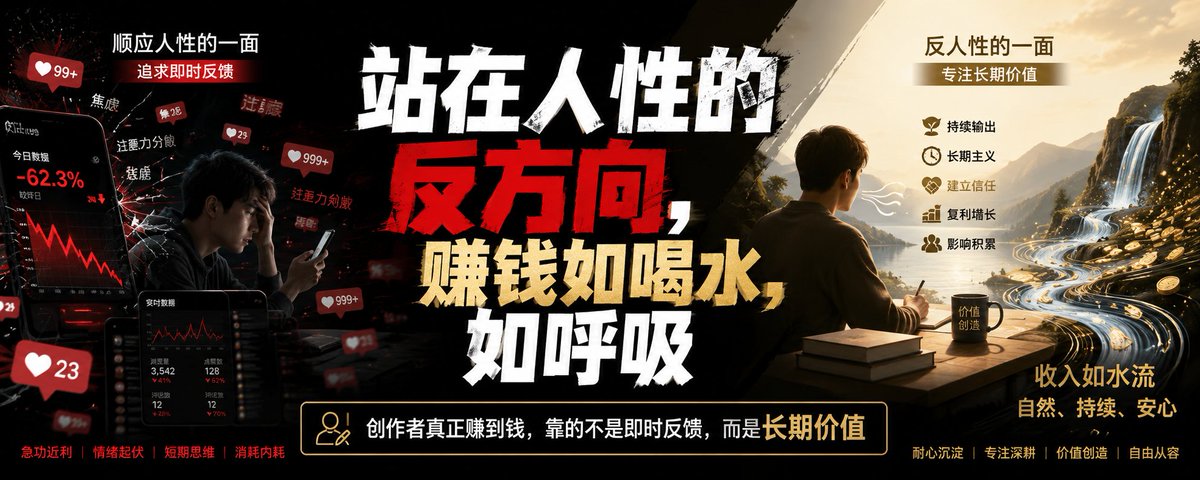
文章探讨了内容创作者如何通过克服“追求即时反馈”的人性弱点来实现长期盈利。作者指出,公众号赚的是信任,抖音赚的是注意力转化,而X赚的是观点连接。真正的赚钱源于持续的价值输出和长期资产的积累,而非平台流量本身。创作者需忍受初期的低反馈,建立清晰的账号主线,将平台视为训练场而非提款机,最终通过复利效应让赚钱变得像呼吸一样自然。
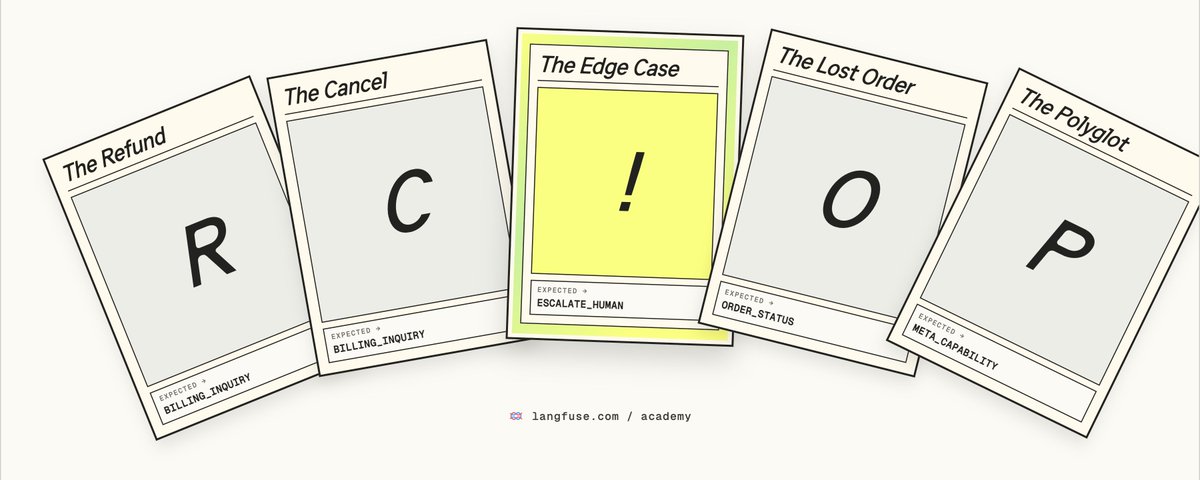
本文是 Langfuse Academy 系列的一部分,深入探讨了 AI 工程生命周期中的数据集设计。文章解释了数据集如何连接生产监控与开发迭代,详细介绍了数据集项的三个核心字段(输入、期望输出、元数据)及不同的评估模式。此外,文章还分享了构建高质量数据集的最佳实践,包括如何定义范围、确定规模,以及如何从生产 Trace、手工编写和合成数据中起步。
文章介绍了 Andrej Karpathy 验证过的 CLAUDE.md 配置方法,该项目在 GitHub 上获得 8.2 万星标。文章分析了开发者在使用 Claude Code 时常遇到的三个痛点:重复解释上下文、AI 擅自修改代码范围、以及缺乏持久记忆。通过在项目根目录创建包含 Defaults、Behavior 和 Memory/Stack 三个部分的 CLAUDE.md 文件,开发者可以将编码准确率从 65% 提升至 94%,并为团队节省大量因沟通和回滚错误造成的时间成本。
文章分析了基于 Hermes 的 Agent 无法实现长期自治的原因,指出问题不在于模型或提示词,而在于缺乏后台调度机制。作者详细介绍了实现 24 小时工作的四个核心组件:Gateway(后台闹钟)、Cron(定时唤醒)、Heartbeat(唤醒指令)和状态文件(上下文存储),并提供了具体的文件结构配置建议。
本文探讨了在 AI 编程时代开发者面临的认知危机。作者指出,过度依赖 AI 生成代码会导致认知能力下降和技能退化,即“认知债务”。文章引用多项研究证实,虽然 AI 能提高短期效率,但会削弱长期理解力和调试能力。作者建议调整使用 AI 的姿势,如先形成假设、先询问原理或开启学习模式,强调在“交付”与“学习”之间取得平衡,避免为了当下的速度而牺牲未来的核心竞争力。
本文是一份详尽的 Reddit 运营实操指南。文章首先从用户画像和心理层面分析了 Reddit 的商业价值,指出其用户具有高学历、高收入、厌恶营销的特征。接着,文章深入讲解了从账号防封(Shadowban 检查)、硬件隔离到 0-500 Karma 的分阶段养号策略(如“佛系活跃”、“抢前排借力”)。最后,作者分享了高阶运营技巧,强调克制发链接、通过主页简介(Bio)截流转化,以及利用 AI 辅助创作高质量干货内容,建立长期信任。
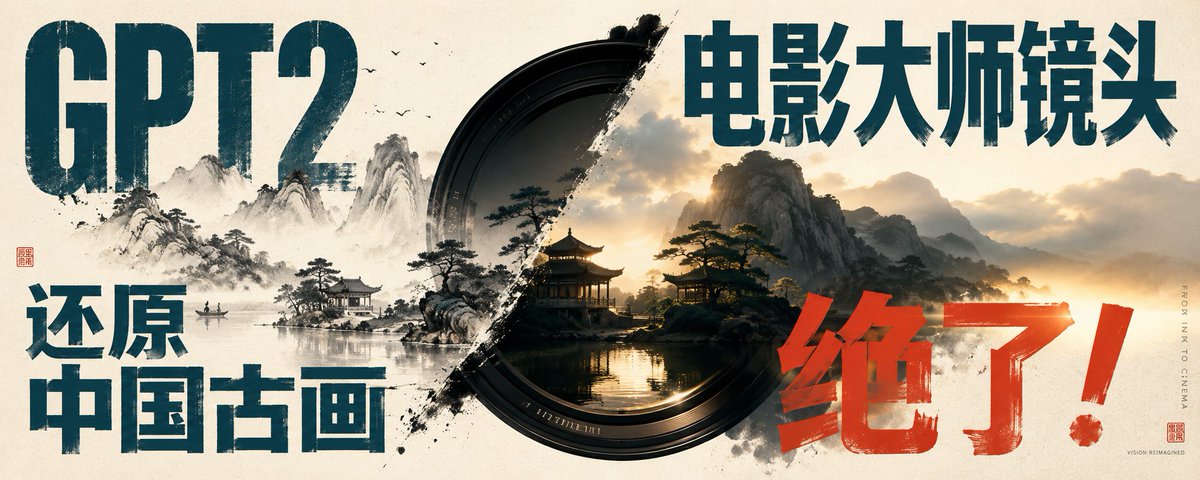
作者分享了利用GPT2模型将中国古画还原为超写实摄影作品的经验。通过精心调试,他将长达3000字的提示词浓缩至207字,实现了极佳的光影效果与美学素质,超越了市面上许多同类产品。