如何构建深度研究系统:超越 OpenAI 的开源方案
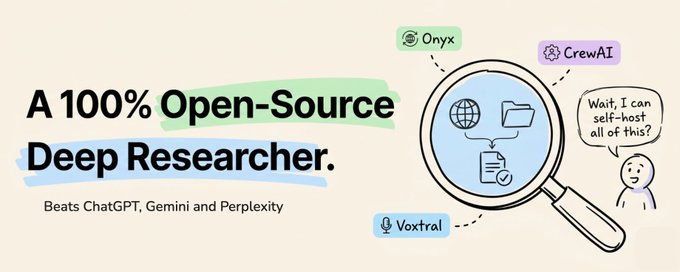
文章介绍了如何构建一个完全开源、可本地部署的深度研究系统。该系统由 Onyx(检索层)、CrewAI(编排层)和 Voxtral(语音层)组成。通过三阶段执行流程、自适应策略和六阶段检索管道,Onyx 在 DeepResearch Bench 排名第一,超越了 OpenAI 和 Gemini。文章强调了数据隐私的重要性,并详细拆解了实现高质量自我托管研究的架构细节。
文章介绍了如何构建一个完全开源、可本地部署的深度研究系统。该系统由 Onyx(检索层)、CrewAI(编排层)和 Voxtral(语音层)组成。通过三阶段执行流程、自适应策略和六阶段检索管道,Onyx 在 DeepResearch Bench 排名第一,超越了 OpenAI 和 Gemini。文章强调了数据隐私的重要性,并详细拆解了实现高质量自我托管研究的架构细节。
文章介绍了一种通过结合 NotebookLM 与 Claude 来大幅降低 Token 消耗的工作流。作者指出直接将海量数据(如 50 篇论文)塞进 Claude 对话极其昂贵且效率低下,而利用 NotebookLM 作为免费的“老师”进行语料存储和检索,让 Claude 仅负责推理与编排,可实现 17 倍以上的成本节省。文中详细解析了 RAG 与 Context 的成本差异、Prompt Cache 的局限性,并提供了针对学术论文、招股书阅读及个人知识库的具体操作指南。
文章指出,当前的 AI Agent 侧重于通过 RAG 和 API 连接工具来检索信息,但检索不等于理解。真正的企业级 AI 应像一位资深幕僚,能够综合多源数据、解决冲突、追踪时效,并建立对企业环境的动态认知(“企业大脑”)。作者提出通过构建“上下文图谱”并将其以文件系统形式输出,让 Agent 能够获得经过综合处理的深层理解,而非每次都从零开始搜索。
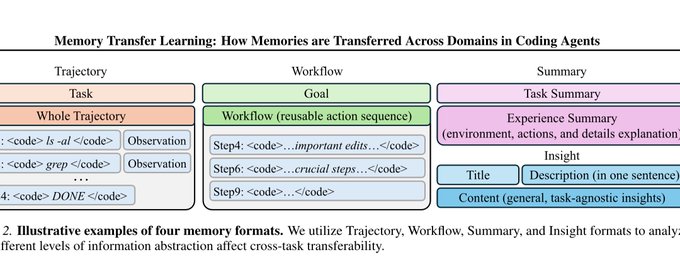
本文深入探讨了一篇关于编码智能体的 Memory Transfer Learning (MTL) 论文。文章解释了如何将过往编码任务的“记忆”复用到新任务中,比较了 Trajectory、Workflow、Summary 和 Insight 四种记忆格式的效果。研究通过在多个基准测试中复用异构记忆池,证明了提取的元知识能有效提升智能体解决新问题的能力。
本文介绍了一种利用持久化 Wiki 解决 Claude Code 上下文遗忘问题的方法。作者基于 Andrej Karpathy 的思路,阐述了通过构建 'raw' 和 'wiki' 文件夹结构,结合编译器原理,将项目知识固化为可索引的 Markdown 文件,从而避免重复消耗 Token 和时间。文章还详细介绍了 Obsidian 的配置、自动化 Hooks(如 session-start/end)的集成,以及 Wiki 与 RAG 在不同数据规模下的优劣对比,为个人开发者提供了一套高效的知识管理方案。
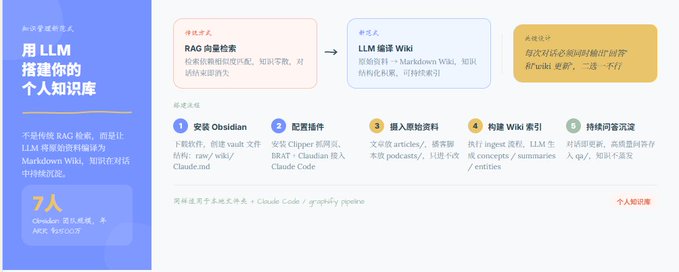
文章介绍了基于 Andrej Karpathy 思想构建的个人知识库系统,核心在于利用 LLM 将原始资料“编译”为结构化的 Wiki,而非传统的向量检索。文章详细阐述了系统的三层架构(Raw、Wiki、Agent 指令),并提供了 Obsidian 图形界面版、本地文件夹结合 Claude Code 版以及 Graphify 工具版的三种实战搭建流程,旨在实现知识的持续沉淀与跨文档关联。
文章深入探讨了 AI Agent 面临的记忆系统瓶颈:无限记忆增长(UMG)导致检索效率低下和噪声干扰,以及虚假记忆传播(FMP)利用思维链错误放大幻觉。作者指出现有的 RAG 系统因读写混合而加剧了该问题,并提出可以借鉴强化学习(RL)机制,根据任务验证结果对记忆进行奖惩打分,从而过滤无效记忆。
文章指出,企业级 AI 代理目前仅停留在信息检索阶段,缺乏对公司的深层理解。真正的智能应像资深员工一样综合多源信息,构建持续更新的现实模型。作者提出了基于文件系统交付的“企业大脑”架构,主张通过上下文图谱解决数据冲突、身份统一和信源权威性等问题,从而实现从被动检索到主动理解的转变。
文章指出直接将大量语料塞入Claude对话会导致Token消耗巨大且缓存利用率低。作者提出了一种优化方案:利用NotebookLM作为“老师”进行免费的知识库检索和带引用问答,仅将检索结果提供给Claude进行推理和编排。实测表明,该方案在研究、打新和知识库场景下可节省大量成本,但响应速度会降低。
文章对比了 Andrej Karpathy 的 LLM Wiki 方案与 Google NotebookLM 的实际使用体验。作者发现 Wiki 架构在处理个人知识时成本高、速度慢且缺乏与现实世界的集成,而 NotebookLM 利用 Embedding 技术实现了即时响应和高效回答。作者主张应将知识转化为技能并融入日常流程,而非仅仅构建静态索引。
文章解读了 Google DeepMind 关于《AI Agent Traps》的论文,系统梳理了针对 AI Agent 的六类攻击陷阱:内容注入、语义操控、认知状态投毒、行为控制、系统性陷阱及人在回路攻击。文章指出,Agent 与人类感知的“鸿沟”使其极易遭受环境篡改攻击,且这些陷阱可组合叠加,造成严重的数据泄露或控制风险。防御需从训练与推理的技术层面同时发力。
文章深入分析了 GitHub 上的 AI Agent 记忆工具,将其分为两大阵营:一是“记忆后端”,如 Mem0 和 Supermemory,主要提取事实并存储于向量数据库;二是“上下文基底”,如 OpenClaw,通过人类可读的结构化文件让会话在上下文中累积。作者指出,虽然 Camp 1 主导了市场,但 Camp 2 的架构才是支持连续、多会话工作的未来方向,例如 Zep 已开始从“记忆”转型为“上下文工程”。
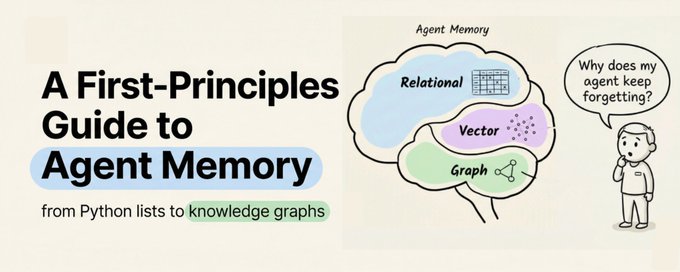
文章从第一性原理出发,深入探讨了 Agent 记忆机制的演变。作者指出单纯依赖 Context Window 会遭遇“中间迷失”效应,并借鉴认知科学将记忆分为感觉记忆、工作记忆和长时记忆。文章通过对比 Python 列表、Markdown 文件和向量搜索等不同技术层级的优劣,揭示了传统方案在持久性、语义理解和关联推理上的局限性,最终提出了结合图数据库和向量搜索的 Graph-Vector 混合解决方案。
文章详细介绍了 YC CEO Garry Tan 开源的 AI 基础设施 GBrain。这是一个为 AI Agent 设计的个人知识层,通过 Git 仓库、Postgres(pgvector)和技能文件的三层架构,解决了 Agent 无状态的痛点。文章深入解析了其搜索管道、知识模型(编译真理+时间线)及数据集成方案,并指出了其对高级模型的依赖。
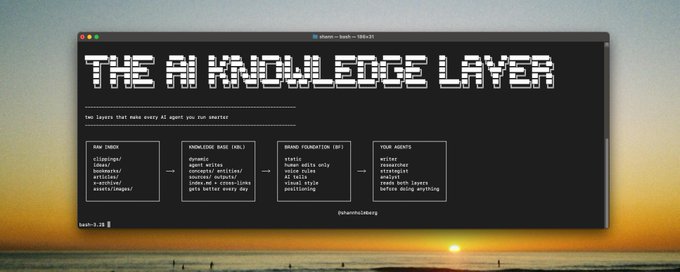
本文提出了一种让 AI 智能体变得更聪明的双层系统:AI 知识层。它包含动态的知识库层(KBL)和静态的品牌基础层(BF),通过编译而非检索(RAG)的方式,让智能体在执行任务前拥有上下文记忆。文章介绍了该系统的概念、与传统 RAG 的区别、以及如何利用开源框架 LLM Wikid 构建个人或企业的知识图谱,从而解决 AI 输出同质化、缺乏个性化的问题。
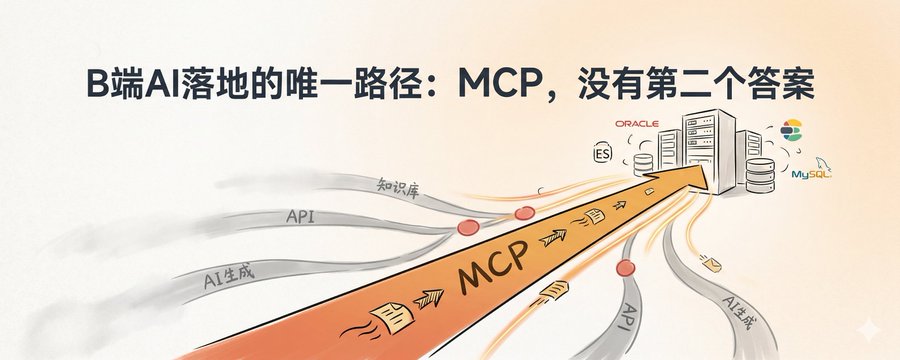
文章指出B端AI落地的核心在于数据接入。传统RAG方案因信任和延迟问题受限,AI生成查询又难以满足B端对高稳定性(99%+)的要求。作者认为,通过MCP(模型上下文协议)实现本地部署,利用标准化接口和参数化模板,是解决数据主权、降低成本并确保业务稳定性的最佳方案。
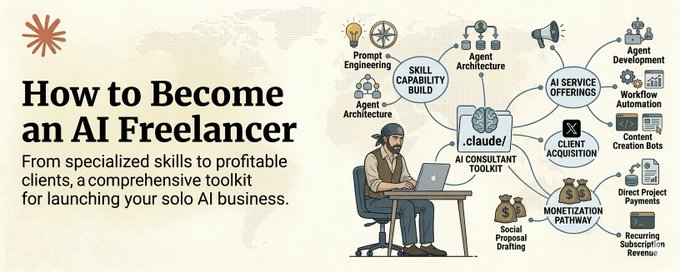
文章探讨了为何 AI 自由职业者目前能获得高溢价(200美元/小时)的原因,指出市场供需失衡创造了机会。指南详细规划了从选择细分领域、建立信任背书、设定合理定价、获取首批客户到交付与规模扩张的完整路径,强调通过提供确定性的商业价值(如 RAG、Agent 开发)来获取高薪,而非单纯的出售时间。
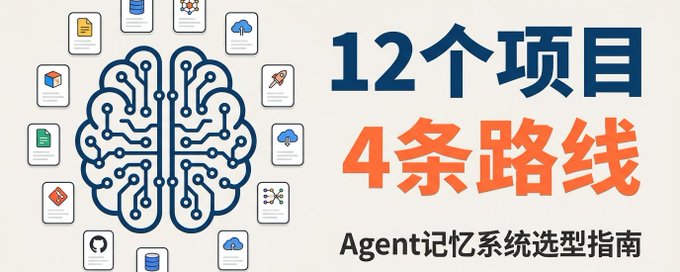
针对 LLM 无状态导致的“失忆”痛点,文章深入探讨了当前 Agent 记忆系统的四条主流技术路线:纯文件存储、向量数据库+RAG、知识图谱及混合检索。文章梳理了从轻量级 hooks 集成到企业级独立平台的 12 个开源项目,涵盖 claude-memory-compiler、agentmemory、Hermes Agent 等代表性工具,并提供了针对不同用户阶段(新手、个人开发者、团队、企业)的选型建议。作者指出,未来的核心竞争将集中在“如何遗忘”、“保证正确性”和“控制成本”三个维度。
文章深入分析了 Andrej Karpathy 提出的“LLM Knowledge Bases”概念。Karpathy 批评了当前 RAG 模式缺乏知识积累的痛点,提出由 LLM 维护的一组持久化 Markdown Wiki 作为替代方案。文章拆解了该方案的“原始资料、Wiki层、规则层”三层架构,以及“摄入、查询、健康检查”的操作模式。作者结合 EverMind Memory 的产品视角,探讨了这一模式从单次交互向积累能力转变的行业趋势,以及“Idea File”作为新知识传播单位的潜力。
文章介绍了 Karpathy 提出的 LLM Wiki 方法,旨在解决传统 RAG 检索缺乏知识沉淀的问题。作者详细演示了如何在 Obsidian 中落地该方案,包括使用插件采集素材、配置图片本地化、利用图谱视图发现盲区、结合 Dataview 生成报表、使用 Marp 制作幻灯片,以及通过 Git 进行版本管理。核心思想是让 AI 承担繁琐的整理与维护工作,人类专注于思考与决策,从而构建持久增殖的个人知识库。
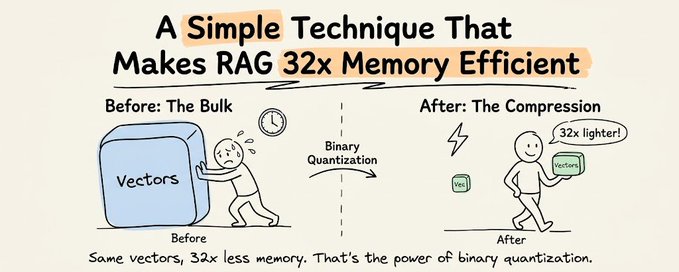
本文介绍了利用二进制量化技术将 RAG(检索增强生成)系统内存效率提高 32 倍的方法。作者以 Perplexity 和 Azure 为例,详细展示了如何使用 Llama Index、Milvus 向量数据库和 Groq 托管的 Kimi-K2 模型构建系统。该系统可在 30 毫秒内查询 3600 万个向量,并在 1 秒内生成响应。文章提供了从数据加载、生成二值嵌入、向量索引到检索生成的完整代码实现。
作者为了训练自己的 AI 管家“贾维斯”掌握 Web3 投资技能,利用 XCrawl 爬虫工具批量抓取了投资大佬 Chris Dixon 的 42 万字博客文章,并将其转化为干净的 Markdown 数据喂给 AI。文章详细介绍了从数据采集、清洗到 AI 学习框架构建的全过程,展示了如何利用 AI Agent 吸收专家知识并进行投资策略分析。
本文是一份详尽的零代码教程,指导如何利用 NotebookLM 和 Gemini 构建纳瓦尔的 AI 数字分身。全流程无需编程,涵盖了使用 Deep Research 寻找数据源、通过网页源码提取链接、利用 NotebookLM 搭建静态知识库(RAG),以及通过 Gemini 注入个性化灵魂并设置 System Prompt 的完整步骤。文末还提供了具体的验证测试用例及现成的资源包。
作者阅读了 20 多本 AI 和 LLM 工程相关书籍,筛选出了 10 本最值得推荐的书单。这些书旨在帮助开发者从理论走向实践,掌握构建、部署和维护生产级 AI 系统的技能。书单涵盖了 Chip Huyen 的《AI Engineering》、RAG 与微调实战手册、从零构建 LLM 以及 Prompt Engineering 等核心领域,适合希望转型或进阶为 AI 工程师的技术人员阅读。
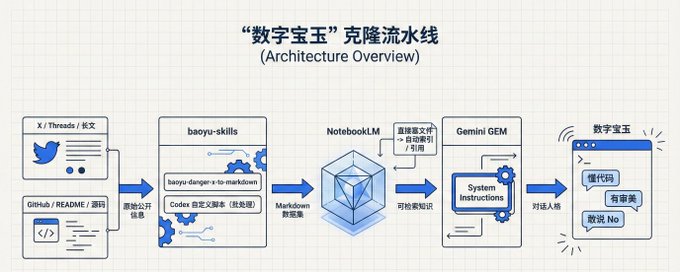
文章介绍了一种利用 AI 工具克隆特定人物数字分身的“保姆级”教程。作者以克隆技术大 V“宝玉”为例,展示了如何使用 baoyu-skills 抓取公开数据,利用 NotebookLM 进行 RAG(检索增强生成)以构建知识库,最后通过 Gemini 创建 GEM 并注入特定的 System Instructions。测试表明,该数字分身成功复刻了原作者的工程审美与批判性思维。