Developers Guide to using fewer Gemini Tokens with your Agents
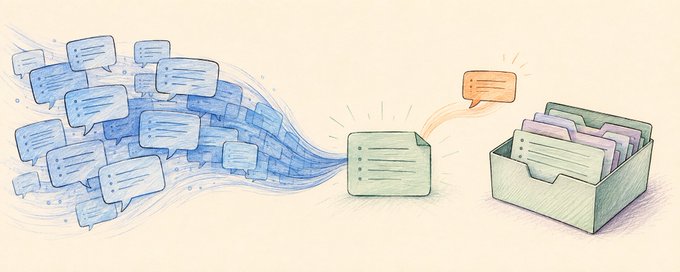
本文介绍如何通过上下文压缩代理 headroom 减少 Agent 调用 Gemini 模型时的 token 消耗。作者指出 agent 上下文中大部分 token 来自工具输出的冗余 JSON、日志和搜索结果,而非精心设计的提示词。通过在 Gemini 3.8 Flash 前部署 headroom 代理,在四种生产级 agent 工作负载测试中,prompt token 减少 76%,任务准确率保持 100%,首 token 时间有所改善,建模成本下降约 70%。文章同时诚实探讨了压缩的有损性:压缩器保留模式、分布和异常值,但会丢弃普通记录,模型在数据缺失时会拒绝编造。项目开源且可复现。