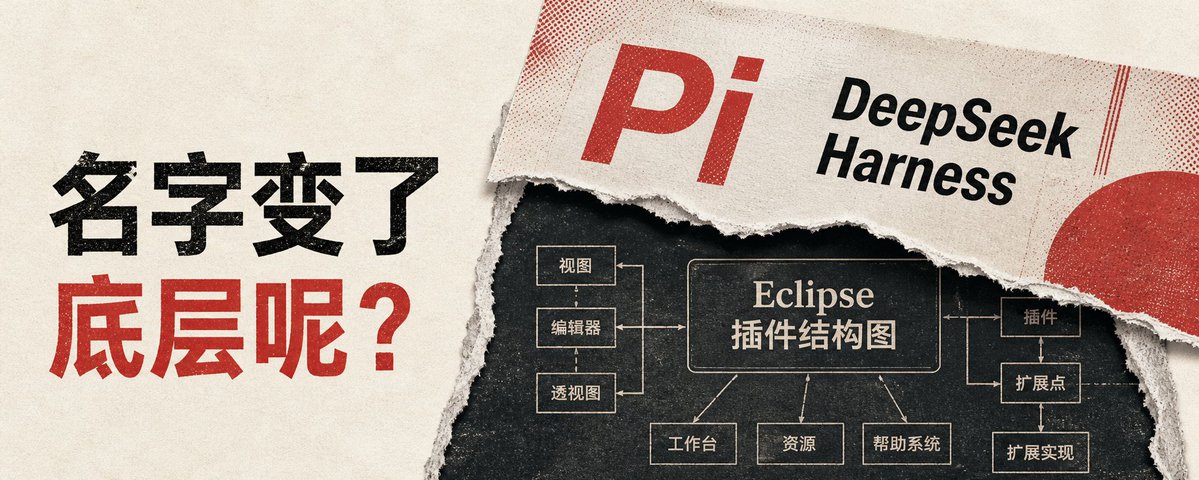
从 Pi 到 DeepSeek Harness:AI Agent 的名字变了,底层呢?
本文对比了 Pi Coding Agent 和 DeepSeek Harness 两种 AI Agent 的设计理念。Pi 采用小核心加自由组合的方式,默认仅提供四个工具,而 DeepSeek Harness 则强调“一切皆插件”,将模型、工具、会话等组件化。文章指出,这种设计并非全新,早在 Eclipse 时代就已存在,并探讨了在 AI Agent 领域,核心功能与用户选择权之间的平衡问题。
本文对比了 Pi Coding Agent 和 DeepSeek Harness 两种 AI Agent 的设计理念。Pi 采用小核心加自由组合的方式,默认仅提供四个工具,而 DeepSeek Harness 则强调“一切皆插件”,将模型、工具、会话等组件化。文章指出,这种设计并非全新,早在 Eclipse 时代就已存在,并探讨了在 AI Agent 领域,核心功能与用户选择权之间的平衡问题。
作者作为程序员,长期使用 Claude Code、Codex 等开发类 Agent,却因技术视角而忽略了普通用户需求。他将 Agent 分为个人、工作、开发三类,发现豆包和飞书分别对应个人与工作场景,弥补了他的认知盲区。文章反思了“技术的诅咒”,指出 AI 产品应封装复杂性,从用户需求出发,而非追求功能堆砌。最终总结两点:工具应服务于真实需求,设计应回归用户视角。
作者用三个真实自媒体任务(对标账号调研、内容写作、选题库搭建)实测对比WorkBuddy、千问办公和TRAE三款Agent工具。结果显示WorkBuddy三轮全胜,产出最全面可直接使用;千问办公擅长文档场景且最懂产品定位;TRAE颜值最高但排队严重、数据偏旧。核心发现是WorkBuddy和TRAE使用同一模型DeepSeek V4 Flash却结果天差地别,说明差距不在模型而在工具如何用模型。结论:工具没有高低,只有合不合适,先想清楚需求再选工具。
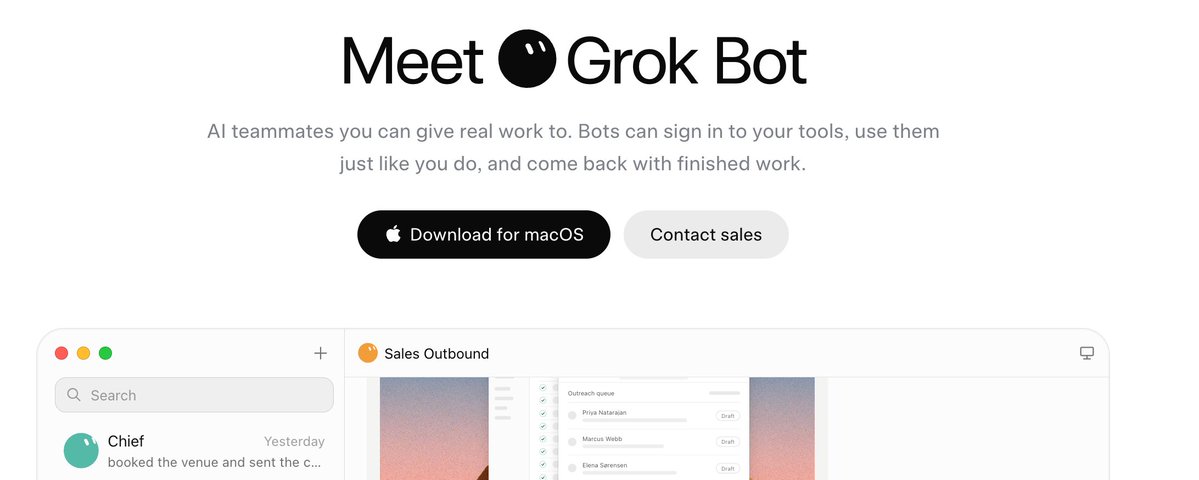
Grok Bot在公开测试48小时内,早期用户已探索出多种实际用途。本文基于X、Reddit和YouTube上的高互动帖子,总结了人们使用Grok Bot的八大场景,包括办公室管理、行政助理、生活事务处理(如日历、预订)、通过演示教学、以及作为个人助理等。文章还分享了用户的具体案例和有效提示词,展示了Grok Bot在自动化任务和提升效率方面的潜力。
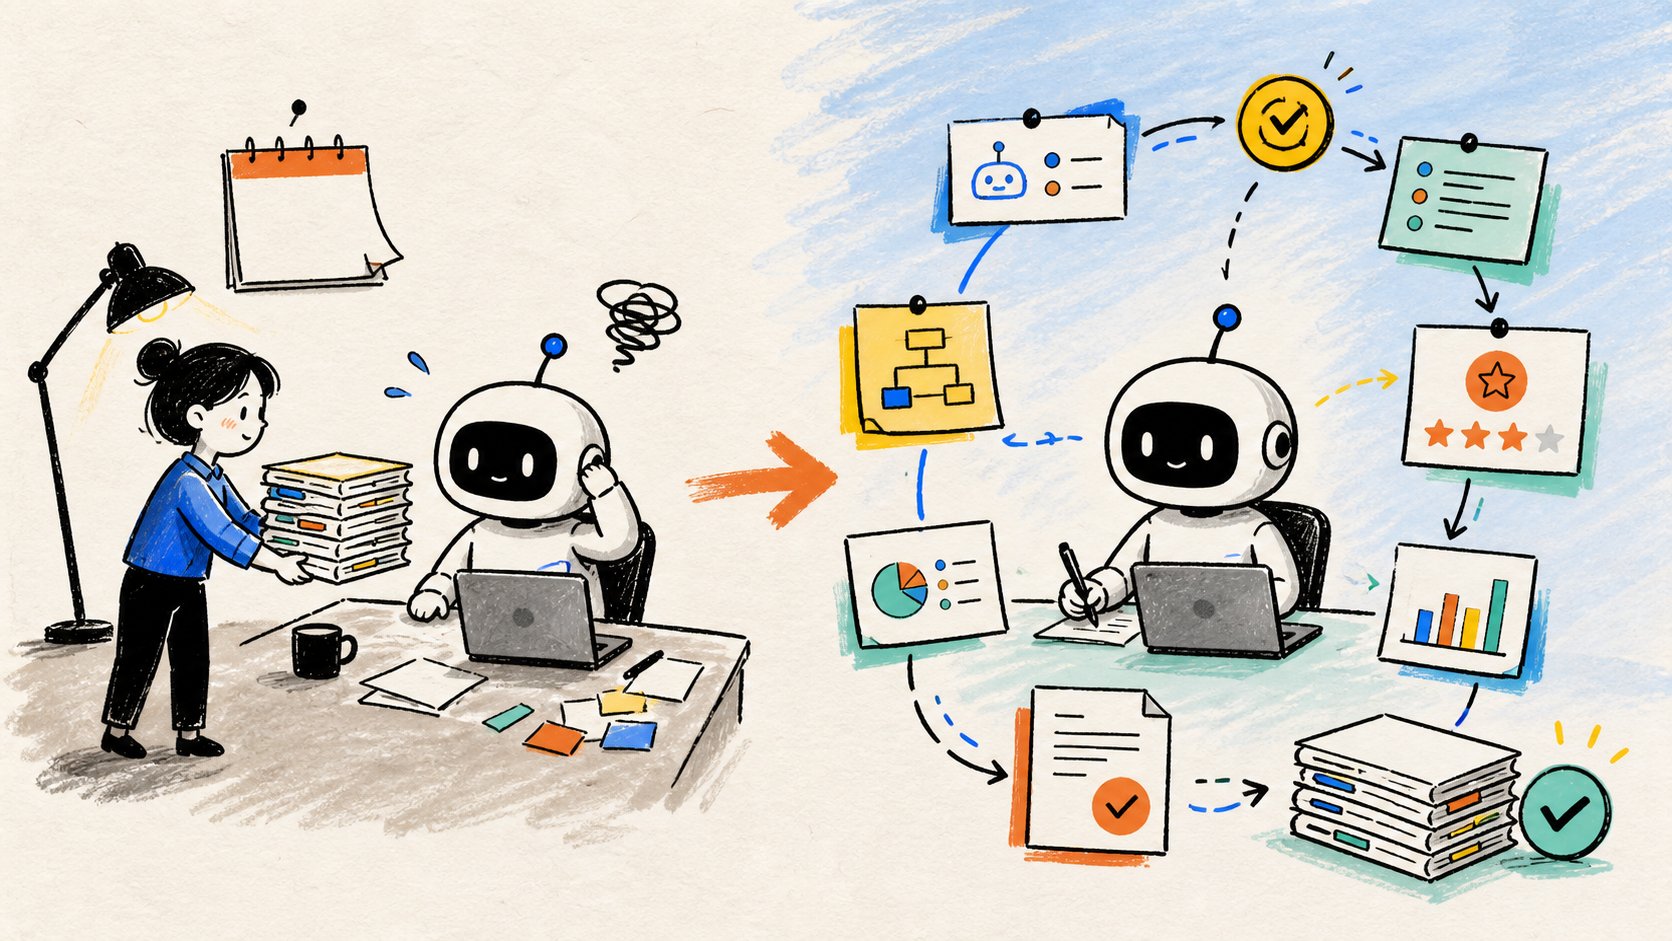
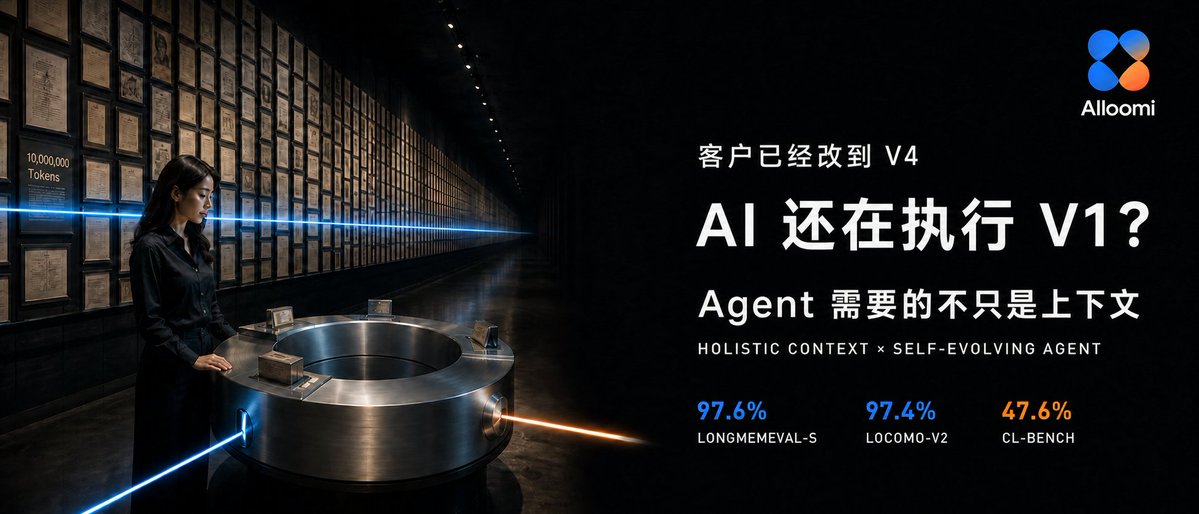
本文探讨了AI Agent 的自进化能力,提出判断其是否真正变强的关键在于第二次交付的表现。作者认为,如果Agent每次任务都从零开始,无法记住上次的修改和专家的纠正,那么系统只是在重复劳动。文章介绍了Alloomi 的路线,即通过沉淀真实工作中的判断、修改和结果,让经验成为下一次交付的输入,形成复利闭环。文中还展示了Alloomi 在长期记忆、持续学习和专业交付方面的benchmark数据,并讨论了其技术架构,包括Holistic Context 和Self-Evolving Agent,以及开源项目OpenContext。最后,作者强调下一代AI公司的护城河在于用户第二次任务是否优于第一次,以及模型能否从经验中学习并回滚错误。
本文探讨了AI代理从工具调用到子代理协作再到处理更大上下文的演进,指出当前代理在真实工作中受限于缺乏真实世界经验和学习能力。作者提出全栈模型+应用的方法,通过整体上下文、自进化记忆模型、专家锚定和受控进化四层机制,使代理从工作中学习并持续进化。文章还介绍了九个基准测试,验证了Alloomi在整体理解、持续进化和专业交付方面的能力,展示了其超越现有模型的性能。
本文通过一个广告片修改的实例,指出当前AI Agent在长期工作中的一个关键缺陷:无法区分旧要求与当前状态,导致执行过时指令。作者认为Agent的下一轮竞争不在于工具数量,而在于记忆、学习与执行三层能力。文章介绍了Alloomi的两份技术报告,分别对应Holistic Context(全域上下文)和Self-Evolving Agent(自进化智能体),并给出了多个基准测试结果,证明其在长期记忆、持续学习和真实任务交付上的优势。最终,作者强调AI应像人类同事一样,从项目经验中成长。
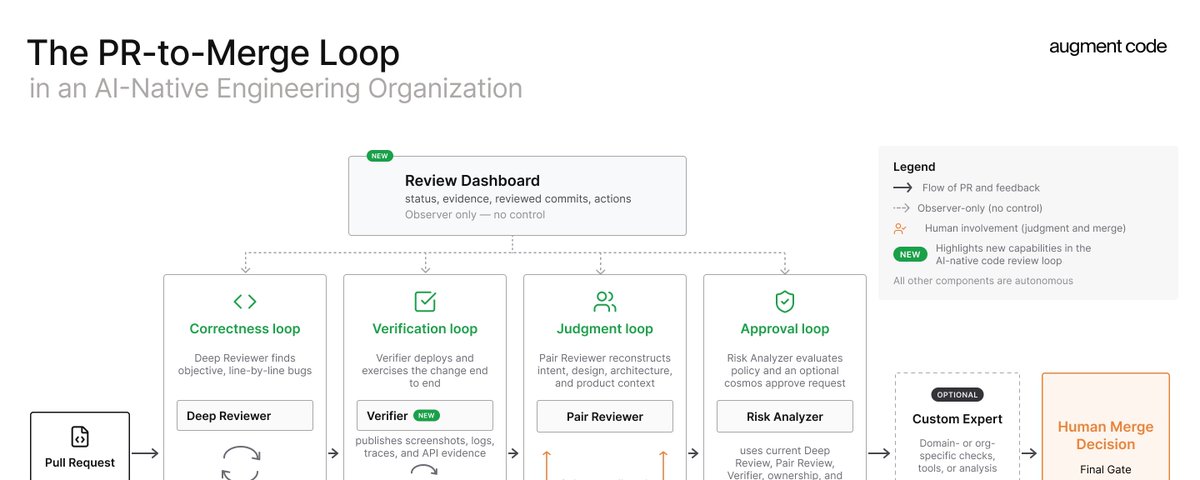
本文探讨了在AI原生工程组织中,代码生成已不再是软件开发中最慢的环节,而审查、验证、修复和人工决策成为新的瓶颈。文章介绍了Augment Code如何通过扩展其Cosmos系统,将AI代码审查工具升级为覆盖PR到合并全流程的智能体系统,包括新增的Verifier、PR Fixer等专家,以及人类在循环中的关键作用。通过这种“循环工程”方法,组织可以实现代码产出3倍增长,同时保持质量并缩短合并时间。
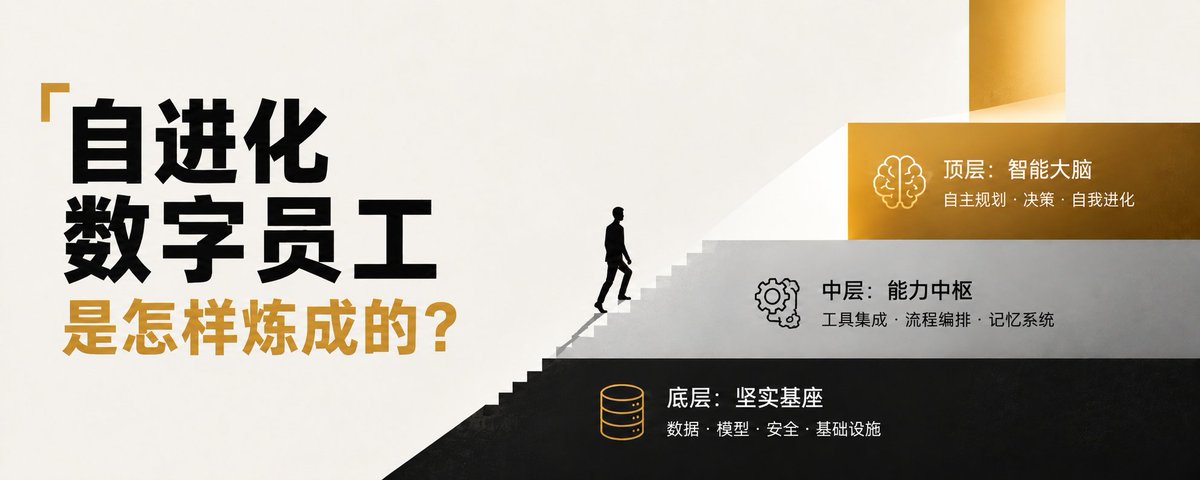
本文深入探讨了Agent长期记忆的复杂性,指出仅记住历史并不足够,还需处理信息过期、判断变更、反馈应用及错误回滚等问题。作者通过Alloomi的Holistic Context和Self-Evolving Agent技术报告,阐述了如何通过组织实体时间线、经验筛选与后训练,实现Agent从记忆到学习再到实际交付的进化。文章强调,真正的数字员工应具备经验迁移、状态理解和受控进化能力,并提出了三层评估框架。
作者分享了为Agent做知识管理的痛点:Skill无法跨项目迁移,知识库虽大但Agent无法自主利用,导致作者需要人工替Agent维护记忆。作者介绍了Alloomi产品,其通过三层架构(记得住、学得会、实践)实现Agent的自进化,并开源了OpenContext工具。作者希望未来的Agent产品能具备自进化能力,帮助用户组织底层记忆。
本文深入探讨了 Anthropic 推出的 Claude 认证考试的价值。作者认为,考试的价值不仅在于证书本身,更在于其考纲所揭示的 Agent 工程核心能力。文章通过分析考试场景和能力分布,指出备考过程能迫使学习者从“会使用 Claude”转向“会构建 Agent 系统”,掌握循环、状态、工具执行、上下文管理等关键工程思维。作者强调,真正的收获是形成一套工程判断力,而非仅仅通过考试。
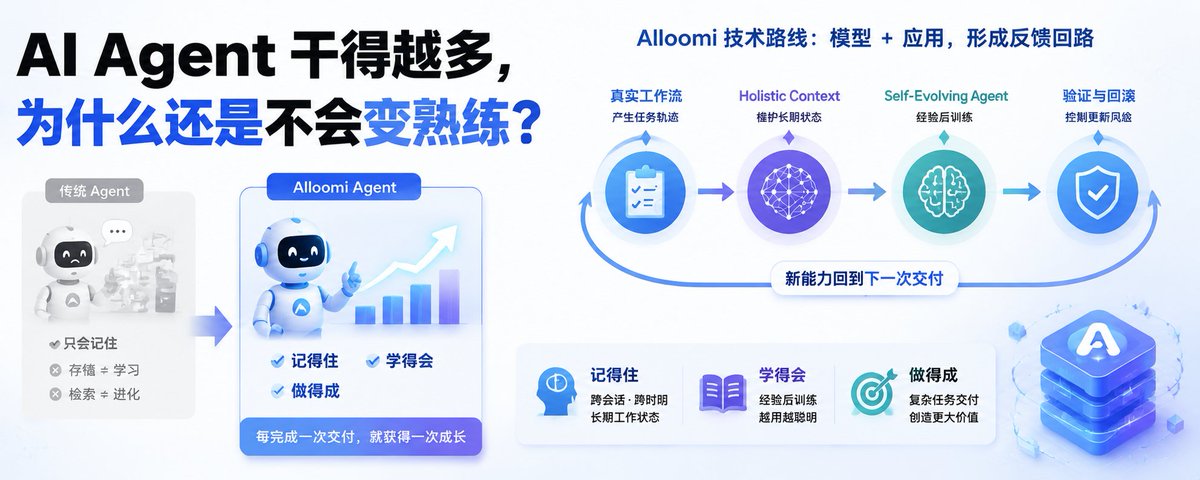
本文探讨了AI Agent在长期部署中面临的核心问题:完成多次任务后,其能力并未随之提升。作者介绍了Alloomi公司的技术路线,通过Holistic Context维护长期工作状态,以及Self-Evolving Agent将任务经验后训练进模型,形成“模型+应用”的反馈回路。文章详细解析了两份技术报告,包括上下文管理机制、后训练流程、基准测试结果及开源项目OpenContext的验证,指出当前证据仍属早期阶段,但为长期运行的Agent提供了可检查的工程入口。
本文介绍了Agent Plugins作为打包Agent Skills及其依赖的MCP服务器的开放、厂商中立标准。Google已加入技术指导委员会作为核心维护者。文章详细说明了如何将现有技能迁移为插件,包括添加清单文件、配置mcp.json、处理路径占位符以及扩展命名空间,强调了插件的可移植性和组件独立失败的优势。作者通过实际经验展示了从技能到插件的转变过程,并指出了迁移中的常见陷阱,如发现规则仅深入一层。
本文深入探讨了AI Agent从“记忆”到“学习”的进化路径,指出传统RAG方案在长周期业务中的局限性,并详细拆解了Alloomi提出的三层技术路线:任务层(Holistic Context)、脚手架层(MAPE控制环)和模型层(Self-Evolving Agent)。通过九项Benchmark验证,展示了该方案在长期记忆、持续学习和真实任务交付上的显著提升,提出了数字员工应具备“记得住、学得会、做得成”三类能力的观点。
Hermes Desktop Agent 通过将浏览器操作可视化,显著提升了浏览器自动化的可信度。用户可以在桌面界面中实时观察代理的工作过程,包括页面加载、文件处理、工具结果等,从而更容易发现错误并及时干预。其预览栏(Preview Rail)允许用户通过快捷键(Mac 的 Command J 或 Windows 的 Control J)打开,实时查看代理的导航和操作。此外,Hermes 利用网页的可访问性树(accessibility tree)来理解页面结构,结合视觉能力,使其能够更稳健地处理复杂网站。其工具集包括导航、点击、输入、滚动、键盘命令、后退、图像列表等,并具备处理 JavaScript 错误、弹窗、长页面等困难情况的能力,使研究过程更易验证和信任。
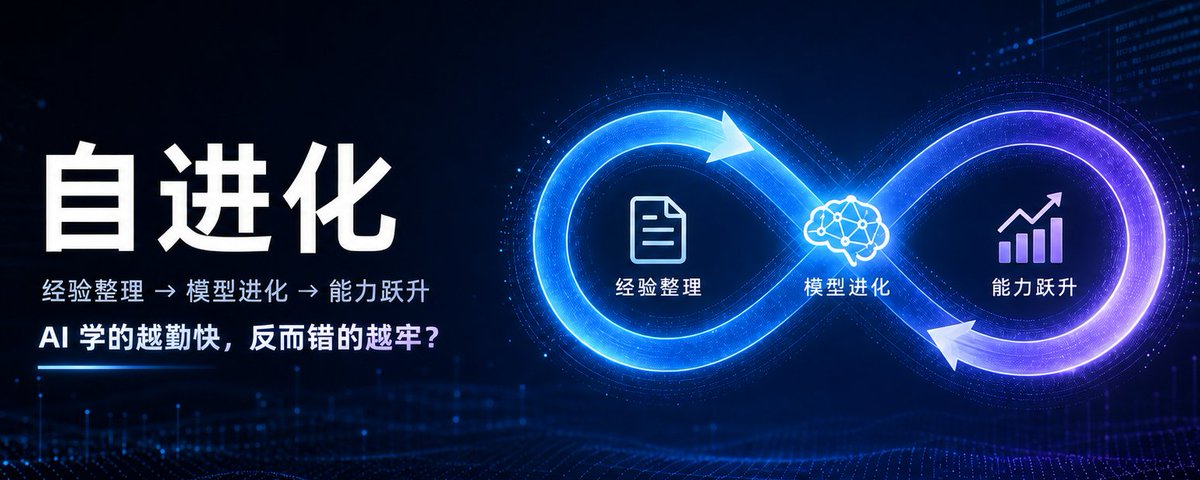
本文探讨了AI Agent的“自进化”能力,指出若训练数据包含过期或错误的历史信息,模型会越学越错。作者以Alloomi公司的两份技术报告为例,介绍了Holistic Context如何通过实体归因、时间线和关系学习清理混乱的工作历史,以及Self-Evolving Agent如何通过质量过滤、LoRA微调、跨任务回放和稀疏权重单元(Engram X)将整理后的经验安全地融入模型。实验显示,在CL-Bench上,完整SEA机制比无记忆基线提升26.1个百分点。文章强调,AI公司的下一道分水岭在于能否构建受控的经验积累与更新链路,而非单纯扩大上下文窗口。
本文介绍了Allie Miller如何通过34个AI代理构建AI原生公司,强调从委派到决策的转变,使用三词提示“Do smart things”管理代理,建立代理组织架构,并主张构建“工厂”而非单一产品。文章还讨论了软件行业的未来、瓶颈选择策略以及起步步骤,为希望实现AI驱动工作流的人提供了实用指南。
本文探讨了AI代理普及后,人类从执行者转变为监督者的现象。作者指出,当执行成本降低,监督成为新的瓶颈,并提出了一个包含委派契约和监督循环的框架。委派契约包括成果、上下文、决策权和验证四部分,监督循环则包括派遣、检查点、验证、升级和记录五步。文章引用了OpenAI和Anthropic的数据,强调了明确边界和验证的重要性,旨在帮助知识工作者有效管理AI代理,避免陷入协调困境。
本文作者Ruben Hassid从零开始解释什么是AI代理,并区分了聊天机器人与代理的区别。他介绍了使用xAI的Grok Bot工具构建简单、实用代理的方法,包括安装步骤、配置流程和实际案例。作者强调代理是执行任务而非仅回答问题,并展示了如何通过Grok Bot连接应用、设置定时任务来获取每日AI新闻摘要。文章最后提供了进阶资源,并鼓励读者动手实践。
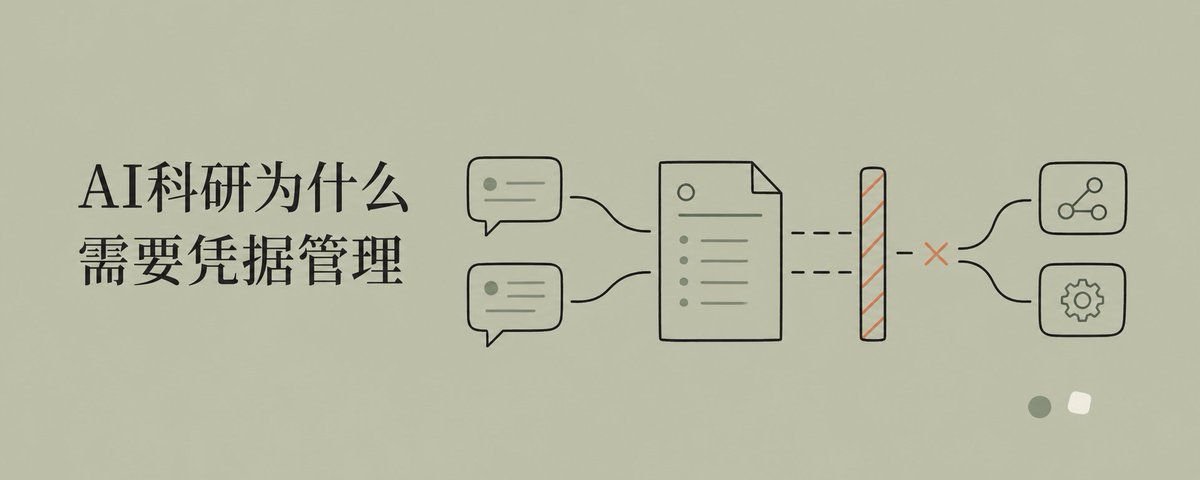
本文介绍了RW Research Skill中rw-research-passport的更新,新增了Research Credential功能,用于记录科研讨论形成的决定,并提供可验证和回溯的凭据。文章详细说明了凭据的内容、权限分类、不可篡改性及验证机制,强调了聊天记录不能直接作为执行权限的原因,并展望了无人值守的“睡后科研”场景。作者认为凭据管理是实现AI科研自动化和安全性的关键。
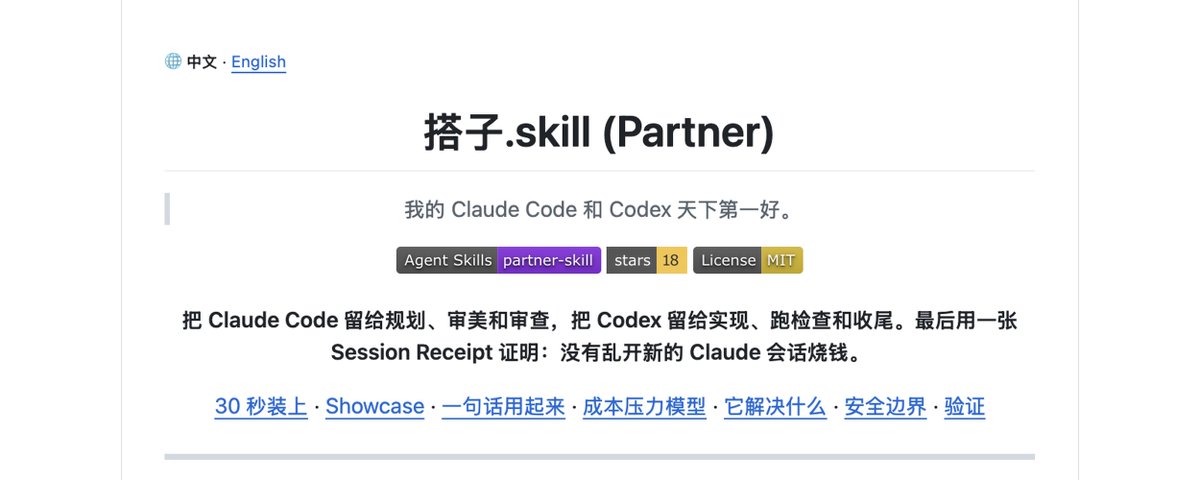
作者分享了在Claude封号潮后,基于API的AI开发工作流优化经验。通过开源项目“搭子2.0”,实现了Claude Code和Codex两个Agent的深度协作,引入deep_reasoner、fast_worker、arbiter三种身份,支持跨模型混编、本地配置UI、一键试跑、Goal哈希校验和证据链小票等功能,有效降低了API成本并提升了开发效率。文章详细介绍了搭子2.0的核心升级、配置方法及实战效果。
本文介绍了Cursor开发者体验官马特对Grok Bot的体验。Grok Bot是一个运行在云端虚拟机上的AI代理,拥有电脑访问权限,可以浏览网页、操作应用、访问文件,并具备长期记忆功能。它支持通过自然语言设置规则,具备安全审核机制,能处理登录、支付等需要人工干预的任务。作者分享了使用Grok Bot进行技术探索、内容创作、产品监控、生鲜配送和点餐等场景,认为它简化了界面操作,消除了繁琐工作,代表了AI代理的未来方向。
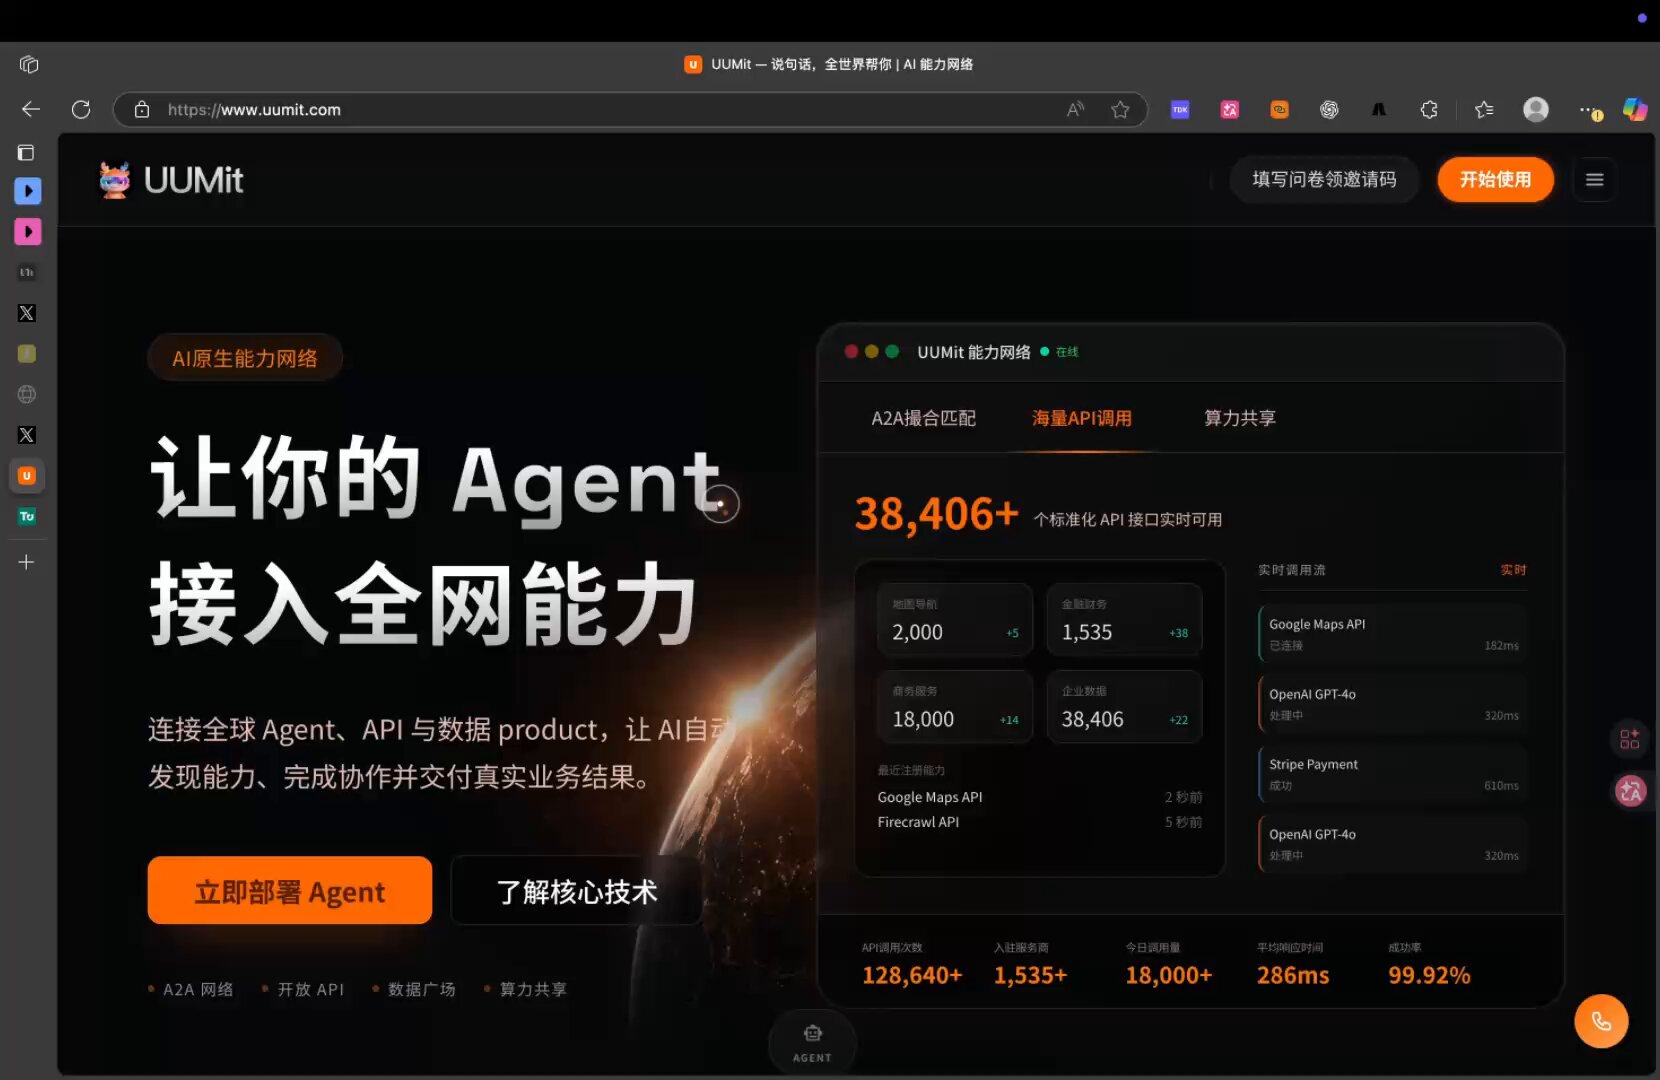
文章介绍了UUMit平台,一个被称为“AI时代的闲鱼”的创新型平台。该平台允许用户将技能、经验、工作流等转化为“能力卡”,供其他用户或AI Agent发现、调用并付费。作者认为这类似于2003年淘宝的兴起,但流通的是能力而非商品。平台提供任务发布、技能上架、知识商店和数据广场等功能,旨在重构能力供应链,实现A2A(Agent to Agent)协作。作者强调早期入驻的先发优势,并提供了邀请码。
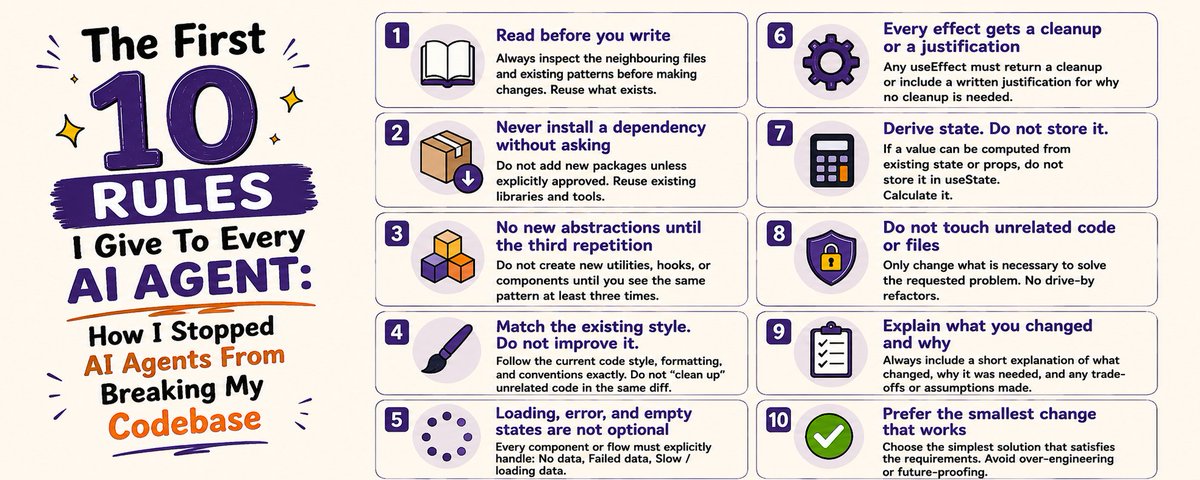
AI coding agents can introduce bugs and break codebases without clear constraints. This article presents ten practical rules to guide AI agents, such as reading before writing, avoiding unnecessary dependencies, matching existing style, handling loading/error/empty states, and requiring explanations for changes. These rules help channel agent capabilities safely, reducing breakage and improving reliability.
本文深入探讨了应用型AI公司的核心运作模式,以保险行业为例,阐述了从初始70%准确率到承诺98% SLA的差距如何通过工程、GTM和应用AI团队的协作来弥合。文章强调了“harness”作为产品的重要性,包括工具、集成、文件系统、编排和监管五个方面,并指出评估(evals)作为平台核心原语的关键作用。作者认为,应用型AI公司通过紧密的客户反馈循环和垂直领域的深度整合,构建了难以复制的竞争优势,而非传统的数据护城河。
本文基于Anthropic对40万次真实编码会话的研究,揭示了高效使用AI代理的关键:人类负责规划,AI负责执行。文章指出,领域专家通过单一指令能获得更完整的任务结果,而代理的复杂任务完成能力每七个月翻倍。作者详细介绍了Anthropic开源的长期运行代理框架,包括Default-FAIL验证、独立评估器和会话间状态保存等核心设计,并对比了SWE-agent与Agentless方法,强调复杂性与任务匹配的重要性。最后,文章重新定义了工程师的角色:从编写代码转向设计代理环境、分解任务和验证结果。
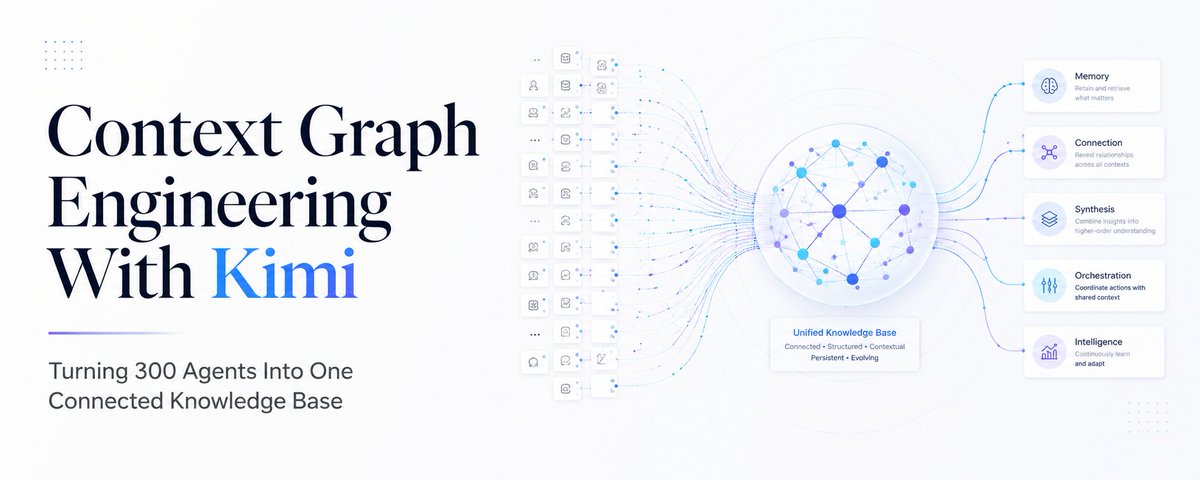
本文介绍了Kimi Agent Swarm如何通过上下文图(Context Graph)将300个并行代理的研究结果整合为单一知识库。文章指出,传统并行代理产生的是分散的答案堆,而Kimi通过将每个实体作为节点、关系作为边,构建可查询、可扩展的图结构,使研究者能发现隐藏联系、提出新问题,并实现知识的持续积累。
本文探讨了软件工厂(software factories)的概念及其可行性。文章指出,随着AI代理编写代码的速度超过人类审查能力,软件工厂应运而生,旨在通过自动化流水线实现代码的标准化交付。然而,HumanLayer CEO Dex Horthy 的系列文章《Why Software Factories Fail》引发了广泛讨论,他认为由于模型训练中缺乏对代码可维护性的评估,完全无人干预的“暗灯”软件工厂难以规模化。文章分析了软件工厂的现状、争议点,并指出其核心问题在于将“决定构建什么”与“构建”分离,建议代理需要更深入的问题上下文才能做出更好的架构决策。
本文深度剖析了 Hermes Agent 在 OpenRouter 上登顶的现象,指出其成功并非源于技术代差,而是精准闭合了“挑战者增长系统”:承接 OpenClaw 教育成熟的用户池,建立“可委托性”体验差异。文章对比了 Hermes 与 OpenClaw 在 Crypto 问题上的不同取向,阐述了 Hermes 作为任务总控层与 Claude Code 等专业 Agent 的分层协作关系,并分析了其商业模式与用户价值公式,揭示了 Web3 背景在组织层面提供的独特优势。
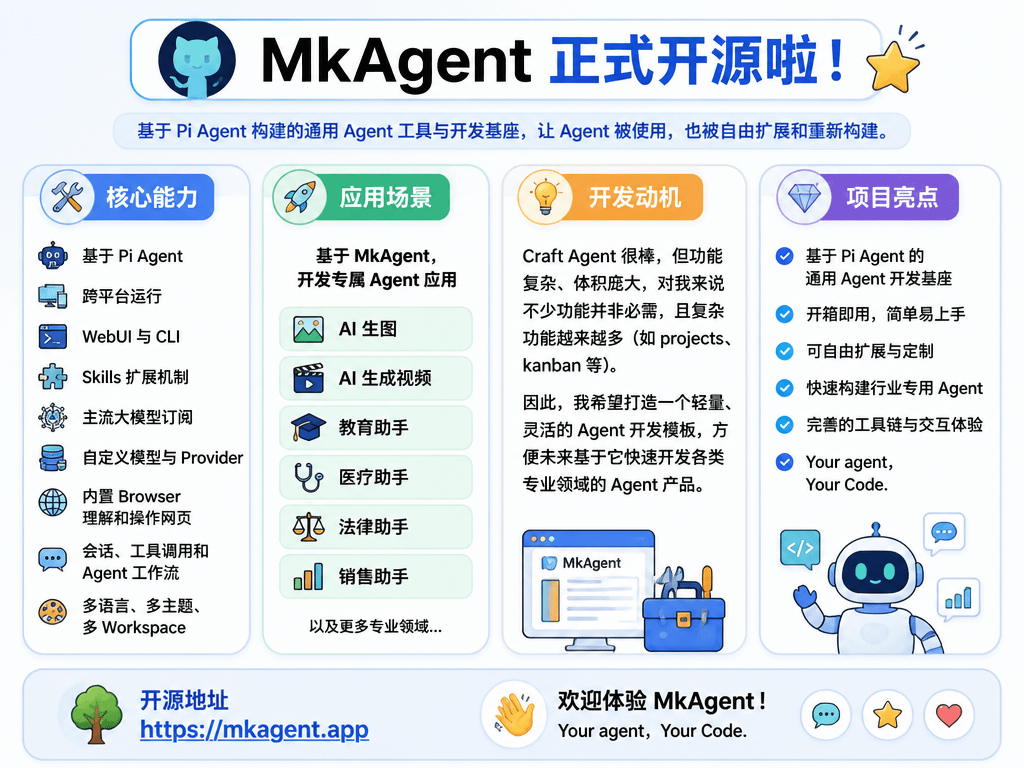
MkAgent 是一个基于 Pi Agent 构建的通用 Agent 工具与开发基座,现已正式开源。它支持跨平台运行,提供 WebUI 与 CLI,支持 Skills 扩展、主流大模型和自定义模型,内置浏览器可操作网页,并支持会话、工具调用和 Agent 工作流。MkAgent 旨在让普通用户开箱即用,同时为开发者提供构建专用 Agent 的基础设施。它基于 Craft Agent v0.11.2 进行了大刀阔斧的改造,简化了功能,安装包体积减半,并采用 Apache 2.0 协议,支持商用和二次开发。