使用 OpenClaw 在本地运行 Gemma 4 的三个步骤
文章介绍了如何简单快速地在本地运行 Gemma 4 模型。主要步骤包括安装 Ollama、下载 Gemma 4 26B A4B 模型,以及通过 Ollama 启动 OpenClaw 并使用 Gemma 4 作为后端。该过程被描述为简单快捷,适合在几分钟内完成本地代理的部署。
文章介绍了如何简单快速地在本地运行 Gemma 4 模型。主要步骤包括安装 Ollama、下载 Gemma 4 26B A4B 模型,以及通过 Ollama 启动 OpenClaw 并使用 Gemma 4 作为后端。该过程被描述为简单快捷,适合在几分钟内完成本地代理的部署。
本文总结了作者半年多使用 Claude Code 的经验,分享了10个提升效率的使用技巧。内容涵盖三种启动方式(可视化、命令行特定历史、自动化无UI)、运行时的三个核心技巧(优雅终止回退、不离开窗口执行命令、上下文管理),以及通过 Superpowers、语音输入和窗口管理工具(Cmux、Vibe Island)来解决人机协同中的效率瓶颈,旨在帮助程序员实现丝滑的 AI 编程体验。
本文介绍了开发者 arman-bd 开源的微型语言模型 GuppyLM。该模型拥有 900 万参数,核心代码仅 130 行,可在免费 Colab 上 5 分钟训练完成。文章详细拆解了构建流程:利用模板生成 6 万条合成数据、训练 4096 词表的 BPE 分词器、搭建 6 层 Vanilla Transformer 架构以及优化推理环节。该项目旨在通过极简的实现,帮助开发者深入理解语言模型的数据工程、架构设计与训练循环。
本文对比分析了近期热门的 Hermes Agent 与 Claude Code、OpenClaw 的区别。Hermes Agent 是一个轻量级、可自我学习的通用 Agent,定位介于三者之间。与 Claude Code 相比,它不绑定 IDE,支持多平台和 18+ 模型;与 OpenClaw 相比,它采用独特的“有限记忆”哲学和自学习循环机制,能自动沉淀个人技能笔记,更适合个人开发者私有化部署。
文章探讨了AI视频创作中常见的“PPT感”问题,指出核心在于缺乏分镜思维而非图片质量。作者提出了适合AI创作者的导演视角,强调通过设计空间、主体、变化和结果来连接镜头。文中详细解析了景别的情绪功能、切镜的逻辑标准,并提供了一个实用的5镜头叙事结构,帮助创作者提升作品的连贯性与故事感。
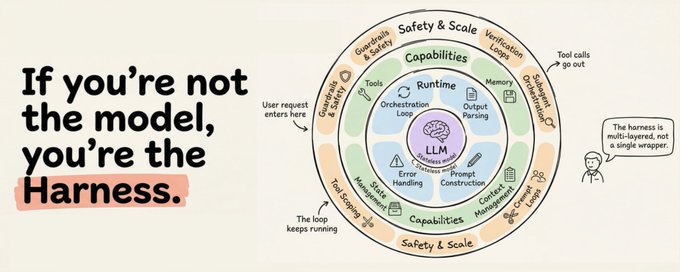
文章详细介绍了 Terraform 之父 Mitchell Hashimoto 的 AI 工程实践六个阶段,从早期的聊天窗口尝试,到最终实现后台常驻 Agent 的愿景。核心亮点在于第五阶段提出的“Harness Engineering”(工程约束),即通过系统性设计(如 AGENTS.md 和验证工具)来防止 Agent 重复犯错。文章结合 Anthropic 和 OpenAI 的行业案例,指出工程师的核心技能正从手写代码转向设计 Agent 的运行约束环境。
本文介绍了如何利用 Claude Projects 功能打造一个专属的 AI 私人家教。通过设定项目指令、上传学习日志,并配合初始化、制定计划、更新进度、攻克难点四个核心 Prompt,用户可以让 Claude 记忆并追踪学习进度,从而实现比传统补习班更高效、个性化的学习体验。
作者分享了利用 OpenClaw 构建全能 AI 幕僚长“Stella”的实战经验。系统核心在于独特的双层记忆架构(每日笔记+长期记忆)和持续进化的 Kaizen 循环。Stella 能够自动化处理会议准备、任务管理、关系上下文跟踪及信息过滤,通过将确定性逻辑交给脚本、仅让 LLM 负责判断,实现了超越人类助理的效率与可靠性。
作者利用 OpenClaw 构建了一个名为 Stella 的 AI 办公室主任,其能力超越了以往的人类助手。文章详细介绍了该系统的核心架构:基于 Markdown 的双层记忆机制(日志与长期记忆)确保上下文连贯;Kaizen 持续改进机制通过周报和社区学习自动优化系统;以及自动化的会议准备、跟进和任务管理流程。该系统利用 Granola 等工具实现了工作流的自动化,不仅提升了效率,更通过持续迭代实现了自我进化。
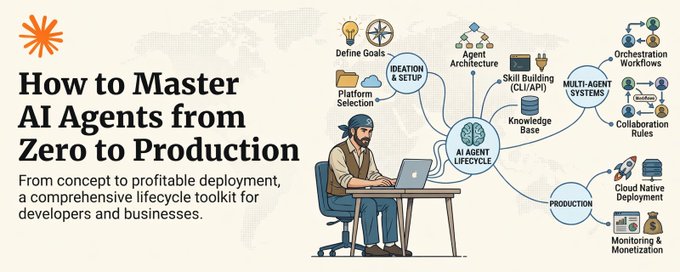
这是一份关于构建生产级 AI 智能体的完整指南。文章详细阐述了智能体与聊天机器人的本质区别,涵盖了从工具设计、系统提示词、多智能体编排到生产环境部署、测试评估的全流程。重点介绍了如何利用 API 构建可靠的智能体循环,并指出了初学者常犯的错误及生产环境下的监控与成本控制策略。
本文详细介绍了如何利用本地笔记工具Obsidian与AI编程助手Claude Code搭建个人AI知识库。文章阐述了该组合在数据主权、AI原生体验及插件生态方面的三大优势,并提供了从基础环境安装、Claude.md规则配置到进阶插件推荐的全流程实操指南,助用户实现高效的本地化知识管理。
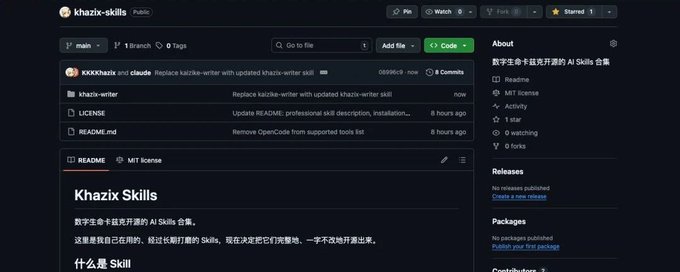
作者宣布开源自己长期使用的内容创作 Skill,并详细阐述了该 Skill 的构建方法、四层自检体系以及迭代流程。文章强调,AI 辅助创作应作为工具加速生产,而非直接生成全文,核心价值在于人类的判断、灵感与情感表达。
本文详细介绍了针对开源大模型(如Gemma-4-31B)进行“越狱”的技术原理与实操流程。不同于闭源模型的提示词工程,开源模型越狱(Abliteration)通过修改权重直接抹除模型内部的“拒绝维度”。文章涵盖了从构建对比数据集、提取激活值、计算拒绝向量、权重正交化到最终验证的完整步骤,并指出了过度顺从等副作用及相关的法律伦理风险。
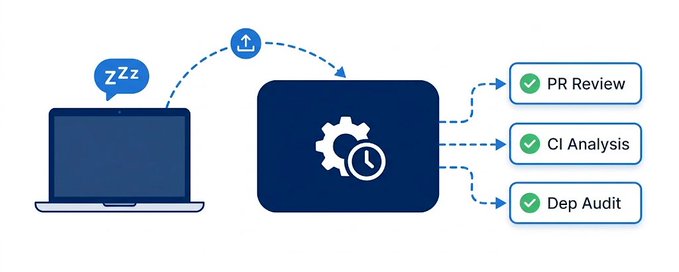
本文介绍了 Claude Code 新增的云端定时任务功能。该功能允许用户设置 Prompt 和执行频率,由 Anthropic 服务器自动运行代码审查、依赖检查等重复性任务,无需本地电脑在线。文章详细对比了 Cloud、Desktop 和 /loop 三种调度模式的适用场景,并提供了创建云端任务的具体步骤,包括 Prompt 编写、仓库配置、环境设置及实用场景建议。
文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。
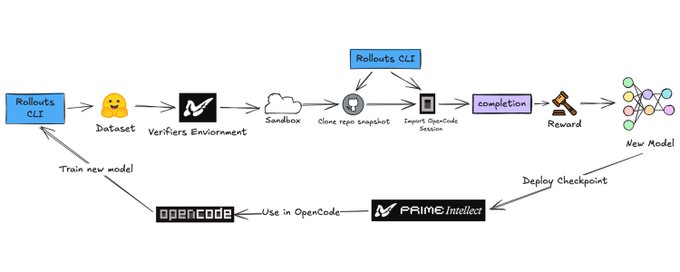
本文介绍了如何利用开源生态系统构建一个持续学习的编码代理系统。作者基于 Prime Intellect 平台和 OpenCode 环境,创建了一套批量增量式在线强化学习流程,通过 Git 快照收集真实交互数据(约 21.8 亿条记录),并在沙箱环境中进行模型训练与部署,旨在实现代码生成的个性化与自我进化。
本文针对 Andrej Karpathy 提出的 LLM Wiki 方案,结合作者自身的 Obsidian + OpenClaw + Claude Code 实践经验进行了优化。作者提出了从三层架构升级为五层架构(增加行动层与产出层),并强调人工确认机制,避免 AI 自动分类的偏差。文章详细介绍了入库、查询和健康检查的具体流程,分享了构建个人知识库的原则,旨在实现知识积累与内容产出的高效闭环。
本文是一篇基于工程视角的AI技术硬核解析,旨在厘清从LLM大模型到Agent智能体的核心概念体系。文章深入浅出地拆解了LLM的文字接龙本质、Tokenizer的翻译机制、上下文窗口的容量限制,以及Prompt工程、MCP工具协议和Agent技能的运作原理,帮助读者建立完整的底层技术认知。
本文详细介绍了如何利用 Cloudflare Pages 和 Workers KV 免费搭建 VPN 节点的全过程。教程涵盖了从准备域名、上传代码、设置管理员密码、绑定 KV 命名空间到配置自定义域名等所有步骤。即使是零基础小白,也可以通过下载提供的 Zip 包直接上传部署,轻松实现自建代理及自助优选订阅。
文章详细介绍了 Seedance 2.0 AI 视频生成工具的提示词编写技巧。该版本采用新的导演式提示词框架:主体+动作+镜头+风格+限制条件,支持多模态输入。文章通过电子游戏、动画、时尚、UGC、动态设计和商业广告六个具体案例,展示了如何精准控制镜头角度、灯光节奏和视觉风格,以生成高质量的AI视频内容。
文章介绍了一套利用 Seedance 2.0、GAS 和 Claude 等最新 AI 工具制作 YouTube 纪实故事视频的“2.0 版本”工作流。该方法摆脱了传统的素材拼接,通过 15 秒连贯长镜头生成和爆款公式拆解,实现高完播率和全网传播。文章详细拆解了从选题调研、脚本撰写、画面生成到剪辑变现的九大步骤。
文章介绍了将 Obsidian 与 Claude 结合,构建“第二大脑”的完整指南。核心在于通过简单的四个文件夹结构(收件箱、笔记、项目、归档)和必要的插件来组织知识。关键在于建立每日捕捉的习惯,并利用 Claude 的上下文理解能力辅助思考、连接知识点及优化写作。
作者分享了如何利用 NotebookLM 和 Claude Code 构建一套个人知识管理系统。通过导入 300 集 Huberman 播客建立专家知识库,结合 Claude Code 进行日程安排、实验设计及晨间习惯追踪,成功将学习内容转化为具体的健康行动(如睡眠、运动),并量化了实践带来的积极效果。
文章回顾了 Claude Code 源代码泄露事件及 Anthropic 封禁 OpenClaw 订阅套餐的应对策略,分析了 OpenAI 与 Anthropic 的融资与市场竞争格局。核心内容围绕作者搭建的 AI 个人工作站,详细介绍了基于 Mac Studio 的软硬件配置(Tailscale 组网、本地大模型、语音输入法等)及结合 Claude Code、OpenClaw 的工作流,提出了 AI 时代“电脑应作为永久在线智能助理”的超级个体理念。
本文介绍了 OpenAI Codex CLI 的增强工具 oh-my-codex (OMX)。OMX 是一个智能工作流增强层,通过需求澄清、规划审批、持久完成循环和多智能体协调等工程化功能,解决了传统 Codex 缺乏工作流管理的痛点。文章详细讲解了 OMX 的核心功能、安装步骤、四大工作流模式($deep-interview, $ralplan, $ralph, $team)以及实战案例。
本文针对近期AI漫剧行业遭遇的严厉监管与“大清洗”现状,指出草莽时代的结束。文章通过拆解高效团队的运作模式,提炼出一套包含剧本提炼、提示词反推、资产管理等环节的“一人公司”工作流。作者强调,普通人在当下不应盲目入场做炮灰,而应学习这种“1个老板+N个AI员工”的提效逻辑,回归内容本质,利用AI辅助本职工作或轻创业。
文章深入分析了 Andrej Karpathy 提出的“LLM Knowledge Bases”概念。Karpathy 批评了当前 RAG 模式缺乏知识积累的痛点,提出由 LLM 维护的一组持久化 Markdown Wiki 作为替代方案。文章拆解了该方案的“原始资料、Wiki层、规则层”三层架构,以及“摄入、查询、健康检查”的操作模式。作者结合 EverMind Memory 的产品视角,探讨了这一模式从单次交互向积累能力转变的行业趋势,以及“Idea File”作为新知识传播单位的潜力。
文章分享了作者因 AI 的教学能力优于人类而失去家教工作的经历,顺势介绍了其开源的 AI 私人导师项目 auto-tutor。该工具具备自适应学习路线规划、实时诊断、交互式学习等功能,支持人文社科书籍、理科教材、工科论文及 GitHub 项目的深度研读,能实现个性化教学和自动笔记,提升学习效率。
本文详细介绍了作者如何构建基于Obsidian和Claude Code的个人工作流系统。文章提出了“未经人脑处理的知识不进仓库”和“输入服务于输出”两大原则,通过构建COO、CTO、心理医生等AI Agent角色,配合定时任务和自动化工作流,实现了一个具有问责机制、自动化记录和个人百科功能的数字“健脑房”,旨在提升思考质量与工作效率。