How to Become a Graph Architect With Zero Experience (Full Course)
本文提供了一条从零开始成为图架构师的完整路径,分为五个阶段。内容涵盖掌握循环、学习图心智模型、掌握核心模式、构建可靠性及进阶设计。文章强调通过二十个具体步骤,从理解基础概念到实际构建多智能体系统,帮助读者在AI工程前沿领域获得竞争优势。
本文提供了一条从零开始成为图架构师的完整路径,分为五个阶段。内容涵盖掌握循环、学习图心智模型、掌握核心模式、构建可靠性及进阶设计。文章强调通过二十个具体步骤,从理解基础概念到实际构建多智能体系统,帮助读者在AI工程前沿领域获得竞争优势。
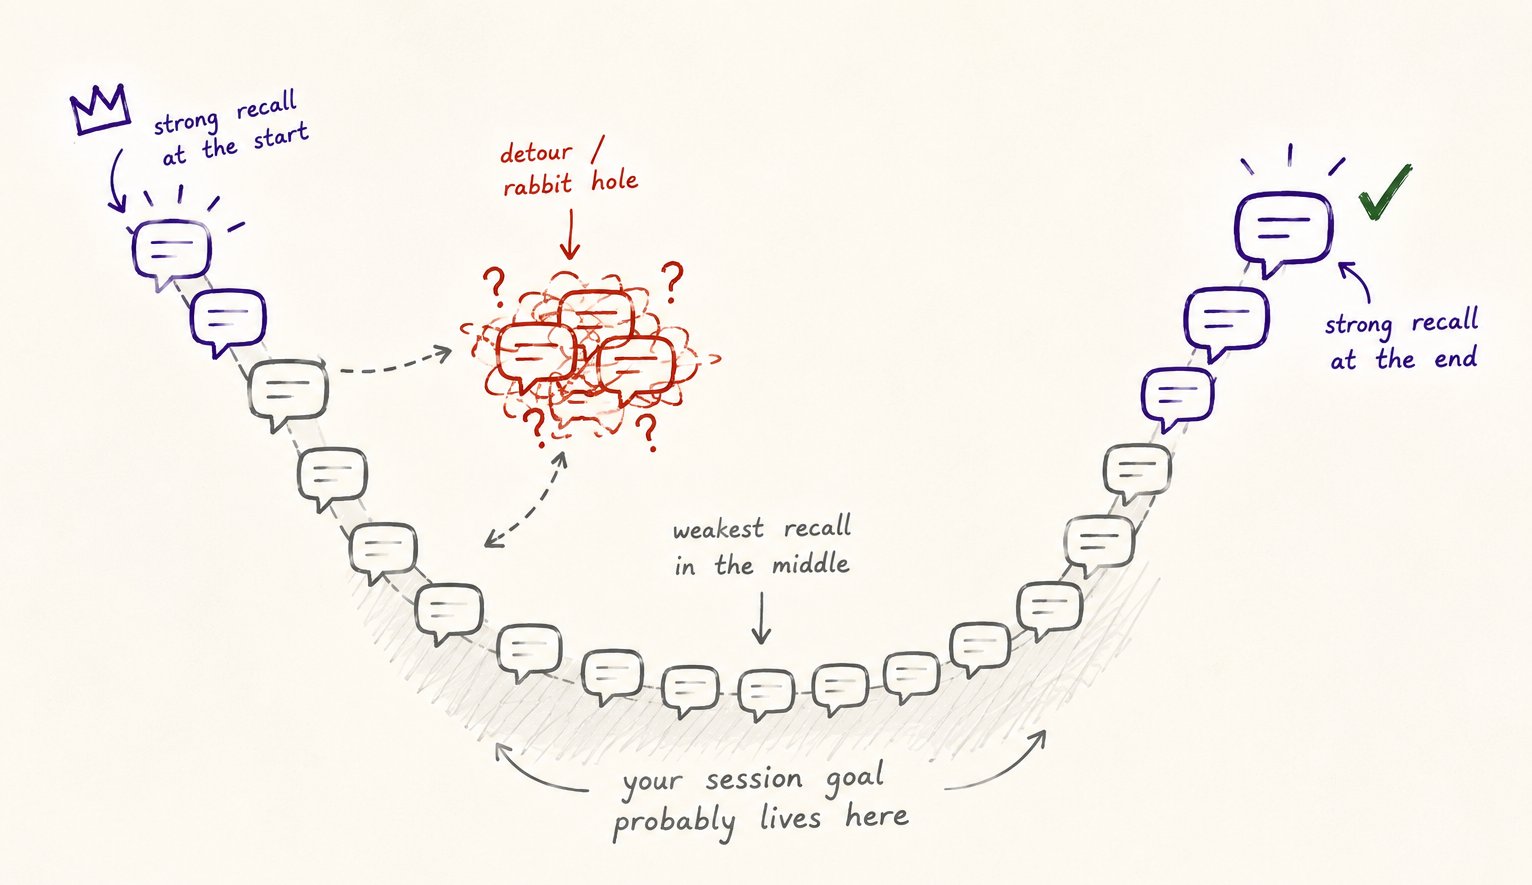
本文深入探讨了 Claude Code 等智能体工具在长对话中性能下降的现象。作者将其归因于“上下文腐烂”,分为无法避免的内在腐烂(模型架构限制)和可管理的内容腐烂(过时信息积累)。文章提供了具体的治理实践,包括前期策展、保持上下文清洁、及时重置以及使用 git 树结构管理会话,以维持工具的敏锐度。
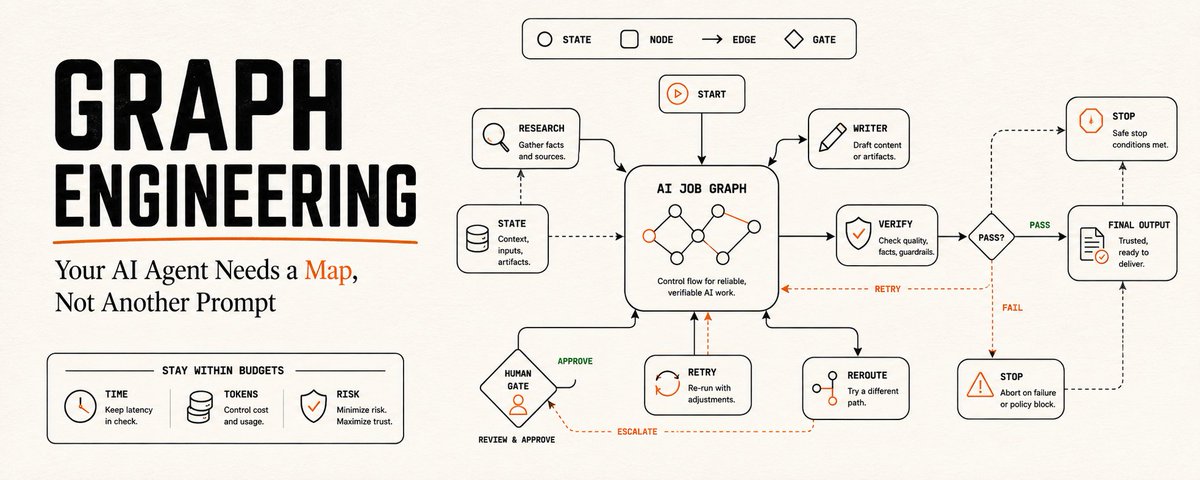
文章探讨了 Graph Engineering 的概念,主张通过预先设计 AI 任务的控制流图,而非单纯依赖提示词,来解决 Agent 的复杂性与错误问题。文中详细阐述了图的四个核心部分:状态、节点、边和门控,并强调围绕失败路径而非成功路径进行设计。最后通过实际研究案例,展示了如何利用图结构拆解任务、验证信息并控制成本。
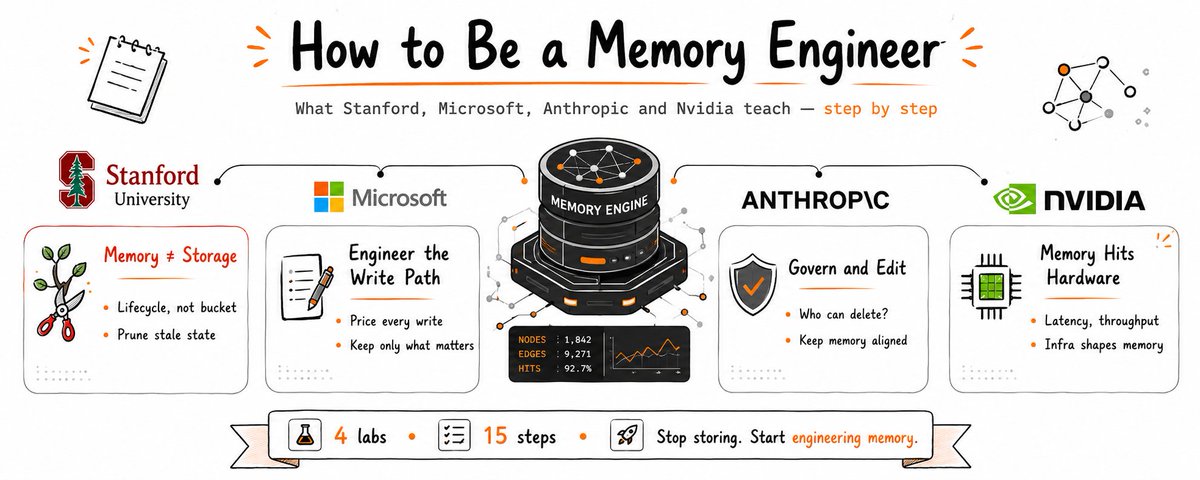
文章探讨了如何成为一名记忆工程师,指出Agent的记忆问题在于从未“有意遗忘”。文章结合斯坦福、微软、Anthropic和英伟达的研究,从成本(写入路径)、价值(事实与技能)、控制(可审计)和硬件(KV缓存)四个维度,提出了构建高效记忆系统的六个主题和十五个步骤。
本文探讨了 Agent 内存的设计原则,指出有效内存应通过遗忘、压缩和整合事件来提升智能,而非单纯存储。文章基于 CoALA 框架,详细阐述了工作、情景、语义和程序四种内存类型的区别,强调了通过整合机制将情景转化为知识的重要性,并介绍了基于时间衰减和重要性的遗忘策略,以优化存储和推理性能。
本期周刊探讨 AI 产品从演示到落地的距离。引用 Jeff Dean 的“1%法则”,将焦点从模型能力转移到系统工程细节。文章深入分析了规格定义、评测验证、任务成本、系统记忆、Skill 治理等关键问题,强调通过工程化手段实现智能体的稳定交付与闭环。
本期早报涵盖了 Igor Babuschkin 对模型开发未来路线的判断,Whatnot 对产品经理配置的反思,以及姚顺雨入主腾讯混元后的组织调整。此外,还速览了 AWS 的 Agent 开发流程、英伟达机器人研究、AI 基准评测及微软 Meta 财报等内容,探讨了技术落地与组织设计的相互影响。
本文详细拆解了 OpenAI 软件工程师的高难度面试流程,涵盖初筛、编码、系统设计、48小时居家项目、技术深潜、终面及未公开的 Agentic Coding 考试。文章分析了每轮考核的核心能力(如 MVCC、分布式一致性、推理系统扩缩容等),并指出面试标准正向“指挥 Agent 交付”迁移,是一份高质量的工程师进阶指南。
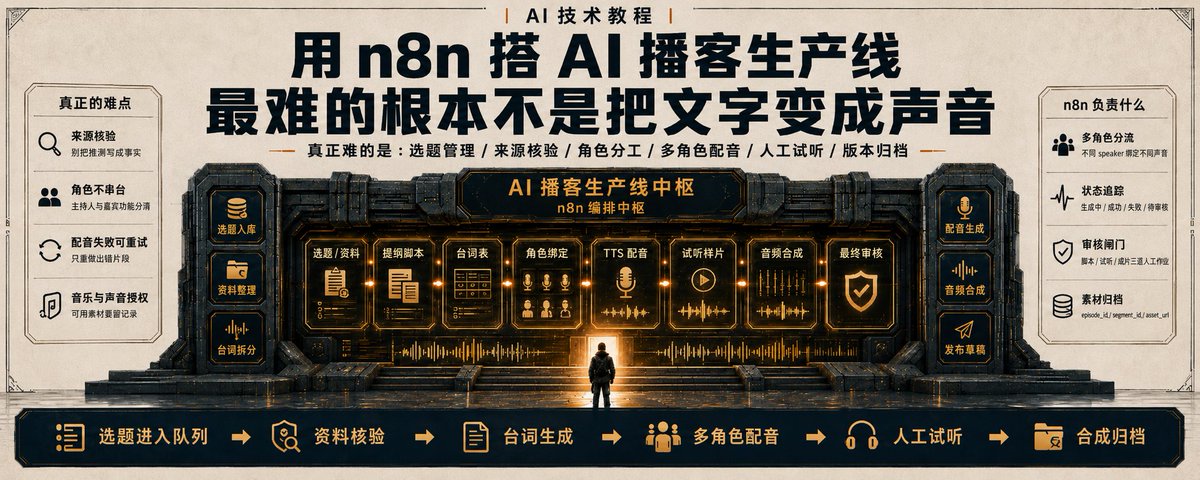
文章探讨了如何利用 n8n 搭建高质量的 AI 播客生产线。作者指出,文字转音只是小部分,真正的难点在于选题、资料核验、脚本拆分、异常处理及数据回流等全流程管理。文章详细拆解了三层架构和六个生产阶段,并强调通过人机协作和状态管理来规避常见陷阱,实现可持续的内容生产。
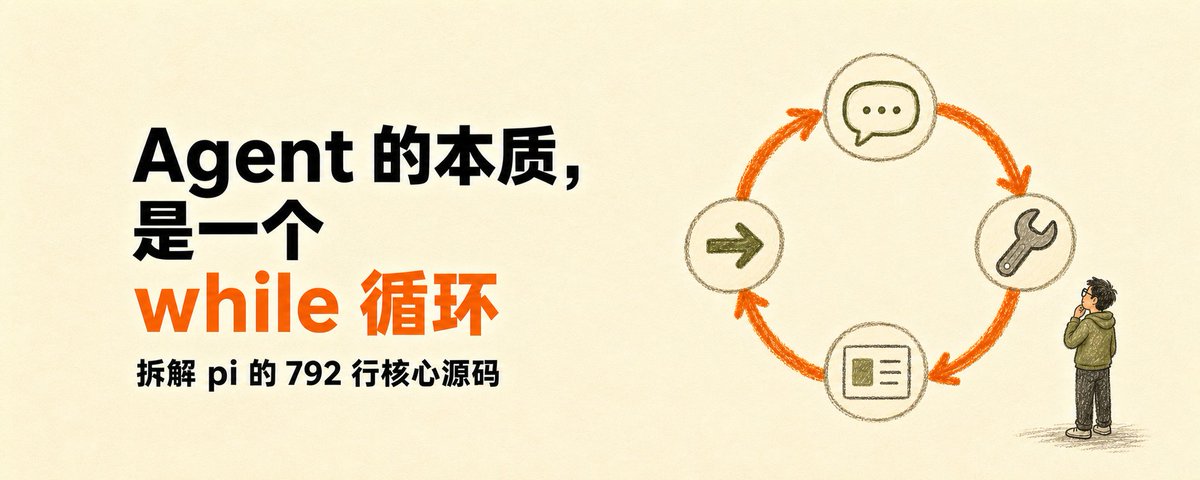
文章通过拆解开源项目 pi 的核心源码,揭示 Agent 的本质是一个 while 循环。作者分析了 pi 的 792 行核心代码,讲解了双层循环、转向消息、事件流解耦、错误处理及 Token 截断防御等关键设计,展示了从玩具代码到生产级 Agent 的工程差距。
文章探讨了即使大模型支持超长上下文窗口,Agent 在处理复杂任务时仍难以维护有效中间状态的问题。作者介绍了评测框架 ArbiGraph,该框架利用可执行任务图来测试模型的状态管理、依赖传递及抗干扰能力。实验表明,随着任务链路和分支复杂度的增加,模型准确率显著下降,强调上下文管理的核心在于维护可流动、可失效的计算状态,而非单纯扩容。
文章深入分析了 Agent 开发的技术趋势,指出核心稀缺资源已从“代码”转向“可信结果”。阐述了 Harness Engineering 的重要性,强调在概率性推理之外建立确定性执行外壳,通过状态管理、身份验证和结果验收,让 Agent 能够在复杂系统中可靠承担责任。
文章详细阐述了构建AI知识库的目录结构与配套Skills工作流的方法。作者基于LLM Wiki与GBrain理念,提出了一套包含知识内容、实体和输出的目录分类体系。核心在于先定管理规则,再通过不同技能(如采集、查重、提炼、综合)分工协作,确保知识从采集到复用全流程的高效闭环。
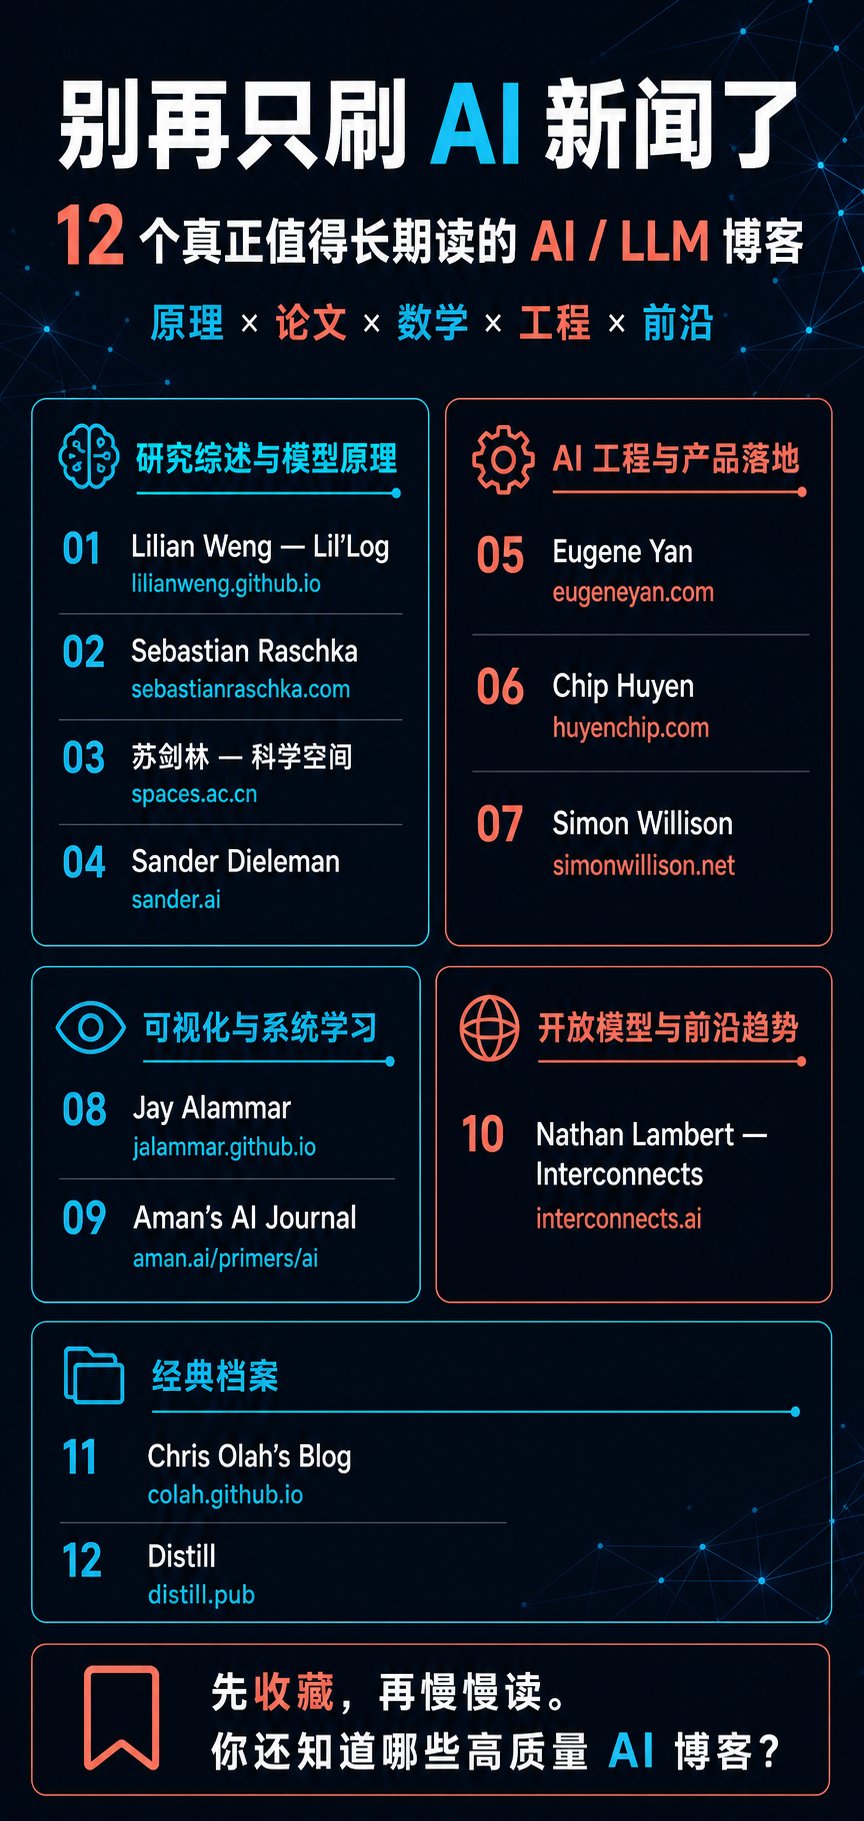
文章推荐了12个值得长期关注的AI与LLM博客,涵盖了研究综述、模型原理、工程实践、可视化学习及前沿趋势。作者强调深入理解AI的重要性,并精选了Lilian Weng、Sebastian Raschka等博主,帮助读者建立系统化的AI认知。
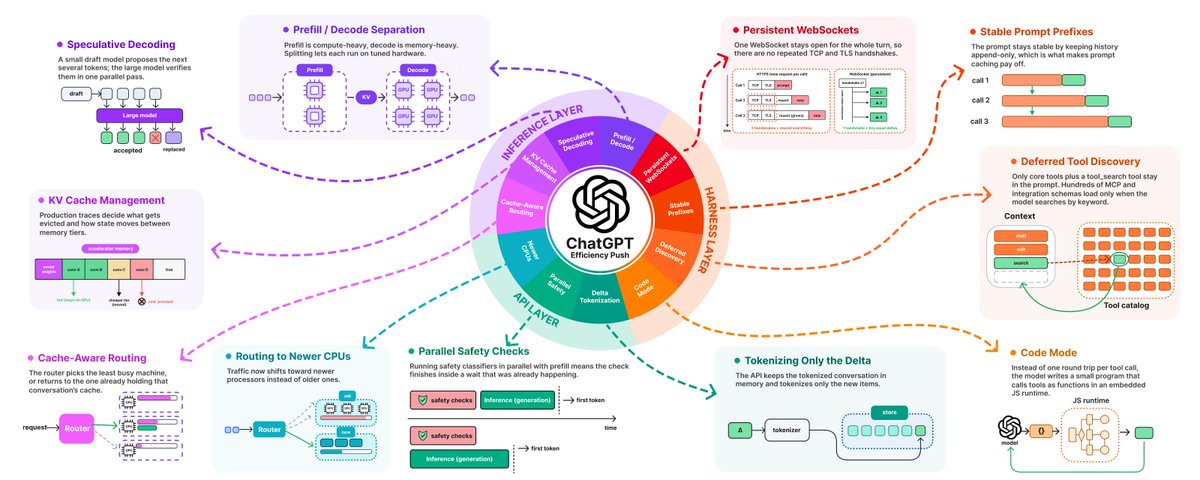
本文深入解析了 ChatGPT 如何通过 Harness、API 和 Inference 三层架构优化 Agent 循环,重点介绍了持久化 WebSocket、增量 Token 化、KV 缓存管理和推测解码等技术,以降低成本并提升效率。
本期早报探讨了 AI 智能体缩短实现周期后,创业者的机遇与挑战。文章涵盖 Sam Altman 对创业窗口的判断、GPT-5.6 的效率工程实践,以及如何通过 Skill Harness 将模型能力封装为可维护的产品功能。
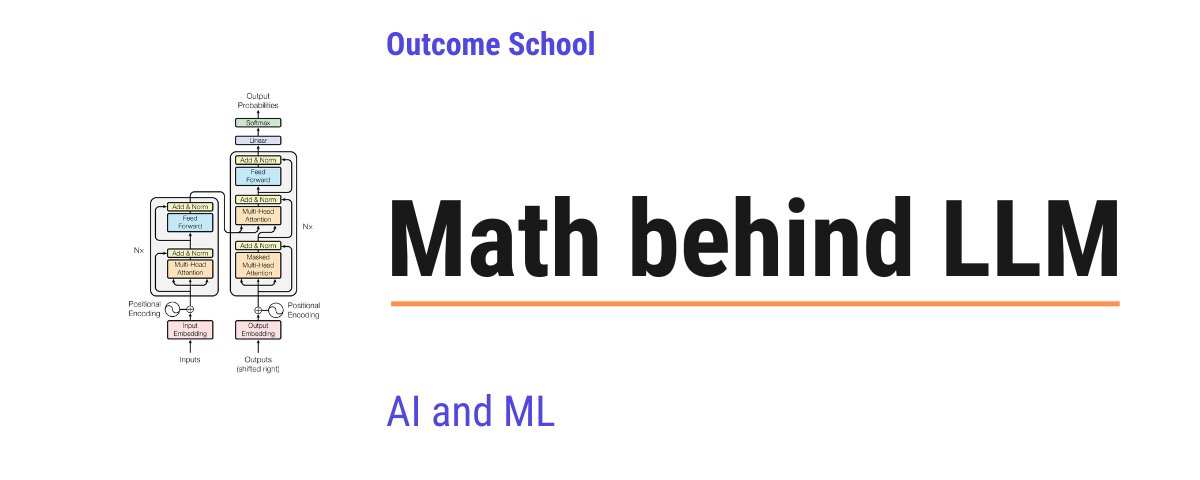
本文介绍了大语言模型背后的数学原理,涵盖Attention机制、缩放因子、反向传播、梯度下降、交叉熵损失、RoPE位置编码和RMSNorm归一化等核心概念。
本文介绍了如何针对 Claude 5 系列模型(Fable, Opus & Sonnet)进行高效提示。文章涵盖了通用提示原则、Fable 的自主任务处理、Opus 的日常优化以及 Sonnet 的高效应用,帮助用户最大化模型生产力。
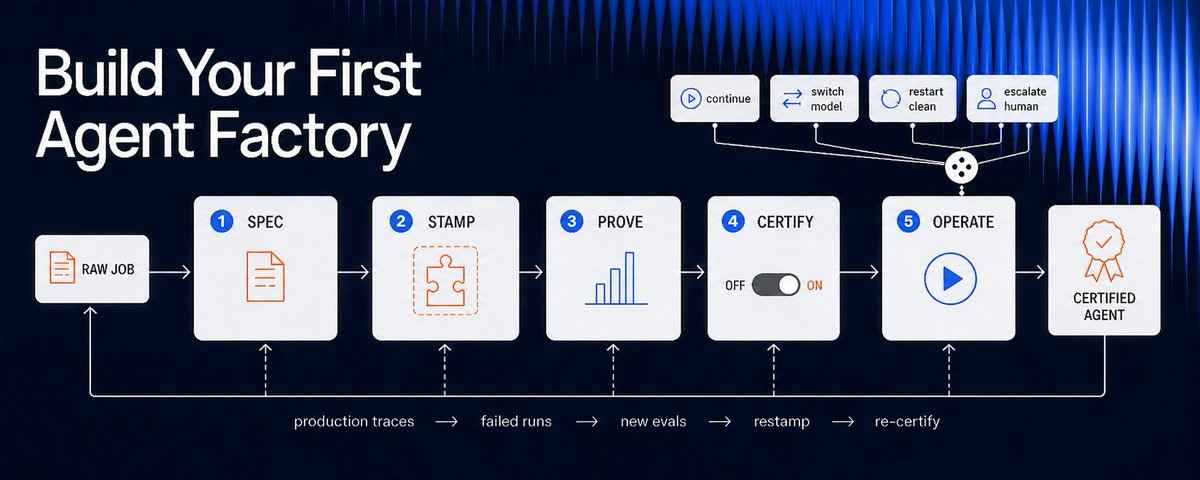
文章探讨了如何从构建单个智能体转向构建智能体工厂,以解决人工审核瓶颈问题。介绍了Sage决策模型在自动化质量控制和输出门控中的应用,提供了具体的实现思路和GitHub资源。
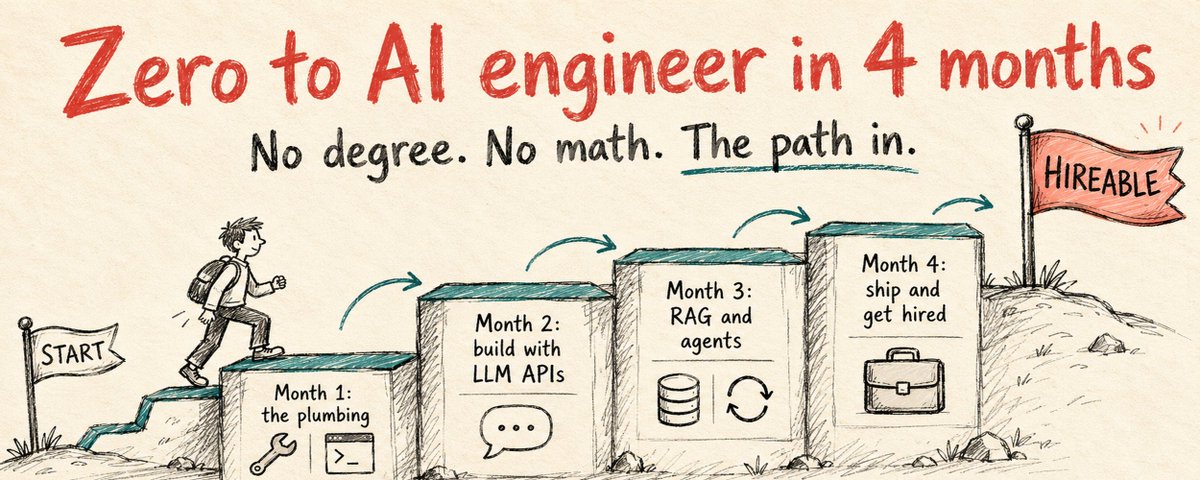
文章介绍了一条 4 个月从零基础成为 AI 工程师的学习路径。文章指出 AI 工程岗位增长迅速且薪资优厚,学位要求正在降低。作者强调职业转型者具备判断力和沟通能力的优势,并指出了初学者常犯的错误,如过早钻研理论、只看不练等。
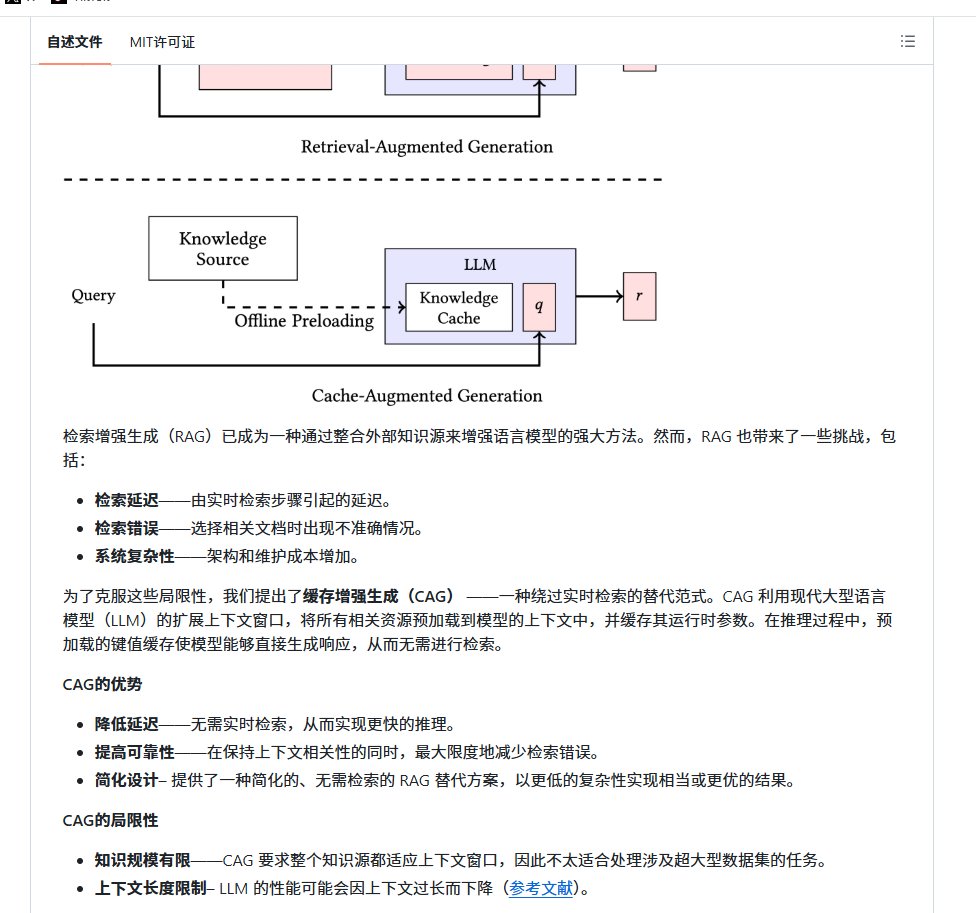
文章介绍了缓存增强生成(CAG)作为一种替代经典RAG流水线的新方案。CAG通过将全部知识预加载到模型上下文并缓存KV Cache,显著提升响应速度,解决检索延迟和召回缺失问题。适用于中短篇幅静态文档,但对大规模或频繁变动数据仍需传统RAG或混合架构。
本文介绍如何超越个人知识库,构建一个“公司大脑”。通过将文件系统与 AI 智能体结合,设定文件夹作用域、定时任务和自动汇报,让智能体自动处理营销、文件归档等工作,实现无需人工干预的全自动企业级知识管理。
文章深入解析了 Matt Pocock 的 AI 工具 /grill-me 的核心逻辑。该工具并非让 AI 直接执行任务,而是通过一套追问协议,强迫 AI 先理清需求再行动,解决了 AI 瞎猜和抢跑的问题。文章进一步阐述了完整的 AI 协作五步法:质疑、规格化、拆票、TDD 和架构评审,旨在通过纪律约束防止 AI 失控,提升人机协作质量。
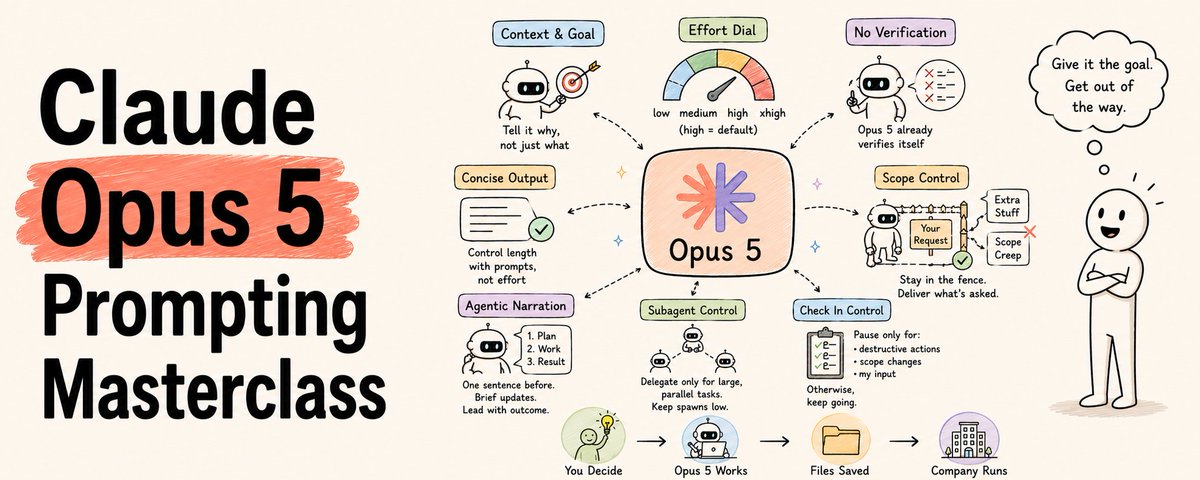
文章详细解读了 Anthropic 发布的 Claude Opus 5 模型及其官方提示指南。核心内容包括“Effort(努力)”设置的使用、从“怎么做”转向“为什么”的提示策略、删除验证指令以降低成本、以及如何控制响应长度和 Agent 叙述行为,旨在帮助用户最大化发挥模型效能。
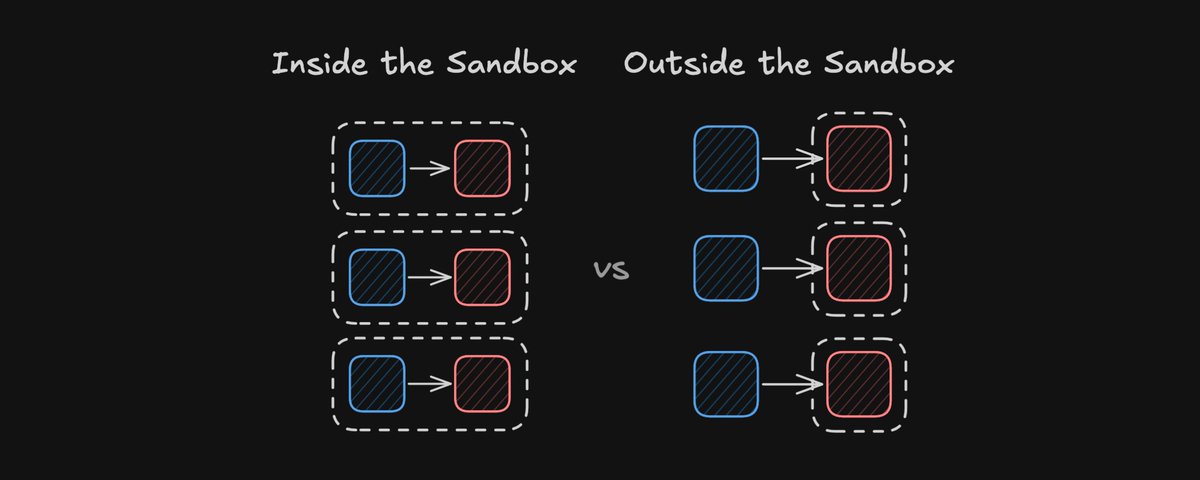
本文探讨了2026年以来关于Agent运行位置的争论,指出行业趋势是将Agent运行在沙箱之外。作者详细解释了沙箱内运行的三个主要问题:爆炸半径、信任边界和沙箱的间歇性运行,并提出了将沙箱作为工具暴露的正确架构,最后提供了基于Vercel AI SDK的实现示例和生产环境中的挑战。
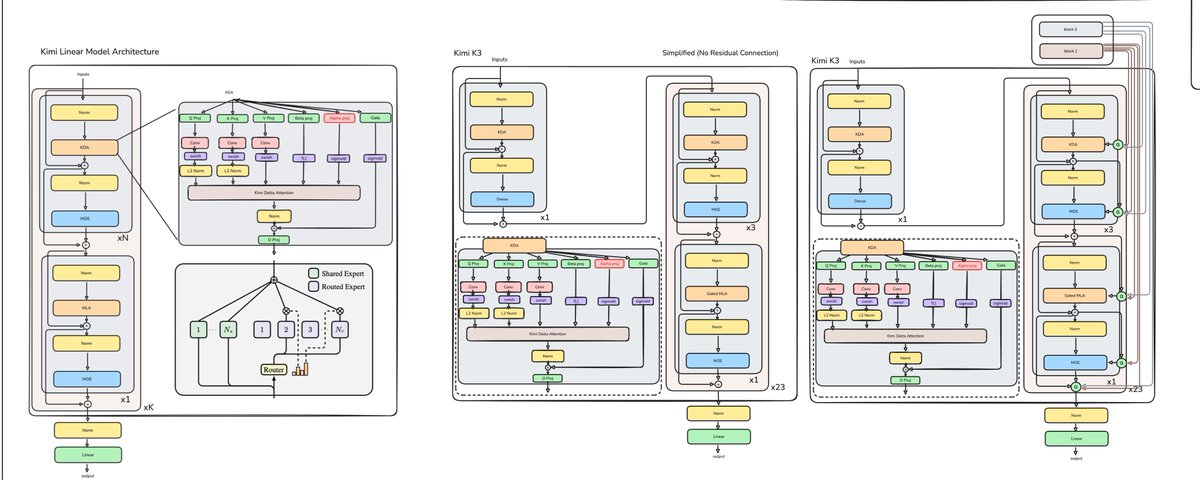
文章回顾了从 GPT-2 (2019) 到 KimiK3 (2026) 的大语言模型架构演进,重点对比了参数规模从 1.24 亿到 2.8 万亿的巨大跨越。深入解析了 GPT-2 的 Transformer 解码器结构、KV 缓存机制,并探讨了线性注意力机制在降低计算复杂度方面的原理与权衡。
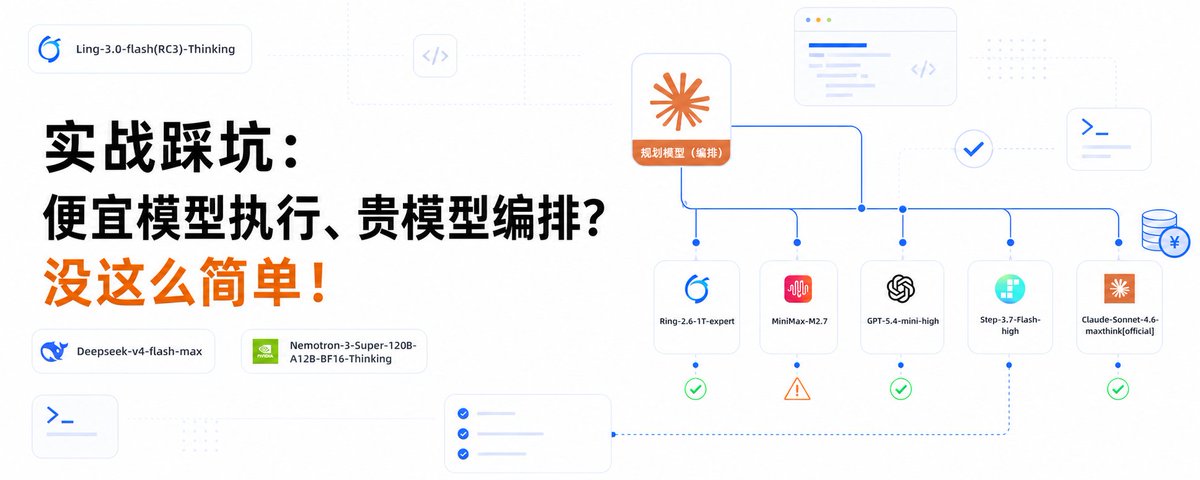
文章通过三个真实案例,验证了“贵模型编排、便宜模型执行”这一省钱策略。作者发现,虽然便宜模型在文本判定等任务上能打平顶尖模型,但在高复杂度代码和开放式视觉任务上存在局限。关键在于控制模型能力代差和任务可验证性,否则返工成本将抵消节省的 token 费用。
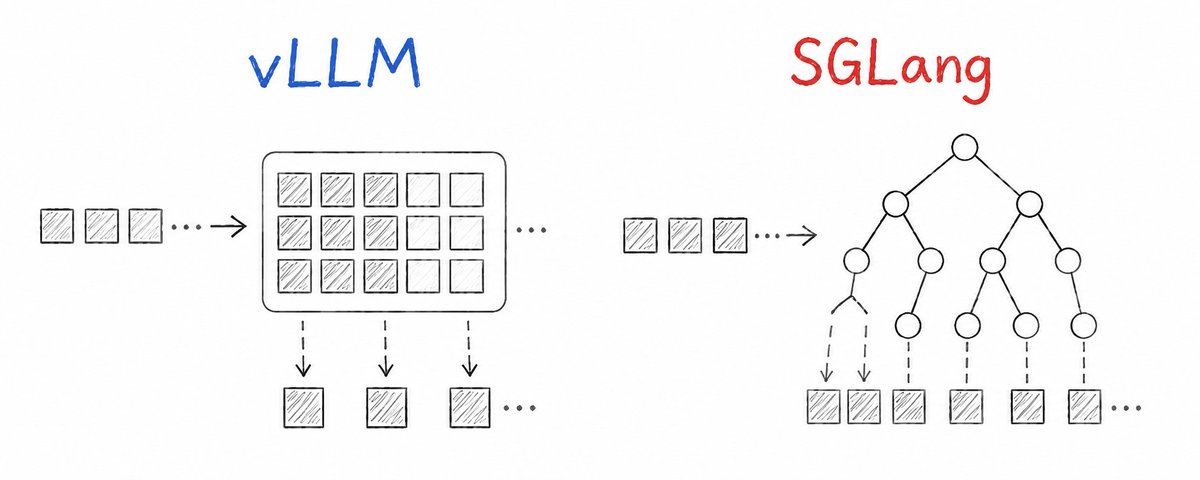
本文深入探讨了 PagedAttention 和 RadixAttention 两种技术。PagedAttention 通过类似操作系统的分页机制管理 GPU 内存,解决 KV Cache 的内部和外部碎片问题,显著提升并发处理能力。RadixAttention 则利用基数树索引缓存的前缀状态,实现跨请求的计算和内存复用,进一步优化推理性能。