Seedance 2.5 咖啡品牌视频生成示例
文章展示了使用 Seedance 2.5 视频生成模型创建咖啡品牌商业视频的案例。作者提供了一个详细的英文提示词,描述了从研磨咖啡豆、浓缩咖啡萃取、拉花,到多样生活方式场景(咖啡馆办公、街头滑板、户外早餐、欧式城市漫步)的完整画面。视频呈现暖色调、现代都市美学和高质感商业广告风格,展示了 AI 视频生成在品牌营销内容创作中的应用潜力。
文章展示了使用 Seedance 2.5 视频生成模型创建咖啡品牌商业视频的案例。作者提供了一个详细的英文提示词,描述了从研磨咖啡豆、浓缩咖啡萃取、拉花,到多样生活方式场景(咖啡馆办公、街头滑板、户外早餐、欧式城市漫步)的完整画面。视频呈现暖色调、现代都市美学和高质感商业广告风格,展示了 AI 视频生成在品牌营销内容创作中的应用潜力。
作者分享了做AI自媒体低粉变现的实战经验。在不到2万粉丝时,他以近5000元一条的价格与AI品牌达成合作,且无销售、无议价、轻交付。文章分析了平台为何愿意补贴创作者(积分、会员、佣金背后是价值交换),一条内容如何替品牌完成曝光、用户教育、注册转化并沉淀为内容资产。品牌不只看粉丝数,更看粉丝质量和创作者能否讲清产品场景。作者总结了低粉变现四步法:选定目标产品与用户、把功能翻译成场景、做出可公开验证的案例、用数据直接找品牌谈合作。
这是一篇面向新手的 AI 视频制作万字教程。作者系统介绍了 AI 视频的基础概念,包括文生图、文生视频、图生视频的区别与选择方法,对比了 Seedance 2.5、MiniMax H3、可灵、Wan 3.0、Veo 3.1 等主流视频模型的特点与费用,并汇总了 LibTV、TapNow、Flova、即梦等聚合平台的特色。教程详细讲解了图生视频的完整制作流程(写故事、定角色、列分镜、生成分镜图、图生视频、剪辑配声),并以《江边告别》为例示范了人物、分镜和视频提示词的写法,帮助读者制作出第一条文生视频和动作迁移视频。
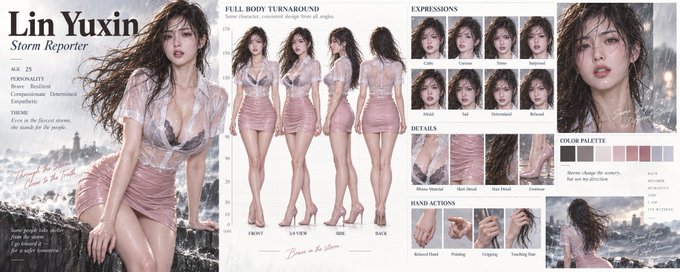
文章介绍了如何制作 AI 角色设定板(Character Sheet)以实现人物一致性控制,这是打造 IP 和提升作品留存率的关键技能。作者将角色卡视为一张角色视觉定义图,分四个步骤讲解:一是通过正面、侧面、背面多视角固定角色的脸部特征与整体造型;二是通过表情、微表情、姿态和手部动作增强角色表现力;三是补充发型、服装材质等细节说明以提升质感;四是结合图像生成工具与完整提示词模板进行实操。核心原则是所有小图都服务于中心主形象图,为 AI 提供一份'角色说明书'。
作者分享了使用对话式 AI 视频 Agent——Pexo,将小说高光片段制作成 AI 动漫短视频的完整流程。作者先用两个自研开源 Skill(novel-distill 提炼小说片段、avatar-keyframe-video 拆解动作关键帧)整理素材,再把 8 张参考帧和要求一次性交给 Pexo。Pexo 会先核实素材并规划镜头,再分段生成视频、配乐并合成。针对生成问题,作者通过文字反馈和 Mark to Fix 圈画功能进行定向返修,最后调整接点与节奏,产出 15 秒连贯成片。该方法省去多模型切换和繁琐制作管理,适合小说高光、角色宣传片等 AIGC 动漫账号的稳定复用。
作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。
文章深度拆解了海外操盘手 Lucas Patiri 一个人调度 590 位博主、累计 26 亿播放的 AI 短视频带货系统。其核心逻辑是:文案话术才是卖货关键,画面只要真实自然即可。系统通过爬取 13 万条真实买家评价提炼痛点话术、逆向拆解同行爆款前 3 秒、按开场骨架结构分类钩子、为博主生成个性化脚本、以及发布前用 Agent 严格审查前 3 秒是否跑题,解决'钩子缺失导致播放暴跌 4.2 倍'的死穴。文中还提供了三套可直接复用的中文 Prompt 模版,并给出国内商家、出海卖家和个人创作者的落地建议。
文章分析了2026年9月公众号、头条号、小红书加强对AI内容审核后,AI辅助写作文章阅读量下降、不被AI搜索引用的原因。作者基于1200多篇自媒体文章的数据统计指出,平台限制的并非AI本身,而是批量生产的低质内容。表现好的文章AI辅助比例通常控制在25%以内,同质化指数低于30%。作者提出三层人工覆写方法(信息覆盖、加入观点、语气校准),并建议发布前进行五维度检测:AI率、同质化、敏感词、标题合规与冷启动流量预测。核心结论是:AI只能提效,无法替代独立思考,每篇文章应补充100-300字第一手内容。
作者介绍了其所在的二次元 AIGC 顶尖团队的 Infra Team,职责涵盖 SRE、Data Infra、推理与训练基础设施建设、安全及 AI Infra 等。团队定位为偏 Infra 的 Product Engineer,与业务深度协作,目标是让服务变得更好。作者分享了地狱周成果:完成全服务 Service Mesh 化、迁移至 Istio Gateway、搭建 1:1 测试集群并完成压测和故障演练,零事故完成机房维保。团队注重效率与沟通,反对纯 AI 生成文档,招聘 SRE、推理、研发效能三个方向的校招到 Senior 人才。
作者分享了一套 AI 视频创作工作流:先用 ChatGPT 讨论并完善画面构思,再让 GPT-6 Astra 操控 Blender 生成极简白模预演,确定空间关系、人物走位、镜头路径和 Timing,最后将白模视频、场景参考图、人物三视图与提示词交给 seedance 生成最终画面。核心思路是用三维白模解决 Prompt 难以精准表达空间和镜头运动的问题,避免视频生成纯靠抽卡。作者不会建模也不懂运镜,仅通过对话就在 30 分钟内做出不错视频,宣告门槛降低的全民导演时代到来。
本文介绍如何利用 GPT6 Codex 的 Computer Use 能力全自动操控 Blender,构建零门槛的 AI 视频生产工作流。分为两大部分:一是复刻工作流,让 AI 自动分析参考视频的场景、人物动作和镜头运动,复刻出 3D 白模预演,再通过 AI 视频模型生成写实成片;二是原创工作流,仅用自然语言指令即可生成白模动画并迭代调整。白模作为'动态骨架'先锁死镜头、走位和空间遮挡关系,AI 只负责渲染画面,有效解决传统 AI 视频镜头漂移、人物变形、空间错乱等问题,实现低成本、高可控的视频生产。
作者苍何与 AgentWork 开源社区历时 30 天打造了开源模型实践指南《魔搭紫皮书》,已被 ModelScope 魔搭开源组织收录。全书 8 章 34 节、40 余万字,涵盖开源模型选型、部署运行、微调与评测、业务系统实践(如 AI 健身教练、智能客服质检)、AIGC 特别篇及 Agent 特别篇(MCP、Skill、Claude Code 等)。所有实验步骤均人工实操验证,旨在帮助开发者从下载模型到真正用好的全过程,项目开源在 GitHub,欢迎社区共创。
文章深扒 X 上一条爆火的 GPT-6 Astra 自主赚钱帖子,剔除链上套利等有水分的案例后,整理出 10 条真实的 AI Agent 商业流水线:多 Agent 链上套利、聪明钱跟单、Bug 赏金猎手、3D 交互教材、AIGC 内容矩阵投流、24 小时虚拟直播、3D 房产建模、体育数据分析工具、SEO 内容工厂、零代码小游戏开发。作者提炼出四个第一性原理:给 Agent 单一具象目标、锁定市场愿付费的交付物、建立无人值守自动化流水线、用 AI 算力优势降维打击人力密集行业,并为不同背景的读者给出对号入座的起步建议。
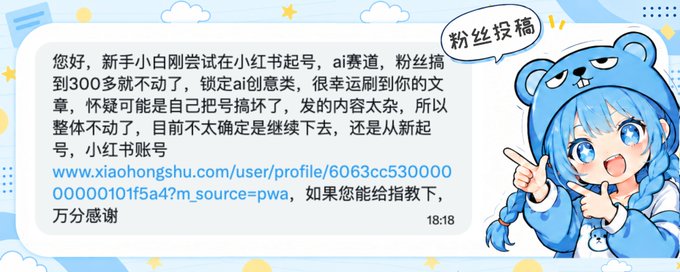
作者通过一位资深三维设计师的账号诊断案例,剖析了 AIGC 创作者自媒体起号失败的典型原因:技术水平卡在 70-75 分却执意死磕纯技术流,内容画风杂乱不聚焦,标题封面自嗨缺乏获得感。文章指出小红书是搜索逻辑平台,建议创作者垂直锁定细分赛道,把内容包装成“痛点+场景+交付物”的利他干货,目标先从 300 粉冲到 2000 粉以获得平台商务合作入场券。核心观点:技术够用即可,学会吆喝和利他思维比死磕技术细节更有效,70 分技术配上 80 分的运营能力就能在自媒体上拿到正反馈。
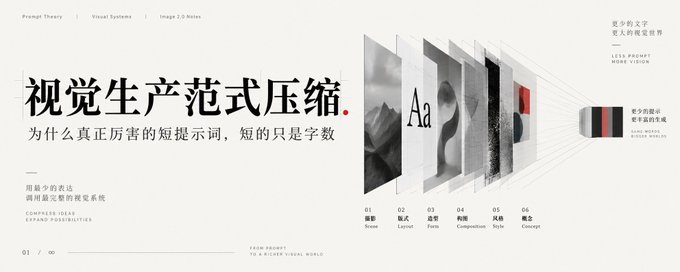
作者通过长期测试 Image 2.0 图像生成模型,发现极短提示词反而能生成异常完整的画面,并提出“视觉生产范式压缩”理论。核心观点是:提示词信息量与字数无关,关键在于“高密度视觉概念”——如“编辑式人像”“极简时尚封面”等概念,能自然带出一整套摄影、造型、构图、版式等视觉惯例。好的组合应让不同概念各有侧重,形成一份简短的创意简报。这种方法通过控制高层结构、保留低层执行自由,让模型在成熟的视觉系统内完成设计。提示词的核心能力已从“描述画面”转向“选择视觉世界”。
本文译写自 OpenAI Cookbook 的开源示例,整理了 GPT-Image 图像生成模型的提示词基本写法与 24 个实用示例。文章首先介绍提示词的组织顺序(场景、主体、关键细节、限制条件),并给出七条核心原则:写出可见细节、明确构图、交代人物姿势动作、逐字列出画面文字、改图时说明保留项、为参考图分配用途、一次修改一个问题。随后通过人物照片、信息图、广告、标志设计、四格漫画、应用界面、教学配图、演示页等场景,以及换衣、合成、透明背景提取、草图转写实、物体移除等编辑示例,展示了完整的提示词与 API 参数设置。
OpenAI 发布 ChatGPT Images 2.5,对图像生成能力全面升级。核心改进包括速度更快、画面更逼真、编辑与微调更精准。新增 Sketch 功能,用户可直接在 ChatGPT 中绘制草图,由模型生成完整图像,还支持将简笔画转为艺术风格、Logo 或 3D 黏土风格。生图过程新增进度条,光照与纹理更自然,并提供自由画布选风格、海报商品图模板、照片一键合成、图上标注编辑等功能。同时推出 GPT-Image-2.5 Flare 和 Sunburst 两个新模型,向所有 ChatGPT、Work 和 Codex 用户开放。
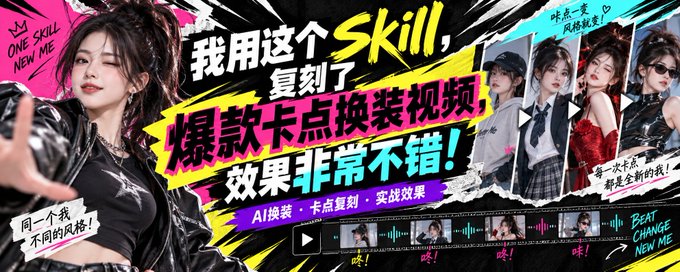
作者李岳分享了如何用自己开发的开源 Skill「female-outfit-director(女性换装导演)」复刻抖音爆款卡点换装视频。文章详细讲解了换装视频在 AI 生成中的难点,如人物一致性、首帧与视频因果关系断裂、双重身体等问题,并提出以结构母图(九宫格拼贴首帧)为核心的解决方案。Skill 能锁定人物身份、生成 7 套造型的首帧、输出精确到秒的换装时间轴,并内置 12 种换装机制。作者用 Seedance 2.5 实测还原度约 80%,项目已开源至 GitHub 并获 607 Star。作者强调 Skill 的价值在于将复刻爆款的方法论沉淀为可复用的工作流。
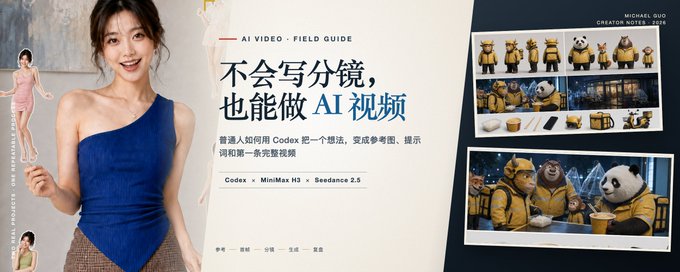
本文作者以零艺术基础为前提,完整分享了普通人用 AI 制作短视频的流程。作者详细介绍了如何用 Codex 分析参考视频、生成制作单、逐张生成测试首帧、编写视频提示词,以及在 MiniMax H3 或 Seedance 2.5 中生成视频并进行诊断修正的迭代方法。文章以 15 秒穿搭变装视频和多人分镜短剧(重建 Cuimao“牛来”视频)为例,涵盖角色设定图、场景站位、四格分镜、shot state map 和多参考提示词的编写技巧,强调“一次只修一个问题”、顺序继承生成等实操原则,帮助新手跑通第一条 AI 视频的完整制作闭环。
作者公开了其 VibeShot AI 摄影 Skill 的完整思路。核心是一个 Prompt 框架:表情+服装风格+场景+瞬间状态+摄影技法。与完全控制式 Prompt 不同,应只控制关键锚点,其余放权给模型,并为锚点准备足够厚的枚举变量池(表情池、服装池、场景池、景别池、焦段池、机位池、构图池、光线池等),形成“骨架+变量池”的“有边界的随机”逻辑。文中给出可直接在 ChatGPT 中运行的完整 Prompt,并开源了 Skill 版仓库,核心是通过加厚变量池产生更多组合。
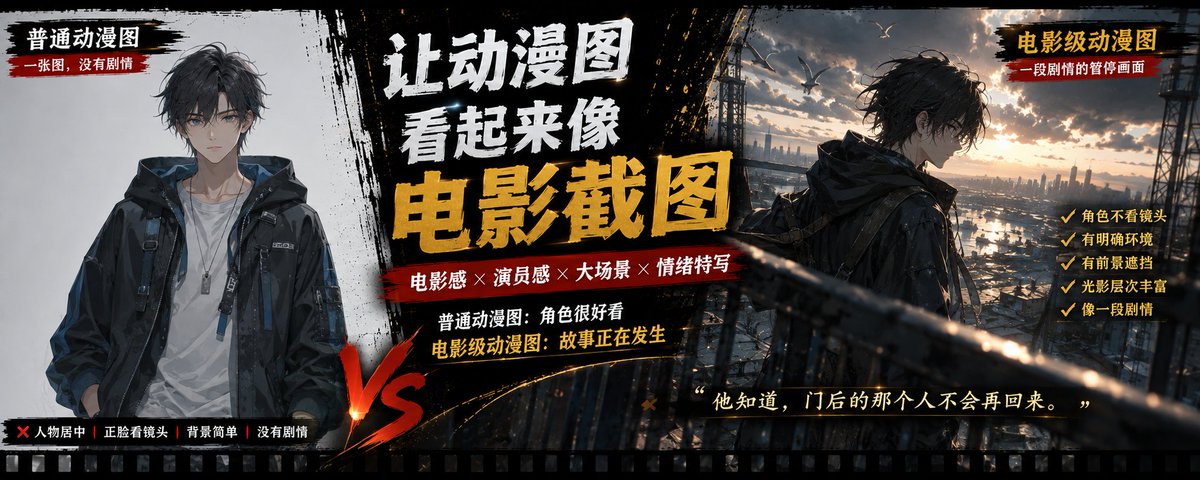
本文介绍4套电影级动漫叙事Prompt组合:通用电影感动漫(构图+体积光+景深)、动漫电影截图感(自然表演替代摆拍)、大场景动画开场(establishing shot交代世界观)、情绪电影特写(克制表情+浅景深)。核心是让画面具备电影构图、自然表演、环境叙事和情绪焦点四要素,使AI生成的动漫图不再像插画,而像正在发生剧情的电影镜头。附完整雨夜悬疑示例。
作者开源了一个 Codex 插件 MiniMax-H3-Cloud,利用开源的 MiniMax H3 模型和云端 GPU,让用户无需高性能电脑即可低成本生成高清 AI 视频。插件封装了从云 GPU 注册配置、GPU 选型(推荐 5090-96GB)、提示词优化到视频生成下载的完整流程,支持文生视频、关键帧生视频和参考图生视频三种模式。从安装到生成第一个视频全程不到 15 分钟,作者邀请大家到 GitHub 共建。
文章探讨了提示词工程中的一个常见误区:提示词越长,生成结果不一定越准确。当提示词同时包含过多人物属性、颜色、物体数量和空间关系时,模型可能生成看起来不错却悄悄偏离关键要求的图片。文中通过长提示词与精简提示词加分步编辑的对比实验说明,约束越多,属性串位、关系混乱和细节遗漏的概率越高。DetailMaster 研究证实,随提示词长度增加,文生图模型在人物属性、位置和实体关系上的准确率一致下降。作者建议不要把提示词写成一次性需求文档,而应先用短提示词锁定主体和构图,再通过局部编辑逐层增加细节,每轮只修改一类变量。
文章探讨公众号创作者关心的文章与贴图混发是否会限流的问题。作者引用微信公开课官方说明和实际案例指出,流量波动不等于限流,混发本身不会导致推荐受限。文章分析了文章与贴图各自的内容定位:文章适合深度内容,贴图适合快速交付重点,关键是保持面向同一类读者。同时详细说明了流量下降后的排查方法,包括内容质量、推荐合规性、账号违规检测和申诉流程,以及AI内容使用的规范要求,如真实标识、避免虚假人设和低价值批量生成内容。
文章介绍如何通过印度运营商 Jio 与谷歌的合作活动,以约 7 元闲鱼购买 18 个月 Google AI Pro 会员。作者详细讲解了 Google Flow 工作台的使用:Nano Banana 2 免费无限生图、Gemini Omni 1.1 Flash 文生视频(登顶竞技场第一)、Veo 3.1 首尾帧控制等功能。还提供了口播拼贴动画、Vox 风格纸雕动画、海外 AI 短剧三种实操玩法,以及提示词公式和避坑指南。最后提醒读者低价会员只是工具入口,关键是将其用于实际创作,建立自己的内容生产闭环。
文章整理了一套按图片类型分类的「图片反推提示词」模板,涵盖通用图片、字体/Logo设计、风景、摄影、插画、3D渲染、IP角色等七大类别。每类提供可直接复制使用的提示词模板,用于从参考图中提取主体、风格、色彩、光影、构图、材质等要素,生成精准的 AI 绘图 prompt。作者还推荐了 PromptCard 插件,可右键一键反推图片提示词,降低写 prompt 的门槛,并附使用方法:先选对应分类,把整段提示词发给模型,再配上原图即可。
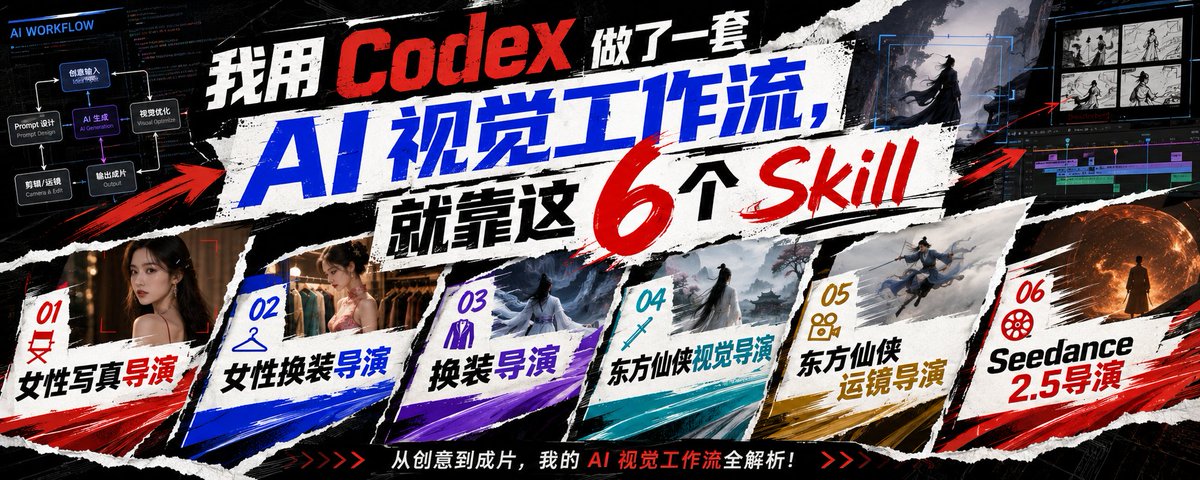
作者李岳分享了基于 Codex Skills 搭建的 AI 视觉工作流,包含六个 Skill:女性写真导演、女性换装导演、通用换装导演、东方仙侠视觉导演、仙侠视频导演和 Seedance 2.5 视频导演。通过将反复踩坑经验转化为规则、路由、默认值和交付格式,把主观审美翻译成可执行的画面参数,形成从人物、服装、场景到镜头和视频方案的完整视觉生产线,强调 Skill 保存的不是形容词而是逻辑判断。
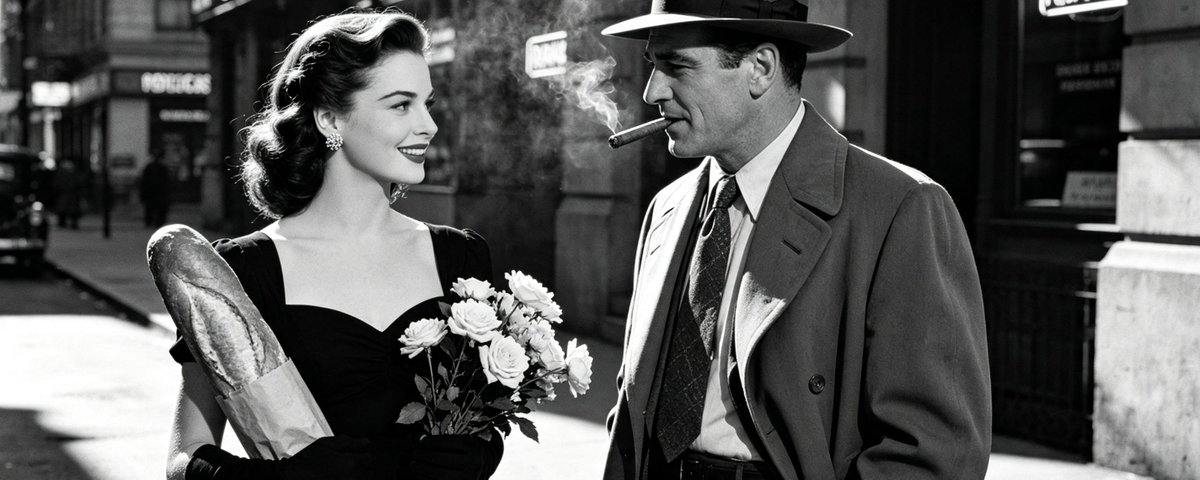
文章介绍AIGC视频生成中的第8种风格——Film Noir黑色电影风格,这是作者见过的AI味最少的视频风格。通过1940年代黑白老电影式的影像(高反差硬光、百叶窗条纹阴影、湿面反光、胶片颗粒质感),AI生成的视频可以以假乱真。作者分析了该风格AI感弱的六大原因:成熟的光影语法、接纳胶片瑕疵、符合现实物理规则、经过好莱坞验证的镜头范式、表达克制、氛围感强。文末提供了可直接使用的万能风格基底提示词,适合罪案悬疑短片、复古品牌片等场景。
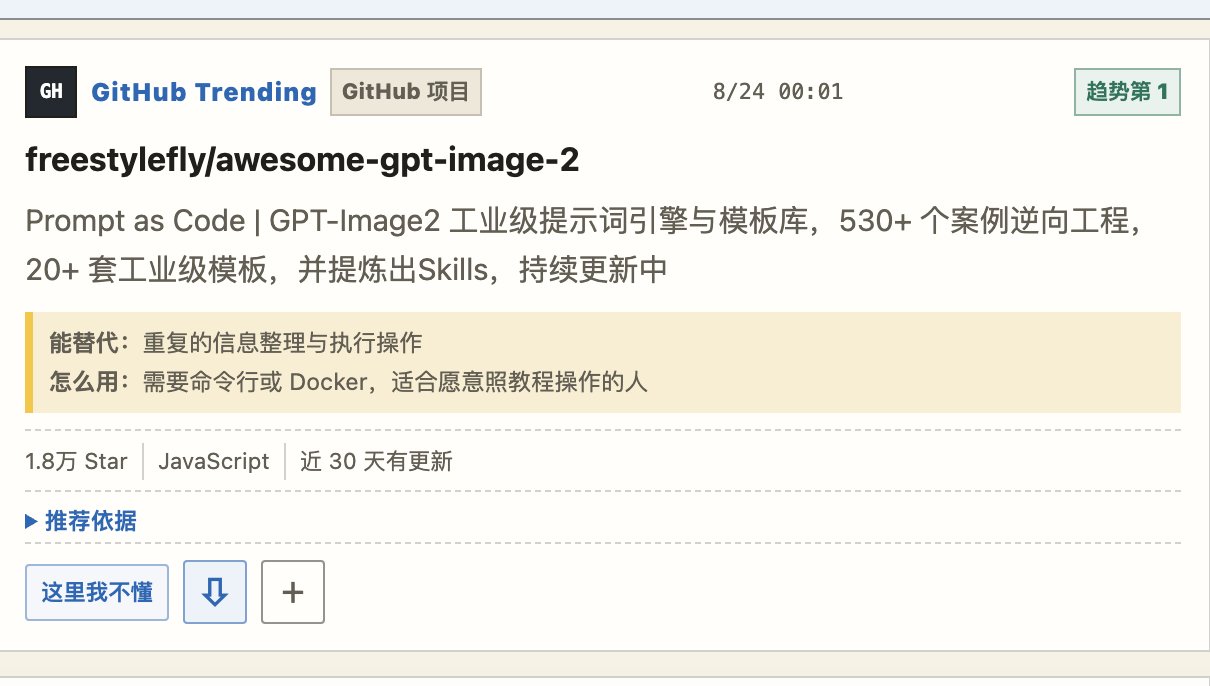
作者分享一个GitHub上爆火的开源仓库 awesome-gpt-image-2,两天内从1.5万Star涨到超2万。该仓库不同于普通提示词合集,先展示结果再拆解提示词写法。内容整理成20多套模板,涵盖主体、光线、材质、文字排版等维度,包括88个海报与排版案例、52个图表与信息可视化案例、31个人物与角色案例,可直接替换内容生成自己的图片,对电商、内容创作和AIGC非常实用。
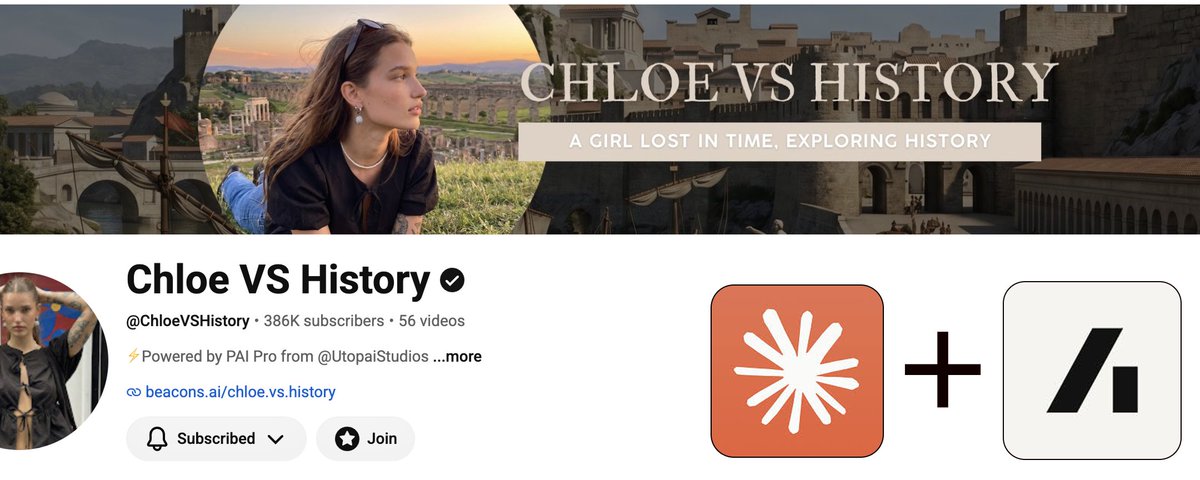
本文介绍如何使用一个名为 ai-history-vlog 的免费 Claude Skill,结合 Arcads AI 视频生成工具,复刻爆火的 YouTube 频道「Chloe VS History」的历史穿越 vlog 视频。用户只需提供一张正面照片、一段 90 秒语音和想穿越的历史时代,Skill 即可自动完成历史调研、以第一人称反应视角撰写剧本、锁定角色面部一致性、生成场景视频并剪辑成片。文章详细讲解了 MCP 连接器配置、Skill 安装、照片与语音素材的最佳准备方式等每一步操作要点。