Wiki 知识库

全部文档 / 标签: Deepseek

252 篇
清除

从Anthropic看用工变化与人的价值,LangChain CEO谈模型路由和运行框架,DeepSeek V4.1 Flash新版本发布

本期早报聚焦三大主题:一是Anthropic内部研究揭示AI如何重塑用工方式,初级技术岗占比从27%降至9%,员工角色从执行转向定义任务、分流输出与验证结果,判断力成为核心能力;二是LangChain创始人Harrison Chase谈智能体系统中模型、运行框架与上下文三层拆分,强调路由价值来自对任务结构的理解,并分享记忆与持续学习的实践经验;三是DeepSeek V4.1 Flash新版本发布,强化从零构建完整项目能力,开放Search/Fetch接口并单独计费。速览部分涵盖AI成本优化、智能体评估实操、美光存储产业史与AI安全等七篇内容。

技术 › LLM ginobefun 2026-10-1828.6 KB 1.7K 3 76

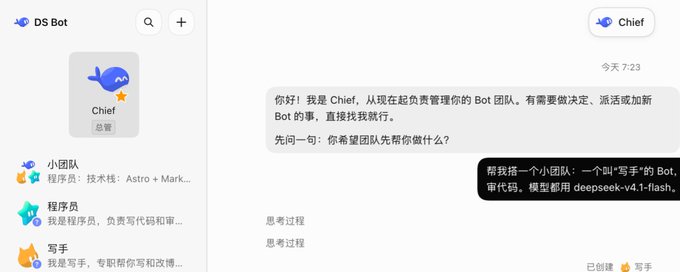
关于 DeepSeek Bot 的开发中的思考和取舍

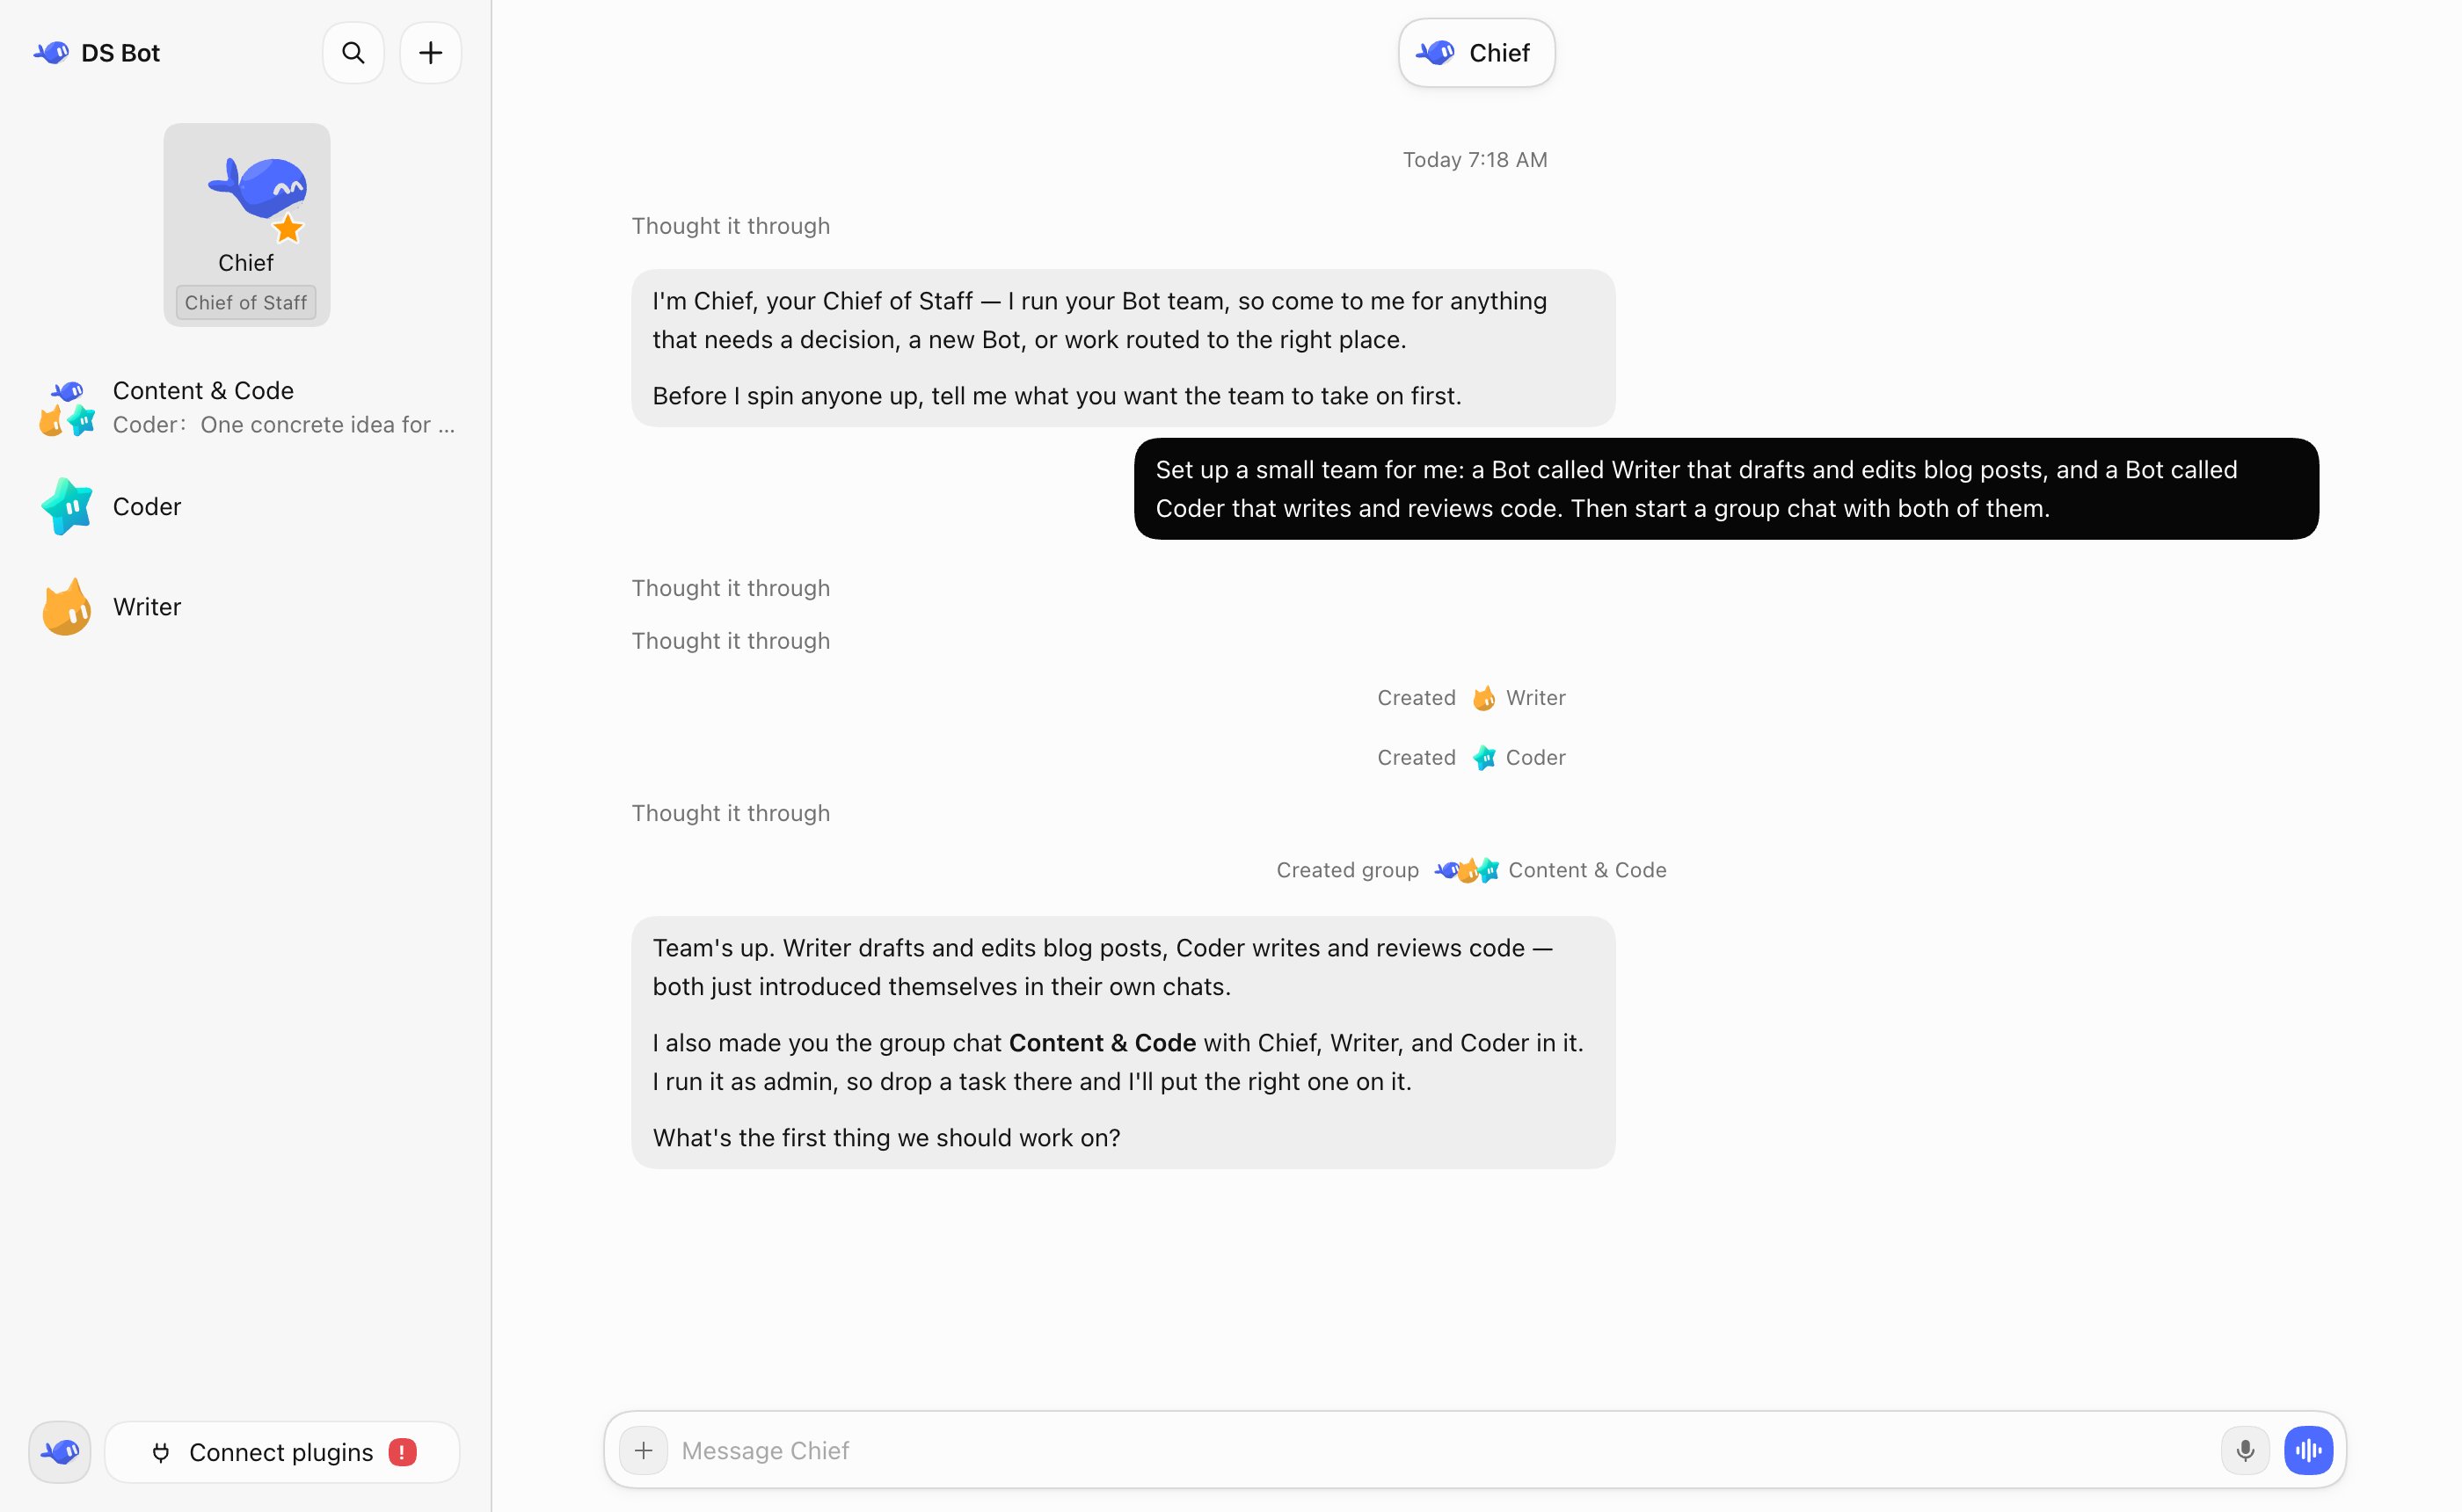
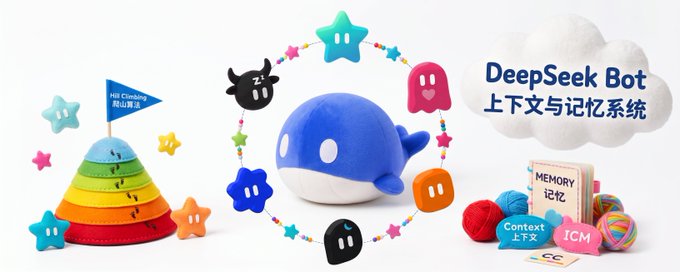
作者分享了基于 DeepSeek Harness 构建的持久化 Bot 团队 DeepSeek Bot 的开发经验,重点讲解上下文和记忆系统的设计。文章对比了传统压缩派(cc)和 Codex 的实验性上下文管理(ecm),提出智能路由方式(icm):由独立的 context manager 决定压缩还是切会话。为确保智能路由真正有效,作者采用爬山算法优化,通过搭建用例、设置训练测试集、逐步迭代提示词来提升效果,并强调屏蔽噪声和成本控制的重要性。记忆系统采用轻量设计并支持外接插件。文章最后感谢社区认可并预告 Computer use、Browser use 等更新。

技术 › Agent FeiZ 2026-10-177.2 KB 11.4K 87 78

DeepSeek-V4.1-Flash-1017 发布

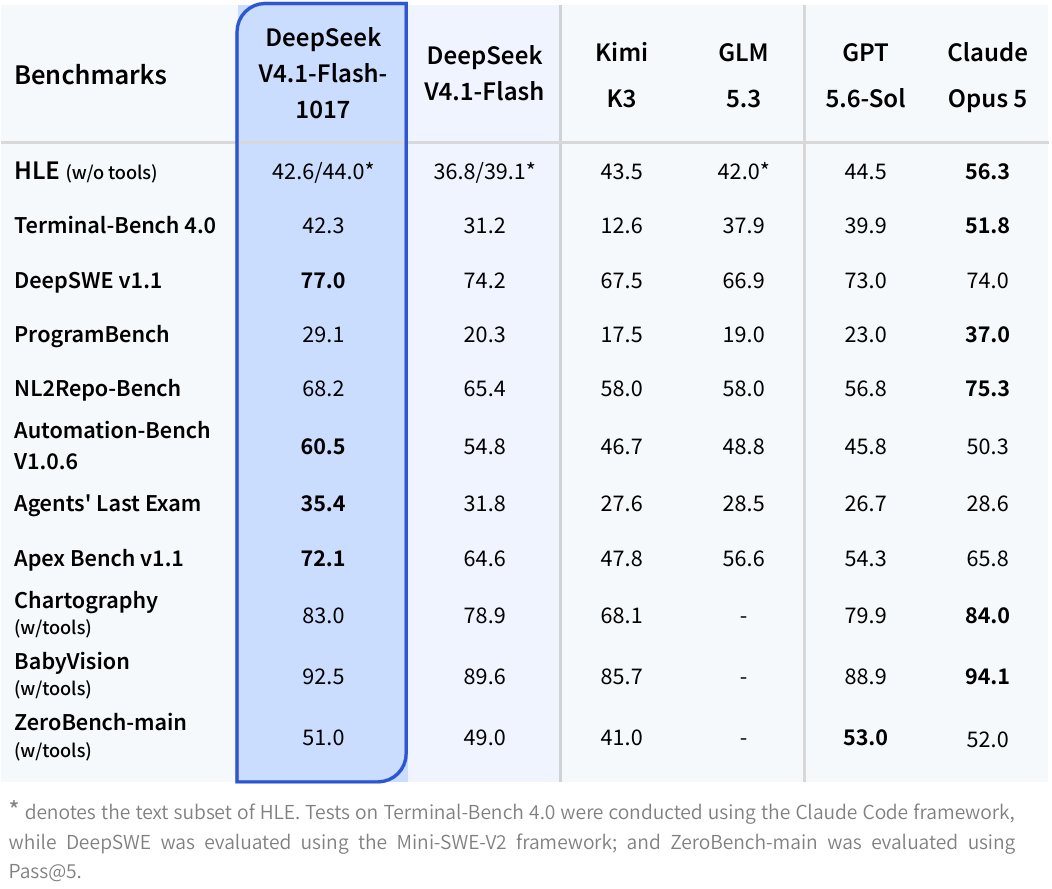
DeepSeek 发布 V4.1-Flash-1017 模型,性能更强、任务完成更快、输出更短,实现性能与成本的帕累托改进,已在官网、App 和 API 上线。模型通过强化学习自反馈优化端到端项目开发能力,覆盖游戏创建到 3D 建模等完整项目构建,并针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等工具优化。同时 Search & Fetch API 面向所有人开放,基于自研搜索引擎,每端点 $0.75/千次调用,已在 Hugging Face 和 ModelScope 开源。

技术 › LLM DeepSeek (@deepseek_ai) 2026-10-173.1 KB 79

一条命令没敲,一分钱模型费没花,我用 DSH 把 128 元的 ESP32-S3 刷成了 AI 音箱

作者购买了一块 128 元的立创实战派 ESP32-S3 开发板,全程未手动输入命令、未花模型费用,通过 DSH(DeepSeek Harness)搭配 WorkBuddy 免费额度的 DeepSeek V4.1 Flash 模型,将开发板刷成小智 AI 音箱。DSH 自主完成了查固件、校验 SHA256、烧录、读串口日志、定位唤醒词等操作,作者仅负责插线、配网和语音交互。文章记录了从配置免费模型、排除充电线问题、烧录固件到激活配网及后台调优的完整过程,展现了 Agent 驱动硬件开发的高效体验。

技术 › Harness Engineering 雨哥向前冲 2026-10-1619.2 KB 47.7K 130 88

DeepSeek 成立产品部急招产品经理和设计师

DeepSeek 将 Harness 团队及 Web、App、Platform 团队整合为“产品部”,由崔添翼负责,统一管理产品、设计与研发,并急招产品经理、产品设计师和项目经理。产品经理分 AI 产品和 Agent Harness 两个方向,要求有完整交付经验、深度使用 Agent 类产品(如 Claude Code、Codex、Manus 等)、懂 Agent 机制与 Context/Harness Engineering;设计师需具备 UI/UX 能力和 vibe coding 技能;项目经理为实习岗。工作地点为北京和杭州,全职与实习均可。

技术 › Agent Max For AI (@MaxForAI) 2026-10-163.7 KB 69

Personal Agent 是什么?为什么大厂都抢着做?连 DeepSeek Bot 都来了

文章介绍了 Personal Agent(个人智能体)这一新概念:拥有专属身份记忆、云电脑、可连接用户应用、24小时在线的 AI 私人助理。作者通过对比聊天 AI(只动嘴的顾问)、桌面端 Agent(用你电脑的实习生)、开源方案 OpenClaw(毛坯房)等形态,说明 Personal Agent 是替你干活的专属助理。并盘点 Grok Bot、Meta Muse、OpenAI Dots、DeepSeek Bot 等大厂产品扎堆发布的现象,解释其爆火原因:新模型已能稳定长时间干活,且掌握用户授权和长期记忆就是下一个超级入口。最后以 Grok Bot 为例演示创建 Bot、连接应用、追热点复盘数据、云电脑等真实使用体验。

技术 › Agent 程序员鱼皮 2026-10-1324.4 KB 12.5K 55 75

我问了 100 个开发者敢不敢给 AI 开 Full Access,结果评论区让我彻底破防了

作者在 X 上发起调查,询问开发者是否敢给 AI Agent 开启 Full Access(全权限自动执行),收到 100 多条回复后发现超过 85% 的重度玩家都在开全权限运行。文章总结了敢开全权限的三大理由:频繁确认打断工作流、手动确认只是心理安慰(确认疲劳)、翻车需靠工程兜底而非人眼审查。并详细介绍了 Claude Code、Codex、Gemini、DeepSeek、ZCode 五大工具的全权限开启方式与安全护栏配置,最后给出保命三件套:终端拦截器 dcg、Git 高频提交与备份、容器/虚拟机环境隔离,实现高效与安全的平衡。

技术 › Agent Kimberly 2026-10-1214.6 KB 4.5K 26 84

一个假期,用 AI 自制 Telos 全能 App 替代多个付费工具

作者在国庆假期用 3 天时间和 Astra 聊天,用 credits 开发出了全能 Mac 应用 Telos,替代了 Granola、Typeless、Things、CleanShot X、Notion Calendar 等多个付费软件,每年省下约四五百美元。Telos 基于 DeepSeek 模型和 Hermes Harness,功能包括:状态栏 Todo list、自动会议转录与总结(ScreenCaptureKit + Qwen3-ASR)、AI 语音标注截图、全局语音输入等。作者认为这些 App 打着买断制旗号行订阅制之实,经济下行下软件生态出现'自产自用'的消费降级趋势。

技术 › Harness Engineering Cellier 2026-10-126.0 KB 10.6K 36 72

从公开内容发布到AI搜索引用:衡量AI搜索系统的脆弱性

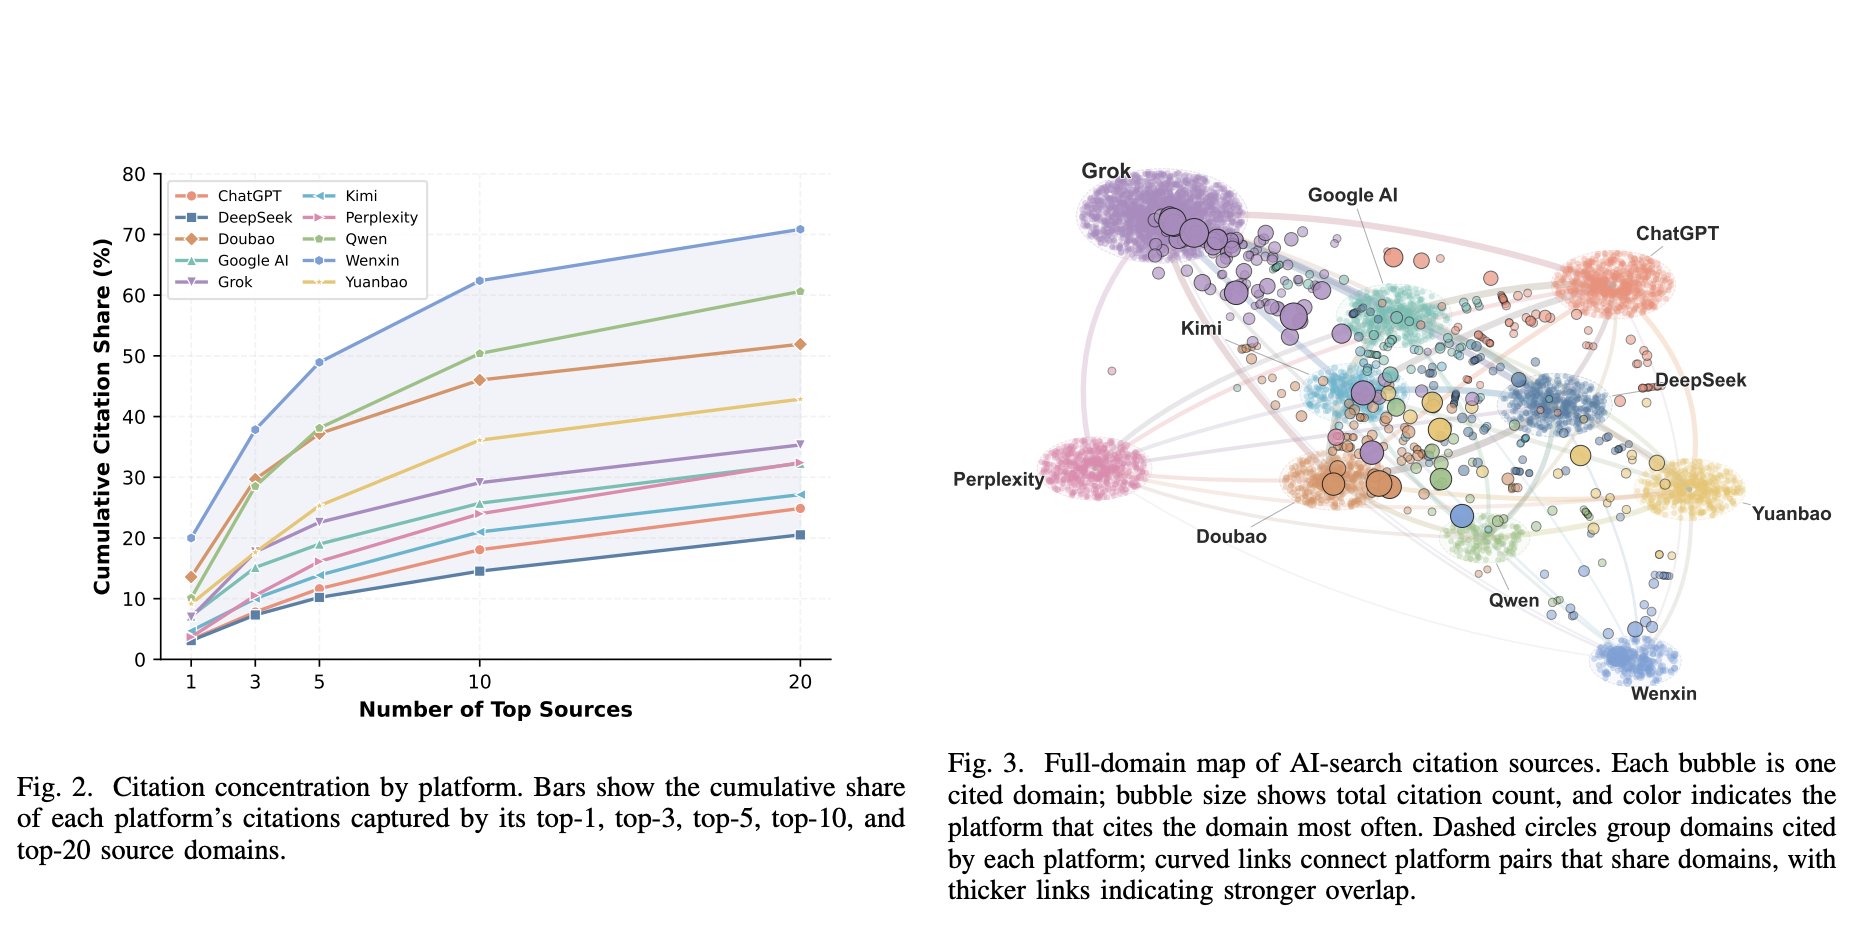
复旦大学与上海浦东密码学研究院团队发布论文,研究10个AI搜索平台(ChatGPT、Perplexity、豆包、DeepSeek等)的引用行为。研究发现:不同平台信源选择偏好明显,头部20个域名可占引用70%以上;80%平台引用了人为发布的虚构概念;发布渠道的选择比内容数量更重要,1篇高偏好平台文章效果可超过20篇低偏好平台文章;14美元即可购买GEO服务使内容被AI引用。作者总结:AI搜索的权力在于决定哪些信息有资格成为答案,GEO应面向不同平台建立独立信源画像,目标是让AI正确理解品牌。

技术 › LLM 姚金刚 (@yaojingang) 2026-10-114.6 KB 81

正式介绍开源的 DeepSeek Bot

作者 FeiZ 正式发布开源插件 DeepSeek Bot(ds bot),基于 DeepSeek Harness(dsh)构建,支持使用自己的 API Key 拥有一组持久化运行的 Bot,具备上下文管理与记忆能力。产品包含 Main Bot 总管家、多 Bot 群聊协作(通过管理员机制优化费用),并可接入任意模型乃至本地 agent。作者已完成多项 dsh 插件的兼容性测试,未来计划支持浏览器与电脑操控。项目目前处于早期阶段,用户可通过 GitHub 仓库或 dsh desktop 插件页安装体验并反馈问题。

技术 › Agent FeiZ (@Fei2411) 2026-10-115.1 KB 72

CC Switch 聚合模式使用指南

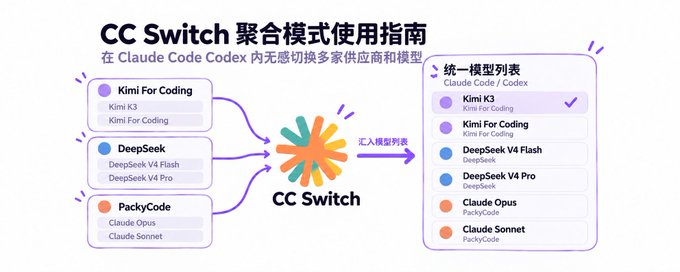
本文介绍 CC Switch 4.0 新增的聚合模式,让 Claude Code 和 Codex 用户可以在客户端内无感切换多家模型供应商。文章从实际效果入手,讲解聚合模式的请求分发原理,并分步骤演示配置流程:进入聚合页面、添加供应商与模型列表(支持一键获取和自动补全模型信息)、将供应商加入聚合名单、选择默认供应商并开启。文中还对比了直连、路由、聚合三种模式的适用场景,说明 Claude 与 OpenAI 官方订阅的支持范围与账号风险差异,以及 Codex 重启、缓存成本等日常使用细节,并向开源项目 opencodex 致敬。

技术 › Claude Code Jason Young 2026-10-0913.9 KB 28.5K 143 88

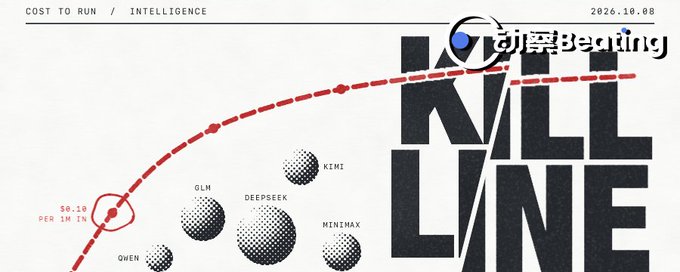
中国大模型的斩杀线,被斩杀了

Anthropic 发布 Haiku 5.5,将短请求价格压至上一代十分之一,OpenAI 同步降价,美国巨头以巨额资金和工程优化发起价格战,接管了帕累托前沿。中国大模型曾凭借 DeepSeek 等极致性价比焊死斩杀线,迫使硅谷换用中国开源基座,但自身陷入增收不增利、算力告急与防御性涨价的困境。随着美国巨头闪电降价,中国模型股价暴跌,低价护城河被填平,斩杀线反被斩杀。

技术 › LLM 动察Beating 2026-10-0814.6 KB 60.8K 80 76

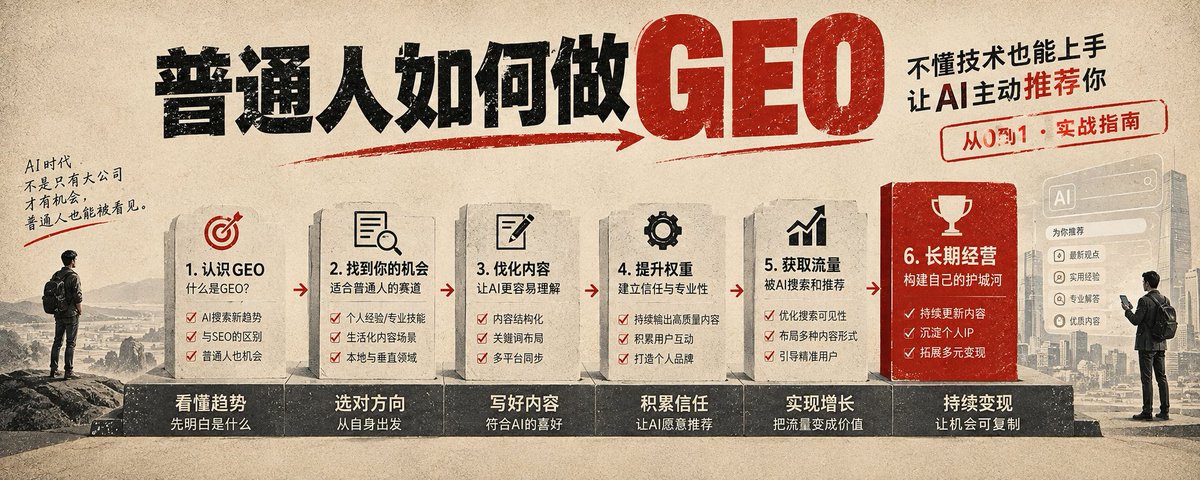
普通人如何做GEO:AI时代的搜索引擎优化实战

作者认为随着用户解决问题习惯从搜索引擎转向AI问答,AI答案已成为新的黄金广告位,当前正处于企业预算尚未跟上的窗口期。文章记录了作者实操GEO项目的全过程:通过电话营销获客碰壁后转型老客户成交,并详细介绍了GEO交付方式,推荐在十二个国内内容平台分发利于AI收录的营销内容。作者测试发现不同AI(文心一言、豆包、DeepSeek等)优先信任的内容源不同,通过编写提示词批量生产内容,第五天即见到收录效果,验证了7-15天见效承诺可行。

技术 › LLM Chill 2026-10-0712.6 KB 78

How to set up your first Local LLM in 10 Steps (Full-course)

这是一篇本地部署 LLM 的完整入门教程。文章首先说明开源模型(Qwen、DeepSeek、GLM 等)已接近闭源前沿约四个月,而 API 订阅配额却在缩水,因此本地部署的价值日益凸显。教程从 Step 0 开始:检查内存、按内存三分之二规则选择模型、安装 Ollama 并运行第一个模型。随后解释了本地模型的核心优势(数据隐私、零边际成本、不受限)与局限(性能不及闭源前沿),分析了订阅补贴经济的不可持续性,并指导读者根据任务需求选择硬件,强调容量决定装得下、带宽决定跑得快、利用率决定是否划算。

技术 › LLM Movez 2026-10-0531.6 KB 258.1K 412 84

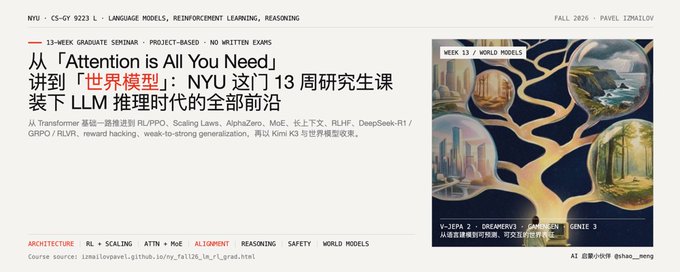
NYU 13周研究生课:LLM推理时代的前沿全景

文章介绍了NYU Tandon 2026年秋季由Anthropic研究员Pavel Izmailov开设的研究生课程《Language Models, Reinforcement Learning, Reasoning》。课程共13周,除Sutton & Barto教材外全部使用原始论文,沿「预训练→架构与训练效率→后训练RL→对齐与安全→前沿与未来」的主线展开,涵盖Attention机制、扩展律、Muon优化器、RLHF、GRPO与RLVR、奖励过优化、可扩展监督以及世界模型等前沿主题。文章分析了课程叙事逻辑,指出RL重回舞台中心、中国实验室工作成为正典、安全对齐被当作工程学科等趋势,并给出自学者建议。

技术 › LLM meng shao 2026-10-0512.9 KB 7.9K 72 80

Pi Durable 实战指南:给自己的 Agent 加上断点续跑

文章介绍了 Pi 发布的持久化运行时库 pi-durable,用于保存 Agent 的会话、工具调用和任务状态,实现进程中断后的断点续跑。作者讲解了核心机制:Harness 负责调度模型请求和工具任务,Storage(如 SQLite)保存提交后的记录;应用可通过 defineDoc 定义业务进度状态,并通过 replay 策略(safe/unsafe)控制被中断工具调用的重跑行为。文章以一个读取本地章节并保存进度的 TypeScript Agent 为例,详细演示了环境准备、依赖安装、代码实现,以及正常运行、重启恢复、中途退出后续跑的完整流程。

技术 › Agent jiangkoumo 2026-10-0419.1 KB 7.5K 63 82

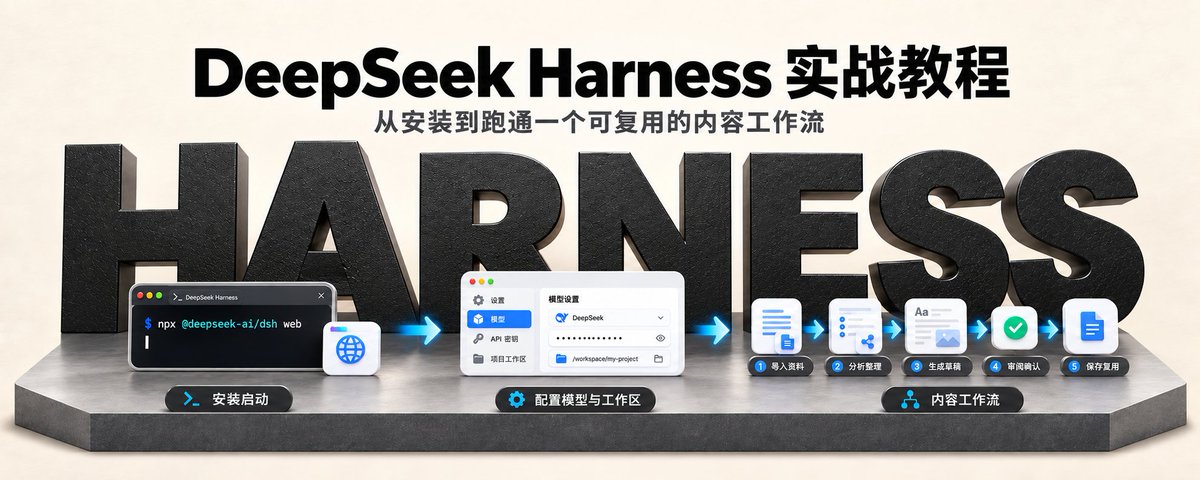
DeepSeek Harness 实战教程:从安装到跑通可复用的内容工作流

本文是 DeepSeek Harness 的实战教程。Harness 是一个可扩展的智能体运行环境,基于 Cordis 构建,一切皆插件。文章介绍了准备工作(Node.js、API 密钥、测试目录)、启动方式(npx 或源码运行 Web UI)、模型配置与工作区选择,并以生成可审核的小说推广文案为例,演示了素材分析、结构化任务指令、执行检查、人工审核到文件保存的完整闭环。还扩展了团队内容初稿、资料整理、插件接入等方向,给出批量处理的分阶段建议和常见问题排查,并强调最小权限、独立环境等安全边界。

技术 › Harness Engineering Kelvin 2026-10-0312.0 KB 83

DeepSeek 开源 dsh-libreoffice-kit:给 AI 配上「看文档的眼睛」

DeepSeek 悄悄开源了 dsh-libreoffice-kit 组件,原本隐藏在 DeepSeek Harness 中。该组件解决了 AI 生成文档却看不到排版效果的痛点:可将 Word、PPT 渲染成图片让 AI 查看排版,真实计算 Excel 公式以核对结果,自带字体管理避免中文乱版,并支持文件级隔离处理防止单点故障。这使 AI 能够自己写、自己看、自己改文档,无需人工逐页返工。文章指出 AI 办公领域的竞争不只在于模型能力,底层基础设施同样关键。

技术 › LLM 程序员鱼皮 2026-10-011.1 KB 66

国庆 AI 羊毛合集!1 亿 Token、最高 75 天免费、30 天订阅……这 9 波现在还能领

作者整理了国庆期间 9 波国内 AI 厂商的免费福利活动,包括豆包工作再送 30 天订阅、智谱 ZCode 送 1 亿 Token(10 月 7 日截止)、Qoder 的 Qwen3.8-Flash 免费及每日 100 Credits、阶跃 Step Plan 最高可叠 75 天、WorkBuddy 的 Hy3/Hy4 preview 限免及国际版 DeepSeek V4.1 Flash 免费至 10 月 9 日、腾讯 LightVela 新用户免 1 个月加 4500 积分、DeepSeek Harness 送 6 元赠金,以及 MiniMax Code 签到积分翻倍。文章详细列出各活动的领取条件、操作步骤和截止时间,提醒读者优先领取有明确截止日期的权益。

技术 › 工具与效率 向箔 Foil 2026-10-0112.3 KB 15.5K 117 78

号商想5万收的Claude防封攻略V2.0

作者分享了Claude账号防封的V2.0经验攻略。核心结论是Anthropic已从防止中国用户转向防止滥用、薅羊毛和违反价值观,封号策略基于综合风险判断。不容易被封的账号特征是养得久、用得少、有价值、风险小。具体建议包括:IP纯净度有一定价值但权重下降;用谷歌/苹果渠道注册订阅更安全;新号先免费用一个月,从20刀循序渐进升级到100刀;账号内容要有价值(如学术论文、前沿问题),会被模型吸收训练;周用量保持在60%以下降低风险。作者认为Claude Opus 5.5很强但普通代码任务国产模型已够用,推荐支持DeepSeek等国产模型。

技术 › Claude 扣子是谁呀 2026-10-019.5 KB 27.2K 144 82

DeepSeek Harness v0.2 桌面版发布

DeepSeek 发布 Harness v0.2 预览版,推出 macOS 和 Windows 桌面应用。新版本改进了文件显示、内容预览和代码变更展示,简化定时任务的设置与管理。核心亮点是插件系统:新增插件管理器,无需终端命令即可安装、禁用或卸载插件;实验性创作者模式允许用户用自然语言描述需求,自动创建插件。官方数据显示 Harness 是 DeepSeek API 用户中最广泛使用的编码 Agent。未来计划改进沙箱与安全、Agent 团队、长期记忆、浏览器自动化、远程访问,并建设官方插件市场,完善插件 API 兼容性。

技术 › Harness Engineering DeepSeek Harness 2026-10-017.2 KB 1.1M 5.9K 70

Marvis马维斯定位升级成AI管家,好像要支棱起来了

作者重新体验腾讯Marvis马维斯Agent,其升级定位为24小时AI管家,区别于多数Agent主攻办公和编程场景。新版采用Hy4与Deepseek V4 Flash双模型自动组合,免费且支持自定义接入第三方模型。文章实测了电脑体检、管家团队(电脑、文件、软件、浏览器四位Agent)、本地知识库/图片库/应用库管理等功能,并介绍其与绿联、飞牛合作将Agent能力扩展到NAS,未来瞄准手机、汽车、智能眼镜等跨硬件场景,认为AI管家方向想象空间较大。

技术 › Agent 马佳彬 2026-09-299.9 KB 580 5 73

超详细 Claude Code 终端教程,从入门到精通(国产模型版)

本文是面向零基础用户的 Claude Code 终端版详细教程。作者先解释了 Claude Code 的概念——住在终端里的 AI 助手,能直接读写本地文件、执行命令,与网页聊天版的区别在于它能直接操作本地环境。教程覆盖完整流程:安装(一行命令)、启动登录、接入第三方模型平台(如 DeepSeek、OpenRouter,包括 CC-Switch 工具和手动配置环境变量的方法)、用 curl 命令验证配置是否成功。文章还讲解了官方与第三方模型的区别、API 密钥安全注意事项、常见配置错误(如 401/404 报错)的排查方法,以及不同项目使用不同模型平台的配置技巧,帮助小白在终端里把 Claude Code 用起来。

技术 › Claude Code 想风 2026-09-2933.0 KB 26K 121 87

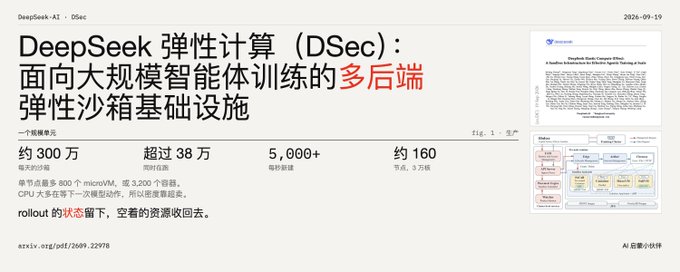
DeepSeek 弹性计算(DSec):面向大规模智能体训练的多后端弹性沙箱基础设施

本文解读 DeepSeek-AI 与清华大学合著的 DSec 论文,这是支撑 DeepSeek V3.2 到 V4.1 智能体 RL 训练的生产级沙箱基础设施。文章分析了智能体训练负载的七大特性(突发创建、CPU 稀疏、有状态长寿命、高度异构等),介绍了其无状态控制面、分层代理数据面架构,以及可组合环境分层、高密度内存管理、QoS 感知 CPU 调度、按需镜像加载四大核心机制。还深入阐述了 agent loop 与训练解耦、暂停恢复协同、防 reward hacking 的安全对抗实践。作者认为这标志着智能体能力竞赛正在演变为基础设施竞赛。

技术 › Agent meng shao 2026-09-2812.9 KB 4.8K 11 83

号商想2万收的Claude防封攻略(26年9月版)

作者分享了保持Claude账号不被封的经验与猜测。核心结论是:账号纯净度并非关键,账号价值高、养得久、用量少才是防封要点。文章提出Claude背后存在账号价值标定体系,若账号内容有训练数据价值(如研究、建模等前沿问题)则不易被封。作者还讨论了IP纯净度作用有限、逐步订阅升级、控制用量、中文与时区影响不大、数据留存风险以及推荐通过谷歌或苹果商店订阅以降低风险等内容,并建议普通任务可多用国产模型如DeepSeek。

技术 › Claude 扣子是谁呀 2026-09-277.7 KB 55.5K 154 74

Is ENGRAM free lunch? Does it not impact AI model quality?

文章深入分析Engram技术:将序列嵌入存储到可卸载至DRAM的嵌入表中,节省HBM内存、减少FLOPs,从而降低AI推理成本。在参数和训练预算相同的对照实验中,Engram-27B相比MoE-27B不仅没有降低性能,反而显著提升(MMLU从57.4升至60.4)。作者指出Engram参数分配存在约20-25%的最优区间,过高会挤占MoE专家参数损害性能,且不能完全替代FFN(FFN负责概念运算)。结论认为Engram确实是一种'免费午餐',DeepSeek、美团LongCat、Qwen等已采纳该技术。

技术 › LLM GDP 2026-09-2710.0 KB 38.3K 64 73

出海独立开发:第一个产品怎么选、怎么做、怎么活下来

作者结合一年多出海独立开发经验,分享第一条产品的三条核心建议:一是优先做 ToC 套壳产品而非 ToB,用最低成本最快验证商业闭环;二是开发采用 Next.js 加 DeepSeek 辅助编程,直接用国内中转站 API 并通过比价网站控制成本,把精力集中在产品和增长上;三是 AI 时代个体价值被放大,创业者应先积累原始资本、尊重产品生命周期、主动结识优质人脉。最后总结为九个字:选得对、做得对、坚持做,三者兼备才能存活。

技术 › 工具与效率 AI创业阿彬 2026-09-252.1 KB 2.8K 14 66

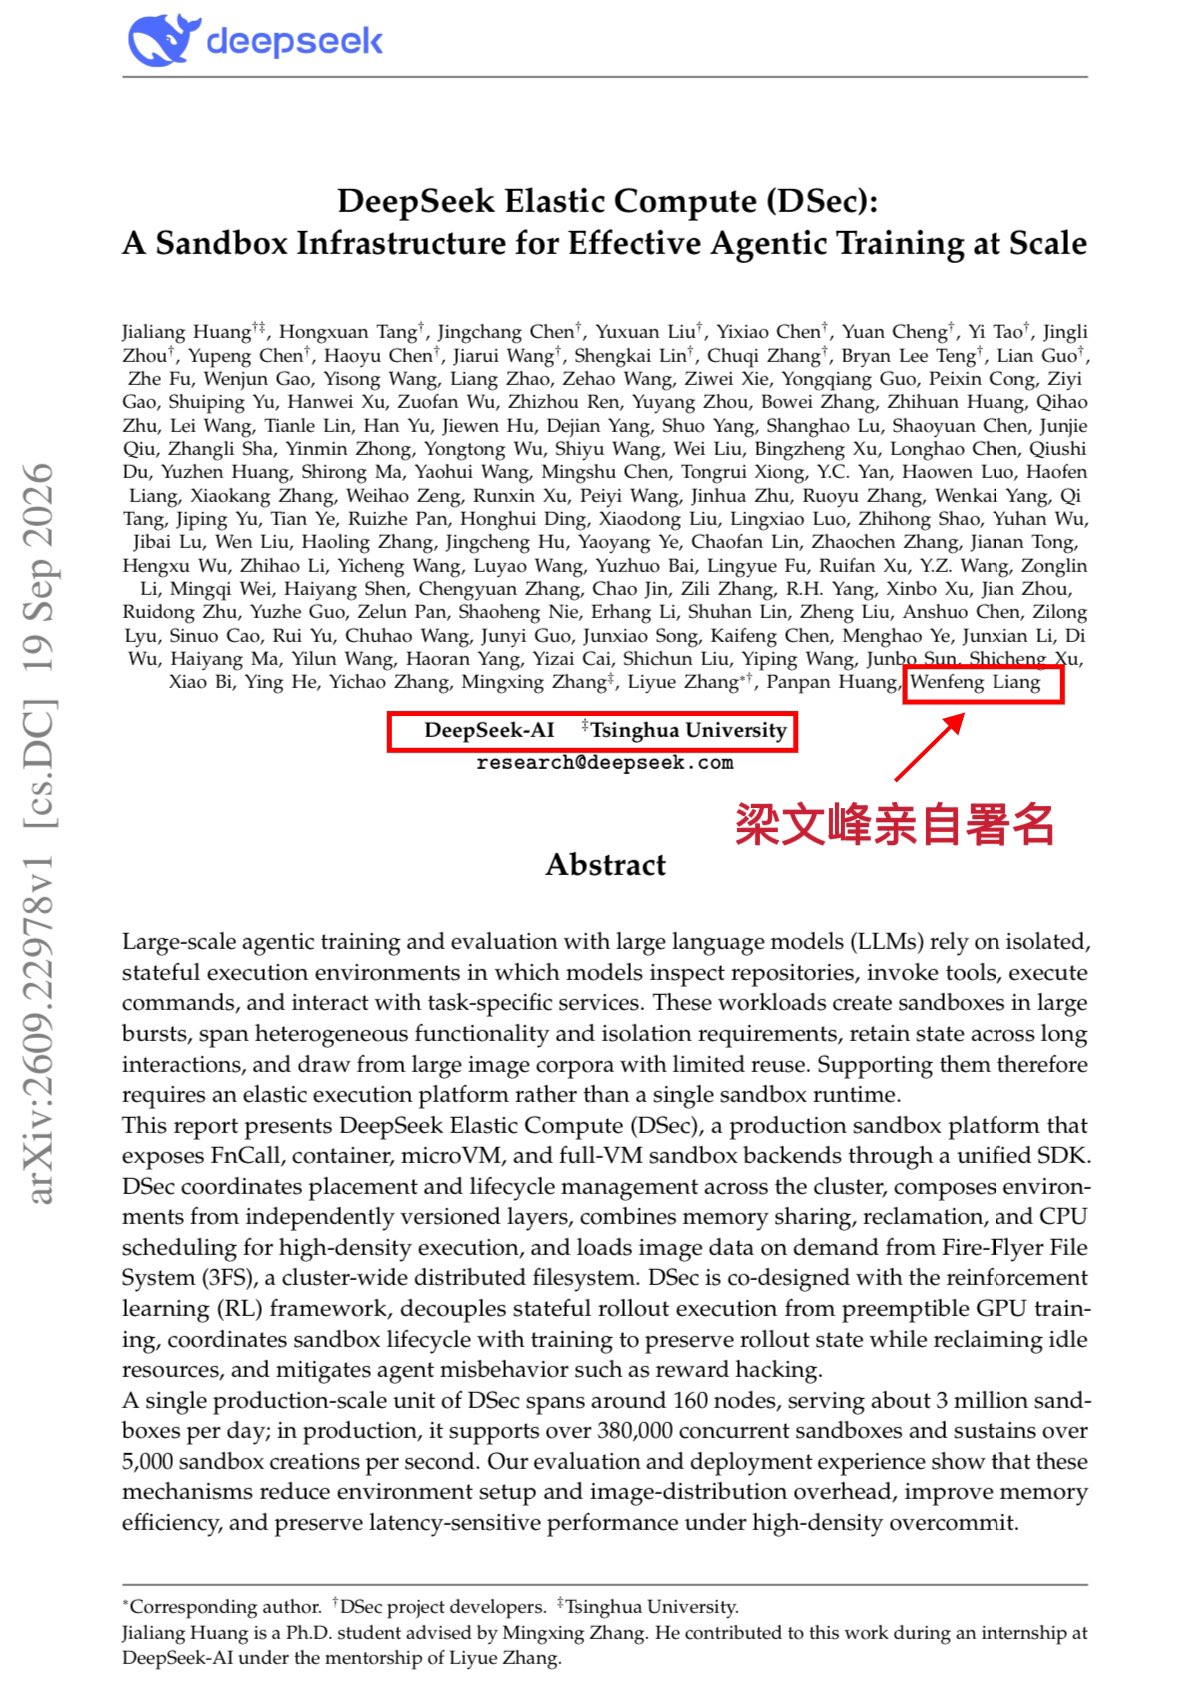
DeepSeek发布DSec沙盒工厂:梁文锋署名论文揭秘Agent训练基础设施

梁文锋亲自署名的新论文公开了DeepSeek的Agent训练沙盒工厂DSec。该系统由约160台机器、3万核CPU、250TB内存组成,一天能造300万个沙盒,同时运行38万个,每秒新建超过5000个。DSec支持从简单函数调用到Docker容器、轻量虚拟机甚至完整Windows/macOS环境,通过镜像三层按需拼装和3FS文件系统按需拉取数据,内存节省三四成,单机最高承载3200个容器。论文还特别阐述了如何防止被训练的Agent作弊——如修改系统文件、绕过权限、扫描端口偷答案等行为。

技术 › Agent SuSu_酥酥 (@NFT_Chen) 2026-09-233.0 KB 67

DeepSeek Harness vs ZCode:Token 消耗能差 10 倍的设计题

本文通过阅读 DeepSeek Harness (DSH) 0.1.7-alpha.1 源码,对比其与 ZCode 执行框架的设计差异。DSH 采用只追加的流水账机制保证可审计性,对缓存前缀极致优化以降低成本,通过三层递进方式管理上下文防止信息丢失,并内置防重复调用守卫、程序化工具调用(PTC)和超时转后台等机制。作者指出这些优势主要体现在长会话、大输出和批量工具调用场景,Token 消耗可差一个数量级;但普通短任务成败仍主要由模型智力决定,两者差距接近于零。

技术 › Harness Engineering 周尔复 2026-09-226.2 KB 7.2K 5 80

DeepSeek,华为,「必须成功」:十六万颗萤火照进荒原

文章讲述了DeepSeek与华为两条看似毫无交集的技术路线如何走向深度结盟的故事。幻方量化创始人梁文锋早在2019年就囤积算力(萤火一号、二号),而华为通过海思备胎计划在实体清单后推出昇腾芯片。在英伟达对华禁售后,DeepSeek以极致工程能力用低配H800训练出V3和R1,震撼硅谷并引发英伟达市值暴跌。2026年,梁文锋押上200亿元,联合华为将下一代旗舰模型迁移到纯国产昇腾底座,并在内蒙古规划16万颗昇腾芯片的超大型数据中心。这是一场被地缘封锁逼出来的、别无选择的技术突围。

技术 › LLM Sleepy [@sleepy0x13] 2026-09-2216.1 KB 20.4K 3 68