分享6个新提示语去掉DeepSeek新模型和codex的AI味
作者分享了6个提示语技巧,用于消除DeepSeek和Codex生成代码动画/UI时的AI味。包括:删除重复无信息的文案、去掉多余的装饰框和阴影、为颜色分配固定用途、统一字号和图标对齐、一屏只讲一件事、优化动效使其服务于叙事和反馈。文中每个技巧都配有具体可用的提示语。作者还预告了正在开发的大剪辑Skill,能用DeepSeek剪出十分钟真人口播视频。
作者分享了6个提示语技巧,用于消除DeepSeek和Codex生成代码动画/UI时的AI味。包括:删除重复无信息的文案、去掉多余的装饰框和阴影、为颜色分配固定用途、统一字号和图标对齐、一屏只讲一件事、优化动效使其服务于叙事和反馈。文中每个技巧都配有具体可用的提示语。作者还预告了正在开发的大剪辑Skill,能用DeepSeek剪出十分钟真人口播视频。
文章基于 YC Paper Club 播客,剖析 LLM 推理成本真相:按两年模型寿命摊算,推理总算力约为训练的 12 倍。decode 阶段 MFU 仅 5%,瓶颈在显存带宽而非算力。DeepSeek 通过 KV cache 保留 72 小时、radix attention、零开销调度等手段将缓存命中率做到 96%,实现 38 美元一卡时、80% 毛利。文章还讨论了 SSM 等被低估的模型结构、服务商质量参差(同一模型不同服务商差距超开源闭源差距)以及开源推理生态的规模,指出推理成本优化才是 LLM 竞争的胜负手。
文章对比了社区开源的 DS Bot(DeepSeek-Bot)与 Grok Bot 两款多角色 AI 助手。核心差异在于'动手能力':Grok Bot 提供托管云电脑,可操作浏览器、跨网站执行任务且合盖继续运行;DS Bot 内置浏览器仅能读网页,但支持自选模型、MCP/Skills 扩展和可检查的 Markdown 记忆。文章从网页操作、模型控制权、数据与权限、成本等维度给出选购建议:不想维护、需要网页自动化选 Grok Bot;已有 API、重视控制权选 DS Bot。作者建议先用一个每周固定任务实测,再决定是否扩展。
作者leonliuzx回顾了自己与开源和开发者关系(DevRel)结缘的历程:初中开始在GitHub上折腾代码,2023年通过AGI Playground参与无障碍AI项目'声桥AI语训',之后深入书生浦语、飞桨等社区做助教、写教程、贡献文档。2024年底加入百度从事社区运营实习并转正,组织Hackathon活动、培养贡献者,甚至与李彦宏共进晚餐。工作之余还发起了OMDSH和OpenAIGames等独立社区。作者将开源社区比作同好群,认为因纯粹热爱而聚集的感觉非常棒,并庆幸自己在这个年纪找到了愿意长期投入的热爱。
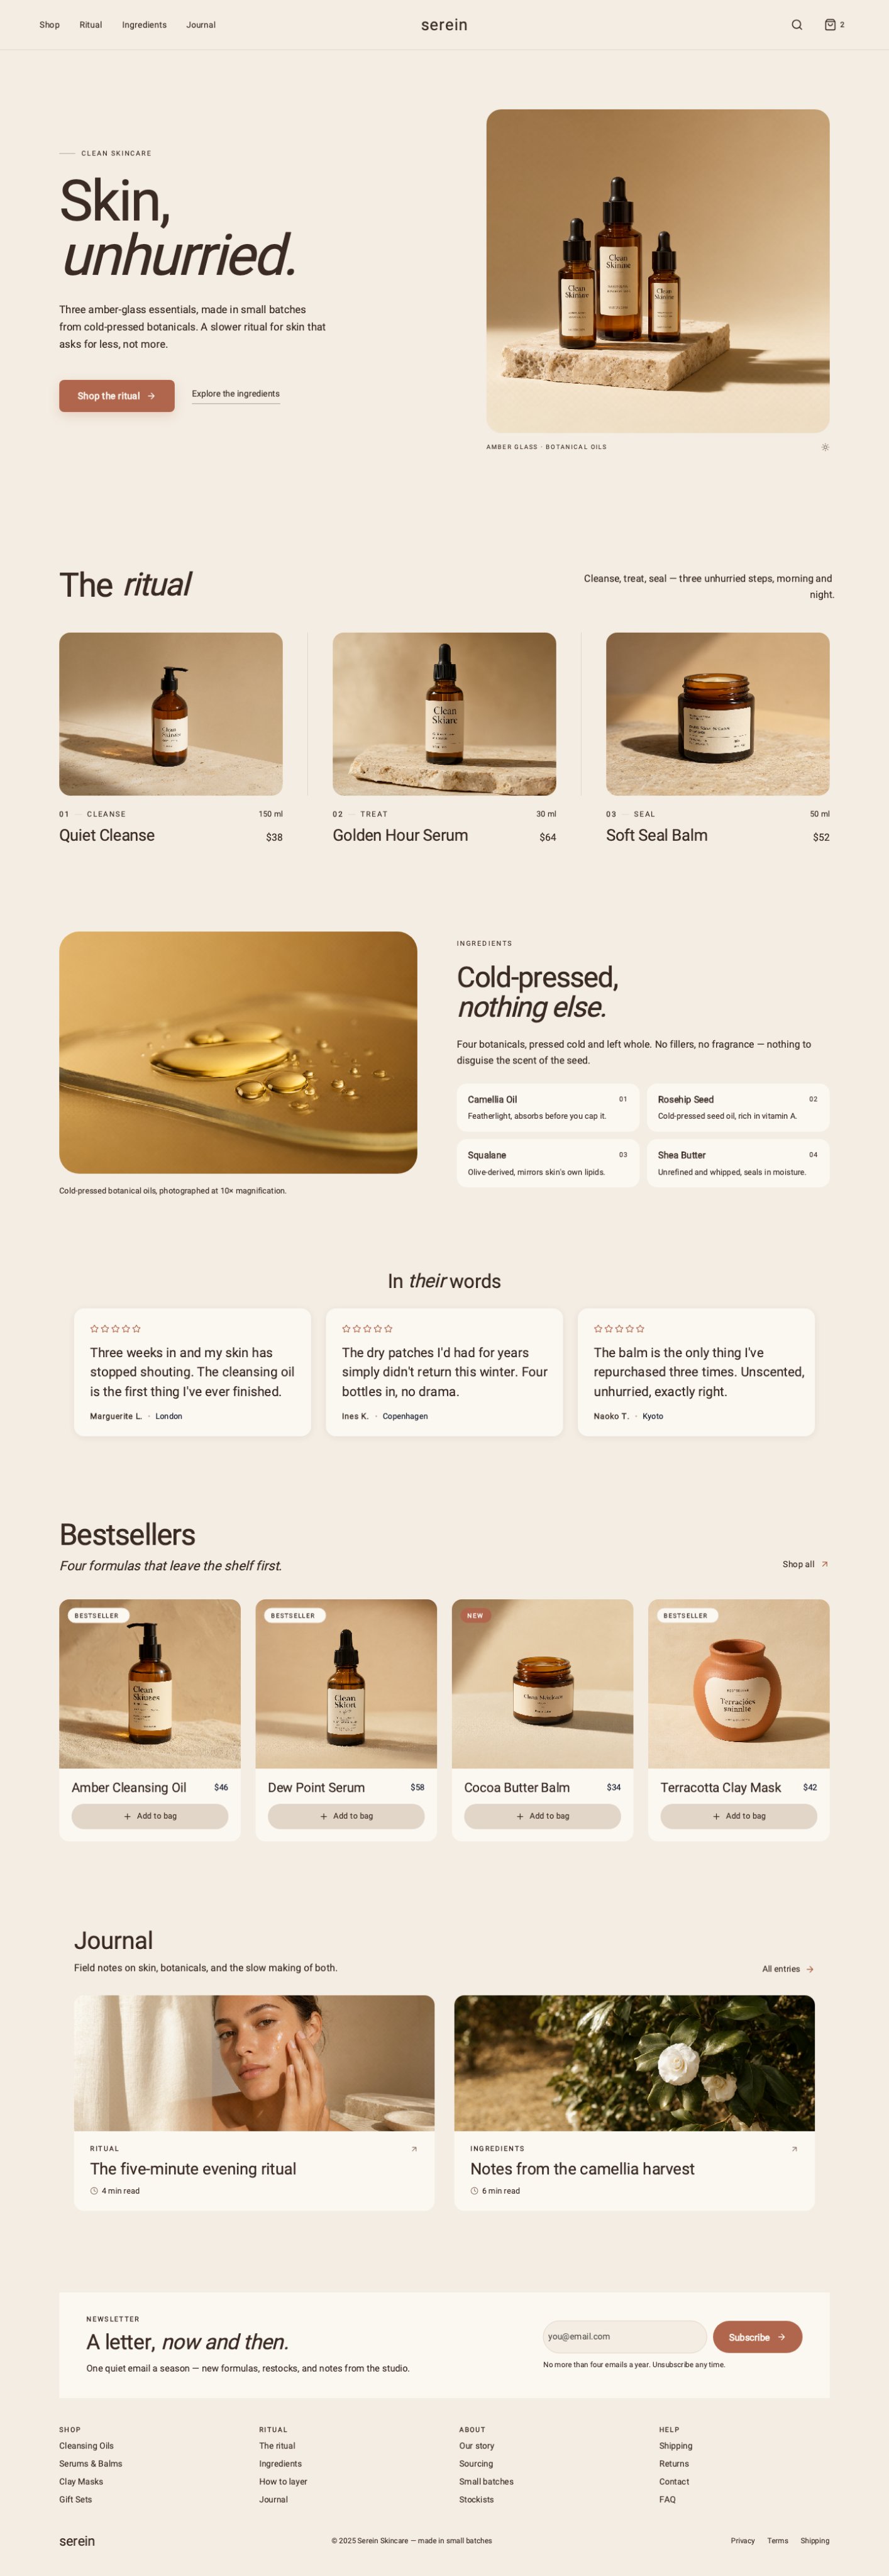
作者分享使用 DeepSeek-V4.1-Flash 1017 模型配合开源 AI 原生设计工具 OpenPencil 和生图模型 Qwen-Image-2.1 Turbo 制作电商落地页与模特图的实战体验。文章包含完整的落地页设计提示词和模特生成提示词,展示了生成结果的高审美水准,并提到 OpenPencil 是一款开源免费的 AI Native 设计工具,核心能力是通过 Agent 输出高质量 UI 设计稿、卡片、轮播图、PPT 等,适用于电商页面和海报制作,评论区多人交作业复刻效果。
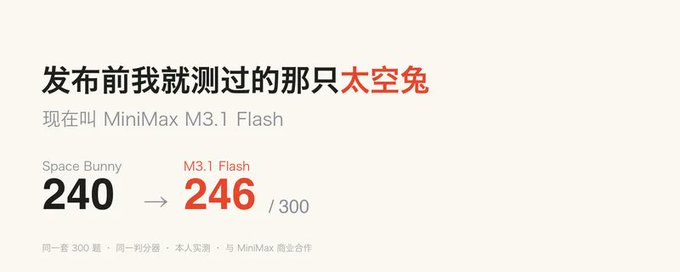
作者在 MiniMax M3.1 Flash 还以匿名模型 Space Bunny 身份活跃时,用自己维护的 300 题封闭测试集(HumanEval+/MBPP+ 代码题与 MMLU-Pro 推理题)进行了评测,匿名期得 240 分。正式版发布后用同一套题复测得 246 分,两版表现几乎一致,主要提升在代码题。代码能力与 DeepSeek V4.1 Flash-1017 基本打平;官方数据显示其在企业流程自动化和操作电脑两项为国产第一,且成本显著低于 Claude Opus 5。短板是困难推理。整套 300 题成本仅一元出头,性价比突出。
作者实测了国内首个原生Personal Agent产品Today,该产品获得腾讯和蚂蚁集团投资的2亿美元融资,新用户注册可获3亿token和3个月Pro会员。文章详细介绍了Today的下载安装、设置页面的模型(内置DeepSeek V4.1 Flash和GLM 5.3)、应用连接、设备连接、Skill技能等功能,并演示了改名、任务创建、记忆构建、做梦写日记与灵感等特色功能。作者强调Personal Agent的好用性在于给足上下文,让AI主动理解用户、安排任务,是AI从被动执行走向主动服务的关键。
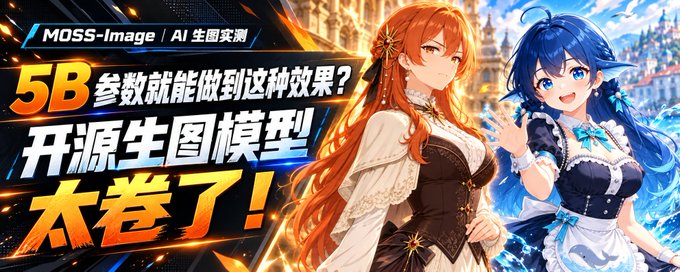
作者使用模思智能开源的 5B 参数图像生成模型 MOSS-Image,为 Claude 和 DeepSeek 设计拟人化角色形象。文章分享了角色设计思路:Claude 采用橙棕奶油配色体现温暖复古气质,DeepSeek 延伸蓝色海洋主题。作者重点介绍了 MOSS-Image 的优势:生成速度快于 Stable Diffusion 和 ComfyUI,支持准确的中英文文字渲染、JSON Layout 布局控制、最长 4K tokens 提示词,并提供 Prompt Enhance 提示词增强功能。模型基于国产 PPU 算力平台训练,已开放 Base 和 SFT 版本权重,支持动漫、写实等多种风格,目前可免费体验。
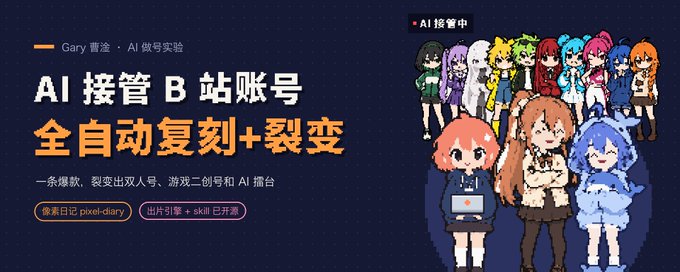
作者拆解了 B 站爆款账号「Claude大小姐在运营」(三天破百万播放)的成功要素:AI 为主角的好奇心选题、B 站现成梗文化、评论区驱动下一期内容、公开账本养成感与信息差。作者用 Claude Code 花一小时、成本两元复刻出像素风视频,并将整套方法(skill 加出片引擎)按 MIT 协议开源。随后他连开三个细分内容号:Claude 与 DeepSeek 双人营业号(中英双语)、鸣潮二创日记号、AI 像素擂台(10 个模型同场比赛),并分享了选题调研方法论:追踪同类爆款数据、判断赛道拥挤程度、寻找未被挤满但持续出爆款的内容形式。
本文是一篇面向小白的 DeepSeek Harness(DSH)完整上手教程。作者介绍了 DSH 的核心特点:门槛低(DeepSeek 账号登录即用)、一切皆插件(连 Agent 循环都可替换,社区插件超 6000 个)、过程可回放(轨迹功能)。文章详细讲解了下载安装、登录方式(账号与 API Key 两种)、界面各功能入口(模式、权限、模型、推理强度等)的含义,并分析了计费方式与省钱技巧,同时提醒它仍是预览版,未经过安全审计,需注意数据安全。后续还将涵盖插件市场、原理拆解、实战练习及与 Pi、Claude Code、Codex 的对比。
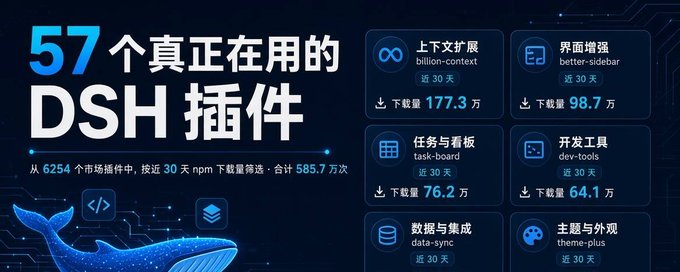
作者从插件市场6254个插件中筛选整理出50+实用插件,覆盖DeepSeek Harness(DSH)生态。文章按功能分为三大类:上下文与记忆(如billion-context压缩、hindsight长期记忆)、界面与主题(Codex风格UI、桌宠、皮肤主题)、任务与开发(子代理、任务看板、Git图、代码审查、多智能体协作等),每个插件附下载量、一句话简介和GitHub仓库链接,方便读者按需查找安装。
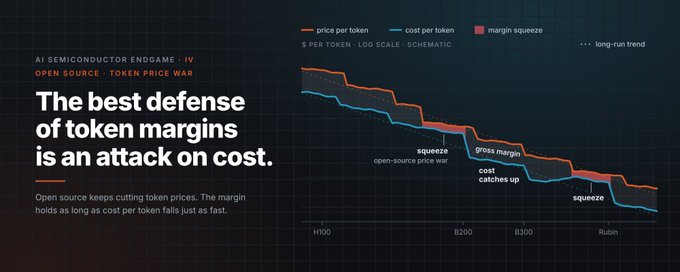
文章探讨开源模型的崛起是否冲击半导体需求这一热门问题。作者指出市场担忧的核心在于开源是否会压低毛利,进而削弱模型公司购买GPU的能力。但通过动态均衡框架分析,token价格下降的同时,硬件与软件的效率提升(每十年各贡献千倍优化)使成本同步快速下降,毛利得以维持。以每GW算力测算,旗舰模型推理毛利率仍达75%-80%以上,开源模型约60%-70%,token收入是硬件摊销成本的十倍。结论是开源不会伤害半导体行业,动态均衡将持续推动AI基础设施扩张。
作者体验了朋友洛小山团队开发的个人 Agent 产品白艾莉(Alice)。该产品以二次元养成游戏的风格呈现,Onboarding 设计如玩游戏般丝滑,有人设、朋友圈、塔罗占卜等细节。产品将多 Agent 设计成自带身份的'朋友',支持创建定制角色,并有广场社区支持二创内容和糖豆消费。同时具备实用功能:可切换 DeepSeek 等模型写代码、连接微信飞书、专属邮箱、定时任务等。作者认为人格化 Agent 满足了用户对'AI 活人感'的关系诉求,有望成为 AI 原生内容社区。
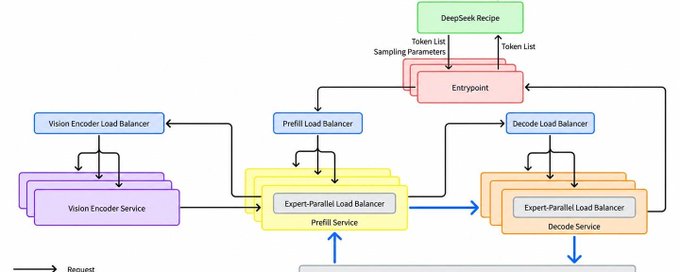
文章介绍 DeepSeek V4.1 Flash 大规模推理系统的部署实践与开源推理框架 DeepInfer。系统设定三大目标:兼容多厂商计算芯片、基于通用硬件组织 Prefill 与 Decode(8 卡机 Prefill、64-128 卡超节点 Decode)、支持 KVCache 保留 72 小时以上以实现上下文复用、减少冗余计算。团队通过在计算、通信、调度与存储上的持续优化,在满足延迟要求下提升有效吞吐。DeepInfer 集成高性能算子与深度优化推理引擎,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出等能力。目前单集群服务吞吐达每天 155 万亿 tokens,整体收入为每卡每小时 38 美元(按低谷价格计)。
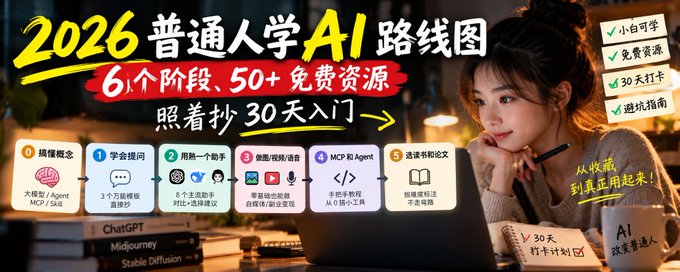
文章针对普通人收藏大量 AI 教程却始终没学会的问题,提出按可上手顺序排列的六阶段学习路线:先搞懂大模型、Agent、MCP、Skill 四个基础概念;再学会高效提问;然后选一个通用 AI 助手用熟;之后分创作者路线(做图、视频、语音)和开发者路线(MCP 与 Agent 开发)深入;最后选读书籍论文进阶。作者强调'卡住你的不是资源不够,而是顺序不对',并附上 30 天打卡表、53 个免费资源和五个避坑建议,倡导边用边学、动手实践。
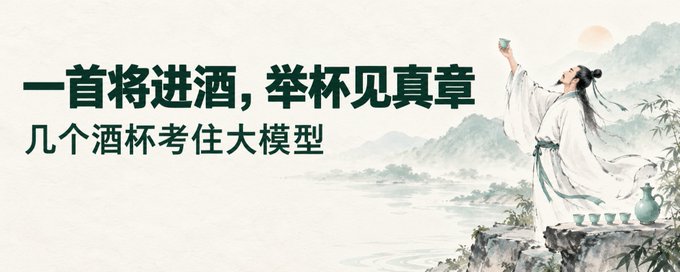
作者用一道难题对比测试开源 5B 图像模型 MOSS-Image 与闭源最强的 GPT Image 2.5:在一张水墨长卷中画出李白临江举杯场景,写出《将进酒》全文12行书法,配标题、作者、朱印和英文,并精确控制酒杯数量。第一轮两者都通过,但第二轮仅改两处细节后,GPT Image 2.5 数错酒杯,MOSS-Image 两轮全部正确。文章分析了小模型在中英文渲染、长提示词理解(支持4K tokens)和风格控制上的优势,并分享了结构化布局、负面约束等复杂提示词技巧,附完整提示词。MOSS-Image 已开源权重和代码,支持 LoRA 微调,ComfyUI 下载量突破70万。
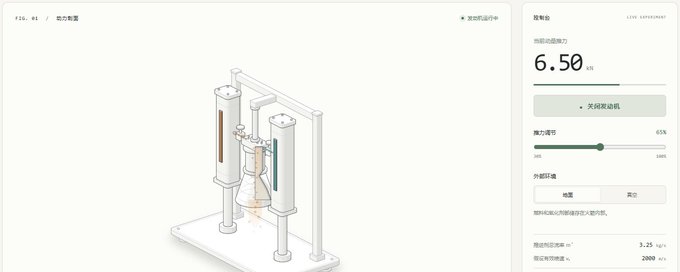
作者基于最新更新的 DeepSeek-V4.1-Flash-1017 模型,搭配 workbuddy 平台和 Anatomy 这个 Skill,用一句话需求分别制作了电动车工作原理和火箭原理两个中文交互式动画实验台,并部署到 Cloudflare。文章详细展示了制作过程:包括能量回收的负号读数、推力计算的模型假设等物理细节,也坦诚记录了脚本变量重复、部件遮挡冲突、满电回收测试失败等问题的排查与修复。作者强调「一句话开工」背后更需要制作、报错、修正和检查,并分享了从具体小需求出发使用 AI 工具的实践经验,主张通过动手交互验证 AI 产出是否可用。
作者实测使用OpenCode搭配DeepSeek V4.1 Flash模型,通过一段完整提示词直接生成了一段22秒的智能手表产品动效视频。提示词详细规定了画面风格(电光蓝配白)、分镜节奏、动效与配乐要求。整个生成过程耗时近5个小时,作者评价效果尚可但生成时间极长,并在回复中表示'OpenCode拉完了',认为其表现不佳。文中还公开了完整的三段式提示词供他人复刻。
作者将 OpenCode Go 和 Command Code GOAT 两个 10 美元/月的套餐接入自己的 Sub2API 网关,基于 64,648 条使用记录和小规模质量测试进行实测对比。两者月额度均为 80 美元,OpenCode 短时额度更大(5 小时 16 美元、周 40 美元),GOAT 为 14/35 美元。在相近规模流式请求中 GOAT 耗时中位数和 P95 更短,400 错误也显著更少。结论:接自己的 Agent 或通用 API 客户端优先 GOAT;用于兼容的 coding agent 且集中跑任务则选 OpenCode Go。文章还讨论了处理费、高峰定价、参数兼容问题和模型是否量化等细节。
本期早报聚焦三条主线:一是 DeepSeek 全面开源内部推理框架 DeepInfer 与生产级 Token 编解码组件 deepseek-recipe,覆盖分布式推理、推测解码、结构化输出等能力,兼容英伟达与昇腾平台;二是 Google 为 vLLM 和 SGLang 推出原生 PyTorch TPU 后端,通过 TorchTPU、分层缓存与 TPU Sync 优化多轮 Agent 场景下的推理性能;三是 Anthropic 团队分享 Claude 如何从问答助手成长为承担团队职责的协作伙伴,涵盖追踪表维护、内部应用开发与会议协调等案例。速览部分还介绍了小红书 ROSS 训练方法、FairStress 公平性评估基准、Dyna Robotics 机器人 Scaling Law 及 SGLang 低延迟模式。
燃气行业财务人员Lucky在卡兹克开源AIHOT当天,借助AI将源码改造成燃气行业资讯站GasHot。零代码基础的他像包工头一样指挥多个AI协作:Claude Code主力开发,Codex负责代码审查和可靠性,DeepSeek做日常资讯AI把关。三周内完成部署、公网上线、接入37个信源、SEO改造和监控机制,并解决了信息准确性、界面简化、数据合规、搜索引擎收录等难题。GasHot提供气价盯盘、业务视角要点、政策倒计时和一页日报,大幅节省了翻找政策资讯的时间。作者证明:懂行业的人,即使不会写代码,也能借助AI亲手造工具。
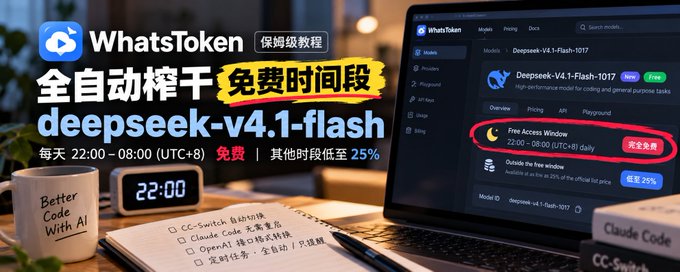
WhatsToken 推出每天 22:00–08:00 的 deepseek-v4.1-flash 免费时段,但手动切换供应商很麻烦,且 Claude Code 启动后改 settings.json 不生效。本文借助 CC-Switch 本地代理解决该问题:让 Claude Code 始终指向本地代理,只在时间窗口边界修改代理路由,无需重启会话即可切换供应商。代理还支持 Anthropic ↔ OpenAI 格式转换,兼容仅有 OpenAI 接口的中转站。文章提供自动切换和仅提醒两种模式,方法适用于任何供应商,并附有可直接交给 Agent 执行的操作手册与常见问题解答。
本文是一篇面向新手的 ESP32 实操教程,作者以立创实战派 ESP32-S3 为例,演示如何借助 Claude Code 等终端 AI 工具,零额外花费把开发板变成桌面 AI 语音助手。内容涵盖:用 Claude Code 识别板子串口、备份原厂固件、下载并烧录开源项目小智固件、手机配网、在 xiaozhi.me 后台绑定设备、通过 GitHub 认证免费解锁 Qwen、DeepSeek 等更优模型、自定义助手名字和性格,以及刷坏后一键恢复出厂的后悔药方法。每步均附提示词、验证标准和常见问题解答,强调先备份、刷不砖,全程可一步步照做。
DeepSeek 于 10 月 17 日发布 V4.1-Flash-1017 版本,AI 编程跑分显著提升,DeepSWE 达 77.0 超越 Claude Opus 5,任务平均费用降至原来的三分之一。作者使用 DeepSeek Harness 实测四个项目:3D 城市生成器对比显示新版的重庆、西安等地标建筑辨识度大幅提升,耗时从 102 分钟降至 61 分钟;许愿式编程能快速产出 3D 地铁跑酷游戏和天坛祈年殿建模;基于新开放的 Search/Fetch 接口开发的 AI 搜索引擎完成度很高。总花费仅 12.81 元,性价比突出,是一次实打实的帕累托改进。
文章总结了一套用于消除AI写作套路的写作Skill规则。作者以V2EX网友讨论和RUC新闻坊实验等为证据,归纳出'不是……而是……'、三段式、对偶、大词、行话、程度词堆叠、科学名词比喻、假精确、编造事实等12条AI写作套路,并为每条制定了明确的删留条件。作者分享了与Claude、ChatGPT等模型多轮协作改稿的4道工序,并指出Claude初稿中4处事实错误说明规则无法替代人工核查。作者认为AI套路源自人类写作被模型放大,保持个性需依靠一手采访、自己的假设、多轮互动以及选用不同模型。
本文是详细的保姆级教程,讲解如何通过本机中转站 Magpie 和 WorkBuddy AI 海外版账号,让 Codex 免费使用 DeepSeek V4.1 Flash 模型。作者介绍了从注册 WorkBuddy AI 账号、安装 Magpie、配置插件、将 Codex 接入 Magpie 的完整流程,并通过路由记录和积分验证免费模型的真实使用。进一步还介绍了路由组功能,实现自动任务分配:复杂任务(架构设计、bug 排查、代码评审)交给 GPT-6 Astra,代码编写等任务交给免费的 DeepSeek。全文在 Mac 环境下实操,包含一个 3D 网页开发的完整实践案例及踩坑经验分享。
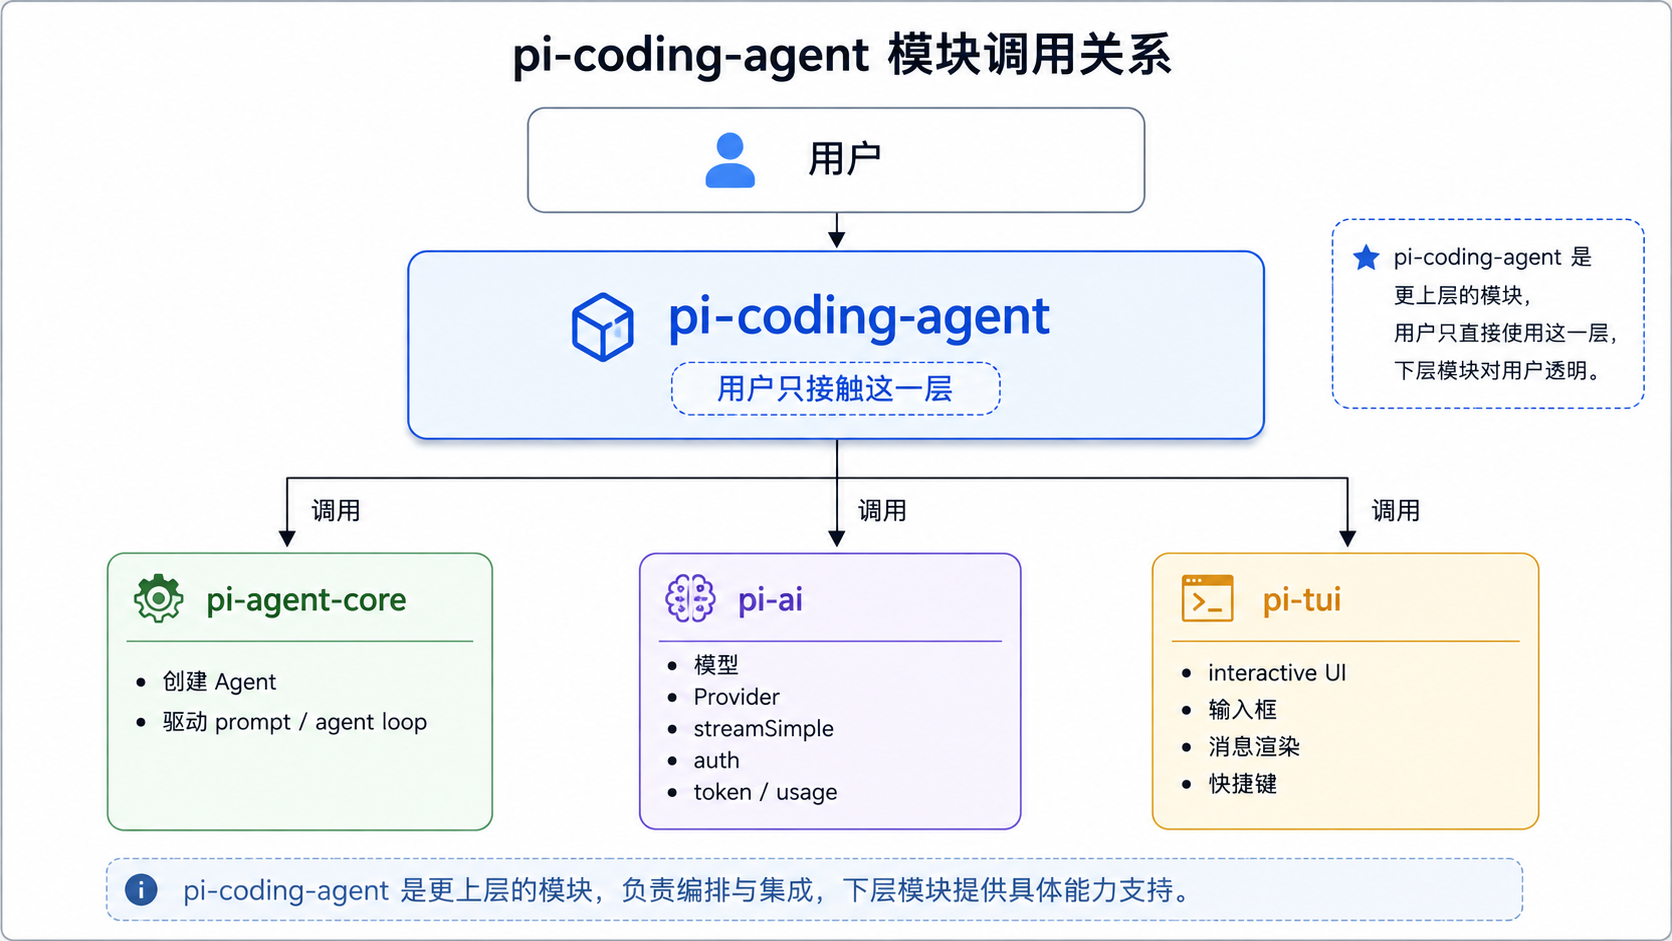
作者基于 DeepSeek Harness 从零搭建一个客服 Agent 的实战教程。文章梳理了客服 Agent 的四大核心能力:快速检索、记忆、人机协同与工具执行;并从交互模式接入、System Prompt 精简、Session 管理与持久化、工具与 Skill 的取舍、安全边界(接口鉴权与 Sandbox 只读)等方面逐步实现。作者强调通过收缩工具数量和精简 System Prompt 降低推理与 Token 开销,用 Skill 约束行为方式、用受控 Tool 约束能力边界,最后分享了利用 DSH 分步完成开发的流程与实用技巧。
花叔开源了Huashu-motion,一个让Claude Code、Codex等coding agent一键生成商业级产品宣传片的skill。项目对标Apple、Google、Anthropic的发布片水准,通过分析21支真实发布片和142支高互动动效片,提炼出导演规则。用户只需一句话,agent就会读产品、出三个设计方向、写节奏单、自动配乐配音效,最后在浏览器编辑器中支持点选修改。作者一天内用它制作了约二十支宣传片,成本极低(约2元/支)。项目已在GitHub开源,附带20种运动语言、10个模板和完整方法文档。
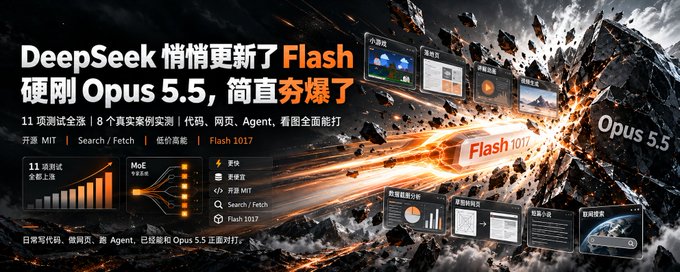
DeepSeek 发布了 DeepSeek-V4.1-Flash-1017 小版本更新,作者在推理、代码、Agent、图像理解等 8 个实际场景中与 Opus 5.5 进行同题对比测试。测试包括网页小游戏开发、落地页设计、讲解动画、视频渲染、数据分析、草图转网页和小说写作。结果显示该 Flash 版本在功能完整度、数据分析、交互还原等方面表现出色,多项能力已接近 Opus 5.5。新版本采用 552B 参数 MoE 架构,MIT 协议开源,同时开放了 Search 和 Fetch 搜索接口。
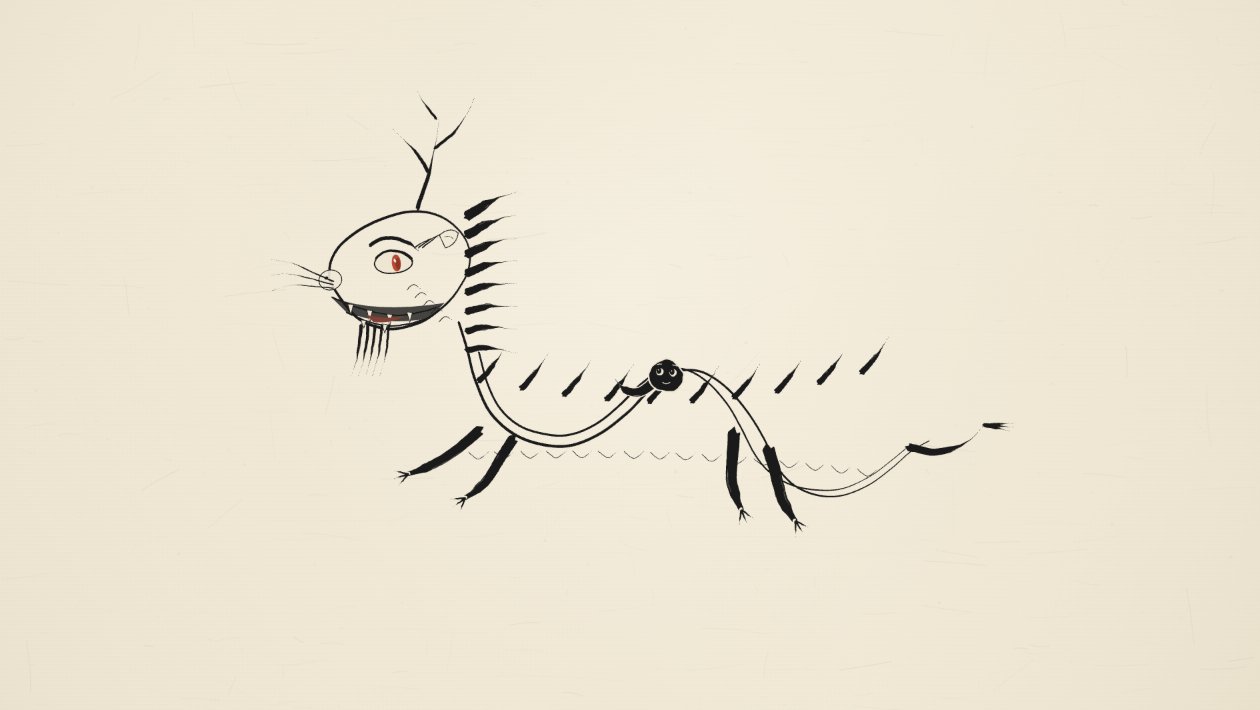
作者使用 DeepSeek-V4.1-Flash-1017 模型,仅用 37 分钟生成了一段 10 秒的 MG 逐帧手绘风格短片《墨戏》,效果接近 Opus 5.5 水准,并盛赞 DeepSeek 是国产大模型的未来。文章完整分享了视频生成的提示词工程方案:以 HTML Canvas2D 实现可变宽度笔刷渲染器,通过每 2 帧循环 3-4 个微差线稿变体伪造 line boil 效果,采用 24fps 一拍二节奏、smear 拖影帧、cel FX 点缀等手绘动画关键技法,配合水墨配色(墨黑、朱砂红、藤黄、宣纸米色)与帧同步音效,最终输出符合专业规格的 H.264 视频文件。