构建永不遗忘的智能体:从基础到向量与图谱混合记忆方案
文章深入探讨了LLM智能体的“记忆”难题,指出单纯增加上下文窗口无法解决“迷失在中间”效应及会话遗忘问题。作者基于认知科学框架,分析了从Python列表、Markdown文件到向量检索各阶段的局限性,强调构建兼具持久化、语义理解和关系推理能力的记忆层至关重要,最终引入了一个能够整合向量、图谱和关系存储的开源解决方案。
文章深入探讨了LLM智能体的“记忆”难题,指出单纯增加上下文窗口无法解决“迷失在中间”效应及会话遗忘问题。作者基于认知科学框架,分析了从Python列表、Markdown文件到向量检索各阶段的局限性,强调构建兼具持久化、语义理解和关系推理能力的记忆层至关重要,最终引入了一个能够整合向量、图谱和关系存储的开源解决方案。
本文是一份详尽的 Hermes Agent 使用避坑指南,旨在帮助新手和资深开发者解决在安装、配置、模型接入及多 Agent 协作中遇到的常见问题。文章总结了 25 个典型的“致命坑”,涵盖 Windows 环境兼容性、WSL 配置、API 接入报错、模型行为控制、记忆管理以及权限安全等核心领域,提供了具体的排查步骤与解决方案,能有效减少用户在调试和部署上浪费的时间。
本文是一份详尽的 Hermes Agent 上手指南,作者通过源码 review 和实验验证,总结出安装后应尝试的十项关键功能。内容涵盖从基础安装、灵魂定义(SOUL.md)、副驾模型(Auxiliary)配置,到记忆系统、搜索能力、自动化审计(Hooks)、沙箱环境、多 Agent 协作、备份策略及技能自动化等进阶设置。文中还总结了 Hermes 的八大亮点,包括合理的主副模型分离机制、交互式配置体验及独特的技能固化能力。
文章基于 Harness Engineering 三大支柱(评估闭环、架构约束、记忆治理),深度对比了 Nous Research 的 Hermes-Agent 与作者基于 OpenClaw 自建的 MemOS 系统。Hermes 主打“有界热记忆 + CLI 优先”,适合个人快速启动;自建方案则采用“无界记忆 + Hook 机制强制捕获”,实现多 Agent 协作与权限隔离,适合团队长期积累。
针对 LLM 无状态导致的“失忆”痛点,文章深入探讨了当前 Agent 记忆系统的四条主流技术路线:纯文件存储、向量数据库+RAG、知识图谱及混合检索。文章梳理了从轻量级 hooks 集成到企业级独立平台的 12 个开源项目,涵盖 claude-memory-compiler、agentmemory、Hermes Agent 等代表性工具,并提供了针对不同用户阶段(新手、个人开发者、团队、企业)的选型建议。作者指出,未来的核心竞争将集中在“如何遗忘”、“保证正确性”和“控制成本”三个维度。
文章提出了“上下文工程”的概念,认为它比单纯的提示词工程更能决定 AI 的输出质量。作者将 LLM 比作 CPU,将上下文窗口比作 RAM,而用户则是操作系统。文章提供了 15 个可直接复制粘贴的实用模板,分为身份设定、任务指令和上下文控制三个部分,旨在帮助用户通过预设背景、品牌语调和工作规则,无需代码即可显著提升 ChatGPT、Claude 等模型的输出质量。
文章提出构建智能体软件应采用系统工程思维,而非仅优化局部组件。作者提出了软件工程的五个关键层面:代理工程、数据工程、安全工程、接口工程和基础设施工程。文章通过开源项目 Dash 演示了如何将 RBAC、数据隔离和多接口集成等原则应用于实际开发中,强调智能体本质仍是软件,需遵循经典的系统设计原则。
文章介绍了如何简单快速地在本地运行 Gemma 4 模型。主要步骤包括安装 Ollama、下载 Gemma 4 26B A4B 模型,以及通过 Ollama 启动 OpenClaw 并使用 Gemma 4 作为后端。该过程被描述为简单快捷,适合在几分钟内完成本地代理的部署。
本文对比分析了近期热门的 Hermes Agent 与 Claude Code、OpenClaw 的区别。Hermes Agent 是一个轻量级、可自我学习的通用 Agent,定位介于三者之间。与 Claude Code 相比,它不绑定 IDE,支持多平台和 18+ 模型;与 OpenClaw 相比,它采用独特的“有限记忆”哲学和自学习循环机制,能自动沉淀个人技能笔记,更适合个人开发者私有化部署。
文章详细介绍了 Terraform 之父 Mitchell Hashimoto 的 AI 工程实践六个阶段,从早期的聊天窗口尝试,到最终实现后台常驻 Agent 的愿景。核心亮点在于第五阶段提出的“Harness Engineering”(工程约束),即通过系统性设计(如 AGENTS.md 和验证工具)来防止 Agent 重复犯错。文章结合 Anthropic 和 OpenAI 的行业案例,指出工程师的核心技能正从手写代码转向设计 Agent 的运行约束环境。
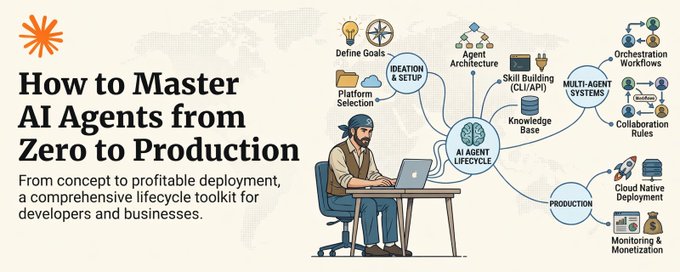
这是一份关于构建生产级 AI 智能体的完整指南。文章详细阐述了智能体与聊天机器人的本质区别,涵盖了从工具设计、系统提示词、多智能体编排到生产环境部署、测试评估的全流程。重点介绍了如何利用 API 构建可靠的智能体循环,并指出了初学者常犯的错误及生产环境下的监控与成本控制策略。
本文针对 Andrej Karpathy 提出的 LLM Wiki 方案,结合作者自身的 Obsidian + OpenClaw + Claude Code 实践经验进行了优化。作者提出了从三层架构升级为五层架构(增加行动层与产出层),并强调人工确认机制,避免 AI 自动分类的偏差。文章详细介绍了入库、查询和健康检查的具体流程,分享了构建个人知识库的原则,旨在实现知识积累与内容产出的高效闭环。
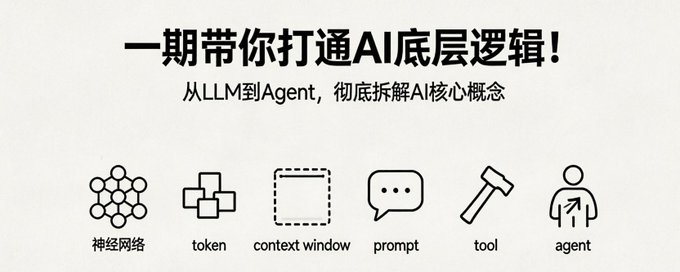
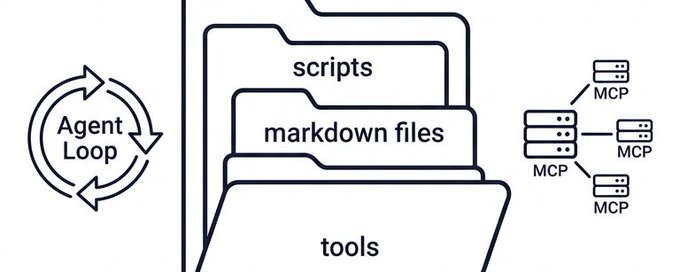
本文是一篇基于工程视角的AI技术硬核解析,旨在厘清从LLM大模型到Agent智能体的核心概念体系。文章深入浅出地拆解了LLM的文字接龙本质、Tokenizer的翻译机制、上下文窗口的容量限制,以及Prompt工程、MCP工具协议和Agent技能的运作原理,帮助读者建立完整的底层技术认知。
文章介绍了 Karpathy 提出的 LLM Wiki 方法,旨在解决传统 RAG 检索缺乏知识沉淀的问题。作者详细演示了如何在 Obsidian 中落地该方案,包括使用插件采集素材、配置图片本地化、利用图谱视图发现盲区、结合 Dataview 生成报表、使用 Marp 制作幻灯片,以及通过 Git 进行版本管理。核心思想是让 AI 承担繁琐的整理与维护工作,人类专注于思考与决策,从而构建持久增殖的个人知识库。
本文介绍了 Andrej Karpathy 提出的“LLM Wiki”个人知识库模式,即利用 AI 将原始资料编译成持久化的 Wiki,解决了传统 RAG 方案无法保留上下文和维护关联的痛点。作者详细解析了 Karpathy 的“Raw/Wiki/Schema”三层架构,并演示了如何利用开源桌面 AI Agent 工具 nexu 落地该模式,实现在微信随手入库、多模型切换及与 Obsidian 的协同工作,从而构建一个由 AI 维护的个人第二大脑。
针对 Agent 长程任务中常见的跳步、幻觉和状态丢失问题,作者开发了 skill-refiner 工具。该工具基于 FSM(有限状态机)设计,通过三原语约束执行流程。此外,它还提供了通过强模型改写提示词以降低弱模型运行成本的策略。
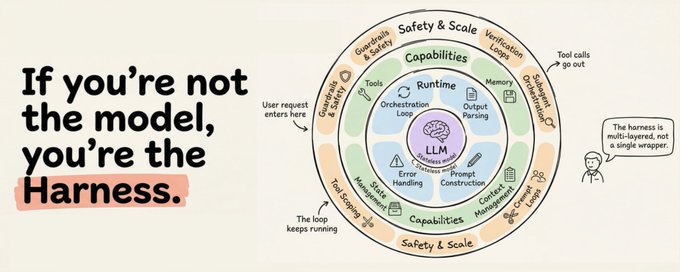
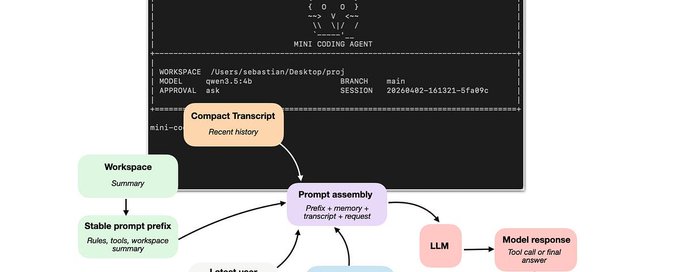
本文探讨了编程智能体(Coding Agent)及其运行框架的设计,重点介绍了模型、推理与智能体的区别,并详细拆解了六大核心组件:实时代码仓库上下文、提示词缓存复用、工具调用与安全验证、上下文压缩机制等。文章指出,优秀的 Harness 框架能将基础模型的潜力最大化,是编程智能体体验的决定性因素。
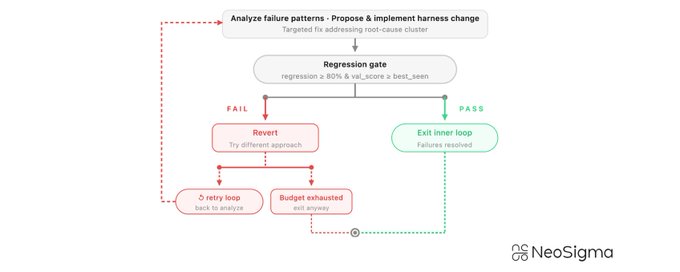
NeoSigma 开源了‘Auto-harness’系统,这是一个自改进循环框架,能将代理失败转化为评估结果并自动修复。实验显示,该系统使 Tau3 基准任务得分提升了 40%。文章探讨了故障聚类、回归门控和子代理管理等关键技术,标志着工程重心从编写代码转向构建能够自我维持和改进的系统。
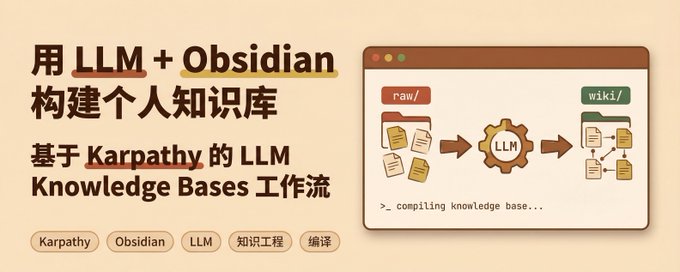
本文介绍了基于 Andrej Karpathy 的理念,利用 LLM 和 Obsidian 构建个人知识库的方法。作者将笔记管理类比为软件开发,提出“原始资料”经 LLM “编译”为结构化知识的概念。文章详细阐述了三层目录结构(摄入、编译、输出)、利用 Claude Code 实现增量摘要与索引、定期进行知识库“健康检查”以及不盲目追求 RAG 的实践建议,旨在解决笔记堆积与腐烂的问题。
本文深入探讨了大模型训练的全链路流程,指出2026年模型效果的差距主要源于后训练阶段。文章从预训练底座、数据配方、系统架构约束、后训练(SFT/RLHF/DPO)以及 Eval/Reward 机制五个维度,解析了如何通过工程化手段提升模型实际落地效果,并引用了 DeepSeek、Llama 等实例。
Anthropic 内部分享指出,与其为每个场景构建新 Agent,不如给通用 Agent 配置“Skills”。Skills 是打包程序化知识的文件夹,通过渐进式加载解决上下文窗口问题。文章介绍了 Skills 与 MCP 的互补关系,及其在金融、科研等领域的生态发展,类比将其比作“应用层”,强调通过知识积累让模型不断进化。
本文总结了21条提升生成式引擎优化(GEO)效果的写作原则,旨在帮助内容创作者提高被AI搜索引用的效率。文章从四个维度展开:内容增强(通过增加数据密度、权威引用和独特词汇建立信源信任度)、结构工程(采用倒金字塔、键值对和表格化适配AI阅读习惯)、语义逻辑(使用显性连接词和客观语调诱导AI推理),以及对抗防御(战略性实体布局和优化查询匹配)。核心观点是将文章构建为高密度、可验证的结构化事实库,而非单纯追求优美文笔。
本文介绍了开源库 AutoAgent,这是一个能够自主优化任何领域代理的框架。通过引入“元代理”概念,AutoAgent 可以自动调整任务代理的提示、工具和编排逻辑,从而在 SpreadsheetBench 和 TerminalBench 测试中取得卓越成绩。文章探讨了“模型同理心”的重要性,并详细阐述了该框架如何通过拆分元任务与任务、利用推理轨迹以及避免过拟合来实现性能的持续提升。
文章介绍了开源客户端 nexu(开源龙虾)作为全球首批接入字节跳动 Seedance 2.0 模型的工具,允许用户通过微信、飞书等聊天软件直接生成高质量 AI 视频。用户无需代码即可快速生成 2K 电影画质视频,文章提供了详细的安装配置教程及免费额度的领取方式,并展示了 nexu 作为全能 Agent 的其他强大功能。
文章指出AI输出质量差往往源于提示词编写不当,并总结了三大常见误区:信息缺失、格式空白和贪心过多。作者通过实战案例对比,详细讲解了如何通过明确角色、补充背景、量化目标、限制格式和反向约束来优化提示词,从而实现从“废话连篇”到“精准输出”的跨越,大幅提升使用效率。
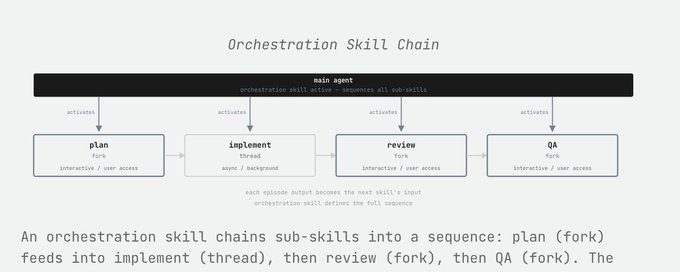
本文探讨了智能体系统中技能实现的局限性,指出技能不应是静态提示,而应是动态的情境行为。作者介绍了在 Slate 系统中通过引入“线程”和“分叉”机制,实现了上下文隔离的自动化技能调用,并提出了“编排技能”的概念,即通过组合其他技能来完成复杂任务链。
文章介绍了如何利用 OpenClaw 搭建一套多 Agent 协同工作流。通过设置“小龙虾”、“码力”、“笔锋”和“谋士”四个专精 Agent,并配合 MemOS 共享记忆系统,实现了各司其职、成本优化与质量提升的平衡。作者分享了架构设计、搭建过程、实战数据及踩坑经验,展示了多 Agent 协作在实际任务流转中的高效价值。
文章分析了 Anthropic 的 Agent Harness 架构,并介绍了 Jason Zuo 如何使用 gstack 和 Compound Engineering (CE) 构建了一套完整的工程工作流。CE 替代了 Superpowers,提供了更深入的规划和审查机制。最关键的差异在于 CE 的 /ce:compound 功能,它通过独立 Agent 将每次开发的经验转化为结构化的项目记忆,实现了 Agent 的自我优化与积累,形成了从规划、执行、审查到记忆的完整闭环。
文章深度解析了 Claude Code 的源码架构,指出大多数用户仅将其作为简单的对话工具,忽略了其作为 Agent 编排平台的强大功能。核心发现包括:CLAUDE.md 的每轮重载机制、Subagents 并行化共享 Prompt Cache 的低成本特性、基于配置的权限系统、5 种上下文压缩策略、25+ 生命周期 Hook 系统以及可恢复的 Session 机制。