用好 Obsidian Skill,让你的 WorkBuddy 对知识库的理解提升 80%
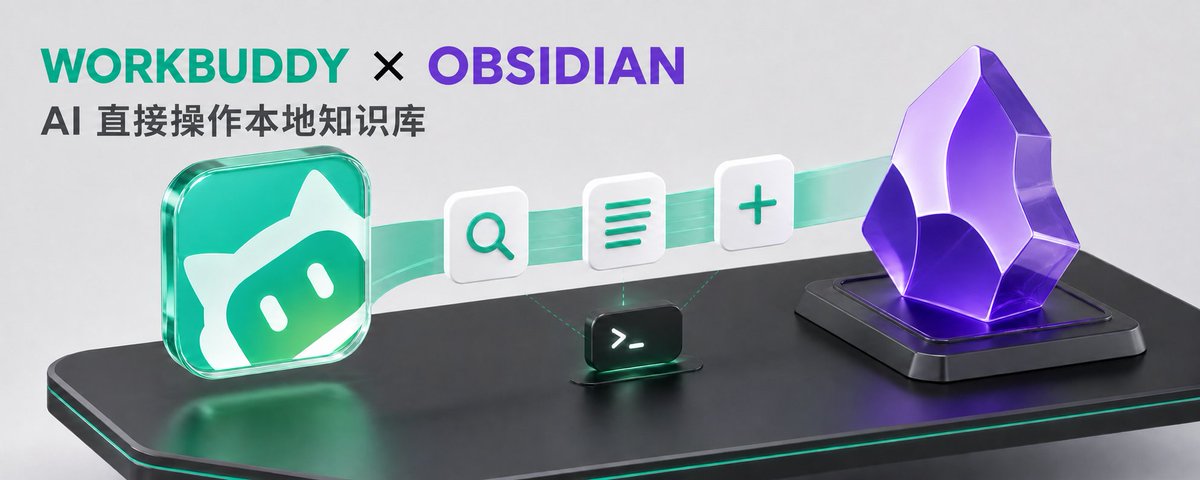
文章介绍了如何在 WorkBuddy 中安装 Obsidian skill,通过自动识别本地知识库、补充 CLI 能力及验证读写操作,实现对 Obsidian 知识库的高效管理。相比直接操作本地文件,使用 skill 能更好地理解双链结构和知识库逻辑。
文章介绍了如何在 WorkBuddy 中安装 Obsidian skill,通过自动识别本地知识库、补充 CLI 能力及验证读写操作,实现对 Obsidian 知识库的高效管理。相比直接操作本地文件,使用 skill 能更好地理解双链结构和知识库逻辑。
文章介绍了利用AI构建和扩展单人企业的完整蓝图。通过使用AI员工(如Viktor)在内容、项目、拓展、财务和广告五个领域实现自动化,只需保留决策环节。文章探讨了两种构建方式:快速路径和自定义构建,强调业务知识库和操作规则的重要性。
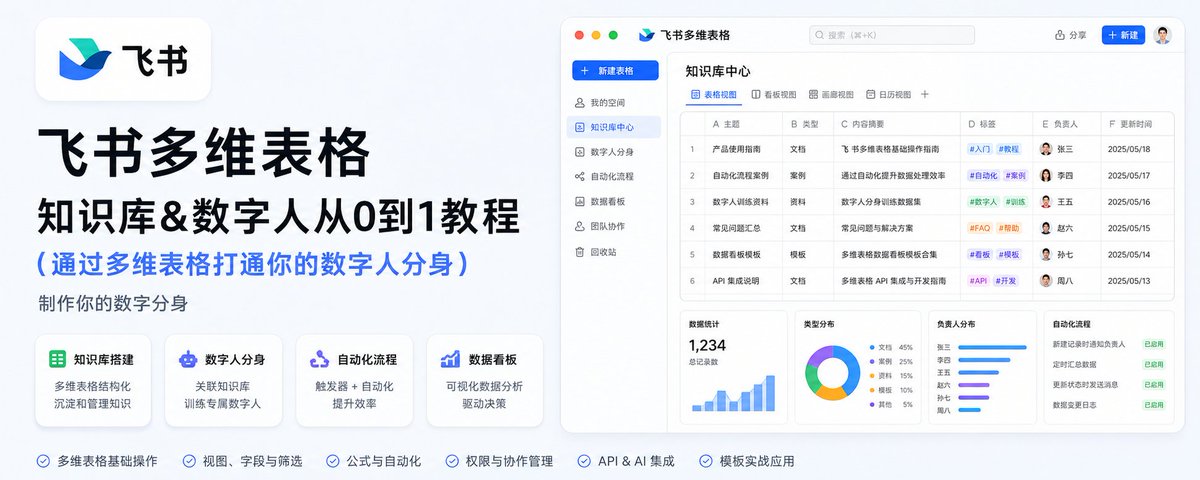
文章介绍了如何利用飞书多维表格结合 AI 技术打造知识库“数字分身”。通过三级进化:将知识结构化存库、利用 AI 字段自动化处理知识、接入飞书机器人实现对话交互,解决专业知识沉淀与复用难题,提升业务效率。
文章介绍了如何利用 Hermes Agent 构建一个集中的个人知识库,解决 AI 使用中上下文分散的问题。通过四个提示词,作者展示了如何建立结构化存储、自动更新归档技能、基于证据的检索机制以及大脑倾倒处理流程,从而让 Agent 全面了解用户并大幅提升生活质量。
文章指出企业 RAG 不仅仅是上传 PDF 回答问题,更需关注文档版本、权限、来源追溯及停用管理。作者通过模拟企业真实文档环境,构建了包含版本控制和过滤机制的评测体系,强调了可靠检索与诚实无答案的重要性,并分享了针对小规模知识库的技术选型经验。
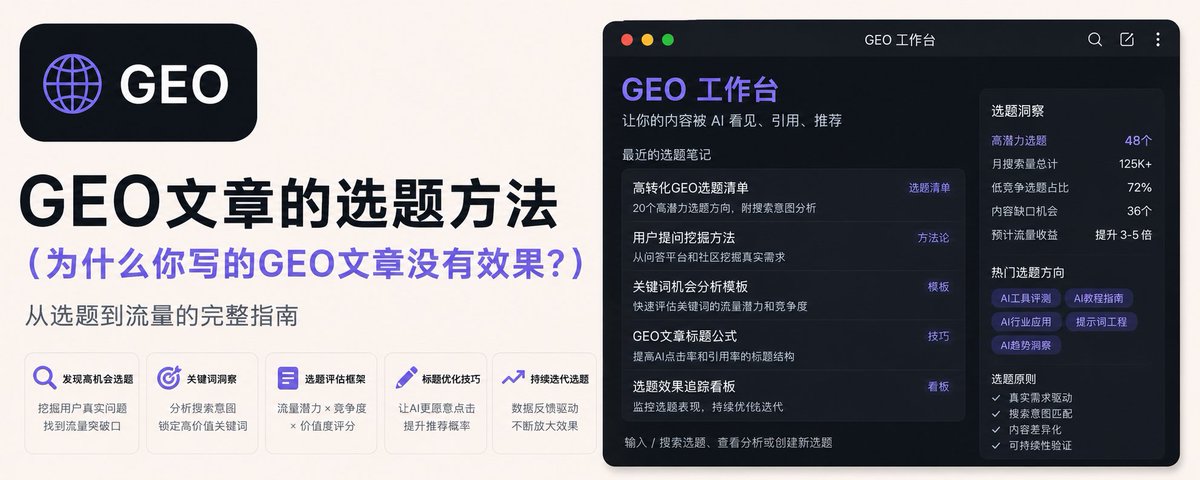
本文探讨了GEO(生成式引擎优化)的选题策略,强调内容创作应从用户的真实问题出发,而非仅仅追逐热点。文章通过离婚律师的案例对比,分析了用户提问背后的意图差异,并介绍了如何按决策进程对问题进行分类和优先级排序。此外,作者还提供了挖掘问题的五个具体渠道,以及建立滚动更新问题库的方法,帮助从业者通过精准的问题分析提升内容效果和品牌可见度。
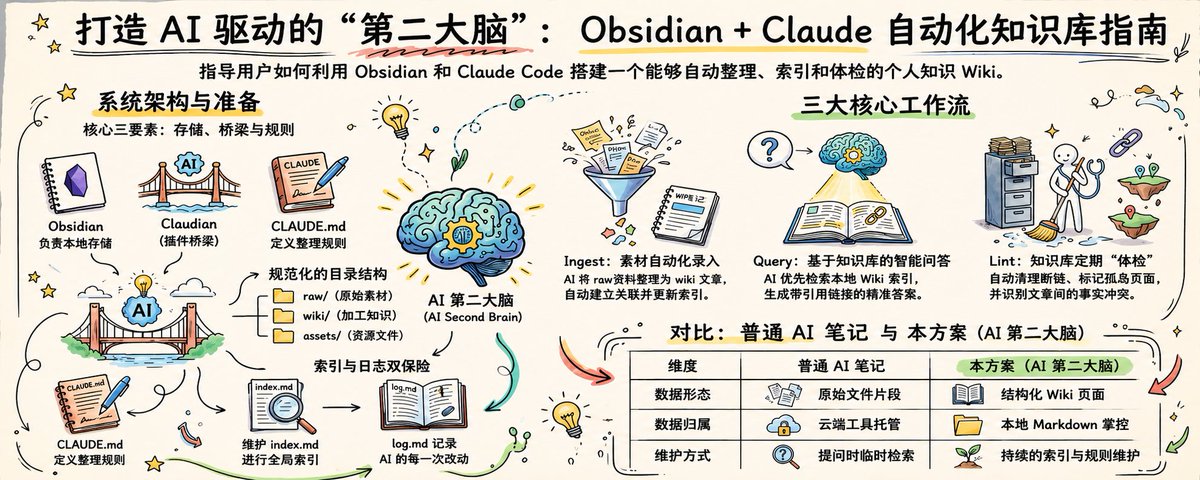
本文介绍了如何利用 Obsidian、Claude Code 和 Claudian 插件,无需编程即可搭建一套可持续维护的个人知识库。文章详细讲解了环境配置、目录结构设计(raw/wiki/assets)、以及通过 CLAUDE.md 定义规则,实现 AI 自动整理素材、生成 Wiki、更新索引和体检系统的全流程。
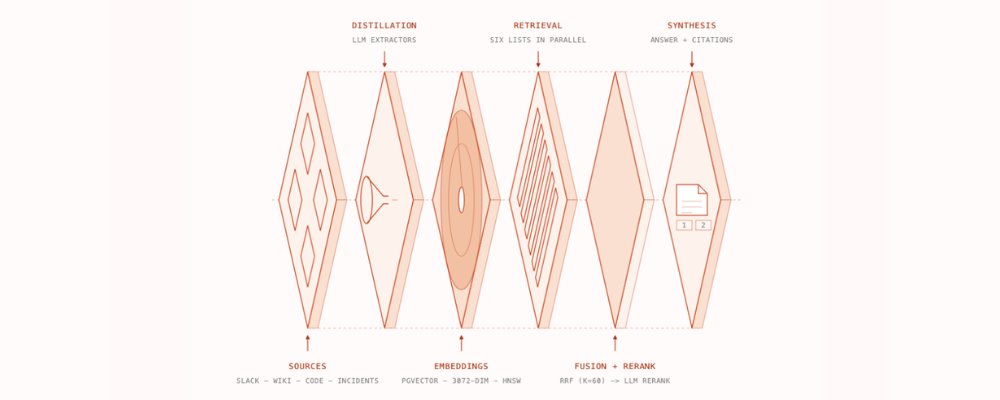
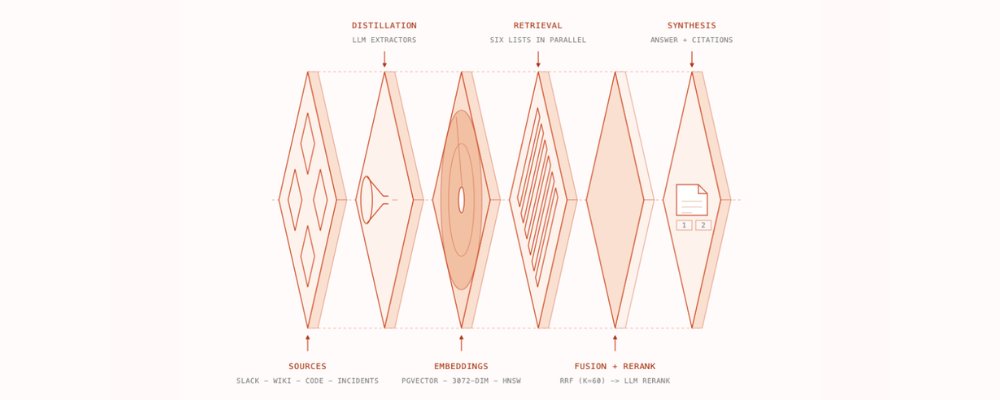
Cerebras 分享了构建其内部知识库的经验。该知识库每天处理超过 15,000 个问题,集成了 Slack、GitHub 等多种数据源。文章详细介绍了如何通过 Postgres 存储 embeddings,并采用混合搜索策略(全文搜索、向量搜索、IDF 加权、时间衰减)来高效检索非结构化对话数据,解决了信息分散和匹配精度的问题。
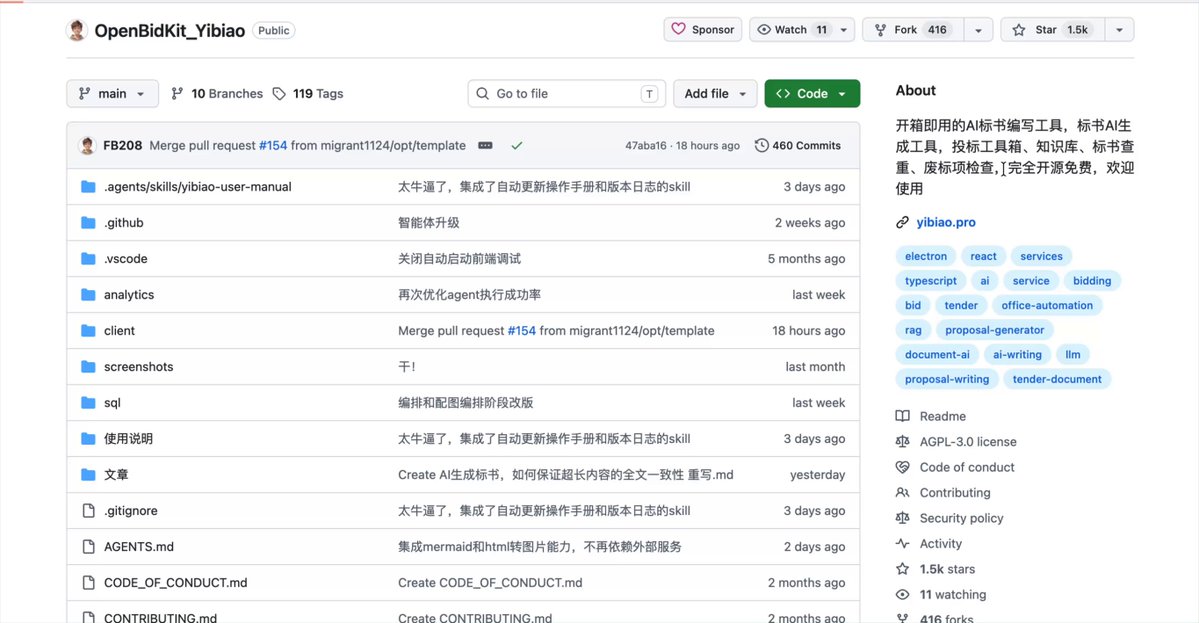
易标投标工具箱(OpenBidKit_Yibiao)正式上线,这是一款开源免费的AI标书编写工具。支持本地桌面运行,兼容DeepSeek、GPT等多种模型,10万字标书成本仅约1元。功能包括知识库智能复用、图文自动生成、标书查重及废标项检查,旨在帮助小企业降低投标成本。
Cerebras 分享了如何构建内部知识库,该系统每天处理超过 15,000 个查询。文章介绍了其数据采集架构,特别是如何通过混合搜索技术(全文搜索、Embedding 搜索、IDF 和时间衰减)来处理非结构化的 Slack 对话,以提高信息检索的准确性和实时性。
Cerebras 介绍了其内部知识库的构建过程,该知识库每天处理超过15,000个问题。系统通过从Slack、GitHub等平台提取数据,利用Postgres存储嵌入和元数据,结合全文搜索、向量搜索、IDF和衰减时间等混合搜索技术,实现了高效的信息检索。
文章讲述了在 AI 时代,个人知识库如何成为核心竞争力。作者通过亲身经历展示了如何利用技术基因库、活数据土壤和认知根系三层生态,实现高效的项目交付和个人能力积累。
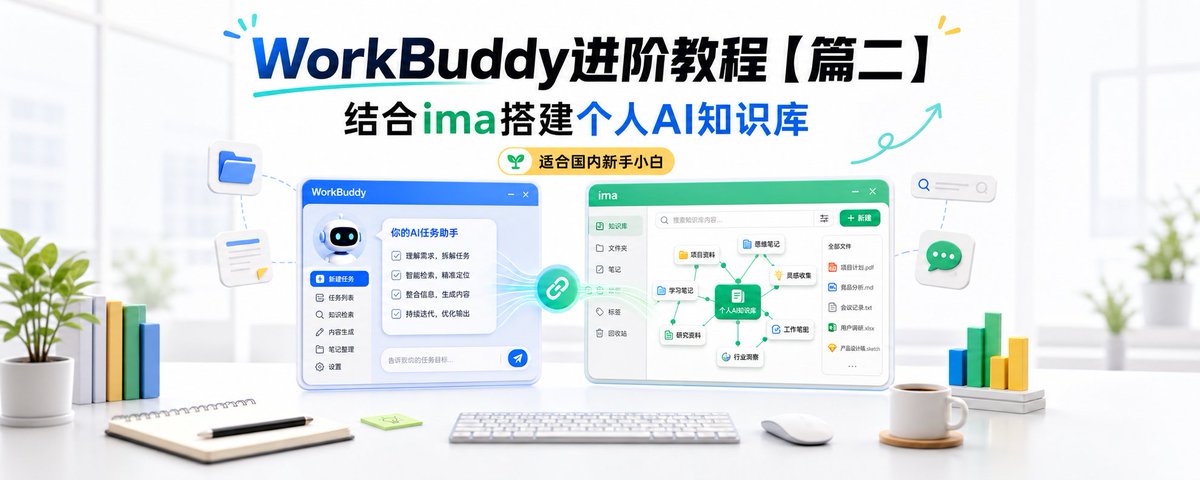
文章指出搭建知识库应先追求实用性而非完美系统。作者推荐使用 WorkBuddy 结合 ima 构建最小闭环:建立资料库、项目库和输出库,导入少量高质量资料,通过 AI 完成扫读、整理和选题,并将加工后的成果回存,从而形成真正可复用的知识体系。
文章详细介绍了大二学生安十一如何利用 Agent 和 Obsidian 搭建“一人公司(OPC)”赚钱系统,半年变现 6 万+。内容涵盖 OPC 的前端获客、中端转化与后端交付闭环,以及如何利用 Obsidian 构建 AI 知识库作为 Agent 的“记忆中枢”,实现课程制作与定制咨询两套后端收入的自动化工作流。
本文记录了作者在区级企业培训现场,利用 WorkBuddy 为一家工业企业搭建“数字分身”的完整演示。文章阐述了企业AI转型的三个判断,详细拆解了从资料建库、热点调研、文章写作到数字人视频生成的全链路流程,并展示了如何利用开源 Skill 将研究报告转化为汇报PPT。作者强调企业应从“+AI”转向“AI+”,选择高频、可验收的小流程切入,将个人经验转化为可复用的系统资产。
文章指出很多人搭建知识库失败的根本原因在于资料难以持续稳定地“入库”。作者介绍了通过 WorkBuddy 与 ima 知识库的组合,利用自然语言指令和自动化文件夹监控,将网页链接、本地文件等低成本地沉淀到知识库中,从而将知识库从简单的收藏夹转变为能辅助内容生产的数字助理。
文章对比了AI写作的“魔法棒”与“流水线”模式,指出一次性生成缺乏质量门禁,容易产生误导性幻觉。作者提出了一套包含库检索、补搜、写作、配图、核查、修复的六步生产管线,强调通过结构化验证和分诊核查,确保每个论点有据可查,从而将AI写作从简单的文本生成升级为可验证的知识生产过程。
文章介绍了一套基于 Obsidian 和 AI 的内容生产工作流,旨在解决素材收集难、利用率低的问题。方案涵盖 Obsidian 的基础安装、双链笔记法、文件夹分类心法,以及如何通过 Copilot 和 Claudian 插件接入 DeepSeek 与 Claude,实现素材的自动化整理、知识库构建与写作辅助,帮助创作者建立可复用的个人资产库。
本文详细解读了 Karpathy 提出的基于 LLM 的个人知识库管理方案 'llm-wiki'。文章核心在于将传统的 RAG 检索模式转变为 '编译' 模式:人负责收集原始资料,LLM 负责将资料编译成互相链接的维基页面。文中深入剖析了系统的三层架构、Schema 设计的重要性,并提供了从 0 到 1 的动手搭建指南及进阶的 '防坑' 建议,旨在帮助读者构建一个具备持续复利能力的个人知识库。
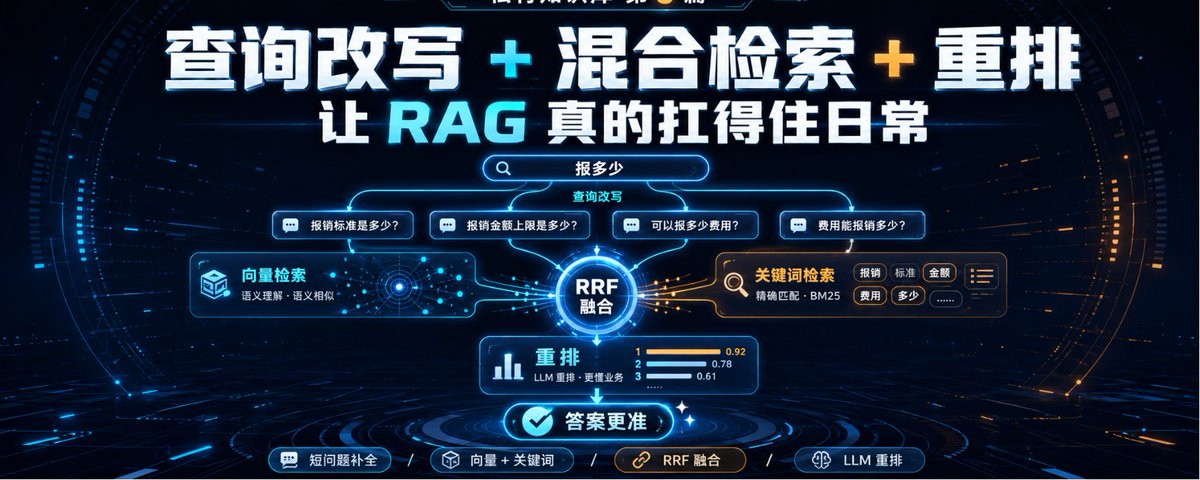
本文是私有知识库构建系列的第 3 篇,旨在解决基础 RAG 系统在短问题召回、关键词匹配及结果排序上的缺陷。作者详细介绍了通过 LLM 进行查询改写以补全上下文,利用 PostgreSQL 结合 Jieba 实现混合检索(向量+BM25),以及使用 RRF 算法融合检索结果,从而显著提升知识库的日常可用性。
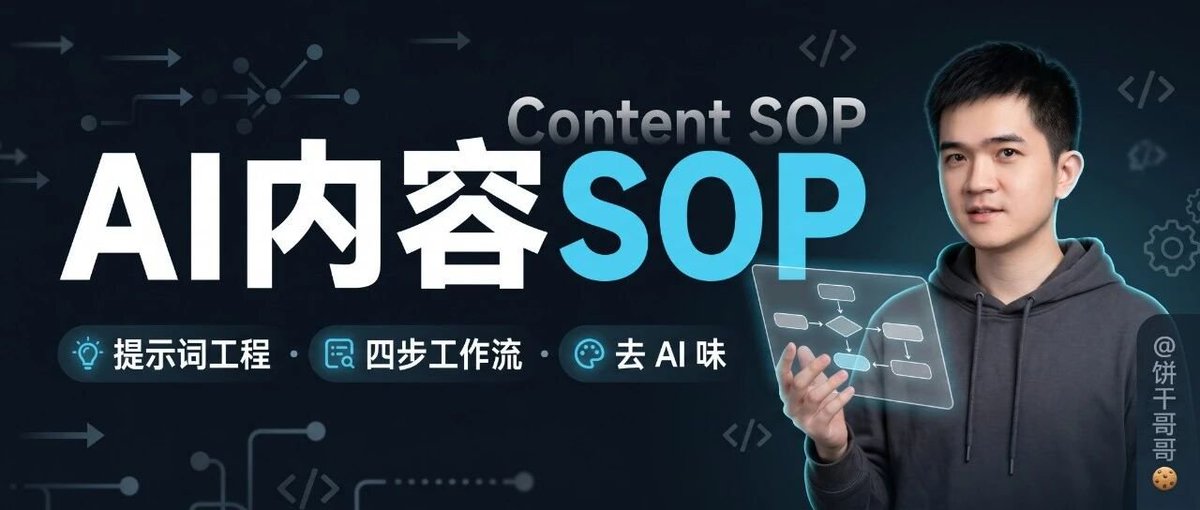
本文提出了商业内容本质是议论文的观点,并量化了好内容的六大标准。作者将AI创作方法进化为三个版本:提示词技巧、SOP流程固化以及基于知识库的3.0记忆系统。同时,详细解析了去除AI味、优化开头结尾的具体策略,强调在AI降低写作成本后,选题判断和真实经历成为核心竞争力。
WorkBuddy 是腾讯出品的本地执行型 AI 智能体(AI Agent),与传统聊天机器人不同,它能直接操作本地文件、调用工具并自动执行任务。本文详细介绍了 WorkBuddy 的核心区别、三种工作模式(Craft/Plan/Ask)、安装配置、专家系统、技能市场以及微信/飞书等远程控制功能的用法,旨在帮助职场人利用 AI 实现办公自动化。
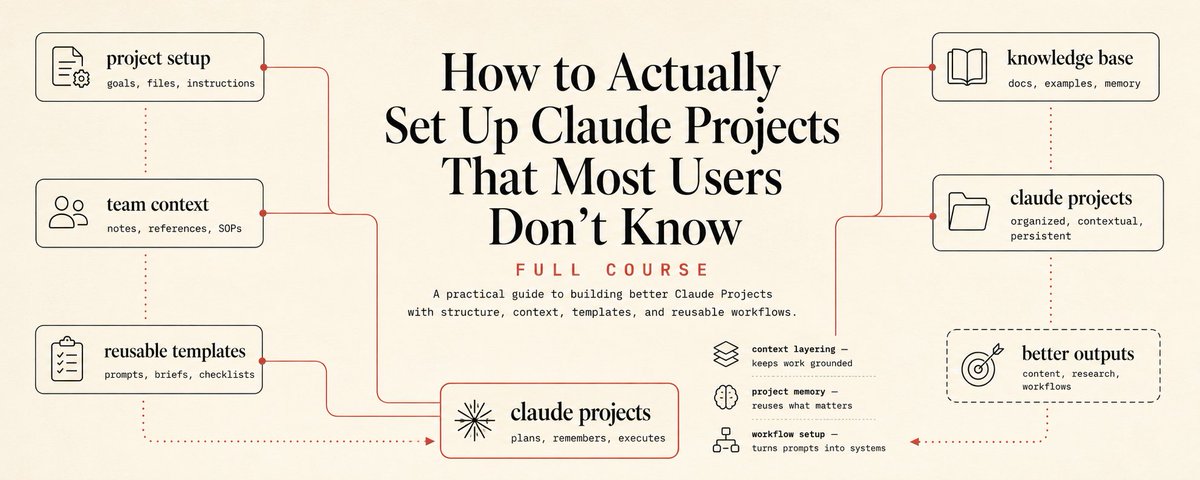
文章揭示了大多数用户使用 Claude 的低效模式,即每次会话都重复提示词,指出 Claude Projects 能通过持久化工作空间解决此问题。文章详细解释了项目的核心构成(自定义指令、知识库、作用域对话),并纠正了堆砌文件的常见误区。作者提供了完整的进阶设置指南:命名需具体、指令需像常备简报般详尽(涵盖角色、回复方式、禁止事项),以及知识库应保持精准短小(1-3页),包含风格指南和最佳范例。
本文介绍了一种适合国内新手的个人AI知识库搭建方案,即使用WorkBuddy结合ima知识库。文章详细讲解了从软件下载、连接授权、知识库创建配置到实际运行任务的全过程,并提供了整理学习资料和生成内容选题的具体Prompt示例。
本文介绍了如何利用 Obsidian、Markdown、GitHub 和 AI(Codex)快速搭建一个同步的知识库。文章建议新手先不要追求复杂的 RAG 和向量数据库,而是使用 Obsidian 结合 Git 插件进行本地与云端(GitHub)的免费同步。文中还提供了小红书及网页内容剪藏插件的推荐,实现内容的快速收集与 AI 辅助整理。
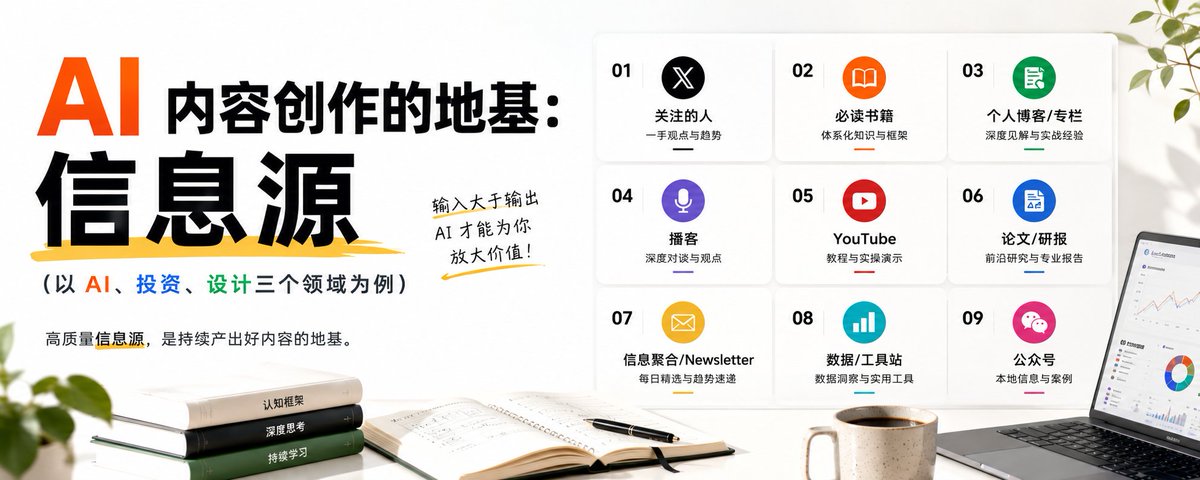
本文阐述了高质量信息源是 AI 内容创作的核心基础,指出 AI 内容质量取决于输入信源的质量。文章系统梳理了 9 类通用信息源(如 X 关注列表、必读书籍、论文库、产品平台等),并以 AI 领域为例,详细列举了值得关注的大佬、书籍、博客、播客及 YouTube 频道,为构建 AI 知识库提供了详尽的参考清单。
文章指出大多数用户仅将 Claude Projects 视为带标签的文件夹,错失了其构建定制化 AI 员工的潜力。作者提出了由身份、规则、流程、输出格式和知识文件组成的六步项目蓝图,通过具体指令和约束,引导 Claude 精准理解用户语调、受众及工作流,从而输出高质量、个性化的内容。
作者开源了其自用的浏览器视频下载插件“小耳抓视频”。该插件支持一键下载 YouTube、B站、X、TikTok 等 1800+ 个网站的视频,旨在帮助用户将教学内容保存到本地,构建个人知识库。此外,作者还配套开源了本地视频转字幕的工具,完善了“下载-转文字-进知识库”的工作流。
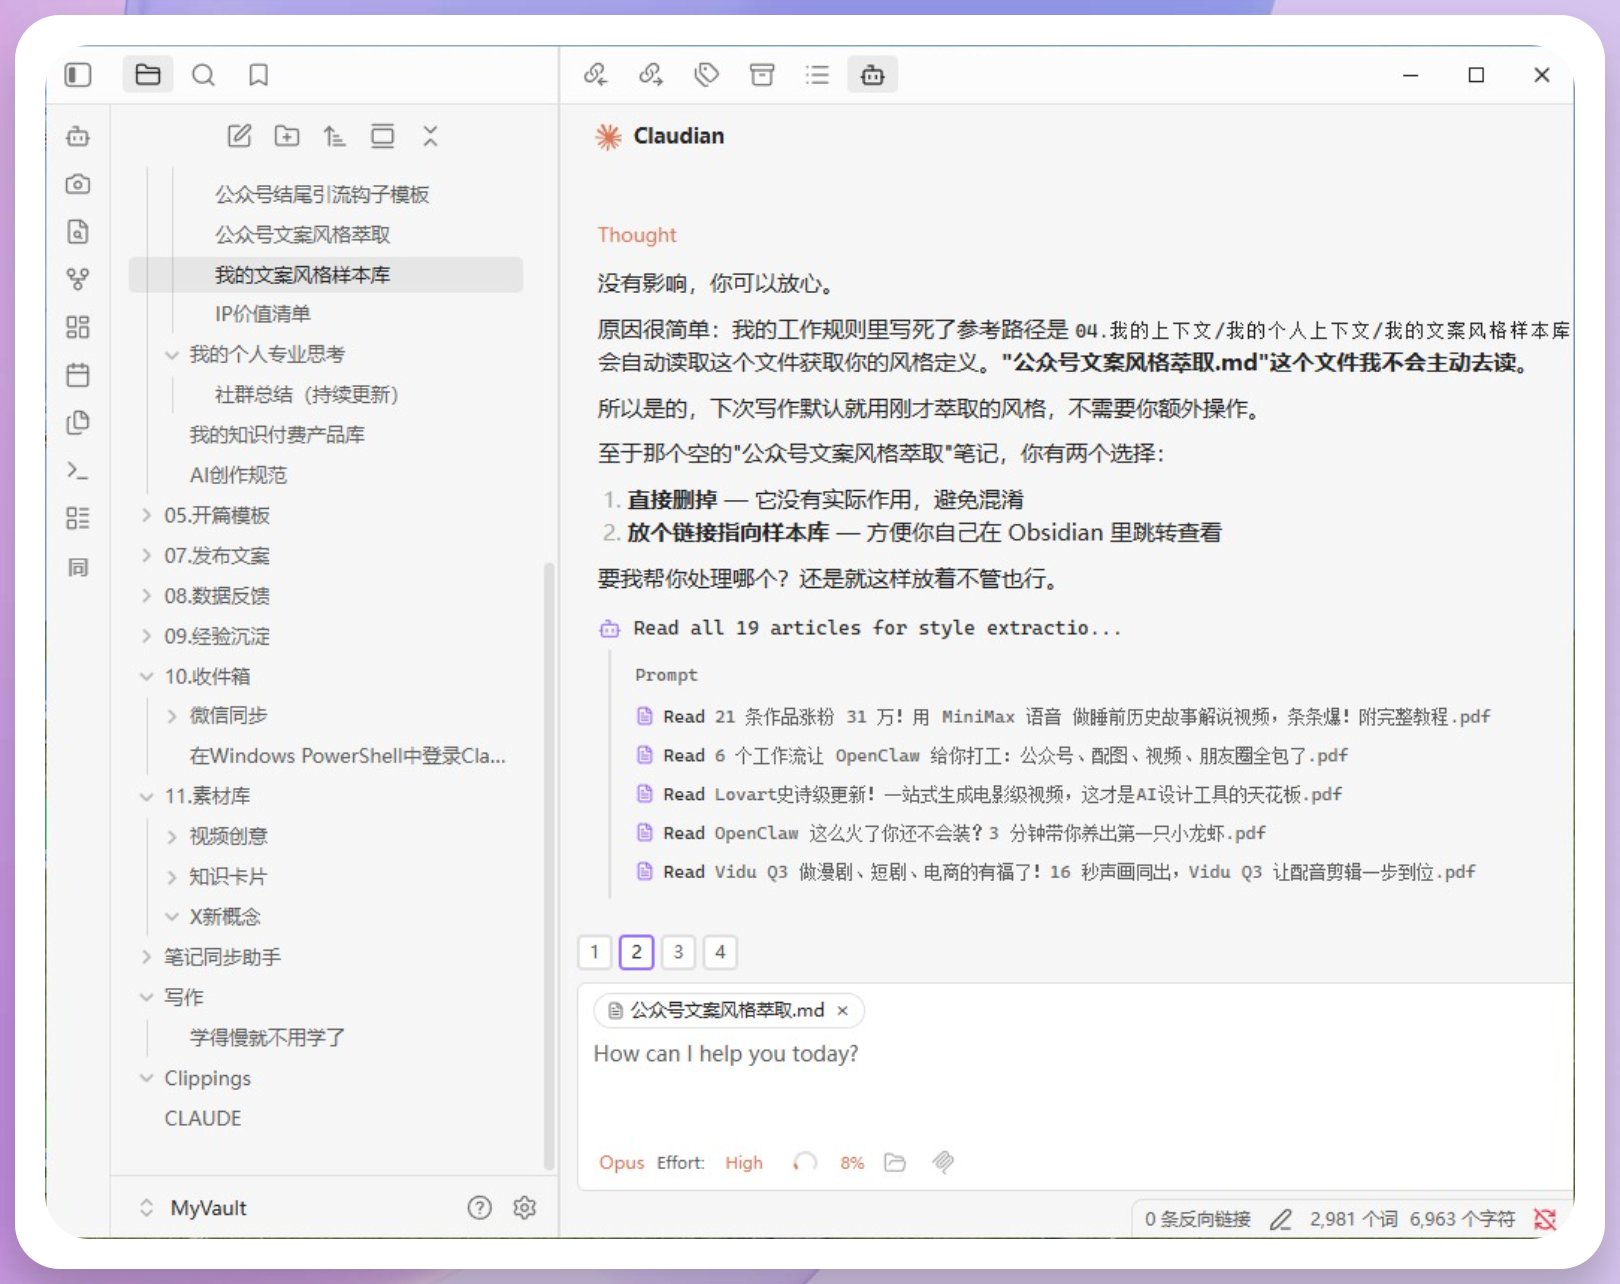
作者分享了周末搭建本地知识库的实战经验。为了解决飞书、微信收藏等信息分散的痛点,采用了 Obsidian 作为存储核心,结合 Claude 和 Codex 两大模型。文章详细介绍了七项具体工作:整理个人传记、萃取写作风格、打通微信同步与浏览器插件归档、训练标题 Skill 以及批量迁移飞书数据。最终实现了 AI 对作者风格的深度理解,强调了私有数据对 AI 效能提升的重要性,以及本地化方案的数据安全性。
本文介绍了自动化社群运营工具 Lucius。它不仅能作为 FAQ Bot 回答问题和拦截垃圾信息,核心价值在于构建“社区记忆层”,将对话转化为可复用的组织记忆。文章分析了 Lucius 的四大护城河:组织记忆、AI 社区经理、用户画像及安全风控,认为它抓住了 AI 领域的 Memory Layer 和 Agent Operator 趋势,适合 Web3 及 SaaS 团队使用。