做完一次总体设计后,我重新理解了企业级知识库
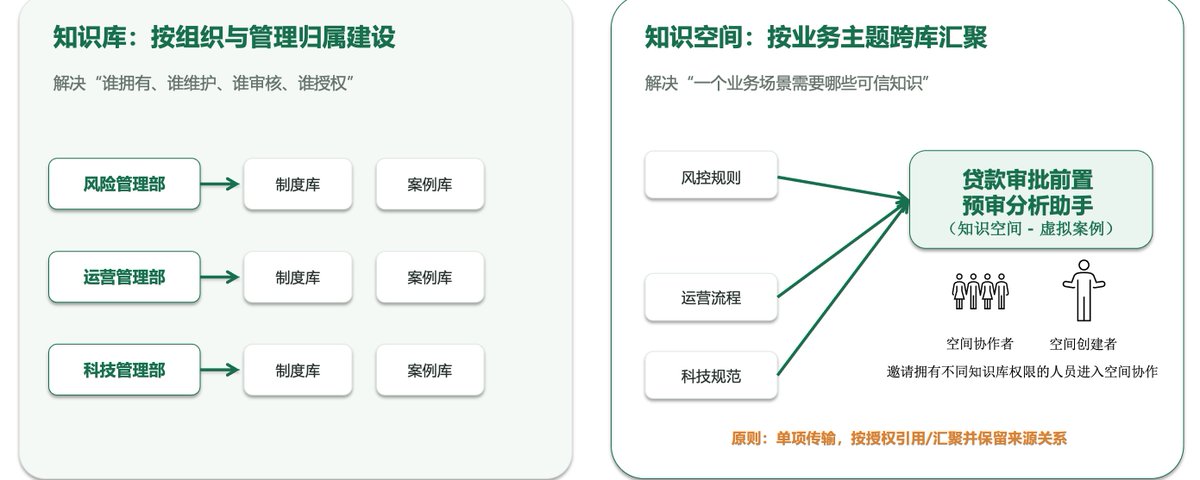
文章基于企业级智能知识库项目的实践,探讨了企业知识库的真正门槛。指出其不仅是文档存储,更是一套涵盖构建、治理、使用和优化的闭环运行机制。重点分析了知识库与知识空间的区别、知识生命周期管理、可信溯源及权限控制,强调知识库应作为支撑未来 Agent 的企业级 AI 知识引擎。
文章基于企业级智能知识库项目的实践,探讨了企业知识库的真正门槛。指出其不仅是文档存储,更是一套涵盖构建、治理、使用和优化的闭环运行机制。重点分析了知识库与知识空间的区别、知识生命周期管理、可信溯源及权限控制,强调知识库应作为支撑未来 Agent 的企业级 AI 知识引擎。
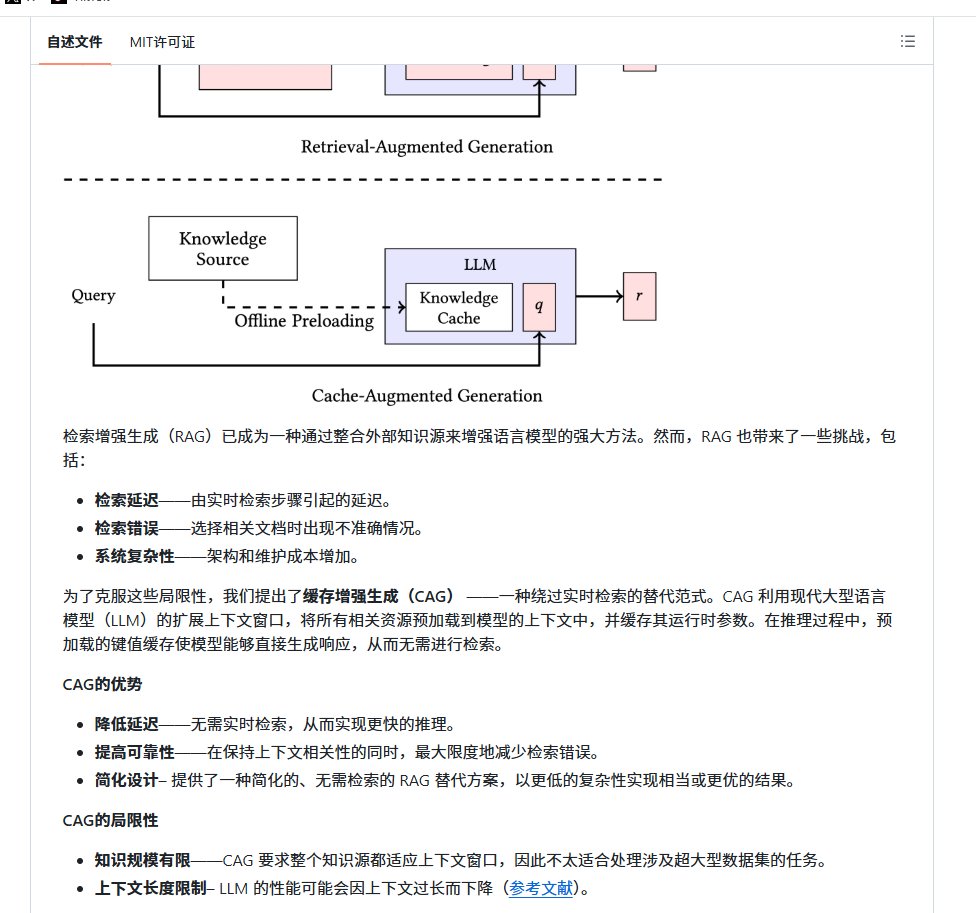
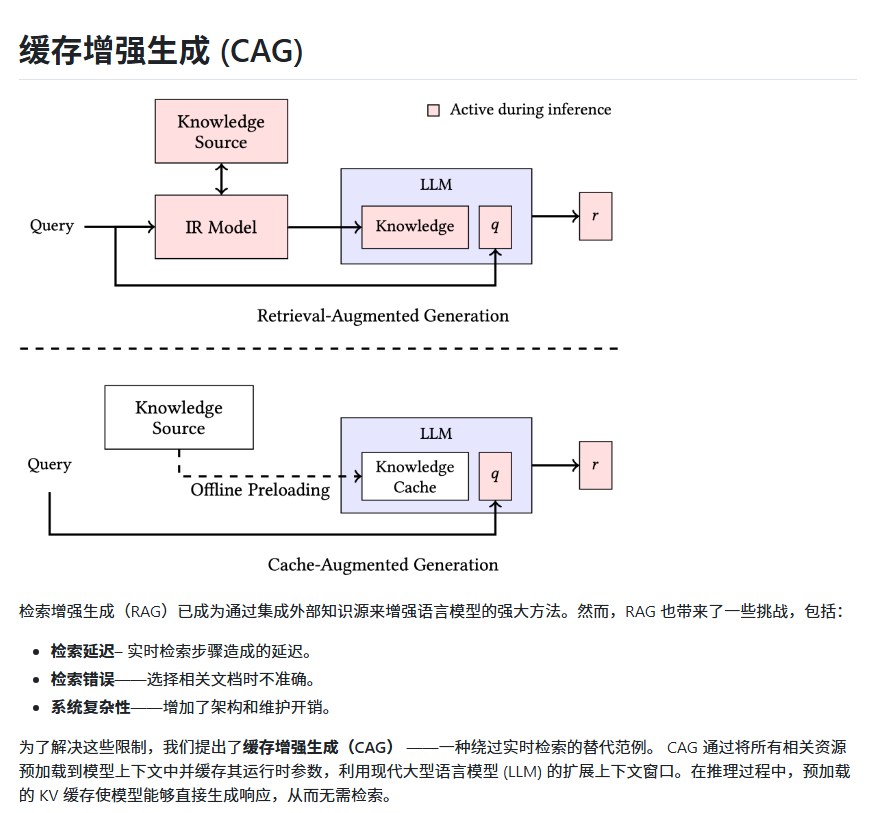
文章介绍了缓存增强生成(CAG)作为一种替代经典RAG流水线的新方案。CAG通过将全部知识预加载到模型上下文并缓存KV Cache,显著提升响应速度,解决检索延迟和召回缺失问题。适用于中短篇幅静态文档,但对大规模或频繁变动数据仍需传统RAG或混合架构。
本文复盘了一个企业级售后工单 AI 工作台的开发全流程。项目经历业务定义、产品设计、技术选型、开发实现及验收部署六个阶段,最终交付包含权限管理、知识检索、审计等功能的完整 Agent。文章总结了“AI 执行,人做选择”的协作模式,强调证据留存与工程边界,提供了一套可复用的 AI 辅助开发方法论。
文章包含两则短讯。前半部分反思了不合群想法的价值,指出吃苦并非成功的途径,找到适合的位置更重要。后半部分讨论了RAG技术在小型企业中的应用,认为文档本身的可信度问题比检索技术更关键,提出应关注运行时Policy的开发,而非过度纠结于检索链路。
文章对比了 Serper(Google 封装)与豆包搜索在 Agent 应用中的表现。豆包在 Query 改写、结构化数据(汇率/股价)、跨语言检索、时效性过滤及信源权威度分级上优势明显,更适合处理中文口语化及实时信息需求;而 Google 在英文学术检索上仍占优。文章指出高质量搜索 API 对提升 Agent 推理能力至关重要。
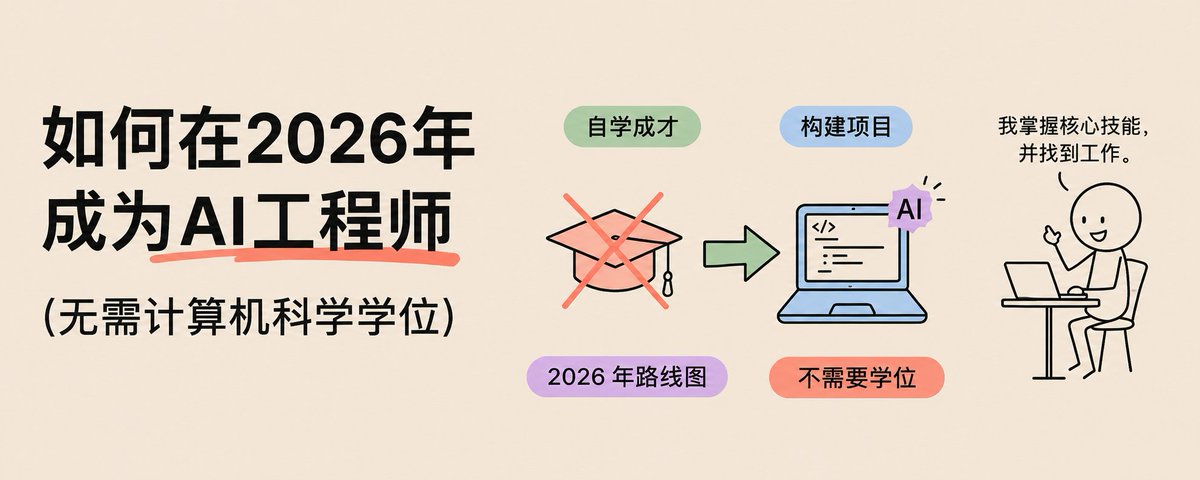
文章指出2026年AI工程师角色已分化为机器学习工程师和应用AI工程师。对于非CS学位求职者,后者是主要机会。文章详细列出了必备技能(Python、LLM行为、RAG系统、评估观测),并提出了三个能替代学历证明的实战项目建议。
文章探讨企业级 Agent 开发中如何防止 AI 越权。作者指出接通大模型仅是第一步,关键在于通过服务端规则、来源白名单和 Human-in-the-loop 机制约束模型行为。文章介绍了流式输出协议、AI 原稿与人工终稿分离、以及模型不可用时的降级策略,强调企业需建立可追踪的责任链路,确保 AI 只提供建议,不直接产生业务结果。
文章介绍了基于 Andrej Karpathy 提出的“LLM Wiki”概念而衍生出的四种 Agent Wiki 系统(DeepWiki、AutoWiki、OpenWiki、GBrain)。核心原理是在摄取阶段将信息编译为 Markdown 页面,而非在查询时检索。文章详细阐述了系统架构、优势及不同团队的工程实现差异。
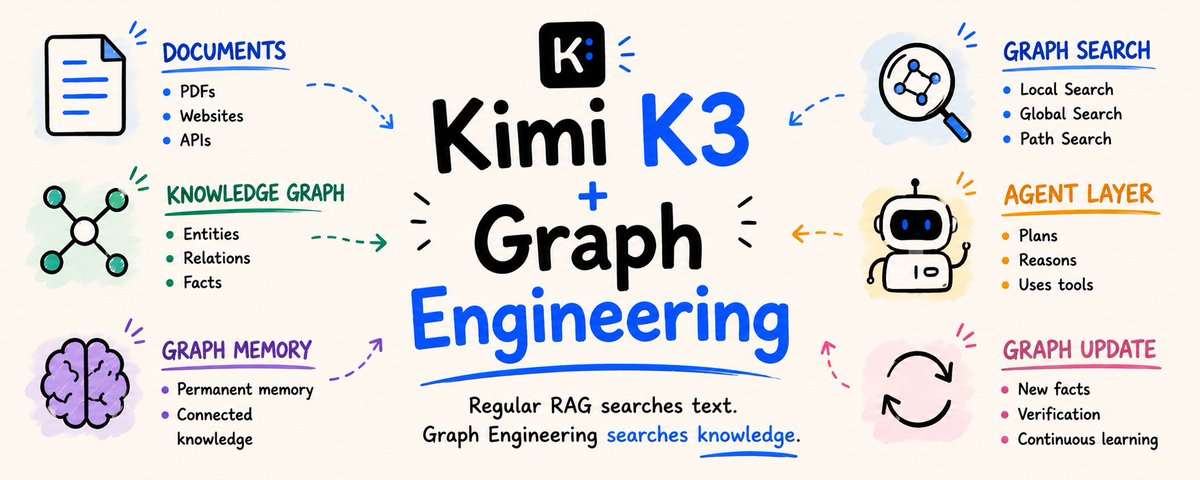
文章介绍了通过结合 Kimi K3 模型与图工程构建 AI 系统的方法。相比传统 RAG,该架构利用知识图谱存储实体关系,能处理复杂推理,实现成本降低85%和准确率提升18%。文章引用微软 GraphRAG 等研究,详细阐述了如何从零开始构建该系统。
文章指出企业 RAG 不仅仅是上传 PDF 回答问题,更需关注文档版本、权限、来源追溯及停用管理。作者通过模拟企业真实文档环境,构建了包含版本控制和过滤机制的评测体系,强调了可靠检索与诚实无答案的重要性,并分享了针对小规模知识库的技术选型经验。
文章探讨了 LLM Wiki 模式的兴起,即通过在摄取时编译知识而非查询时检索,解决传统 RAG 无法积累知识的问题。介绍了 Cognition、FactoryAI、LangChain 等团队构建的 Agent Wiki 系统,分析了其架构原理及在维护成本上的优势。
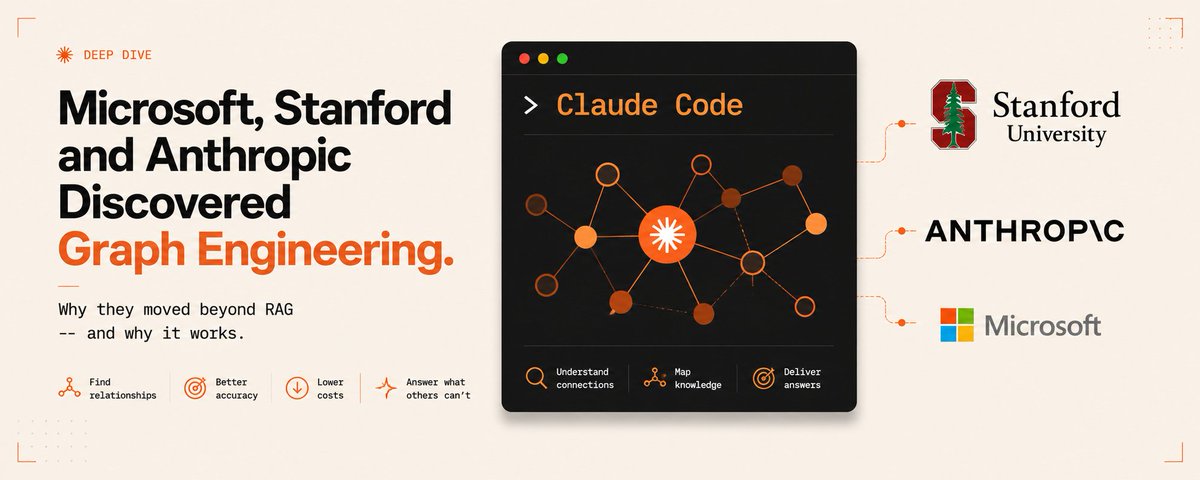
文章介绍了图工程相比传统RAG在复杂问题回答上的优势,通过微软GraphRAG、斯坦福DSPy及Anthropic Claude的案例,展示了图结构如何提升AI准确性和降低成本。核心观点是图工程能捕捉实体间关系,而非仅检索文本片段。
PixelRAG 是一种开源的视觉化网页检索技术,通过直接截图并使用视觉模型分析像素,而非依赖 HTML 解析,从而避免信息丢失。它构建了 3000 万维基百科截图的视觉索引,在问答任务上超越传统文本 RAG 基准 18.1%,并支持 Claude 代码插件。
本文是“AI时代的知识编排”系列收官之作。作者回顾了利用AI与结构化知识库高效产出技术博客的实践,发现写作过程本身遵循着“文档驱动”(SDD)的逻辑。文章通过信息论、认知科学及实证数据论证了结构化输入的重要性,并指出知识编排已成为AI时代内容生产的生存必需,强调了核查与人工判断不可替代。
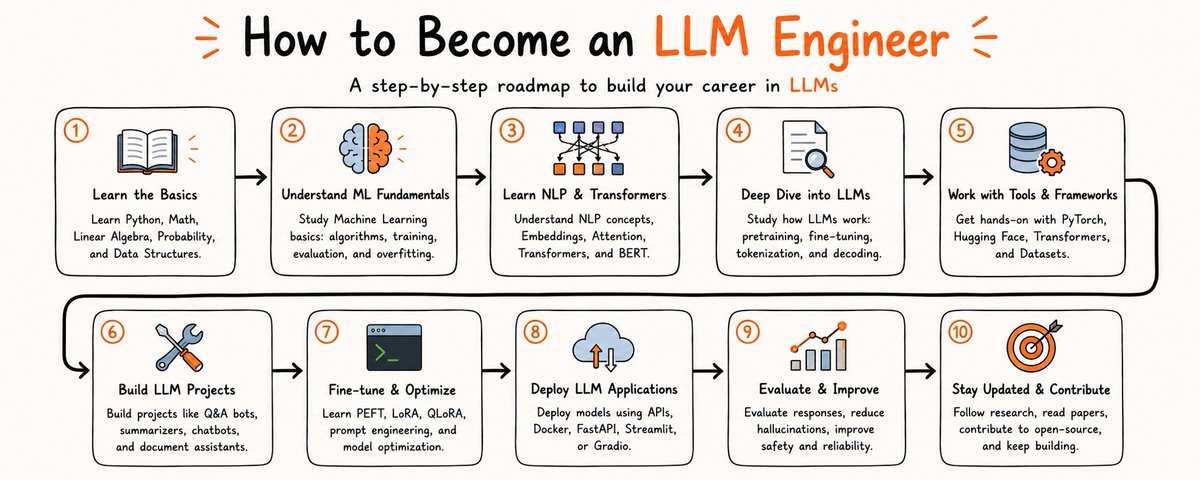
本文是2026年成为LLM工程师的实用指南,涵盖核心技能(RAG、Agents、生产部署)、学习路线、推荐工具及项目构建建议,帮助读者系统掌握大模型应用开发与工程化能力。
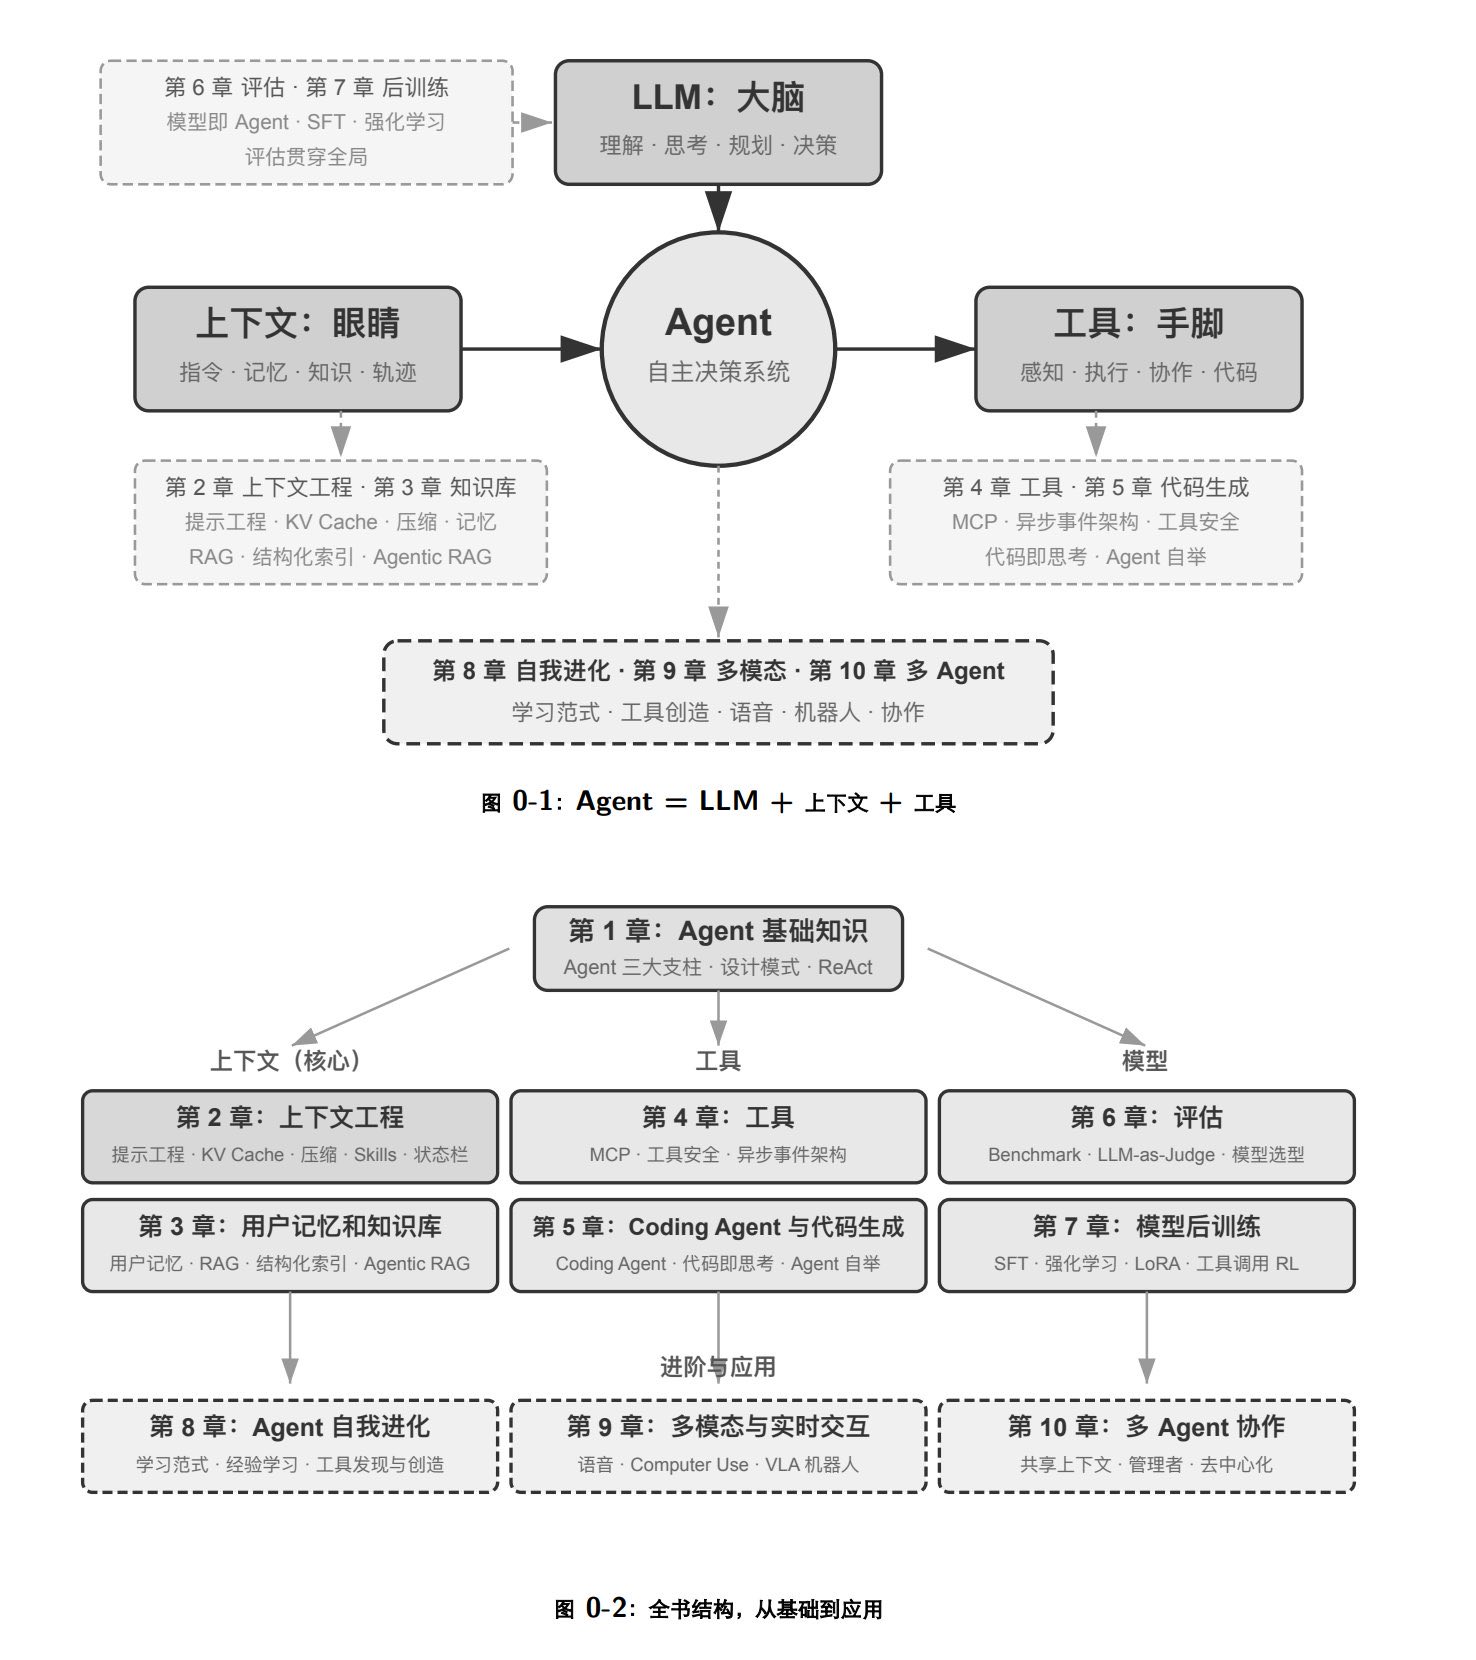
李博杰新书《深入理解 AI Agent:设计原理与工程实践》开源,涵盖从0到1构建生产级AI Agent的原理与代码,包括RAG、工具调用、多Agent协作等实战内容。
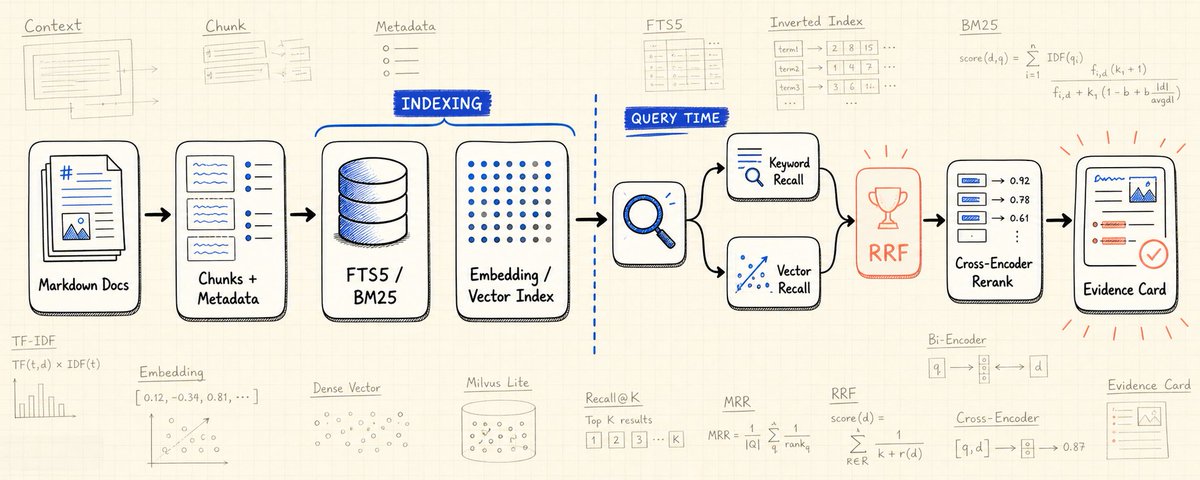
本文通过 Notebook 实战项目,对 RAG 系统的索引与检索过程进行了深度解析。内容涵盖文档切分(Chunking)、SQLite FTS5 倒排索引、BM25 关键词检索、向量 Embedding 语义检索,以及基于 RRF 的混合检索召回策略。此外,文章还介绍了如何构建评测集来验证检索效果,提供了完整的代码与数据结构示例,旨在帮助开发者理解 RAG 底层运作原理与工程实践细节。
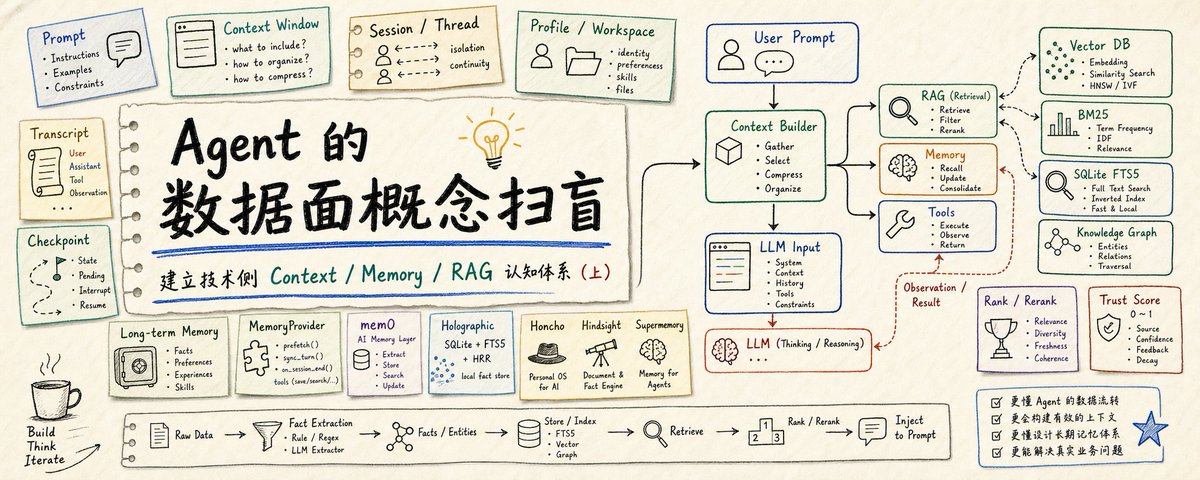
本文深入解析了 Agent 数据面的核心概念,将其比作操作系统的内存管理单元。文章详细阐述了 Context Engineering 的演变、Session/Thread/Profile 的架构差异,以及 Session Memory 与 Long-term Memory 的区别。作者还重点介绍了 Hermes 中的 Memory 设计方案、SQLite FTS5 与 BM25 算法原理,以及向量检索与关键词检索在 RAG 中的混合应用,旨在为开发者建立一套完整的 Agent 数据面技术认知体系。
文章介绍了一款名为 Crawl4AI 的开源爬虫工具,GitHub 星标超 7 万。该工具专为 RAG 和 Agent 设计,能将网页快速转换为干净的结构化 Markdown 数据。其特点包括零 API Key、异步浏览器池、智能去噪、支持 CLI/Docker 部署以及强大的反爬策略,被视为构建 LLM 数据管道的利器。
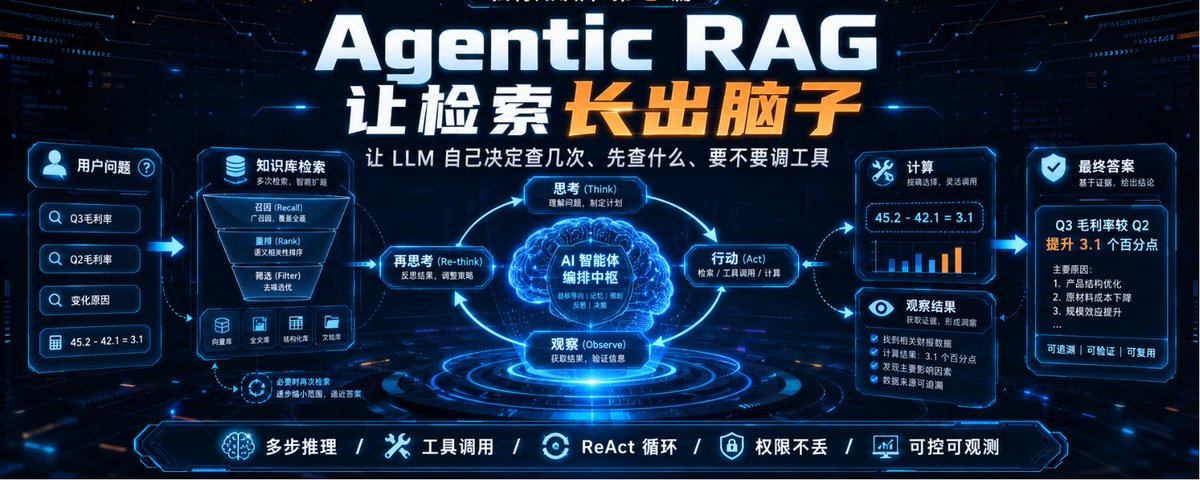
文章指出传统单轮 RAG 在处理复合问题时存在检索不足或幻觉的缺陷,提出通过 Agentic RAG(多步推理)来解决。核心思路是将 LLM 从被动应答升级为主动调度的指挥官,利用 ReAct(推理-行动循环)机制,自主决定检索次数和工具调用。文中详细展示了如何封装检索工具、执行函数(含权限过滤、混合检索)以及编写多步推理循环代码,实现复杂问题的精准回答。
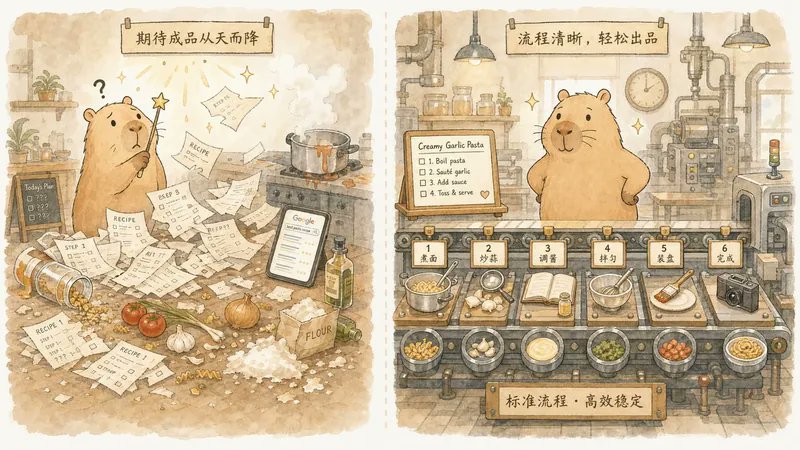
文章对比了AI写作的“魔法棒”与“流水线”模式,指出一次性生成缺乏质量门禁,容易产生误导性幻觉。作者提出了一套包含库检索、补搜、写作、配图、核查、修复的六步生产管线,强调通过结构化验证和分诊核查,确保每个论点有据可查,从而将AI写作从简单的文本生成升级为可验证的知识生产过程。
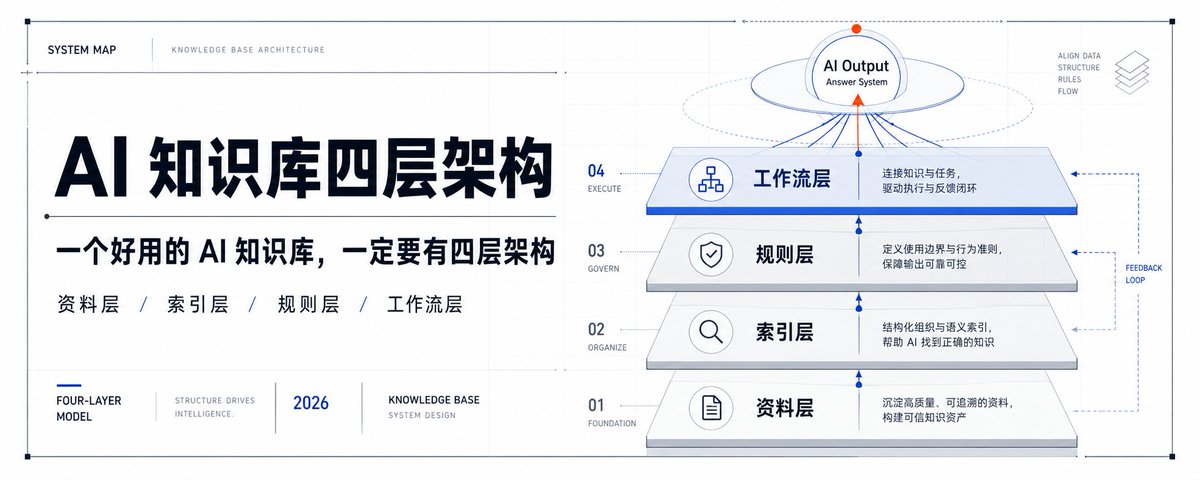
文章指出AI知识库搭建失败常因只有资料层,缺了索引、规则和工作流。资料层重质不重量,索引层解决检索路径,规则层限定输出与引用规范,工作流层确保落地任务。
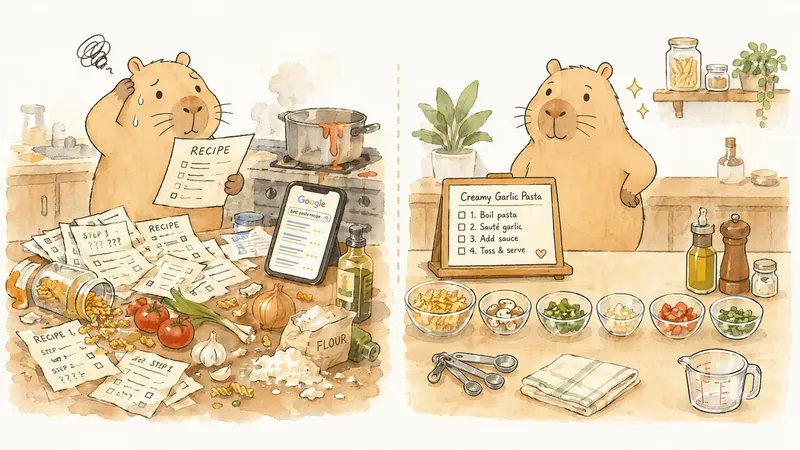
文章指出直接使用 ChatGPT 等 AI 生成内容往往缺乏事实依据且容易产生幻觉,作者提出了一种「先建库,再写作」的方法。通过提前花两天时间收集并结构化整理 43 篇高质量文献作为私有知识库(人工版 RAG),确保写作时每个论点都有可靠的数据和来源支撑。文章对比了临时搜索与提前备料的差异,并展示了该方法在 7 天内产出多篇高质量技术博客并获得显著收益的实战案例。
文章指出 2026 年 AI 工程师的门槛已变,不再看重学历,而是看重作品集与交付能力。作者拆解了 AI 工程师的三个核心能力:软件工程、LLM 使用及产品思维,并规划了一份为期 12 个月的六阶段实战路线图,涵盖 Python 基础、LLM API、RAG、Agent 系统开发、评估部署及求职准备。
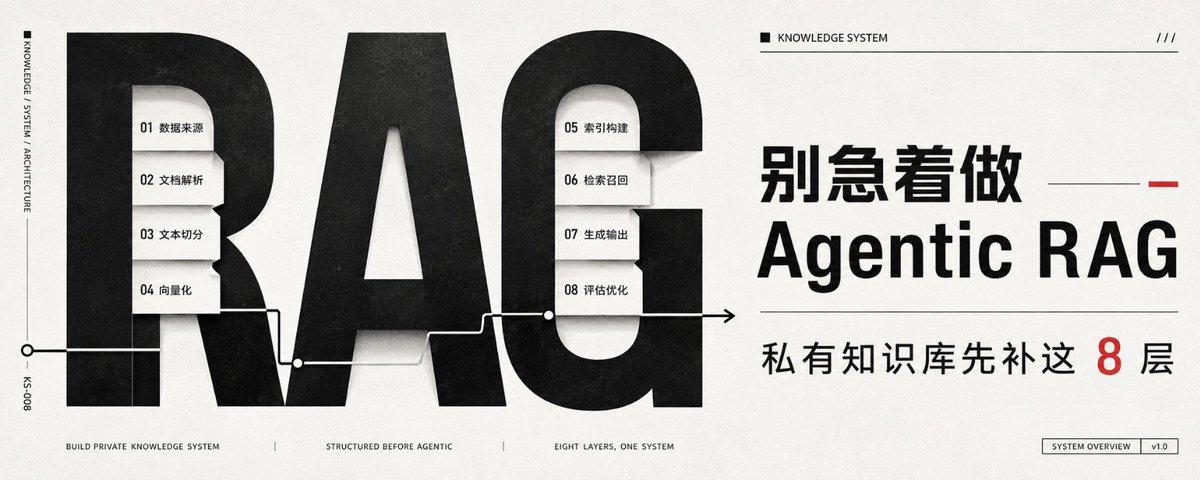
文章探讨了私有知识库项目在实际落地中遇到的挑战。许多 Demo 看起来聪明,但在生产环境中常因检索链路混乱而答非所问。作者指出单纯升级模型无济于事,根本在于构建稳固的 RAG 底座。文章详细拆解了从数据源、解析、清洗、切分、Embedding 到索引、检索、生成及评估的 8 层最小可用架构,并阐述了 Agentic RAG 如何通过决策层优化检索策略。最后提供了从 0 到 1 的搭建步骤及技术选型建议,强调权限过滤、混合检索与持续评估的重要性。
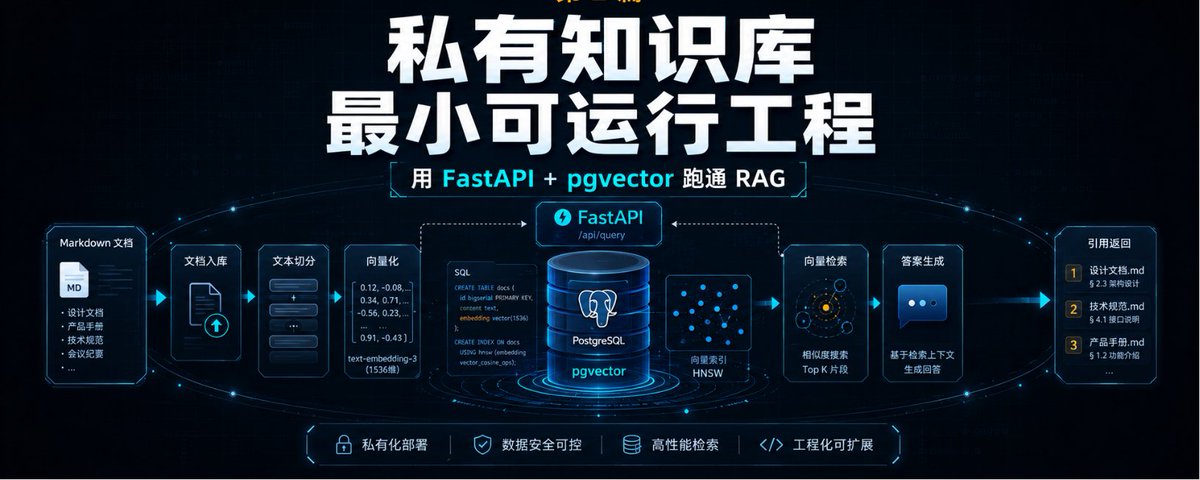
本文是一份实战教程,指导读者从零搭建一套最小可运行的 RAG(检索增强生成)私有知识库。技术栈采用 FastAPI 作为接口框架,PostgreSQL 配合 pgvector 扩展进行向量存储,并调用通义千问(Qwen)模型与 Embedding 服务。文章详细讲解了项目结构、依赖配置、数据库模型定义以及文档入库的完整代码实现,旨在构建一个可落地的工程底座。
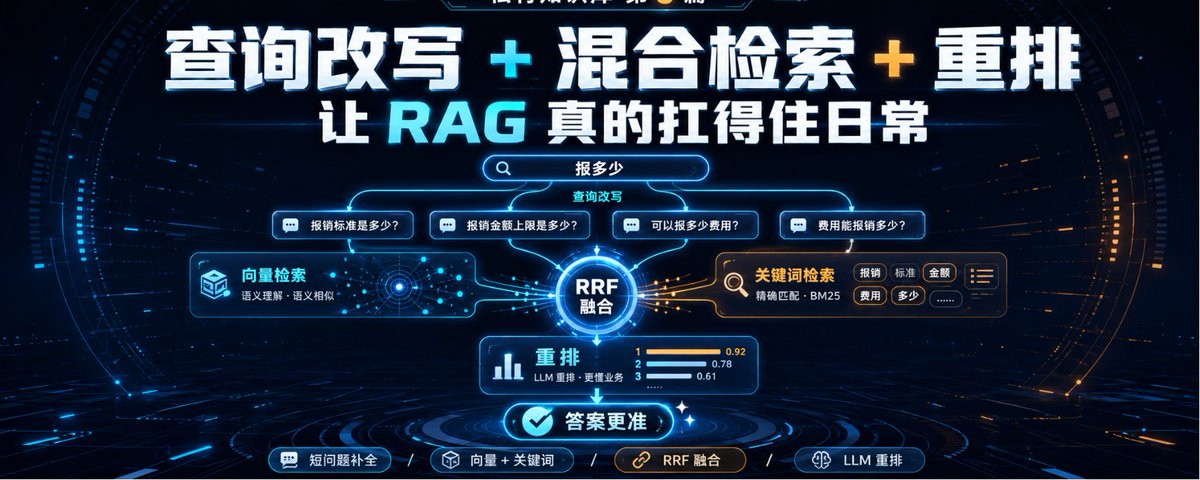
本文是私有知识库构建系列的第 3 篇,旨在解决基础 RAG 系统在短问题召回、关键词匹配及结果排序上的缺陷。作者详细介绍了通过 LLM 进行查询改写以补全上下文,利用 PostgreSQL 结合 Jieba 实现混合检索(向量+BM25),以及使用 RRF 算法融合检索结果,从而显著提升知识库的日常可用性。
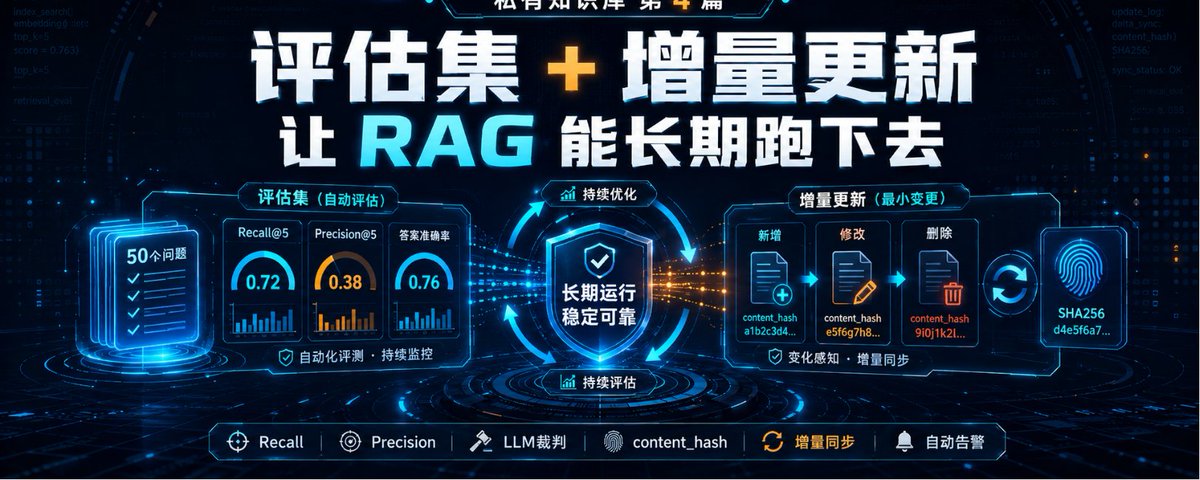
文章探讨了 RAG(检索增强生成)系统长期运行的两大难题:评估与更新。作者提出建立包含50个问题的“评估集”,通过 Recall、Precision 和 LLM 辅助的答案准确率来量化系统效果,避免盲目调参。同时,针对文档更新导致的全量重建成本问题,介绍了基于内容 Hash 的增量更新策略,仅处理变动文档,大幅降低资源消耗与停机时间。
阿里开源了一款名为 Zvec 的向量数据库项目,主打“纯本地、内嵌式”极简体验,号称向量界的 SQLite。该项目基于 C++ 编写,支持零配置安装,性能强悍(毫秒级搜索数十亿向量),同时兼容稠密、稀疏向量及全文检索。它非常适合本地大模型、RAG 和个人知识库开发,彻底免去了部署繁琐的后端向量服务。
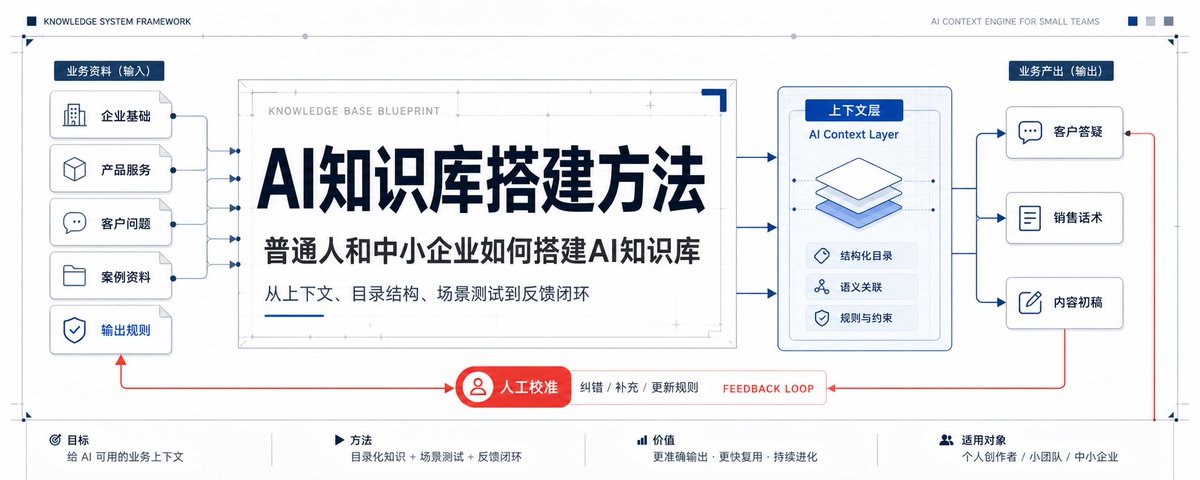
文章针对通用大模型不懂企业内部业务的问题,提出搭建AI知识库的解决方案。作者分析了从直接投喂到RAG等五种实现方式的优劣,强调中小企业应优先采用“目录化知识库”,并结合教培、健康产品、家装等实际案例进行说明。最后提供了具体的目录结构建议、可直接复用的提示词以及工具选择标准,帮助读者快速落地应用。