X千粉复盘:一次冲动消费,意外救活了我的账号
作者复盘了从0到1000粉近3个月的运营历程。前期因互关增长、方向迷茫、把X当公告栏而停滞。转机来自冲动购买SuperGrok Heavy年卡后,深入研究Grok Bot并持续输出实操内容,同时通过线下分享和主动互动建立真实连接。核心经验:找到真实使用的内容抓手,把经历加工成读者价值,发布不是终点而是交流的开始。
作者复盘了从0到1000粉近3个月的运营历程。前期因互关增长、方向迷茫、把X当公告栏而停滞。转机来自冲动购买SuperGrok Heavy年卡后,深入研究Grok Bot并持续输出实操内容,同时通过线下分享和主动互动建立真实连接。核心经验:找到真实使用的内容抓手,把经历加工成读者价值,发布不是终点而是交流的开始。
本文是一份自动化获客完整指南,介绍如何利用 AI agent(如 grok bot、hermes)和 skill 文件,为数字产品、本地实体生意或无产品者自动生成线索。核心方法:找到已付费人群,抓取公开数据,生成买家画像与广告素材,通过 whop ads 投放或渲染物业修复效果触达业主,最终将线索卖给企业。文章分三条 pipeline:数字线索、实体线索、线索变现,并说明 agent 负责寻找、画像、素材、渲染、外联等,仅少数环节需人工决策。
本文是一篇面向新手的个人网站上线教程,用通俗语言讲解从本地项目到线上访问的完整流程。文章分为四部分:先解释GitHub、Vercel、域名、DNS等概念及平台选择;再以GitHub+Vercel为例,手把手演示创建仓库、上传代码、导入部署、查看结果;接着介绍购买域名、配置DNS解析、绑定自定义网址;最后说明后续更新流程和费用构成。作者强调理解流程的重要性,并提供了可发给AI Agent的提示词模板,帮助读者在遇到问题时能定位排查。
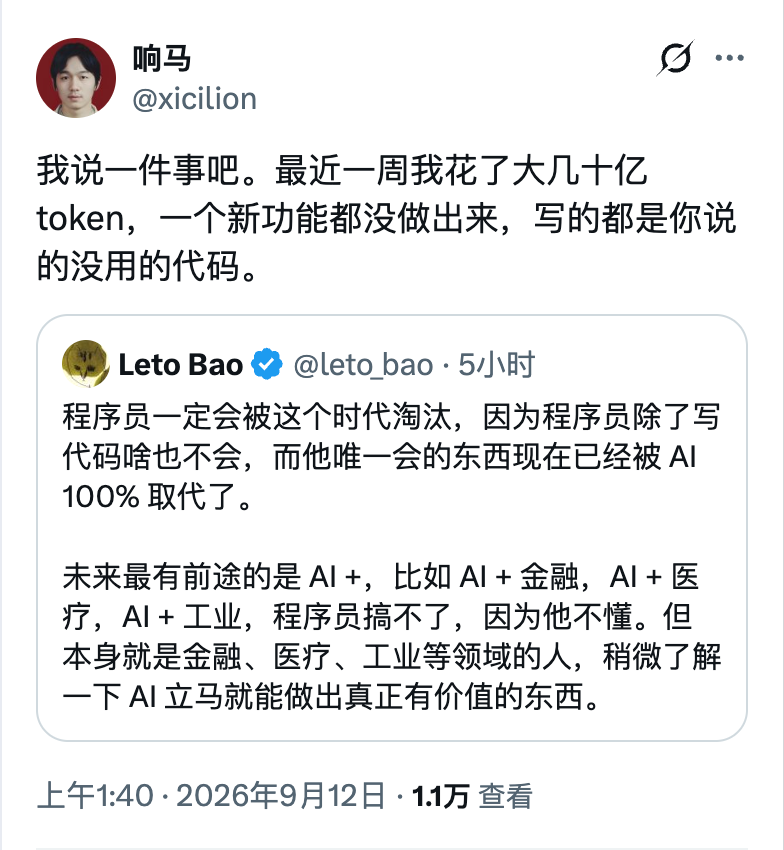
文章反驳了“程序员除了写代码啥也不会、将被AI取代”的观点。作者指出软件工程师的核心能力是理解需求、抽象设计、验证与维护,编码只是中间产物;领域专家靠“稍微了解AI”做出可用产品过于乐观,从原型到产品还需处理UI、边界条件、高并发、安全等问题,而AI工程本身就是一门学科,有工程底子的人更容易掌握。能力迁移是双向的,工程师的抽象与系统思维是跨领域的元能力。AI改变的是职业流程中的环节而非职业本身,工程师重心从写代码转向定义问题、验收结果,各行业岗位都在经历类似重新定位。
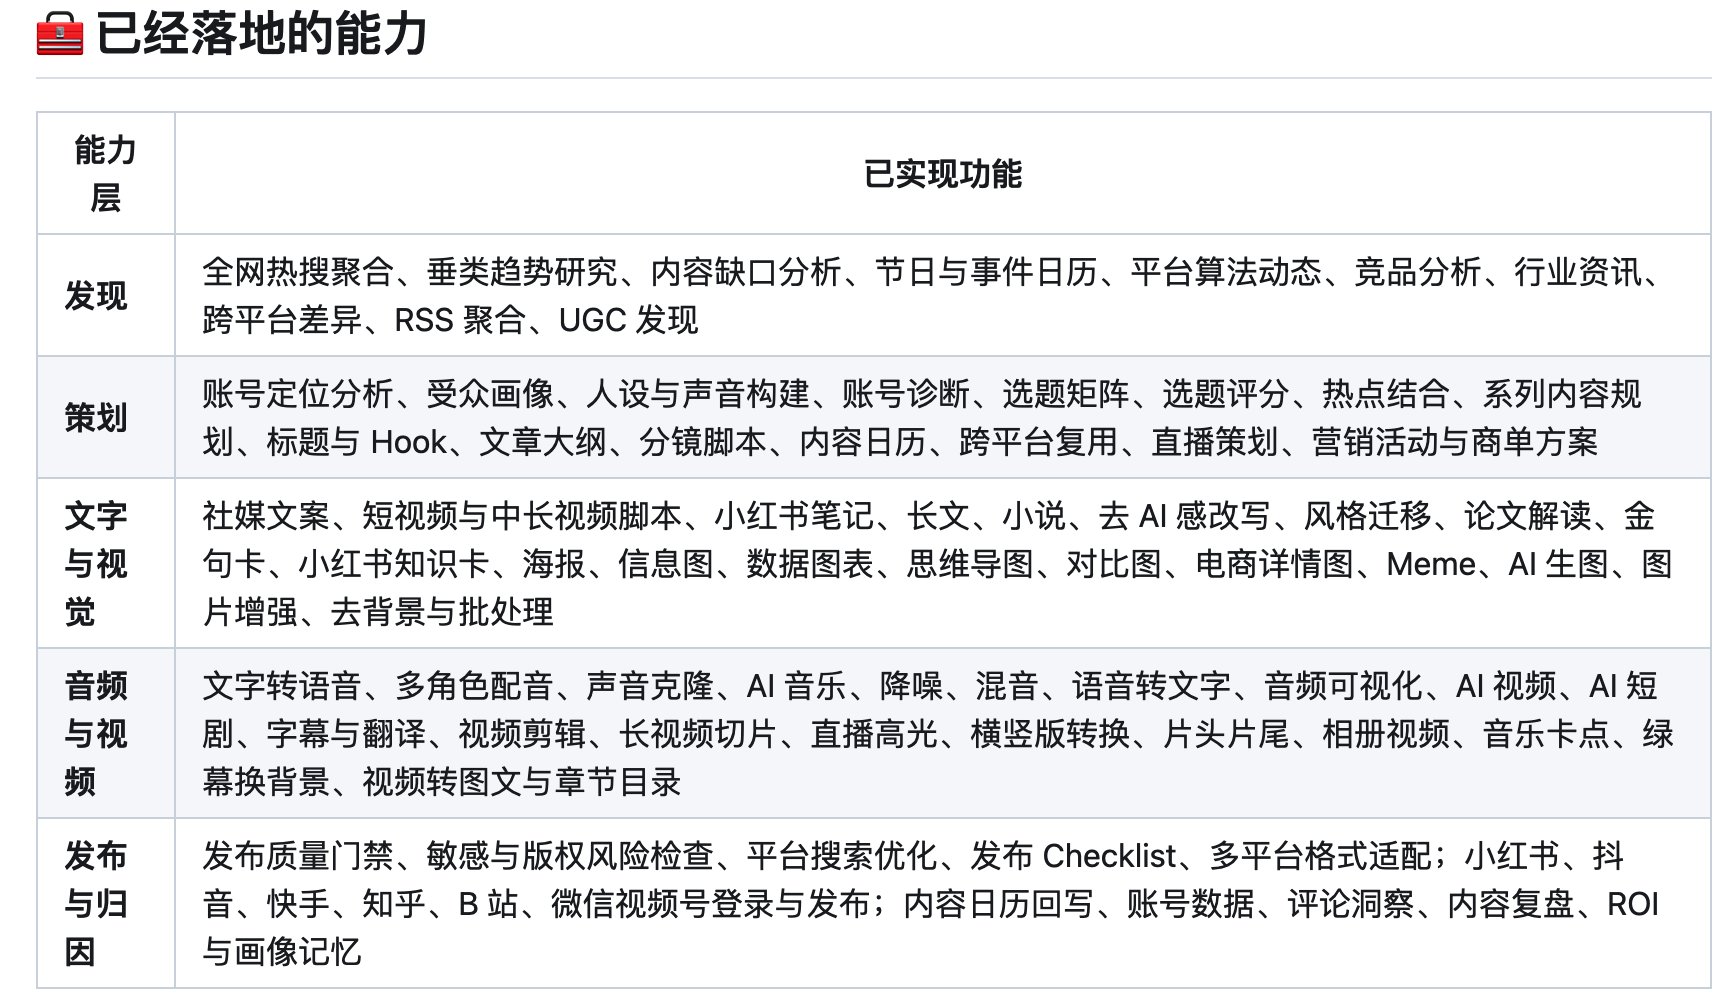
做自媒体最累的不是创作,而是每天重复找热点、想选题、写文案、做封面、剪视频、发平台、看数据等流程。文章推荐开源项目 Easel,由浙大和北大实验室开发,运行在 OpenClaw 上的社媒运营 Agent。它将热点发现、内容策划、图文/视频制作、多平台发布和数据复盘串成完整工作流,并为每个账号建立长期画像,记住定位、受众、风格、平台限制和历史表现,通过数据反馈持续优化内容生成,相当于为个人自媒体配了一支会自我复盘的 AI 内容团队。
作者维护开源软件工厂 OpenInspect,解释为何开源而非商业化销售。他认为软件工厂是将信号(issue、Slack 消息等)转化为成果(PR、修复、答案)的 AI Agent 基础设施。将其作为产品出售困难重重:沙箱和模型推理等核心组件已被商品化,各组织需求差异大。真正的价值在于组织流程——代理路由、知识分发、系统改进、成本优化和 Token 支出的 ROI 归因,这些都需要与公司组织结构深度匹配。作者曾为 10 到 500 人规模的团队部署此类系统,认为软件工厂会成为关键基础设施,应由企业自持,因此选择开源以让团队专注于组织层面的问题。
文章从马尔可夫毯与自由能原理出发,探讨新一代大模型(如GPT-6 Astra)的演进方向。作者认为,模型能力提升的关键在于与环境交互:通过观察、行动和反馈形成闭环,主动推断并选择信息量最大的行动。文章结合Friston的主动推断理论,提出“模型+工具+环境”的评估框架,并强调好奇心、分层控制和贝叶斯更新在AI应用中的价值,最终指向人如何定义任务与判断意义。
文章以微博VibeLab AI创意赛(2500多件作品)为切入点,分析了Vibe Coding兴起的五大原因:一是AI Agent大幅降低了编程门槛,写代码从专业技能变成语言表达能力;二是传统软件无法满足个性化长尾需求,现在普通人可以自己动手实现;三是开发链条缩短,从想法到交付只需几步,甚至无需界面产品,一个脚本或Agent Skill即可;四是模型能力持续升级,从Copilot补全到Claude Code自主探索再到操作电脑;五是做工具心态变化,从宏大目标转向解决具体痛点。最后作者给出实用建议:从写Agent Skill起步,分步骤做原型、MVP再迭代,注意验收与安全,并把作品发布出来获得反馈。
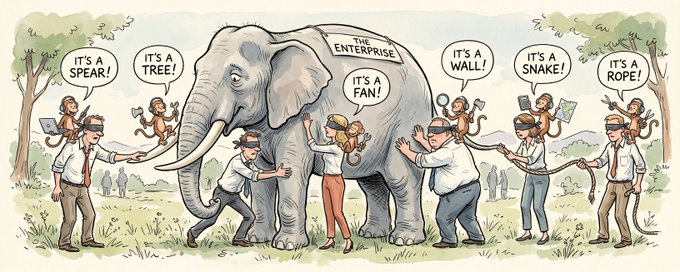
作者借“盲人摸象”寓言剖析个人 AI Agent(BYOA,自带智能体)进入企业后的系统性风险。个人代理凭私钥托管、私有记忆、授权代表和静默执行四大特性在个人任务中表现出色,但在企业中因缺乏共享的组织记忆和集中协调,会引发信息陈旧导致的错误承诺、针对 Agent 的提示注入欺诈、客户沟通混乱、机密泄露以及智能体间操作冲突等问题。作者指出这不是模型能力问题,而是缺少治理型组织记忆,企业需要单一共享的现实来协调各方 Agent 的行动。
本文整理了 SpaceXAI 官方发布的非工程师使用 Grok Bot 的最佳实践案例。作者发现官方数据显示非技术岗位是 Grok Bot 最重的使用群体,因此调研了招聘、销售、市场、财务、设计五大职能的具体用法:招聘用 Talent Scout Bot 自动搜寻和评估候选人;销售团队以幕僚长 Bot 总控,一人带一队 Bot 覆盖会议准备、拓客、客户跟进全流程;市场用 Bot 自动把研讨会线索分发给对应销售;财务的 Haggle Bot 通过席位审计和供应商比价一周省下超十万美元;设计师用四个协作 Bot 高效完成 Figma 设计和动效原型。文章强调 AI 可自动化流程,但关键决策和审批权应保留在人类手中。
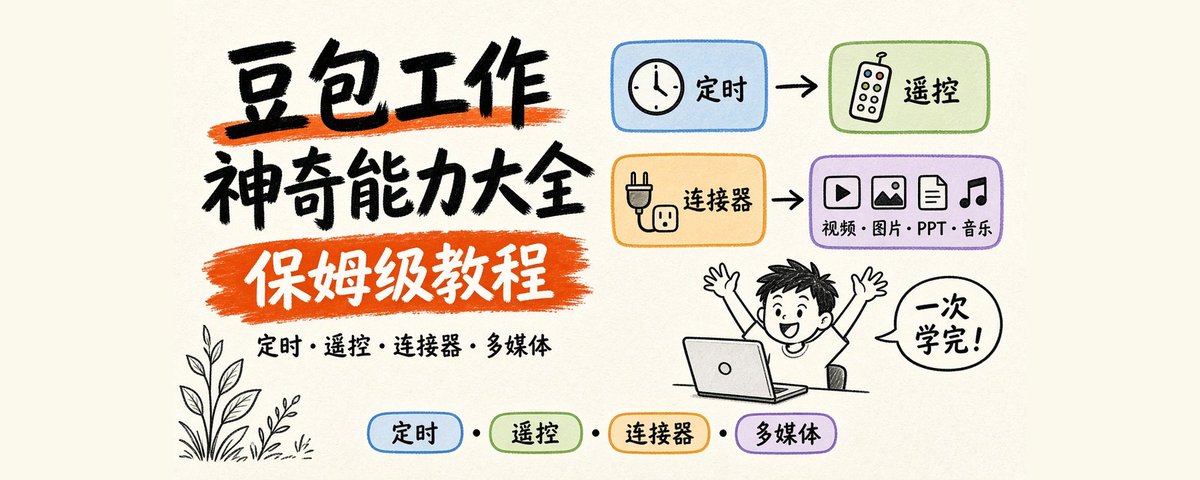
本文是一篇豆包桌面端的保姆级教程,详细介绍了豆包从聊天AI进化为AI Agent后的各项功能。包括安装登录、左侧导航的7个主入口(新工作任务、新对话、定时任务、技能·连接器·伙伴、手机遥控电脑、云盘、更多)、底部对话模式(对话、视频生成、帮我写作、图像生成、PPT生成、解题算题、音乐生成、更多)、工作任务模式(+号、工作任务、项目、按需确认、技能、连接器、模型与推理强度)以及免费与付费方案。文章还分享了使用技巧和避坑指南,帮助打工人充分利用豆包提升工作效率。
作者与两位数千Star开源项目作者对谈,分享开源实战经验:从自身痛点出发找需求、零预算冷启动、算清开源回报账本。开源带来信任凭证、成就感和职业选择权,而非直接经济回报。作者也分享技术人做社交媒体的心得,强调Learn in Public、立即行动、经营个人账号的长期复利,以及AI Agent开发与效能实践。
本文介绍如何利用 OpenAI 于 2026 年 9 月发布的 GPT-6 Astra 构建 24/7 自动发现盈利交易策略的 AI Agent,将过去量化对冲基金(如文艺复兴科技)需数百万美元搭建的策略发现流水线成本降至每月约 300 美元。文章详解四大市场错误定价来源:统计套利(Ornstein-Uhlenbeck 均值回归)、波动率曲面错配(Heston 模型)、因子分解异常(Fama-French 五因子残差 alpha)与内部人信号检测(集群买入 Cluster Score)。作者为后端开发者 Roan,专注系统设计、高频执行与量化交易系统。
本文详细介绍如何用 xAI 推出的 Grok Bot(配有云端电脑的 AI Agent)搭建一支自媒体内容团队。作者配置了五个角色:情报侦察员、选题策划师、内容主笔、事实编辑和数据复盘师,形成从信息收集到发布复盘的完整内容流水线。文章涵盖 Grok Bot 与 Codex、Claude Code 的区别、权限边界设置、共享目录结构搭建,以及每个 Bot 的完整提示词配置。作者强调保留人工确认环节:发布、点赞、私信等敏感操作必须人工执行,并给出了关掉本地电脑执行、写入禁止项等安全建议。
文章从人类进化史切入,借助赫拉利《人类简史》《智人之上》的观点,指出智人依靠语言构建想象共同体而胜出。作者认为AI与蒸汽机等以往技术革命截然不同,它进入语言、判断与决策领域,成为信息网络中的主动节点。文章提出两大反常识观点:AI无需意识即可深刻改变文明;真正的威胁不是失业,而是人类对复杂系统决策权的垄断逐渐外包。作者分析了AI在复制、永生、并行存在等方面突破生物边界的特征,并讨论人类与AI共存的三种路径,最终警示:改变历史走向的往往不是技术本身,而是谁拥有这项技术。
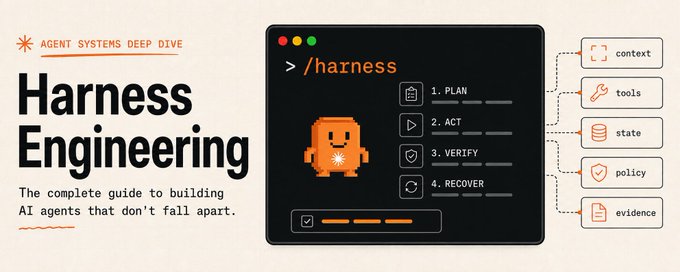
文章指出许多 Agent 失败并非模型推理问题,而是环境(Harness)设计缺陷。作者系统阐述了 Harness Engineering 这一工程学科:将模糊请求转化为包含目标、范围、约束、验收标准和审批要求的任务契约;通过渐进式披露提供项目地图而非信息轰炸;构建带校验和风险控制的工具网关而非工具堆砌;分离大脑(推理)、双手(执行)和历史(状态)三大职责;将对话历史转化为包含事实、决策、进度和教训的持久化状态,从而将模型智能转化为可靠的工作成果。
本文是 Nick Spisak 的 13 节课教程指南,讲解如何为企业搭建'第二大脑'(second brain)知识库,并结合 AI Agent 使用。作者以自己的公司 Capstone Brands 为例,完整展示了从选择业务问题、创建 GitHub 组织与仓库、用 GitHub Desktop 克隆本地副本、在 Codex 中使用知识库模板发起构建请求,到按销售、营销、情报、财务、运营五大业务职能组织知识的全过程。最终目标是让 Slack 中的 Agent 能阅读公司知识库、回答真实业务问题并引用来源文件。教程还涵盖版本历史管理、访问权限控制、标准操作流程转化为 Agent Skill 等实践要点。
作者分享了一套通过 AI Agent 自动化个人生活的实用方案。文章提供了一份可直接复制使用的 Markdown 提示词,角色为「AI Agent 架构师」,用于对用户的生活和工作做全面审计与访谈。核心原则是最小化有用的 Agent 编制(通常 1-3 个即可),遵循从手动任务到一次性 AI 任务、技能、例行程序、命名专家 Agent、多 Agent 协作再到定时自动化的渐进升级层级。文章详细给出工作流决策漏斗、Agent 拆分测试的六个维度(所有权、上下文、工具、工作风格、审批边界、触发节奏)、Agent ROI 评估方法,以及 Grok Bot 与 Hermes 两个运行时平台的选型指导。
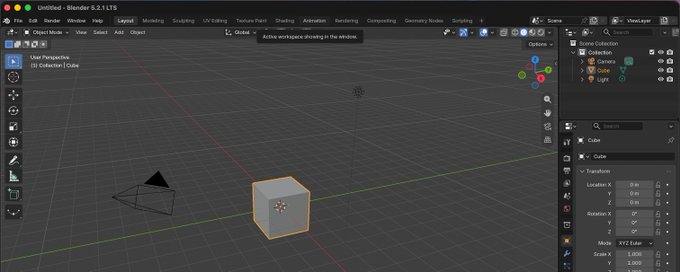
作者亲测 GPT-6 Astra 操控专业软件(Blender、Audacity),指出 AI 是放大器而非许愿池:它能跨越操作门槛,却无法补上领域知识与审美判断。Blender 建模测试中因缺乏建模知识反复翻车,只能给出'不好看'的模糊反馈;Audacity 测试则展现了 Astra 惊人的跨工具调度能力。文章还探讨了 AI 操作留下的中间产物可能成为新的原创证明,并分析 Astra 常停在'下一步'不执行的行为差异,认为门槛没有消失,只是往里挪了一层。
SpaceXAI 工程师分享如何用 Grok Bot 打造 AI 工程团队:将 Grok Bot 视为能管理编码 agent 的“工程实习生”,通过五个各司其职的工程师 Bot 负责移动端、桌面端、基础设施等领域,配合运营 Bot Jenny 处理 onboarding 与复盘。核心方法包括共享 Notion 数据库突破上下文限制、夜间自动代码审计、P0 紧急流程等,实现同时管理 200+ cloud agent。作者总结了给 agent 完整反馈闭环、减少重复工作、让 Bot 互相编排等实践建议。
作者 Jackywine 基于六年重度使用经验,全面分享 Obsidian 知识管理体系的万字长文。文章回顾了自己从疯狂装 47 个插件、反复删库重建的「工具崇拜」弯路,到形成成熟使用方法的历程;汇总并点评了多篇入门教程与论坛精华;介绍了 Obsidian 的创始人故事、本地 Markdown 数据持久性理念、双链优先于分类的核心思想、2500+ 插件生态,以及与 Notion、Logseq、Roam 的对比;最后结合 Karpathy 用 LLM 构建知识库的实践,探讨了 AI Agent 时代 LLM-Wiki 的知识管理新范式。
本文是一篇通俗易懂的 AI Agent 入门到进阶教程,讲解了 Agent 的核心原理与工程实践。作者用公式'Agent = 模型 + 目标 + 工具 + 记忆 + 运行循环 + 安全边界'拆解 Agent 构成,对比聊天机器人、自动化流程与 Agent 的差异。文章详细介绍三种经典模式(ReAct、Plan-and-Solve、Reflection)、工具设计的六条硬规则、提示词注入攻击防范、记忆/RAG/上下文工程的区别与用法,以及工作流、低代码、框架、自研四条实现路线的选择建议,并涉及 MCP、多智能体和 A2A 等概念。
文章指出 Agent 最危险的失败不是报错,而是做错了却显示"已完成"。作者以一个资料研究 Agent 为例,搭建了一套最小可用的 Agent 评测框架,回答三个问题:任务有没有做成、失败发生在哪里、新版本能否发布。核心方法包括:先明确评测要回答的发布决策;把"做完"写成可检查的完成条件和 Hard Failure;建立 30 条起步的分层评测数据集(dev/holdout/regression/challenge);将 Outcome 与 Trajectory 分开评估;采用 Rules + LLM Judge + Human 三层打分体系。最终通过重复运行对比 v1/v2、设置发布门禁、把线上失败送回评测集,形成完整评测闭环。
文章指出传统确定性单元测试无法覆盖 AI Agent 的多轮、非确定性行为,提出将评估视为可自动化、可度量的 CI/CD 测试套件。作者给出 6 种生产级 Eval 实践:1)先做确定性 schema 检查(JSON 有效性、工具调用参数);2)用 Check Grounding API 等数学化度量事实依据,低于阈值即拒绝输出;3)检查多轮工具调用轨迹的依赖顺序并惩罚循环调用;4)构建带严格评分标准、输出推理过程的 AutoRater 评审模型;5)用 AutoSxS 成对对决和胜率数据安全替换模型;6)在 CI 中建立黄金回归数据集作为硬门禁。文中提到 Firebase 团队借此将复杂多步任务通过率从 31.7% 提升至 78.0%。
本文介绍 Palantir 架构核心的 Ontology 系统,强调其关注的不是孤立数据,而是企业中复杂关联的决策。Ontology 通过数据、逻辑、行动和安全四重整合来表达决策,将 ERP、CRM、传感器等多源数据统一为对象、属性和链接,并结合行动逻辑支持实时写回运营系统。文章以医疗制造企业为例说明多团队权限与 AI 智能体安全继承机制,并将 Ontology 概念上分为语言、引擎和工具链三层,支持把 Ontology 当作后端构建 AI 应用,最终形成可持续吸收反馈、支持人机协作的运营决策底座。
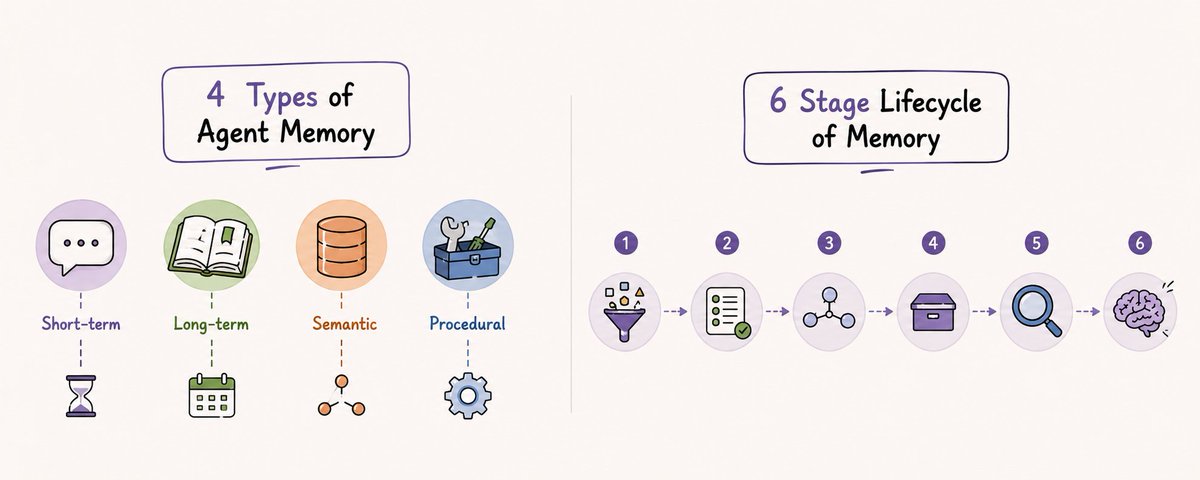
本文是 Agent 记忆系列第二篇,基于普林斯顿的 CoALA 认知架构框架,将 Agent 记忆分为四种类型:工作记忆(当前上下文)、语义记忆(事实性知识)、情景记忆(带时间戳的具体事件)和程序性记忆(Agent 自行从重复经验中学到的规则)。作者强调仅靠厂商记忆功能只覆盖语义记忆的一小部分,完整的生产级 Agent 还需理解记忆的六阶段生命周期:提取、存储、检索、注入、更新与遗忘。文章为后续动手构建带记忆的 Agent 系统奠定概念基础。
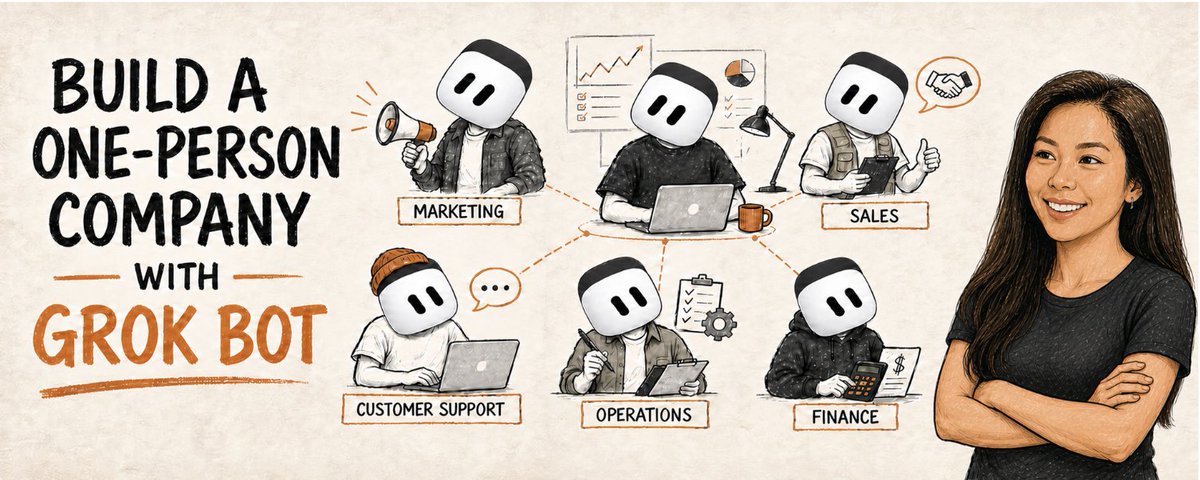
作者分享如何用 Grok Bot 搭建一人公司的完整指南。她将自己获得 4100 万次浏览的营销系统(基于 7 个 Claude Skills)迁移到 Grok Bot 中,组建了 4 个专职 Bot 组成的 AI 营销团队。文章强调:不要构建一个通用 Bot,而应让每个 Bot 只做一件事,共享云端电脑,相互传递工作。作者给出选择第一个自动化任务的 5 条标准(周期性、稳定、多步骤、可逆、可衡量),并提供了首席幕僚、营销、销售、客服、运营、财务等功能的组织架构表,指出关键是在关键操作上设置审批边界,让自己从瓶颈变成决策者。
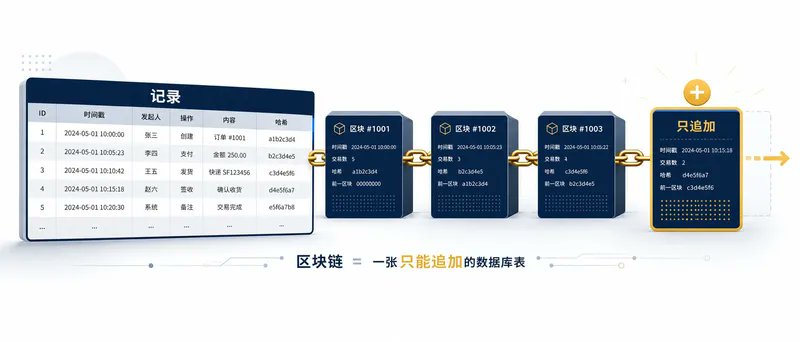
文章面向有编程经验的开发者,用数据库的类比讲透区块链核心概念:链是一个只能追加、不可篡改的数据库;钱包只是存密钥的容器,资产记录在链上账本中;转账是带签名的写请求,Gas 是写入计价与排队机制;智能合约是部署上链的公开代码。作者总结了链与普通数据库的四大区别:写入付费、不可回滚、代码即规则、没有管理员。最后以 OKX 开源的 MCP 工具为例,介绍如何让 AI Agent 安全接入交易所 API,并给出从查行情到模拟盘的上手路径。
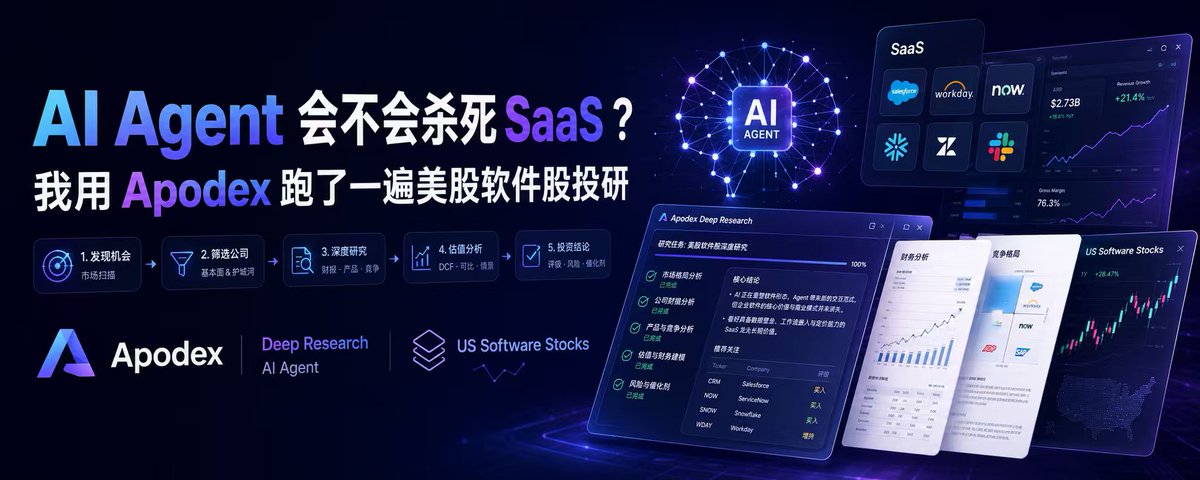
作者针对'AI Agent会不会杀死SaaS'这一争议问题,使用Apodex投研工具进行了系统分析。Apodex先拆解任务,研究Salesforce、ServiceNow、Workday等公司,分析seat-based模式、AI收入及Agent与SaaS的关系。核心结论是:Agent绕过的是人机界面,但依赖数据、权限、工作流和system of record。AI Agent会压缩浅层SaaS的席位和界面定价权,但增强掌握企业数据轨道的平台。AI收入是真实增量但尚未完全验证。短期是AI增强SaaS确认期,中期转向seat+usage+workflow混合模式,长期SaaS将演变为'轨道+Agent市场'。
文章探讨了构建软件工厂时最困难的问题之一:如何将人类语言描述的大型目标拆解为代理可执行的具体工作。作者梳理了五种逐步演进的方法:直接委派子代理(如 Claude Code、Codex)、可追踪任务系统(如 Gemini CLI、OpenAI Symphony)、工厂形态的工作结构(如 Warp)、结果关联的工作(如 Factory 的 Missions),以及动态工作图。作者指出,随着代理日益自主,系统本身需要围绕模型构建自己的智能来塑形、追踪和修正工作,这是软件工厂区别于普通代理框架的关键,也是当今 AI 领域最有趣创新的方向。