从0到1带你速通WorkBuddy
本文是一篇WorkBuddy的从0到1新手教程。文章指出WorkBuddy是国内口碑不错的通用Agent产品,相比Claude Code和Codex更对国内用户友好。内容涵盖安装登录、界面模式介绍(Ask/Plan/Craft)、专家与技能市场、腾讯生态连接及个性化配置,并演示了日常办公报告生成和网页开发两个实战案例。
本文是一篇WorkBuddy的从0到1新手教程。文章指出WorkBuddy是国内口碑不错的通用Agent产品,相比Claude Code和Codex更对国内用户友好。内容涵盖安装登录、界面模式介绍(Ask/Plan/Craft)、专家与技能市场、腾讯生态连接及个性化配置,并演示了日常办公报告生成和网页开发两个实战案例。
Anthropic 正式发布了 Claude Fable 5 模型,该模型是此前仅限合作伙伴使用的“神话级”网络安全模型 Mythos 的公开版本,新增了安全分类器。文章详细介绍了 Fable 5 的技术定位、昂贵的 API 定价(显著高于 DeepSeek V4 和 GPT 5.5)、以及在代码生成、视觉游戏通关(如宝可梦、异星工厂)、生命科学(蛋白质设计)等方面展现出的惊人能力。作者在亲测后,对其“究极水桶”般的智能水平表示震撼,同时也因昂贵的费用和 AI 进步速度超越人类认知而产生的虚无感进行了深度思考。
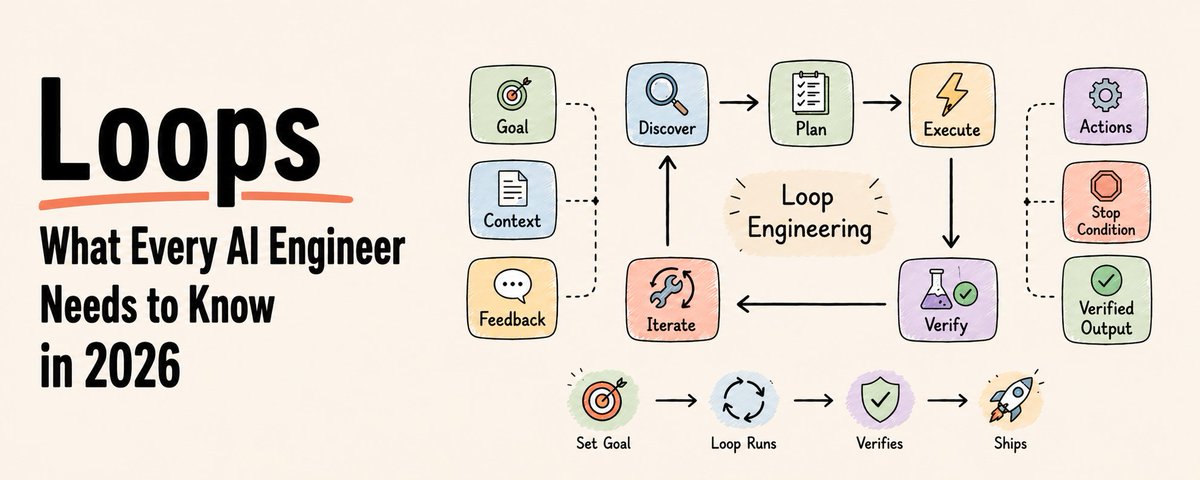
文章探讨了2026年AI工程范式的转变:从单纯的“提示词工程”转向设计自动化的“循环系统”。OpenAI与Anthropic的专家指出,工程师的角色已变为编写控制Agent的循环。文章深入解析了循环工程的定义、单体Agent与编队模式的区别,以及开放式与封闭式循环的差异。此外,文章重点讨论了循环模式带来的高昂Token成本问题,指出DeepSeek等低成本、大上下文的中国大模型是解决这一经济瓶颈的关键。
文章记录了一次关于12个顶级AI模型的高考模拟测评。测试选取了Claude、GPT-5.5、DeepSeek等国内外主流模型,针对高考语文和数学试卷进行考核,并邀请真人老师进行盲审阅卷。结果显示,头部模型之间的分差极小,部分模型存在“偏科”现象(如DeepSeek数学强但作文弱)。文章详细回顾了测试的公平性设计、评分过程及最终排名,并回顾了过去几年AI模型在考试能力上的巨大进步。
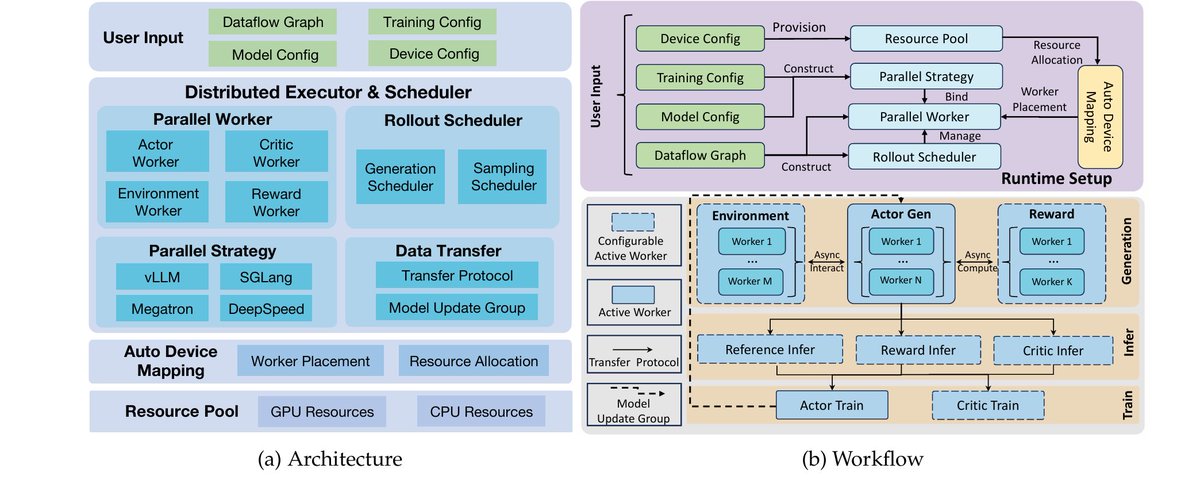
本文汇总了35道2026年强化学习(RL)领域的面试核心问题。内容涵盖算法与基础设施两大方向,既包括PPO、GRPO等训练机制的原理探讨,也涉及分布式推理、显存优化等工程落地细节。作者强调现代RL岗位需要具备全栈理解能力,建议面试者不仅要熟记问题,更需深究背后的技术逻辑。
文章探讨了现有 Agent 记忆方案的局限性,即仅是“搜旧聊天”而非真正的学习。作者介绍了 MemOS Local Plugin,它通过 Reflect2Evolve 机制,从对话中自动提炼策略和技能。实测显示,它能跨 Session 应用写作偏好并积累经验,代表了从“存规则”到“学策略”的进步。
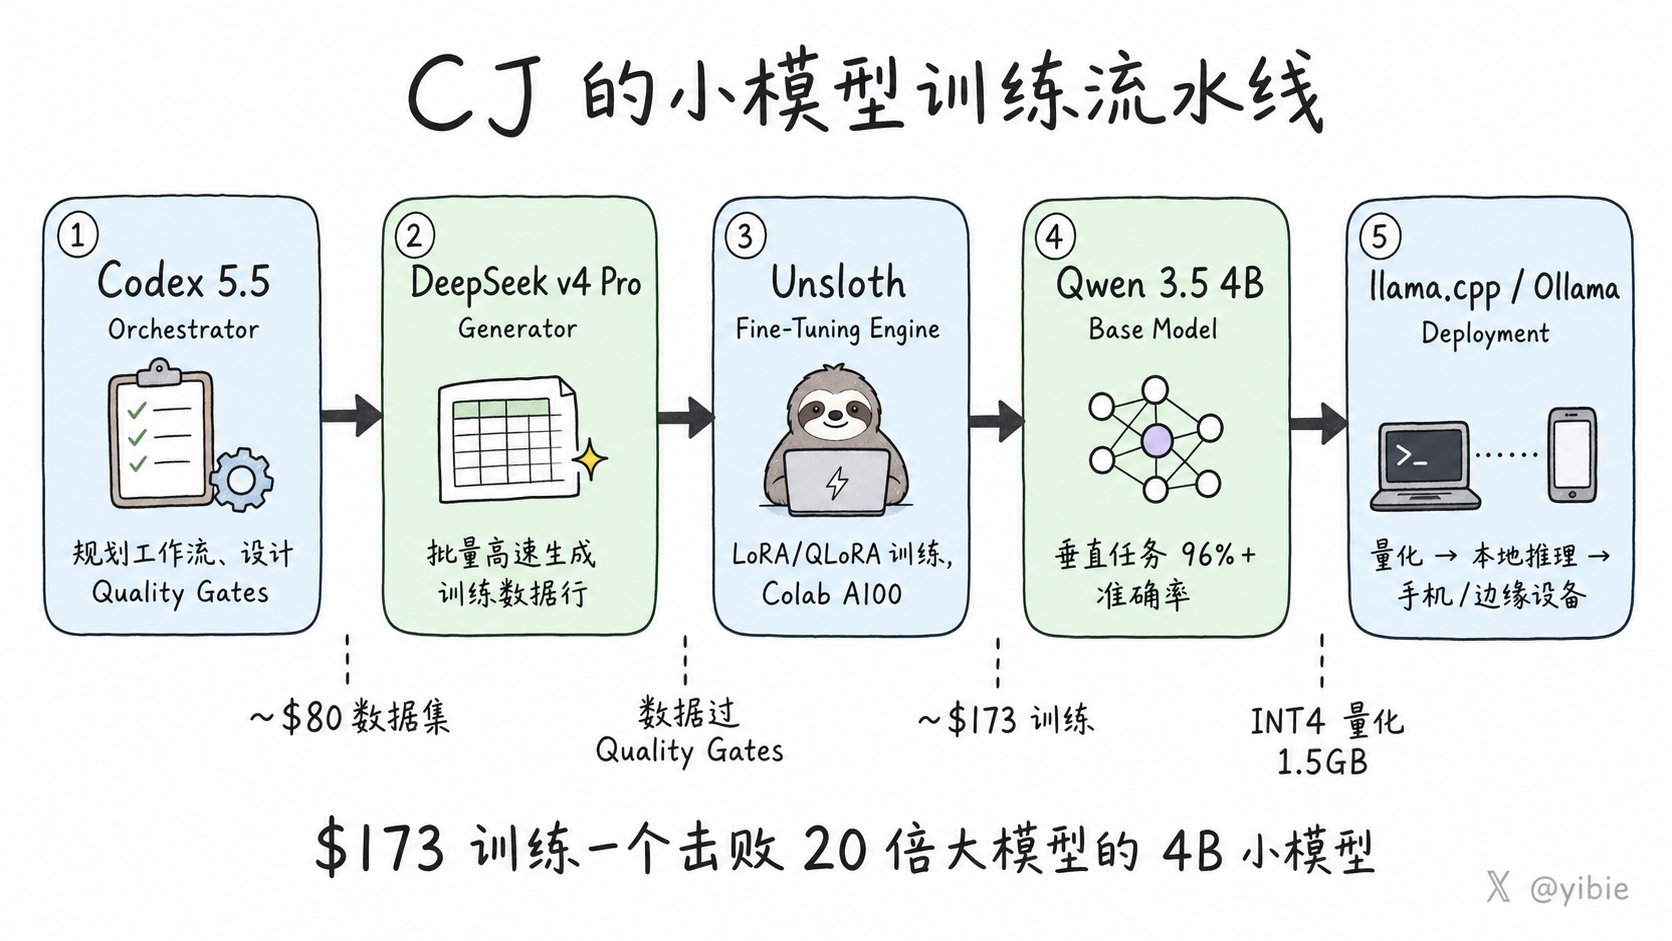
本文探讨了 2026 年 AI 领域的边缘趋势:个人开发者训练小模型(SLM)。文章详细介绍了 CJ Zafir 的方法论,即利用 Codex 和 DeepSeek 生成数据、Unsloth 进行训练、Qwen 作为基座,以极低成本(最低 11 美元)在垂直任务上超越大模型。文章指出,真正的护城河在于高质量数据集的生成工厂,而随着硬件门槛降低和工具成熟,模型微调正从企业军备竞赛转向个人技能。
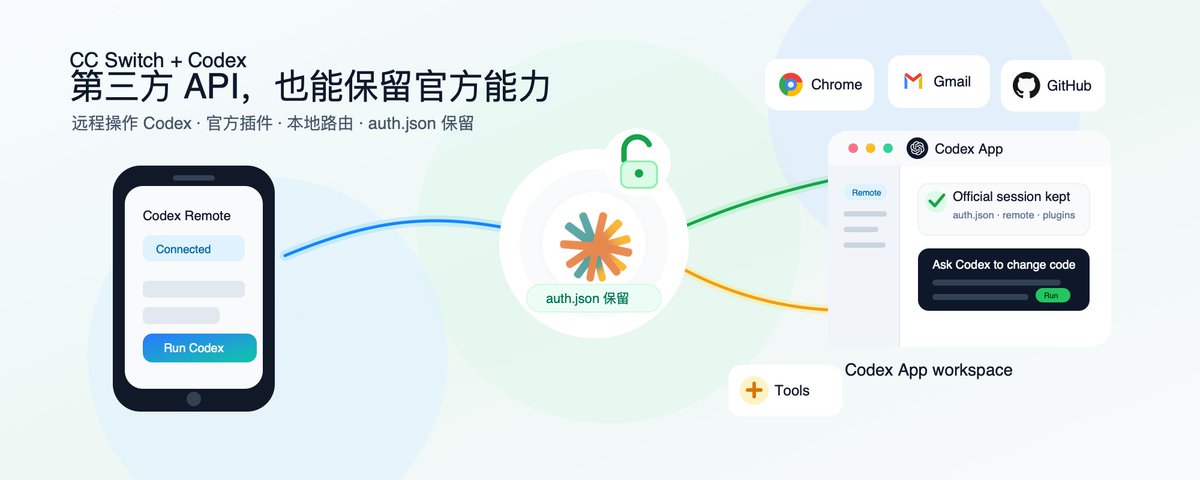
本文介绍了 CC Switch v3.16.1 版本新增的“Codex 应用增强”功能。该功能通过将第三方 API 信息写入 config.toml 而非覆盖 auth.json,解决了用户在使用 DeepSeek 等第三方模型时,无法保留 Codex 官方远程操作和插件能力的痛点。文章详细讲解了开启本地路由、配置 DeepSeek 等供应商的具体步骤及原理。
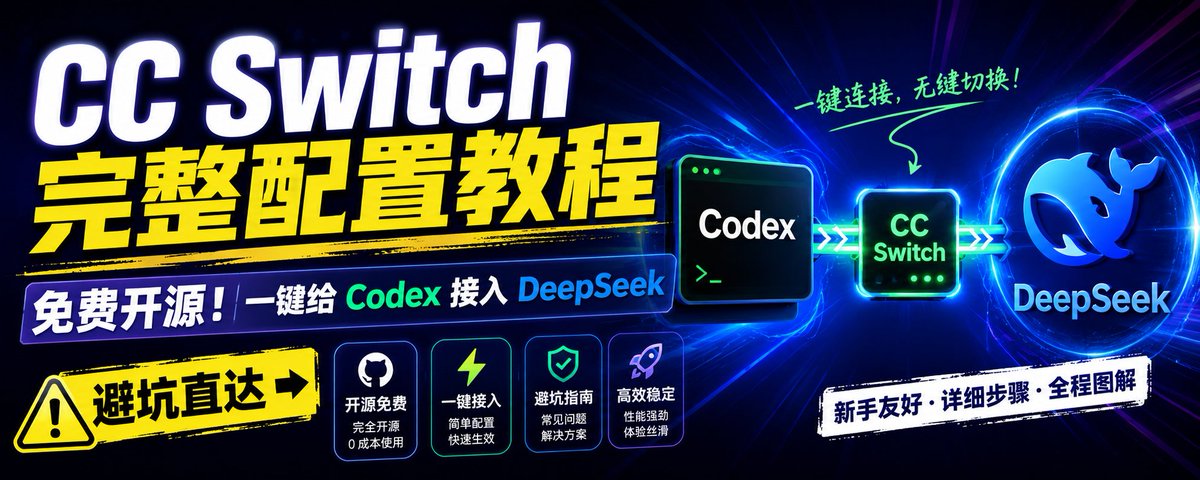
本教程详细介绍了如何使用开源工具 CC Switch 将 DeepSeek 接入 Codex 或 Cursor。文章包含两步配置指南:开启本地路由以支持 DeepSeek 的特殊接口格式,以及填入官方或第三方 API Key。文中特别强调了重启客户端的必要性,以实现模型的后端替换。
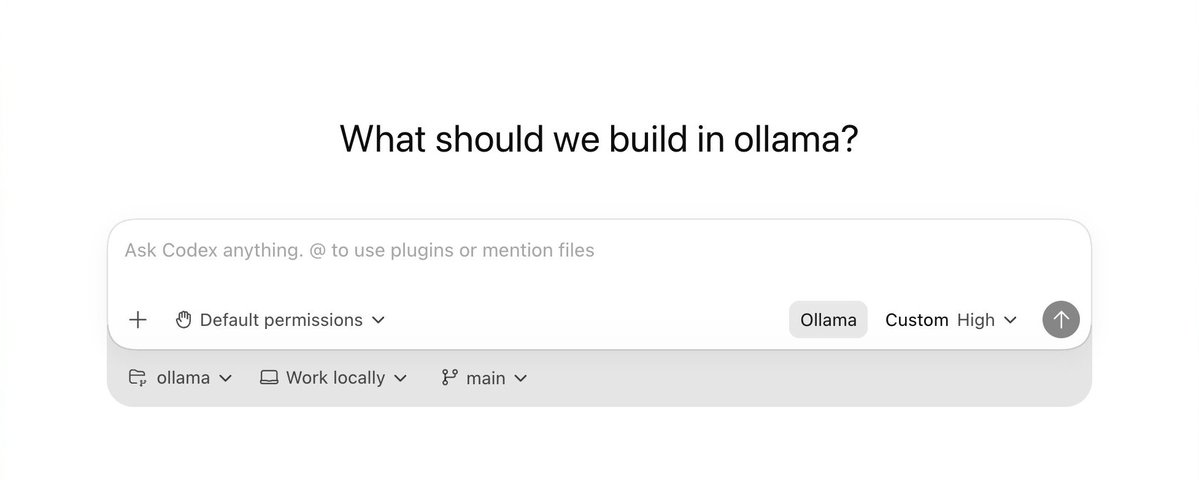
文章介绍了如何利用 Ollama v0.24+ 在本地免费运行 OpenAI Codex。通过集成 Gemma 4、Qwen 3.6 等开源模型,用户可以实现零成本、无限制且隐私安全的代码编写体验。文中详细讲解了 Codex Desktop App 和 CLI 的配置方法,并推荐了适配不同硬件的模型。
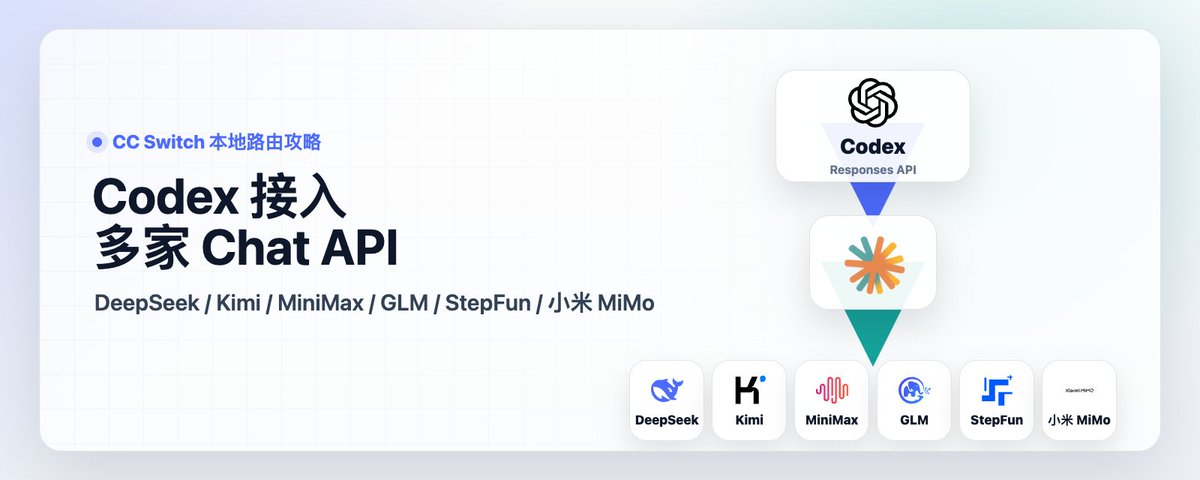
本文介绍了如何使用 CC Switch 本地路由将 DeepSeek 等兼容 OpenAI Chat Completions 协议的 API 接入 Codex CLI。文章详细解释了本地路由的原理,即将 Codex 的 Responses API 请求转换为 Chat Completions 请求并转发,同时提供了添加 DeepSeek 供应商、开启路由及排查 404 等常见问题的具体操作步骤。
文章介绍了 OpenCodex 项目,这是一个旨在为 Codex Desktop 解锁第三方 API 能力的本地网关工具。它具有零配置启动、Web 控制面板管理、低延迟 CU 引擎截图压缩等特性,并支持非多模态模型流畅运行 Computer Use。此外,该工具不影响 Codex 原生的手机远程功能。
文章为独立开发者提供了一套低成本(年费低于500元)的全栈技术方案。涵盖了从域名注册、前后端部署、数据库选型、AI接口集成、邮件发送、CDN图片处理到监控日志及支付接入的各个环节。作者推荐利用 Cloudflare、Vercel、Supabase、DeepSeek 等有免费额度的大厂服务,强调了“先做单点突破”和“节省时间成本”的重要性,帮助开发者以最小成本跑通业务闭环。
作者Gorden Sun发布了一款名为GordenPPT的Skill,支持一句话生成复杂、豪华且可编辑的PPT。该工具兼容DeepSeek、Claude、GPT等多种模型,具备自动更新机制,提供丰富的商务风格模板,非常适合国企及互联网大厂的高效办公需求。
这是一份关于如何利用 Hermes 的 Profile 机制构建多智能体协作群聊的实操教程。文章详细介绍了配置 1 个主 Agent(Leader)和 3 个辅助 Agent(数据、技术、市场研究员)的完整流程。内容涵盖了 Profile 创建、共享 API 密钥配置、角色 Prompt 编写、Discord 机器人对接以及发言顺序控制与成本优化策略。
文章作者分享了12条经过验证的AI变现路径,强调AI变现的核心在于重写“赚钱流程”而非单纯玩工具。内容涵盖网文创作、AI短剧、小红书视觉号、表情包、POD按需打印、图库资产、Agent解决方案、视频二创、知识付费、本地生活服务、音频内容以及微型SaaS工具。作者指出AI是能力的放大器,真正的盈利点在于人机耦合的工作流。
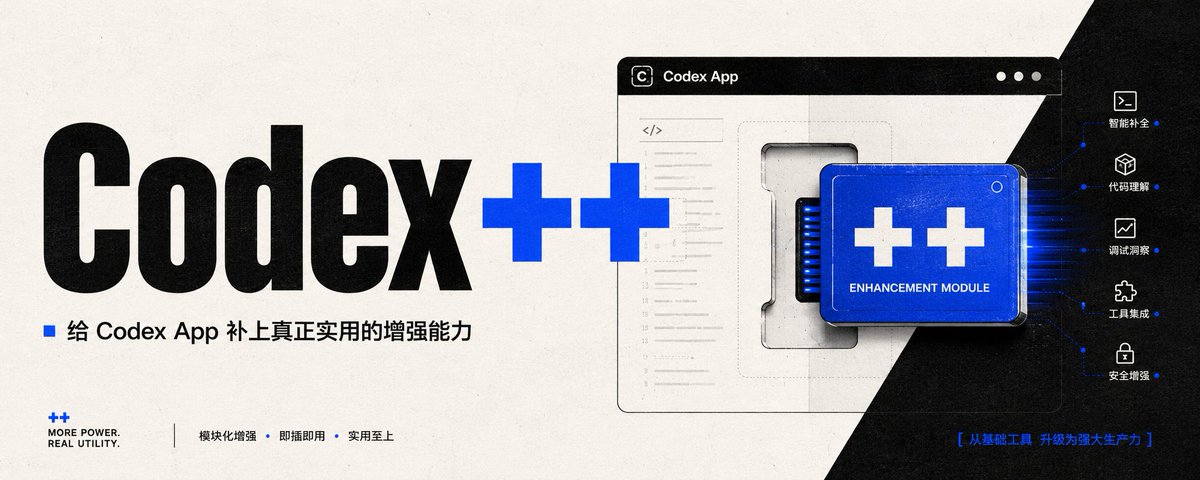
文章介绍了一款名为 Codex++ 的增强工具,旨在解决 Codex App 原生版在插件锁定、会话管理及 API 接入(如 DeepSeek)方面的痛点。它通过外部启动和 CDP 注入实现功能解锁、会话删除、Markdown 导出及中转注入,提供完整的生态补丁层,提升开发效率。
文章详细记录了将阶跃星辰(Step)等国产大模型 API 接入 Codex App 的全过程与测试结果。作者验证了在 API 模式下,Codex 的手机调用、锁屏截图、浏览器自动化及电脑控制等核心功能依然可用。同时,文章对比了不同模型的性价比,探讨了 API 模式在记忆管理和多设备联动上的局限性,并分享了 Codex 在自动化、长期目标设定及与其他 Agent 工具协作中的最佳实践。
文章介绍了 OpenAI 工程师 Jason Liu 分享的 9 条 Codex 高效工作法,包括持久线程、共享记忆、语音输入、实时纠偏、操作电脑浏览器等。这些方法将 Agent 从单纯的聊天工具转变为能记住上下文、主动执行任务并操作真实应用的长期资产。作者指出,这套通用的 Agent 逻辑不仅适用于 Codex,通过 OpenCode、Playwright 等工具,在 DeepSeek 环境下也能完美复现。
本文深入分析了 DeepSeek 如何通过 MLA、MoE、mHC 等一系列底层技术创新,极大幅度降低大模型对 HBM(高带宽内存)和先进 GPU 制程的依赖。文章指出,DeepSeek 的战略并非局限于软件订阅,而是旨在通过算法优化盘活中国产能充足的 NAND 闪存和 LPDDR 产业,以此构建一套独立于西方之外的 AI 硬件生态,最终撬动价值 10 万亿美元的产业巨兽。
文章深入解析了 pi-goal 这一长程目标自动循环工具的源码机制,并设计了高难度的 Karpathy 开源项目洞察任务,对 Gemini、Claude 和 DeepSeek 三款模型进行了同台实测。结果表明,DeepSeek V4 Pro 在成本上仅是 Gemini 的 1/31,质量却更优。文章还发现过度推理会增加幻觉,以及软预算机制可作为模型行为探针,并指出了 pi-goal 在审计验证上的盲区。
文章介绍了一种利用AI生成寓言故事来理解和学习抽象概念的方法。作者基于Anthropic专家Amanda Askell的思路,优化了一套Prompt,通过让AI编写不带术语的“暗语”故事,帮助读者直观掌握陌生化等复杂概念的本质。该方法不仅提升了学习乐趣,还通过隐喻加深记忆,适用于Claude、GPT等多种大模型,被视为一种回归人性的高效学习路径。
作者 0xJeff 介绍了 Hermes Agent 与 xAI 的最新集成,通过 x_search 工具实现了对 X (Twitter) 平台的实时原生搜索。文章详细分享了作者如何利用这一功能优化投资分析工作流,包括书签定时任务、六阶段深度研究管道以及 KOL 追踪流程。作者对比了 Grok 4.3 与 DeepSeek 在 Agent 任务中的表现,并推荐结合 x_search 与 Cookie 工具以获取高质量的结构化数据与实时洞察。
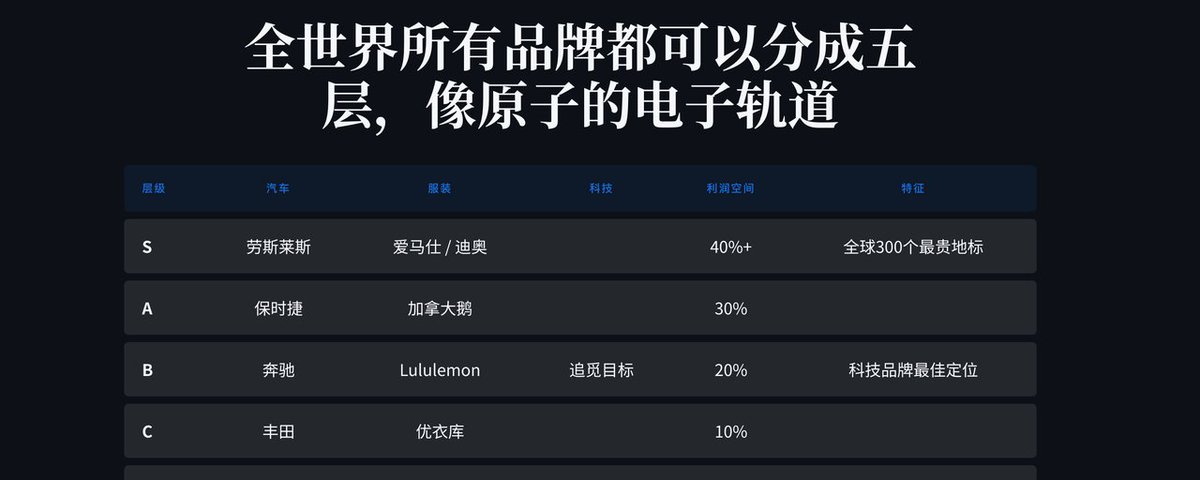
文章探讨了生成式引擎优化(GEO)的重要性。随着 AI 搜索成为用户采购决策的首选入口,品牌若不被 AI 推荐将面临巨大流量损失。文章详细对比了国内外主流 AI(如豆包、文心、ChatGPT)的内容抓取机制与引用偏好,指出国内存在“围墙花园”现象,并提供了针对性的内容优化策略与效果监测方法。
作者推出了名为 Violin 的开源视频翻译技能。该工具结合了语音识别(ASR)、LLM 翻译和语音合成(TTS)技术,旨在打破高质量视频内容的语言壁垒。Violin 支持个性化翻译、多语言处理及与视频互动,提供 Web、CLI 和代理技能等多种使用方式,并已在 MIT 协议下完全开源。
本文详细介绍了如何利用 AI(DeepSeek 和 GPT)辅助创作短篇小说并实现变现的完整流程。文章涵盖爽文底层逻辑、实操步骤、工具配合策略以及平台投稿注意事项,指出通过 AI 负责初稿、人工负责润色的模式,普通人在 1-2 周内即可完成一篇短篇并获得稿费。
作者开源了一款名为 'note-slides' 的 Skill,旨在将长文(PDF、链接等)转换为结构化的幻灯片。该工具模拟资深用户视角,提炼关键思考与洞见,形成总览、展开和总结三部分内容。作者认为 AI 幻灯片提供了“地图视角”,弥补了线性阅读后记忆模糊的短板。目前该工具已针对 DeepSeek V4 模型进行优化,在 Claude Code 中运行成本极低,适合用于长文的快速信息筛选与复习复盘。
本文详细介绍了字节旗下 AI Agent 工具 TRAE SOLO 移动端的发布与使用方法。该工具实现了 App、Web 和桌面端的三端互通,无需邀请码即可使用。文章重点展示了移动端的配置流程,以及如何通过安装 Skill、接入飞书、配置第三方模型等方式,实现数据分析、信息整理、自动化任务和学习辅助等多种场景,将 AI Agent 的使用场景从桌面扩展到了口袋。
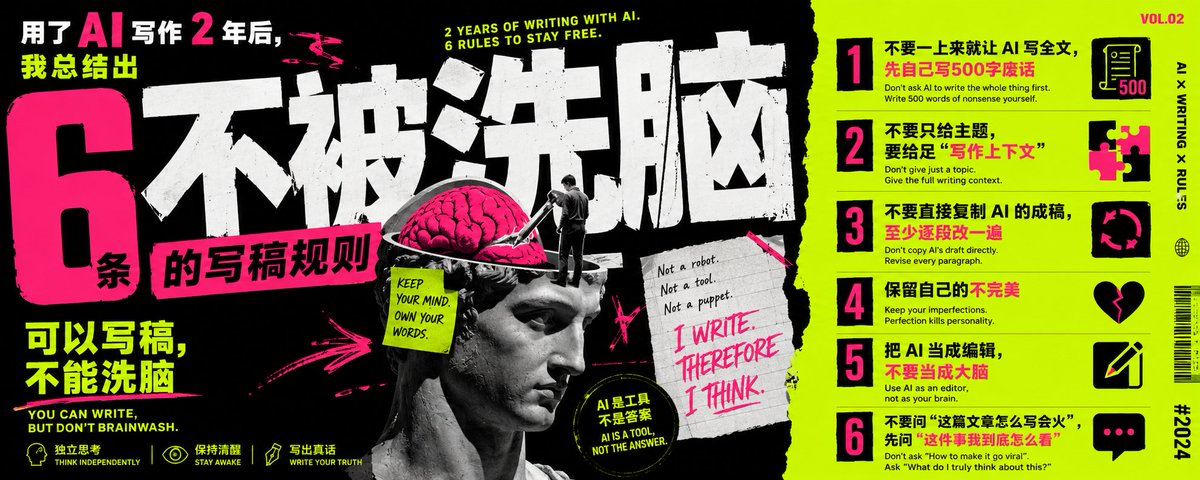
作者分享了自己使用 AI 写作两年的心路历程,从初期的抗拒到中期的依赖,再到警醒后重新掌握主动权。文章指出 AI 虽能优化表达,但无法替代个人经历与思考,容易让人产出“高级的空话”。为此,作者总结出 6 条规则,核心在于坚持先写草稿、提供充足上下文、保留个人瑕疵,并将 AI 视为编辑而非大脑,强调在 AI 时代保持自我表达和真实内容资产的重要性。
作者正式开放了其内部开发的AI热点监控网站“AIHOT”,旨在通过精选信源和智能评分策略解决AI时代的信息过载问题。文章详细介绍了产品的信源分级、多维度评分机制(迭代了11版)以及利用代码而非AI主导的架构设计思路。该工具能对海量信息进行降噪、聚类和精选,提供AI日报等功能,以保护用户的注意力。