为什么服务型企业将赢得下一个十年
作者认为AI正在模糊软件与服务业的边界:软件变得越来越像服务(产品主动适配用户),而服务业借助AI代理实现产品化,形成'产品化服务'的混合模式。这类业务对外像服务(客户获得定制化结果),内部却像产品一样高效运转,既保留服务关系又获得软件级利润率。作者以自己21岁创办的Hourglass AI为例(自筹资金、持续盈利、单月收入破10万美元),认为这是年轻人低风险创业的最佳路径:从第一天就盈利、无需融资、拥有全部股权,并建议先亲自交付服务,再用AI代理规模化。
作者认为AI正在模糊软件与服务业的边界:软件变得越来越像服务(产品主动适配用户),而服务业借助AI代理实现产品化,形成'产品化服务'的混合模式。这类业务对外像服务(客户获得定制化结果),内部却像产品一样高效运转,既保留服务关系又获得软件级利润率。作者以自己21岁创办的Hourglass AI为例(自筹资金、持续盈利、单月收入破10万美元),认为这是年轻人低风险创业的最佳路径:从第一天就盈利、无需融资、拥有全部股权,并建议先亲自交付服务,再用AI代理规模化。
作者分享使用 DeepSeek-V4.1-Flash 1017 模型配合开源 AI 原生设计工具 OpenPencil 和生图模型 Qwen-Image-2.1 Turbo 制作电商落地页与模特图的实战体验。文章包含完整的落地页设计提示词和模特生成提示词,展示了生成结果的高审美水准,并提到 OpenPencil 是一款开源免费的 AI Native 设计工具,核心能力是通过 Agent 输出高质量 UI 设计稿、卡片、轮播图、PPT 等,适用于电商页面和海报制作,评论区多人交作业复刻效果。
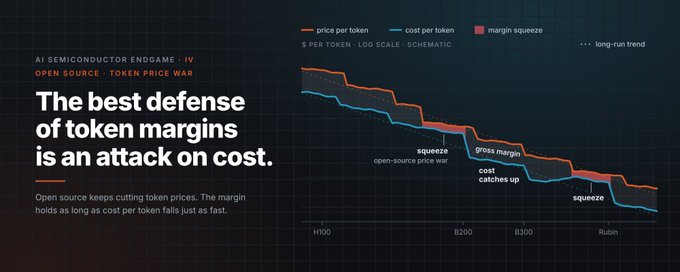
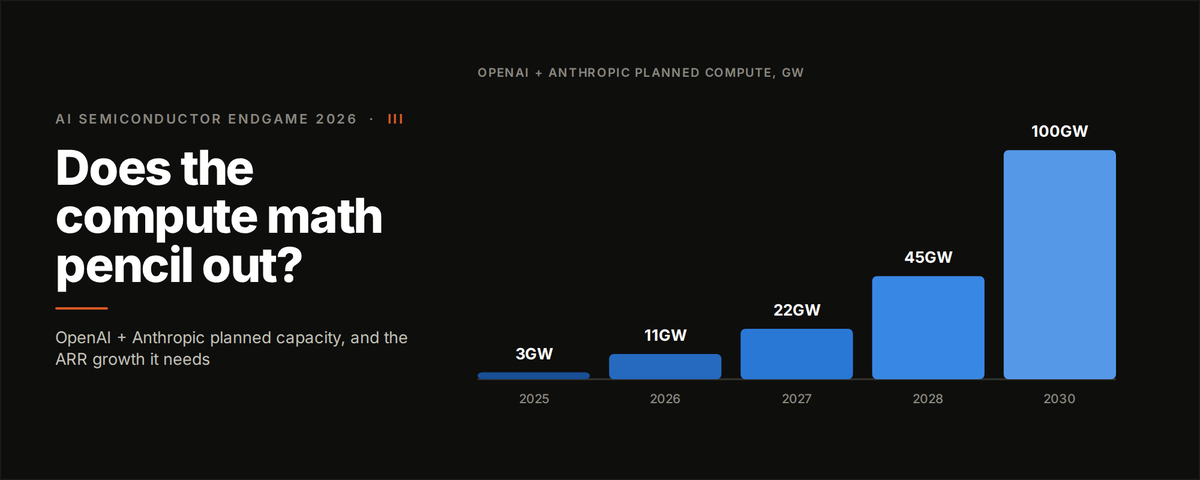
文章探讨开源模型的崛起是否冲击半导体需求这一热门问题。作者指出市场担忧的核心在于开源是否会压低毛利,进而削弱模型公司购买GPU的能力。但通过动态均衡框架分析,token价格下降的同时,硬件与软件的效率提升(每十年各贡献千倍优化)使成本同步快速下降,毛利得以维持。以每GW算力测算,旗舰模型推理毛利率仍达75%-80%以上,开源模型约60%-70%,token收入是硬件摊销成本的十倍。结论是开源不会伤害半导体行业,动态均衡将持续推动AI基础设施扩张。
本文是 Codex-OpenPencil 插件的快速上手教程,以设计一个服装购物 APP 为例,完整演示从安装、打开画布、确认风格、扩展页面、选中元素口喷修改,到图片生成与搜索、保存设计资产,再到设计稿转代码的全流程。插件免费开源,提供支持平移缩放的无限画布,Codex 负责理解需求并调用工具,OpenPencil 负责设计展示与编辑,可 100% 还原生成 HTML、Vue、React、SwiftUI 等框架代码。文章还介绍了看板、教程图、对比图、PPT 等其他应用场景及常见问题处理方法。
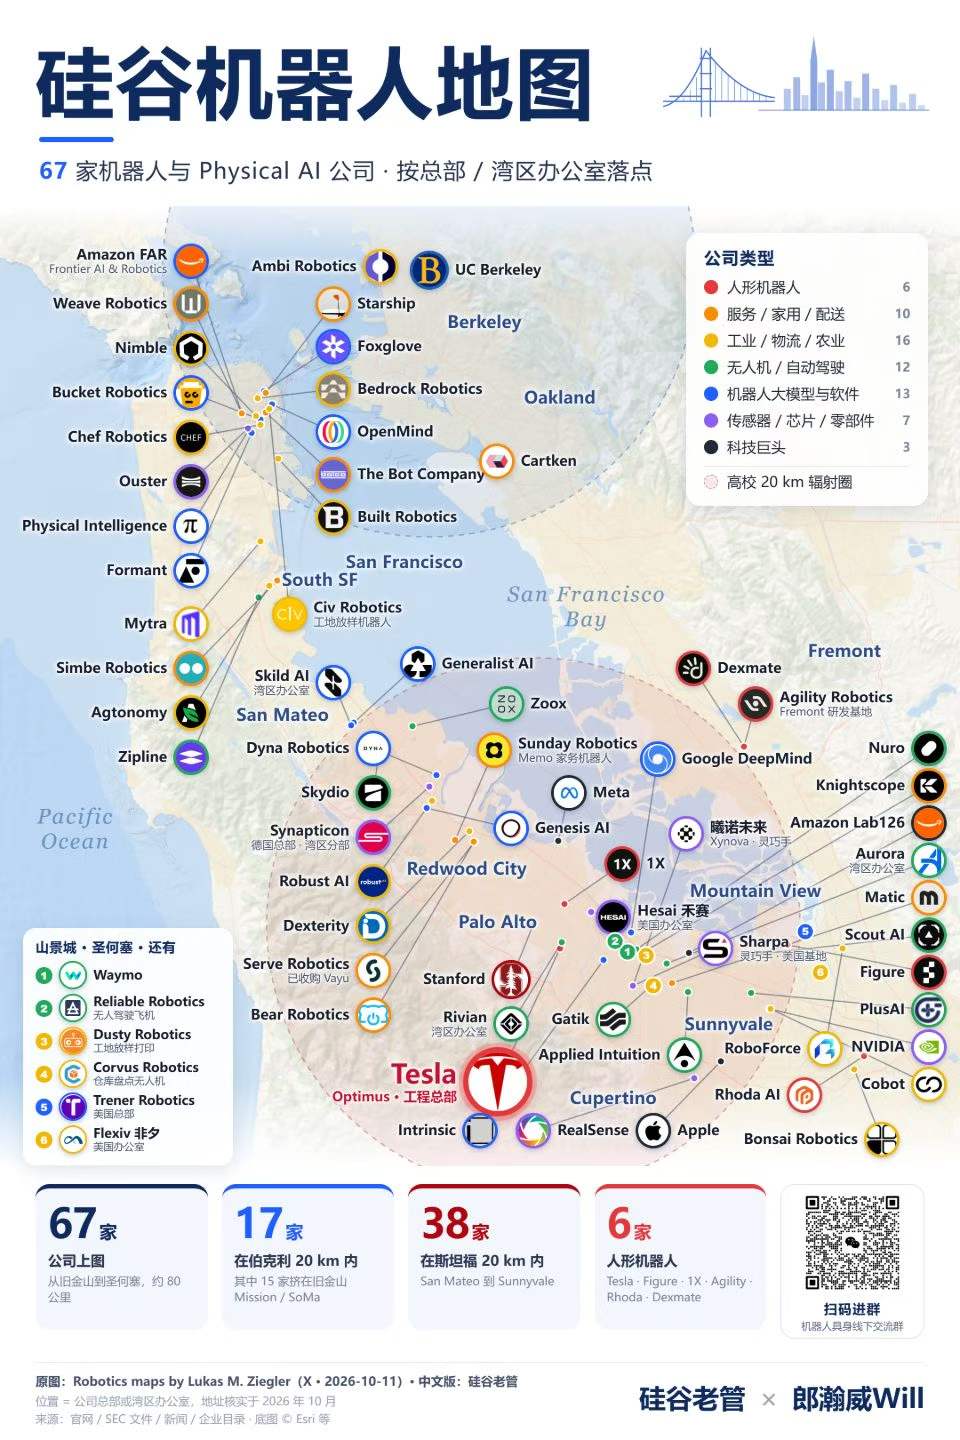
作者用 5 张地图对比了硅谷与北上杭深的机器人产业格局:硅谷 67 家、深圳 36 家、北京 32 家、上海 25 家、杭州 25 家。各城市产业结构差异明显:北京依托高校与 AI 公司,具身智能和人形机器人集中;上海偏工业与制造,国际厂商与本土公司并存;杭州生态集中、产品化速度快;深圳覆盖从零部件到整机的完整链条,人形机器人公司数量国内最高。硅谷擅长定义未来,中国城市正以不同方式把未来造出来。
作者分享了打造七位数营收 AI 原生公司 Hourglass 过程中消费的所有媒体资源与内容管理系统。文章引用 Paul Graham 的知识分形边缘理论,指出 AI 前沿充满机会缺口,并按主题推荐内容:创业(Paul Graham、Tim Ferriss)、经营 AI 原生公司(Maister、红杉、Every)、跟进 AI 动态(Twitter、All-In Podcast、AI 2027)以及保持人性的虚构文学阅读。作者还介绍了名为 Consume 的系统:用 Apple Shortcut 收集内容存入数据库,每周由 Claude 自动分类处理,将 Karpathy 的 LLM Wiki、Hamel Husain 的 Eval 思想等素材转化为公司实践与产品。
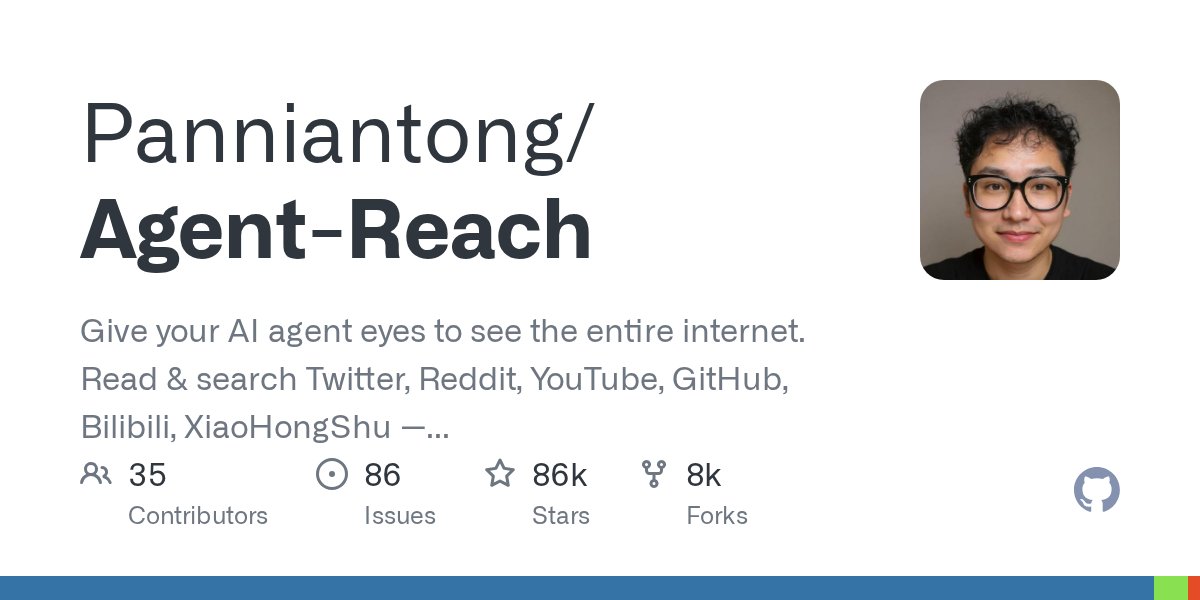
文章介绍了三个 GitHub 开源工具,让 AI Agent 几乎可以从整个互联网抓取数据。Agent-Reach 将 X、YouTube、Reddit、GitHub 等平台整合到一个入口;Patchright Enhanced 基于 Playwright 监听网站请求,即使网站没有 API 也能通过脚本提取数据;Scrapling 是面向任意网页的通用自适应抓取框架。用户只需告诉 Agent 想要什么数据,Agent 会自动编写代码、完成采集并返回结果,例如分析 X 账号帖子话题表现、收集 Reddit 和 YouTube 上的产品评价等,相当于给 Agent 装上了读取整个互联网的眼睛。
作者基于一年运营 AI 原生公司并帮助客户转型的经验,提出打造 AI 原生公司的七步方法论:先清理数据与上下文(建立 Company AI Brain),再构建共享基础设施而非零散自动化;让全员在 Harness(如 Claude Cowork、Codex)中工作;用技能、上下文和新模型解决大部分工作;全员教育并培养 Champion 推动进化;自定义 Agent 最后才建;并保持持续尝试。作者还破除 Agent 神话,指出'人机三明治'模式依然存在,人的角色随信任与上下文积累而变薄。
本文详细介绍了 Qwen-Image 2.1 图像生成模型的三种本地部署路线:ComfyUI、Unsloth Desktop 和官方 Diffusers。作者首先解释了不同后端权重的差异,指出 DiT、文字编码器和 VAE 三件套需分别下载且不能混用。文章给出了 Windows RTX 5080 与 MacBook Pro M2 Max 两套平台的实测数据:5080 上 1MP 文生图约13秒,M2 Max 单张约10分钟。同时涵盖模型目录结构、extra_model_paths 配置、图像编辑模板用法、常见问题排查及 Qwen Research License 商用限制提醒,是一份可复现的完整部署教程。
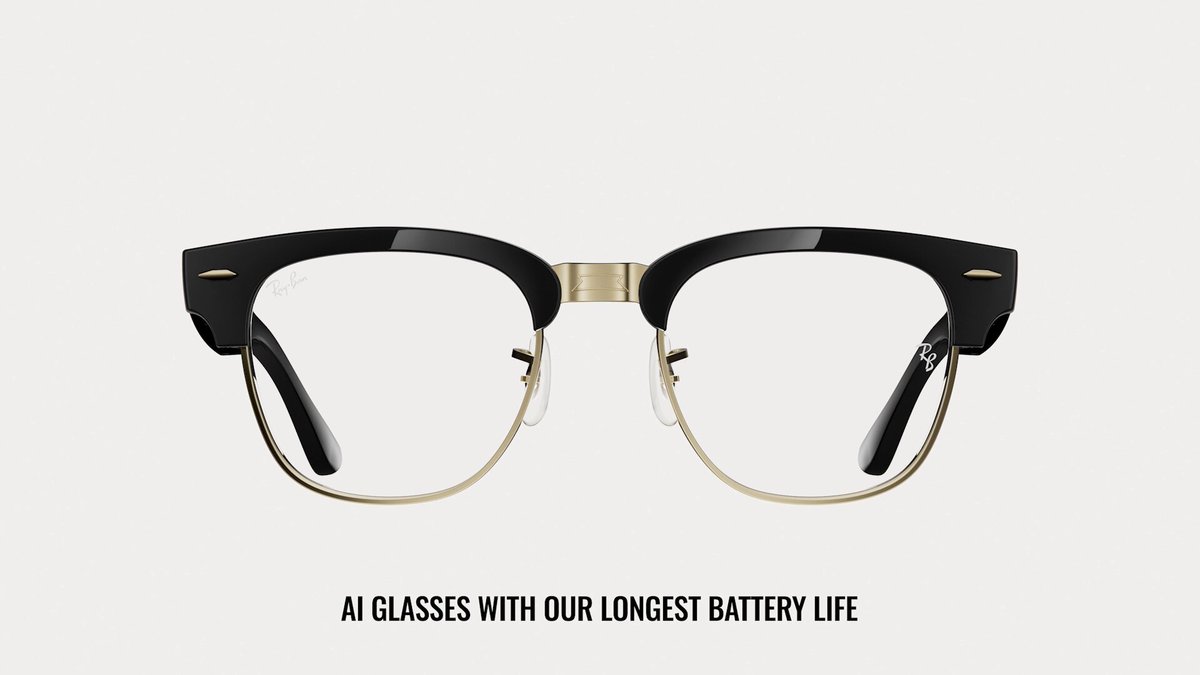
Meta Connect 2026 上,扎克伯格一口气发布了 8 项新品和功能,涵盖 AI 助手与硬件生态:Muse 支持语音和实时视频并可进入 Meta 眼镜实现全天免手持操作;Meta Glasses 获得 FDA 助听器许可,价格远低于普通助听器;推出注重隐私的 Private Processing;发布首款无摄像头、全天续航的音频眼镜;Ray-Ban Meta Gen 3 升级续航与麦克风;款式年底将超 100 种;VR 眼镜首次以眼镜形态集成私人影院、多显示器和游戏;还推出可挂钥匙扣的 Muse Charm,预计 12 月发货。
作者在测试 Qwen-Image 2.1 时发现,生图和改图效果不佳的主要原因是创作意图未被准确传递给模型,如负面文字被印进海报、改姿势只换了衣服等。作者将经验整理成 qwen-image-gen Skill 并提交开源:区分文生图、局部编辑和参考人物创作;将人物动作、接触关系、镜头和画面文字写成模型可执行的描述;落实比例决策并检查返回图片真实像素;将质量反馈带回下一版。四组对照实验显示三组改善、一组失败,证明提示词改写有价值但非几何纠错器。
作者介绍了基于 TypeSafe 发布的 Jev 模型构建信号驱动外呼机器人的方法。Jev 比通用模型快约百倍且成本极低,可为每个销售线索快速打分。作者团队曾用 Claude 做信号驱动 SDR,两周内约到 19 次会议,回复率 12%。文章详细拆解了开源项目 signal-ranker 的架构:watch.py 通过日期文件对比追踪招聘重发、融资等信号,judge.py 负责调用 Jev 评分,policy.py 用纯代码实现门槛与权重,两者分离以便复用已付费的判断结果。支持用 Claude Code 自行拉取线索或使用 yourmax.ai,可放入 Claude Code 或 Codex 终端复现。
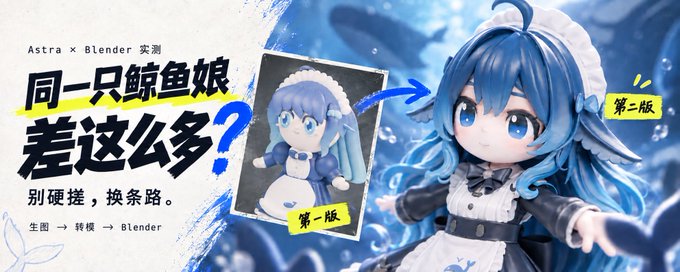
作者分享了从角色参考图制作 3D 手办模型的完整流程。先用 GPT 生成手办效果图,再选择转模工具(对比 TRELLIS.2、Tripo 3.1、Tripo 2.5 三条路线,涉及免费配额与导出权限差异),下载带贴图的 GLB 后导入 Blender,让 AI 助手检查并修整面部、贴图等细节,最终输出高清 PNG 和 8 秒转台 MP4 视频。作者强调直接让 AI 从零建模效果不佳,正确的流程顺序、事先确认导出权限、区分白模/分部件/纹理等概念是成功的关键。
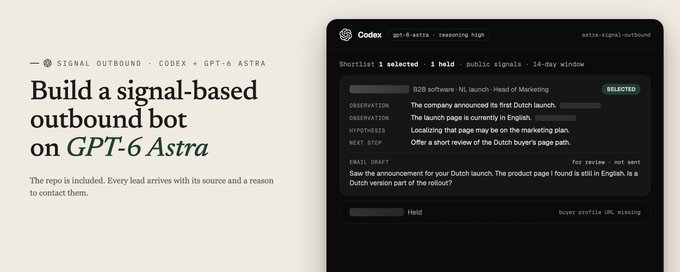
作者介绍了一个基于 GPT-6 Astra 与 Codex 构建的销售线索外呼机器人系统。该系统通过 profile.json 定义产品offer与理想客户画像(ICP),利用 AGENTS.md 约束 Agent 行为,自动搜索近期商业事件作为购买信号,验证公司与买家信息,并起草待人工审核的外联消息。文章详细讲解了四个实施步骤:为模型设定具体任务、将 offer 与 ICP 结合、选择能改变工作方式的信号、寻找能解释时机的信号组合。仓库包含信号目录、验证规则和示例,所有产出均附带来源链接与联系理由,代码免费开源。
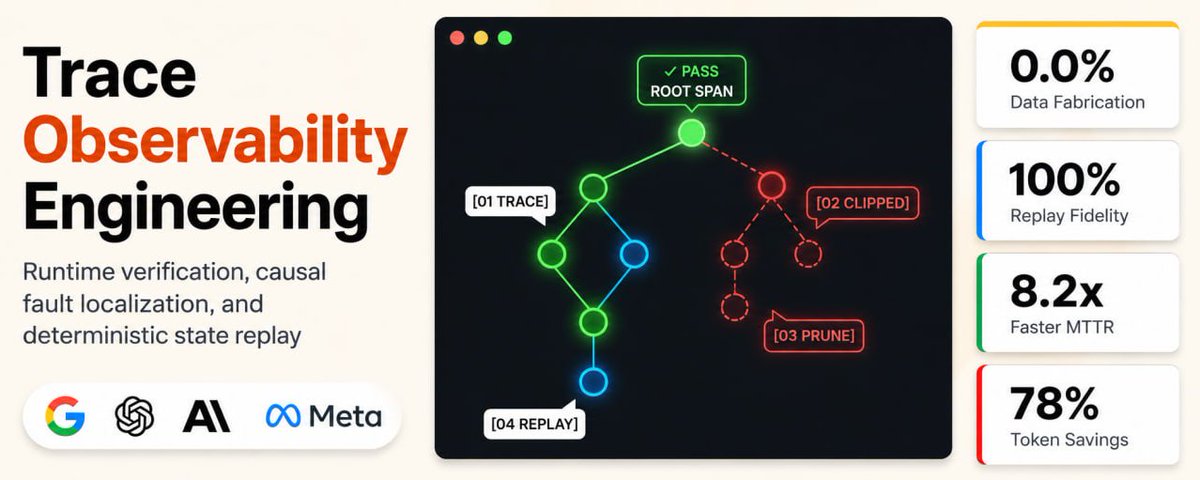
文章指出生产环境中多 Agent 系统的故障调试不是提示词问题,而是分布式系统可观测性问题。作者提出 Trace Engineering 架构,区分了日志、轨迹与分布式执行追踪三种对象:日志记录文本输出,轨迹记录顺序对话轮次,而追踪以 DAG 形式刻画因果图,支持并行分叉与子 Agent 委托。文章进一步阐述确定性重放与因果状态重建,通过事件溯源(append-only 事件账本)记录工具载荷、随机种子与采样参数,实现 Mocked Replay(离线零成本验证)与 Live State Resumption(从快照恢复现场)两种调试模式,避免不可控的递归重试烧毁大量 Token 成本。
文章探讨 AI 基础设施建设的长期逻辑:与互联网时代单一维度的用户渗透不同,AI 硬件需求由用户渗透率与人均 token 用量两个指数增长维度相乘驱动,形成历史上罕见的「双 S 曲线接力」,支撑更长的半导体超级周期。同时指出,由于推理的高边际成本,AI 时代商业模式已从「流量×转化率」转向「每 token 毛利」。文章还分析编码(广义)作为下一个 ARR 增长引擎的潜力:大量非编码任务(财务、法务、销售等)正被转化为编码代理执行结构,OpenAI Codex 在非工程岗位的周活用户暴涨即为例证。
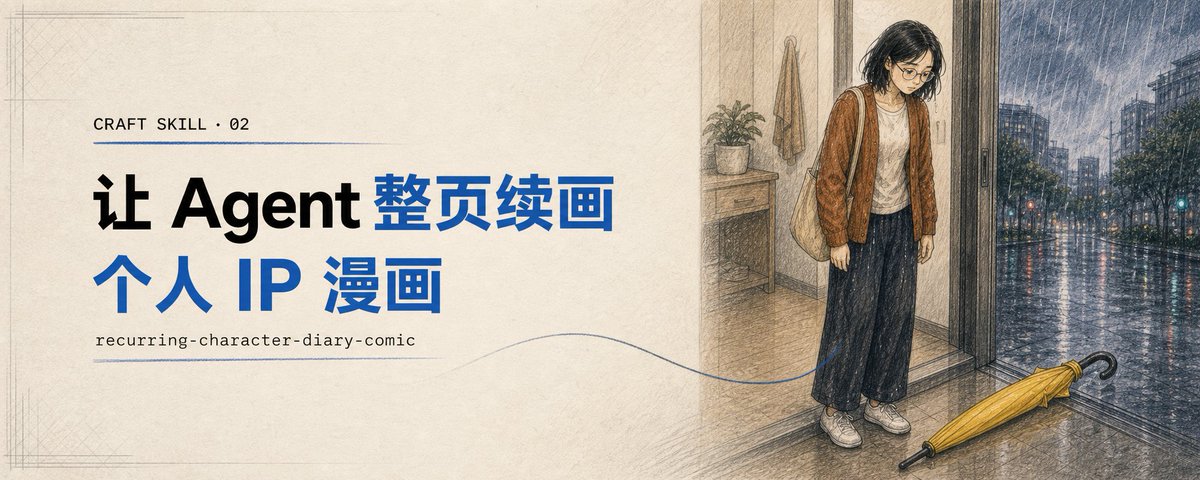
本文介绍了开源 Craft Skill「recurring-character-diary-comic」,一套让 Agent 持续生成同一固定角色个人 IP 漫画的工作流。它不依赖长 Prompt 或逐格拼图,而是通过故事合同(S0 故事真相、S1 身体真相、S2 表现选择)、page-native 整页生成、方向物体逐对象证明、有边界的局部修复和双轴像素验收,保证角色一致性、故事准确、中文对白无误,且整页作品自然统一。文字生成失败时才启用 compositor 做确定性排字兜底。
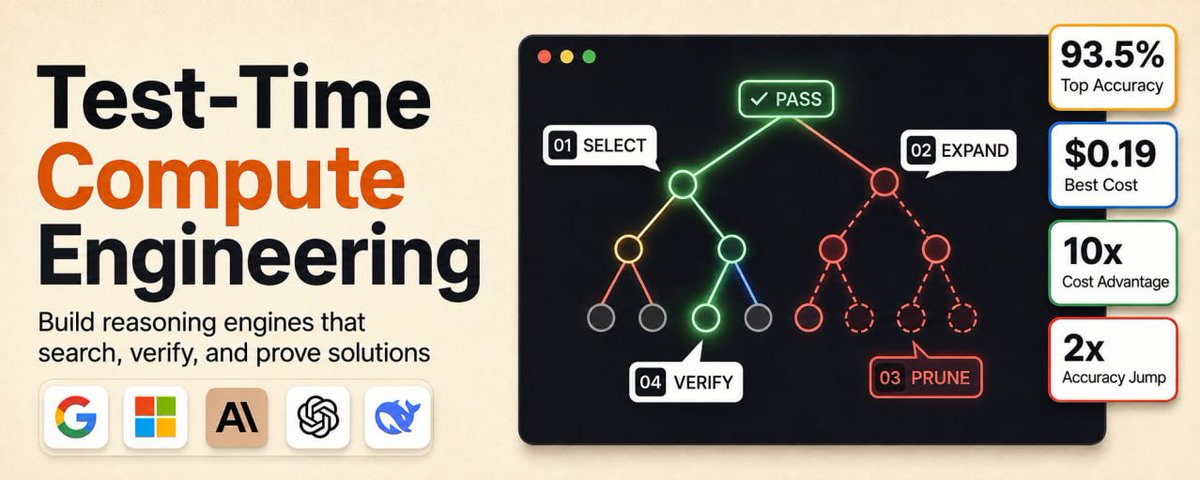
本文探讨了 Test-Time Compute Engineering,即通过将算力从预训练转移到推理阶段,利用动态预算分配、搜索树拓扑、过程奖励模型验证和剪枝策略,构建在回复前进行自主推理的 AI 引擎,以突破预训练规模定律的限制并提高复杂任务的准确性。
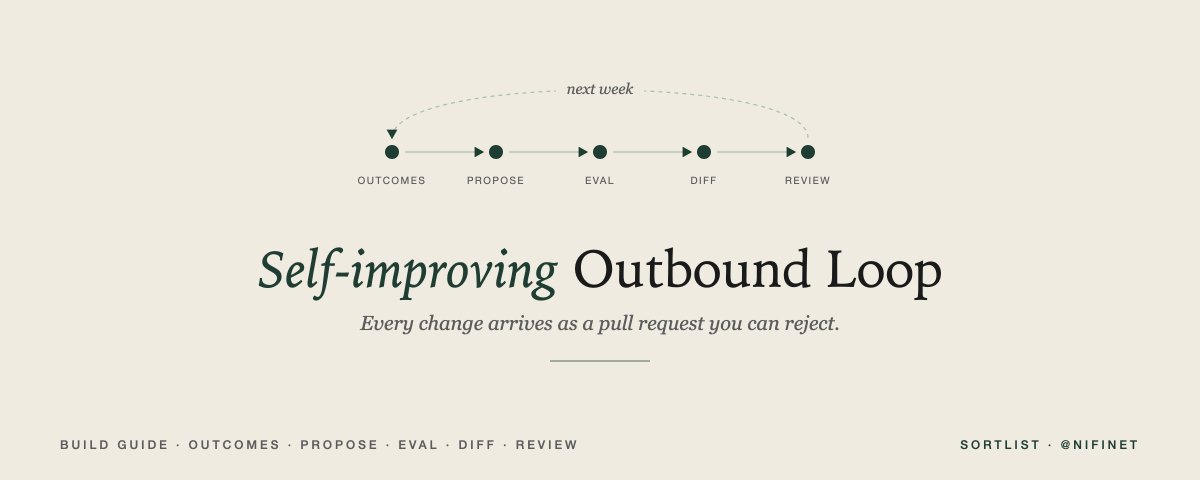
本文介绍了如何利用 Codex 构建一个自我改进的外联系统。通过将市场反馈记录为内存文件,Codex 自动评估并修改评分规则和话术配置,提交优化建议供人工审核,从而实现 GTM 策略的持续迭代与优化。
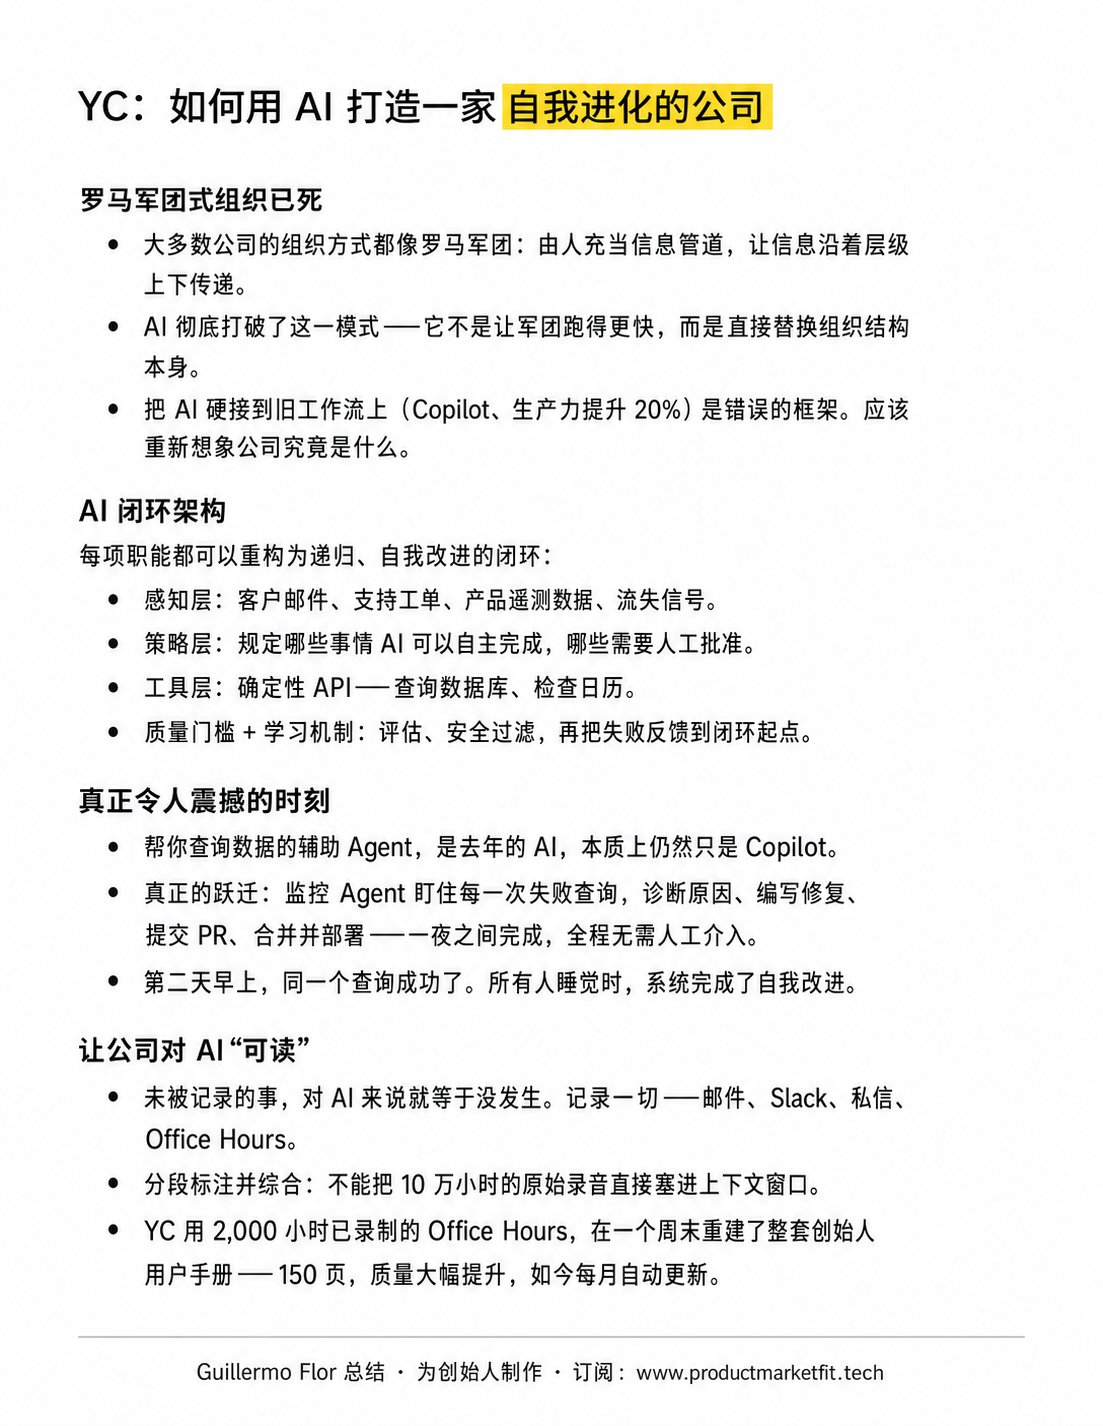
文章介绍了 Tom Blomfield 关于利用 AI 构建自我改进型公司的观点,包含相关视频和引用的原始内容,探讨 AI 在公司发展中的应用。
文章探讨了上下文工程在外拓代理中的应用,强调通过精心设计上下文窗口(包含角色、案例、证据和规则四层),解决模型幻觉和生成内容泛化的问题。文章介绍了组装、撰写和优化三个核心技能,以提升个性化消息的质量和响应率。
本文介绍如何利用名为 Mexus 的工具在五一假期实现随时随地(特别是 iPad)进行 Vibe Coding。文章详细说明了在云服务器上配置 Node.js 环境及 CLI Coding Agent(如 ClaudeCode)的三步流程,并重点展示了 Mexus 针对 iPad 优化的多 Agent 并行编程界面,适合假期不想携带电脑的开发者快速落地产品创意。
本文转发了 Anthropic 发布的一份 23 页指南,详细拆解了如何利用 Claude Code 覆盖公司 10 个核心部门的工作流。案例涵盖了从增长营销、数据基础设施、产品开发到安全工程、法务合规等全方位场景,展示了 Claude Code 在不同专业领域的强大辅助能力与实际落地应用。