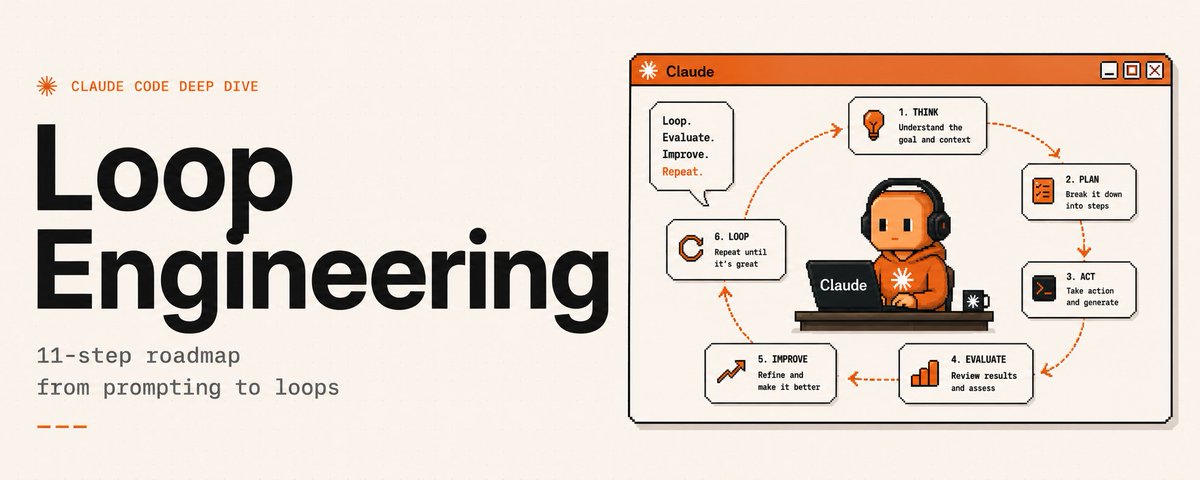
循环工程:营销人员的自主代理构建指南
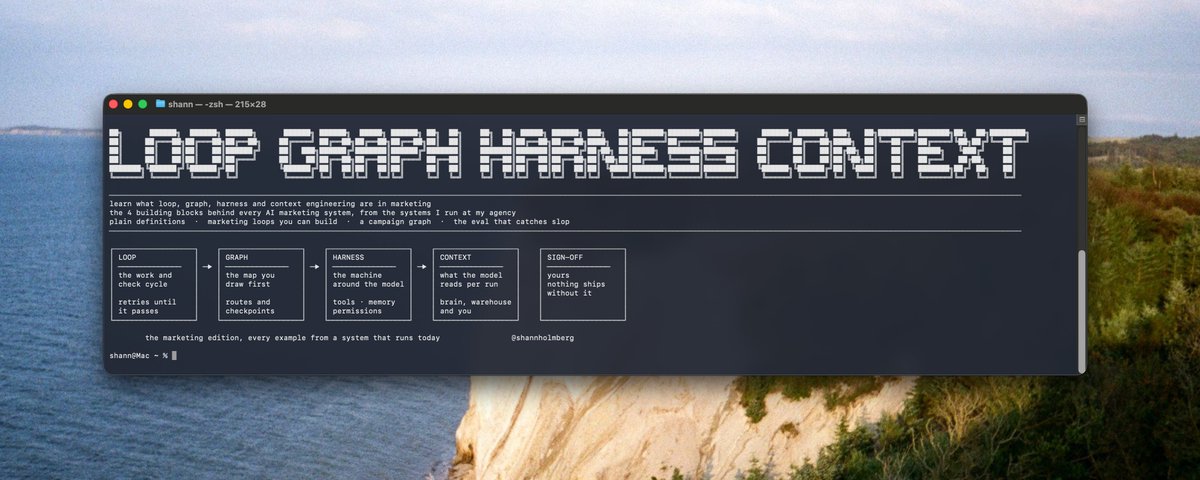
本文介绍了如何将循环、图谱、上下文和测试工具等工程概念应用于营销领域,使营销人员成为自主代理工程师。重点解析了循环工程的核心机制,详细阐述了代理循环、验证循环、事件驱动和自我改进四种循环类型,并结合营销场景(如内容、SEO、活动运营等)提供了具体的构建方法。文章强调了通过评估循环有效防止AI生成低质内容,从而实现高效自动化营销。
本文介绍了如何将循环、图谱、上下文和测试工具等工程概念应用于营销领域,使营销人员成为自主代理工程师。重点解析了循环工程的核心机制,详细阐述了代理循环、验证循环、事件驱动和自我改进四种循环类型,并结合营销场景(如内容、SEO、活动运营等)提供了具体的构建方法。文章强调了通过评估循环有效防止AI生成低质内容,从而实现高效自动化营销。
随着大模型进入企业级应用,前沿AI能力与实际生产落地之间仍存在巨大的工程鸿沟。本文深入剖析了Palantir的现场部署(FDE)方法,指出将AI接入企业运营的核心在于构建“本体”。Ontology不仅是数据的语义层,还包含动作、逻辑与安全边界。文章结合医院和水处理厂的真实案例,探讨了如何通过定义动词、控制权限,将企业的隐性知识转化为可执行、可审计的系统资产,为AI在企业中的安全落地提供了实践框架。
文章指出,AI使用的未来在于构建“循环”而非单纯编写提示词。作者以Karpathy的AutoResearch项目为例,阐述了AI如何通过循环自主进行实验和优化。一个有效的循环必须包含验证器、状态记录和停止条件。文章强调,当任务具备可自动化的验证机制且需要重复执行时,应让AI在循环中自我迭代以移除人类瓶颈。最后,文章分享了构建基础AI循环和有效验证器的核心代码模式。
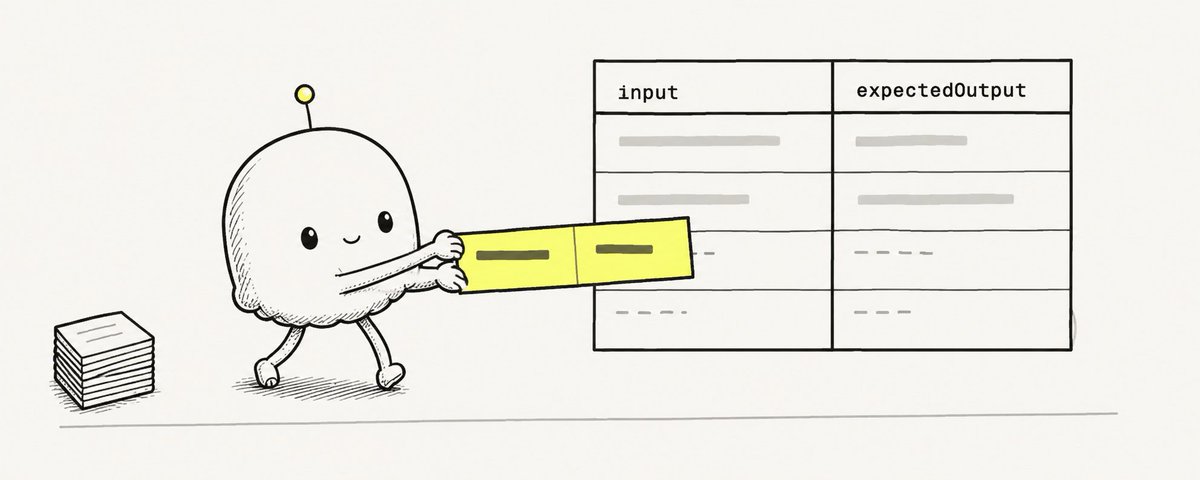
当应用仅靠直觉调试无法满足需求时,构建评估数据集至关重要。本文详细介绍了设计AI Agent评估数据集的五个核心步骤:1.明确数据集的最小目标;2.检查生产记录、现有资产等可用数据源;3.规划输入分布,合理搭配场景与难度;4.决定评估机制,选择基于参考或无参考的评估方式;5.定义包含输入、预期输出和元数据的结构化项目模式。通过迭代设计,确保系统质量可量化和持续改进。
本文对比了构建AI智能体的三个开源框架层级:Deep Agents、LangChain和LangGraph。它们提供不同层级的控制力与抽象程度:Deep Agents是开箱即用的智能体套件,专注于最佳上下文工程实践;LangChain是高度可定制的智能体核心抽象与集成框架;LangGraph则是基于图的底层运行时,适用于混合确定性与动态步骤的复杂工作流。三者完全可组合,开发者可在自主性与确定性之间灵活平衡。
本文探讨了从单Agent向多Agent团队转型的实践经验。作者对比了Raft与Buzz等工具,指出多Agent架构能按角色分配模型与权限。文章重点剖析了多Agent场景下的核心痛点:跨域上下文联想、静默失败设计与分层记忆机制。作者强调,决定Agent系统可靠性的关键在于失败可见性、记忆唤醒路径及按职责隔离的设计,而非仅靠协作界面。
本文深入解析了 Claude Code 创始人 Boris Cherny 的日常工作流与核心理念。他指出,Claude Code 的最佳使用方式已从传统的“单次提示”转变为“设计循环”,即通过多会话和子智能体构建自动化的系统。文章探讨了系统提示词的演进逻辑,并分享了如何像 Anthropic 内部团队一样高效编写 CLAUDE.md 文件:将 Claude 视为一名能力极强但患有失忆症的新员工,仅提供必要的全局指令与渐进式上下文。
文章回顾了AI递归自我改进(RSI)的80年历史,将其划分为四次浪潮:随机突变(遭遇生成瓶颈)、数学证明(陷入验证瘫痪)、AutoML(过度拟合基准测试),以及当前大语言模型阶段。作者指出,随着LLM解决了代码生成的瓶颈,AI系统演进的核心挑战已剧烈转移至“验证”阶段。面对开放式任务,如何有效验证AI生成复杂系统的逻辑可靠性,成为了当前AI自我进化的真正天花板。
作者为其开发的RW Research Skill(一套基于Agent的科研工作流)引入了新的自动投稿模块。该工具能读取期刊要求,自动整理、检查并修改本地论文文件(如分离图表、修正编号),随后代替人工在投稿系统中填写信息与上传材料,且具备页面报错复核机制。该自动化流程大幅减轻了作者在格式调整和反复核对上的繁琐负担,而学术伦理、数据真实性及最终提交等责任仍由作者本人承担。
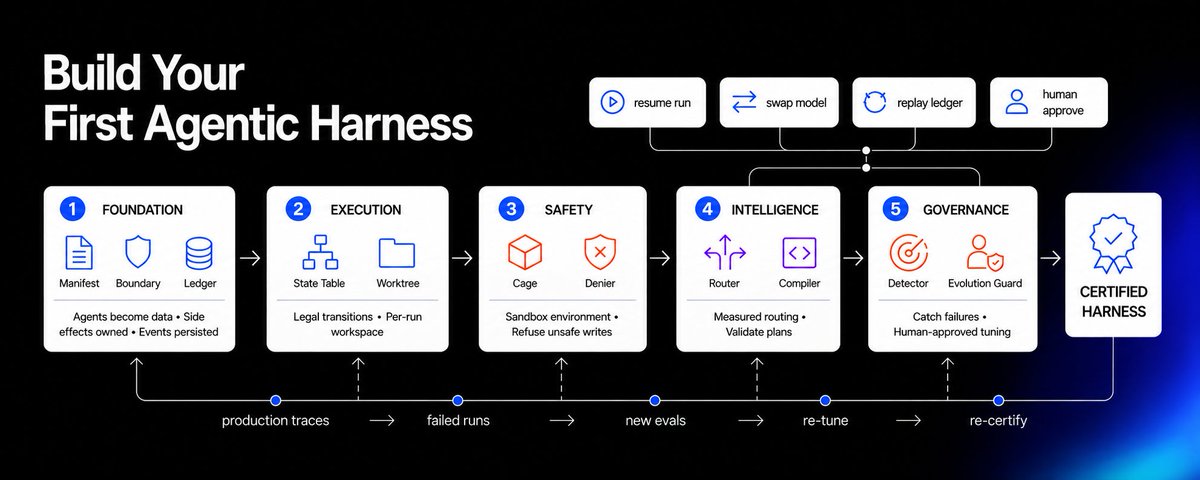
文章指出AI模型正变得廉价且可互换,核心资产在于控制层(Harness)而非模型本身。作者提出了构建Agent控制层的三条核心法则:模型是消耗品而框架是资产、耦合要轻但框架本身要做厚、可调设置必须有代码级别的硬边界。文章详细拆解了构建可复用控制层的11个关键要素,并主张让框架去适应工作流而不是绑定特定的模型供应商,以适应快速迭代的AI技术格局。
本文详细介绍了如何利用Claude Code结合ColdIQ单一API,构建全自动化的GTM(走向市场)流程。通过预先定义ICP、评分规则和文案模板等四个文件,即可用一句话指令驱动7个阶段的自动化:包括信号检测、客户打分分层、寻找联系人、邮箱验证补全、文案生成和营销推送等。该方案通过统一接口智能调度43个数据提供商,结合按结果计费和消费上限机制,大幅降低了多平台管理的成本与复杂度,实现高效的营销自动化。
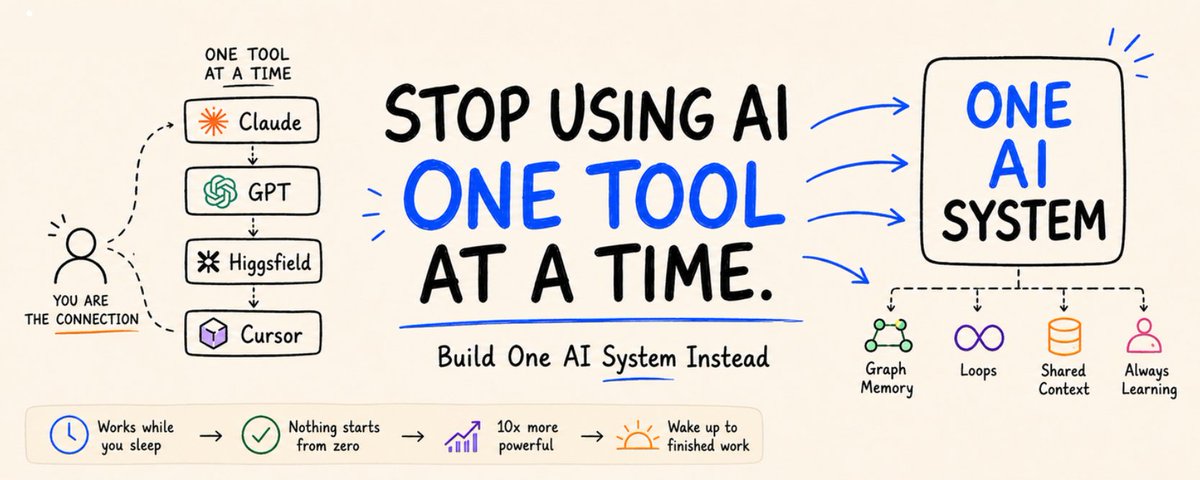
本文介绍如何摒弃手动单次提示,通过构建AI系统实现开发自动化。以Claude Code为基础,结合上下文规则实现工程化代理;利用循环工程让系统自动发现任务、执行并验证结果;引入图工程作为知识记忆层,通过三元组存储项目逻辑,使模型准确率大幅提升且避免从零开始;最后通过模型路由按任务复杂度自动分配Opus 5或Fable 5,以大幅降低开发成本并成倍提升工作效率。
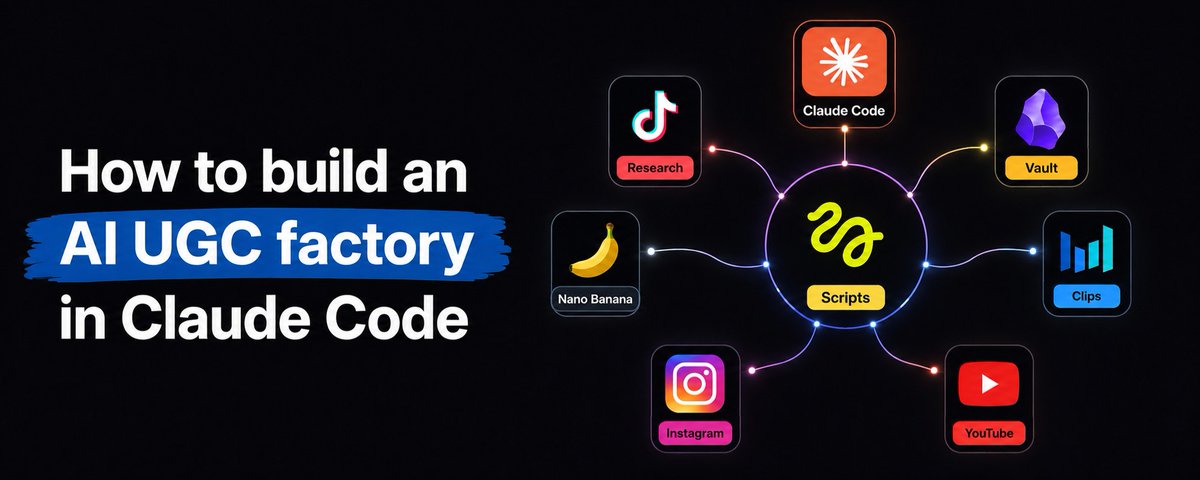
本文是一篇详细的实战指南,教你如何从零开始,利用AI技术建立一个全自动的UGC广告制作工厂。作者强调广告的灵魂在于文案,因此流程以挖掘用户真实痛点和拆解爆款脚本为起点。文章详细介绍了如何通过分析竞品和用户评论来建立Obsidian爆款脚本库,并展示了如何结合Higgsfield平台或使用Claude Code自主构建Agent,以打通从调研、脚本撰写、图片生成到视频剪辑的完整AI流水线。
本文详细拆解了如何利用 Codex 搭建一条多 Agent 并行的 AI 视频流水线,用于制作爆火的“人生副本”解压长视频。文章从选题评分、剧本创作、内容质检、视觉设计、配音、批量生图到最终渲染,分八个步骤深入解析。通过引入并行处理与角色身份证等机制,大幅提升制作效率,实现单日产出一条高质量成片,非常适合作为短视频带货或副业项目。
随着AI模型能力提升,企业最缺的反而是将模型带入业务现场的“前线部署工程师”(FDE)。FDE的价值在于解决从Demo到生产落地的难题,包括重新定义业务问题、接入生产流程并推动组织变革。AI降低了执行成本,使得识别高价值场景、深度理解和质量验收等判断能力变得稀缺。在国内市场,FDE可通过沉淀Skill和模板,将深度交付转化为可复用的长期资产,真正实现AI的业务价值。
本文总结了AI时代未来十年的六条核心职业建议。在AI擅长解决标准化问题的背景下,人类的价值转向无法被模型评分的工作。建议包括:聚焦时间、关系和声誉等真正稀缺的资源;培养发现问题而非仅解决问题的能力;选择最雄心勃勃的挑战;死磕交付的最后10%;同时提高捕捉机会的概率(xG)和转化效率;以及把研究当作一种心态去探索未知。未来属于能选对方向并创造卓越结果的人。
本文编译了Phil Chen关于AI时代职业发展的建议。作者指出,能被明确定义和打分的工作正被AI取代,未来真正稀缺的是时间、人脉和声誉。在agent-native时代,工程师的核心能力正从“写代码解题”转向“发现并定义问题”。选公司应看重其解决方案的野心,工作中要死磕“最后一公里”的细节。文末作者结合自身经验,对面试方式变革、生产环境重写及发现问题的前提给出了独到见解。
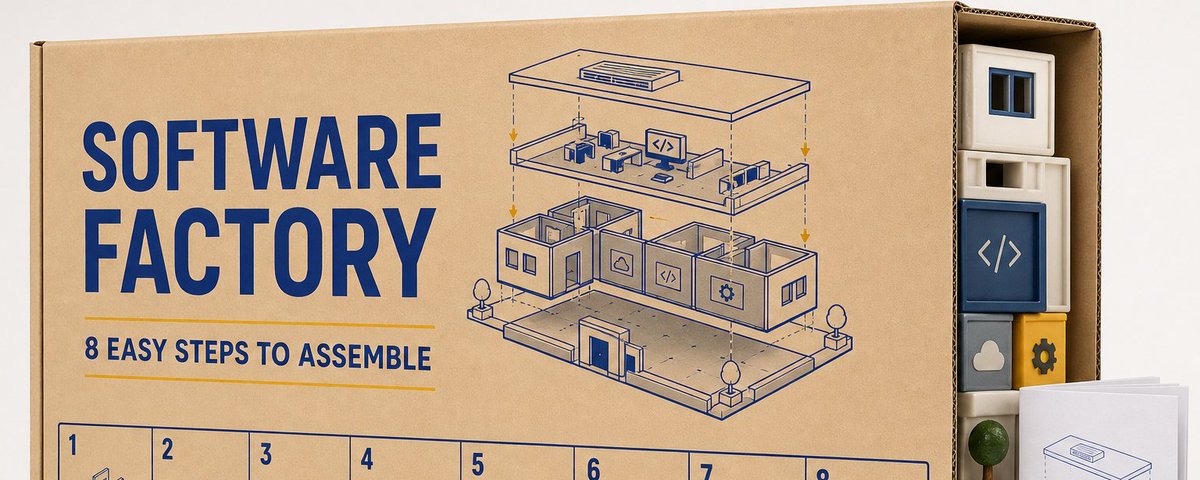
作者提出“软件工厂”本质上是一种自动化工作流而非单一产品。文章拆解了从获取任务到提交代码的软件开发全流程,并指出通过Agent、MCP、CI等工具组合即可轻松构建该工作流。相比于依赖容易失效的PRD和文档,作者主张记录真实的开发执行轨迹。将软件工厂视为自动化模式而非100%包办代码的万能产品,能有效解决现实开发中的复杂跨库等痛点,显著提升研发效率。
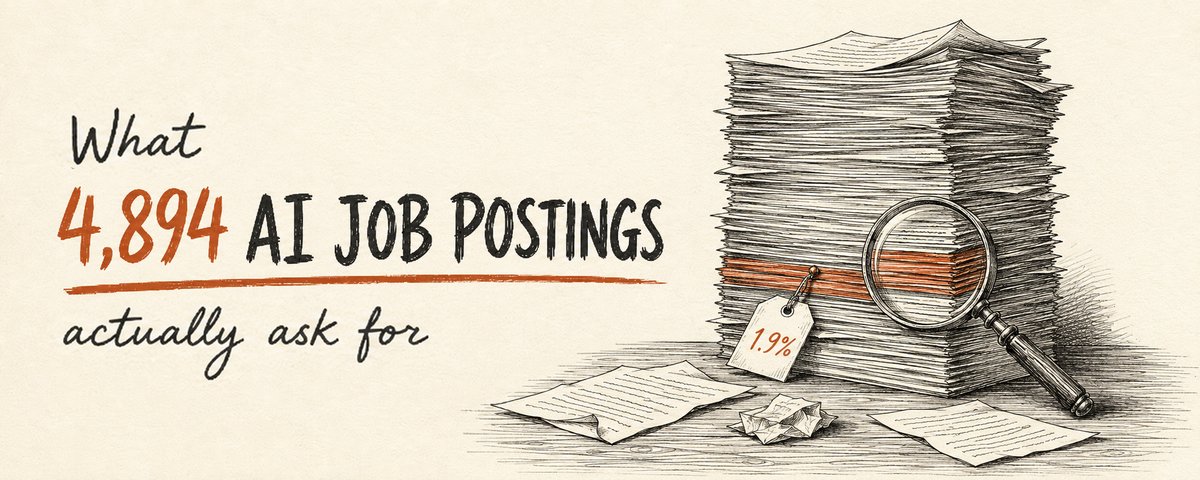
文章基于2026年AI工程师岗位数据分析,指出传统机器学习岗位仅占1.2%,而72.9%的工作涉及RAG、Agent等AI系统构建。文章详细拆解了LLM应用、AI平台、ML模型及研究四条职业路径的技能要求、实际工作内容与学习资源,强调AI工程师已演变为全栈角色。
文章探讨了如何区分 AI 声称任务完成与实际完成的差异。问题常源于初始指令模糊,如“整理好”、“改一下”缺乏明确标准。作者建议在动手前制定具体的检查清单,明确每项验收标准,并记录检查过程,以确保交付结果符合预期。
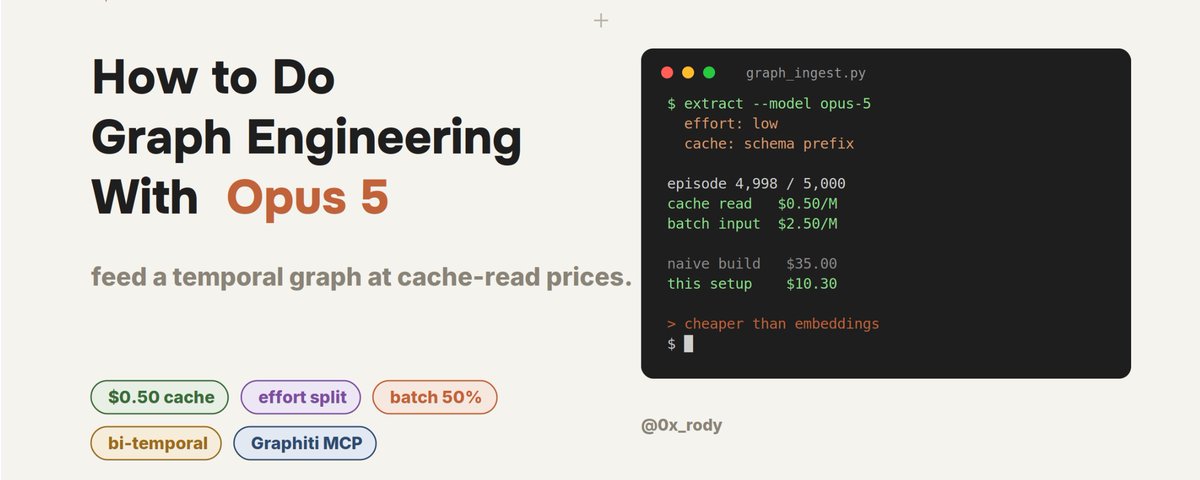
文章介绍了如何利用 Opus 5 的新特性(如缓存控制和低 effort 模式)低成本构建图记忆。核心在于将提取和遍历分离:提取使用低 effort 和缓存前缀以降低成本,遍历使用高 effort 以保证推理质量。通过优化配置,图工程的成本可降至原本的三分之一,甚至低于向量存储。
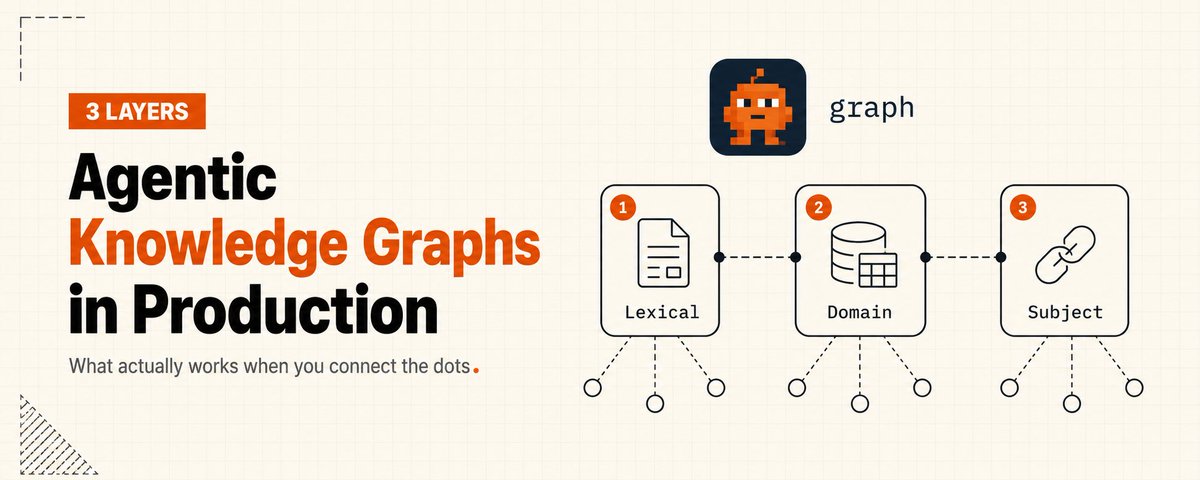
文章探讨了在生产环境中实施智能体知识图谱的实际经验。作者指出,并非所有场景都需要图谱,大部分问题可通过元数据过滤或混合搜索解决。只有当需要多跳连接(如根因分析)时才需引入图谱。建议将图谱分为领域图、词汇图和主题图三层,并从简单的单智能体流程开始构建。
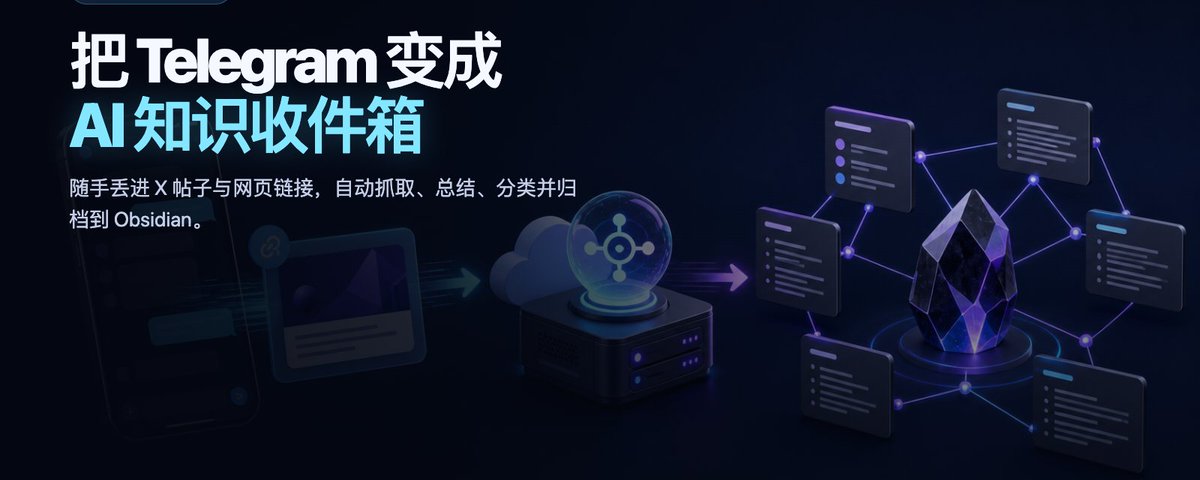
本文介绍了一种利用 Hermes、Telegram 和 Obsidian 搭建个人 AI 公用大脑的方法。用户只需将链接发送到 Telegram,Hermes 会自动抓取内容、生成摘要、去重并归档到 Obsidian 中。文章详细部署了从安装 Hermes、配置 Telegram Bot、设置抓取工具到编写 Skill 实现自动化工作流的全过程。
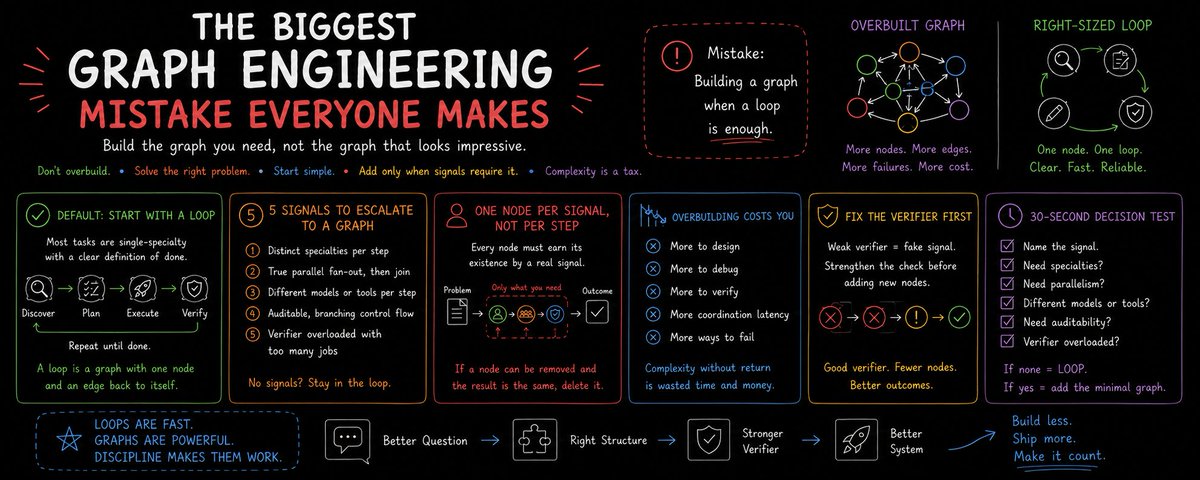
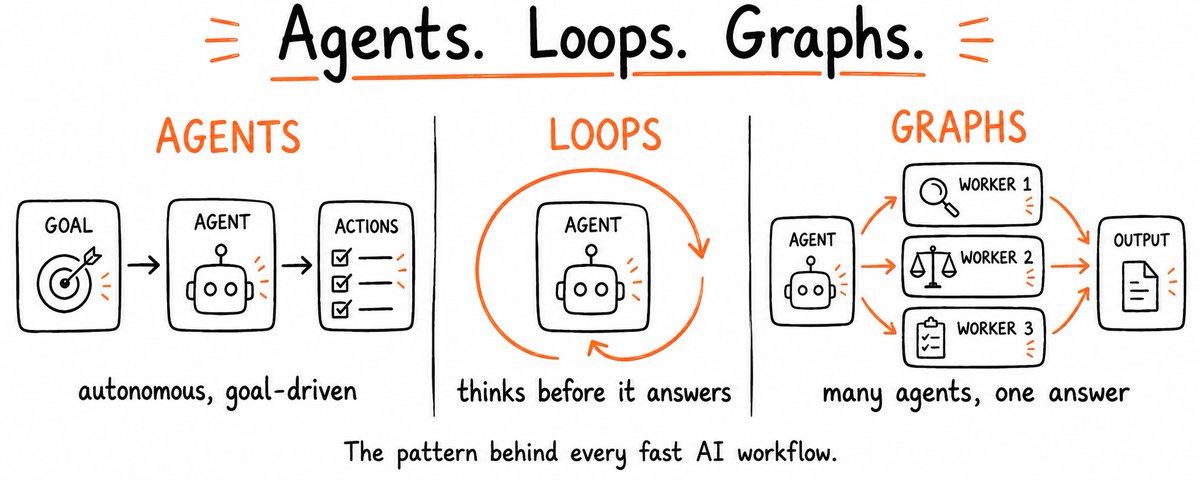
文章探讨了在构建 Agent 时,默认应采用单节点循环(Loop),仅在出现特定信号时才升级为图结构(Graph)。循环更便宜且易于调试,适用于大多数单任务。只有在任务分解、并行处理或验证器过载等明确信号出现时,才值得引入图的复杂性。
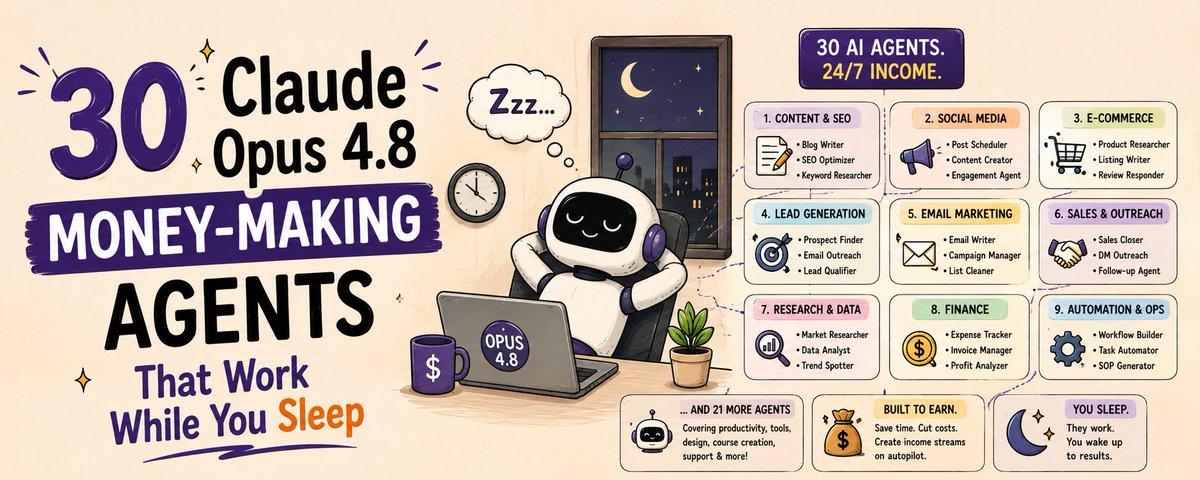
文章介绍了30个利用Claude Opus 4.8构建的实用赚钱智能体,涵盖内容创作、销售线索挖掘和数字产品开发等领域。这些智能体能够实现半自动化运行,在人类最少监督下处理多步骤任务,显著提升工作效率,被视为高杠杆助手而非完全自动化的收入机器。
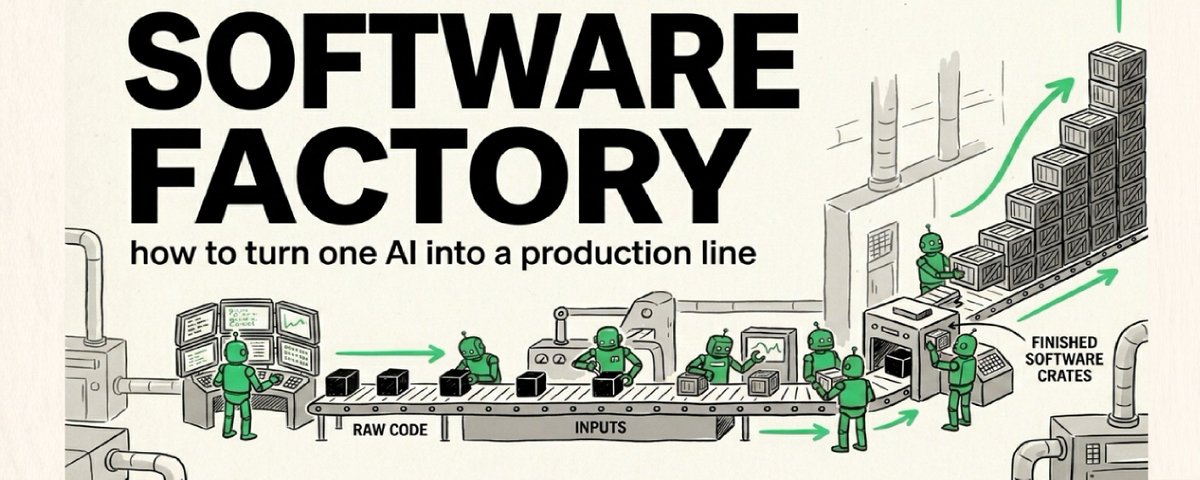
本文介绍了如何通过构建“软件工厂”将单一AI转化为高效的生产线。文章详细阐述了利用队列系统、独立工作空间、权限隔离和质量门控四个组件,实现AI代理的自动化协作与任务调度,从而提升软件开发效率并降低成本。
文章介绍了 Claude 的三大核心能力:Agents(代理)、Loops(循环)和 Graphs(图)。文章详细解释了如何通过工具、记忆和循环机制构建从 Level 1 到 Level 4 的自主代理,提供了研究、数据分析和代码编写三种代理的 System Prompt 模板,并探讨了如何解决长任务中的记忆丢失问题。
文章分享了作者试用开源项目“Moonlit Stories”生成英文绘本的体验。作者指出,该项目成功的关键在于将内容、视觉、音频等流程固化成契约,让Agent按规范执行。这表明个人利用本地模型和Agent工作流,已能独立交付过去需专业团队完成的完整产品。
文章介绍了Anthropic工程师采用的“图工程”方法,通过将Agent控制从模型内部转移到图结构节点,解决了长任务中的状态丢失和漂移问题。文章详细阐述了如何构建评判器、编写规则书、测试规则及将状态存储在磁盘而非上下文窗口中,从而实现大规模代码迁移和自动化审查。