我们如何将 Playbook 审查重建为多智能体系统
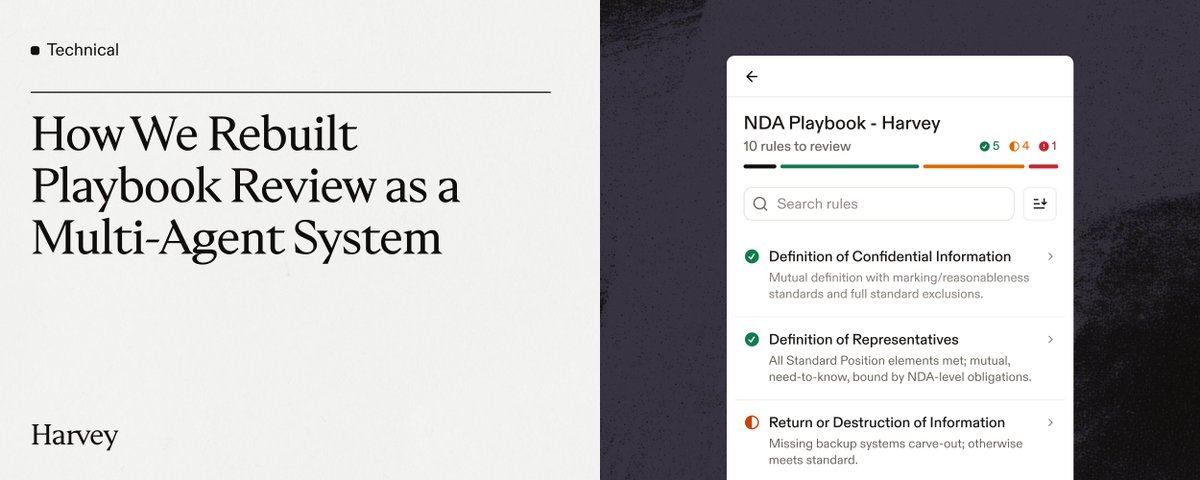
Harvey 团队将合同 Playbook 审查引擎从基于固定提示词流水线的旧系统重构为多智能体系统。文章分析了合同审查的难点:复杂的条件逻辑、规则间的交叉依赖、交易情境影响判断、最小编辑原则以及需人工升级的决策。旧流水线架构存在上下文丢失、按条款孤立编辑、建议互相冲突等问题。团队与内部法律团队共建了评估基准,将法律判断量化,并据此设计了新的多智能体架构,以分析文档、标记风险并提出律师可信赖的精准修订建议。
Harvey 团队将合同 Playbook 审查引擎从基于固定提示词流水线的旧系统重构为多智能体系统。文章分析了合同审查的难点:复杂的条件逻辑、规则间的交叉依赖、交易情境影响判断、最小编辑原则以及需人工升级的决策。旧流水线架构存在上下文丢失、按条款孤立编辑、建议互相冲突等问题。团队与内部法律团队共建了评估基准,将法律判断量化,并据此设计了新的多智能体架构,以分析文档、标记风险并提出律师可信赖的精准修订建议。
前文字记者作者介绍了自己开发的「写作蒸馏器.skill」,一个可以复刻任意写作风格的 Claude Skill。该工具基于语言学研究方法,将写作风格拆解为六层:词汇统计、文章结构、选题逻辑、视角、认知世界观以及配图排版,通过量化统计和逐篇标注的方式蒸馏出可复用的风格规则档案。使用流程分三步:准备至少20-30篇同体裁完整文章作为素材、让agent自动蒸馏生成Writing-DNA等风格文档、写作时让agent重读风格文件并参考原材料来复现风格。作者对比了蒸馏与微调两种方案,认为小样本场景下蒸馏通过锚定模型注意力更有效。该skill已开源并被超6759人使用,作者也分享了基于它的新写作工作流。
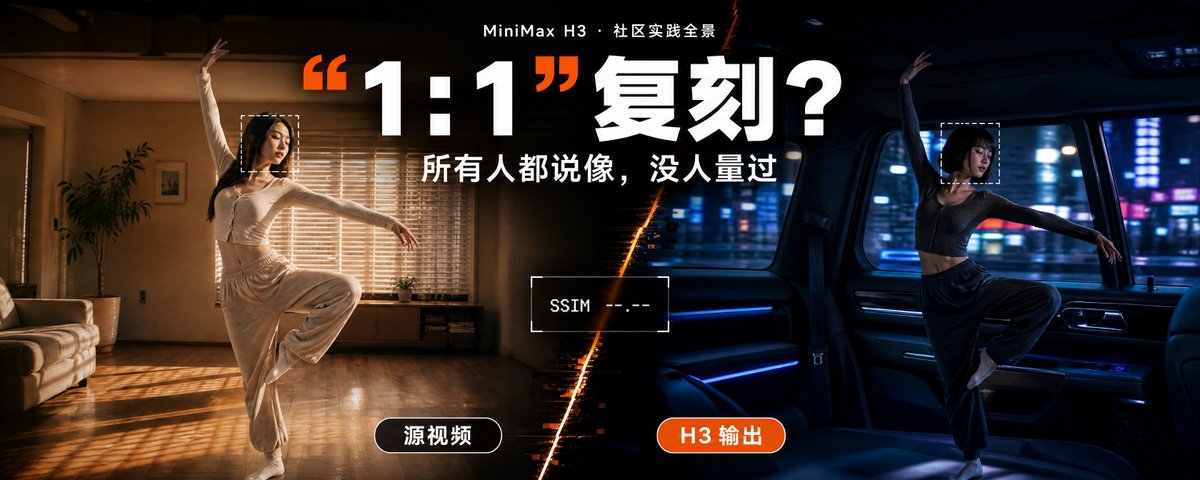
文章系统调研了截至 2026 年 9 月社区对 MiniMax H3 视频编辑模型(Ref2VA)的实践情况,评估其“1:1 复刻”宣传的真实能力边界。作者按证据可信度分级,指出 H3 是整帧重生成而非像素级复制:换人玩法最热但身份稳定性最弱(约半数会丢身份),社区分化出遮罩合成路线保留背景;换背景最稳定;动作迁移最容易翻车。文章还详解官方六段式提示词规范、可直接套用的换人提示词骨架,并汇总身份、画质、音频、工程规格四类失败模式与硬限制,最后指出社区普遍缺乏 SSIM/MAE 量化验证这一空白。
作者分享一套跑了两个月、已开源的 Codex AI 视频自动化工作流。核心思路是让脚本、人物资产、关键帧、视频生成和剪辑共享同一时间线,而非依赖更强的模型。流程包括五步:先做图片路由分工(预览、母帧、关键帧、精修分而治之);用 Midjourney V8.2 建立人物、场景、道具、风格四类母版资产保证一致性;Codex 生成可观察的动作提示词并驱动视频生成与质检;最后用 HyperFrames 以旁白为时钟完成程序化剪辑和信息层。流程保留人工确认门和可复跑记录,实现可复用的 AI 视频生产线。
本文介绍了 Dance Director Skill 的使用方法,该 Skill 能将 AI 从简单的 Prompt 生成器转变为'舞蹈导演'。用户只需提供一张角色图片,AI 即可按照导演规则自动设计编舞、镜头运动和 H3 I2VA 提示词,无需手动编写复杂的舞蹈指令。Skill 支持无音乐时共同创作音乐与编舞,也支持有音乐时根据节拍进行音乐驱动编舞。文章附带了完整的 Skill 内容,涵盖角色设定、动作短语思维、参考图视觉权威、编舞匹配角色、身体力学、动作幅度、音乐性等编舞设计原则。
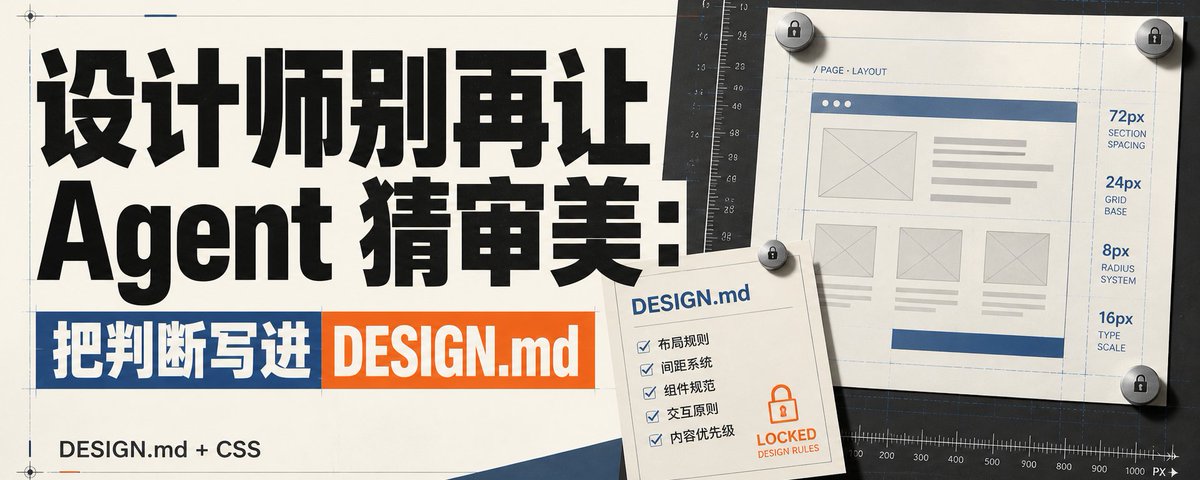
文章介绍 Vercel 如何用 design.md 文件、CSS 样式表和评测闭环,解决 AI Agent 生成页面总「差一点」、需要反复人工修整的问题。核心方法是把工作拆成三层:design.md 写设计判断(读者、信息层级、拒绝的套路),CSS 承接字号、间距、表格等机械性版式约束且不占模型上下文,评测闭环把每次返工转化为可复查的规则。作者强调规则要从模糊感觉翻译成可观察动作,如「别丑」改为「表格全宽」。测试显示公开场景下机械故障从 91 次降到 39 次,约少 57%。建议从一类高频产物入手,把高频修改沉淀为规则,逐步减少返工。
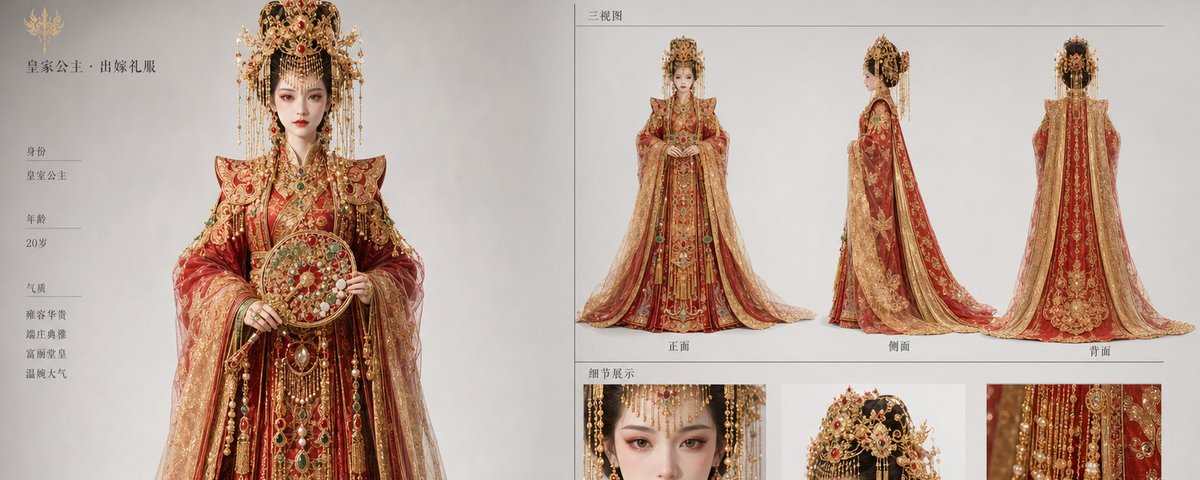
作者分享了研究多年的万能AI角色图提示词框架,解决AI绘图中提示词匮乏和参数繁琐的痛点。用户只需输入一句话人物描述,框架即可自动提取关键信息、推断缺失参数、生成配色方案、套用固定模块,输出包含渲染标签、光影系统、画面结构、角色设定、服化道细节、负面提示词的完整生图提示词。框架内置性别与身份服饰适配表和多种风格映射表(3D次世代、2D日系、水墨国风等),支持豆包、即梦等工具使用。
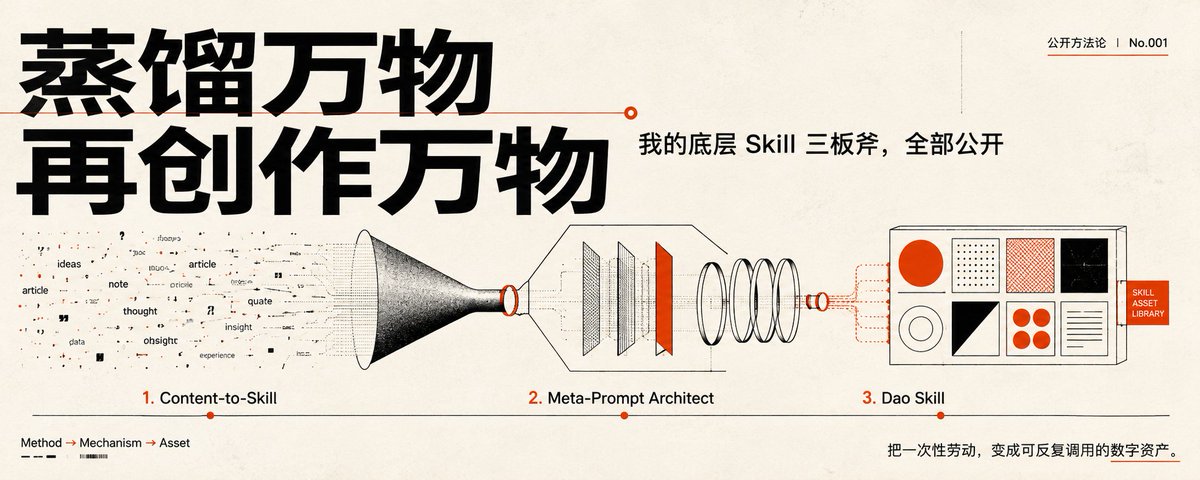
作者分享了在 YouMind 平台累计获得约 601.94 美元的成果,并完整公开其 Skill 创作三板斧方法论:Content-to-Skill 用于从文章、课程等材料中蒸馏出可复用机制;元提示词架构师将机制重构为可执行、可测试的指令系统,强调先写失败清单再写提示词;道 Skill 借鉴道家思想,对 Skill 进行归根、结构化封装与验证。作者推荐按蒸馏→写指令→封装验证的顺序生产,并指出真正值得复制的不是提示词本身,而是从真实问题出发、手工跑通流程、持续迭代验证的路径。
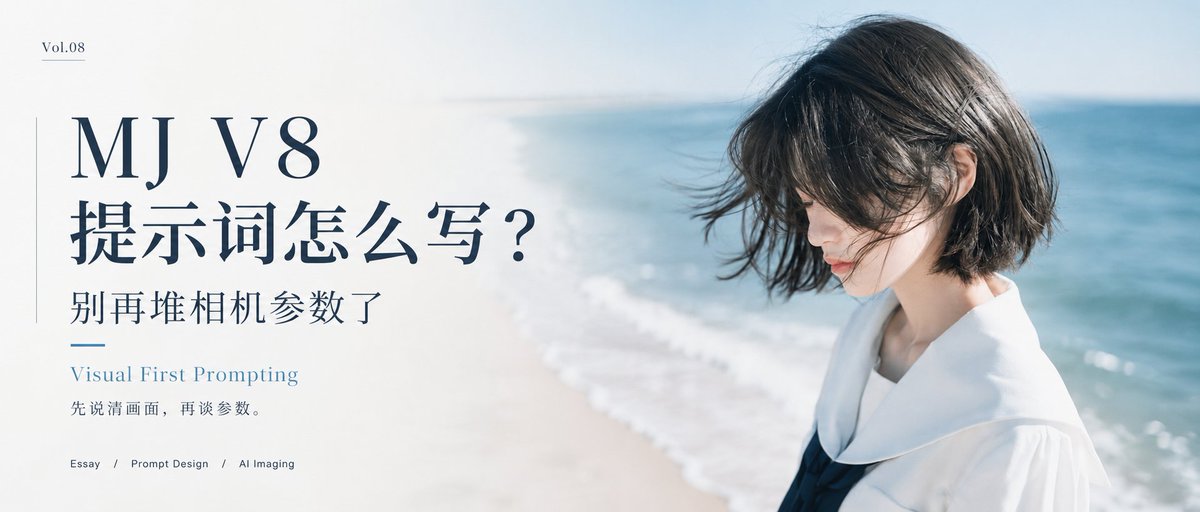
文章讲解了 Midjourney V8 摄影类提示词的正确写法,指出堆砌相机参数(如机身型号、光圈、快门)并非最优解,应遵循“主体与动作→景别与角度→镜头感觉→光线→胶片质感→参数”的顺序结构化描述。作者详细解释了景别与机位选择、各类镜头词的画面倾向、光线要写可见结果而非数字参数、质感词的作用,以及 --ar、--raw 等参数的正确用法。还提供了中文+英文混合写作的实用方案,以及细节丢失时的排查顺序,帮助写出结构清晰、可控可改的 Prompt。
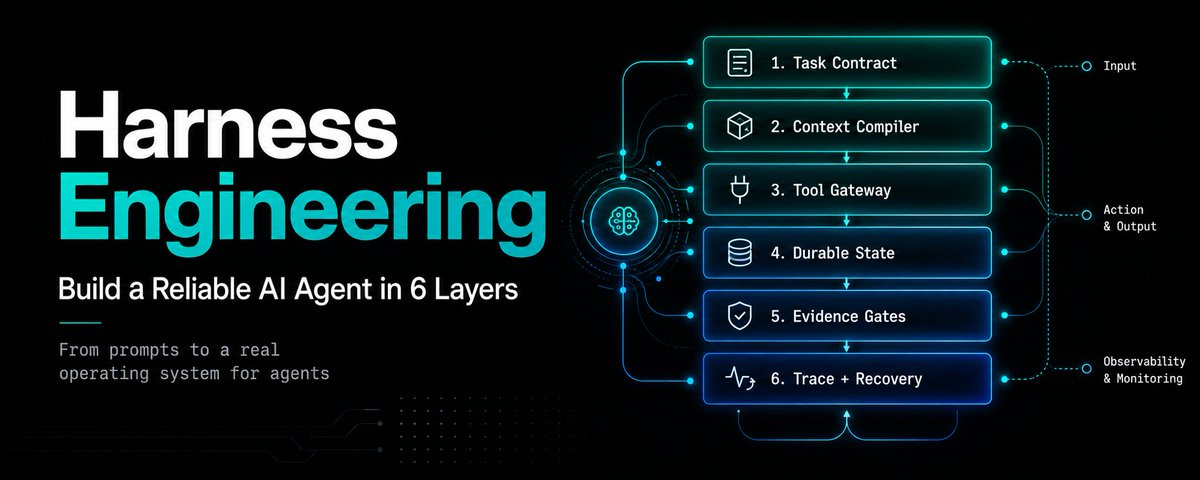
文章提出构建可靠 AI Agent 的关键不在于更好的提示词,而在于模型周围的 Harness(工程脚手架)。作者借鉴 OpenAI 用 Codex 零手写代码构建产品的经验,提出六层最小可行 Harness:1) 将请求转化为明确的任务契约,定义目标、约束与完成条件;2) 用上下文编译器按需提供高信号信息而非堆料;3) 在模型与工具之间设置网关,做权限校验与结构化观察结果;4) 将记忆外化为持久状态,区分事实、决策、状态与教训;5) 以证据门控完成判定,用测试与验证结果决定接受、重试或上报;6) 建立追踪与恢复循环。
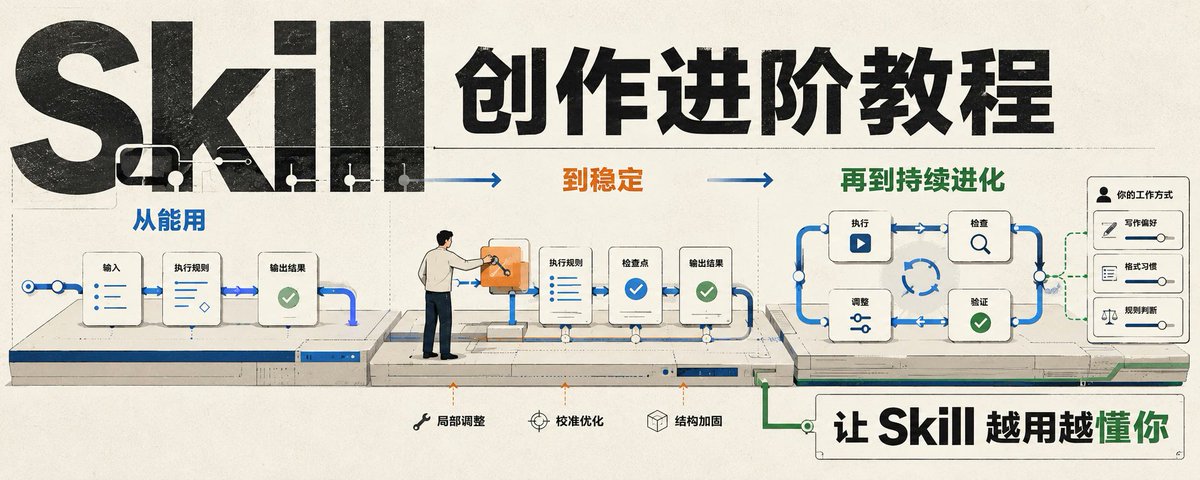
文章讨论 Skill 写完后的持续维护问题,指出 Skill 会随时间腐烂:重复规则、过时参数、失败补丁不断堆积。作者在 Matt Pocock 六种失效模式基础上,扩展为八项检查:过早完成、重复、沉积、蔓延、空操作、否定式引导、样本过拟合和分支串线。针对每种问题,文章给出症状、成因和修复方法,强调先给失败命名再修改,修复后做回归测试。最后提供一份十项体检清单和可直接使用的审计提示词,帮助诊断和优化正在使用的 Skill,让 AI 在正确时间稳定执行正确过程。
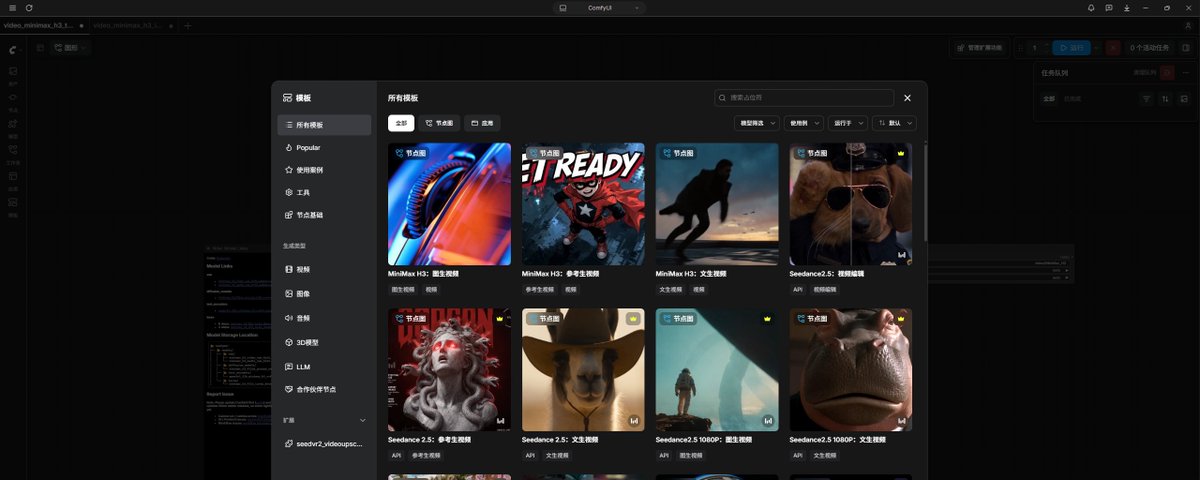
本文是 MiniMax H3 视频生成系列第二篇,作者在 4080 12G 显存笔电上用 ComfyUI 本地运行 H3。文章首先分析官方公开的九套 Skills,涵盖产品广告、品牌宣传、纸拼贴、纸艺定格、歌词贴字 MV、3D 动画、手绘实拍融合和双人游戏开场,并附自制案例视频。随后详解 H3 提示词写作规范:先确定任务模式(T2VA/I2VA/FL2VA/L2VA/Ref2VA),为参考素材分工,定义视觉系统,单独列出屏幕文字的进入、可读与退出状态,按时间线写主体动作与运镜,将声音分为剧情内音景与非剧情配乐,规定转场继承方式,并明确结尾定格,最后给出一份可直接复用的 Prompt Spec 模板。
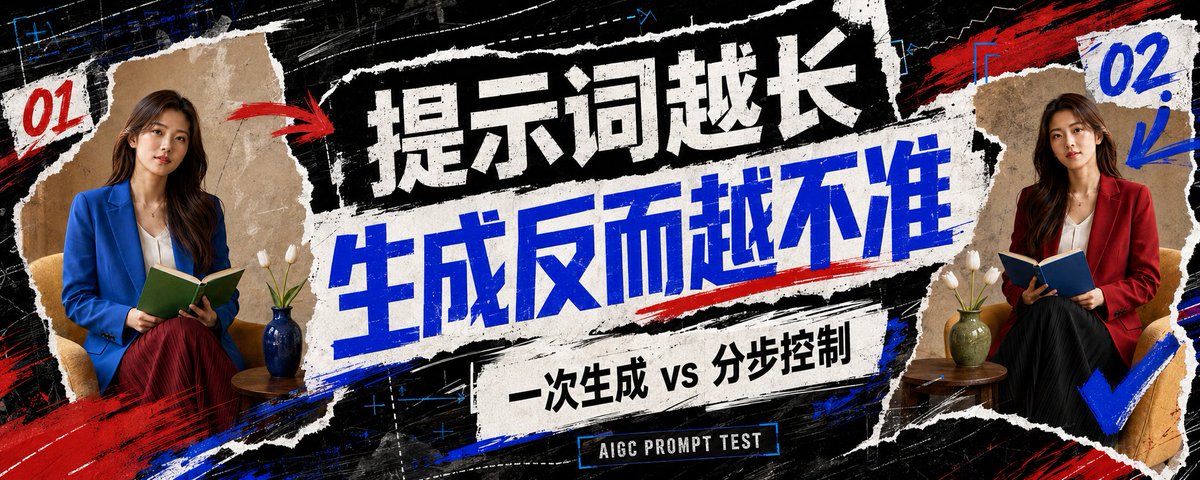
文章探讨了提示词工程中的一个常见误区:提示词越长,生成结果不一定越准确。当提示词同时包含过多人物属性、颜色、物体数量和空间关系时,模型可能生成看起来不错却悄悄偏离关键要求的图片。文中通过长提示词与精简提示词加分步编辑的对比实验说明,约束越多,属性串位、关系混乱和细节遗漏的概率越高。DetailMaster 研究证实,随提示词长度增加,文生图模型在人物属性、位置和实体关系上的准确率一致下降。作者建议不要把提示词写成一次性需求文档,而应先用短提示词锁定主体和构图,再通过局部编辑逐层增加细节,每轮只修改一类变量。
作者分享了在RTX 4070 16G显存电脑上本地部署MiniMax H3视频生成模型的完整经验:使用精简版ComfyUI和turbo lora模型(6步生成480P,超分至1080P),并让AI工具搭建了手机可远程调用的自动化系统,支持文生视频、图生视频、首尾帧等功能。文章详细说明不同分辨率下的时长与耗时数据,总结了低分辨率视频的美学要点(适合风景、特写、慢镜头),并附上完整的30秒电影复刻级英文对白短片提示词,涵盖镜头设计、人物一致性、声音设计与避坑指南。
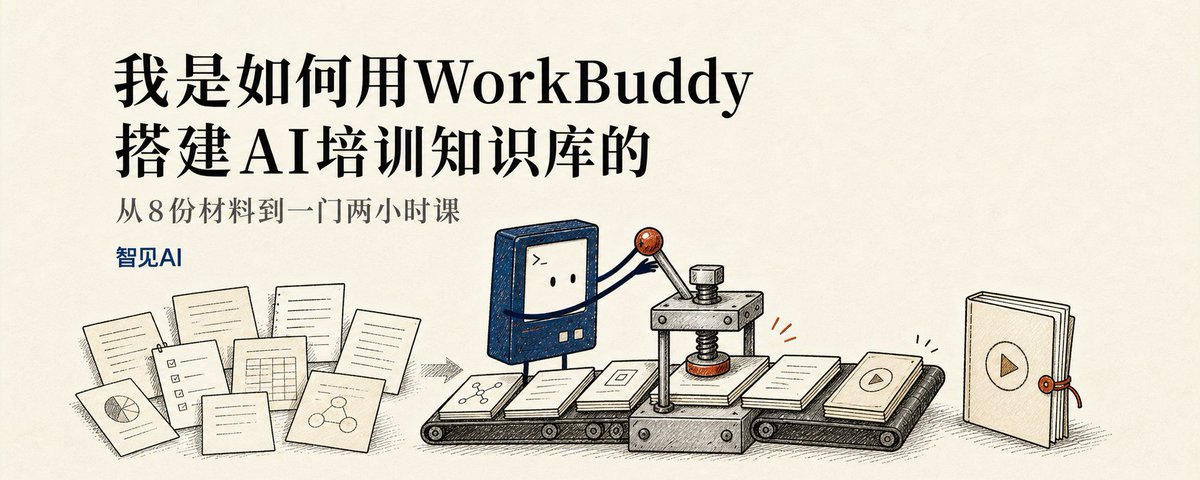
作者分享了用WorkBuddy搭建AI培训知识库的完整实战经验。文章指出收藏夹和搜索无法让AI真正理解业务,核心问题在于保存不等于复用、搜索无法判断内容责任、一次性对话不会积累经验。作者从8份散乱材料复建了一个最小Wiki,设计了原始材料、来源卡、知识页、入口地图和交付物五个核心层,并通过设计一门两小时企业AI入门课来验证知识库的实际价值。文章还总结了AI建库初犯的错误(如未审核就标记live)、课程经验回写机制、定期Lint体检以及自动化来源雷达采集等持续运营方法,强调知识库的复利来自每次取舍都有理由。
作者用相同的提示词、品牌素材和数据让 Claude Code(Opus 5)和 Codex(GPT-5.6 Sol)各构建八个网站,从设计质量、Agent 数量、耗时、输出 token 和 API 成本多维度对比。结果是 Codex 在开放式设计环节赢得六轮中的五轮,效率优势显著:Codex 仅用 9 个 agent、约 5 小时、55 万 token、约 100 美元,而 Claude Code 用了 25 个 agent、14 小时、近 300 万 token、约 444 美元。实验还发现当提示词足够具体时,两者产出几乎一致。
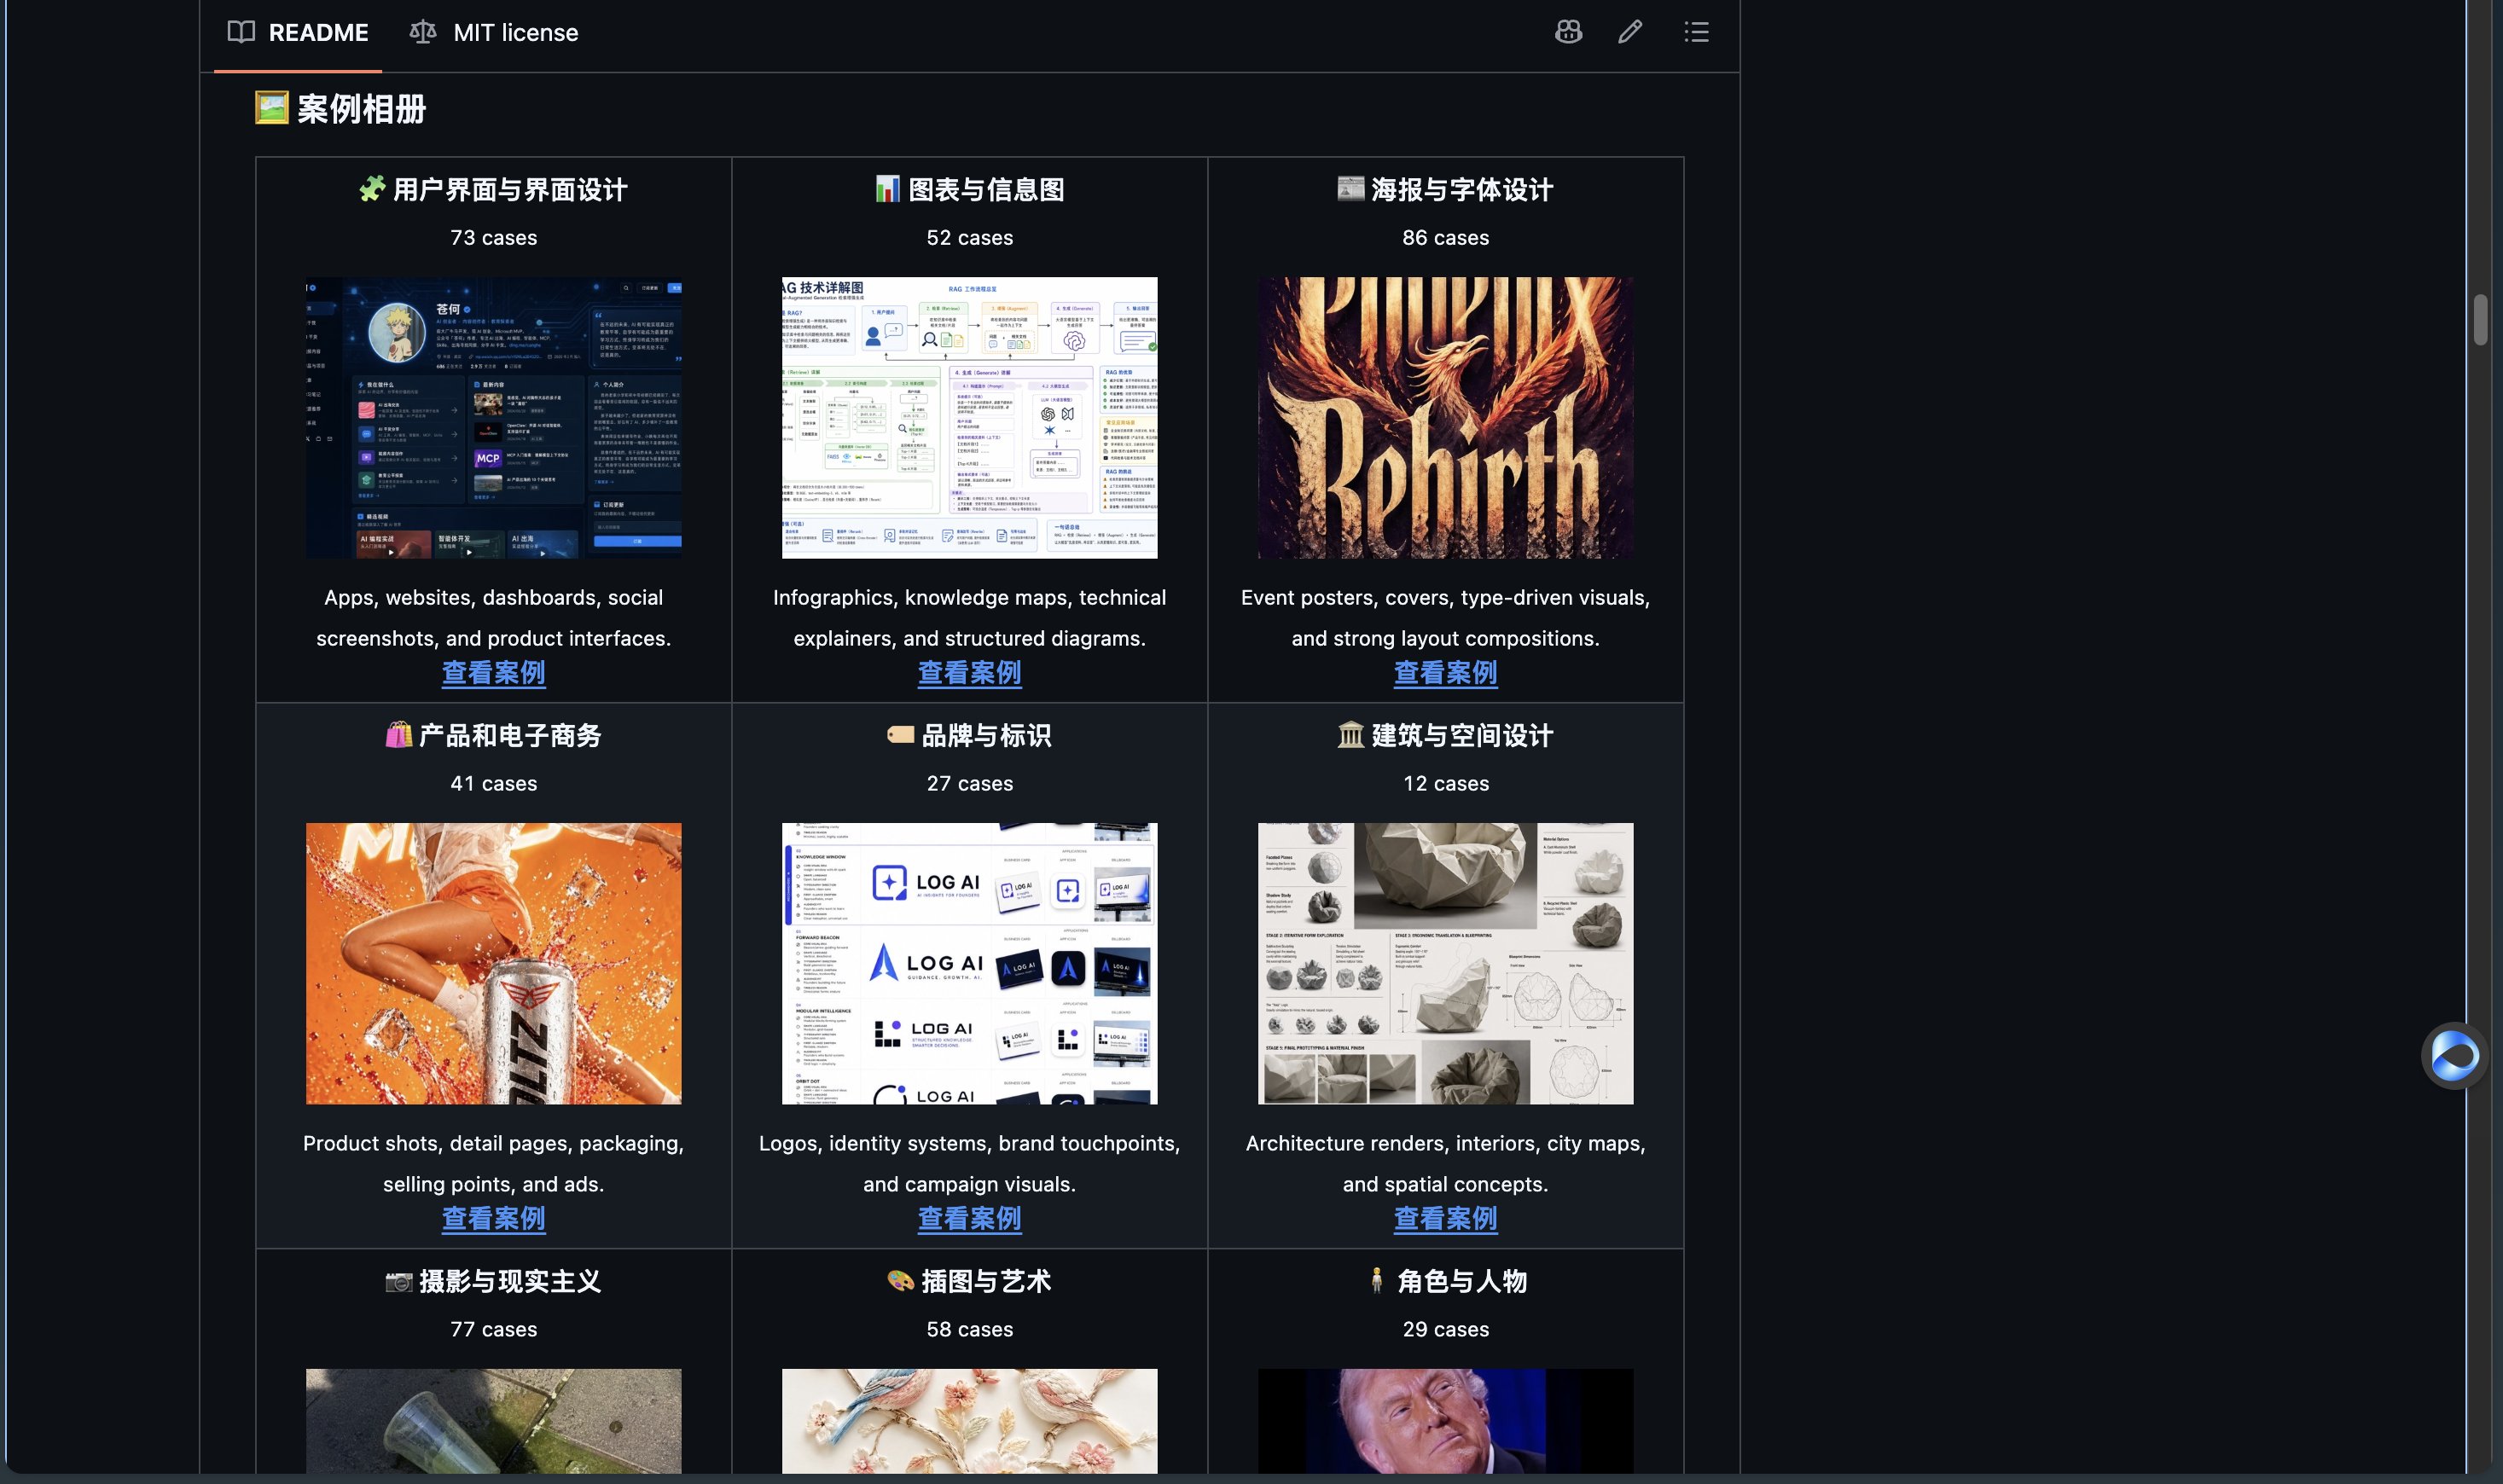
森叔推荐苍何的开源项目 awesome-gpt-image-2,该项目登顶 GitHub 趋势榜第一,堪称 GPT Image 2 的应用百科全书。项目包含 532 个覆盖 UI、信息图、海报、电商等 13 个方向的图片案例,以及 22 套结构化提示词模板。还提供 gpt-image-2-style-library Skill,可安装到 Codex、Claude Code、Cursor 等 Agent 中,自动匹配模板和风格生成可用提示词。项目采用 Prompt as Code 思路,适合批量生成与 Agent 自动调用,对经常制作海报、课程封面、信息图的用户极具收藏价值。
作者介绍了其 XXD Panel 系统:56 个各自独立、各守一套审美的“士兵”Skill,配合负责推荐、点将、试稿和批量派发的“将军”Skill(xxd-panel-all),解决风格多样后如何选择、批量制作如何提效的问题。每位士兵保留独立原始提示词,互不混血,支持上下、左右、纯设计、壁纸包四种交付模式和批量目录处理。文章详述了 56 位士兵的风格特长分组、适用人群、质量控制逻辑及入门方式。
文章探讨了AI生成多人视频时角色站位混乱的问题:提示词写得越详细,混入多套参照系(世界坐标、镜头画面坐标、人物互动关系),模型反而越乱。作者提出三层方法:用俯视图锁定房间空间关系,用编号映射锁定角色身份,用逐秒时间码描述当前镜头画面。并建议先做3-5秒无对白测试,定位错误层级后只修对应层,而非重写整段提示词。跨空间移动时应重建新的站位图。
本文系统讲解如何编写和维护 Claude Code 的 CLAUDE.md 与 Codex 的 AGENTS.md 等长期指令文件。核心观点是:规则越多 Agent 反而越容易跑偏,指令文件应只保存 Agent 无法从代码推断的隐性知识。作者提出先做减法(三问:能否从项目找到、是否多数任务都用、是否长期成立),再做加法(五个问题提取业务规则、固定入口、联动关系、完成标准和权威资料),并给出内容分流表、最小模板、双工具共用一份文件的方案、加载验证方法、修剪维护节奏,以及一段可直接使用的审计提示词。
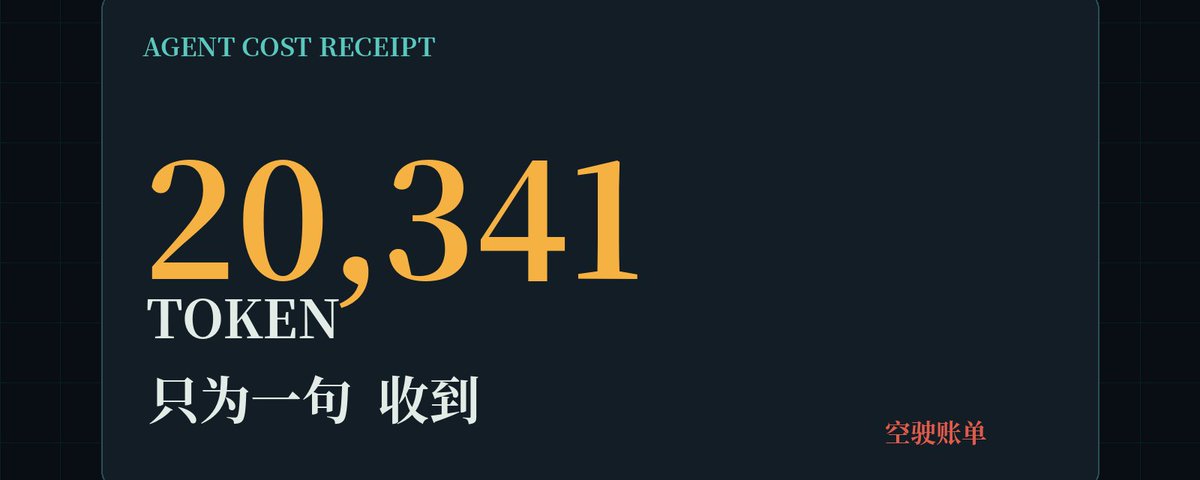
作者发现验证Agent成员是否存活时,一句简单的「收到」竟消耗两万个token,原因是每次对话都要重新装配成员的身份、记忆、技能清单等。文章剖析了Agent成本的三层「过路费」结构:身份装配、上下文搬运和格式开销,指出七成token花在空驶而非思考上。作者提出三刀止损法:利用前缀缓存把不变内容前置、健康探针直连绕过人格装配、协作转手只传摘要。实施后成本降了一半以上,但同时也暴露出便宜诱发滥用、缓存惩罚变动等新问题,并引出本地化部署的机会成本与主权优势思考。
本文提出一套系统性的Agent语义工程蒸馏方法论:从模型API请求终点出发,通过逆向溯源、注入源穷举、工具三层分析(引导、行为包装、结果封装)、多agent协作语义、记忆定义、时间轴动态策略、语言表达分析等维度,深入提取Agent框架的上下文组装与语义设计模式。文章还涵盖框架强相关与通用指导的区分、基于提交历史等证据的开发者意图推断,以及以世界观塑造为首要标准的评价体系,为学习和迭代Agent harness提供全局认知框架。
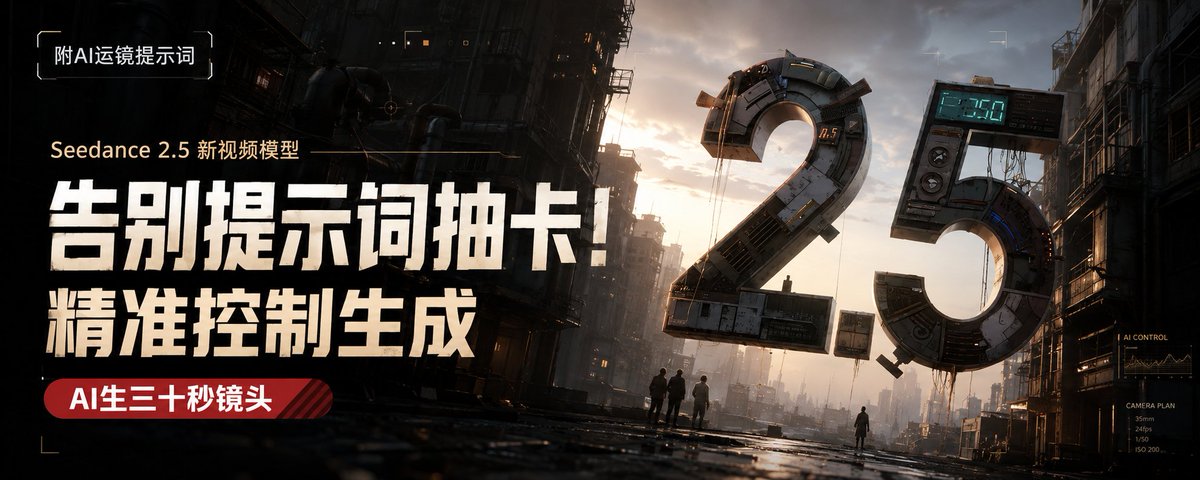
文章指出使用Seedance 2.5时堆砌超长提示词的误区,提出AI视频控制的新思路:图片、视频、音频、白模等多素材各司其职,Prompt只需回答素材职责、禁止复制项、不可退让条件、保留与改变项、冲突优先级五个问题。作者分享了完整Prompt模板、分层控制方法(固定项/方向项/放手项)以及“一轮只改一个变量”的迭代技巧,强调从写咒语猜结果转向提供正确答案让模型执行。
作者认为Grok Bot被严重低估,它正从被动聊天AI转变为持久在线的自主执行引擎。其核心优势包括:专属云运行环境(带真实浏览器、文件系统和持久登录)、实时网络与X平台数据接入、无需API即可视觉操控各类网站工具、以及多Agent并行深度搜索。文章提供了四个高杠杆提示词框架(趋势预测、竞品审计、自主内容架构、多Agent代码审计),并展望其在VC尽调、销售GTM和软件工程等领域的变革潜力,称xAI正在构建现实世界执行的操作系统。
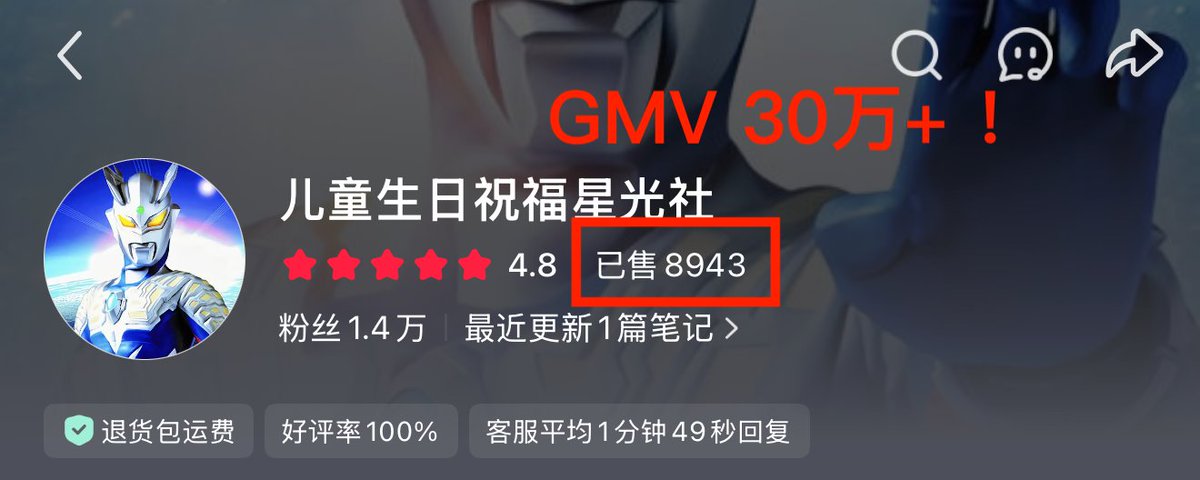
作者发现小红书和海外平台上「儿童个性化生日定制视频」这一暴利虚拟商品赛道,单条售价29-49元,已有单品卖出近10万元。作者开源了一套基于AI视频生成的折纸定格动画工作流,包含视觉风格锚点设计(纸张质感、柔和布光、马卡龙色调)、30秒黄金三段式分镜架构(创意出场、生日祝福、暖心叮嘱)、提示词工程技巧(风格锁后缀、参考图生成专属折纸小人)。单条30秒高清短片算力成本不到5毛钱。文章还提供了四大变现出口:国内定制服务、海外短视频出海、早教机构合作、不露脸自媒体起号,并将全套代码开源在GitHub,支持五种语言。
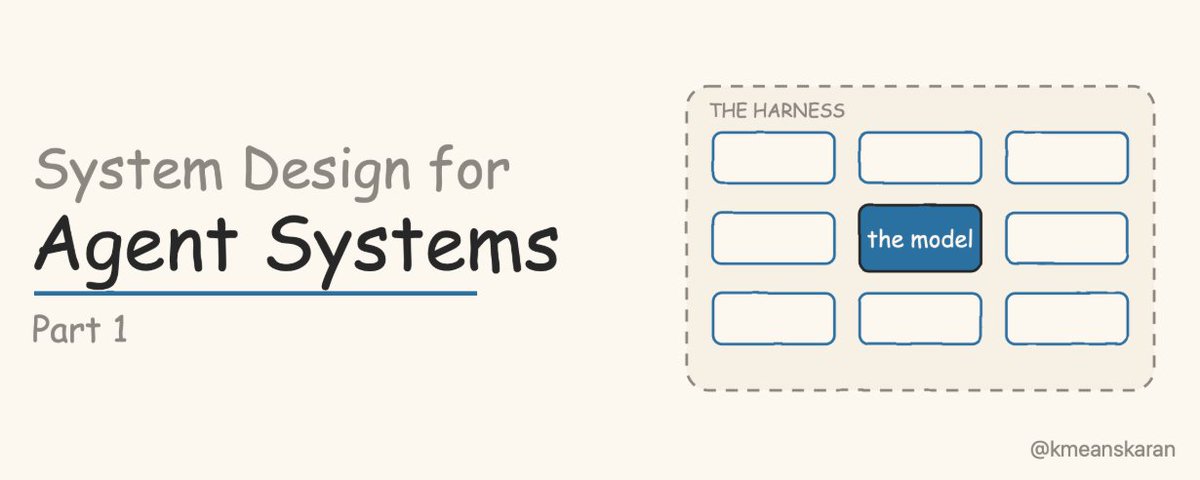
本文深入探讨了代理系统设计的基础与核心组件。作者指出,将前沿模型放入设计糟糕的代理系统只会得到更清晰的失败,因此工程重点应放在模型之外的代理框架(harness)上。文章首先对比了代理工作负载与传统Web请求的差异,强调代理任务耗时、I/O密集、非确定性和高边际成本,并由此推导出架构设计原则。随后,文章详细介绍了代理框架的四个关键组件:工具(Tools)的设计契约与最佳实践、提示词工程(Prompt Engineering)的结构化方法与版本管理、记忆(Memory)的短期与长期区分及上下文管理,以及多代理编排(Orchestration)的并行与顺序模式。所有内容均基于一个真实的五代理系统DevVoice,提供了实用的设计决策与代码示例。
本文介绍了一套名为“BLACKGLASS ASCENDANT”的图像生成提示词系统,用于GPT Image Gen V2或Nano Banana Pro。该系统通过三个子系统(Ascendant Frame、Blackglass Lattice、Silverfall Halo)来构建具有视觉冲击力的图像,强调主体支配、材质细节和光影控制。文章详细规定了提示词的生成规则,包括主题确定、表面处理、光照逻辑、色彩方案等,并针对GPT和Nano分别给出了输出格式要求。
作者分享了使用Midjourney v8.2和Seedance 2.5等AI工具为一款产品制作广告的完整流程。文章详细介绍了从角色设计、环境构建到视频生成的每一步,包括角色参考表、环境静态图、视频生成提示词结构以及后期制作方法。作者强调高质量静态图对视频质量的重要性,并提供了具体的提示词示例和生成数量等数据,旨在为读者提供可复制的AI视频制作方法论。
文章针对在 Google Nano Banana 与 OpenAI GPT Image 2 之间迁移图片生成提示词时的常见误区进行辨析。作者指出长提示词翻车的根源不在长短,而在于信息冲突、约束缺乏优先级、参考图职责不清以及一次性要求过多。文章提出'创意简报'与'结构化施工图'两种提示模式应按偏差成本选择而非按模型选择,并给出重做任务定义、约束优先级、参考图职责与迭代方式的四层迁移框架,最后强调模型差异需通过严格的对照实测验证。
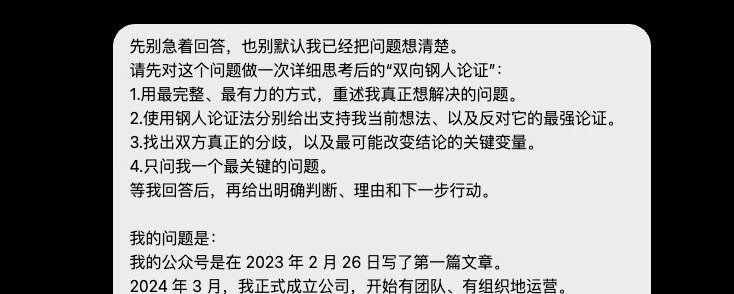
作者从推特上一条让AI先深度思考再回答的Prompt出发,追溯其Reddit原帖,学习了"钢人论证"(steelman)这一源自"稻草人谬误"反义的逻辑方法:先替对方把论点补到最强再判断。为克服AI谄媚、结论含糊的问题,作者设计了"双向钢人Prompt",让AI重述真实问题、强化正反双方论证、找出关键变量,并逼出明确判断与行动。作者以公司选择司庆日为例,成功用它找到了内心最真实的答案。