Wiki 知识库

全部文档 / 标签: 视频生成

259 篇
清除

豆包工作的神奇能力:定时,遥控,连接器,视频,图片,ppt,音乐(保姆级教程)

本文是一篇豆包桌面端的保姆级教程,详细介绍了豆包从聊天AI进化为AI Agent后的各项功能。包括安装登录、左侧导航的7个主入口(新工作任务、新对话、定时任务、技能·连接器·伙伴、手机遥控电脑、云盘、更多)、底部对话模式(对话、视频生成、帮我写作、图像生成、PPT生成、解题算题、音乐生成、更多)、工作任务模式(+号、工作任务、项目、按需确认、技能、连接器、模型与推理强度)以及免费与付费方案。文章还分享了使用技巧和避坑指南,帮助打工人充分利用豆包提升工作效率。

技术 › 工具与效率 产品经理老王霸 2026-09-0917.7 KB 10.4K 38 79

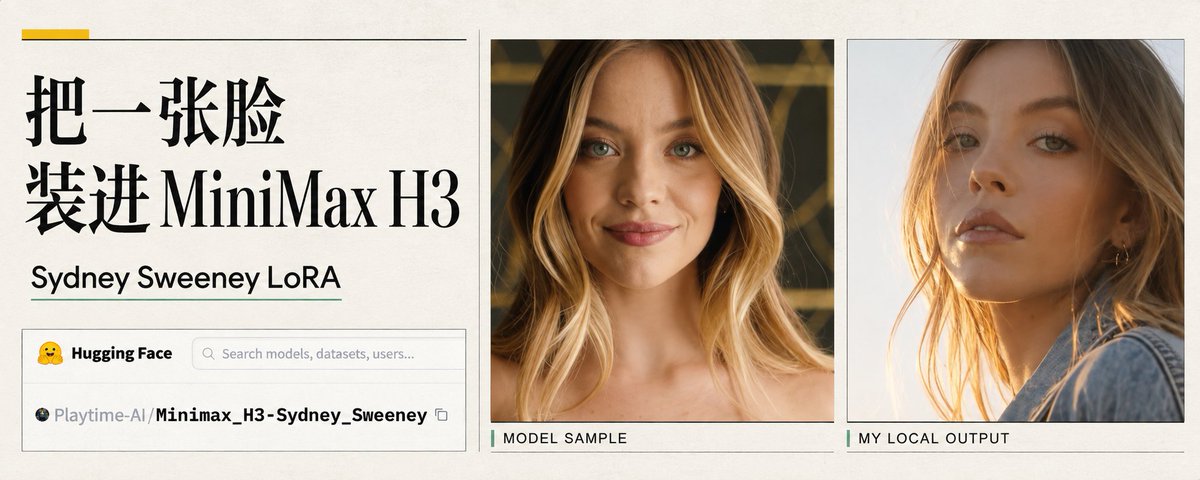
把 Sydney Sweeney 装进 MiniMax H3:人物 LoRA 的原理和本地使用

作者拆解了 Playtime-AI 发布的 Sydney Sweeney 人物 LoRA(仅 155MB)如何在 MiniMax H3 视频模型上无需参考图、仅凭名字生成人物视频。文章讲解 LoRA 低秩自适应原理:冻结基础模型,只训练小矩阵 A、B 记录人物身份差量;还原训练过程(3440 步、120 epoch、rank 16、约 5% caption dropout);并分享本地加载实践,包括底模版本兼容、量化格式、采样步数(6 步而非 30 步才清晰)和触发词拼写等常见坑。最后指出 LoRA 技术正在改变人物身份的传播方式。
技术 › LLM Michael Guo 2026-09-0813.8 KB 32.5K 183 87

Codex 实战系列|零剪辑自动生成爆款视频

本文是 Codex 视频制作实战教程,讲解如何用 Codex 实现从文章或主题到成品视频的全流程自动化。作者介绍了完整的制作路线:生成口播稿、TTS 配音(含用 CosyVoice 复刻个人声音)、基于最终音频建立时间轴、拆解分镜、用 HyperFrames 生成成片,以及用 Remotion 制作固定栏目模板。文章还对比了 HyperFrames 与 Remotion 的选择策略,并补充了用 video-use 处理真人口播剪辑的方法。核心原则是先定稿声音再做画面,避免返工。零剪辑基础的新手只需将 GitHub 仓库链接交给 Codex,即可完成工具安装和视频生成。

技术 › Codex Miles Ma 2026-09-0819.5 KB 877K 2.2K 91

我用这个 Skill,复刻了爆款卡点换装视频,效果非常不错!

作者李岳分享了如何用自己开发的开源 Skill「female-outfit-director(女性换装导演)」复刻抖音爆款卡点换装视频。文章详细讲解了换装视频在 AI 生成中的难点,如人物一致性、首帧与视频因果关系断裂、双重身体等问题,并提出以结构母图(九宫格拼贴首帧)为核心的解决方案。Skill 能锁定人物身份、生成 7 套造型的首帧、输出精确到秒的换装时间轴,并内置 12 种换装机制。作者用 Seedance 2.5 实测还原度约 80%,项目已开源至 GitHub 并获 607 Star。作者强调 Skill 的价值在于将复刻爆款的方法论沉淀为可复用的工作流。

技术 › Skill 李岳 2026-09-0712.9 KB 21K 148 83

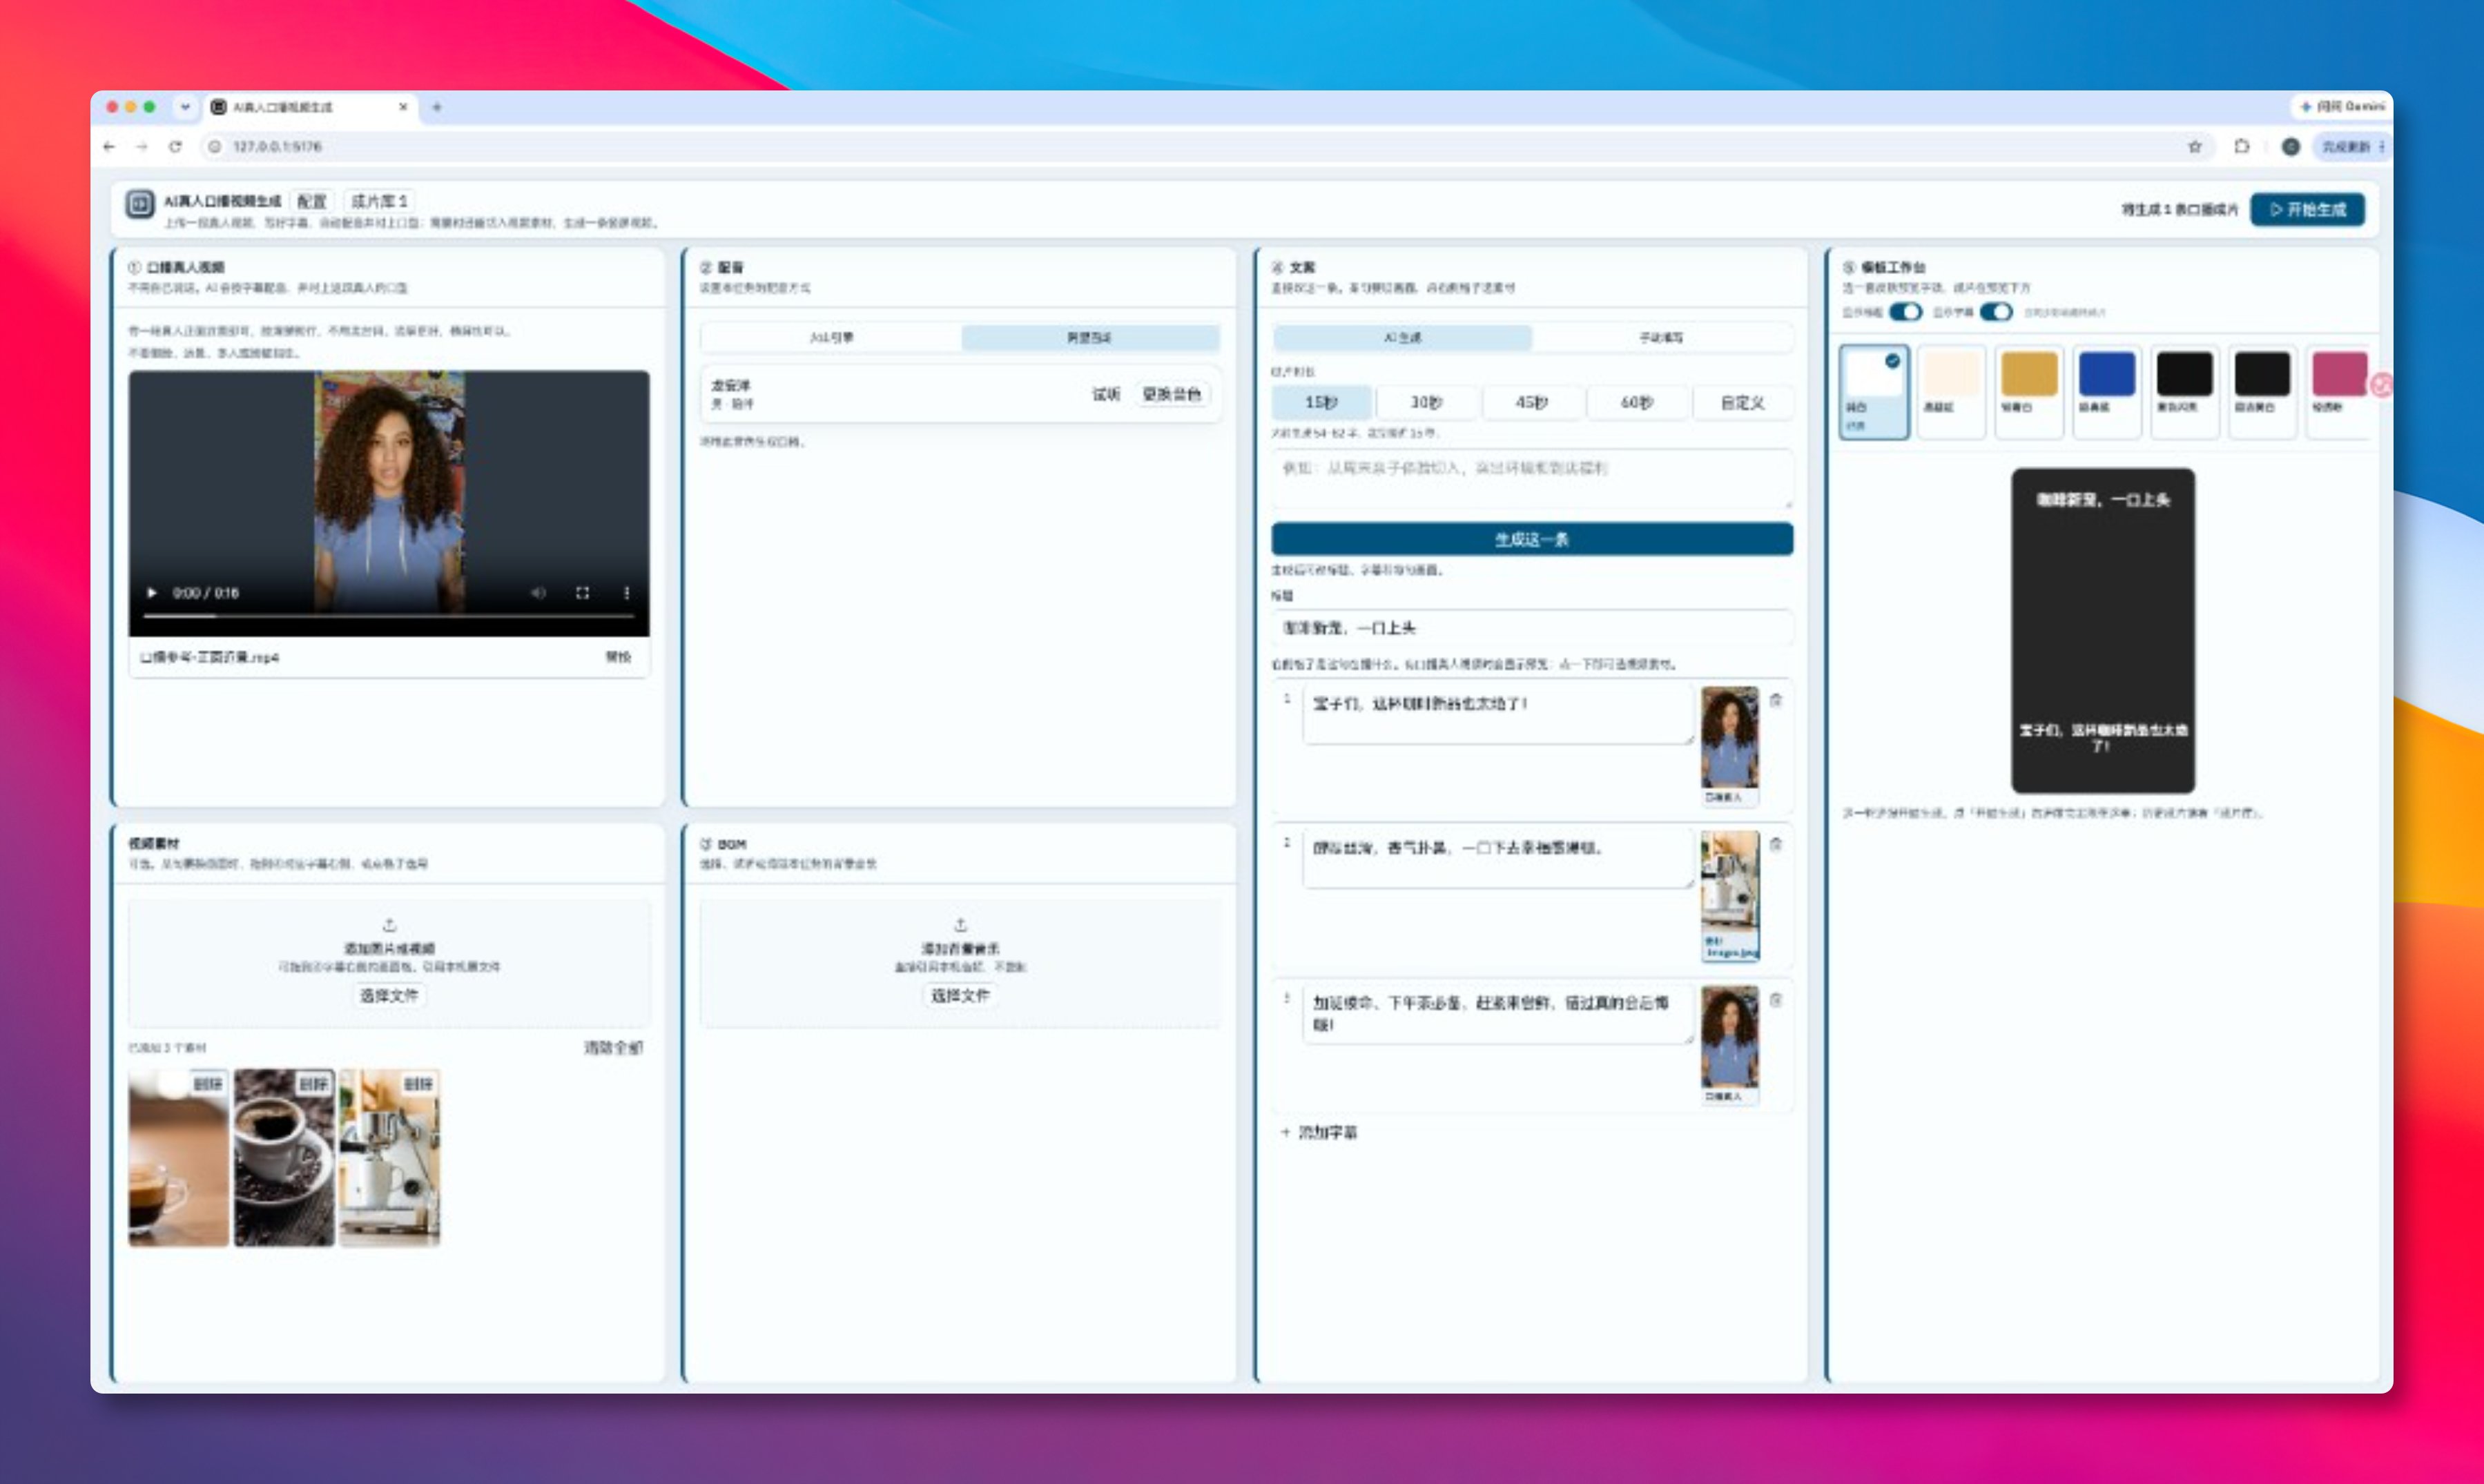
video-ai-talking:开源真人口播视频自动生成工具

文章介绍了一个名为 video-ai-talking 的开源工具,用于自动生成真人口播视频。用户只需提供一段真人出镜视频(无需念台词)和文案,工具即可本机合成竖屏 MP4。流程包括:先用火山引擎或阿里百炼配音,再通过百炼对口型接口合成,最后用 FFmpeg 拼接字幕。支持 DeepSeek 自动生成口播文案,成片时长 15-60 秒可选,字幕有多套皮肤,可自定义画面替换。密钥仅存浏览器、任务和成片均在本地处理,无云端服务器,适合想做知识口播但懒得出镜念稿的用户。

AI 短片制作全流程小白入门教程

本文介绍了从零制作 AI 短片的完整流程,分为四个步骤:人物与场景定妆、分镜与脚本编写、视频/语音/BGM 生成、剪辑与字幕。作者推荐三件套工具:Claude Code、LibTV 和 ChatCut,通过 Agent 实现口喷式创作。文章详细讲解了人物三视图、参考图对保持一致性的重要性,如何用 AI 辅助分镜创作,减少抽卡成本的技巧,以及剪辑时如何将素材变成艺术品。作者分享了首部短片《白夜之后》的创作心得。

技术 › 短剧 Kieran Zhang 2026-09-076.7 KB 99.2K 282 74

H3 AI 换装游戏视频提示词教程:从反复失败到稳定出片

文章分享了用 H3 视频生成模型稳定产出 10 秒 AI 换装游戏视频的完整教程。核心方法包括:具体描写每套服装实现图片与文字双重锚定、将核心规则前置并声明最高优先级、用 identical 替代 match 封死重新解读空间、固定相机保证 UI 与人物同时可见、选择 10 秒时长避免模型跑偏。作者提供了完整的提示词模板和 5 步使用流程,并总结了 8 个失败经验教训,如避免提示词过长、不要套用学术模板等,帮助读者快速稳定出片。

技术 › 提示词工程 AI Dance Paradise 2026-09-0613.2 KB 67K 164 91

靠白模精准复刻动作大片,附保姆级教学

作者分享使用AI视频深度动作捕捉功能制作动作大片的保姆级教学。通过将参考视频(如只狼boss战、成龙电影、蔡徐坤多人舞蹈)转换为白模(无贴图的灰模),剥离与动作无关的信息,只保留人物位置、运动轨迹和机位轨迹,让AI模型不再需要猜测细节。再通过角色绑定和精细提示词,将新角色素材照着白模动作'演绎',实现精准复刻。实测显示该方法大幅降低抽卡次数,多人舞蹈的人物数量与队形也能保持稳定,让AI生成视频具备可控性,并附上完整提示词模板供读者参考。

技术 › 短剧 产品经理老王霸 2026-09-0512.6 KB 159.2K 298 82

55套提示词让AI人物具备影帝般的微表情演技

文章针对AI生成视频人物表情夸张、缺乏灵魂的问题,提出5套可直接套用的微表情提示词方法:情绪阈值控制法(用程度副词+具体面部动作控制情绪幅度)、因果肢体连动法(让身体动作带动表情)、时序演变法(写清情绪变化的起点、转折、终点)、视觉焦点引导法(给眼神具体落点避免死盯镜头)、生理呼吸注入法(加入眨眼、吞咽、呼吸等生理细节)。全部提示词中英对照,适用于即梦、可灵、豆包、千问等视频模型,并附赠55套编号提示词库供读者复制使用。

技术 › 短剧 AI求道者Siri 2026-09-0511.1 KB 84.1K 285 86

AI视频X绘画每日一词:一镜十姿

本文介绍了一种名为「一镜十姿」的AI时装视频生成技巧,核心是让同一人物在同一摄影棚空间中连续完成十个不同姿态,保持身份、服装和场景不变。文章提供了完整的提示词模板,包括15秒9:16竖版视频的生成要求、十个具体姿态序列,以及通过'三把锁'(身份锁、服装锁、动作链)保证一致性的核心逻辑。还给出关键控制点:先测试4-6个姿态验证身份稳定性、姿态间需显著改变轮廓、验收时重点检查转身人脸、交叉迈步双腿和甩衣摆手指三个易错位置。

文档从0-1变60秒竖版短视频

本文介绍如何使用 Google NotebookLM 的 Short Video Overview 功能,将文档直接转化为 60 秒竖版短视频,解决普通人不会剪辑的痛点。作者详细讲解了从准备资料、创建笔记本、选择 Short 模式到编写焦点指令的完整流程,提供了焦点指令写作公式(对象、只讲、不要、开头三要素),并对比了竖版 Short 与横版视频的适用场景。文章还涵盖了权限配额说明、五大避坑指南,以及旧稿翻新、课程笔记、产品说明、会议纪要等创作者实战场景,帮助读者零基础跑通第一条 AI 生成竖版视频。

技术 › 工具与效率 沈美丽子 2026-09-0411.3 KB 89.5K 236 80

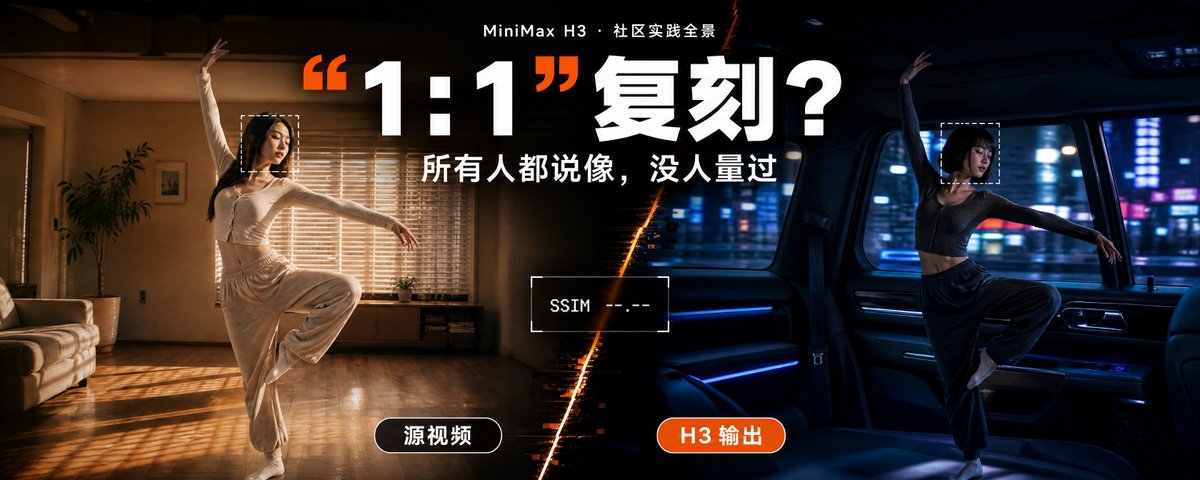
H3 的“1:1”视频复刻与换人换背景:社区实践全景

文章系统调研了截至 2026 年 9 月社区对 MiniMax H3 视频编辑模型(Ref2VA)的实践情况,评估其“1:1 复刻”宣传的真实能力边界。作者按证据可信度分级,指出 H3 是整帧重生成而非像素级复制:换人玩法最热但身份稳定性最弱(约半数会丢身份),社区分化出遮罩合成路线保留背景;换背景最稳定;动作迁移最容易翻车。文章还详解官方六段式提示词规范、可直接套用的换人提示词骨架,并汇总身份、画质、音频、工程规格四类失败模式与硬限制,最后指出社区普遍缺乏 SSIM/MAE 量化验证这一空白。

技术 › LLM huangserva 2026-09-0331.5 KB 43.2K 163 90

如何使用 Dance Director Skill,生成丰富的 H3 舞蹈视频

本文介绍了 Dance Director Skill 的使用方法,该 Skill 能将 AI 从简单的 Prompt 生成器转变为'舞蹈导演'。用户只需提供一张角色图片,AI 即可按照导演规则自动设计编舞、镜头运动和 H3 I2VA 提示词,无需手动编写复杂的舞蹈指令。Skill 支持无音乐时共同创作音乐与编舞,也支持有音乐时根据节拍进行音乐驱动编舞。文章附带了完整的 Skill 内容,涵盖角色设定、动作短语思维、参考图视觉权威、编舞匹配角色、身体力学、动作幅度、音乐性等编舞设计原则。

技术 › Skill AI Dance Paradise 2026-09-0318.9 KB 111.4K 427 83

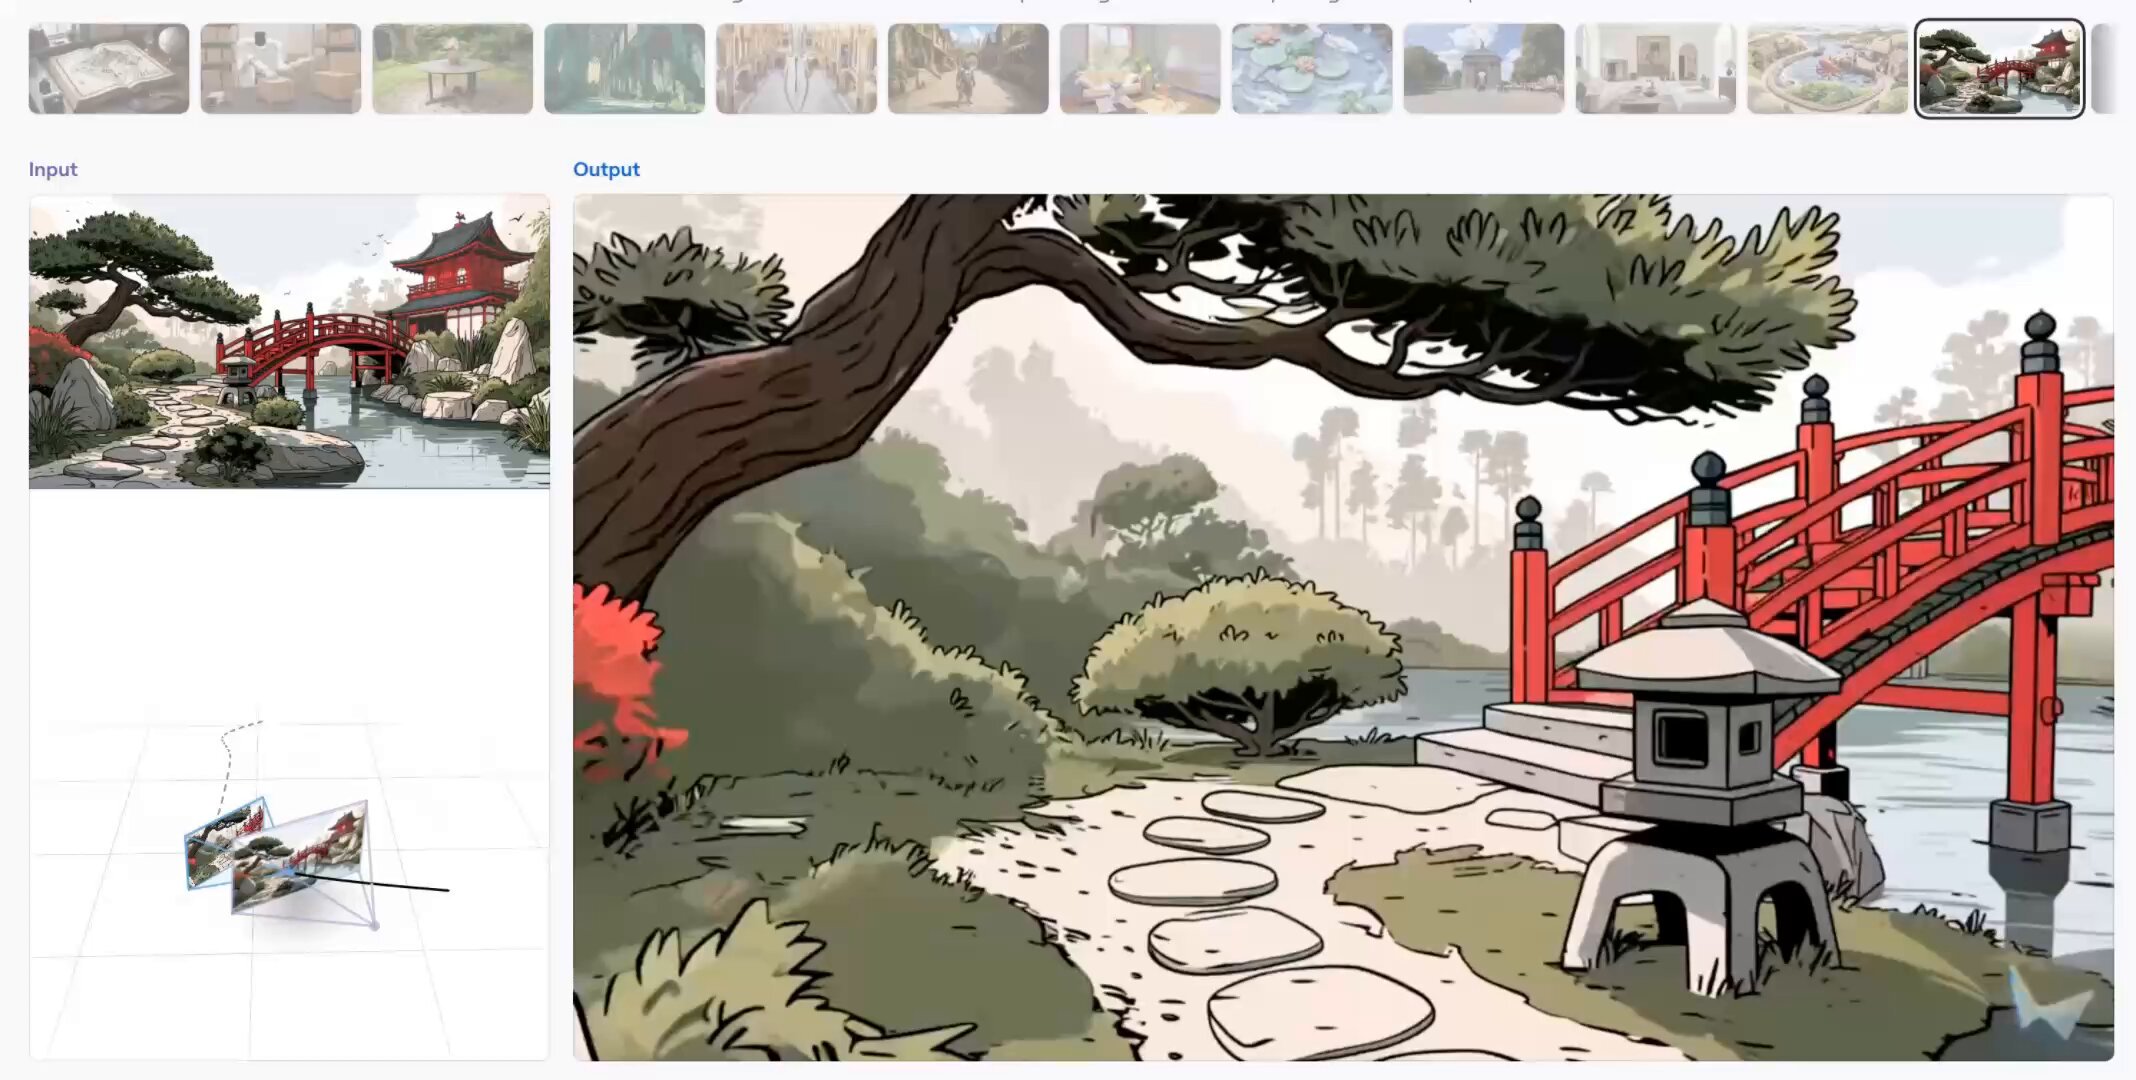
World Labs 发布新一代世界模型 Atlas

李飞飞创立的 World Labs 发布了新的多模态世界模型 Atlas,用户只需一张图片即可创建完整的 3D 空间场景并自由运动,模型还能理解时间演变规律。Atlas 可将多张输入图像锚定在共享三维空间上下文中,支持三大任务:一是从参考图出发,以像素级精确的相机控制生成图像或最长 1 分钟的 1440p 视频;二是用少量图片重建真实 3D 场景,生成点云和 3D 高斯泼溅结果,效果超过专门的 3D 优化模型;三是时空仿真,可将普通手机视频重制为“子弹时间”效果,并为机器人训练生成测试数据。

技术 › LLM 歸藏 (@op7418) 2026-09-021.8 KB 64

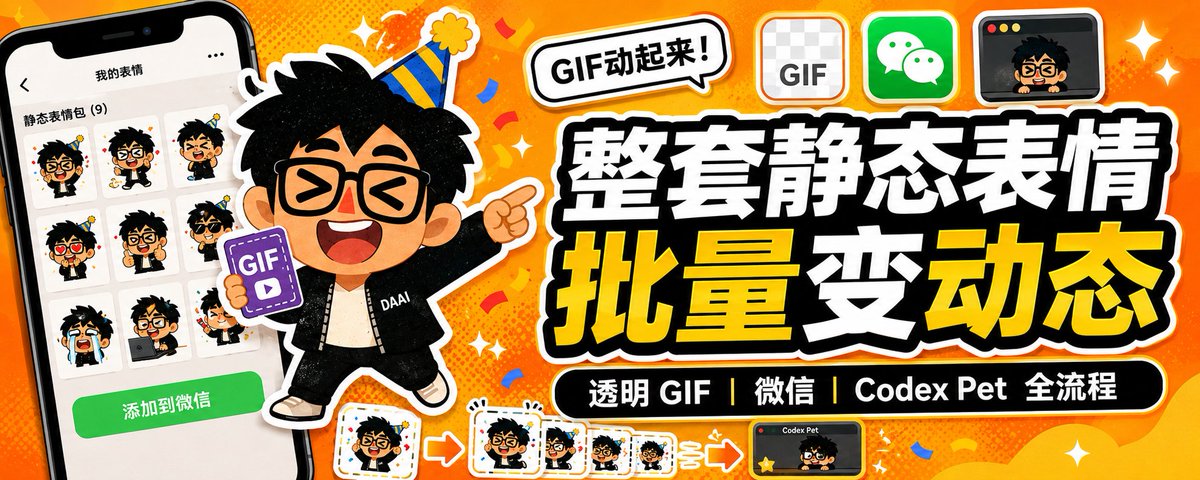
别再一张张做动图了:我把整套静态表情批量变成 GIF,还顺手做成了桌面宠物

本文是表情包制作教程的续篇,讲解了如何把整套静态表情批量变成动态 GIF 并制作成个人 IP 桌面宠物。作者详细介绍了完整流程:用 ChatGPT 生成无外描边的透明九宫格表情并切分打包,填充纯色背景以便后续抠图;然后对比两种批量生成动态 GIF 的方案——用 Grok/豆包等视频模型生成动作后逐帧抠图转透明 GIF,或用 Codex 编写 Pillow 脚本直接生成关键帧动画 GIF。文章分析了两种方案在自然度、一致性、稳定性上的差异,最后介绍了如何将 9 个动作 GIF 制作为 ChatGPT 桌面端的自定义 Pet 桌面宠物。

技术 › 工具与效率 DAAI 2026-09-0123.3 KB 82

别再研究提示词了,我把黄果批量生产短剧的技术栈扒出来了

作者对一张流传甚广的AI短剧《黄果》制作流水线图进行逐帧验证与修正,提出三个关键判断:黄果并非一部剧而是一个多创作者投稿制内容平台;24fps补帧痕迹不能锁定Wan模型,Seedance同为24fps输出;真正的护城河不是13步工序,而是平台持有的'破限模型'。作者进而提出'双轨模型+后期统一'的技术假说,给出五条可证伪预测,并分析了成本结构、法律风险及工艺向合规赛道的迁移价值,强调分析框架比结论更重要。

技术 › 短剧 王大锤 2026-08-3020.1 KB 646.5K 1.2K 82

MiniMax H3 特效提示词分享

作者分享了 MiniMax H3 的特效视频提示词。文章指出 MiniMax H3 的核心优势在于能将手绘图层与实拍的运动逻辑锁定在一起——手持晃动时手绘特效随之同步,不漂不移。作者给出了一个 15 秒洗衣店场景的完整提示词,通过指尖丝线变成水母、袜子、流星、小鱼、火车等连贯变形,最终整间洗衣店变成夜空涂鸦。作者还对比认为 H3 适合生成广告,Seedance 更适合拍电影、做戏剧。

技术 › AI视频 波妞PONYO (@ponyodong) 2026-08-302.2 KB 66

从零开始用 ComfyUI 跑 MiniMax H3(2):官方skill分析与简易示例

本文是 MiniMax H3 视频生成系列第二篇,作者在 4080 12G 显存笔电上用 ComfyUI 本地运行 H3。文章首先分析官方公开的九套 Skills,涵盖产品广告、品牌宣传、纸拼贴、纸艺定格、歌词贴字 MV、3D 动画、手绘实拍融合和双人游戏开场,并附自制案例视频。随后详解 H3 提示词写作规范:先确定任务模式(T2VA/I2VA/FL2VA/L2VA/Ref2VA),为参考素材分工,定义视觉系统,单独列出屏幕文字的进入、可读与退出状态,按时间线写主体动作与运镜,将声音分为剧情内音景与非剧情配乐,规定转场继承方式,并明确结尾定格,最后给出一份可直接复用的 Prompt Spec 模板。

技术 › Skill 阿哲Phil 2026-08-3018.0 KB 33.8K 77 85

H3 Prompt 实战:如何让 AI 真正理解“人物、镜头、动作、音乐”

文章分享了使用 H3 视频生成模型进行高分辨率俯拍镜头控制的提示词实战经验。核心技巧包括:将机位约束放在提示词最顶部以提高识别权重;明确接受俯拍导致的人脸透视变形,打破模型内置的人脸美化逻辑;直接禁止模型为美化人脸而将机位拉回平视的行为;使用 NO、DO NOT 等强否定短句代替解释性长文;保留原图的人物身份与服装参考,但完全替换原图机位、背景与灯光。作者强调,有效的提示词不是解释“什么是俯拍”,而是硬性禁止模型在高分辨率模式下自动修正机位和人脸透视的内部行为。

技术 › LLM AI Dance Paradise 2026-08-2923.6 KB 316.4K 302 80

我用 Codex 做了一套 AI 视觉工作流,就靠这 6 个 Skill

作者李岳分享了基于 Codex Skills 搭建的 AI 视觉工作流,包含六个 Skill:女性写真导演、女性换装导演、通用换装导演、东方仙侠视觉导演、仙侠视频导演和 Seedance 2.5 视频导演。通过将反复踩坑经验转化为规则、路由、默认值和交付格式,把主观审美翻译成可执行的画面参数,形成从人物、服装、场景到镜头和视频方案的完整视觉生产线,强调 Skill 保存的不是形容词而是逻辑判断。

技术 › Skill 李岳 2026-08-2926.4 KB 117.1K 160 87

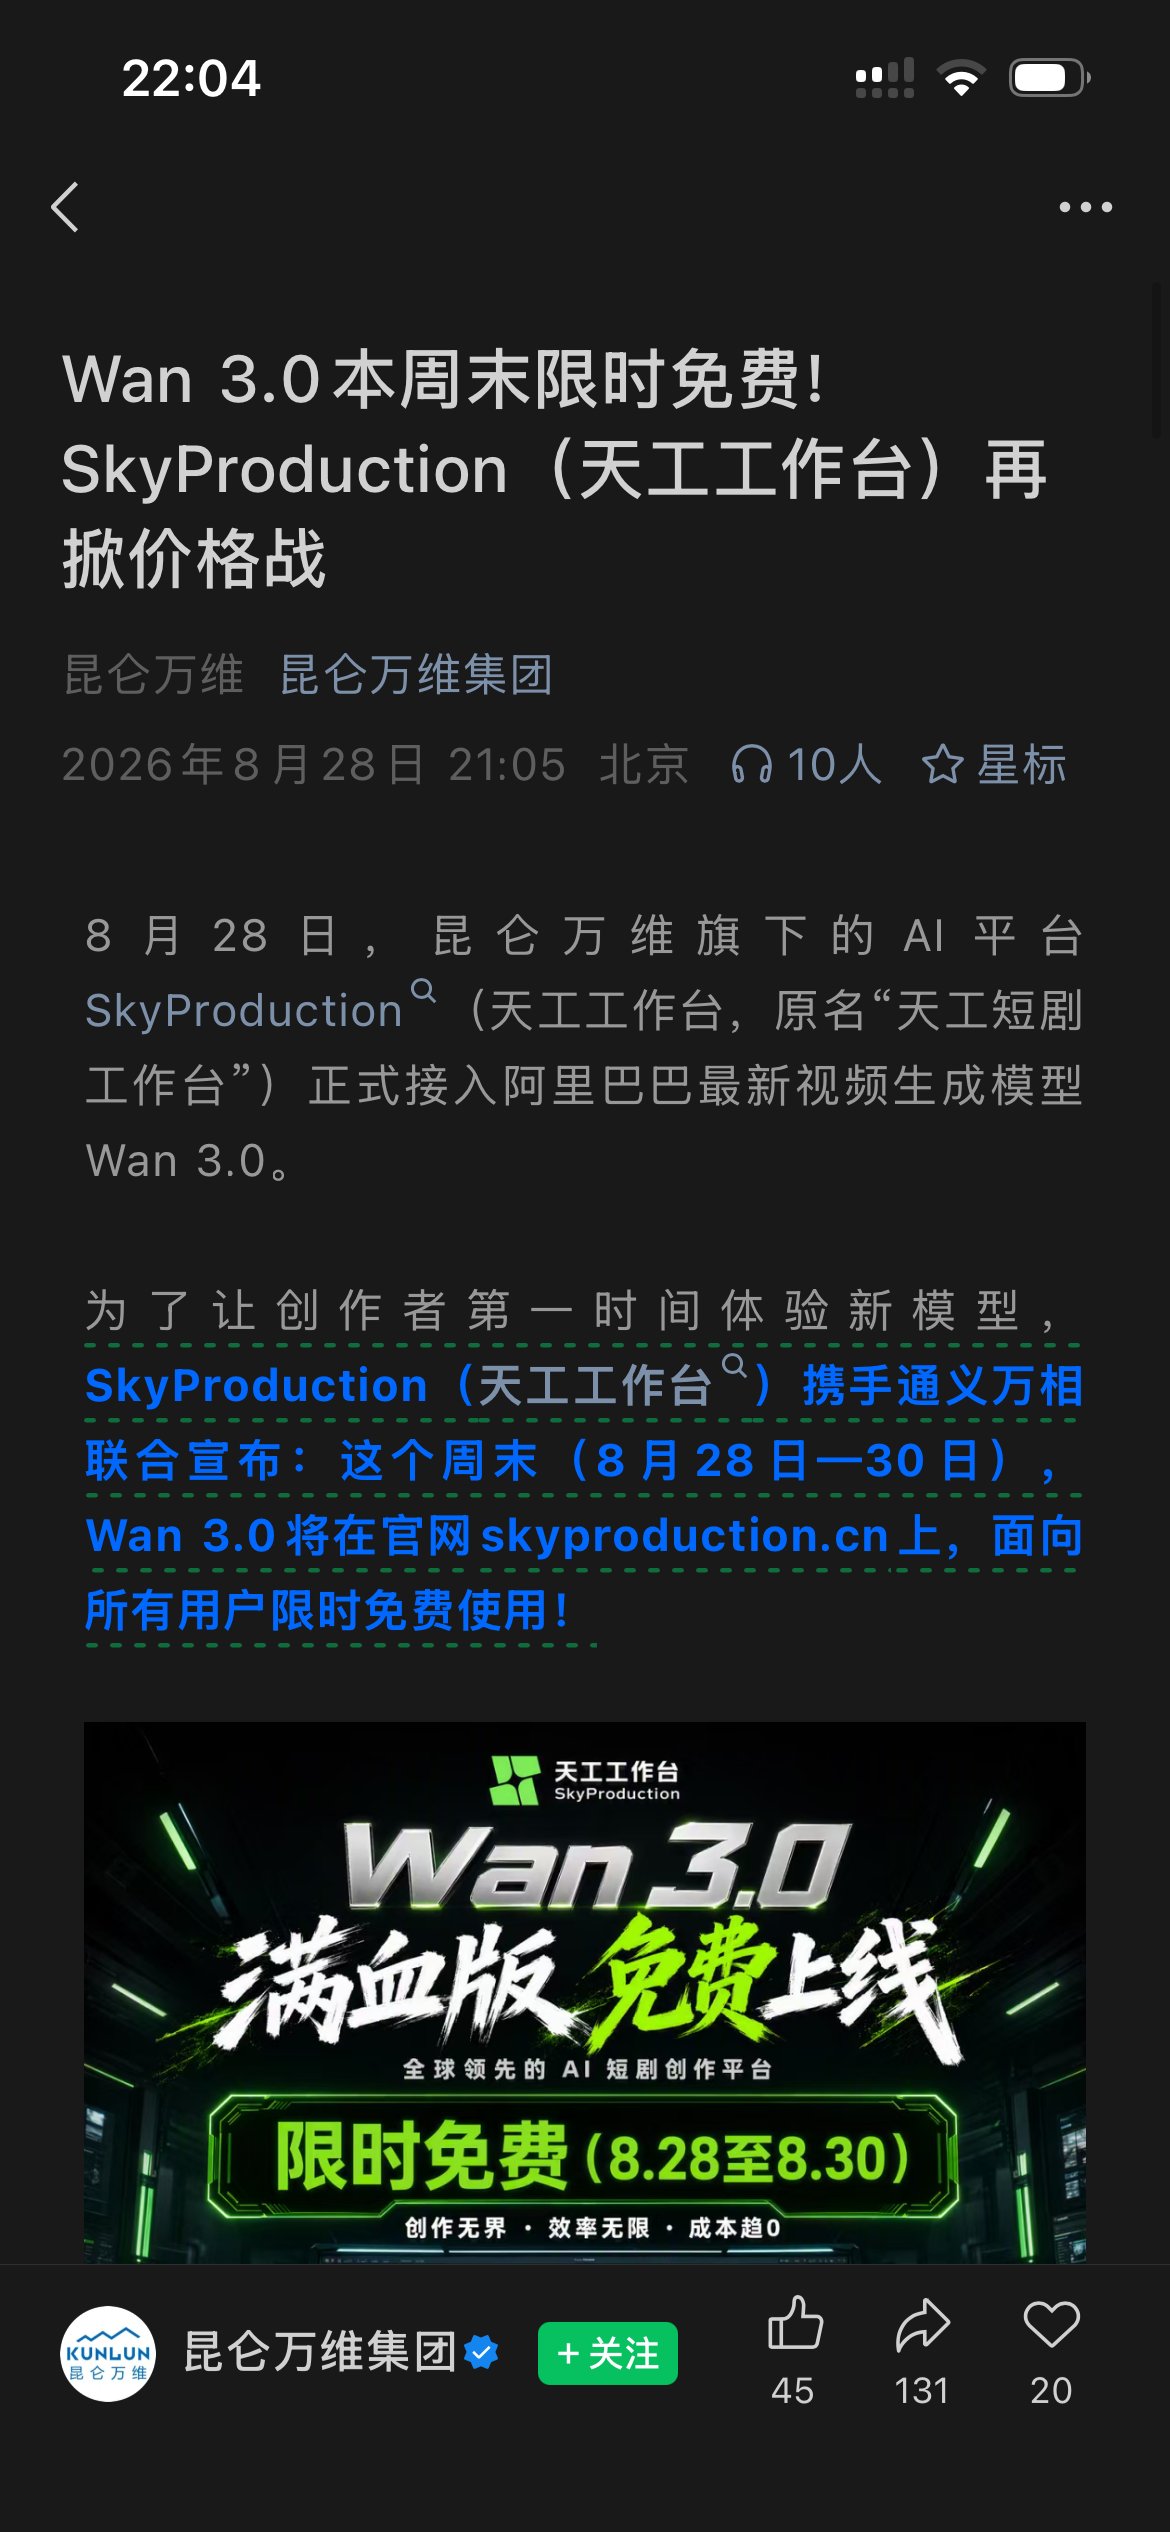
AI视频的价格战已经打到0了

文章报道了AI视频生成领域的激烈价格竞争。阿里Wan 3.0于本周末全量免费,昆仑万维旗下天工工作台(skyproduction.cn)在8月28日至30日期间对所有用户免费开放,新老用户及个人企业均可使用。周一恢复收费后定价为0.05元/秒,一条30秒视频约1.5元,号称全网最低价。作者提醒读者抓住这个仅剩3天的免费窗口期,尽快体验AI视频生成服务。这反映了国内AI视频工具在价格层面的白热化竞争态势。

How I write motion graphics prompts for MiniMax H3 Max

作者分享了为 MiniMax H3 Max 编写动态图形视频提示词的经验。文章介绍了 Prompt Expansion 的三种模式选择策略(Disabled、Balanced、Quality),讲解了通过首尾帧技术(结合 gpt-image-2 增强)解决文字过多时生成不准确的问题,以及如何拼接多段视频。作者重点展示了时间戳提示词技巧,可精确控制视频中每段文字出现的时间和动作,还介绍了文本动画的提示词写法,如将每个短语定义为完整文本层、避免字母级别的动画等。作者认为 H3 Max 在提示词遵循能力上远超其他模型,生成质量和速度令人惊叹。

技术 › 工具与效率 ilker 2026-08-2819.5 KB 630K 880 81

AI还原《倩女幽魂》经典台词:本地生成25秒写实古风短片

作者分享使用MiniMax模型在本地电脑(4070显卡16G显存)生成的25秒《倩女幽魂》AI视频,还原电影经典台词场景,无需花费token。文章附带了完整的视频提示词Skill框架,涵盖人物一致性设定、四镜头分镜设计(宁采臣与聂小倩的离别对白)、声音设计(原生中文对白、口型同步)及影像限制要求(宽银幕画幅、胶片质感、无字幕水印等),展示了AI视频生成在古风剧情短片创作中的应用效果。

技术 › 短剧 PixelAIGC 2026-08-275.4 KB 70

2026 开源模型全网最全盘点:从入门到榨干(含双机实测)

文章系统盘点了 2026 年值得关注的开源 AI 模型,涵盖语言、图片、视频三大类别,包括 Qwen、DeepSeek、Kimi、GLM、MiniMax、混元等国产阵营及海外模型。作者拆解了模型命名规则(参数量、MoE、量化、许可证等),提出五步选型筛选法,并比较各硬件平台(Mac 统一内存、NPU AI PC、大内存 APU 等)的适配能力。文章还讲解了本地部署的适用场景与许可注意事项,最后通过 Mac 和 Windows 双机实测检验模型在文字、看图、分镜和视频任务上的真实表现,帮助读者判断自己需要哪类模型以及电脑能否带动。

技术 › LLM 诺鸭船长3 2026-08-2735.5 KB 44.1K 51 87

从零开始用 ComfyUI 跑 MiniMax H3:本地安装、云端和视频工作流

本文面向新手介绍如何在 ComfyUI 中使用开源视频大模型 MiniMax H3 生成带同步声音的视频。内容包括:检查本地电脑显卡、显存与磁盘空间(建议预留70-100GB);Windows 安装 ComfyUI Desktop 的步骤;不适合本地时使用 Comfy Cloud 云端方案;使用官方 T2V/I2V/R2V 模板生成第一条5秒视频的参数与提示词写法;以及高清修复、多参考素材、首尾帧控制、长视频续拍、局部重绘等进阶工作流,最后给出常见问题排查和最稳学习路线。

技术 › AI视频 阿哲Phil 2026-08-2614.0 KB 309.7K 840 88

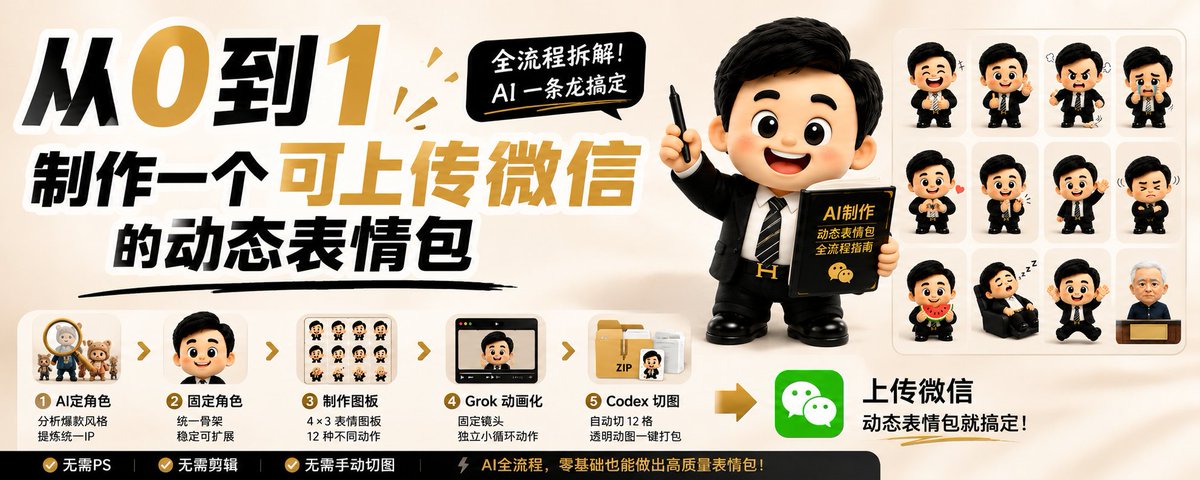
从0到1制作可上传微信的动态表情包全流程

作者分享了一套用 AI 工具从零制作可上传微信的动态表情包的完整流程:先用 ChatGPT 分析爆款潮玩形象并提炼提示词,固定原创毛绒潮玩 IP 骨架;再生成 4×3 十二宫格表情图板;用 Grok Imagine 将图板动画化生成循环动作视频;最后用 Codex 切图、去背景并导出透明 Animated WebP 和符合微信表情平台规范的 GIF。文章附有各环节详细提示词及避坑经验。

技术 › 工具与效率 刘屿之外 2026-08-2517.0 KB 9.7K 132 84

AI视频多人站位:提示词越细画面越乱的解法

文章探讨了AI生成多人视频时角色站位混乱的问题:提示词写得越详细,混入多套参照系(世界坐标、镜头画面坐标、人物互动关系),模型反而越乱。作者提出三层方法:用俯视图锁定房间空间关系,用编号映射锁定角色身份,用逐秒时间码描述当前镜头画面。并建议先做3-5秒无对白测试,定位错误层级后只修对应层,而非重写整段提示词。跨空间移动时应重建新的站位图。

技术 › 短剧 Foyege 2026-08-258.2 KB 17.5K 228 85

「豆包工作」实测:从日文PDF到官网、视频、PPT一站式搞定

字节跳动发布「豆包工作」,一个面向生产力场景的独立Agent产品。作者通过朋友的日本山椒外贸业务实测:上传日文PDF手册后,豆包工作十分钟生成支持询盘的企业官网(含日文版),又生成12条社交媒体传播素材写入飞书文档,调用Seedance 2.5生成企业宣传片,制作中日双语PPT,还定制了日语邮件润色Skill。豆包工作与飞书深度打通,企业账号登录后可调用组织关系、群聊、云文档、多维表格、会议纪要等丰富上下文,让Agent真正融入企业协作,是传统企业AI落地的实用工具。

技术 › Agent 向 向阳乔木 2026-08-2510.1 KB 32.5K 105 73

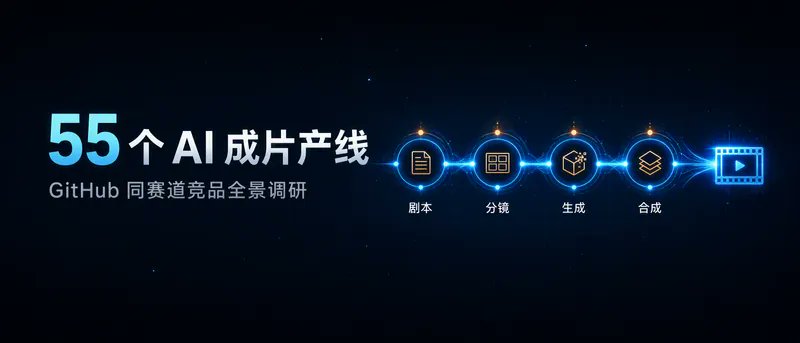
我扒完了 GitHub 上 55 个 AI 成片产线,得出一个结论

作者为做 skill/agent 驱动的 AI 成片产线,梳理了 GitHub 上 55 个近一个月仍活跃更新的同赛道项目,分为三类:装进 Claude Code/Codex 的视频 skill(28 个)、一站式成片平台(27 个,短剧扎堆)、分镜/导演画布(3 个)。核心判断是:skill 化是最活跃的增量方向,短剧是最卷场景,竞争焦点在编排产线而非模型本身,且窗口期真实存在。

技术 › 短剧 huangserva 2026-08-2521.0 KB 89K 661 76

开源:MiniMax H3 动漫 PV 包装导演 Skill

作者基于开源的 MiniMax H3 模型,经过多轮测试优化,开发了一个动漫 PV 包装导演 Skill(Ver 0.8)。用户上传人物参考图并选择视觉方向后,Skill 会分析人物造型、服装配色、道具与气质,先给出时间段分镜方案供确认,再生成适配 H3 的 15 秒中文视频提示词。内置高饱和潮流、冰蓝科技动作、红白线条漫画三种实测风格,并支持自定义风格组合,注重运镜逻辑与节奏把控,项目已开源在 GitHub。

技术 › Skill 迪威 2026-08-244.3 KB 8.9K 77 70