Wiki 知识库

技术 / 后端

41 篇
清除

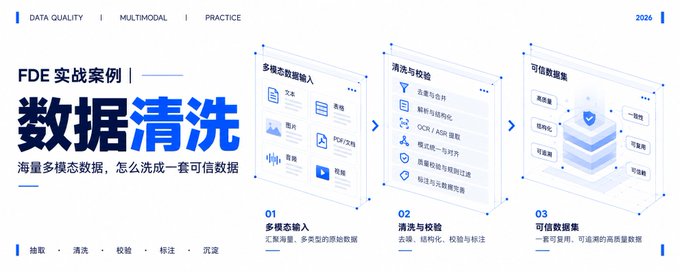
FDE 实战案例:海量多模态数据清洗成可信数据的八步方法

作者以美妆企业 FDE 落地项目为例,讲解如何将小红书、抖音、视频号、微博等平台采集的多模态数据(文字、图片、音频、视频)清洗成一套可信、可查询的结构化数据。文章提出八步通用链路:定数据规范、保留原始内容、梳理用户/帖子/评论关系、多模态归一处理、冲突与质量清洗(含证据分级)、生成结构化数据、执行验收、按规则和版本入库。文中还给出 OCR/ASR 工具选型建议(FFmpeg、PaddleOCR、Whisper 等)以及大模型结构化输出的实践经验。

技术 › 后端 Miles Ma 2026-10-2712.9 KB 5.8K 61 86

From Big Tech SWE to AI Infra (Part 2): What I Learned in My First Year

作者分享从大厂软件工程师转向 AI 基础设施方向一年的学习历程与心得。毕业加入大厂后,因工作缺乏主动性空间和创造感,三个月后决定转向 AI infra。通过学习基础知识、深入研读 SGLang 源码、参与社区贡献,逐步加入 SGLang-Omni 项目并进入一家 AI infra 创业公司。作者认为这一年是高回报率的一年,但也指出 AI 领域竞争激烈、节奏快,转行需权衡个人追求。文章最后强调了开源的重要性,认为强大的 AI 工具不应只掌握在少数公司手中,呼吁更多人参与开源社区。

技术 › 后端 Yichi Zhang 2026-10-257.8 KB 20K 401 69

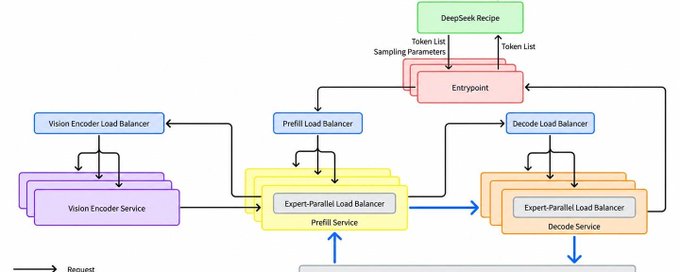
DeepSeek V4.1 Flash 大规模推理部署实践

文章介绍 DeepSeek V4.1 Flash 大规模推理系统的部署实践与开源推理框架 DeepInfer。系统设定三大目标:兼容多厂商计算芯片、基于通用硬件组织 Prefill 与 Decode(8 卡机 Prefill、64-128 卡超节点 Decode)、支持 KVCache 保留 72 小时以上以实现上下文复用、减少冗余计算。团队通过在计算、通信、调度与存储上的持续优化,在满足延迟要求下提升有效吞吐。DeepInfer 集成高性能算子与深度优化推理引擎,支持分布式推理、投机解码、SWA Bounded Replay 和结构化输出等能力。目前单集群服务吞吐达每天 155 万亿 tokens,整体收入为每卡每小时 38 美元(按低谷价格计)。

技术 › 后端 Latent.Space 2026-10-2182.1 KB 92.6K 432 69

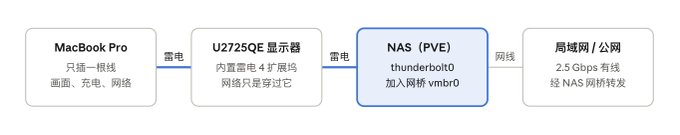
为了把雷电接口当一个普通两万兆网卡用,我让AI写了个Linux内核模块驱动

作者因家庭NAS使用频繁,希望用雷电4接口直连MacBook与NAS获得高速网络。文章介绍雷电网络(ThunderboltIP/USB4NET)的基本原理,详解Linux下各发行版(ifupdown、netplan、systemd-networkd、NetworkManager)配置桥接的完整步骤,并深入分析了直连快、经Linux转发后Mac上传速度塌到几Mbit/s的原因——Mac开启TSO发送64KiB大包而Linux转发时无法正确分段。作者最终与AI合作编写了thunderbolt-net-dkms内核驱动,通过从TCP握手学习路径MTU来正确切包,桥接后可跑满约24.5Gbit/s。

技术 › 后端 River Leaf 2026-10-1218.3 KB 8.3K 41 91

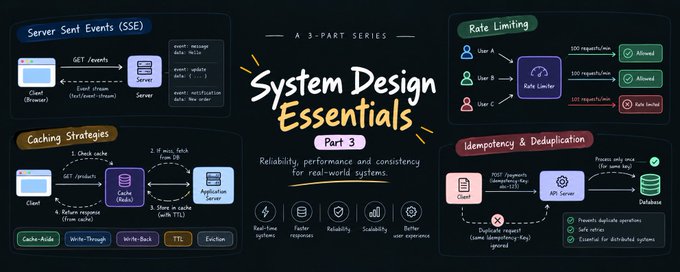
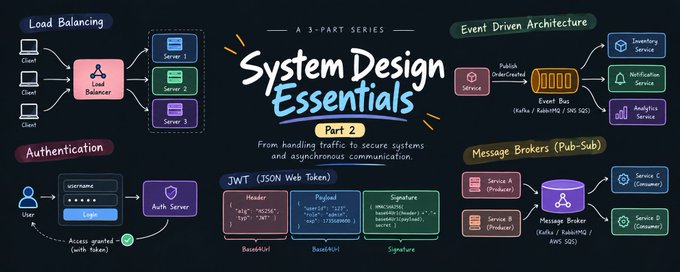
System Design Essentials - Part 3

本文是System Design Essentials系列的第三部分也是最后一部分,聚焦系统设计中的优化技术。文章详细介绍了缓存概念、缓存命中与失效,以及五种缓存策略:Cache Aside、Read Through、Write Through、Write Around和Write Back。此外还讲解了幂等性、幂等键、去重机制及其在分布式系统中的重要性,并分析了分布式系统的优势与挑战(一致性、可用性、容错性、延迟),最后深入解释了一致性哈希的原理及其在服务器扩缩容时减少请求重映射的作用。

技术 › 后端 Anurag 2026-10-0615.7 KB 15K 355 75

System Design Essentials - 2

本文是系统设计系列三篇中的第二篇,聚焦架构决策与关键组件。作者逐一讲解了事件驱动架构(EDA)的松耦合与异步通信优势、Serverless 架构的按需执行与冷启动特性、CDN 通过边缘节点缓存静态内容的原理、消息队列在生产者与消费者之间的解耦与缓冲作用、Pub-Sub 一对多广播模式与队列的区别,以及后台任务处理(将非关键任务异步化)和 Cron 定时任务等模式。文章强调知道组件与知道如何组装系统不同,重点在于权衡各架构选择的成本与收益。

技术 › 后端 Anurag 2026-09-2917.8 KB 18.7K 386 70

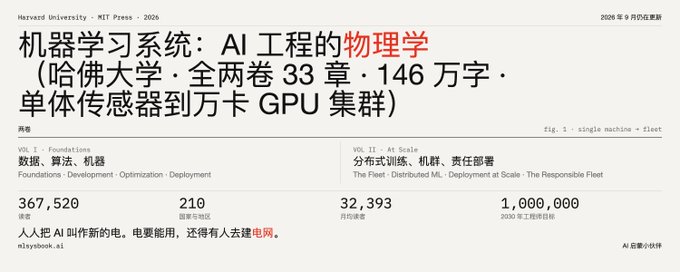
机器学习系统:AI 工程的物理学(哈佛大学开源教材解读)

文章介绍了哈佛大学 Vijay Janapa Reddi 教授的开源教材《Machine Learning Systems: The Physics of AI Engineering》,两卷 33 章,旨在像 Hennessy & Patterson 的体系结构经典一样,将 ML 系统工程变为有定量定律的学科。全书以铁律、屋顶线模型、能耗阶梯、Amdahl 定律、漂移方程等核心定律组织内容:第一卷讲单机 ML 系统栈(数据、训练、压缩、硬件、服务、MLOps),第二卷讲集群规模化(分布式训练、3D 并行、容错、推理经济学、可持续 AI)。文章总结了书中'约束驱动''一切皆有价格''静默失败是默认模式'等核心世界观,并给出不同读者群体的阅读建议。

技术 › 后端 meng shao 2026-09-2817.0 KB 13.5K 125 84

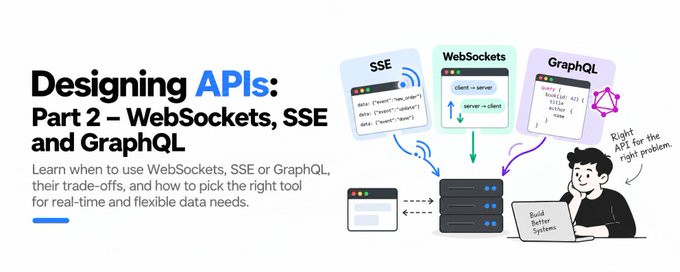
Designing APIs: Part 2 – WebSockets, SSE, and GraphQL

本文是 API 设计系列的第二部分,讲解三种突破传统请求-响应模式的 API 设计方案。SSE 是服务端单向推送通道,基于纯 HTTP,内置自动重连和 Last-Event-ID 断点续传,适合实时仪表盘和通知流;WebSockets 提供全双工双向通信,但连接有状态,需通过粘性会话或发布/订阅架构解决扩展问题,适合聊天和协作编辑;GraphQL 让客户端精确指定所需字段,解决过度获取和获取不足问题,但存在缓存困难和 N+1 查询等权衡。文章最后给出选型建议:单向推送用 SSE,双向低延迟通信用 WebSockets,灵活嵌套数据查询用 GraphQL,实际系统常组合使用。

技术 › 后端 Saurav Jha 2026-09-288.1 KB 12.4K 294 77

Designing APIs: Part 1 – REST, gRPC and tRPC

本文系统讲解 API 设计的核心概念,聚焦资源导向设计模式及 REST 与 RPC 家族(gRPC、tRPC)的对比。作者首先介绍 API 设计的三大要素:资源、资源关系与边界,以及五种标准方法(Create、Get、Update、Delete、List)。随后分析 REST 的松耦合、JSON 传输特点及其在带宽和类型契约上的不足;gRPC 基于 HTTP/2 二进制协议和 proto 文件代码生成实现编译期紧耦合;tRPC 则面向全栈 TypeScript 项目,无需额外 schema 即可端到端类型安全。最后给出选型建议:公开 API、多客户端场景优先 REST。

技术 › 后端 Saurav Jha 2026-09-289.6 KB 12.3K 296 69

System Design Essentials - 1

本文是系统设计基础三部曲系列的第一篇,介绍了软件系统设计中的核心构建模块,包括客户端-服务器架构(二层与三层架构)、垂直扩展与水平扩展的区别、数据库基础及CRUD操作、ACID与BASE两种事务模型、CAP定理及其在分布式系统中的权衡、关系型数据库(SQL)与非关系型数据库(NoSQL)的特点与适用场景,以及数据库主从复制的读写分离模式。每个概念都配有简明解释、图示、解决的问题及背后的权衡,适合系统设计入门学习和面试准备。

技术 › 后端 Anurag 2026-09-2221.6 KB 235.3K 1.6K 62

从 CRDTs 到本地优先的同步引擎(上)

本文是 zx_loro 在 local-first 线上会议分享的文字版(上篇)。作者团队从 CRDT 库 Loro 出发构建了 local-first 团队 AI agent 控制面 Lody,并在实践中总结出'CRDTs are not enough'的观点。文章介绍了本地优先软件的理念(秒开、离线可用、多端协作、数据归用户所有),指出统一同步引擎应吸纳请求失败、权限管理、持久化等必要复杂度,并分析了 CRDT 库(Loro、Yjs、Automerge)只覆盖纯计算而不涉及网络与持久化的局限。作者分享了团队自研新 CRDT Flock 实现目录级 metadata 同步,以及在浏览器本地存储、全文搜索、端到端加密等方面的实践经验。
技术 › 后端 leon7hao / 陈子轩(zx_loro) 2026-09-2212.3 KB 12.7K 64 77

The Ultimate Cloudflare Guide

这篇指南全面介绍了 Cloudflare 开发者平台的各个组件、定价和实际使用中的注意事项。作者以自己运行多个产品的经验为基础,提出了核心心智模型:Worker 即应用,其余皆为绑定(binding)。文章涵盖计算类服务(Workers、Durable Objects、Workflows、Containers、Queues、Cron Triggers)、数据存储选择规则(D1、R2、KV、Hyperdrive、Vectorize)、AI 相关产品(Workers AI、AI Gateway、Browser Rendering、Agents/MCP),以及大量免费服务如 Tunnel、Zero Trust Access、Turnstile、CDN/DDoS 防护和邮件服务。作者给出明确的选型建议,如新项目应使用 Workers 而非 Pages。
技术 › 后端 Elia 2026-09-1711.3 KB 51.5K 522 87

Redis From First Principles Episode 1: Networks, Sockets and the Magic of Communication

本文是'从零重建Redis'系列的第一篇,作者Temi通过亲手重建Redis来深入理解其工作原理。文章首先介绍Redis作为基于内存的持久化存储的特点和应用场景,随后深入讲解网络通信基础:socket的概念、Unix文件描述符,以及两种主要socket类型——提供可靠有序字节流的TCP流式socket和不保证送达但延迟低的UDP数据报socket。作者还用Python实现了第一个基于TCP的client/server回显程序,并分析了当前设计的局限性,如服务器一次只能处理一个客户端、TCP不保留消息边界等问题。

技术 › 后端 Temi 2026-09-1510.3 KB 7.2K 175 69

System Design for Beginners: How to Start With HLD and LLD

本文面向系统设计初学者,清晰区分高层设计(HLD)与低层设计(LLD)。HLD关注系统整体架构,如组件交互、数据存储与扩展性;LLD关注代码级细节,如类、对象与设计模式。文章强调两者缺一不可,并深入讲解请求流程、延迟与吞吐量、垂直与水平扩展等核心概念,为初学者提供了一条清晰的学习路径。

技术 › 后端 Harshit Khosla 2026-09-1475.9 KB 61.3K 1.1K 61

The Inference Engineering Skills Map

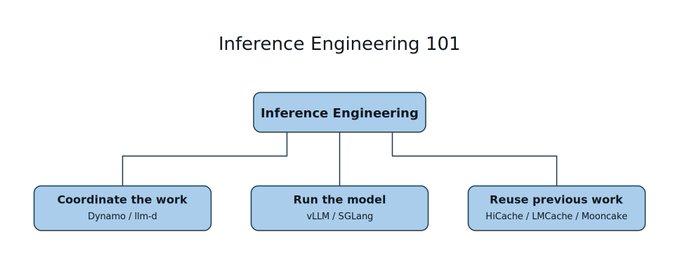
作者从 B2B SaaS Web 开发转向推理工程一个月后分享的入门知识地图。文章将推理工程分为三大类:协调工作(Nvidia Dynamo、llm-d 负责路由、调度与扩展,需智能负载均衡)、运行模型(vLLM、SGLang 处理批处理、张量并行、prefill/decode 分离)、复用先前工作(KV 缓存与 HiCache、LMCache、Mooncake 实现跨 GPU/CPU/NVMe 的分层前缀缓存)。作者强调从 Web 开发转型并不难,不需要精通 CUDA,先跑起模型、发送流量,再逐层深入即可。

技术 › 后端 Nick Khami 2026-09-118.5 KB 17.7K 512 73

从自动化到流程:现代技术组织的一个哲学悖论

文章探讨技术组织中自动化与流程管控之间的矛盾:团队一边搭建高效自动化流水线,一边又设置层层审批关卡。作者从复杂系统演化视角分析,指出速度在软件行业中成为最大风险放大器,事故后的管控收紧、审批与自动化的循环是组织维持动态平衡的免疫机制。文章进一步以康威定律解读代码架构作为权力划分,类比平台化与操作系统、标准化与消除单点故障,最后借社会契约解释工程师为何让渡自由换取秩序与稳定性,指出系统规模越大,制度外壳越厚。

技术 › 后端 win98 2026-09-077.1 KB 1.7K 10 61

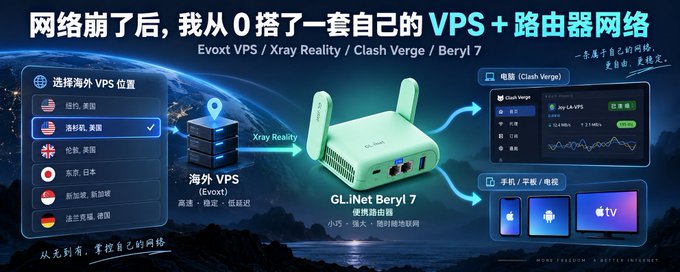
从一台 1GB VPS 到一台随身路由器,我把自己的网络重新搭了一遍

作者因网络节点不稳定,决定自购海外 VPS(Evoxt)从零搭建网络环境。通过 SSH 连接服务器,安装 Xray 并配置 VLESS + Reality + XTLS Vision,客户端用 Clash Verge/Mihomo 接入,并利用 rule-providers 实现国内直连、海外走 VPS 的分流。随后又为朋友家的 GL.iNet Beryl 7 路由器加装 WireGuard,让手机、平板、电视等设备无需各自配置代理客户端即可上网。文章还分享了排错方法论:遇到 Reality 认证失败等问题时,不做无谓猜测,而是通过 A/B 交叉测试拆解变量、定位问题,最终整套方案经 YouTube 4K 测试流畅运行。

技术 › 后端 joy 2026-09-0710.7 KB 20K 138 78

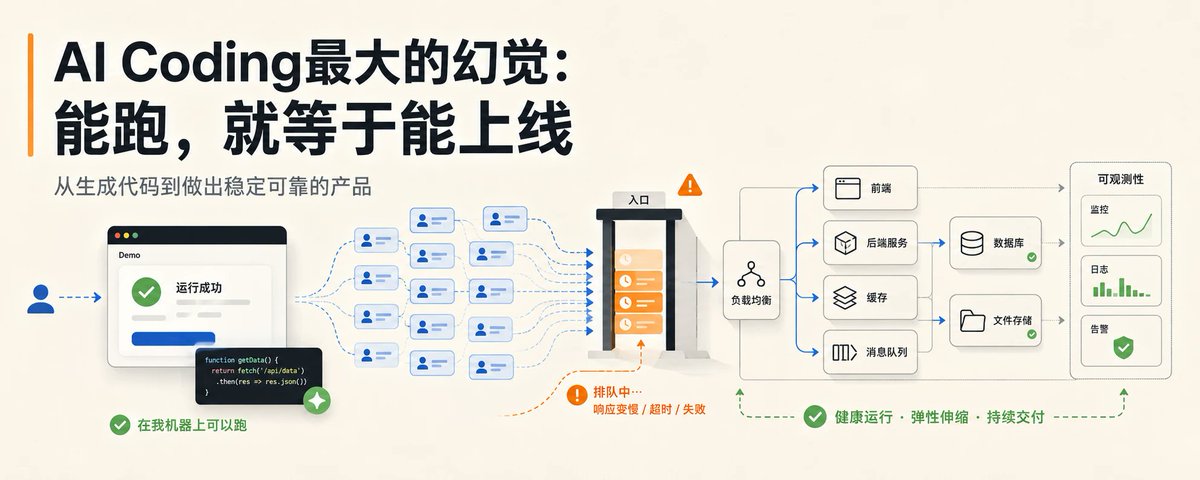
Ai Vibe Coding:小白也能看懂的产品稳定性教程

文章以面包店从街角小店成长到全国连锁的故事为比喻,系统讲解网站如何应对用户增长与稳定性挑战。从单体架构(一台烤箱)讲到垂直扩展、数据库索引、N+1 查询优化、缓存与缓存失效、水平扩展、负载均衡与自动扩缩容,再延伸到 Docker 容器化、CI/CD、可观测性、读写分离、微服务拆分、CDN 内容分发,以及限流、队列与异步处理等高并发应对手段。用通俗类比帮助零基础读者理解前后端、数据库、缓存等核心概念,掌握系统扩容与稳定性的基本方法论。

技术 › 后端 苏乐 2026-09-0333.6 KB 55.2K 67 79

Serialization and Deserialization: The Universal Language of Backend Engineering

本文系统讲解了序列化与反序列化在后端工程中的核心作用。作者以 React 前端与 Node.js 后端通信为例,说明跨网络传输数据时必须将内存中的对象转换为可传输的标准化格式。文章对比了文本格式(JSON、YAML、XML)与二进制格式(Protobuf、Avro、MessagePack)的优劣,深入剖析了 JSON 作为行业标准的语法规则,并通过一个完整的 Node.js 请求生命周期示例,演示了从客户端序列化、网络传输、服务端反序列化、业务处理到响应返回的全流程,最后给出了错误处理、数据校验等实践建议。

技术 › 后端 Anurag Jha 2026-08-3024.9 KB 37.1K 636 66

Latency Patterns for Faster Applications

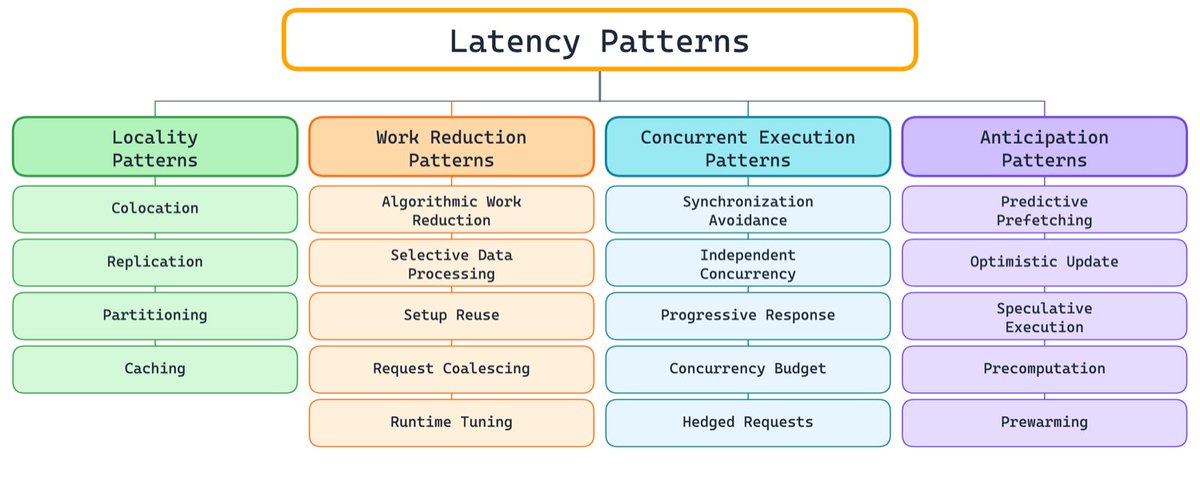
本文探讨了AI与非AI应用中的延迟优化模式。作者指出延迟是指从用户操作到首个有用结果出现的时间,用户感知的是完整关键路径而非单个组件。文章将延迟优化归纳为四大类共19种模式:一是本地化,包括同置、复制、分区和缓存;二是减少工作量,包括算法优化、选择性数据处理、初始化复用、请求合并和运行时调优;三是并发执行,包括避免同步、独立并发、渐进式响应、并发预算和对冲请求;四是预测性优化,提前处理可预测的工作。这些模式既适用于传统应用,也适用于涉及LLM调用、MCP服务器和Agent协调的现代AI应用路径。

技术 › 后端 Bilgin Ibryam 2026-08-3011.5 KB 18.4K 316 78

AI Engineering Skills Map: 软件工程基础

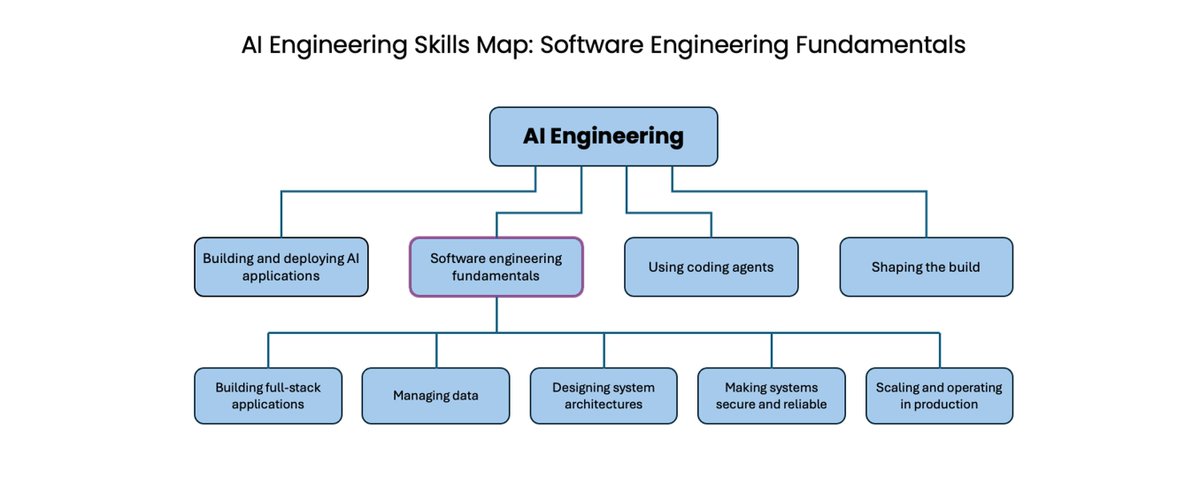
吴恩达探讨了在智能体编程(agentic coding)时代,软件工程基础知识为何依然重要。即使编码智能体可以代写全部代码,开发者仍需理解软件基础,才能引导智能体在延迟、可用性、一致性、可靠性、可维护性和成本等方面做出正确权衡。文章归纳了AI工程师应掌握的核心技能:构建全栈应用、管理数据、设计系统架构、保障系统安全可靠、以及在生产环境的扩展与运维。他强调,死记语法等知识正在过时,但深入理解软件原理的开发者远胜于盲目'氛围编码'的新手。

技术 › 后端 Andrew Ng 2026-08-297.7 KB 1.1M 8.8K 71

现代SaaS架构:软件公司的实用指南

本文探讨了现代SaaS架构的关键决策,强调架构选择应从一开始就考虑合规性、可扩展性和可观测性。文章指出,SaaS架构模型不是终点,而是通往可扩展业务成果的道路。作者建议使用AWS Well-Architected框架的SaaS Lens来指导部署模型、可观测性、租户隔离和合规性等决策。文章详细比较了单租户、多租户和混合架构的优缺点,并强调了可观测性(日志、追踪、指标)和租户隔离的重要性,提供了在AWS上实现这些目标的工具和方法。

技术 › 后端 Amazon Web Services 2026-08-1115.4 KB 78.7K 440 75

谷歌 Gemini 背后的男人,永远的代码之神

文章讲述了谷歌人工智能负责人 Jeff Dean 的传奇生平。从高中编写流行病软件,到与桑杰在 DEC 结缘,再到加入谷歌挽救索引危机。他们通过 MapReduce、Bigtable 和 Spanner 等创新,奠定了现代分布式系统与大数据的基石,展现了应对大规模硬件故障的非凡工程能力。

技术 › 后端 向 向阳乔木 2026-08-0643.3 KB 49.1K 43

State Machines: From Loops to Graphs (Explained)

文章阐述了状态机理论及其在软件开发中的应用。作者指出Agent框架从链条到循环再到图形的演变,本质上是有限状态机(FSM)的体现。通过将分散的逻辑迁移到明确的转换函数中,状态机能消除不可能状态,避免竞态条件,并提供类型级安全保障。文章展示了基于查找表和Switch语句的实现方式,强调了其在代码审查、测试及系统可靠性方面的优势。

技术 › 后端 vixhaℓ 2026-07-2142.1 KB 81.2K 562

2分钟理解状态机

文章指出当前的 Agent 图等新概念本质上是数十年前的软件工程模式(如状态机和 Actor 模型)的重新包装。作者用 2 分钟解释了状态机核心公式(state, event) → nextState,强调其可视化和保证逻辑确定性的优势。无论是循环、图还是 Agent 逻辑,底层都是状态机。

技术 › 后端 David K 2026-07-204.7 KB 82.8K 748

How we built our knowledge base

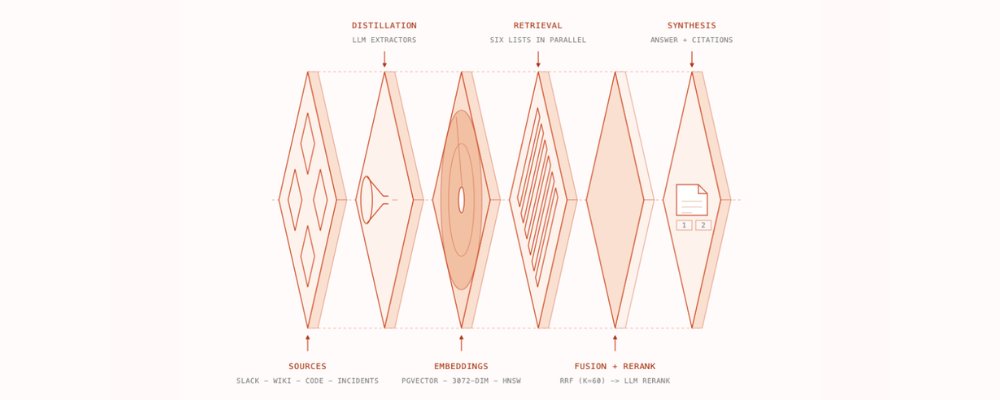
Cerebras 分享了如何构建内部知识库,该系统每天处理超过 15,000 个查询。文章介绍了其数据采集架构,特别是如何通过混合搜索技术(全文搜索、Embedding 搜索、IDF 和时间衰减)来处理非结构化的 Slack 对话,以提高信息检索的准确性和实时性。

技术 › 后端 Cerebras 2026-07-17261.6 KB

后端工程师进阶路线:40个核心概念与六个成长阶段

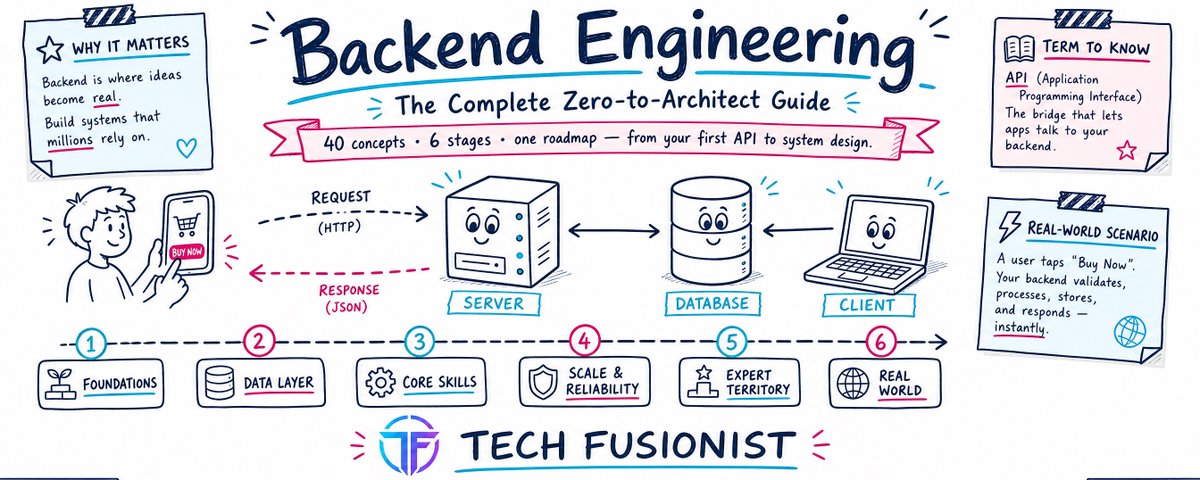
本文为准备系统设计面试的后端工程师提供了一份详尽的学习指南。作者将零散的技术知识点整合为六个递进阶段:从Web基础、数据库管理,到构建生产级应用、系统扩缩容,再到分布式系统思维与架构设计。文章强调技术概念间的内在联系,旨在帮助开发者通过系统性的学习路径,从初学者成长为合格的软件架构师。

技术 › 后端 Tech Fusionist 2026-07-134.7 KB 110.6K 620

你是大模型的受益方,还是被吞掉方?AI应用的护城河与机会 ft. TiDB 唐刘

文章探讨了 AI Agent 时代数据库角色的演变。TiDB 唐刘指出,虽然 AI 压缩了中间层软件,但数据库作为 Agent 的“统一存储层”和“单一事实源”,其重要性不降反升。文章详细梳理了从存海量数据、租户隔离、Agent 自主管理到文件与 Workspace 托管的六大产品演化阶段,并讨论了 FDE 角色在 AI 时代的回归,以及判断 AI 产品护城河的核心逻辑:是模型进步的受益方,还是将被吞掉的一层。

技术 › 后端 Star@Day1Global Podcast 2026-07-1319.4 KB 10.7K 12

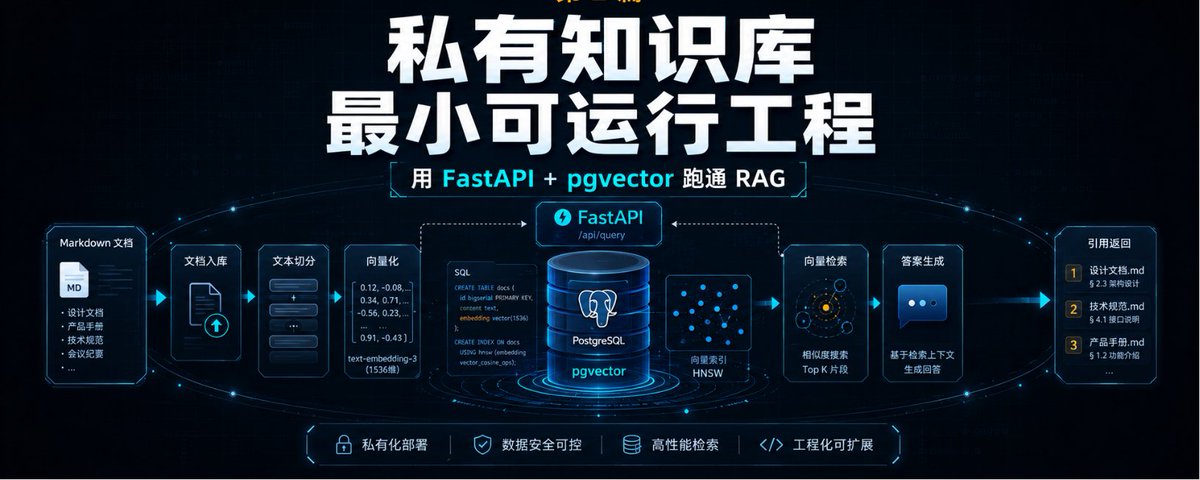
用 FastAPI + pgvector 跑通最小可运行私有知识库

本文是一份实战教程,指导读者从零搭建一套最小可运行的 RAG(检索增强生成)私有知识库。技术栈采用 FastAPI 作为接口框架,PostgreSQL 配合 pgvector 扩展进行向量存储,并调用通义千问(Qwen)模型与 Embedding 服务。文章详细讲解了项目结构、依赖配置、数据库模型定义以及文档入库的完整代码实现,旨在构建一个可落地的工程底座。

技术 › 后端 A Ando 2026-07-0822.2 KB