谢赛宁对LLM的判断:从Sora关停到世界模型的崛起
文章从OpenAI关停Sora切入,深入探讨了Sora核心架构DiT创造者谢赛宁对大语言模型(LLM)的根本性质疑。谢赛宁认为LLM只是在模仿语言的统计规律,而非理解世界,语言是“鸦片”。文章详细阐述了基于抽象表征空间的预测架构(JEPA)和世界模型才是通往通用智能的正确路径,并指出未来的AI架构中,LLM将退化为仅用于交流的界面,而表征层才是真正的基石。
文章从OpenAI关停Sora切入,深入探讨了Sora核心架构DiT创造者谢赛宁对大语言模型(LLM)的根本性质疑。谢赛宁认为LLM只是在模仿语言的统计规律,而非理解世界,语言是“鸦片”。文章详细阐述了基于抽象表征空间的预测架构(JEPA)和世界模型才是通往通用智能的正确路径,并指出未来的AI架构中,LLM将退化为仅用于交流的界面,而表征层才是真正的基石。
本文是一篇零基础的 AI 短视频制作教程,详细介绍了利用 Seedance 2.0 和 GPT 2.0 从脚本策划到成片输出的完整工作流。内容涵盖如何利用 LLM 进行脚本拆解与分镜设计,使用三视图锁定角色一致性,掌握镜头景别与节奏控制,以及通过提示词生成高质量视频素材并进行后期剪辑。
本文是对 AI 产品 Moxt 的深度评测。作者指出当前 AI 工作存在“上下文散”和“格式脏”两大痛点,而 Moxt 通过构建基于本地文件系统和 Markdown 格式的工作空间有效解决了这些问题。文章详细介绍了 Moxt 的核心功能:包括基于 AGENTS.md 的个人 AI 分身、支持 Skill 自动化的工作流、以及生成可视化的 HTML 报告。作者认为 Moxt 将 AI 从单纯的对话工具转变为具备记忆和执行能力的“同事”,非常适合处理复杂的组织协作任务。
文章针对 Claude Code 用户频繁手动授权从而打断工作流的问题,详细介绍了如何通过配置 settings.json 文件来自动化权限管理。内容涵盖了三种配置层级、五种权限模式以及 allow/deny/ask 规则的优先级,并提供了 Node.js/TypeScript 项目的完整配置示例。此外,还讲解了如何配置 Hooks 自动化代码格式,以及如何在团队中共享统一的安全设置。
文章指出传统 Prompt 工程在规模化、持久化和稳定性上的局限,提出了“Skill”概念。Skill 将系统提示词、入参 Schema 和执行逻辑封装为可复用的“AI 函数”。文章对比了 Skill 与 Prompt、MCP、Agent 的区别,并介绍了基于“渐进式披露”的三层交互架构,旨在用软件工程的严谨性提升 AI 应用的可控性。
SMFS 是一个结合了 RAG 和传统文件系统优势的新型可挂载文件系统。它允许 Agent 使用标准的 Unix 命令(如 grep)执行语义搜索,支持多格式文件的自动解析与提取,并提供本地优先的同步引擎。内部基准测试显示,SMFS 能显著减少 Token 消耗和工具调用次数,同时大幅提升检索准确率。
这是一份为期 30 天的 Claude Cowork 掌握指南。文章指出大多数人仅将其作为简单的文件整理工具,而忽略了其自主运行多步骤工作流的强大潜力。课程分为四周:第一周学习从“提问”转向“委托”的思维方式;第二周配置 Gmail、Drive 等连接器以打通应用生态;第三周利用 /schedule 指令设置晨间简报、文件归档等定时自动化任务;第四周将各环节串联,构建内容生产、客户管理及商业情报系统。旨在帮助用户每周节省 15-25 小时。
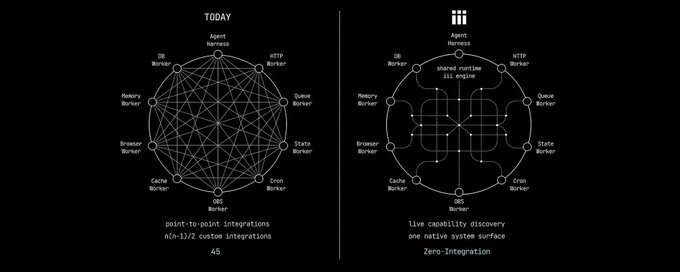
文章探讨了当前 AI 架构中 Harness(编排层)与后端基础设施分离带来的问题,指出这种分离导致了 Agent 的随机性与后端的确定性之间的调试复杂性。作者提出将后端抽象为 Worker、Trigger 和 Function 三个基本元素,介绍了名为 'iii' 的架构,使 Agent 作为 Worker 直接参与后端系统,而非通过外部集成层调用,从而实现真正的统一基础设施。
作者分享了使用 Claude Code 四个月以来的实战经验。文章详细介绍了 Claude Code 的三种形态(CLI、Desktop App、VS Code 扩展)、订阅方案选择及风控成本。重点讲解了提升效率的核心配置:编写 CLAUDE.md 规范项目行为,以及利用 Skill 实现自动化流程(如部署、SEO 审计)。同时总结了新手常见的坑,如任务拆解过大、数据备份缺失及 IP 风控问题。
本文探讨了 AI 编程时代的真正门槛。作者指出,虽然 AI 解决了“写代码”的问题,但对于初学者,真正的鸿沟在于缺乏“系统思维”和“判断力”。文章详细拆解了判断力的六个维度,并为非技术背景人员提供了从“改”代码、逐行阅读、刻意制造 bug 等五个具体的成长阶段,强调真正的核心能力不再是语法,而是对软件运作的直觉。
本文详细介绍了如何利用 Claude Code 等无代码/低代码 AI 工具,通过 Google Trends 挖掘热词(如新 AI 模型),快速搭建 SEO 导航站或落地页以获取搜索流量。文章涵盖了从环境准备、选词策略、内容生产到部署上线及变现的完整闭环,旨在分享“爬虫 + LLM + 多语言 SEO”的自动化赚钱逻辑。
文章讲述了作者使用DeepSeek V4模型及其EasyClaw平台,通过简单的口述指令,快速生成并部署了一个网页版“重生”文字小游戏。游戏中包含了霸总变狗、皇帝用钉钉管理朝堂、乞丐摆摊IPO等极具幽默感和荒诞感的剧情,展示了AI在逻辑推理和内容生成上的强大能力以及低门槛开发的便利性。
本文是一份 Hermes Agent 的实战变现教程。作者首先解析了 Hermes Agent 具备的长期记忆、技能自动沉淀及 24 小时在线等核心优势,随后提供了“喂饭级”的安装与部署教程。文章重点列举了三种适合普通人的变现路径:出售代安装服务(卖铲子)、为线下店铺搭建 AI 客服系统(卖服务)以及利用 AI 分身辅助内容生产(卖自己)。最后,作者分享了避免被割韭菜的三条保命铁律,鼓励读者从第一笔小额收入做起,享受 AI 带来的复利红利。
本文介绍了一种利用编码 Agent(如 Claude Code)自动生成 Skill 的方法,实现 YouTube 视频到文章的高效转换。通过 yt-dlp 获取字幕并清洗,再利用大模型改写,将原本繁琐的视频转写工作自动化。文章详细解析了实现原理、Agent 编写 Prompt 的技巧以及进阶功能的扩展。
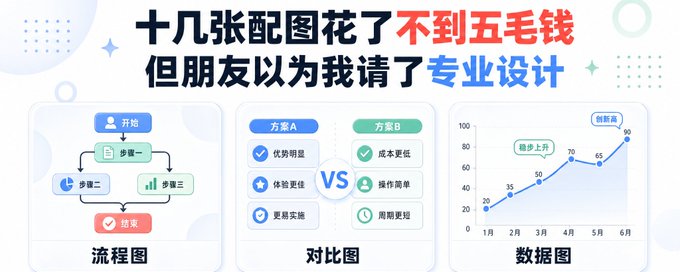
作者分享了使用 GPT-Image-2 生成低成本高质量信息图的经验。通过设定特定的配色(如#4B91F3)和风格约束(类似 SaaS 数据报告),作者成功生成了流程图、对比图和数据图,总成本不到 0.5 元人民币。文章详细介绍了 Prompt 编写技巧、迭代过程以及如何避免 AI 绘图的常见陷阱。
本文探讨了 Andrej Karpathy 的 LLM Wiki 工作流在人类“第二大脑”场景下的优势,指出其在处理 AI Agent 时的局限性。文章强调,人类记忆优先考虑可读性和反思,而 Agent 记忆系统则需要快速检索、低 Token 成本和冲突解决。Mercury 提出的混合架构方案,主张使用 Markdown 作为人类界面,同时采用结构化内存作为 Agent 的底层设施,以实现上下文的持续累积和可靠运行。
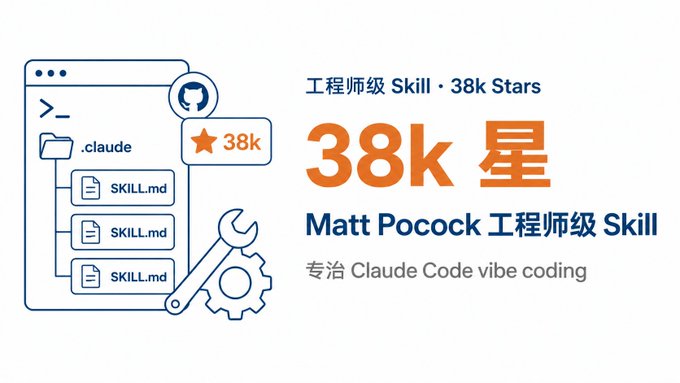
Total TypeScript 作者 Matt Pocock 开源了其个人常用的 16 个 Claude Code Skill,GitHub 星标迅速突破 38k。这套工具主张“真工程师”模式,摒弃了 BMAD 等重流程框架,采用“小、可改、可组合”的 Unix 哲学。文章详细解析了针对 Agent 失败四大根因(需求模糊、啰嗦、代码报错、屎山)的解决方案,重点介绍了 CONTEXT.md 建立项目共享语言的方法,适合具备工程基础的开发者提升 AI 编码效率。
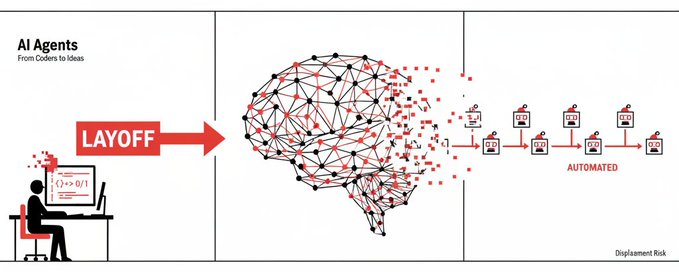
前字节跳动工程师郭宇在《单向街东京》对话中提出惊人判断:知识工作者剩下的有意义工作时间仅约六个月。文章指出,随着 Claude Code 推出 Skill 模式,软件工程范式被改写,代码变为“流动的 Token”,不再依赖人工监督。这种“一人公司”模式正颠覆传统 SaaS、法律及初级编程岗位。AI 虽短期赋予个人以一当万的能力,但长期将导致岗位消失,加剧通缩与分配矛盾。
文章精选了69个经过实战验证、维护活跃的开源AI仓库,旨在替代昂贵的API订阅。内容涵盖完整的AI技术栈,包括本地大模型推理、RAG知识库构建、AI智能体框架、提示词与评估、模型微调、工具链及部署等十大领域,为开发者、研究人员和独立黑客提供免费的生产级AI工具清单。
文章针对当下企业盲目引入AI的现象,提出了“五维评估法”来辅助决策。这五个维度包括:问题复杂度(规则是否可解)、数据基础(数据是否优质可用)、业务影响(是否具备高ROI)、容错空间(业务能否承担AI错误)以及组织能力(团队是否能持续运营)。作者强调AI应解决业务痛点而非炫耀技术,并提供了具体的评估清单,旨在帮助企业避免资源浪费,实现AI的真正价值。
文章深入探讨了 AI Agent 遗忘信息的根本原因。作者指出,问题通常不在于检索,而在于 KV Cache 在上下文过长时的处理机制。文章对比了 StreamingLLM(仅保留近期信息)与 SnapKV(基于注意力分数保留关键信息)的区别,并解释了模型如何通过“注意力权重”来决定哪些 Token 值得被记忆,从而实现 92% 的压缩比且不丢失关键信息。
文章介绍了一款名为“洁癖.Skill”的开源工具,旨在解决Agent长期使用后因上下文和文档混乱导致的“越用越笨”问题。该Skill通过自动审查和迭代项目的文档、记忆及配置文件(如CLAUDE.md),确保知识库的准确性,适用于Claude Code、Codex等多个平台。作者提出“合并优于追加,删除优于保留”的原则,强调在AI协作中保持信息纯净比信息海量更重要,这能让开发者通过“存档”机制实现Agent的持续进化。
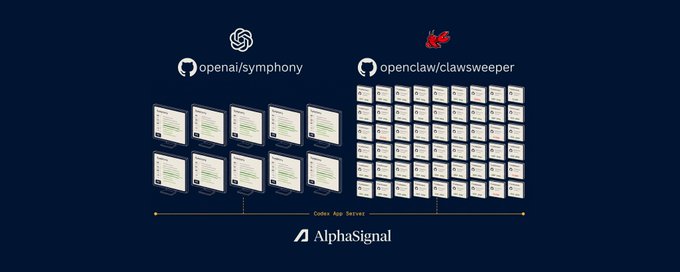
文章介绍了 OpenAI 生态内两个同时发布的开源项目:Symphony 和 ClawSweeper。两者均基于 Codex App Server 这一原始编排层,分别针对 SDLC 的两端(PR 创建与 Issue 维护)提供了参考实现。Symphony 将 Linear 转化为自动化代理系统,提升 PR 吞吐量;ClawSweeper 则能并行运行大量 Codex 实例,自动清理无意义 Issue。文章分析了它们的架构模式、应用场景及局限性。
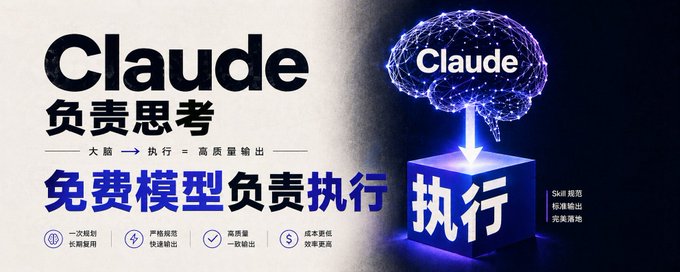
本文介绍了如何配置 Claude Desktop 以接入 DeepSeek、GLM 等第三方或国产模型,提供了详细的开启开发者模式及配置 API 的图文步骤。此外,作者分享了两种节约成本的高效工作流:一是利用 Claude 生成并沉淀包含规范和系统 Prompt 的 Skill 文档;二是结合免费模型(如 Ling-2.6-1T)执行具体生成任务,实现低成本高质量的产出。
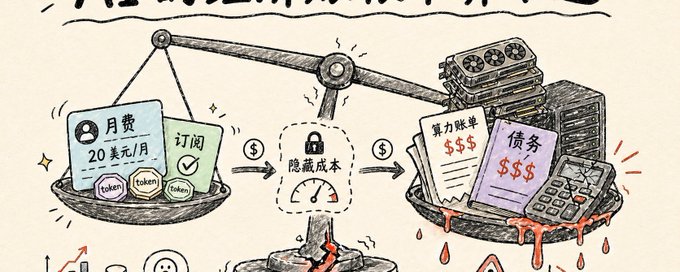
文章通过 GitHub Copilot 改为按用量计费的事件,剖析了生成式 AI 行业面临的深层经济危机。作者指出,目前的月费订阅模式建立在巨量算力补贴的基础上,企业长期亏损运营。随着推理成本因模型复杂化而上升,这种“次贷式 AI 危机”终将爆发,迫使行业转向按 token 真实计费,届时大量用户的真实成本将激增,导致商业模式崩塌。
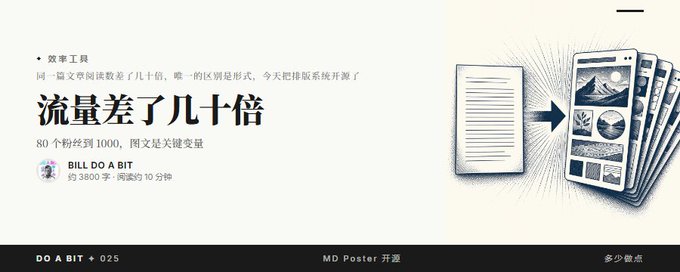
作者分享了其公众号粉丝从 80 涨到 1000 的经验,发现将长文转化为图文卡片可使阅读量提升 5-20 倍。为此,作者开源了一套基于 Python 和 Playwright 的自动化排版系统,能将 Markdown 转化为精美图片,将排版时间从 2 小时缩短至 30 秒。该工具结合 AI 指令,实现了低门槛的批量内容生产,适用于公众号、小红书等多平台分发。
Compound Engineering v3.3.0 版本发布,核心更新在于优化 Agent 的交互模式。新版 Agent 会在执行耗时任务前先展示其理解(Stated、Inferred、Out-of-scope),从而在早期纠正错误假设,降低返工成本。此外,文档审查和代码审查技能变得更加智能,减少了不必要的用户打断,能够自动修复更多问题,旨在让 Agent 更易于纠正且更值得信赖。
大多数用户仅将 Hermes Agent 视为简单的聊天机器人,浪费了其 92% 的潜力。文章介绍了 15 个改变游戏规则的高级功能,包括:SOUL.md 个性化设定、持久化记忆(MEMORY.md)、会话分支与回滚、供应商无关的模型切换、17 平台网关、实时语音交互、内置 Cron 定时任务以及上百个可用的 Skill 斜杠命令。掌握这些功能可以将 Hermes 从单纯的对话工具转变为全功能的自动化与生产力中心。
Warp 创始人 Zach Lloyd 宣布 Warp 客户端正式开源,采用 AGPL 许可证。此次变革核心在于由 Oz 云代理编排平台管理的“Agent 优先”工作流,社区可参与构建。OpenAI 作为创始赞助商,相关工作流由 GPT 模型驱动。Warp 认为,由人类管理规模化 Agent 来构建生产级软件是未来的开发模型。此举旨在打破内部开发瓶颈,让社区参与监督 Agent 并贡献高杠杆工作。新版本还增加了对 Kimi 等开源模型的支持及设置文件可编程控制。
本文介绍了 Scout,一个开源的企业级“上下文代理”(Company Brain)。针对现有方案将所有数据存入向量数据库导致索引过时的问题,Scout 提出了“导航优于搜索”的理念,通过 Context Providers 连接 Slack、Google Drive 等实时数据源,像操作文件系统一样导航信息。它还能动态构建 Wiki 和 CRM,并通过持续学习形成闭环。