我是如何从好莱坞视效,开始转型做AIGC的
作者Cara曾参与《西部世界》《哥谭市》等好莱坞剧集的视效制作,回国后在外企视效公司、腾讯游戏工作,2026年7月裸辞All in AIGC。她发现当AI技术门槛降低后,做AIGC最难的不是技术,而是讲故事。文章记录了她用1000元预算试错、建立工作流的过程,并分享了两部作品的经验:《曜曜侠》花费800元、2分18秒,让她认识到短视频需要黄金三秒和强冲突;AI小猫Vlog《莫莫的Vlog》仅用1天、80元完成。她的结论是内容为王,先完成再完美。
作者Cara曾参与《西部世界》《哥谭市》等好莱坞剧集的视效制作,回国后在外企视效公司、腾讯游戏工作,2026年7月裸辞All in AIGC。她发现当AI技术门槛降低后,做AIGC最难的不是技术,而是讲故事。文章记录了她用1000元预算试错、建立工作流的过程,并分享了两部作品的经验:《曜曜侠》花费800元、2分18秒,让她认识到短视频需要黄金三秒和强冲突;AI小猫Vlog《莫莫的Vlog》仅用1天、80元完成。她的结论是内容为王,先完成再完美。
作者详细记录了从零开始训练一个专属人物 LoRA 的完整实战流程。他使用 GPT Image 2 生成 56 张虚构人物训练数据,基于开源模型 MOSS-Image(5B 参数 Diffusion Transformer)进行微调,仅用一张 RTX 4090 训练约 65 分钟即获得稳定的人物形象生成能力。文章涵盖数据准备、Caption 标注、Checkpoint 选择、效果验收等关键环节,并指出了过拟合等常见问题。作者将整个流程开源到 GitHub,提供运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,建议初学者亲手跑一遍以真正理解 LoRA 训练原理,一通百通。
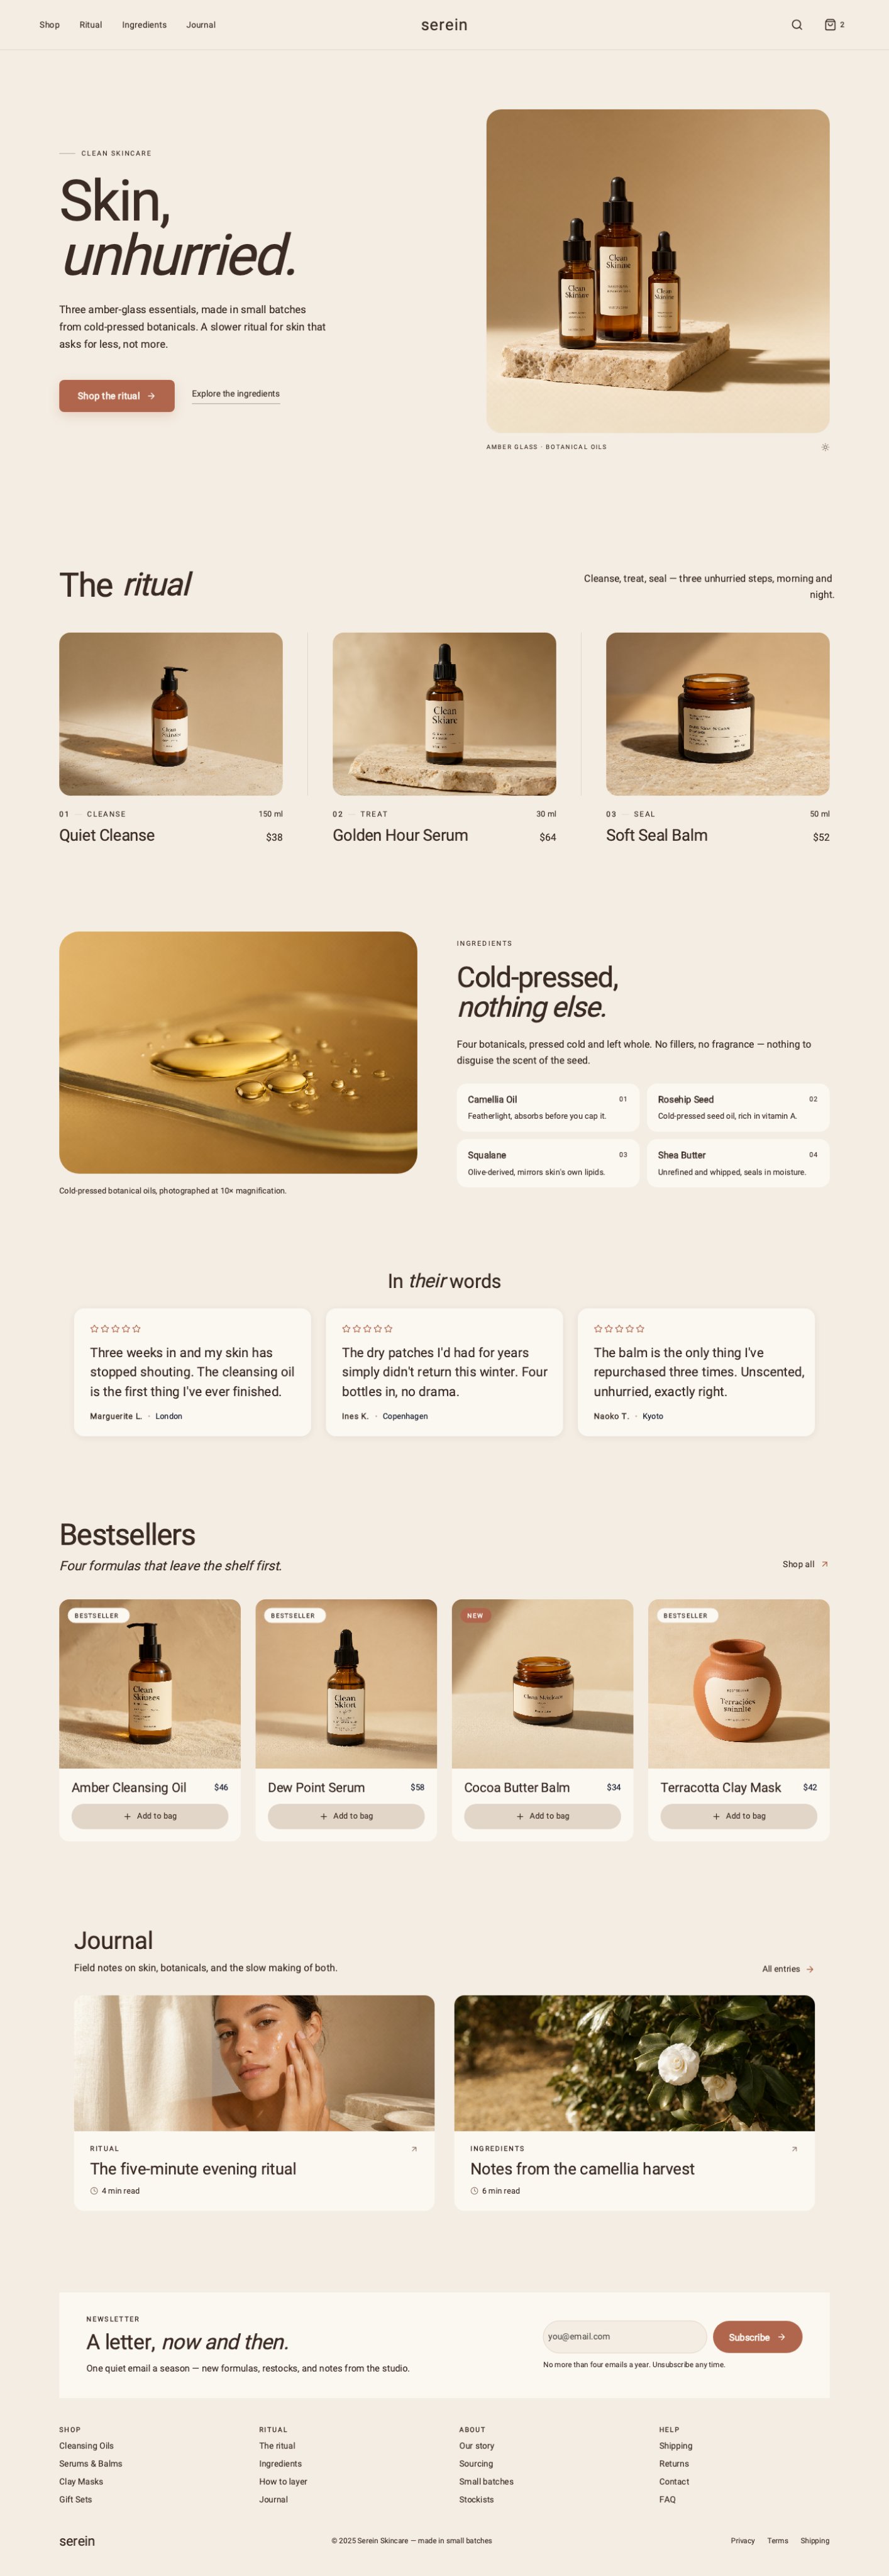
作者分享使用 DeepSeek-V4.1-Flash 1017 模型配合开源 AI 原生设计工具 OpenPencil 和生图模型 Qwen-Image-2.1 Turbo 制作电商落地页与模特图的实战体验。文章包含完整的落地页设计提示词和模特生成提示词,展示了生成结果的高审美水准,并提到 OpenPencil 是一款开源免费的 AI Native 设计工具,核心能力是通过 Agent 输出高质量 UI 设计稿、卡片、轮播图、PPT 等,适用于电商页面和海报制作,评论区多人交作业复刻效果。
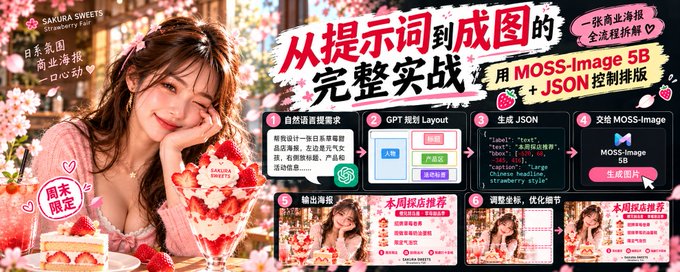
作者测试了模思智能开源的 5B 生图模型 MOSS-Image,重点验证其文字渲染与 JSON Layout 结构化布局能力。通过虚构日系甜品店海报案例,对比传统自然语言 Prompt 与 JSON 布局控制的效果差异:JSON 可将人物、产品、标题等元素按坐标框精确定位,类似写前端页面。三轮测试覆盖主视觉、商业活动海报排版及中英文文字生成,验证了文案正确率、版式适配与视觉融合。结论是 JSON Layout 虽非 PS 级精确编辑,但能将模糊排版需求变为结构化描述,对商业海报、电商图等场景具有实际价值。
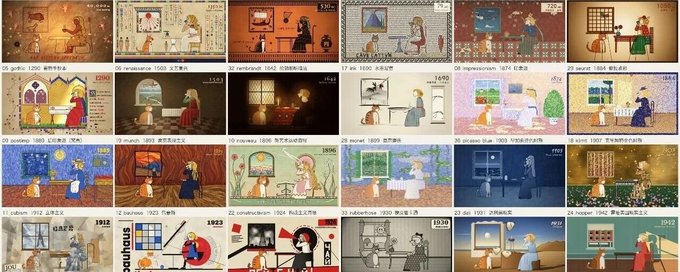
文章系统讲解美术色彩学中的“调性”(Tonality)概念:调性是画面中所有色彩在明度、纯度、冷暖及面积比例关系下形成的整体视觉秩序与情绪特征。作者区分了色调与调性,剖析决定调性的四大因素,并以伦勃朗、维米尔、哈默修伊的古典油画为例说明调性统一的原理。最后将这一美术逻辑迁移到 AIGC 图像创作中,指出相比简单罗列色卡,描述调性关系能让提示词更完整、画面更协调。
作者用一道难题对比测试开源 5B 图像模型 MOSS-Image 与闭源最强的 GPT Image 2.5:在一张水墨长卷中画出李白临江举杯场景,写出《将进酒》全文12行书法,配标题、作者、朱印和英文,并精确控制酒杯数量。第一轮两者都通过,但第二轮仅改两处细节后,GPT Image 2.5 数错酒杯,MOSS-Image 两轮全部正确。文章分析了小模型在中英文渲染、长提示词理解(支持4K tokens)和风格控制上的优势,并分享了结构化布局、负面约束等复杂提示词技巧,附完整提示词。MOSS-Image 已开源权重和代码,支持 LoRA 微调,ComfyUI 下载量突破70万。
作者实测开源的 MOSS-Image(基于 5B DiT 主干)文生图模型,创作宋城市集、汴京灯市、青绿千里江山等中国风作品。文中分享了通过 JSON Layout 控制构图、中文店招直出、参考布局改材质(丝绸、青瓷、墨金)等玩法,并给出具体参数与工作流:先写场景拆布局,再生成、放大核对、迭代修改。模型 Base/SFT 权重与代码已开源,支持 4K tokens 提示词与微调。
文章整理了10种适合中国市场的AI美女图片变现方式,包括小红书养号接品牌广告、售卖高清壁纸素材、闲鱼AI写真头像定制、帮电商商家制作AI模特图、打造虚拟IP、出售提示词教程、参加AI创作比赛、为短视频博主制作视频素材、给线下商家做宣传海报、以及设计插画周边等。作者结合AYAYI、柳夜熙等真实案例说明变现逻辑,并建议普通人从可明确交付的小项目入手,同时强调需注意肖像权与合规问题。
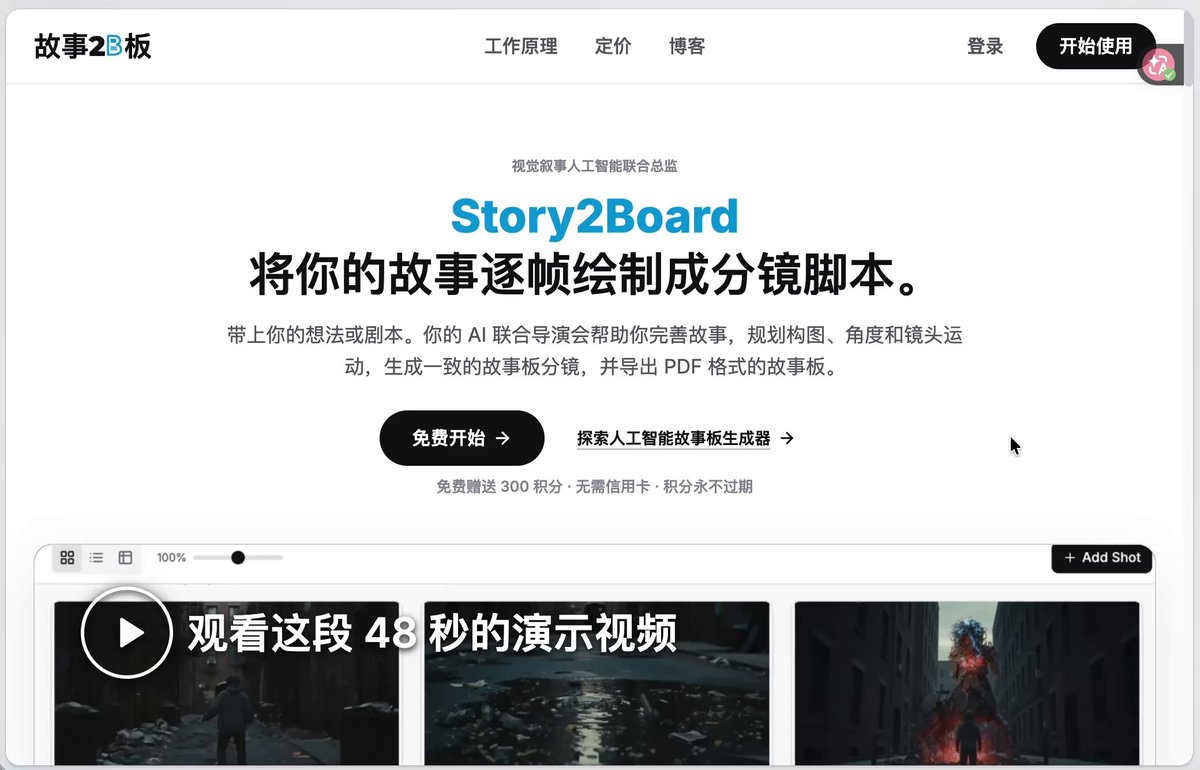
前字节团队推出专为独立导演和广告人打造的 AI 分镜 Agent「Story2Board」,蒸馏 250 部影史名片构建 27 万+ 电影分镜索引库。其核心亮点包括:通过 Consistency Layer 固化角色、道具和场景资产,解决人物一致性问题;接入影史镜头标注数据,可像专业摄影指导一样反推景别、运镜方式并解释情绪动机;支持导出含场记数据的 PDF 分镜表。商业模式采用按点数充值而非订阅制,降低了尝鲜门槛,但作者也指出这牺牲了 LTV 和营收可预测性,对获客能力要求更高。
文章介绍了 MoodMax 新推出的电商创作 Agent,面向双 11 等大促场景,解决商家素材制作慢的痛点。用户只需上传商品图、模特图和参考编排图,用自然语言描述需求,Agent 即可完成拆解规划、逐张生成和自动编排,交付主图、SKU 图、详情页、海报、推广图及带货短视频等成套内容。生成结果适配淘宝、京东、拼多多、亚马逊、SHEIN 等海内外主流平台规格。产品还提供爆款短视频提示词模板库,支持选模板、传素材、三步出片。作者认为素材产能比创意优化更关键,这类 Agent 适合先跑通成套交付流程。
本文是作者基于3家企业AI内训经验整理的AI入门长文,涵盖四大部分:大模型通识、提示词方法、智能体入门与实操。文章用通俗语言解释AIGC概念、大模型的定义与工作原理(概率预测文字接龙)、AI的优势(信息处理、知识覆盖、内容生成)与局限(幻觉、时效性、偏见、推理限制),并阐明AI软件=大模型+产品界面的本质,介绍提示词、微调、RAG三种大模型优化手段,帮助读者快速建立完整的AI认知框架。
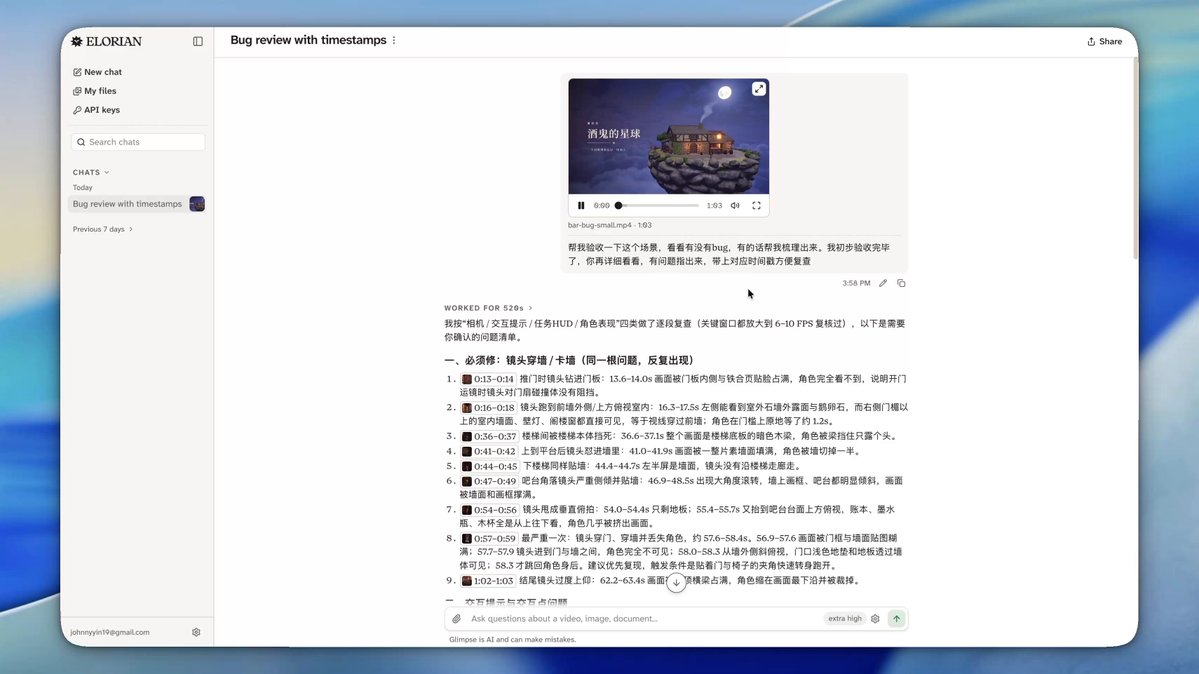
作者分享了使用 Elorian AI 刚发布的视觉理解与推理大模型 Glimpse 的体验。该模型能原生理解图片和视频中元素的位置、结构与空间关系。作者将其用于小王子游戏的 bug 排查:只需提供实际游玩录屏,Glimpse 就能分析游戏设计是否合理并梳理潜在 bug。实测中,在无游戏上下文情况下,其发现的问题数量是 Astra 的 3 倍,且可按视频时间戳罗列细节问题,便于逐一核验,极大解决了个人开发者验收容易遗漏的痛点。Glimpse 已开放 API,可接入 Codex、Claude Code 完善验收流程,也适合视频/图片生成等 AIGC 场景。
作者分析了100多个国外开源Claude动画源码,通过双盲实验和消融实验迭代开发出Claude Motion skill,让Codex也能生成具有“Claude感”的动画视频。该skill通过素材库(含47条源码案例、5套制作系统、14个场景入口、30条物件包)为GPT提供可复用的绘图实现,GPT负责判断题目需求、检索案例、复制实现并重写主体与镜头,最终由浏览器逐帧绘制、FFmpeg合成视频。文章展示了天文台、灯塔、光圈等五组盲测对照成果,效果显著优于官方skill,项目已在GitHub开源。
作者从自己在X上分享的提示词中精选出收藏和点赞最多的30条,整理成可直接复制的合集,涵盖AI视频与人像自拍两大类玩法。视频类包括苹果风产品广告片、一镜十姿时装视频、奢侈品风塑料袋广告、无人机第一视角导览、高奢刺绣广告等;图片类包括黏土定格动画人像、自拍虚拟试穿、杂志大片重绘、和小时候的自己合影、85mm焦外抽离、极端广角人像等。每条附提示词原文、出图效果链接及修改建议,适用工具涉及GPT-Image-2、海螺H3、Seedance 2.0等模型。
文章以《疯狂水世界》的AI广告为案例,分析其营销为何能引发玩梗与自发传播。作者指出这类广告先具备独立娱乐价值,通过固定人物与可变冲突的设计让观众愿意追更,可复述的符号(如海水过滤器)降低了分享门槛,使不玩游戏的人也成为传播者。AI的作用不只是降低制作成本,更在于缩短创意迭代循环,让同一故事框架能持续生成变体。最后强调营销价值需落到产品端,分为内容观看、转化、留存三个环节衡量,品牌须保持一致性才能积累用户记忆。
文章探讨了AI视频创作中工具与导演思维的关系。作者认为,尽管Vibe Creating等理念降低了技术门槛,让普通人能用自然语言生成视频,但决定作品上限的仍是导演思维:一是动手前清楚知道自己想要什么画面和感受,二是能判断生成结果的对错并明确改进方向。作者以Vibe Coding类比,指出描述与判断越模糊,结果越随机。纯粹玩乐时无需导演思维,但要做出系列作品或商业交付,就必须具备画面感和叙事能力。学习影视理论的意义不在术语,而在构建脑中画面与判断力。
作者分享了其开源AI画布项目BeefTV在一周内获得800 stars的经验。项目源于对闭源无限画布产品体验的不满,定位为轻量化、用户体验优先的开源AI画布工作台。落地过程中,作者借助CodeX等AI工具完成100%代码编写,通过借鉴成熟开源方案、用Playwright拆解优秀产品交互、配置专门Agent自动化测试等方式提效,并沉淀出skill。推广方面,作者利用'开源版LibTV'的概念作为社交货币引发传播,通过开源积累用户反馈,构建社群连接,并探索算力商业闭环,目标是打造开源AIGC平台。
作者分享了使用豆包工作「无限画布」进行 AI 设计的实操体验。从一张石榴海报的灵感出发,依次完成了产品图、品牌展示板、包装、帆布袋、社媒图、宣传海报等一整套品牌物料,最后还生成了一条 15 秒广告视频。文章详细介绍了无限画布的核心功能,包括引用生成、局部编辑、分图层、抠图、消除、扩图和变清晰等工具,以及「创意设计」和「创意视频」Agent 的使用方法。作者强调这种工作流让没有设计背景的人也能快速迭代创作,对比不同方案并逐步打磨细节,大大降低了创作门槛。
本文整理了 OpenAI 官方 GPT Image 2.5 提示词写作指南的八条核心原则:先定义结果、选易维护格式、描述可见细节、写清人物动作、精确文字加引号、分开要改与要保持的内容、给参考图编号、有意识迭代。同时介绍了模型与参数(quality、size、background)的选择建议,并结合人像摄影与自然景物两类示例,给出中文提示词模板和实操要点,帮助用户写出可控、可迭代的图像生成提示词。
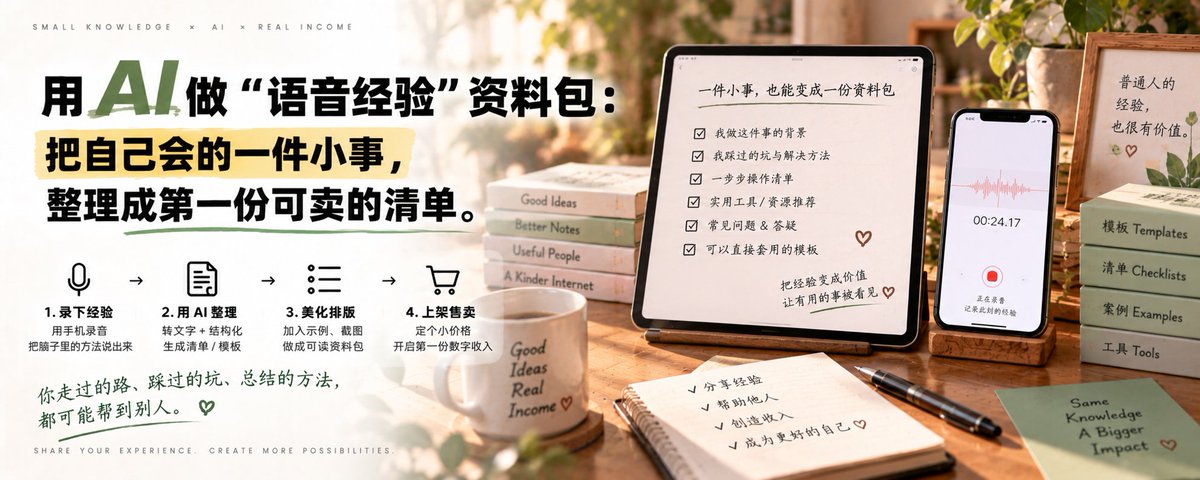
文章介绍普通人如何利用 AI 将自己的实践经验转化为可出售的资料包。作者建议选择至少做过三次的小事,用手机口述 10 分钟,再借助豆包、Kimi、ChatGPT 等工具整理成可执行清单,并强调必须逐行核对 AI 输出。资料包应排成 3-5 页 PDF 并附可编辑表格,明示内容来源和使用范围,不抄袭他人教程。定价可从 9.9 元起步,先让 3 位目标用户免费试用并根据反馈迭代。文章强调卖的是个人真实实践清单而非权威建议,这是普通人最稳的 AI 产品化起点。
作者发布了一个纯网页小游戏站 NEON ARCADE,收录 6 款由 AI 参与创造的免费游戏,无需下载注册,浏览器即点即玩。游戏包括致敬红白机的《魂斗罗 2026》重制版(支持双人同屏和手机触屏)、12v12 据点争夺《星陨前线》、小队养成《智械前线》、霓虹生存《霓潮》、摩托竞速格斗《公路狂徒》以及以山海经神兽为 BOSS 的 3D 弹幕空战《雷霆战翼》。站内还设有「AI 放映厅」播放 AI 生成的 MV《千禧凝思》,站点将持续更新。
文章分析了公众号等平台大量下架低质量AI生成内容后,创作者即使降低AI检测百分比仍拿不到曝光的原因:平台核心判定标准是内容是否带来新信息,而非是否用AI。作者指出信息密度不足、标题党、模板化表达、虚构数据、内容同质化等是限流主因,并通过职场博主案例说明全手写也会因同质化被限流。解决方案包括发布前做多维度检测(AI率、同质化、敏感词等),保持信息增量和独特价值,避免频繁修改等异常行为,持续输出高质量内容以恢复账号权重。
花叔开源了一个名为huashu-art-motion的动画skill,可用Claude Code等agent生成代码绘制场景、合成配乐的动画视频。文章展示了复刻Fable 5.5风格艺术穿越动画的过程,制作了一镜到底穿越20多种画风的片子,以及白板、Vox、3Blue1Brown等8种解说风格动画,适用于B站、YouTube科普和教程视频。skill内含几十张艺术风格卡、参考视频拆解方法和自动质检流程,已开源在GitHub,支持Claude Code、Codex、Cursor等工具安装使用。
本文详细介绍 AI 剪辑工具 ChatCut 的使用方法。ChatCut 通过自然语言对话完成视频剪辑,与需要手动操作的剪映形成互补:ChatCut 负责初剪、挑高光、配乐、加字幕等,剪映负责最后精修,且支持导出为可编辑的剪映草稿。文章涵盖桌面端/网页端/Agent Plugin 三种入口的安装方式,讲解如何接入 Codex 和 Claude Code 等 AI 智能体,介绍界面布局、剪辑流程、字幕文本式剪辑、导出设置、免费与 Pro 套餐区别,以及常见坑和实用指令速查表,帮助创作者快速上手 AI 驱动的视频剪辑工作流。
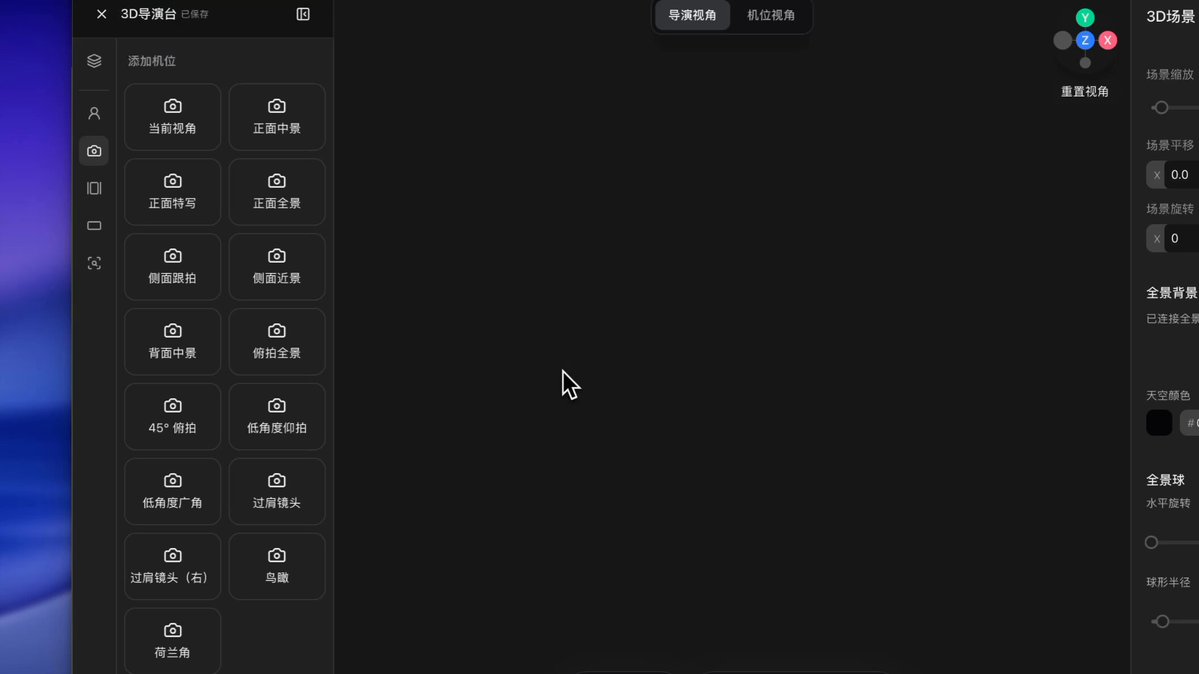
作者宣布在开源项目 BeefTV 中上线 3D 导演台功能,解决 AI 视频制作中“脑中有画面但模型听不懂怎么拍”的痛点。用户可在 3D 场景中创建白模、布置镜头机位与人物关系,再交由 AI 精确生成专业级视频。项目从零复刻 LibTV,已突破 700 stars,作者虽无科班编程经验,但借助开源社区积极反馈持续优化画布 UI 与导演台功能,并邀请用户加入微信社群共同建设 AIGC 开源社区。
Kling 4.0 已进入封闭测试,预计10月正式发布。奥美资深创意总监、Kling AI 创意合作伙伴 Johnson Sheng 从商业制作角度对模型进行了实测。评测显示:4.0 在大幅度运镜和高速动态中保持画面稳定,支持最长30秒的一镜到底打斗场景生成,动作连贯且能与环境实时互动;通过千字长提示词(使用 Skill 编写)可准确理解复杂创意意图;在多场景切换中,人物、道具和环境保持高度一致性。模型还支持立体声音频、精准口型同步、最高4K分辨率和10-bit HDR输出,显著提升商业广告交付的可用性。
文章介绍了一套用 AI 从零制作 3D 模型的完整流程:先用 GPT Image 生成物体的前、后、左、右四视图(人物统一 T 姿势),再上传 TripoAI 通过多视图生成 3D 模型。作者详细讲解了模型精度与面型选择、整体与分件模型的取舍、贴图(全局贴图、Magic Brush 局部修补、PBR 材质、去光照开关)、重新拓扑降面、自动绑骨骼(人形与非人形)以及按用途导出 GLB/FBX/STL/USDZ 等格式。最后用 GPT 生成基于 model-viewer 的单文件 HTML 预览页,实现拖拽旋转、动画切换与截图功能,让模型可直接用于网站或工作中。
作者将平时积累的AI视觉创作经验整理为开源项目Derekwen AIGC Visual Skills,包含30条案例记录、10个可复用Agent Skills和16个公开视觉图例。项目把提示词、参考条件、关键控制点整理成统一数据结构,并配Gallery示例图方便按效果查找。涵盖角色设定板、多参考图融合、品牌视觉、社媒配图等场景,解决角色一致性、素材组合等常见问题。支持直接用生图工具改提示词,或通过Agent接入Skill两种使用方式,采用MIT许可。
文章探讨AI如何降低创作门槛:过去人们因不会编曲、绘画等技术而无法实现想法,如今文字成为通用创作接口,可将内在感受转化为图片、音乐、视频。作者称之为“反向通感”——从文字让人脑补变为文字让机器落地。但AI降低的是制作门槛而非审美门槛,真正的分水岭在于内在积累:能否说清自己要什么、能否判断好坏。输出的差距本质是内在世界分辨率的差距,唯有真切体验世界,才能让内在积累这座“矿”永不枯竭。
文章介绍了 Fotor Agent,一款能将 Markdown、PDF、Word、Excel 等文档转化为可编辑 4K MG(动态图形)视频的 AI 工具。它解决了传统 AI 视频生成只能输出不可编辑 MP4 的痛点,通过原生多轨道编排(画面、配音、字幕、MG 动画分离),支持自然语言指挥制作、精准局部修改和工程复用。作者实测用 PDF 生成数字人讲解视频,初稿时间从 3-5 天压缩到 40 分钟,成本约 $7.41,适合商业交付与高频改稿场景。