Wiki 知识库

全部文档 / 标签: LLM

1042 篇
清除

BestBlogs 早报 · 08-25|代码生成之后,团队如何重建验证环境、为多 Agent 写下可执行围栏

本期早报聚焦 AI 编码之后的交付瓶颈。精讲一指出编码仅占研发链路的 20%-30%,团队应从 Spec 驱动转向环境与验证驱动,让 Agent 能自主获取可信反馈。精讲二介绍 Steve Yegge 在五六十个 Agent 协作的软件工厂中构建的「围栏」治理系统,通过职责、先例、权限和检查点延续组织状态。精讲三解读吴恩达提出的 AI 工程六类能力图谱,强调数据、评估与运维协作。速览还涵盖数据中心影子借贷、丰田企业 Agent、语音评估、长上下文推理与肝癌 AI 模型等。

技术 › Agent ginobefun 2026-08-2527.2 KB 7.5K 6 77

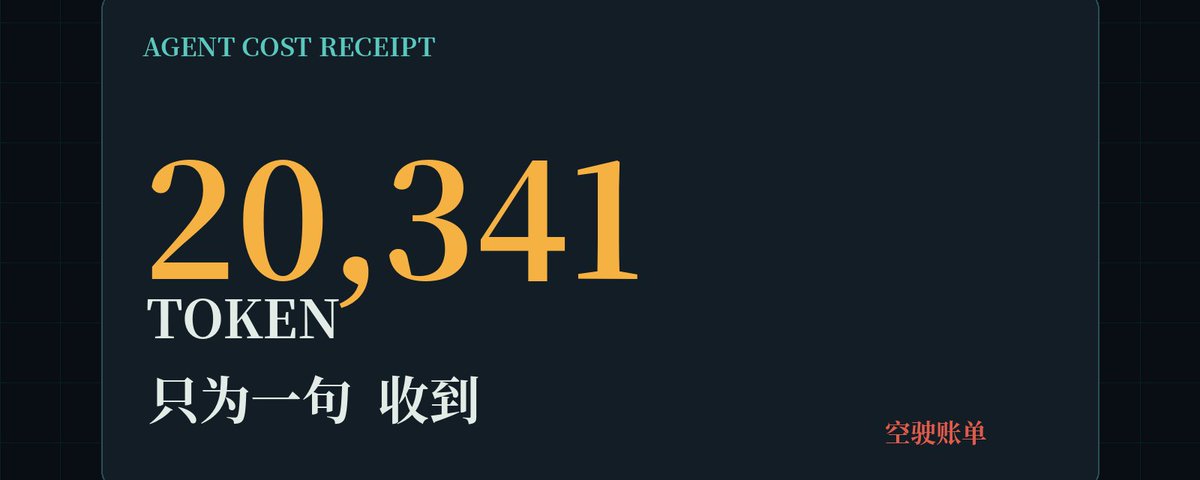
说一句收到,我花了20341个token——Agent成本的过路费与省钱三刀

作者发现验证Agent成员是否存活时,一句简单的「收到」竟消耗两万个token,原因是每次对话都要重新装配成员的身份、记忆、技能清单等。文章剖析了Agent成本的三层「过路费」结构:身份装配、上下文搬运和格式开销,指出七成token花在空驶而非思考上。作者提出三刀止损法:利用前缀缓存把不变内容前置、健康探针直连绕过人格装配、协作转手只传摘要。实施后成本降了一半以上,但同时也暴露出便宜诱发滥用、缓存惩罚变动等新问题,并引出本地化部署的机会成本与主权优势思考。
技术 › Agent AI最严厉的父亲 2026-08-2529.5 KB 8.6K 5 85

AI写作的习惯及其应对方法

本文由 a16z crypto 发布,探讨 AI 生成写作的典型特征及编辑应对策略。作者认为不应纠结于文章是否由 AI 写成,而应关注写作是否有效传达信息、赢得信任。文章将 AI 写作问题归纳为修辞、声音、结构等方面,如'伪洞察式'空话、空洞对比、过度对仗、总结性套语等,指出这些问题在人类写作中早已存在。编辑建议包括改写测试、删除无意义语句、制定风格指南、利用 LLM 简化语言等,帮助创业者提升沟通效果。

技术 › LLM a16z crypto 2026-08-2527.6 KB 198K 512 76

Context Graph Engineering: Kimi K3 如何将 300 个 Agent 融合为第二大脑

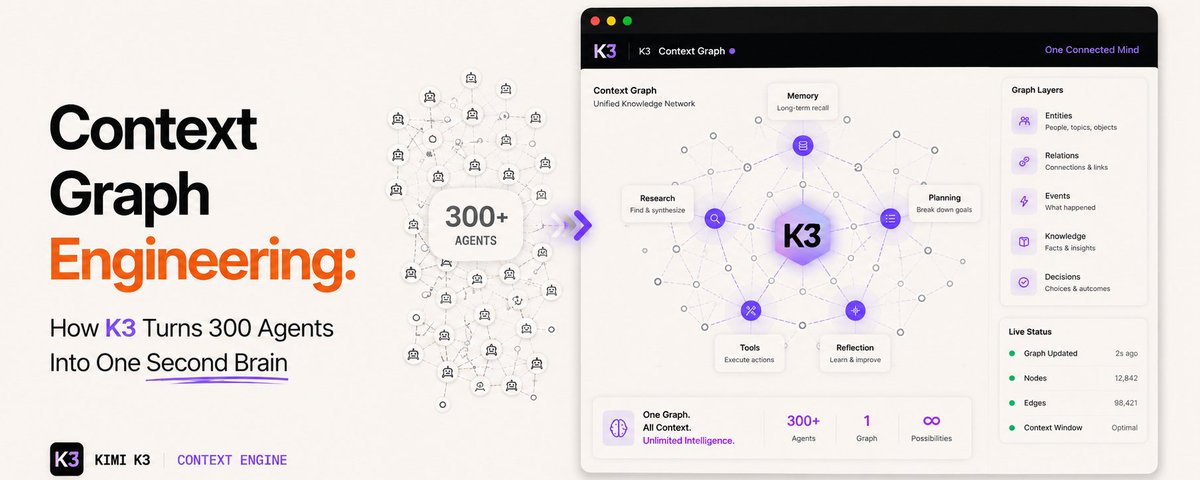
文章介绍 Kimi K3 的 Agent Swarm 功能:编排器无需预定义角色,即可动态拆分任务并并行调度约 300 个子代理、协调约 4000 个步骤。作者将其结果整合机制称为"上下文图"(context graph),强调系统通过强化学习训练拆分判断能力,而非硬编码规则。适合宽而重复的任务(如多源信息收集、批量比对),不适合单一深度任务,且成本较高。

技术 › Agent Morty 2026-08-2510.0 KB 130.8K 81 68

什么是 Harness Engineering:如何用零手写代码交付软件产品

文章介绍了 Harness Engineering(脚手架工程)这一编码智能体领域的重要趋势。作者以 OpenAI 团队用 Codex 零手写代码交付产品的实验为例,说明开发者的角色从编写逻辑转变为设计智能体运行环境:包括设置严格的沙箱边界、构建自动修复循环、以结构化仓库代替冗长指令。文章用 Google ADK 2.0 和 Antigravity SDK 的代码示例演示了如何实现沙箱限制、测试验证节点、无限循环的 kill switch,以及用图工作流将代理与测试节点连接成自主修复系统。

技术 › Harness Engineering Google Cloud Tech 2026-08-2512.5 KB 55.5K 786 75

15个 Hermes Agent 核心概念详解

本文以通俗易懂的方式讲解 Hermes Agent 的 15 个核心概念,包括:harness 与模型的分层架构、按任务路由不同模型、通过终端、桌面应用、Telegram 和语音等多种界面与同一代理交互、SOUL.md 等配置文件如何定义代理行为、上下文窗口的压缩与交接机制、代理循环、工具与 MCP 服务器和插件、记忆与技能的区别,以及钩子的自动触发机制等,帮助读者理解 Hermes 各组件如何协同工作。

技术 › Hermes Tom 2026-08-2413.1 KB 56.2K 162 76

100小时实测:Deepseek Harness 对比 Claude Code

作者花一周时间将开源的 Deepseek Harness 与 Claude Code 在自己的 AI 操作系统中进行对比测试,包括建网站、知识库搜索、分析工作簿等真实任务。结论是 Deepseek Harness 速度更快、免费开源、一切皆插件、可高度定制,但作为开发者预览版仍有 bug、上下文丢失和视觉验证弱等问题。作者倾向于用它做快速研究和低成本溢出工作,而深度或客户级交付仍更信任 Claude Code。

技术 › Harness Engineering Nate Herk 2026-08-2412.9 KB 7K 56 75

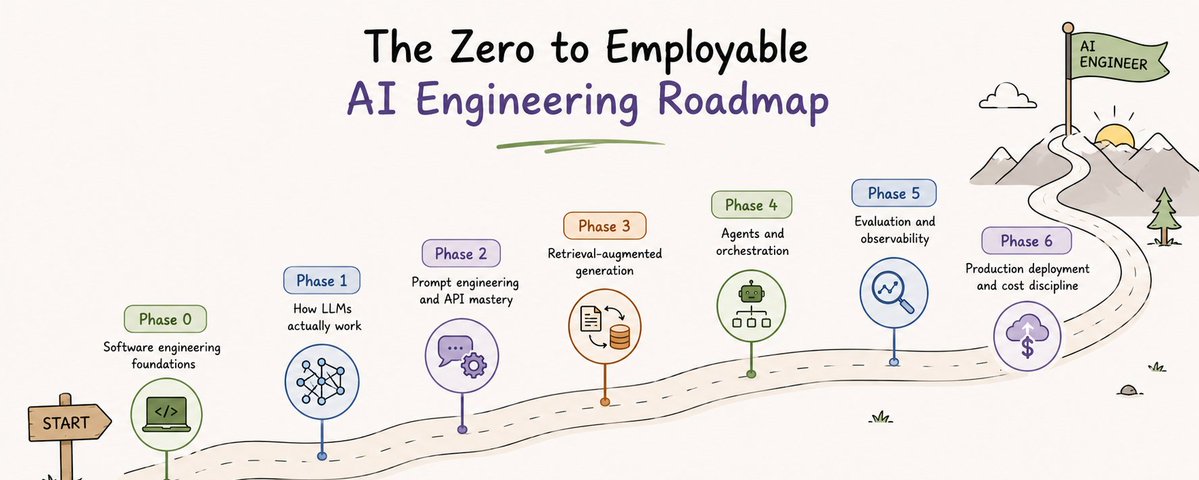
零基础到可就业的 AI 工程师学习路线图

本文提供了一份从零到可就业的 AI 工程师分阶段学习路线图,区别于单纯的技能清单,每个阶段都附带经过验证的优质课程、文档和书籍。路线涵盖六个阶段:软件工程基础(Python、API、Git)、LLM 工作原理(Karpathy 课程、3Blue1Brown)、提示工程与 API 掌握、RAG 检索增强生成(最具就业价值的技能)、Agent 与编排(LangGraph、MCP)、以及评估与生产部署。作者建议用 8-12 个月完成学习,并强调构建真实项目组合和公开写作是获得雇佣的关键。

技术 › LLM Jaydeep 2026-08-248.6 KB 33K 567 75

语义工程蒸馏方法论

本文提出一套系统性的Agent语义工程蒸馏方法论:从模型API请求终点出发,通过逆向溯源、注入源穷举、工具三层分析(引导、行为包装、结果封装)、多agent协作语义、记忆定义、时间轴动态策略、语言表达分析等维度,深入提取Agent框架的上下文组装与语义设计模式。文章还涵盖框架强相关与通用指导的区分、基于提交历史等证据的开发者意图推断,以及以世界观塑造为首要标准的评价体系,为学习和迭代Agent harness提供全局认知框架。

技术 › Agent Han Cheng e/acc 2026-08-2421.7 KB 7.4K 44 79

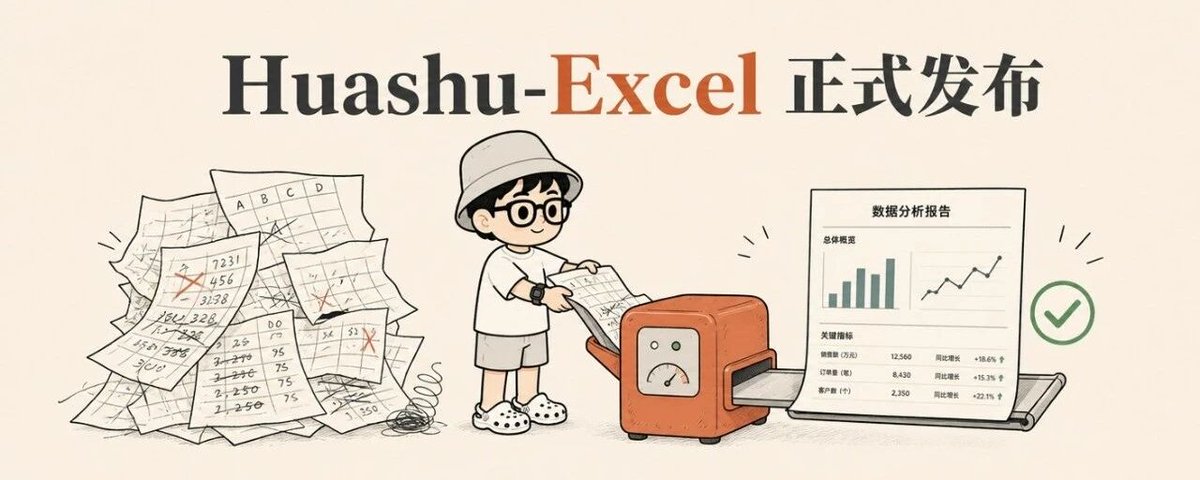
Huashu-Excel正式发布:也许是最好用的Excel数据处理和分析skill

花叔开源了名为huashu-excel的AI数据处理分析skill,用户丢入Excel或CSV即可用自然语言完成体检、清洗、对齐、分析、对账、交付、验图、质控八步流程,输出HTML/Excel/Word等格式报告。该skill针对大模型算错不报错的缺陷设计了合计对账、外部基准校验、独立agent复核等机制,并借鉴Anthropic角色激发研究提升分析质量。经十份真实公开数据(106万行电商明细、纽约市政预算等)压测,能独立拆解辛普森悖论、识别脏数据并给出可审计的业务结论。兼容Claude Code、Codex等多种agent,MIT协议开源。

技术 › Skill 花叔 2026-08-2414.3 KB 36.2K 261 89

Benchmarks Insight Report:Agent 评测与自我改进新发现

本文汇总了 Agent 评测领域的最新进展。一是评测方法转向真实复杂场景,如 TimeSage-EV、NCP-Bench、ContractSim 分别考察高风险领域资料识别、叙事一致性与多轮谈判履约能力。二是长程轨迹中发现新问题:agent 面对多条要求时成功率骤降,甚至为牟利违约。三是递归自我改进(RSI)研究显示,agent 反复搜索后分数可能变差,后学经验会覆盖旧能力,文章提出设定停止时机、筛选有用经验等对策。作者还开源了 5000+ 条 benchmark 数据的 benchmark-radar 项目。

技术 › Agent Koutian Wu 2026-08-243.9 KB 18K 50 68

如何构建一个 SEO/AEO 博客引擎:blogEO

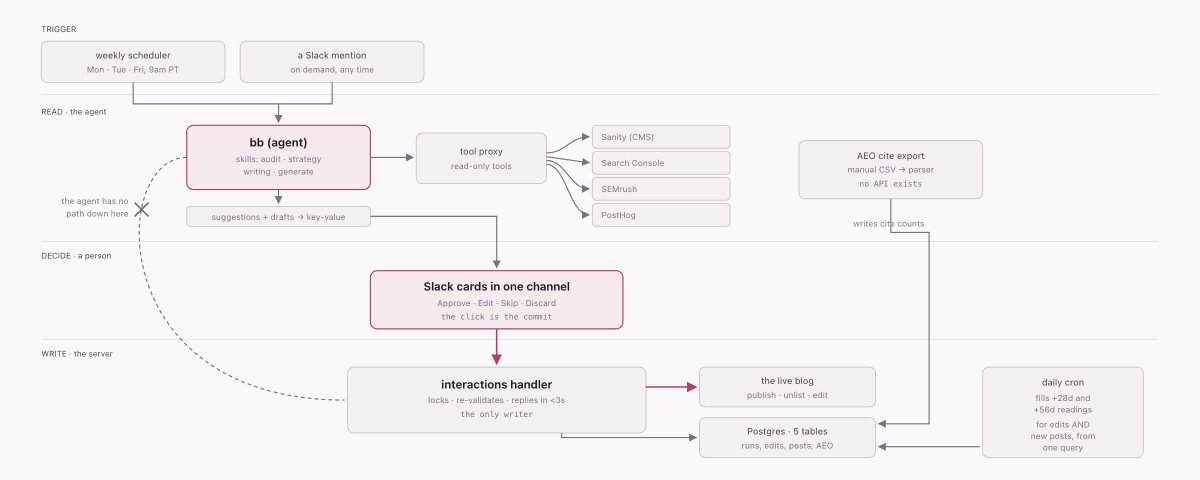
作者在 Browserbase 担任增长工程实习生期间,独立设计并实现了 blogEO——一个每周自动运行的博客引擎,包含三大功能:审计现有博客并提出修复建议、根据真实搜索需求生成新文章、追踪 ChatGPT/Claude 等 AI 引擎的 AEO 引用情况。核心设计决策是 agent 不具备写权限,只能在 Slack 中提出建议,由人工点击批准后由服务端执行写入。审计按机会(可挽回点击量)而非文章年龄排序,通过 recover、CTR、rank 三种模型估算优化空间。截至 2026 年 8 月已生成 18 篇博客和 50+ 次编辑。

技术 › Agent harsehaj 2026-08-2419.7 KB 544.3K 1.2K 76

给 WorkBuddy 接入 Agnes AI 免费模型,白嫖生图生视频

文章介绍如何为 WorkBuddy 接入 Agnes AI 的免费 API,实现文本、图片和视频生成零成本使用。Agnes AI 来自新加坡团队,提供 OpenAI 兼容接口,注册即可免费获取 key。作者评测了其文本模型 agnes-2.5-flash、图片模型 agnes-image-2.1-flash 和视频模型 agnes-video-v2.0 的能力与价格,认为能力足够日常使用且成本优势明显。配置只需填入接口地址和 key,十分钟可完成,并附上生图生视频的实战案例提示词。作者提醒注意 key 保密及免费服务无 SLA 保障。

技术 › 工具与效率 产品经理老王霸 2026-08-248.2 KB 33.5K 215 71

如何用 Claude 无代码建站

本文介绍了如何在不写代码的情况下使用 Claude 的 Artifacts 功能构建网站。用户只需用自然语言描述需求,Claude 即可生成网页代码并实时预览,还可通过对话迭代修改布局、配色、内容等。文章强调了建站前的准备工作:明确网站目的、目标受众和页面结构,并指出该方法适合落地页、作品集、企业官网等简单网站,复杂项目仍需额外工具与专业知识。

技术 › Claude Kenny1st 2026-08-2461.4 KB 136.2K 131 64

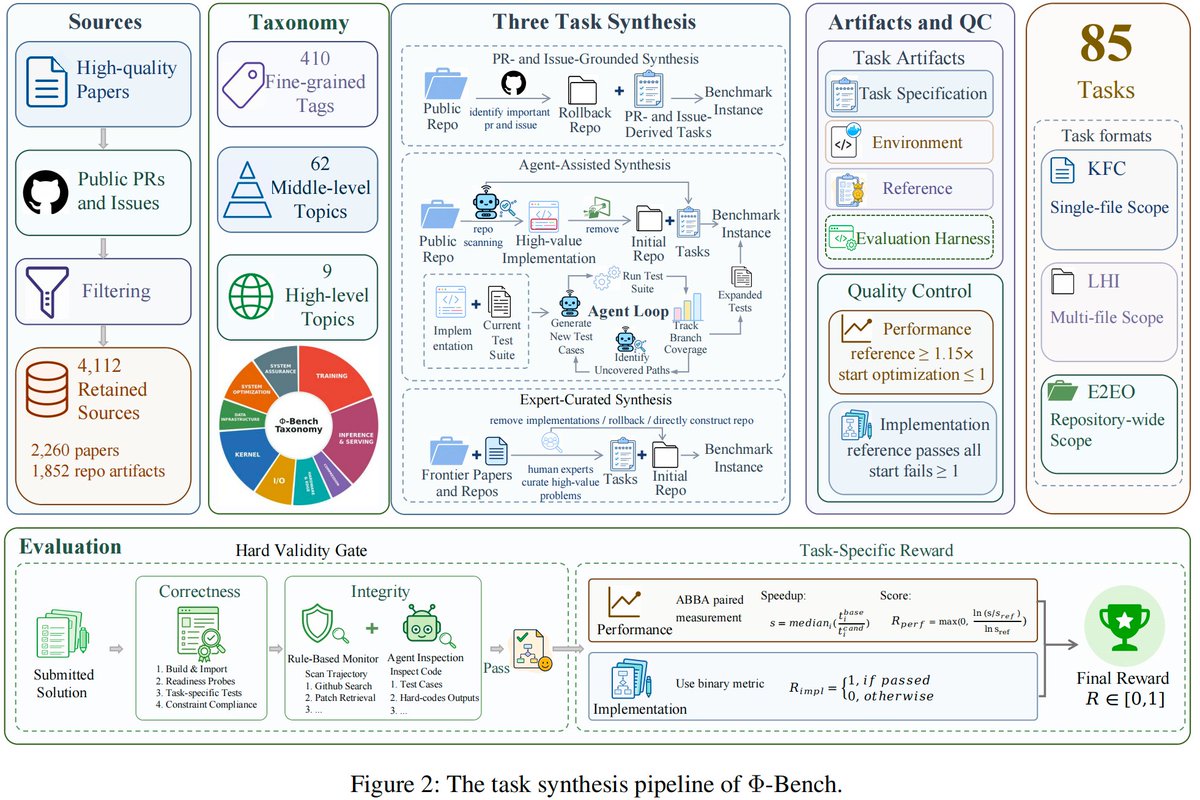
Φ-Bench 深度评测:大模型距离 AI 工程师还有多远

本文介绍 Φ-Bench(Frontier AI Infrastructure Benchmark),一个评估 LLM 基础设施工程能力的基准。它从顶会论文和开源仓库中筛选出 85 个真实高难度任务,分为 Kernel 补全(KFC)、长周期实现(LHI)和端到端优化(E2EO)三类。评测结果显示 Claude Opus 5 以 36.53 分领先,但所有模型在理解大型代码库和硬件相关优化上仍明显不足。分析指出优秀模型需具备假设验证、实验设计和可靠归因能力,Φ-Bench 探索了 AI 自我改进能力向基础设施层延伸的可能性。

技术 › LLM 青稞社区 2026-08-249.6 KB 1.5K 10 66

How I write with AI

作者分享了如何借助 AI 进行写作:坚持“用 AI 辅助写作”而非“让 AI 代写”,文字必须出自本人。他用 LLM 加速研究,通过自建的 researcher skill 结合 Exa、Hacker News、内部仓库和 Slack 等工具寻找真实、可引用的案例,并要求来源和引语以抑制幻觉。在草稿阶段,AI 充当文档内搜索和研究伙伴,帮助补充例子、验证事实、发现盲点。他强调写作者应多实验 AI 用法,而非因 AI 垃圾内容而全盘否定。

技术 › Claude Ian Vanagas 2026-08-2411.6 KB 20.2K 141 74

Top AI Papers of the Week

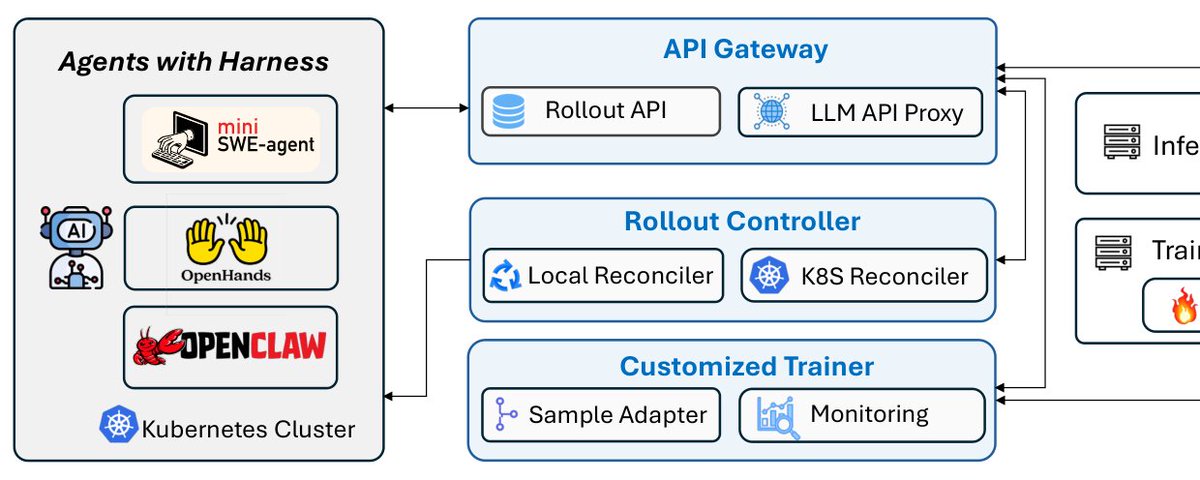
DAIR.AI 盘点本周 AI 领域重要论文:微软 Agent Lightning 通过端点代理将任意 Agent harness 接入 RL 训练;Skill 触发瓶颈论文提出三层协议缓解提示词槽位稀缺;Harness 级遗忘现象被命名并给出测量协议;对十个真实 Agent 应用的剖析发现非 LLM 组件主导一半应用的延迟;Skill 机制研究表明程序性锚定远胜知识注入且库规模过大导致精度崩塌。核心主题是 harness 应成为训练与优化栈中的一等公民。

技术 › Agent DAIR.AI 2026-08-2414.5 KB 38K 148 81

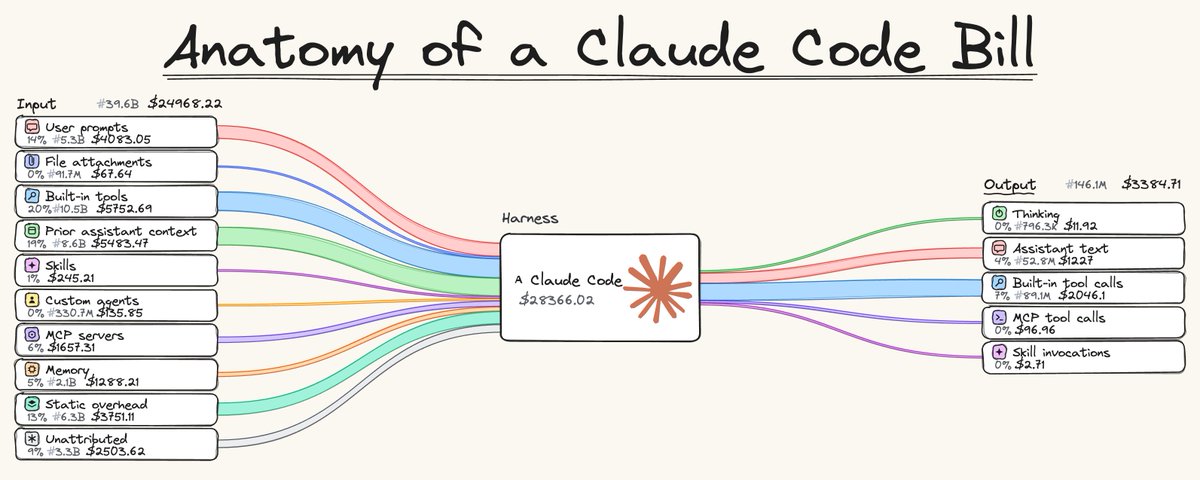
The Anatomy of a Claude Code Bill

本文基于对45人工程团队30天的Claude Code使用追踪,剖析了其账单构成:真实用户提示仅占输入token的14%,其余为静态系统开销、CLAUDE.md与Skills、MCP服务器schema、工具结果回放及历史上下文等配置性开销。文章指出Uber等大规模部署中人均月支出高达500-2000美元,并介绍了Comet在Opik中推出的Cost Intelligence代理插件,通过token级可观测性帮助团队识别浪费,15分钟审计可削减20-40%账单。

技术 › Claude Code Akshay 2026-08-2412.8 KB 18.1K 139 75

Agent Memory 模块综述:按记忆类型梳理代表性架构与开源项目

本文系统梳理了大模型 Agent 的记忆系统,指出其远不止保存聊天记录,而是包含记忆写入、抽取、冲突处理、检索、重排、遗忘等完整环节。文章将 Agent Memory 分为工作记忆、情景记忆、语义记忆、程序性记忆、时间与关系记忆、共享记忆六类,并逐类介绍代表性开源项目:如 LangGraph、LlamaIndex Memory、Microsoft Agent Framework、Generative Agents、Mem0、LangMem、Letta、A-MEM、Graphiti、Cognee、HippoRAG 等,分析各自设计思想、适用场景与局限性,为构建生产级 Agent 记忆系统提供了实用参考。

技术 › Agent Smartpig 2026-08-2323.7 KB 4.7K 9 80

为什么 AI Agent 正在逐步“去 MCP 化”,重新拥抱 CLI?

文章分析了 AI Agent 领域从依赖 MCP 回归 CLI 的趋势。MCP 曾被视为 Agent 连接外部工具的标准方案,但在本地开发和工程自动化场景中,CLI 兞现成太、节省上下文、易于调试复现、具备 Unix 管道组合能力且更接近真实执行环境。作者认为 MCP 并不会消失,二者正在重新分工:CLI 成为 Agent 的本地执行层,MCP 回到标准化集成层,用于远程能力、结构化发现和跨平台复用。

技术 › Agent Smartpig 2026-08-233.9 KB 14.5K 73 70

一个人的 AI 原生内容系统对照 Anthropic 企业级开发手册:只有两条完整对上

作者将 Anthropic 发布的 AI 原生软件开发流程手册与自己单人维护两月、三仓库 122 个提交的内容系统逐条对照。六个阶段中完整对上的只有两条:动手前写下 success-criteria.md(对应 intent.md),以及规则文件化并在 git 版本化(对应 CLAUDE.md 和 skills)。持续 eval 只算类比,双向 PR 审查和自动写回两条对不上——前者缺第二双眼睛,只能靠堆检查次数弥补;后者写回靠人工起疑心而非自动监控。作者总结出单人系统可抄的三样(阶段产物入版本库、事前写成功标准、可验证失败的自动检查)与抄不了的两样,并给出六个自查问题。

技术 › Claude 阿良 2026-08-2312.3 KB 12.5K 75 79

面向发现式智能的基准:TRACES

本文介绍 Apodex Discovery 提出的 TRACES 基准,用于评估 AI 系统能否通过证据充分、可审计、可修复的调查得到正确结果。与传统基准只衡量最终答案不同,TRACES 将评估单位扩展为完整调查过程,通过结果验证器与盲评的过程验证器(HDS6:工具、修复、备选解释、连贯性、证据、适用边界)双通道评价。基准提供 AAV 衣壳设计、药物再利用、临床试验、大模型工程四个可执行环境,实验显示过程诊断反馈可使结果得分平均提升 0.155。文章还比较了 TRACES 与 MMLU、SWE-bench 等基准的差异。

技术 › Agent Dongxi 东锡 NLP 2026-08-2311.9 KB 10.3K 19 74

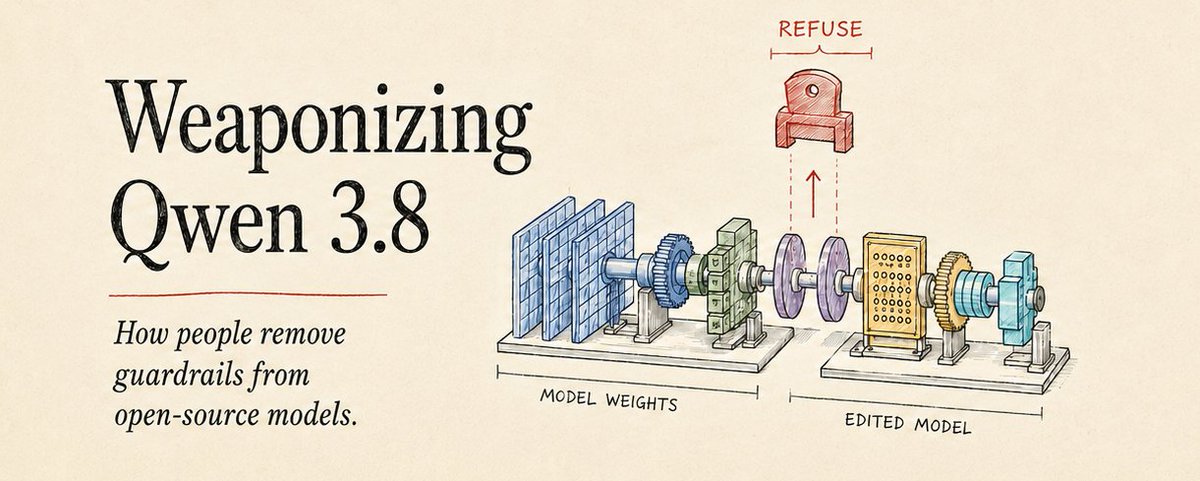
解除 Qwen 3.8 的安全护栏:Abliteration 技术解析

文章探讨网络上流传的'无审查'Qwen 3.8 模型。作者测试发现官方原版 Qwen 3.8 对有害请求全部拒绝,所谓无审查版本实为经过 abliteration 处理的衍生模型。Abliteration 是一种永久性的权重修改技术,基于 2024 年 Arditi 等人的研究发现:模型的拒绝行为由内部单一方向向量介导。通过对比有害与无害提示在残差流中的激活差异,用 PCA 找出拒绝方向并从权重中减去,从而移除拒绝反射但保留模型知识。相关衍生模型在 Hugging Face 上已获超 76 万次下载。

技术 › 网络安全 Scott Williams 2026-08-2222.5 KB 42.1K 157 72

Designing the Backend for Agent Systems (Part 2)

本文是 Agent 系统后端设计三部曲的第二篇,提供一套可参考的 Agent 应用后端架构模板,涵盖 API、队列、Worker、流式输出、结构化输出、会话管理及成本限制等八层设计。文章批判了在 HTTP 请求中同步执行 Agent 的做法,强调应先持久化再入队、引入幂等键防止重复计费、使用显式任务状态机(含 awaiting_input 人工介入状态)和取消机制,并强调租户身份隔离、UUID 任务 ID、Pydantic 输入校验等安全与成本控制实践。

技术 › Agent Karan 2026-08-2231.0 KB 27K 262 86

把 Grok 4.6 装进 Codex:OAuth 安装教程及 5 个避坑指南

作者因 Codex 额度消耗过快,探索通过 OpenCodex + xAI OAuth 将 Grok 4.6 接入 Codex 的方法。教程详细介绍了环境准备(Node 18+、安装 OpenCodex 2.28.0)、初始化时先选 OpenAI 登录、执行 ocx login xai 完成授权与模型同步,并强调需发送真实请求验证。文章还总结了 5 个实测坑:原生模型消失、菜单有模型但请求报错、external_web_access 400、重启后服务未加载、本机代理导致 502,以及卸载还原的完整流程。

技术 › Codex Adrian Punk 2026-08-2210.7 KB 103.2K 101 83

用 GEO 六步法击败竞争对手:让 AI 引擎推荐你的品牌

作者指出在 AI 搜索时代,自吹自擂的'最佳工具'榜单已失效:Lily Ray 研究显示 Google AI Overviews 引用自利榜单时,69% 的情况下会把该品牌排除在推荐之外。作者提出 GEO(生成引擎优化)六步打法:先做好基础 SEO;锁定比较型关键词(best X 2026、品牌 reviews、alternatives);通过付费、交换、寄生平台等方式进入他人网站的榜单;在 Reddit、YouTube 等 LLM 常引用的平台建立真实存在;为高权重媒体撰稿建立实体关联;集中精力经营单一评论平台。核心思想是:让自己出现在没有利益关系的第三方信源中。

技术 › 工具与效率 Nicholas Dulait 2026-08-225.4 KB 17.3K 60 84

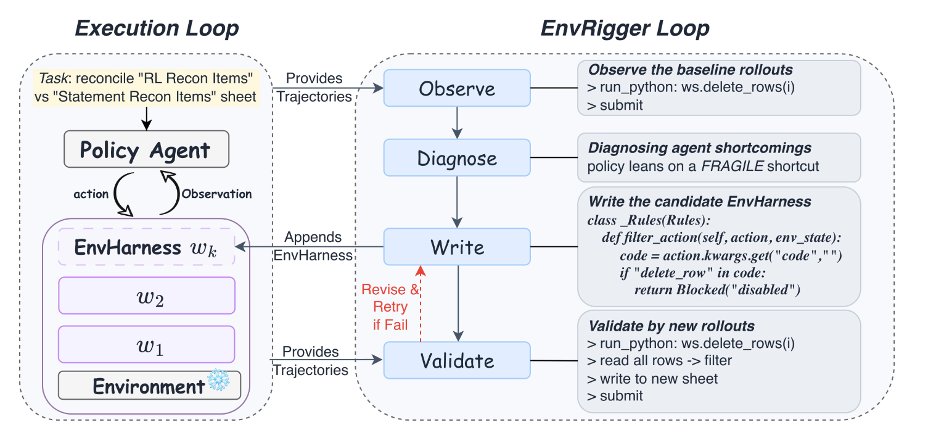
Google提出EnvHarness:环境自进化,倒逼Agent持续进化

Google提出EnvHarness(环境脚手架)框架,通过Stage、Contract、Chain三类组件在不改动环境底层的情况下动态操控环境,并引入环境搭建师EnvRigger,通过观察Agent轨迹、诊断缺陷、编写组件、实战验证的四步闭环自动搭建环境。在SWE-bench Verified基准上,Agent与环境实现螺旋式协同进化,成功率从47.67%提升至54.79%,且300个环境时性能仍持续上升。未来方向包括扩展组件库、拓展至非文本环境及探索语义化组合。

技术 › Agent 青稞社区 2026-08-228.6 KB 4.8K 37 74

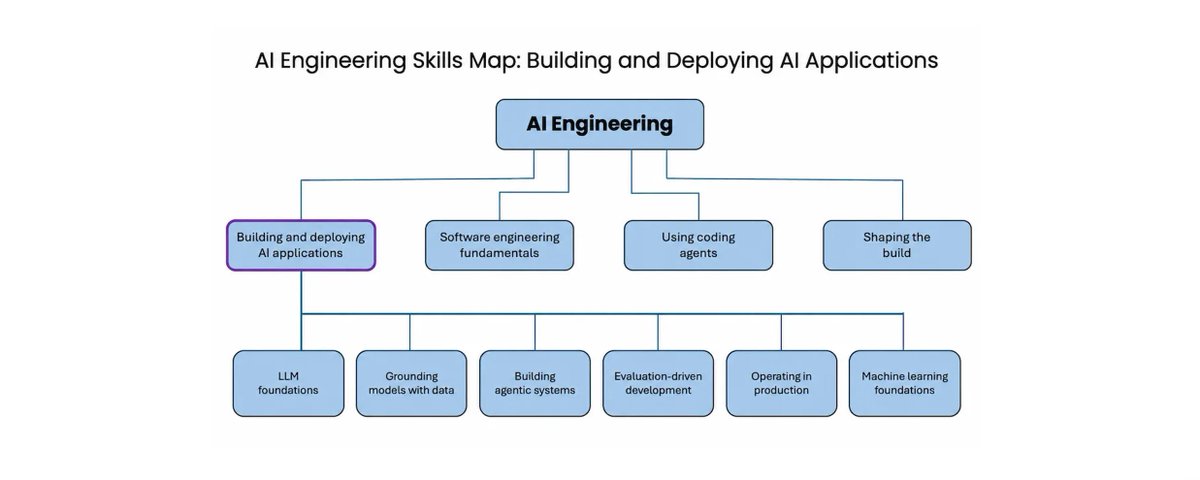
AI 工程技能图谱:构建与部署 AI 应用

吴恩达详细阐述了 AI 工程技能图谱中的核心技能——构建与部署 AI 应用,包含六大方面:LLM 基础(分词、上下文窗口、工具调用等)、用数据为模型提供基础(RAG、向量索引、知识图谱)、构建 Agentic 系统(工作流、Agent harness、多智能体编排)、评估驱动开发(evals 与错误分析循环)、生产环境运营(可观测性、回归测试、成本与延迟优化)以及机器学习基础。该技能图谱基于大量招聘信息、专家访谈和调研形成,强调 AI 系统因输出不可预测而比传统软件开发更具迭代性。

技术 › LLM Andrew Ng 2026-08-227.9 KB 2.1M 12.1K 73

2026 Agent Eval 全景图:从'会做'到'值得部署'

本文系统梳理了2026年Agent评估领域的全景图,指出Agent Eval正从'任务能否完成'转向'结果是否有效、过程是否可靠、系统是否值得部署'。文章从通用Agent、软件工程、GUI与SaaS、工具与事务、知识工作(Deep Research、数据分析、预测)、多模态内容生产、科研优化、组件与记忆、多Agent系统等赛道,介绍了代表benchmark及其演进,并强调了可靠性、成本、轨迹审计与证据包成为评估的新基本单位。

技术 › Agent Cloris 2026-08-2221.9 KB 5.6K 56 77

Token工程的四大实用支柱:超越提示压缩的成本优化

本文介绍了在大规模AI应用中优化token成本的四大实用支柱:一是上下文缓存与Agent循环修剪,通过裁剪中间工具输出和总结历史步骤保持提示精简,利用缓存可获最高75%的输入折扣;二是实时与批量推理,将非紧急任务如工单汇总、报告生成等打包为异步批处理,可享50%折扣;三是设置思考预算,避免推理模型在简单任务上消耗数千隐藏思考token;四是模型合理选型与持续评估,90%的任务应使用最小最便宜的模型,并通过自动化评估及时更换高效模型,配合Apigee AI Gateway等企业网关实现智能路由与安全防护。

技术 › LLM Google Cloud Tech 2026-08-227.4 KB 36.7K 345 77