Wiki 知识库

全部文档 / 标签: RAG

205 篇
清除

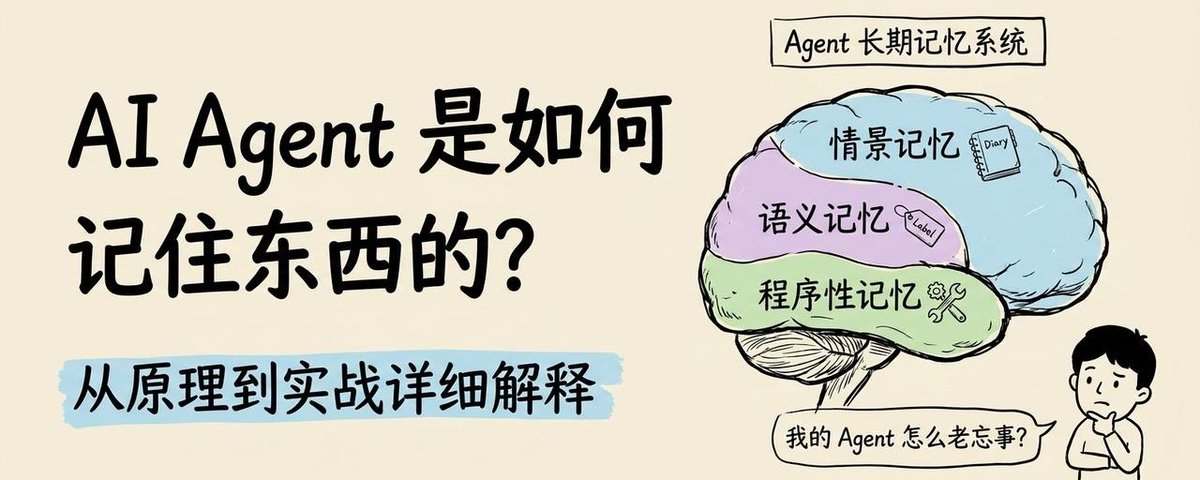
AI Agent 记忆机制原理与实战解析

文章深入浅出地讲解了 AI Agent 记忆系统的工作原理,从基础的单会话与多会话记忆保持切入,引出 Google 提出的情景、语义与程序性记忆三分法。通过对比 OpenClaw 的实现方式与存在的问题,重点剖析了企业级方案 EverOS 的架构。EverOS 将记忆细分为六大类,并通过语义巩固、主动上下文重建等技术优化记忆的抽取、更新与检索。文章还包含 EverOS 的 API 调用示例及 20 个真实落地场景,为开发者提供了 Agent 记忆系统的全景指南。

技术 › Agent 铁锤人 2026-05-1417.0 KB 445.2K 585 84

如何把聊天记录变成可检索知识库(2026版)

文章探讨了如何将微信、Telegram等平台的聊天记录转化为可用的个人知识库。作者从数据获取、清洗降噪(语义分块、去重、上下文修复)到存储检索(Embedding选型、GraphRAG)提供了全流程的技术指导,并提出了数字分身、知识传承等多种应用场景。
技术 › LLM AI最严厉的父亲 2026-05-1226.8 KB 59K 158 91

不做中转,不卖课,如何用 AI 月入 10万

作者分享了今年通过接企业知识库项目实现月入数万的实战经验。文章详细阐述了如何将基础 RAG 升级为企业级 RAG 系统,重点涵盖数据处理层面的文档切分策略(针对 PDF、Excel、代码等)、向量化模型选择及数据库选型;同时深入讲解了检索策略优化,包括长问题处理、混合检索、Rerank 精排及多因素加权排序等技术细节。

技术 › LLM M Miles. 2026-05-1226.8 KB 91

非向量 RAG 框架 PageIndex:用 LLM 推理替代 Embedding

文章介绍了 VectifyAI 开源的 PageIndex 框架,这是一种不使用向量嵌入的 RAG(检索增强生成)方法。它通过构建文档的层次树结构,利用 LLM 的推理能力来精确定位答案页面。该框架在 GitHub 获得了超过 2.9 万星,其构建的 Mafin 2.5 在金融问答基准测试中取得了 98.7% 的高准确率。

技术 › LLM AlphaSignal AI 2026-05-0811.9 KB 11.3K 165 87

多Agent场景下数据读写不同步的解决方案

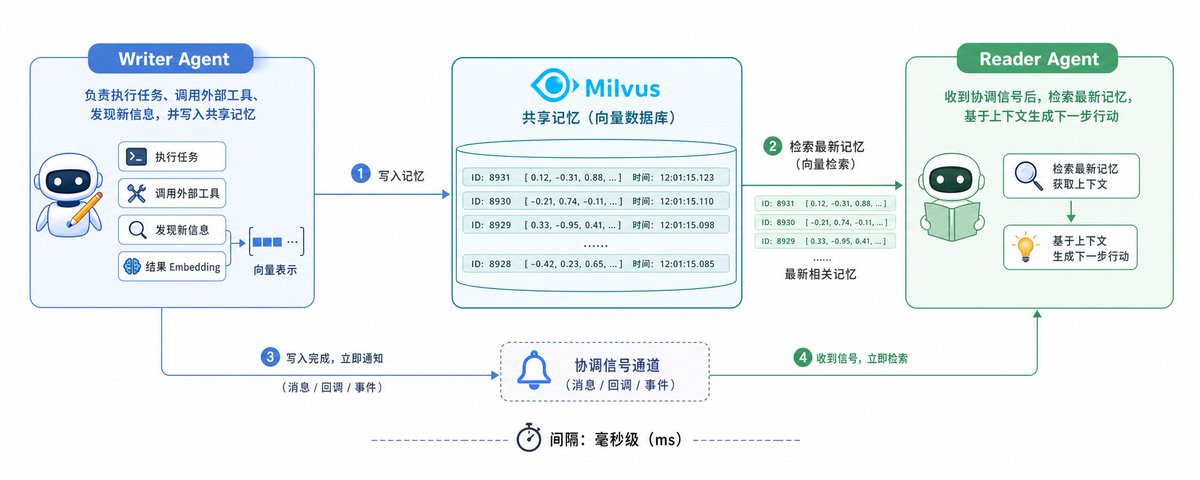
本文探讨了在多Agent系统中,子Agent之间数据读写不同步的问题。根本原因在于单Agent场景设计的默认数据库一致性配置(如Milvus的Bounded级别)无法满足多Agent毫秒级的读写需求。文章详细解释了Milvus的写入机制和四档一致性级别,并通过实验证明将一致性级别从默认的Bounded切换为Strong可以有效解决“写后读空”的问题。

技术 › Agent 尹珉 2026-05-0715.4 KB 9.1K 66 83

Multimodal RAG with the Gemini API File Search Tool: A Developer Guide

本文介绍了 Gemini API 中的 File Search 工具,该工具现已通过 Gemini Embedding 2 支持多模态检索。文章详细讲解了如何创建存储、上传图文文档、执行具备依据生成的查询以及检索引用和图像。File Search 提供了全托管的 RAG 解决方案,具备原生图像搜索、内置引用和成本效益高等优势。

技术 › LLM Google AI Studio 2026-05-0612.3 KB 29.7K 377 84

Context engineering: 构建卓越 Agent 的关键

文章探讨了“Context engineering(上下文工程)”作为构建优秀 AI Agent 的核心挑战与解决方案。相比于传统的 IVR 和预设流程,Context engineering 通过“渐进式披露”和条件逻辑,确保 Agent 在对话的每一个时刻都能获得最相关且最少量的信息。这不仅解决了模型处理大量 Token 时的性能下降和幻觉问题,还能让 Agent 充分利用大模型的推理能力,适应复杂的现实场景,并随着模型升级而自然进化。

技术 › Agent Neil Rahilly 2026-05-067.1 KB 34.9K 320 79

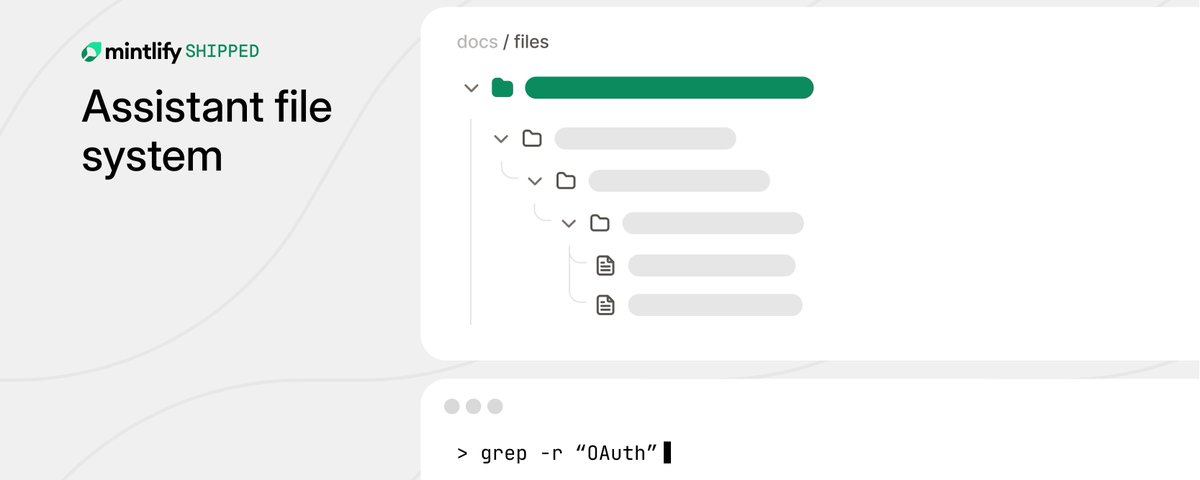
为 Mintlify AI 助手构建虚拟文件系统

文章探讨了如何通过构建虚拟文件系统 ChromaFs 来优化 Mintlify 的 AI 文档助手。作者指出传统的沙箱克隆方案存在高延迟(约 46 秒)和高成本(年费超 7 万美元)的问题。ChromaFs 通过拦截 Unix 命令并将其转换为 Chroma 数据库查询,实现了零边际计算成本和毫秒级的会话启动速度。文章详细介绍了 ChromaFs 的架构、目录树引导、权限控制、分块重组以及针对 grep 命令的优化策略。

技术 › LLM Dens Sumesh 2026-05-069.1 KB 936.1K 1.1K 89

Memory Is State, Not a Service

本文指出企业 AI 工具普遍存在“记忆碎片化”问题,主张构建“公司大脑”应将记忆视为共享状态而非独立服务。文章提出语义记忆文件系统架构,通过实体、事实、状态变化和关系存储,利用本体论作为透镜,让同一记忆在不同角色和 Agent 面前呈现不同上下文,从而解决信息孤岛,实现人机共享的可信赖记忆底座。

技术 › Agent Ashwin Gopinath 2026-05-0618.9 KB 43.2K 313 78

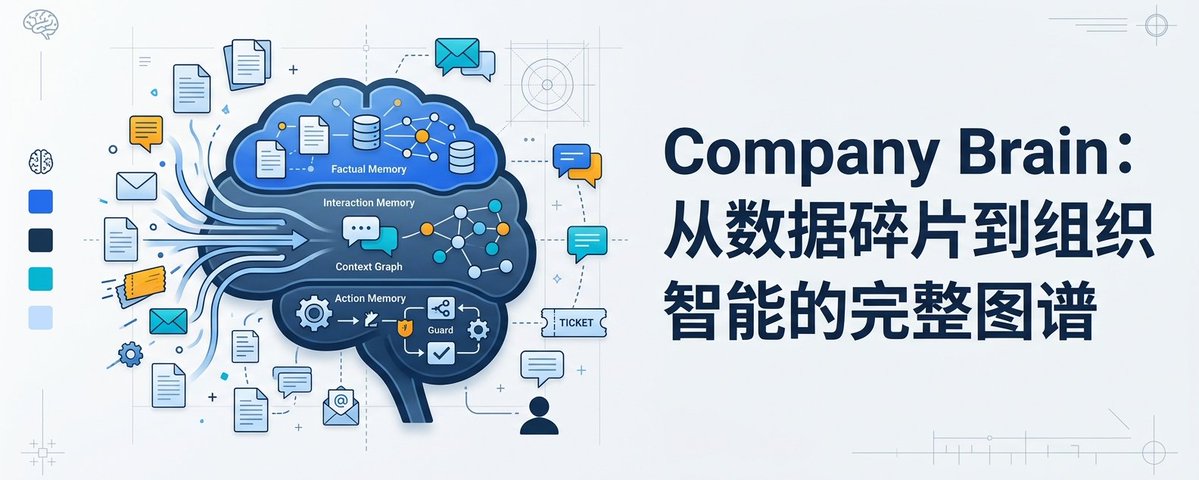
Company Brain:构建组织智能的三层记忆架构

文章探讨了公司如何通过构建“Company Brain”来解决制度性摩擦和上下文缺失的问题。作者指出,单纯的知识库或RAG无法构成真正的公司大脑,提出了一个包含三层记忆的架构:事实记忆(记录发生了什么,强调语义关联而非单纯检索)、交互记忆(记录决策背后的意义与思维链,涉及本体论和上下文图)以及行动记忆(记录实际运作路径与代理护栏)。该系统旨在通过AI帮助组织实现从数据碎片到组织智能的涌现。

技术 › Agent nash_su 2026-05-0625.4 KB 5K 56 82

AI 算命技术解析:从出海百亿赛道到 Claude Code 本地部署

文章分析了海外 AI 算命市场(如 FateTell、Astrotalk)的高利润率与高复购率,指出普通 AI 因缺乏专业知识导致的“废话”和排盘错误是产品失败的主因。作者展示了如何利用 Claude Code 构建基于 17 部经典古籍(如《滴天髓》)和 44MB 知识图谱的专业系统,通过“四家投票”机制和双系统验证,将准确率提升至六七成,并提供了完整的提示词和本地安装方案。

技术 › Agent 百 百年 AI×出海 2026-05-0515.7 KB 96

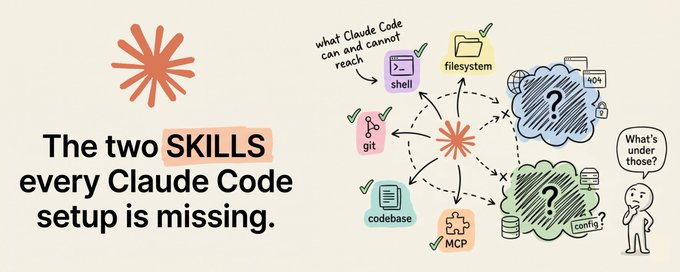
修复 Claude Code 的两大盲点:网页抓取与后端集成

文章指出 Claude Code 在网页抓取和后端集成(如 Supabase)方面存在两个主要盲点,导致 Token 消耗巨大且效率低下。作者介绍了两个开源工具来解决这些问题:Bright Data 负责高效抓取网页数据(包括 JS 渲染和反爬虫页面),InsForge 则作为后端上下文工程层优化数据库交互。作者演示了如何结合这两个工具,仅用一个 Prompt 就基于 YouTube 教程成功构建了一个包含 Google OAuth 和 AI 聊天功能的 Google Docs 克隆应用。

技术 › Agent Akshay 2026-05-047.5 KB 209.4K 229 82

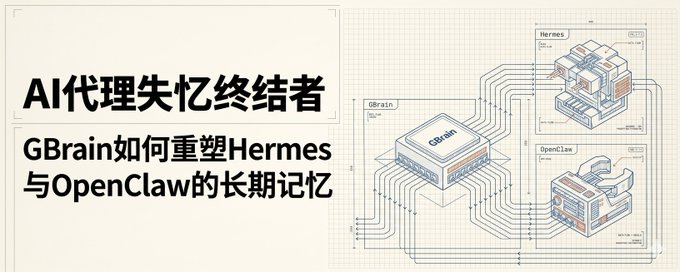
AI代理内存痛点终于被解决?GBrain + Hermes/OpenClaw真实反馈

作者分享了AI代理工具Hermes和OpenClaw在长期记忆方面的痛点,并介绍了YC总裁Garry Tan开源的GBrain。GBrain作为一个“外挂大脑”,基于Postgres和向量技术,解决了AI代理容易遗忘的问题,实现了跨会话的长期记忆和知识库管理,被视为2026年个人AI生产力的重要突破。

技术 › Agent loveabit 2026-05-033.9 KB 7.2K 60 81

Agent Memory Engineering

文章探讨了 AI Agent 的记忆机制,解释了为何不同 Agent(如 Claude Code 和 Codex)之间无法直接通过复制文件来迁移记忆。作者指出,这是因为模型在后期训练时与特定的记忆层“融合”了。文章对比了 Hermes、Codex CLI 和 Claude Code 三种实现,并得出结论:最聪明的架构(如向量数据库、知识图谱)输给了最简单的方案(LLM + Markdown + Bash 工具)。核心在于 Agent 遵循的读写规范,而非数据结构本身。

技术 › Agent Nicolas Bustamante 2026-05-0299.9 KB 78.1K 381 81

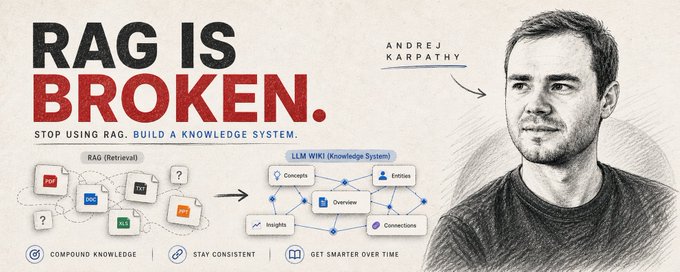
RAG Is a Lie — Karpathy's LLM Wiki 模式解析

文章批判了当前主流的 RAG(检索增强生成)模式无法积累知识的局限性,并介绍了 Andrej Karpathy 提出的 LLM Wiki 范式。该模式主张让 LLM 维护一个动态的结构化知识库(Wiki),在数据摄入时进行编译和整合,而非在查询时临时检索。这种方法通过将繁琐的维护工作交给 LLM,实现了知识的复利增长和自我进化,解决了传统知识管理系统中维护成本高昂的痛点。

技术 › LLM Suryansh Tiwari 2026-05-024.7 KB 50.1K 551 60

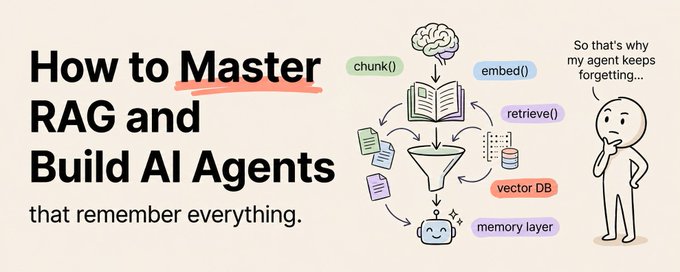
如何精通 RAG 并构建拥有完美记忆的 AI Agent (全流程教程)

本文是一篇关于检索增强生成(RAG)技术的完整教程。文章指出,大多数 AI Agent 难以落地的原因在于模型无法获取企业私有数据。RAG 通过将外部知识库与大模型结合,解决了这一痛点。作者详细拆解了构建 RAG 系统的五个核心阶段:文档摄取与分块、文本嵌入、向量存储、信息检索以及最终生成,并提供了关于分块策略、嵌入模型选择及混合检索的实战建议。

技术 › LLM Khairallah AL-Awady 2026-05-0113.7 KB 191.9K 662 78

The Skeleton of Remembering: Why Your Filesystem Is a Brain Waiting to Happen

文章探讨了 AI 中“知识库”与“记忆”的本质区别,指出仅靠语义相似性检索会导致遗忘和误报。作者介绍了 SMF 架构,利用 POSIX 符号链接构建原生文件系统知识图谱。相比传统数据库或 Markdown 链接,SMF 提供了访问控制、可编程遍历及云端扩展性。实验表明,良好的结构化架构(BM25+图遍历)在效率上优于单纯扩大模型规模。

技术 › LLM Ashwin Gopinath 2026-05-0159.4 KB 9.3K 110 75

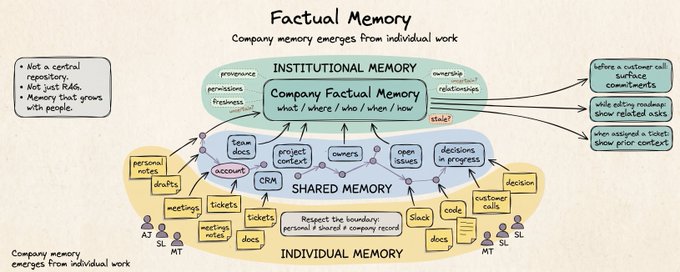
Company Brain, Part 2: Factual Memory

文章探讨了构建“公司大脑”中的事实记忆层。作者指出,真正的企业记忆不是简单的知识库或带有聊天框的企业搜索,而是一种从个人工作向外涌现的语义文件系统。它必须具备追溯性、权限管理和个性化能力,能够综合多源数据(如文档、CRM、代码)并主动提供上下文,而非仅被动等待查询。

技术 › LLM Ashwin Gopinath 2026-05-0119.8 KB 71.7K 709 66

Introducing SMFS: The Supermemory Filesystem

SMFS 是一个结合了 RAG 和传统文件系统优势的新型可挂载文件系统。它允许 Agent 使用标准的 Unix 命令(如 grep)执行语义搜索,支持多格式文件的自动解析与提取,并提供本地优先的同步引擎。内部基准测试显示,SMFS 能显著减少 Token 消耗和工具调用次数,同时大幅提升检索准确率。

技术 › 工具与效率 Dhravya Shah 2026-04-296.8 KB 192.8K 369 78

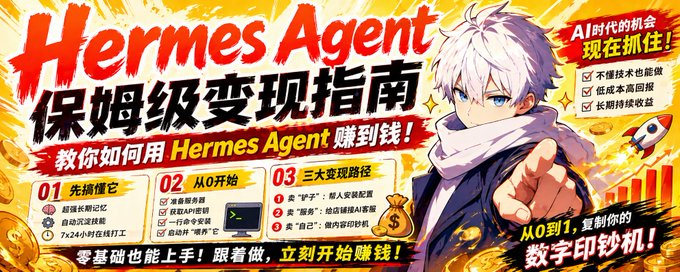
Hermes Agent 保姆级变现指南

本文是一份 Hermes Agent 的实战变现教程。作者首先解析了 Hermes Agent 具备的长期记忆、技能自动沉淀及 24 小时在线等核心优势,随后提供了“喂饭级”的安装与部署教程。文章重点列举了三种适合普通人的变现路径:出售代安装服务(卖铲子)、为线下店铺搭建 AI 客服系统(卖服务)以及利用 AI 分身辅助内容生产(卖自己)。最后,作者分享了避免被割韭菜的三条保命铁律,鼓励读者从第一笔小额收入做起,享受 AI 带来的复利红利。

技术 › Agent Suu 2026-04-298.2 KB 12.4K 137 63

Why Karpathy’s Second Brain Breaks at Agent Scale. How Mercury Solves It.

本文探讨了 Andrej Karpathy 的 LLM Wiki 工作流在人类“第二大脑”场景下的优势,指出其在处理 AI Agent 时的局限性。文章强调,人类记忆优先考虑可读性和反思,而 Agent 记忆系统则需要快速检索、低 Token 成本和冲突解决。Mercury 提出的混合架构方案,主张使用 Markdown 作为人类界面,同时采用结构化内存作为 Agent 的底层设施,以实现上下文的持续累积和可靠运行。

技术 › Agent Zaid 2026-04-297.3 KB 61

69个最佳开源AI仓库推荐(2026年4月)

文章精选了69个经过实战验证、维护活跃的开源AI仓库,旨在替代昂贵的API订阅。内容涵盖完整的AI技术栈,包括本地大模型推理、RAG知识库构建、AI智能体框架、提示词与评估、模型微调、工具链及部署等十大领域,为开发者、研究人员和独立黑客提供免费的生产级AI工具清单。

技术 › 工具与效率 self.dll 2026-04-2950.2 KB 698K 576 81

Meet Scout: 开源的企业级上下文代理

本文介绍了 Scout,一个开源的企业级“上下文代理”(Company Brain)。针对现有方案将所有数据存入向量数据库导致索引过时的问题,Scout 提出了“导航优于搜索”的理念,通过 Context Providers 连接 Slack、Google Drive 等实时数据源,像操作文件系统一样导航信息。它还能动态构建 Wiki 和 CRM,并通过持续学习形成闭环。

技术 › Agent Ashpreet Bedi 2026-04-2911.2 KB 169K 1.3K 82

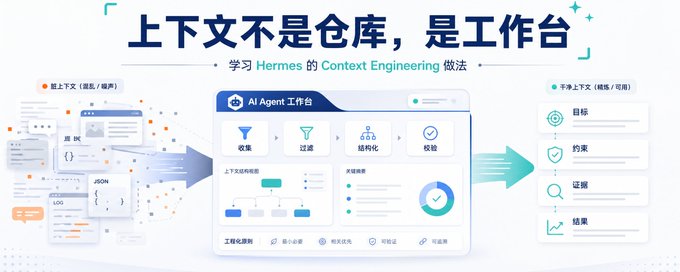
Hermes 给我的最大启发:上下文不是仓库,是工作台

本文指出 Agent 表现不佳往往是因为上下文管理不当,而非模型能力不足。文章引用多项研究证明长上下文不等于高效,并提出应像管理“工作台”而非“仓库”一样管理上下文。作者结合 Hermes 的实践,介绍了外部化记忆、子任务隔离、技能沉淀等策略,并重点推荐使用 XCrawl 等工具清洗网页噪声,以实现低噪、高效的 AI Agent 工作流。

技术 › Hermes 泊舟 2026-04-2818.8 KB 22.9K 95 79

DeepSeek-V4 工程权衡分析:1M 上下文并非无损记忆

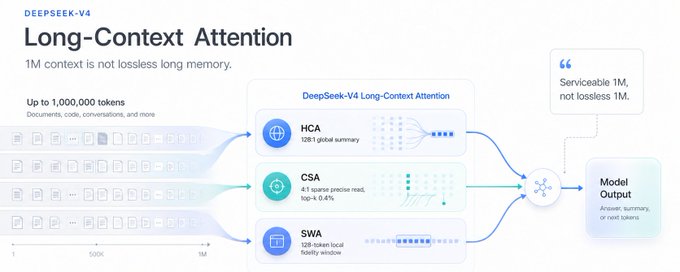
文章深入剖析了 DeepSeek-V4 如何通过 HCA、CSA 和 SWA 三通道并行架构,将 KV Cache 压缩至基线的 2%,从而实现工程上可行的 100 万 token 上下文。然而,这种极致的压缩是有代价的:MRCR 8-needle 测试准确率在 1M 长度下显著下降至 0.59。文章指出,V4 通过牺牲检索精度换取了推理成本的数量级降低,是一种‘有损的 1M’,并明确论证了该设计原理上无法完全替代 RAG 系统。

技术 › LLM GoGoNN 2026-04-2845.4 KB 16.8K 23 75

如何在6个月内从零成为AI工程师(2026版)

本文针对2026年的行业现状,驳斥了通过传统机器学习理论入行的误区,提出了6个月速成AI工程师的实战路线图。作者强调无需深奥数学,而应从Python和API调用起步。核心路径涵盖:深入掌握LLM原理与提示工程,精通RAG(检索增强生成)及语义分块、重排序等进阶技术,最终构建结合Agent与生产级思维的复杂AI系统。文章指出,唯有动手解决实际问题、构建高可用系统,而非单纯考取证书,才是成为合格AI工程师的关键。

技术 › LLM Suryansh Tiwari 2026-04-288.1 KB 8.6K 192 64

本周顶级 AI 论文综述:DeepSeek V4 与自进化智能体

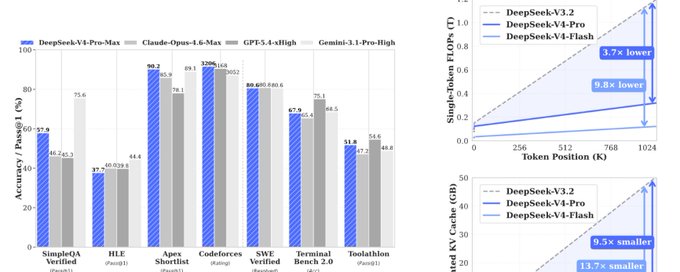
本周综述重点介绍了 DeepSeek V4,这是首个默认支持百万 token 上下文的开源模型系列,通过 CSA/HCA 混合注意力机制和领域专家后训练技术,在推理性能上媲美 GPT-5.2。此外,还涵盖了 Apple 的 Mamba 架构知识蒸馏方法、Autogenesis 自进化智能体协议,以及 Skill-RAG 失败感知检索系统。

技术 › LLM DAIR.AI 2026-04-2733.5 KB 74.7K 165 68

AI 工程师学习路线图:从核心技能到生产实践

文章基于 2000 余份职位描述,规划了一条务实的 AI 工程师学习路径。重点指出 AI 工程并非从零训练模型,而是构建以 LLM 为核心的系统。核心技能包括 LLM 基础、RAG 检索增强、Agent 智能体、测试评估及监控部署。此外,文章还梳理了 Python、Web 开发、云原生及数据库等支撑性技能,并推荐了学习优先级与主流技术栈,旨在帮助开发者构建可靠、可落地的生产级 AI 系统。

技术 › AI工程 Luffytaro 2026-04-2712.1 KB 113.3K 1.5K 71

如何对视频进行 Grep 检索

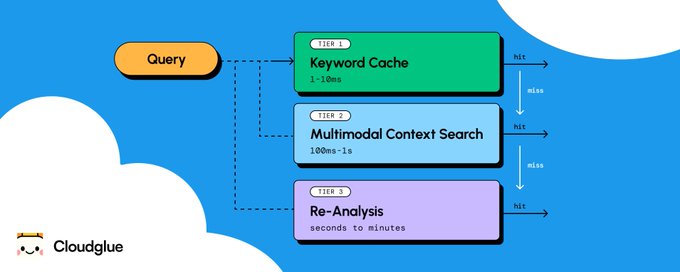
文章探讨了如何让 LLM 理解和处理海量视频数据。作者指出单纯依赖上下文窗口并非最佳方案,因为成本高昂且无法进行确定性检索。借鉴编程中的 Unix 模式,文章提出构建“中间表示层”,提前提取并结构化对齐转录、视觉、情感等多模态数据,从而实现对视频内容类似 Grep 的高效搜索与组合分析。

技术 › LLM Amy Xiao 2026-04-2421.8 KB 11K 150 78