Wiki 知识库

全部文档 / 作者: Avi Chawla / 标签: LLM

11 篇
清除

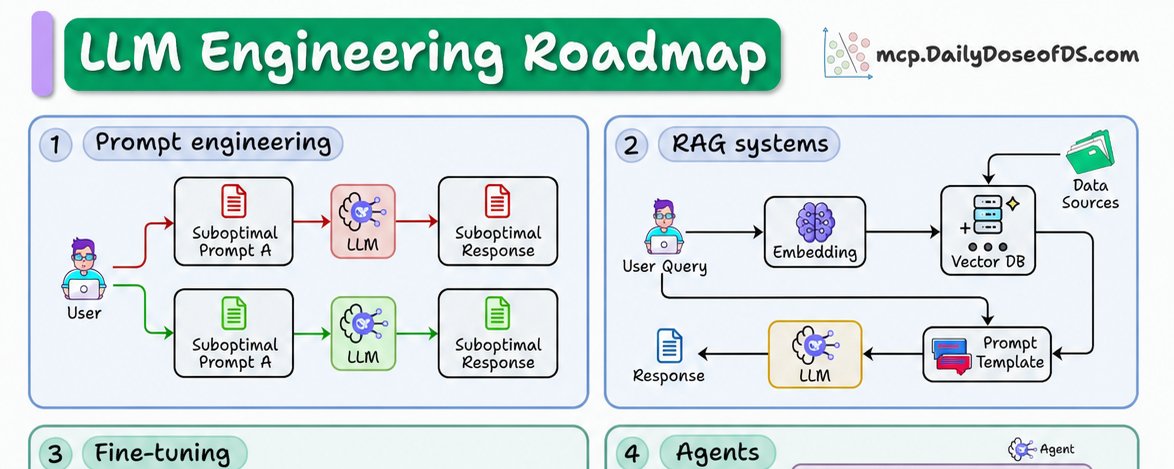
The 2026 LLM Engineering Roadmap

本文提出了2026年LLM工程路线图,指出与LLM工作不只是提示词,生产级系统需要对LLM的工程化、部署和优化有深入理解。文章总结八大支柱:提示工程(将prompt当作代码管理)、RAG系统(嵌入、检索、重排)、上下文工程(管理上下文窗口中各类信息的取舍)、微调(LoRA/QLoRA等技术)、Agent(工具调用循环与编排、状态管理、重试逻辑),并为每个领域提供了大量免费开源学习资源,如Anthropic、OpenAI官方指南及多个GitHub教程仓库。

技术 › LLM Avi Chawla 2026-10-0919.8 KB 403.3K 447 71

Build your own Jev (100% local):用开源 LLM 构建本地决策引擎

文章介绍如何将开源 LLM 变成快速、本地的决策引擎,而无需重新训练。核心思想是:当应用已知所有可能的答案时,不必让模型生成文本或 JSON,而是通过 next-token scoring 一次性为每个候选答案返回分数和概率分布。作者讲解了固定答案打分与结构化输出的区别、LLM 第一个输出 token 的生成原理,并使用 SGLang 的 /v1/score 接口,结合 Qwen 和 DeepSeek 模型进行实测,与普通文本生成进行了基准对比。文中还提到概率的含义与校准问题。

技术 › LLM Avi Chawla 2026-09-2022.3 KB 1.1M 3.1K 76

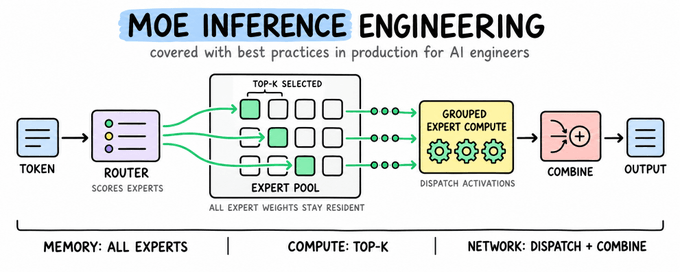
MoE 推理工程详解

本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。

技术 › LLM Avi Chawla 2026-09-1929.1 KB 148.8K 316 73

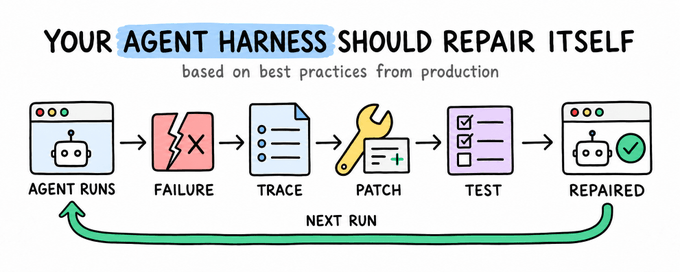
Your Agent Harness Should Repair Itself

文章探讨 Agent 系统如何在不更新模型权重的情况下自我改进。作者阐述了两条反馈路径:成功运行产生可复用的程序性记忆(以 Hermes 的 SKILL.md 文件和 GEPA 离线优化为代表),失败运行则通过 Opik 的执行 trace 进行诊断,定位故障源头(模型、工具、配置或代码),提出修复方案,经人工审核后重跑并添加回归测试。文章强调失败必须被记录为可验证的预期行为和测试用例,才能转化为可复用的知识,并详细介绍了 trace 结构、失败检测与根因分析的工作流程。

技术 › Agent Avi Chawla 2026-09-1218.9 KB 53K 415 81

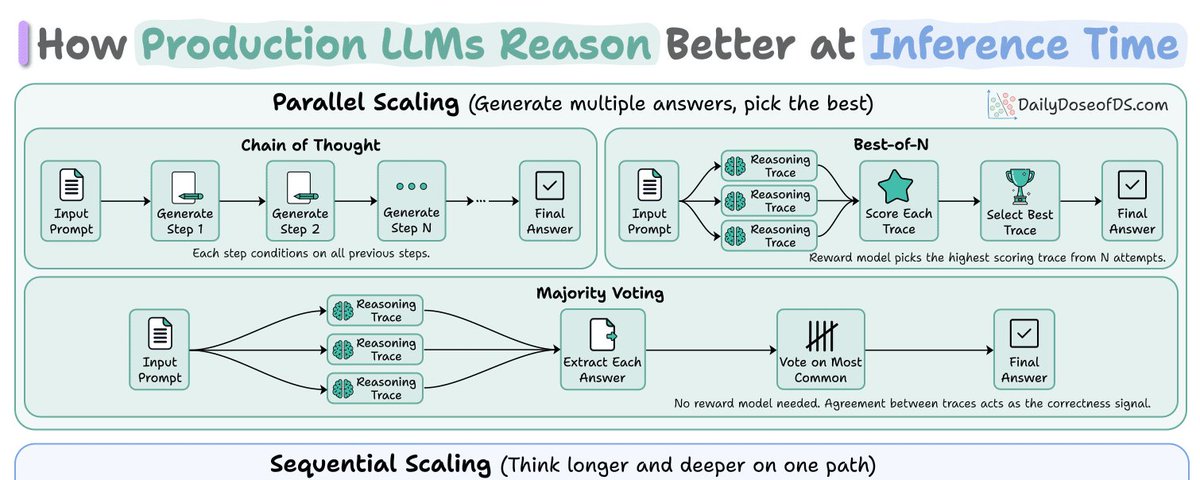
How Production LLMs Reason Better at Inference Time

本文介绍了八种在推理阶段提升大语言模型推理能力的技术,包括思维链、多数投票、Best-of-N、扩展思考、自我精炼等,并分析了每种技术的权衡和实际应用注意事项。文章指出,在推理阶段干预是提升准确率最经济的方式,无需重新训练模型。通过FLOPs匹配比较,测试时计算优于14倍大的模型。文章还讨论了并行采样与顺序扩展两种计算分配方式,以及树方法如何结合两者。每种技术都有其适用场景和局限性,如多数投票无法处理开放生成任务,Best-of-N需要奖励模型且存在过优化风险,扩展思考并非越长越好。最后,文章强调选择合适技术需根据任务特性和评估结果。

技术 › LLM Avi Chawla 2026-08-1514.3 KB 73.8K 132 78

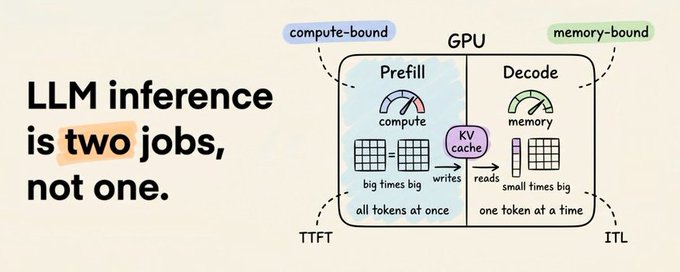
LLM 推理原理详解:从 Prefill 到 Decode

本文深入解析了大语言模型(LLM)推理的计算流程。文章指出,LLM 推理主要包含 Prefill(处理提示词,计算密集型)和 Decode(逐词生成,显存带宽密集型)两个阶段。作者详细阐述了分词、Embedding、Transformer 层及 KV Cache 的工作原理,并分析了 KV Cache 带来的内存挑战及 vLLM 的优化方案。最后,探讨了 DeepSeek-V4 等新架构通过重新设计注意力机制来从根本上压缩 KV Cache 的创新思路。

技术 › LLM Avi Chawla 2026-06-2923.7 KB 320.3K 776

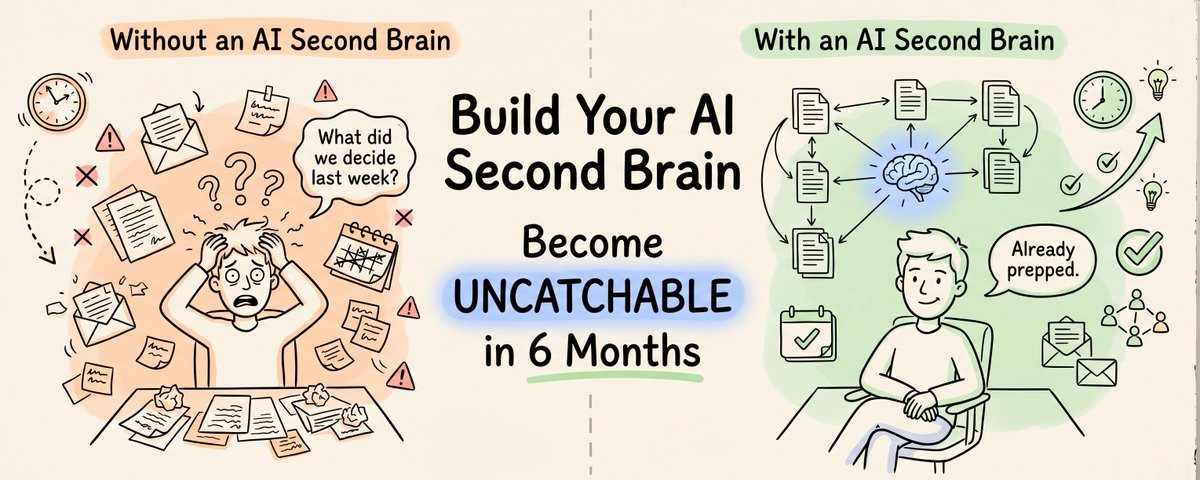
AI 第二大脑搭建指南:从 Wiki 到知识图谱

文章探讨了 AI 第二大脑的演进,指出简单的 Wiki 模式无法适应工作中不断演变的上下文,并推荐了基于知识图谱的开源工具 Rowboat。文中详细介绍了 Rowboat 的安装配置、本地化部署(支持 Ollama/OpenAI)、与 Obsidian 的集成,以及如何通过连接 Gmail、日历和会议记录,自动提取决策、承诺和截止日期,构建一个完全本地化且具备上下文感知能力的智能工作系统。

技术 › Agent Avi Chawla 2026-05-0725.5 KB 422.5K 694 86

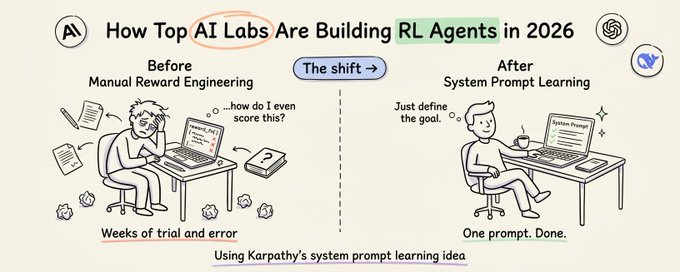
顶级AI实验室如何构建RL智能体:从RLHF到RULER的演进

文章探讨了 Anthropic、OpenAI 和 DeepSeek 等顶尖 AI 实验室在 2026 年关于强化学习(RL)的趋同思路,即使用系统提示作为奖励函数。内容详细梳理了 RL 在 LLM 中的应用历程,从 RLHF 到 RULER(Karpathy 提出的系统提示学习概念)的演变。重点介绍了 DeepSeek R1 利用可验证奖励(RLVR)突破传统瓶颈的机制,通过规则编译器直接提供信号,并结合 GRPO 算法移除了复杂的 Critic 和奖励模型,实现了从 15.6% 到 77.9% 的 AIME 数学成绩飞跃。

技术 › LLM Avi Chawla 2026-04-2863.5 KB 857.5K 502 74

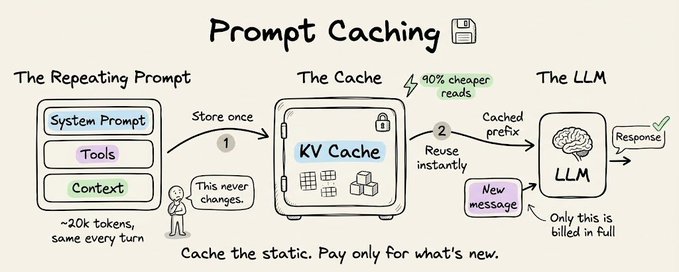
LLM 中的 Prompt Caching 技术详解:以 Claude 为例的高效缓存策略

本文深入探讨了 LLM 中的 Prompt Caching 技术,解释了其背后的 KV Cache 机制及静态/动态上下文分离原理。文章通过 Claude Code 的案例分析,展示了如何通过保持 92% 的缓存命中率来将计算成本降低 81%,并总结了哈希敏感性和工程化落地的关键约束。

技术 › LLM Avi Chawla 2026-04-2021.1 KB 755.1K 1K 87

LLM 提示词缓存原理与实战应用

文章深入探讨了LLM中的提示词缓存技术。通过区分静态前缀(如系统指令)和动态后缀(如用户消息),利用KV Cache机制避免重复计算,大幅降低长上下文任务的成本。文章以Claude Code为例,展示了如何通过保持92%的缓存命中率将成本降低81%。同时,强调了Hash缓存的脆弱性,任何微小的前缀变动都会导致缓存失效,并给出了在开发Agent时维持缓存热度的具体工程建议。

技术 › LLM Avi Chawla 2026-04-1620.9 KB 87

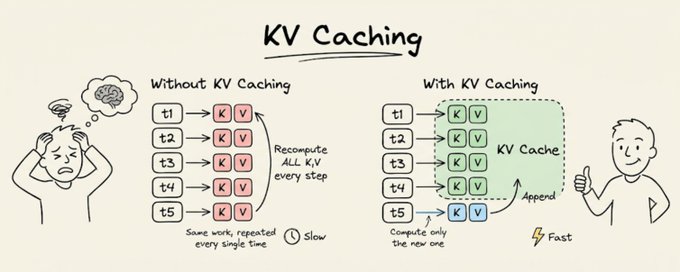
LLM 中的 KV 缓存机制详解

文章深入解释了大型语言模型(LLM)中的 KV 缓存技术。作者指出,LLM 生成文本时首个令牌较慢而后续令牌迅速的现象,归功于 KV 缓存的工程优化。该技术通过存储已计算键值向量,避免在自回归生成过程中的冗余计算,以 GPU 内存为代价换取显著的计算加速。文中详细解析了注意力机制的冗余问题、KV 缓存的工作原理、首令牌延迟(TTFT)的产生原因,以及内存与计算资源之间的权衡取舍。

技术 › LLM Avi Chawla 2026-03-226.3 KB 1.8M 2.9K 69