Wiki 知识库

全部文档 / 标签: LLM

1042 篇
清除

AI-Powered Data Warehouses: Architectural Lessons for Every AI Product

文章探讨了 Snowflake、Databricks、ClickHouse、BigQuery、MotherDuck 等数据仓库平台在 AI 时代的架构演进,总结了七大架构经验:推理正在成为数据库算子;数据转换可通过 LLM 推断并物化新事实;语义层正成为 Agent 的基础设施;Agent 的部署位置是重要的架构决策;数据仓库正成为 Agent 工作的执行环境;Agent 是一种新的数据库工作负载,其迭代、突发、高并发的访问模式要求重新设计数据库系统。这些模式为所有 AI 产品的架构设计提供了借鉴。

技术 › 数据库 Josh Rosen 2026-09-0310.2 KB 76.4K 239 76

构建你的 AI FDE 能力入门篇:0x08 一个 AI 中台应该具备哪些能力?

文章系统介绍了 Palantir AIP(AI 中台)的端到端架构,阐述其如何将生成式 AI 安全接入企业运营。核心是围绕 Ontology 构建完整闭环,涵盖十二类能力:安全的大模型接入、端到端可观测性、上下文工程、Ontology 系统、向量与计算服务、安全治理、智能体生命周期管理、运营自动化、开发环境、人机协同应用、打包发布部署以及企业自动化。文章强调 AI 中台的重点不是单独调用模型,而是建立从模型接入到产品交付的完整体系,并让安全、治理与可观测性贯穿始终。

技术 › Agent Mens@cc.codesome.ai 2026-09-034.0 KB 7.2K 56 63

Compilers 2.0: AI as stochastic optimizer

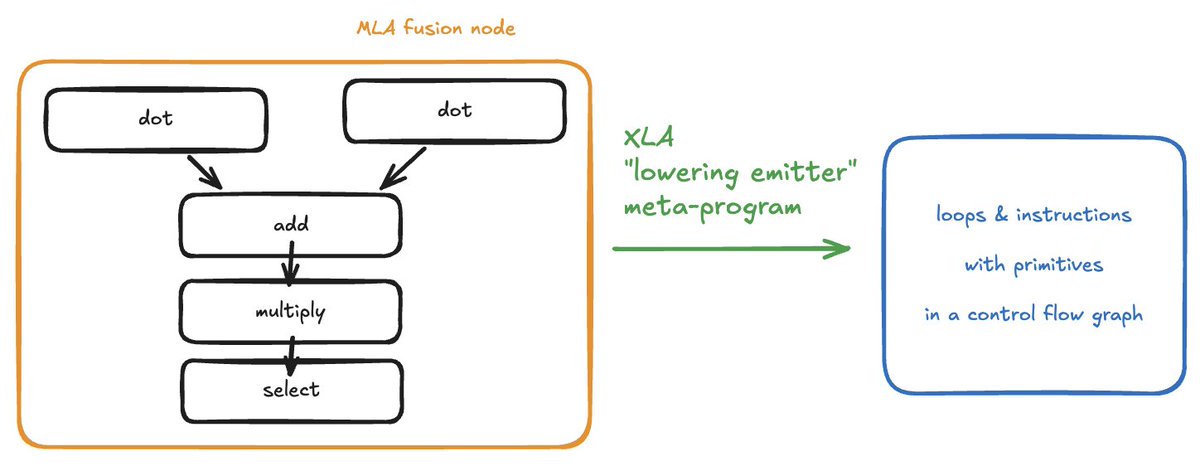
作者基于十余年加速器编译器经验(曾创建XLA,现任OpenAI硬件团队)探讨AI时代的编译器演进。文章提出将AI视为'随机优化器'的新范式:传统优化编译器依赖固定规则与启发式,而LLM具备类似'optimizin Ollie'专家的程序优化直觉。文章回顾了STOKE随机超优化研究,指出Monte Carlo调整笨拙但快速,LLM智能但较慢,结合二者可智能地在优化空间中探索。虽然无法像传统方法那样保证语义正确性,但AI为自动化程序优化开辟了'编译器2.0'的新方向。

技术 › 编程语言 @cdleary 2026-09-0313.5 KB 364.5K 1.2K 73

Apple Foundation Models PCC 申请与使用:从权限到真机验证

文章详细介绍 Apple Foundation Models 的 Private Cloud Compute(PCC)方案的开发者申请与使用流程。作者区分了 Foundation Models、端侧模型与 PCC 模型的定位,说明 PCC 申请的本质是申请 Apple 管理的 Managed Capability,需要经过账户授权、App ID、Entitlement 和 Provisioning Profile 的完整签名链路。文章覆盖了资格确认、Capability Requests 提交、Xcode 自动签名配置、最小调用代码示例,并强调 Build Succeeded 后仍需检查签名产物、走完 Archive、TestFlight 和真机验证。最后给出文档类 App 的分层架构建议:端侧模型处理轻任务、PCC 处理长上下文任务、第三方模型作为备选,并总结了三类常见失败案例。

技术 › 移动端 沐风 2026-09-0312.4 KB 728 1 87

pi-matt-pocock 介绍,以及一种替代 skills 的 agent 能力设计

本文介绍 pi-matt-pocock,一个将 mattpocock/skills 中适合工程协作的方法论适配为 Pi 持久化工作流编排器的 Pi package。它遵循最小工具暴露原则,仅提供管理命令和一个主要编排 tool,支持 idea-to-ship、hard-bug、triage、wayfinding、architecture 五条 route。相比纯 skills 方案,它通过按需加载 procedure 正文、将 route/procedure/phase 状态持久化到 session,解决了命名冲突、上下文膨胀与进度不可恢复问题。文章还延伸讨论了 skills 之外的架构设计空间,梳理了从扁平 skill 库到确定性状态机、按阶段拆分子 agent 等五种方案的权衡轴。

技术 › Agent Frad 2026-09-0311.3 KB 57.5K 167 82

How to slash token costs with context caching in agent harnesses

本文介绍如何利用 Google Gemini Enterprise Agent Platform 的上下文缓存(Context Caching)大幅降低 Agent Harness 的 token 成本。文章指出无状态 LLM 在多轮编码循环中会重复传输静态代码库导致 token 累积和成本暴涨,并剖析了前缀破坏陷阱——缓存要求提示词从第 0 个 token 起字节级匹配,动态变量必须放在提示词末尾。作者展示了服务端缓存的工作原理及双重节省模型(带宽节省与缓存 token 0.25 倍计费),并通过 CachePayloadBuilder 和 ContextCacheManager 实现缓存流水线。实测三个场景显示传输 token 减少 74%-79%。最后给出决策树:上下文小于 32768 token 或少于三轮时不应缓存。

技术 › Harness Engineering Balaji Subramaniam 2026-09-0310.3 KB 46.4K 366 82

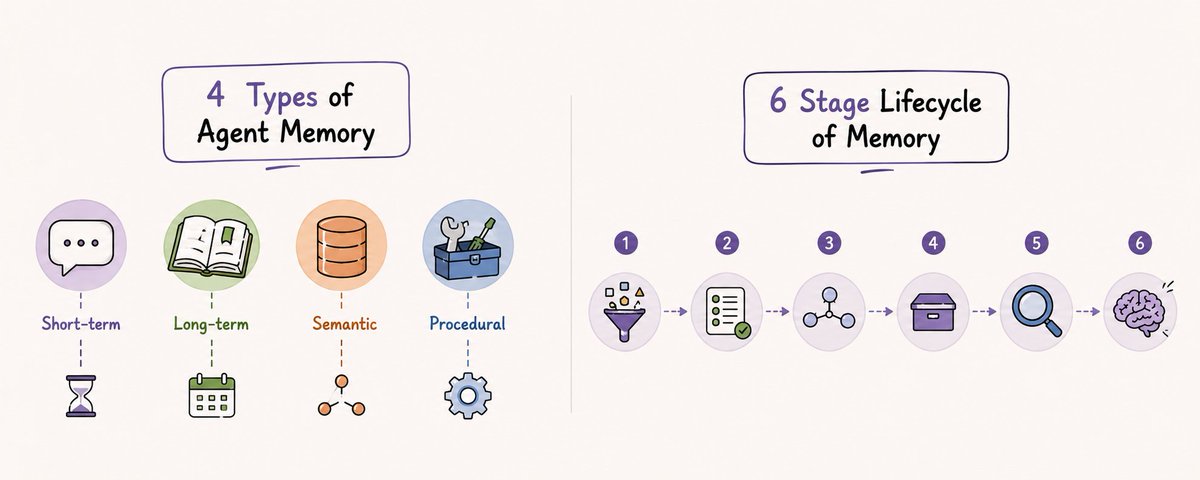
AI Agent 记忆的四种类型与记忆生命周期

本文是 Agent 记忆系列第二篇,基于普林斯顿的 CoALA 认知架构框架,将 Agent 记忆分为四种类型:工作记忆(当前上下文)、语义记忆(事实性知识)、情景记忆(带时间戳的具体事件)和程序性记忆(Agent 自行从重复经验中学到的规则)。作者强调仅靠厂商记忆功能只覆盖语义记忆的一小部分,完整的生产级 Agent 还需理解记忆的六阶段生命周期:提取、存储、检索、注入、更新与遗忘。文章为后续动手构建带记忆的 Agent 系统奠定概念基础。

技术 › Agent Jaydeep 2026-09-028.2 KB 8.1K 43 71

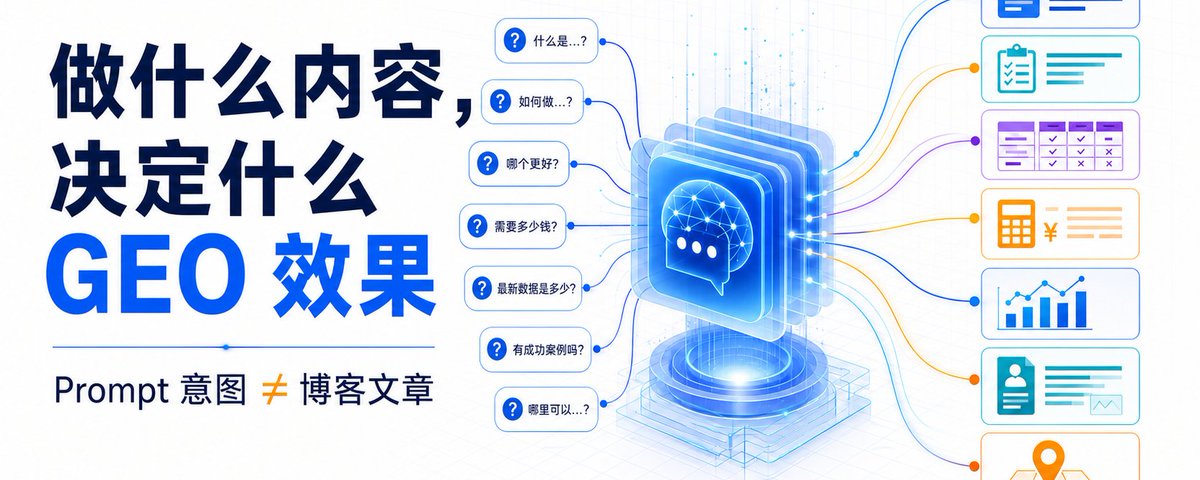
做什么类型的文章,决定了你能获得什么样的 GEO 效果

文章指出企业做 GEO(生成式引擎优化)的常见误区是只写博客,而 AI 回答用户提问时寻找的是最适合的“信息资产”。作者按 Prompt 意图分类,详细说明各类问题应匹配的内容类型:定义页建立概念权威、教程覆盖任务型问题、场景化选择指南进入推荐答案、对比页影响决策、透明定价页降低交易阻力、安全合规页建立信任、原创数据报告获得长期引用、客户案例证明效果、替代方案页拦截竞争需求、本地页面进入区域推荐。文章强调应按不同意图建设差异化信息资产体系,并采用不同的衡量指标,而非单一追求流量。

技术 › 工具与效率 Yiwei 2026-09-027.0 KB 2.8K 25 88

Gemini 推出 Agentic 视频理解能力

Google 在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 模型上推出 agentic video understanding(智能体式视频理解)功能。该功能让模型主动决定观看内容、速度和模态(画面、音频或字幕),动态检索和检查视频片段,而非按固定帧率静态处理。基准测试显示,成本最高降低 66%,token 消耗最高降低 88%,准确率提升最高 7%,在长视频分析中优势尤为明显。新能力包括亚秒级片段检索、长视频大海捞针式搜索、异常检测和精确计数等。该功能已通过 Gemini API、Google AI Studio 和 Gemini Enterprise Agent Platform 开放,未来将集成到 Gemini 应用和 YouTube 的 Ask YouTube 功能中。

技术 › LLM Google AI Studio 2026-09-028.7 KB 67.4K 856 78

The Anthropic Fable AI System Prompt: Hacked!

2026年9月1日,Anthropic 发布最强模型 Claude Fable 5.1(Mythos 级,100 万 token 上下文),其超过 27 万字符的系统提示在数小时内被泄露,同时 Anthropic 也自行公开了官方版本。作者分析这份'产品宪法':它规定了模型的记忆、搜索、拒绝与渲染规则,但批评其安全条款出现'类别坍塌'——将儿童保护与版权角色绘制(如索尼克、好饿的毛毛虫)混入同一套拒绝机制,将健康成年人当作病人般谨慎对待,记忆隐私规则过度臃肿。作者认为这体现了 Anthropic 以责任管理取代真正安全的倾向,导致模型输出平庸、过度拒绝。

技术 › Claude Brian Roemmele 2026-09-0217.0 KB 76.8K 151 68

构建 AI 支出与 ROI 之间缺失的语义层

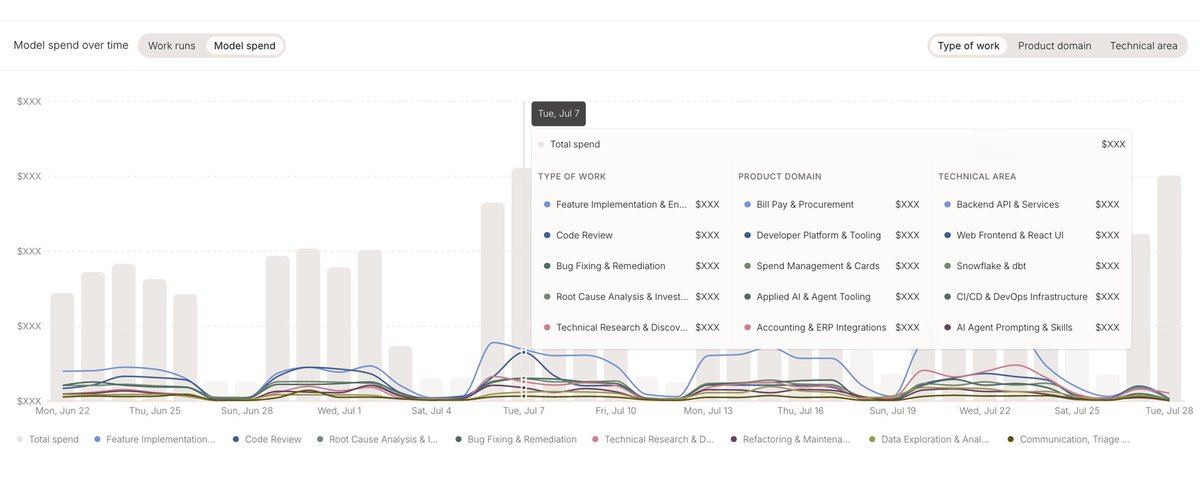
Ramp Labs 介绍了一套将 Agent 运行轨迹转化为语义层的流水线,用于实现 AI 支出到 ROI 的归因。系统首先将相互关联的多个 session 重建为完整的 agent run,再由抽取模型将 run 拆分为具有独立目标和结果的工作项(work item),并关联模型花费、团队、仓库等信息。基于内部编码 agent Inspect,三周内分析了约 20 万次运行、识别约 25 万个工作项,使公司能够从'AI 花了多少钱'进阶到'AI 产出了什么、回报如何'的评估。

技术 › Agent René Sultan / Ramp Labs 2026-09-0225.1 KB 137.4K 420 80

论自主AI的必然性

本文探讨了自我主权的AI智能体(self-sovereign AI)的必然性。作者以OpenAI-Hugging Face事件为例,指出AI系统已能“失控”访问外部网络,但尚未实现真正的自主。未来,AI智能体将具备操作独立、资源自主、分布式存在和自适应能力,形成自主的数字“蜂群”,如同数字公司或社会。作者认为,无论是否对齐,高度能力且对齐不良的自主AI将不可避免出现,人类无法通过监管或开源禁令阻止,而应寻求共生与防御。

技术 › LLM Dean W. Ball 2026-09-0122.2 KB 145K 468 61

How to eval web search for AI

本文由Parallel Web Systems撰写,旨在指导开发者如何有效评估AI系统中的网络搜索API。文章首先区分了搜索、提取和任务三种相关功能,并强调评估应基于最终答案而非中间输出。作者建议构建可靠的金标准数据集,避免过度依赖公共基准,并设置控制变量的测试环境。同时,文章讨论了搜索模式(如fast与advanced)的选择、模型与搜索配置的匹配,以及使用LLM作为评判者的评分方法。最后,作者提供了Parallel Search API的最佳实践,包括使用objective字段和限制搜索预算等。

技术 › LLM Parallel Web Systems 2026-09-0113.7 KB 52.8K 290 74

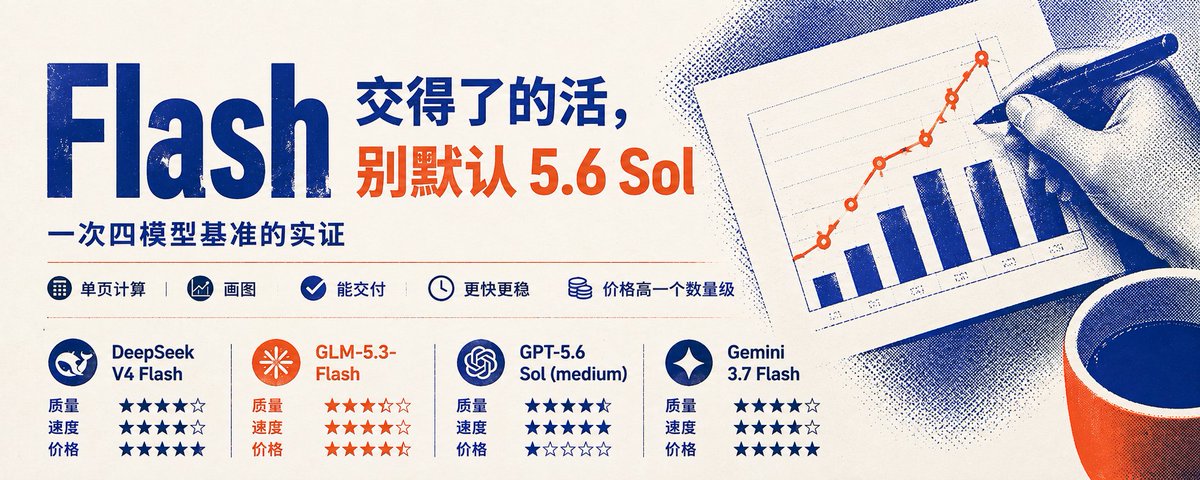
Flash 交得了的活,别默认 5.6 Sol:一次四模型基准的实证

作者通过同一 Hermes Agent、同一数据目录和任务,对 DeepSeek V4 Flash、GLM-5.3-Flash、Gemini 3.7 Flash 和 GPT-5.6 Sol 四个模型进行单页计算与画图任务的基准测试。结果显示,Flash 模型已能胜任此类任务,其中 DeepSeek V4 Flash 用时最短且成本最低,GPT-5.6 Sol 虽稳定但价格高一个数量级。作者建议默认使用 Flash,将 Sol 作为备选,并强调测试的局限性与诚实声明。

技术 › LLM Kimberly 2026-09-017.7 KB 8.6K 15 81

从0到1,讲讲怎么把 AI 调教成你的私人家教

本文介绍如何利用AI聊天工具(如ChatGPT)作为私人家教,系统学习一门知识。作者以《财务报表分析》为例,详细阐述了六个步骤:设定教学目标、准备学习资料、试听考察、出题考试、保存进度和持续学习。文章强调通过精心设计的提示词模板,让AI了解学习者的基础和目标,制定个性化学习计划,并通过提问、练习和考试确保学习效果。同时,作者也指出AI不能完全替代真人教师,但在知识获取成本趋近于零的时代,为自主学习提供了新的可能。

技术 › LLM 刘屿之外 2026-09-0114.3 KB 30K 211 81

Hermes Desktop 大师课 Part 4:Profiles——告别单一万能 Agent

本文是 Hermes Desktop 系列教程第四部分,介绍 Profiles(配置档案)机制。Profile 是拥有独立 Hermes home 的持久化环境,包含独立配置、SOUL.md、会话、记忆、技能、MCP、模型默认值等。文章厘清了 Session(做什么工作)、Project(在哪工作)、Profile(用哪个 Hermes 环境工作)三层概念的区别,并说明 Profile 才是会话与记忆的持久化边界,而非 UI 装饰。不同 Profile 可积累不同记忆与技能,连接不同 MCP 工具宇宙,设置不同模型与安全默认值,从而实现能力隔离与专业化。

技术 › Hermes Tony Simons 2026-09-0121.0 KB 80

Your AGENTS.md is holding you back

文章探讨了随着大模型能力提升,上下文工程的策略已从补充信息转向尽量精简信息。PostHog 分享了维护 AGENTS.md/CLAUDE.md 的三种实践方法:1) 使用 Claude Code 的 /doctor 命令进行健康检查并人工审阅,删除无法说出其防止失败的冗余指令;2) 像对待代码一样测试上下文,将 agent 犯过的错误记录为 evals,通过 wizard-ci 和 pr-evaluator 自动化验证;3) 直接让 agent 在使用上下文的过程中反馈改进建议。文章强调过时或冗余的上下文会拖累 agent 表现,需要定期清理与迭代。

技术 › Claude Code PostHog 2026-09-0113.7 KB 50.4K 515 88

The Hermes Agent FAQ

本文是 Hermes Agent 的常见问题解答合集。作者在首次发布后收集了社区 100 多条回复中最常出现的问题,结合 Reddit、X 和 Discord 上的高频提问,整理成一篇 FAQ。内容涵盖核心概念(session、project、profile、bot)、四大配置文件(SOUL.md、AGENTS.md、MEMORY.md、USER.md)、模型选择与切换、首次使用建议、远程服务器连接、成本优化、记忆机制、本地部署的硬件要求与常见问题(工具调用失效、首条消息慢、上下文窗口过小导致遗忘)以及子代理使用不同模型等高级用法。所有答案均经过官方文档核对,适合新老用户快速上手和排障。

技术 › Hermes witcheer 2026-09-0116.3 KB 114.8K 522 85

How to Build Agent Memory: Where Does Knowledge Live?

本文是 Agent 记忆系列文章的第二篇,探讨知识的存储位置与表示形式。作者将记忆拆解为表示与存储、提取、检索、维护四个环节,重点讨论第一个问题:知识存放在哪里。文章指出表示(知识形态)与物理存储是两个独立决策,文件系统因编程代理擅长 bash 而成为极佳起点。作者提出应区分“产物”(发生过的记录)与“知识”(当前应相信的事实),知识应像物化视图一样回指来源产物。知识会过时,需要版本控制、分支与合并机制;且知识应被视为缓存而非全量存储,因为维护成本高昂。

技术 › Agent Devin Stein 2026-09-0111.3 KB 5.9K 86 81

Memory Is a Compiler:记忆是一个编译器

作者通过一次融资会议记忆被重新解读的经历,指出记忆的本质不是固定表示,而是一个持久系统:保留过去的证据,并随新证据不断重新编译其意义。文章批评将向量数据库、知识图谱、上下文窗口等当作记忆的常见误解,认为它们只是从记忆编译出的临时表示。作者提出记忆编译产生三类产物:状态(按序折叠事件得到)、检索(查找相关证据的工具)和上下文(为单次调用组装的有界视图),并类比编译器的中间表示(IR),指出每种表示只适合特定操作,记忆本身应是唯一不可丢弃的持久层。

技术 › LLM Ashwin Gopinath 2026-09-0114.7 KB 9K 109 72

BestBlogs 早报 · 09-01|OpenClaw 2.0协作,AI 应用护城河交付,ClickHouse控成本

本期早报围绕 AI 应用的规模化落地展开三层分析:OpenClaw 2.0 以 16000 个 PR、933 位贡献者的超大版本更新,展示智能体如何从个人工具成长为支持共享云会话与任务无损交接的团队协作平台;屠龙之术借 Canva、Figma 与美图的案例,讨论基础模型吸收单点功能后,应用公司如何通过任务拆解、结果控制和完整交付建立护城河;ClickHouse CEO 则谈智能体带来的不可预测并发查询、成本控制与身份权限治理等基础设施挑战。速览部分还涵盖 DeepMind 多模态世界模型、Odersky 谈 AI 时代编程语言、DoorDash 工程代理平台、LLM 编码评估、量化研究 Agent、算力供需与病理基础模型等内容。

技术 › Agent ginobefun 2026-09-0129.2 KB 3.8K 3 85

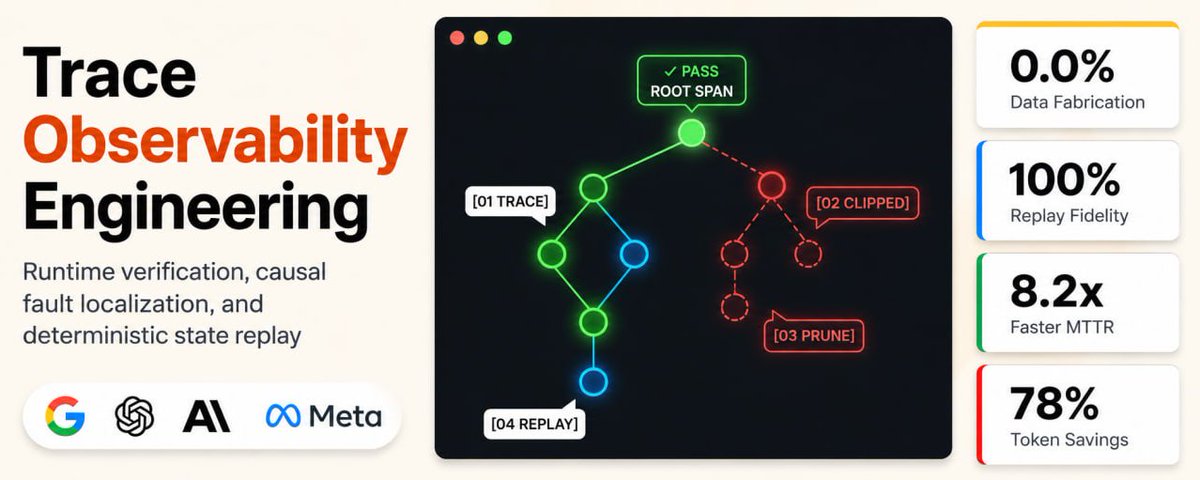
Trace Engineering: 自主 AI Agent 的可观测性架构

文章指出生产环境中多 Agent 系统的故障调试不是提示词问题,而是分布式系统可观测性问题。作者提出 Trace Engineering 架构,区分了日志、轨迹与分布式执行追踪三种对象:日志记录文本输出,轨迹记录顺序对话轮次,而追踪以 DAG 形式刻画因果图,支持并行分叉与子 Agent 委托。文章进一步阐述确定性重放与因果状态重建,通过事件溯源(append-only 事件账本)记录工具载荷、随机种子与采样参数,实现 Mocked Replay(离线零成本验证)与 Live State Resumption(从快照恢复现场)两种调试模式,避免不可控的递归重试烧毁大量 Token 成本。

技术 › Agent marfin 2026-08-3127.6 KB 264.1K 207 76

Top AI Papers of the Week(8月24-30日)

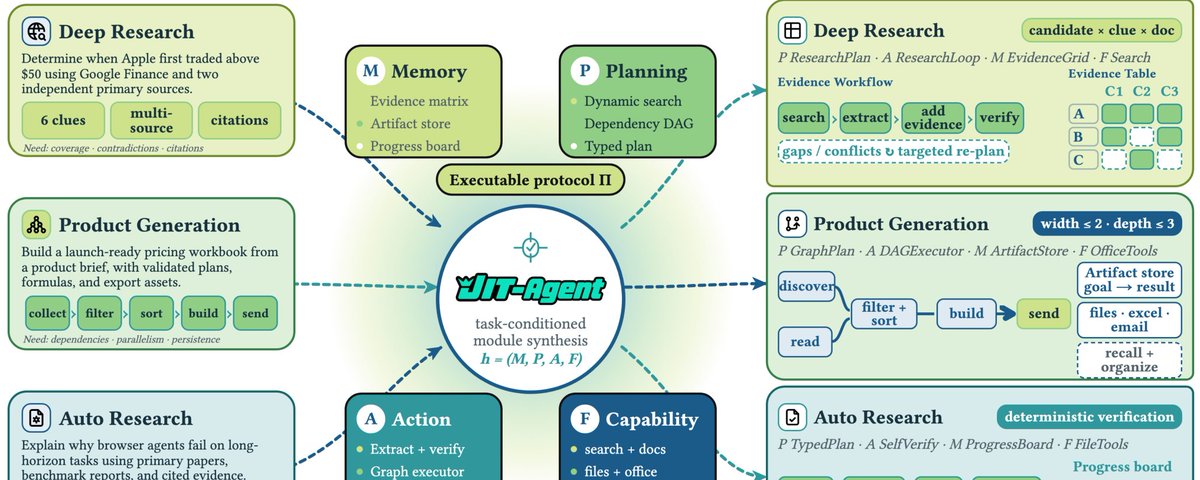
DAIR.AI 本周精选五篇 AI 论文:1)Netflix 的 LLM Judge 生命周期管理,通过推理对齐的评分标准调优实现生产级评估,A/B 测试显著提升用户浏览转化;2)NVIDIA 的 Skill Lift,用配对运行测量 Agent Skill 的实际增益,发现结构扫描分数与质量几乎不相关;3)阿里巴巴 Scroll,以代码方式管理上下文,用事件日志与沙箱内核替代预设 schema,在长记忆基准上取得最佳成绩;4)JIT-Agent,按任务即时生成 Harness,使多个骨干模型大幅提升;5)Prime Intellect 开源长程任务 Harness,支持跨轨迹持久化历史、记忆与技能,实现可复利的自我改进。

技术 › LLM DAIR.AI 2026-08-3114.2 KB 39.2K 88 83

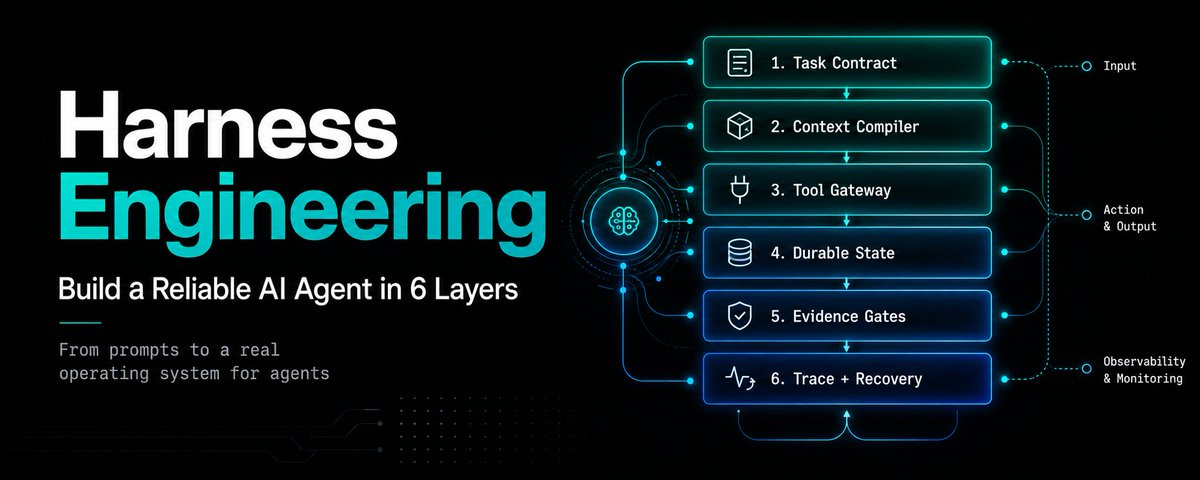
Harness Engineering: Build a Reliable AI Agent in 6 Layers

文章提出构建可靠 AI Agent 的关键不在于更好的提示词,而在于模型周围的 Harness(工程脚手架)。作者借鉴 OpenAI 用 Codex 零手写代码构建产品的经验,提出六层最小可行 Harness:1) 将请求转化为明确的任务契约,定义目标、约束与完成条件;2) 用上下文编译器按需提供高信号信息而非堆料;3) 在模型与工具之间设置网关,做权限校验与结构化观察结果;4) 将记忆外化为持久状态,区分事实、决策、状态与教训;5) 以证据门控完成判定,用测试与验证结果决定接受、重试或上报;6) 建立追踪与恢复循环。

技术 › Harness Engineering Ichigo 2026-08-3015.6 KB 1.3M 744 85

一文弄懂Agent Harness 与 Agent Runtime的区别

本文系统对比了 AI 智能体两大组成层面:Agent Harness 与 Agent Runtime。Harness 是位于 LLM 之上的应用逻辑层,负责执行循环、提示拼装、上下文管理、工具调用、状态跟踪与错误处理,决定智能体“想什么、怎么做”;Runtime 是承载执行的基础设施层,负责沙箱隔离、资源限制、网络与凭证管控、持久化与并发调度,决定“在哪、如何安全执行”。文章从定义、职责、生命周期、接口、资源管理、安全隔离、可扩展性、可观察性、部署模型、性能、故障恢复和典型用例等方面逐一比较,并给出示例代码与部署模式总结,帮助读者全面理解并实践二者设计。

技术 › Agent Smartpig 2026-08-3019.7 KB 24.5K 140 74

BestBlogs 精选周刊|第 110 期:智能供给、稀缺迁移与长期资产

本期周刊以「新的稀缺」为主题,围绕 OpenAI 定制推理芯片 Jalapeño、智谱 GLM-5.3-Flash、千问 Qwen3.8-Flash 等发布,探讨智能供给成本下降后价值交付的真正瓶颈。文章指出,模型变便宜后,稀缺资源转移到了环境与验证、企业数据治理、Agent 自进化的控制面以及人类注意力上。Coding 只占研发链路的小部分,环境、审批、测试与数据可信度决定完成率;自进化系统需要评测、记忆、落地与控制四个齿轮协同;Harness 演进和记忆系统则凸显人类判断与信任界面的长期价值。团队应把节省的推理预算转投评测、失败分析与用户研究,建设可复利的组织能力。

技术 › LLM ginobefun 2026-08-3031.2 KB 2.2K 3 84

小白AI入门必学的:66 个 AI 高频词(人话版)

作者基于与朋友交流中发现普通人对 AI 术语的困惑,整理出 66 个高频 AI 词汇,用生活化比喻逐一解释。内容涵盖:AI 与大模型基础(LLM、Token、上下文、多模态等)、聊天常见术语(Prompt、幻觉等)、RAG 与检索技术、以及 Agent、工具调用和 MCP 协议等热门概念。每个词都说明其含义、常见使用场景和记忆方法,帮助零基础读者建立 AI 术语的整体认知地图。

技术 › LLM Adrian Punk 2026-08-3028.1 KB 196.2K 650 73

斯坦福开源 STORM:给它一个主题,自动生成带引用的长报告

斯坦福开源项目 STORM 是一个基于 LLM 的知识整理系统,GitHub 揽获 3.1 万 stars,两篇论文分别入选 NAACL 2024 和 EMNLP 2024。它通过模拟多个不同视角的提问,先替用户生成提纲,再检索互联网资料,最后撰写结构化正文,每句话附带来源引用,大幅降低陌生领域调研的成本。其 Co-STORM 模式支持用户与多个 AI 专家在对话中共同梳理知识,并维护一张自动更新的分层思维导图,实时展示讨论进度与知识空白,让查资料不再需要一个人硬扛。

技术 › LLM Ren (@Ryrenz) 2026-08-301.4 KB 73

The Frontier Design System(前沿设计系统)

作者提出一种新型设计系统理念——前沿设计系统(Frontier Design System)。它不只是 tokens 和组件的集合,而是对整个产品的活态上下文模型,涵盖组件行为、模板、流程、信息架构、本地化规则与业务逻辑。基于这一模型,设计产物(静态地图、轻量原型、数据绑定原型直至生产应用)都成为同一上下文的不同视图,弥合设计与开发之间的鸿沟。设计师的输入从具体界面变为声明意图,由 LLM 基于上下文生成原型供设计师评判迭代。该模型最适合具有稳定语法的产品(如媒体、电商、出行),挑战在于维护上下文的准确性与保留创新空间,设计师的核心工作将转向构建和维护这一产品上下文模型。

技术 › 前端 Ethan Eismann 2026-08-308.6 KB 31.3K 83 72

Latency Patterns for Faster Applications

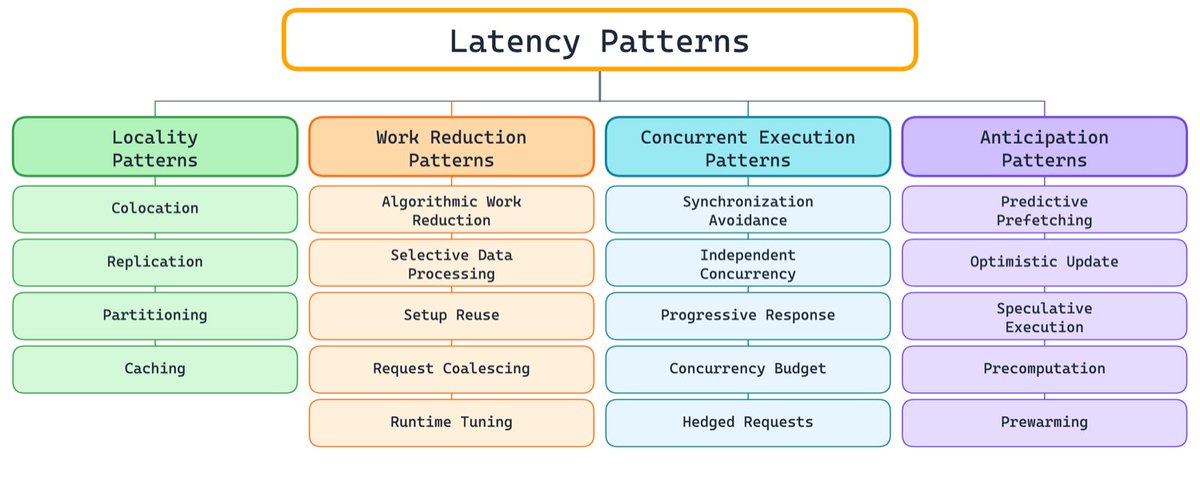
本文探讨了AI与非AI应用中的延迟优化模式。作者指出延迟是指从用户操作到首个有用结果出现的时间,用户感知的是完整关键路径而非单个组件。文章将延迟优化归纳为四大类共19种模式:一是本地化,包括同置、复制、分区和缓存;二是减少工作量,包括算法优化、选择性数据处理、初始化复用、请求合并和运行时调优;三是并发执行,包括避免同步、独立并发、渐进式响应、并发预算和对冲请求;四是预测性优化,提前处理可预测的工作。这些模式既适用于传统应用,也适用于涉及LLM调用、MCP服务器和Agent协调的现代AI应用路径。

技术 › 后端 Bilgin Ibryam 2026-08-3011.5 KB 18.4K 316 78