Wiki 知识库

全部文档 / 标签: 推理优化

46 篇
清除

BestBlogs 早报 · 08-30|腾讯开源 Hy4,Anthropic 员工用 Claude,携程推行代码即文档

本期早报聚焦 AI 能力如何进入真实任务并沉淀为组织资产。精讲一:腾讯发布开源大模型 Hy4 preview(770B 参数、激活 49B、1M 上下文),通过 CodeBuddy、WorkBuddy 等产品形成任务反馈闭环,并让模型参与推理系统自优化,端到端吞吐提升 31.8%。精讲二:Anthropic 分享员工在 Slack 中使用 Claude 的实践,通过明确搜索范围、匹配标准、事实核验与人工签字责任,把开放协作改造成可检查的工作流。精讲三:携程机票前端团队构建 Lumos,以 MR 为事件触发自动文档生成与向量知识库建设,人工维护文档时间下降 80% 以上。三条案例共同勾勒出「能力进入任务—过程接受核验—结果沉淀为资产」的完整实践路径。

技术 › LLM ginobefun 2026-08-3033.2 KB 6.8K 3 75

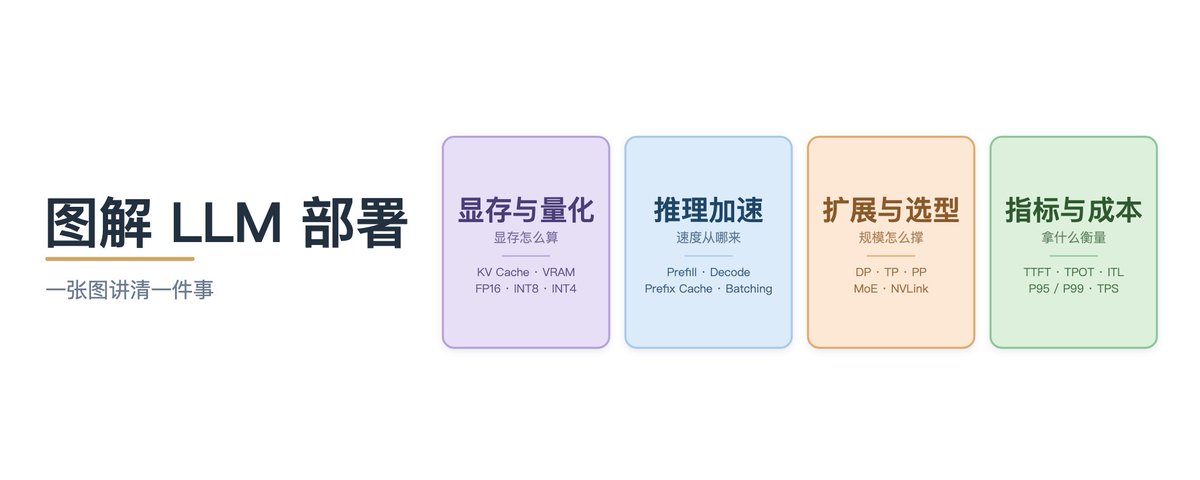
图解大语言模型部署

本文系统讲解大语言模型自部署的核心指标与实践要点,覆盖延迟类指标(TTFT、TPOT/ITL、P95/P99)、吞吐类指标(TPS、QPS、连续批处理)、资源类指标(显存与KV cache计算、量化精度)、服务质量(错误率、探针、可用性)以及成本核算(cost per token、TCO)。作者以 Ling-3.0-Flash MoE 模型在 DGX Spark 上的真实实测为例,将抽象指标落地为具体数字,帮助读者选对硬件配置、排查吞吐瓶颈与OOM问题、评估自建与API的划算临界点。

技术 › LLM WquGuru 2026-08-2927.1 KB 56.2K 199 89

We Made Our Best Voice Model Free. Here's the GPU Math Behind It.

Fish Audio 通过重构 S2.1 Pro 语音模型的服务栈,将 GPU 利用率从约 50% 提升至 90% 以上,使原本需要四块 H200 的请求量现在一块即可承载。核心技术包括:针对 TTS decode 小矩阵形状定制的 FP8 CUDA 内核(比 torch.compile-fused cuBLAS 快 2.1–4.3 倍)、Continuous Batching(并发 1 到 64 吞吐量提升约 52 倍,仅增加 37ms 延迟)、Kubernetes 与 Slurm 弹性调度填充空闲算力,以及自建网络与存储基础设施。所有推理变更均需通过正确性与性能双重门槛。这些优化带来的单位经济效益使 Fish Audio 能够将完整的 S2.1 Pro 模型免费开放,并开源了 fish-scales-ops 内核库。

技术 › TTS Fish Audio 2026-08-289.6 KB 13.5K 227 84

Pi Agent + Qwen 3.8 27B 深度优化

作者在懒猫AI算力舱 X5(128GB显存)上部署 Qwen 3.8 27B 稠密模型,真实项目中跑了4个任务均完成良好。通过 MTP 投机解码 + NVFP8 混合优化并关闭 thinking 模式,速度从 13.9 提升到 30.8 Tokens;但发现关闭思考模式会降低代码推理准确度,重新开启后实测稳定 26.47 Tokens(含思考阶段实际可达 35.23 Tokens/s)。后续还将通过重新量化构建 draft engine 进一步提速。

技术 › LLM Andy Stewart 2026-08-252.7 KB 26.1K 42 55

How Production LLMs Reason Better at Inference Time

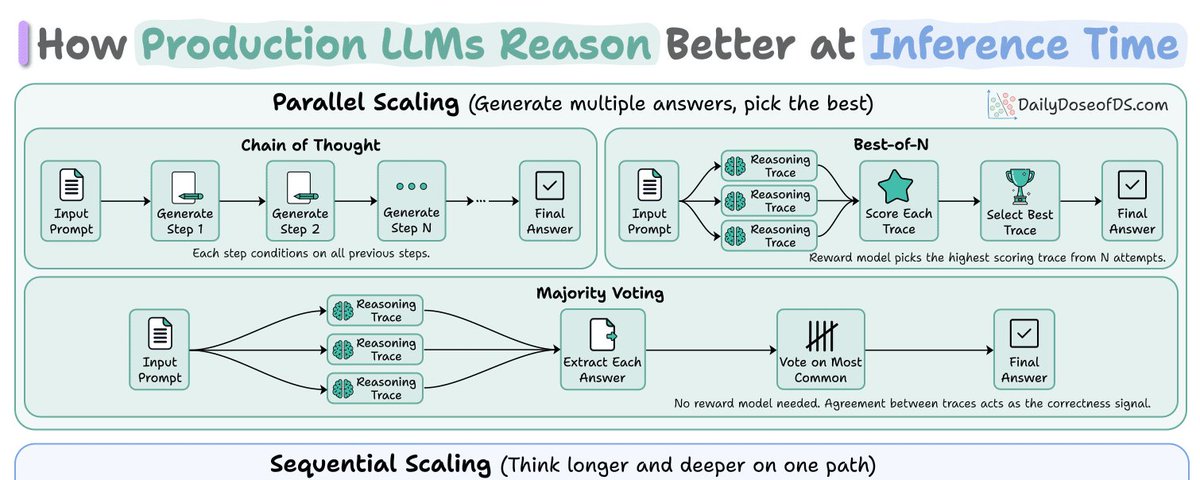
本文介绍了八种在推理阶段提升大语言模型推理能力的技术,包括思维链、多数投票、Best-of-N、扩展思考、自我精炼等,并分析了每种技术的权衡和实际应用注意事项。文章指出,在推理阶段干预是提升准确率最经济的方式,无需重新训练模型。通过FLOPs匹配比较,测试时计算优于14倍大的模型。文章还讨论了并行采样与顺序扩展两种计算分配方式,以及树方法如何结合两者。每种技术都有其适用场景和局限性,如多数投票无法处理开放生成任务,Best-of-N需要奖励模型且存在过优化风险,扩展思考并非越长越好。最后,文章强调选择合适技术需根据任务特性和评估结果。

技术 › LLM Avi Chawla 2026-08-1514.3 KB 73.8K 132 78

MiniMax H3 双 4090 本地部署实操教程

本文详细介绍了在 Windows 宿主 + Linux Docker 容器环境下,使用双 RTX 4090(48GB)本地部署 MiniMax H3 视频生成模型的完整过程。内容包括本地部署的优势(成本、隐私、可控性)、双 GPU 架构分工、宿主机目录布局、模型文件清单、Docker 容器创建、启动验收、已验证的推理链、速度实测、分辨率与帧数注意事项、最小生成验证流程、复现清单以及生产链必需节点。文章提供了具体的配置命令和参数,并强调了可复现性的重要性。

技术 › 工具与效率 雪踏乌云 2026-08-1413.0 KB 22.2K 63 89

使用 SGLang 和 Torch Profiler 对 LLM 推理进行性能分析

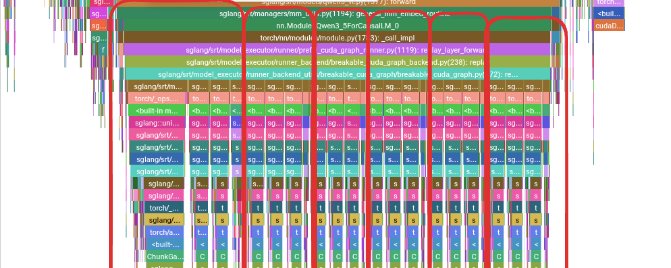
本文详细介绍了如何使用 SGLang 内置的 Torch Profiler 对大语言模型(Qwen3.5-0.8B)进行推理性能分析。作者阐述了如何通过追踪 CPU 和 GPU 端事件来定位计算瓶颈,并结合屋顶线模型证实单批次解码主要受限于内存带宽。文中展示了如何利用 Perfetto UI 分析 Prefill 阶段的性能追踪数据,将其底层计算操作与模型的混合架构(如 Gated DeltaNet 和全注意力机制)精准映射,帮助读者深入理解 LLM 的底层执行流程。

技术 › LLM Jino Rohit 2026-08-0913.8 KB 104.1K 916 88

长上下文缓存能复用,为什么一压缩就失真?

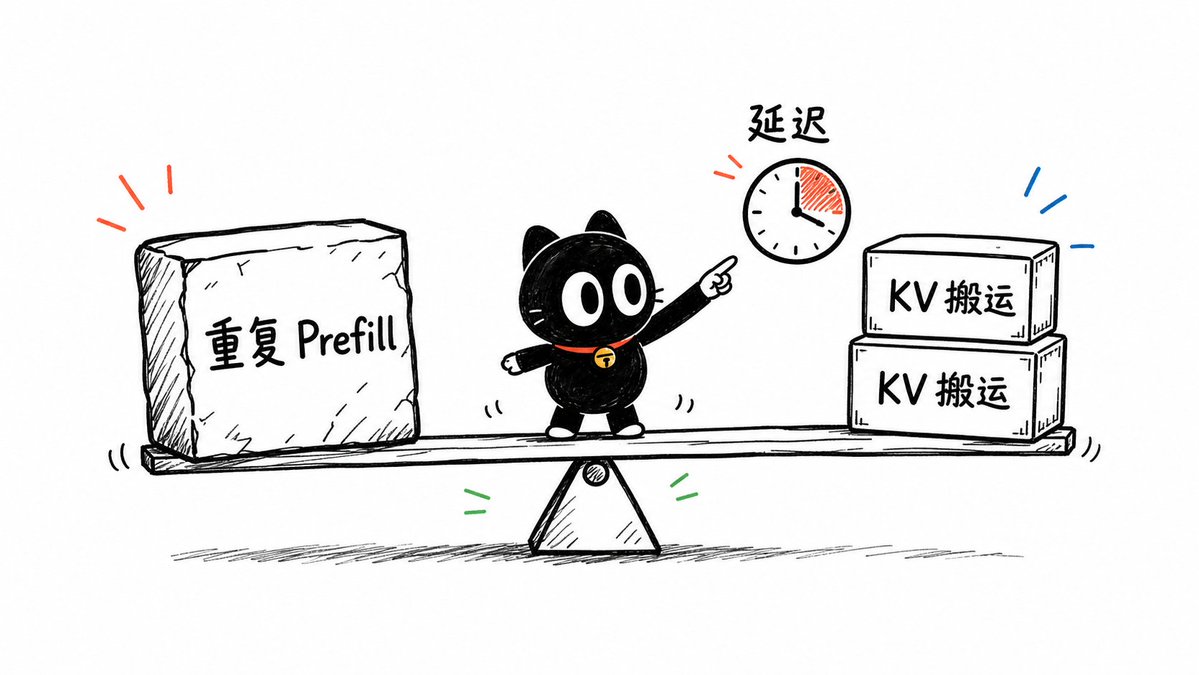
文章探讨了 RAG 场景中 KV Cache 复用的挑战。现有方法在长上下文下面临存储与传输瓶颈,且直接复用或简单压缩会导致位置偏移和误差放大。C2KV 通过轻量级 Extractor 将文档压缩为可拼接、位置解耦的 KV 表示,实现了显著推理加速。文章分析了其在质量、延迟和工程落地上的权衡,强调 KV 复用已演变为存储、传输和质量共同约束的系统问题。

技术 › LLM 烟花老师 2026-08-0413.9 KB 1.2K 5

PagedAttention & RadixAttention

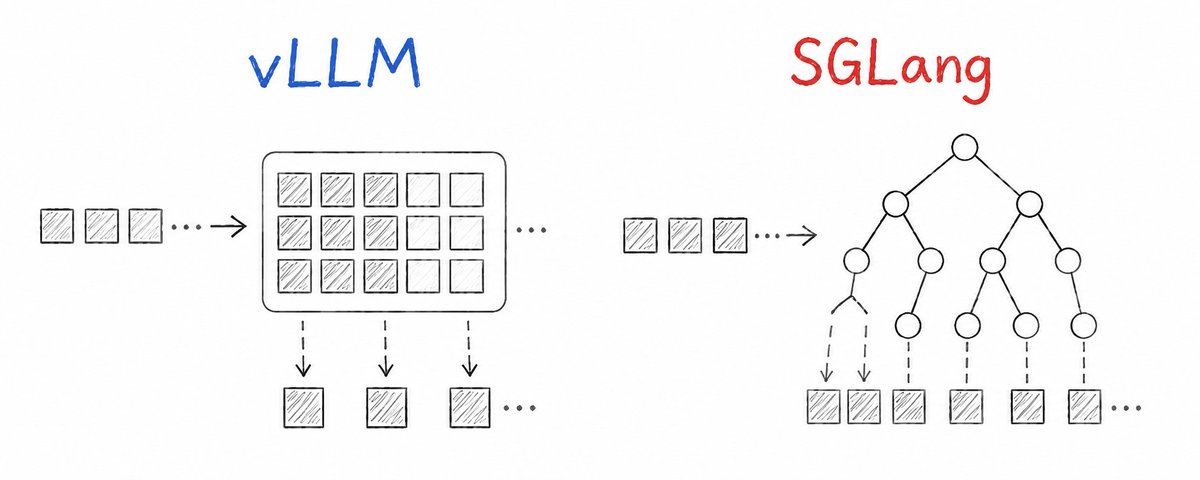
本文深入探讨了 PagedAttention 和 RadixAttention 两种技术。PagedAttention 通过类似操作系统的分页机制管理 GPU 内存,解决 KV Cache 的内部和外部碎片问题,显著提升并发处理能力。RadixAttention 则利用基数树索引缓存的前缀状态,实现跨请求的计算和内存复用,进一步优化推理性能。

技术 › LLM prasanna 2026-07-2814.4 KB 43.7K 565

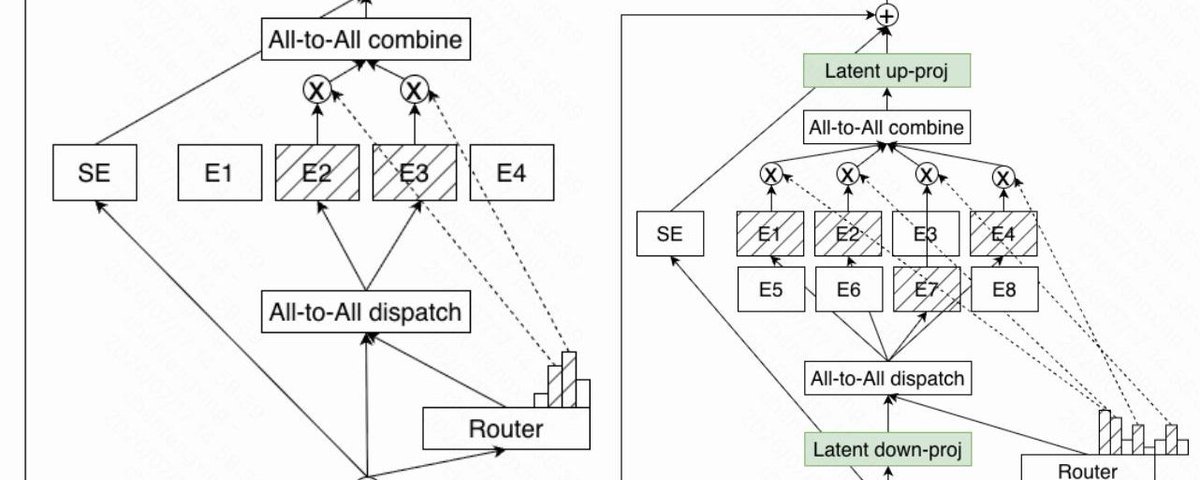
从 Kimi K3 看下一代 MoE 架构的转折点:LatentMoE

文章分析了 2026 年大模型架构的新趋势 LatentMoE。通过对比 NVIDIA Nemotron 3 Super 和 Moonshot AI Kimi K3,揭示了 LatentMoE 如何通过将 token 投影到低维潜在空间,大幅降低内存和通信开销,从而在同等推理成本下激活更多专家,提升模型性能与效率。

技术 › LLM 青稞社区 2026-07-208.2 KB 21.8K 189

人工智能的工程全景(中):推理,后训练,对齐和安全

本文是AI工程全景的中篇,深入探讨了模型训练完成后的工程化路径。首先详述了推理优化的核心手段,包括模型瘦身(量化、蒸馏、剪枝、MoE)、投机解码以及主流推理引擎(vLLM, TensorRT-LLM, SGLang)的生态格局。文章分析了成本、延迟与吞吐的“不可能三角”,并重点介绍了“测试时计算”这一范式转变,即通过在推理阶段增加计算量来动态提升模型智能。

技术 › LLM snowboat 2026-07-0372.0 KB 19.2K 43

Top Companies Are Secretly Working on This (It Will Replace LLMs)

文章探讨了顶级科技公司正在秘密研发的架构转变——状态空间模型(SSM)。旨在解决 Transformer 架构在长序列处理中的计算成本高和内存消耗大的问题。文章详细解析了 SSM 的工作原理、相比 LLM 的优势(线性时间复杂度、恒定内存),并展示了 NVIDIA、IBM 和 Microsoft 等公司在 Nemotron、Bamba 和 SambaY 等混合架构上的实际应用进展。

技术 › LLM Siddharth 2026-05-0652.5 KB 116K 203 84

RTX 3090 上实现 Qwen3.5-27B 模型 207 tok/s 推理速度的技术实践

文章介绍了如何通过构建独立的 C++/ggml 推测解码器,在单张 RTX 3090 (24GB) 显卡上实现了 Qwen3.5-27B (Q4_K_M) 模型的高效推理。利用 DFlash block-diffusion draft 和 DDTree 验证器,成功将峰值解码速度提升至 207.6 tok/s,较自回归基准提升约 5.46 倍,并实现了在有限显存下运行 128K 长上下文的能力。

技术 › LLM Sandro 2026-04-2116.5 KB 218.8K 925 88