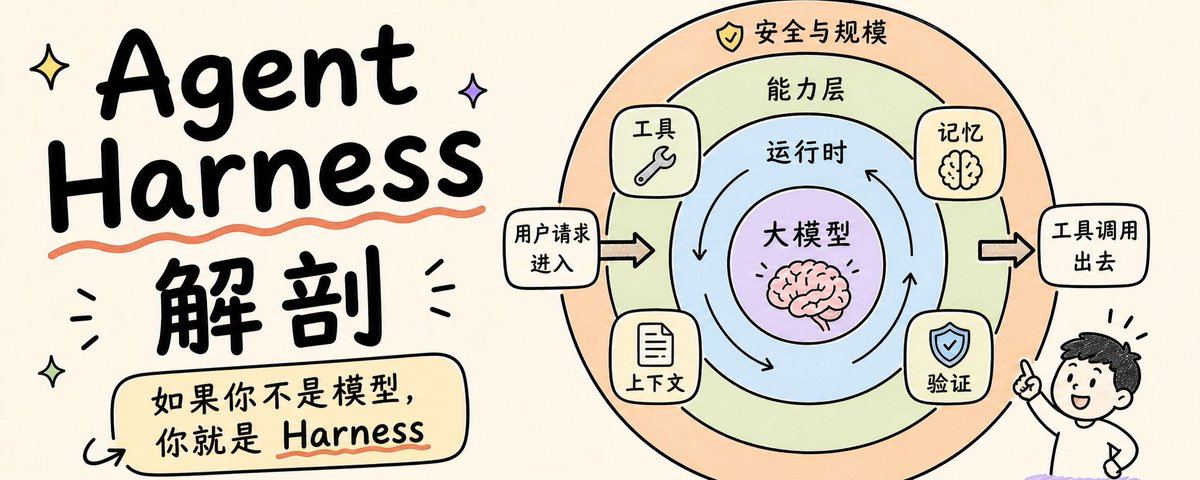
Agent Harness 拆解:AI Agent 的工程化基础设施
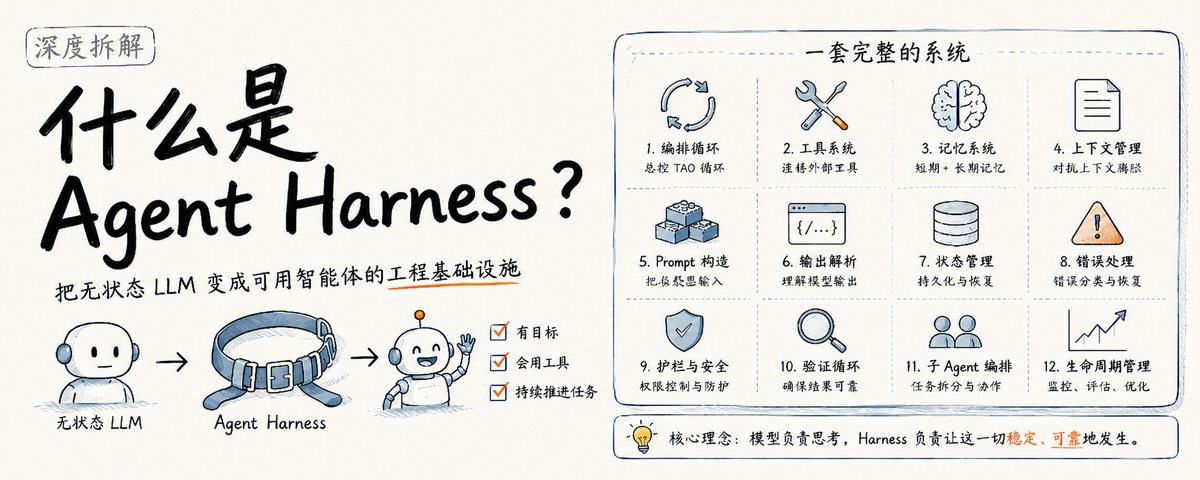
本文深入探讨了 Agent Harness 的概念,即包裹在 LLM 外部、将无状态模型转化为可用智能体的完整软件基础设施。文章引用了 Anthropic、OpenAI 和 LangChain 的实践,详细拆解了生产级 Harness 的 12 个核心组件(如编排循环、记忆系统、上下文管理、验证循环等),并阐述了如何通过优化这层“操作系统”来解决遗忘、工具调用失败和上下文腐烂等工程难题。
本文深入探讨了 Agent Harness 的概念,即包裹在 LLM 外部、将无状态模型转化为可用智能体的完整软件基础设施。文章引用了 Anthropic、OpenAI 和 LangChain 的实践,详细拆解了生产级 Harness 的 12 个核心组件(如编排循环、记忆系统、上下文管理、验证循环等),并阐述了如何通过优化这层“操作系统”来解决遗忘、工具调用失败和上下文腐烂等工程难题。
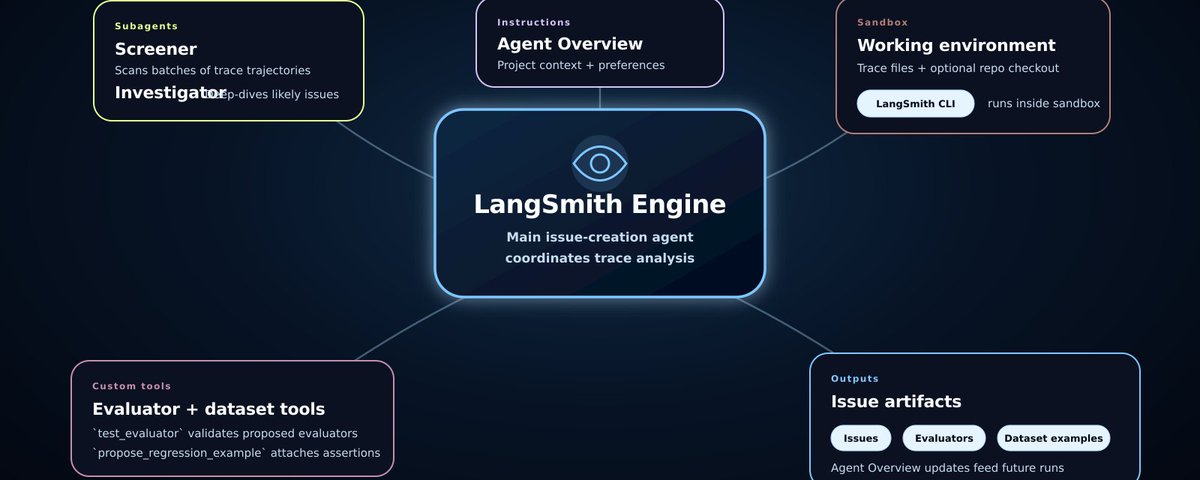
文章详细介绍了 LangSmith Engine 的技术架构与实现细节。Engine 是一个构建在 LangSmith 平台之上的元 Agent,旨在解决大规模 Agent 部署中的调试难题。它能够自动分析海量 Traces,识别如工具循环调用、参数错误等重复性失败模式,并将其转化为具体的“问题”,进而建议评估器、数据集示例或代码修复方案。
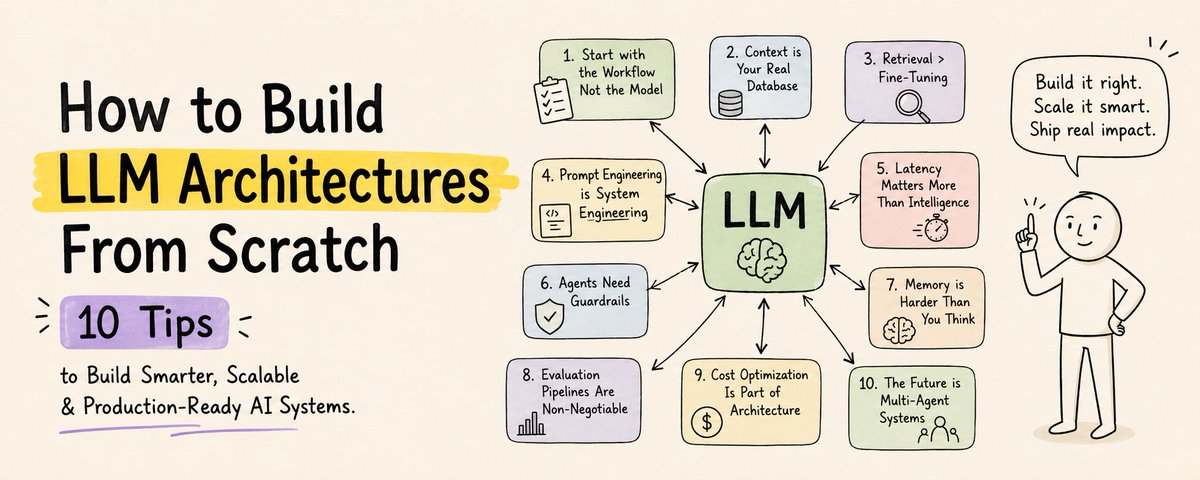
本文指出构建 AI 产品的核心不在于选择模型,而在于架构设计。作者分享了 10 个实用经验,强调从工作流而非模型入手、重视检索优于微调、将提示工程视为系统工程、关注延迟优化、为智能体设置护栏、妥善处理记忆、建立评估管道以及优化成本。最终,多智能体系统将是未来趋势。
本文详细解析了企业级 AI Agent 的构建方法,重点在于通过多 Agent 系统解决复杂任务。文章从 Agent 的核心定义出发,区分了 Workflow 与 Agent 的适用场景,并深入探讨了多 Agent 系统的编排模式、上下文管理及信息传递机制。作者以 Deep Research 为例,拆解了其工作原理与架构设计,强调了在 AI 变现中做定制化项目的价值。
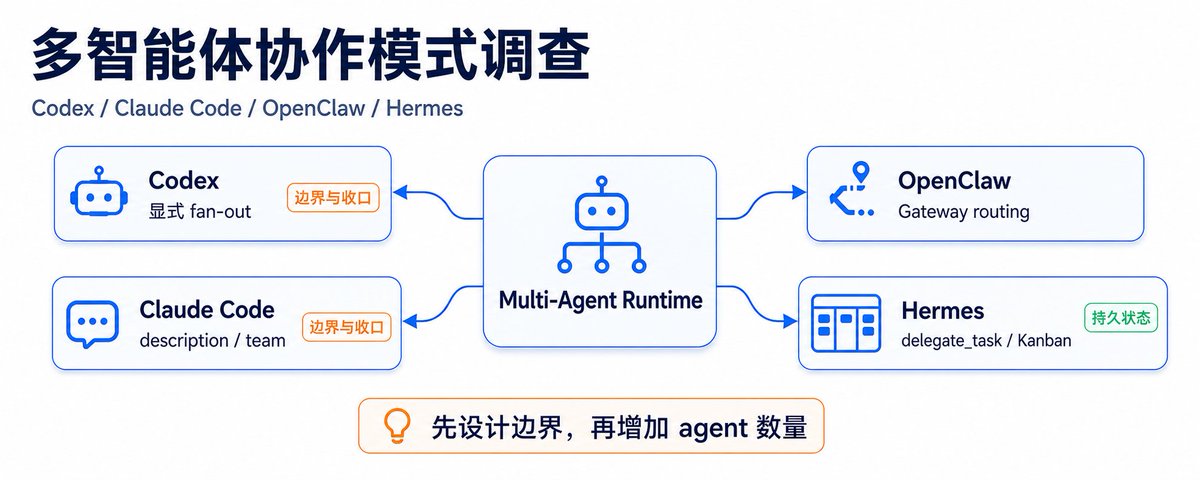
本文深入探讨了多智能体协作的工程实现细节,指出其并非简单的模型实例多开,而是涉及任务调度、状态管理等复杂机制。文章详细分析了 Codex、Claude Code、OpenClaw 等系统在触发方式(显式/语义/路由/队列)和拓扑结构(星型/链式/树型等)上的设计差异,并拆解了调用链中的关键环节。作者强调了显式控制、上下文隔离及 Merge 策略在构建高效多智能体系统中的重要性。
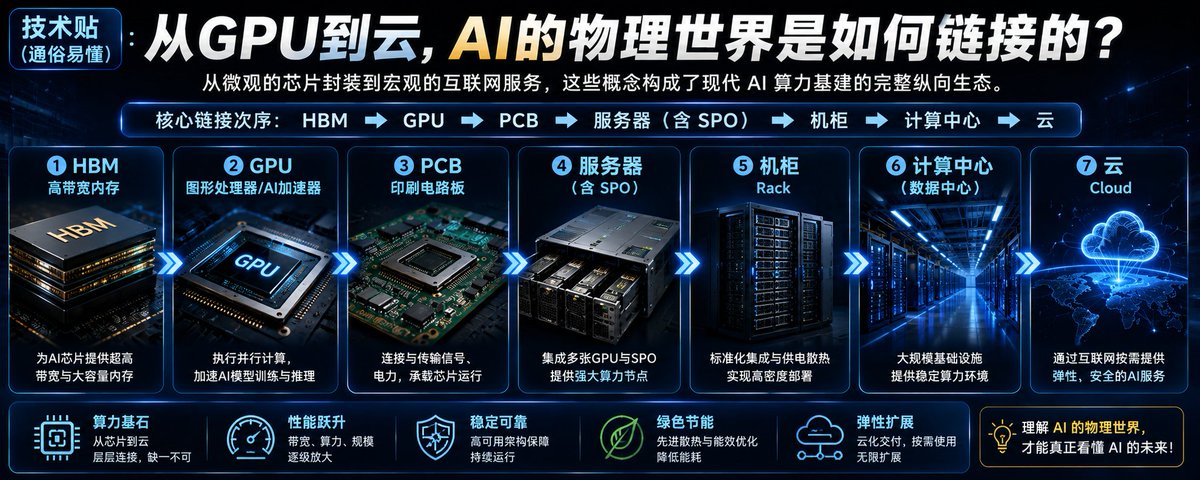
本文以通俗易懂的方式,从微观到宏观详细拆解了AI算力基础设施的物理构成。文章按照 HBM、GPU、PCB、服务器、机柜、计算中心到云的层级顺序,解析了各硬件的连接关系与核心作用,并补充了硅中介层、交换芯片、散热系统及数据中心与云的区别等关键知识点。
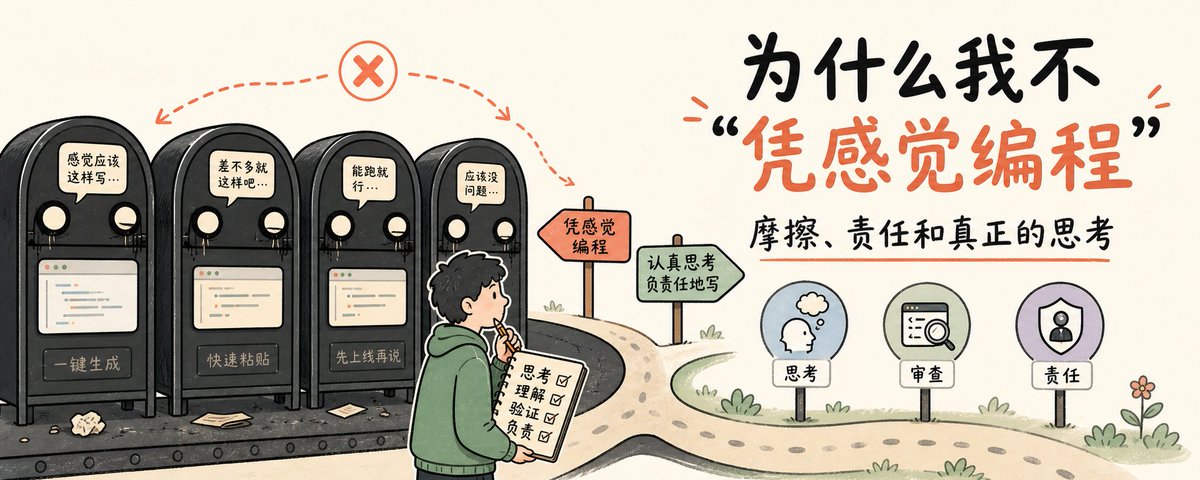
文章翻译并分享了 Jacob Harris 关于拒绝使用“凭感觉编程”(即过度依赖 LLM 辅助编程)的观点。作者从经济成本、经验主义、抽象本质、摩擦的价值以及责任感五个维度展开论述。他认为,编程是在复杂现实中建立抽象的过程,需要深度理解架构决策和承担后果,而 LLM 只能解决偶然复杂性,无法处理本质复杂性,更无法替代人类的思考与责任。
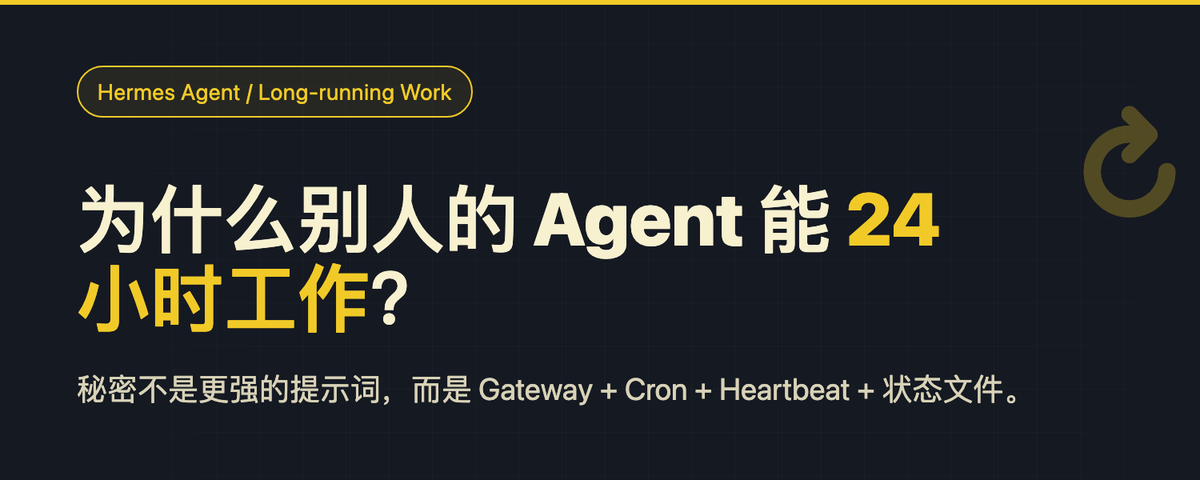
文章分析了基于 Hermes 的 Agent 无法实现长期自治的原因,指出问题不在于模型或提示词,而在于缺乏后台调度机制。作者详细介绍了实现 24 小时工作的四个核心组件:Gateway(后台闹钟)、Cron(定时唤醒)、Heartbeat(唤醒指令)和状态文件(上下文存储),并提供了具体的文件结构配置建议。
作者分享了将 AI Agent 从 Demo 推向生产环境过程中遇到的四个“深坑”:Function Calling 的不可预测性需加代码校验兜底;多步任务必须引入状态机和 checkpoint 防止重复执行或死无对证;记忆管理需分层以解决 token 爆炸和“丢失中间”问题;权限控制是最大风险,需防范 prompt injection 并建立分级审计机制。
文章深入探讨了 Claude Code 如何在大型代码库(如单体仓库、遗留系统)中高效工作。与依赖过时索引的 RAG 工具不同,Claude 采用代理式搜索遍历本地文件系统。文章指出,工具链(包括 CLAUDE.md、钩子、技能、插件、MCP 服务器和 LSP 集成)对性能的影响往往大于模型本身。通过建立正确的上下文层次和渐进式采用策略,团队可显著提升开发效率。
文章深入解析了 OpenAI Codex CLI 的内存架构,该工具通过本地 Markdown 文件异步生成和汇总记忆。文章详细介绍了记忆的写入与加载流程,指出其缺乏向量数据库、仅依赖关键词匹配及受限于本地文件系统等局限。最后,文章引入 Mem0 作为解决方案,通过 MCP 协议提供跨机器、跨工具的持久化智能记忆层,解决原生功能在扩展性和同步方面的不足。
文章深入探讨了“AI Agent Harness”的概念,即包裹在大语言模型之外、使其转变为智能体的完整软件架构。作者详细拆解了生产级 Harness 的 12 个核心组件(如编排循环、工具、记忆、上下文管理等),对比了 Anthropic、OpenAI 和 LangChain 的不同实现路径,并指出 Harness 工程是决定 AI 应用性能的关键。
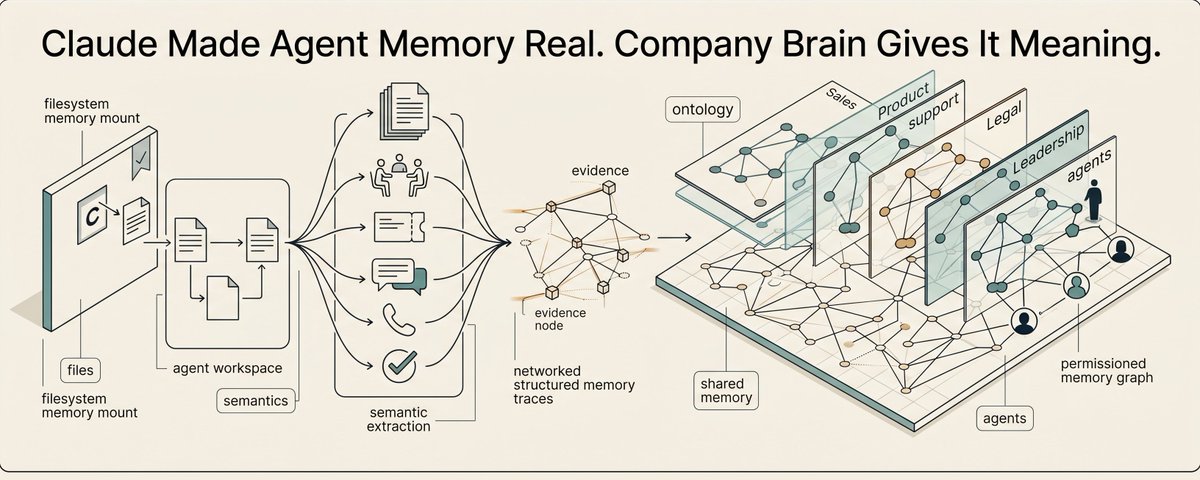
文章探讨了Anthropic最新发布的Claude“托管代理”中的记忆功能,指出虽然文件化的记忆存储为Agent提供了可检查、可跨会话持久化的基础,但仅有存储并不等同于理解。作者强调,真正的智能记忆需要“语义”(定义事物是什么)和“本体”(定义事物为何重要)。文章以企业场景为例,阐述了销售、法务、产品等不同部门对同一信息的不同理解视角(即本体),并提出企业AI的未来在于构建共享的底层记忆基座与上层可定制的领域本体(透镜层),从而让AI从被动问答转向主动提供上下文。
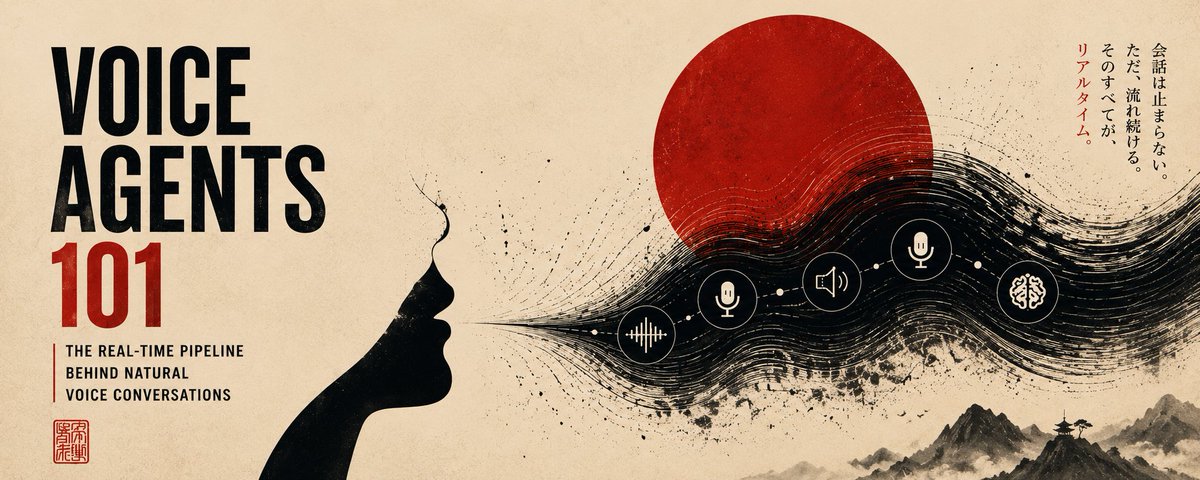
本文深入探讨了语音智能体的技术架构,指出语音工程不同于文本工程。文章对比了级联式与端到端两种语音模型,分析了全双工通信的难点,并详细解析了为了实现自然对话所需的流式处理与延迟优化策略。
文章深入探讨了混合专家模型(MoE),这是一种通过激活特定子网络来高效扩展 AI 模型的架构策略。文章回顾了 MoE 的历史背景,详细解释了其由门控网络和专家组成的结构及稀疏路由机制,并分析了其在 Transformer 中的应用、优势(如高效计算、参数扩展)以及面临的负载平衡和通信开销等挑战。
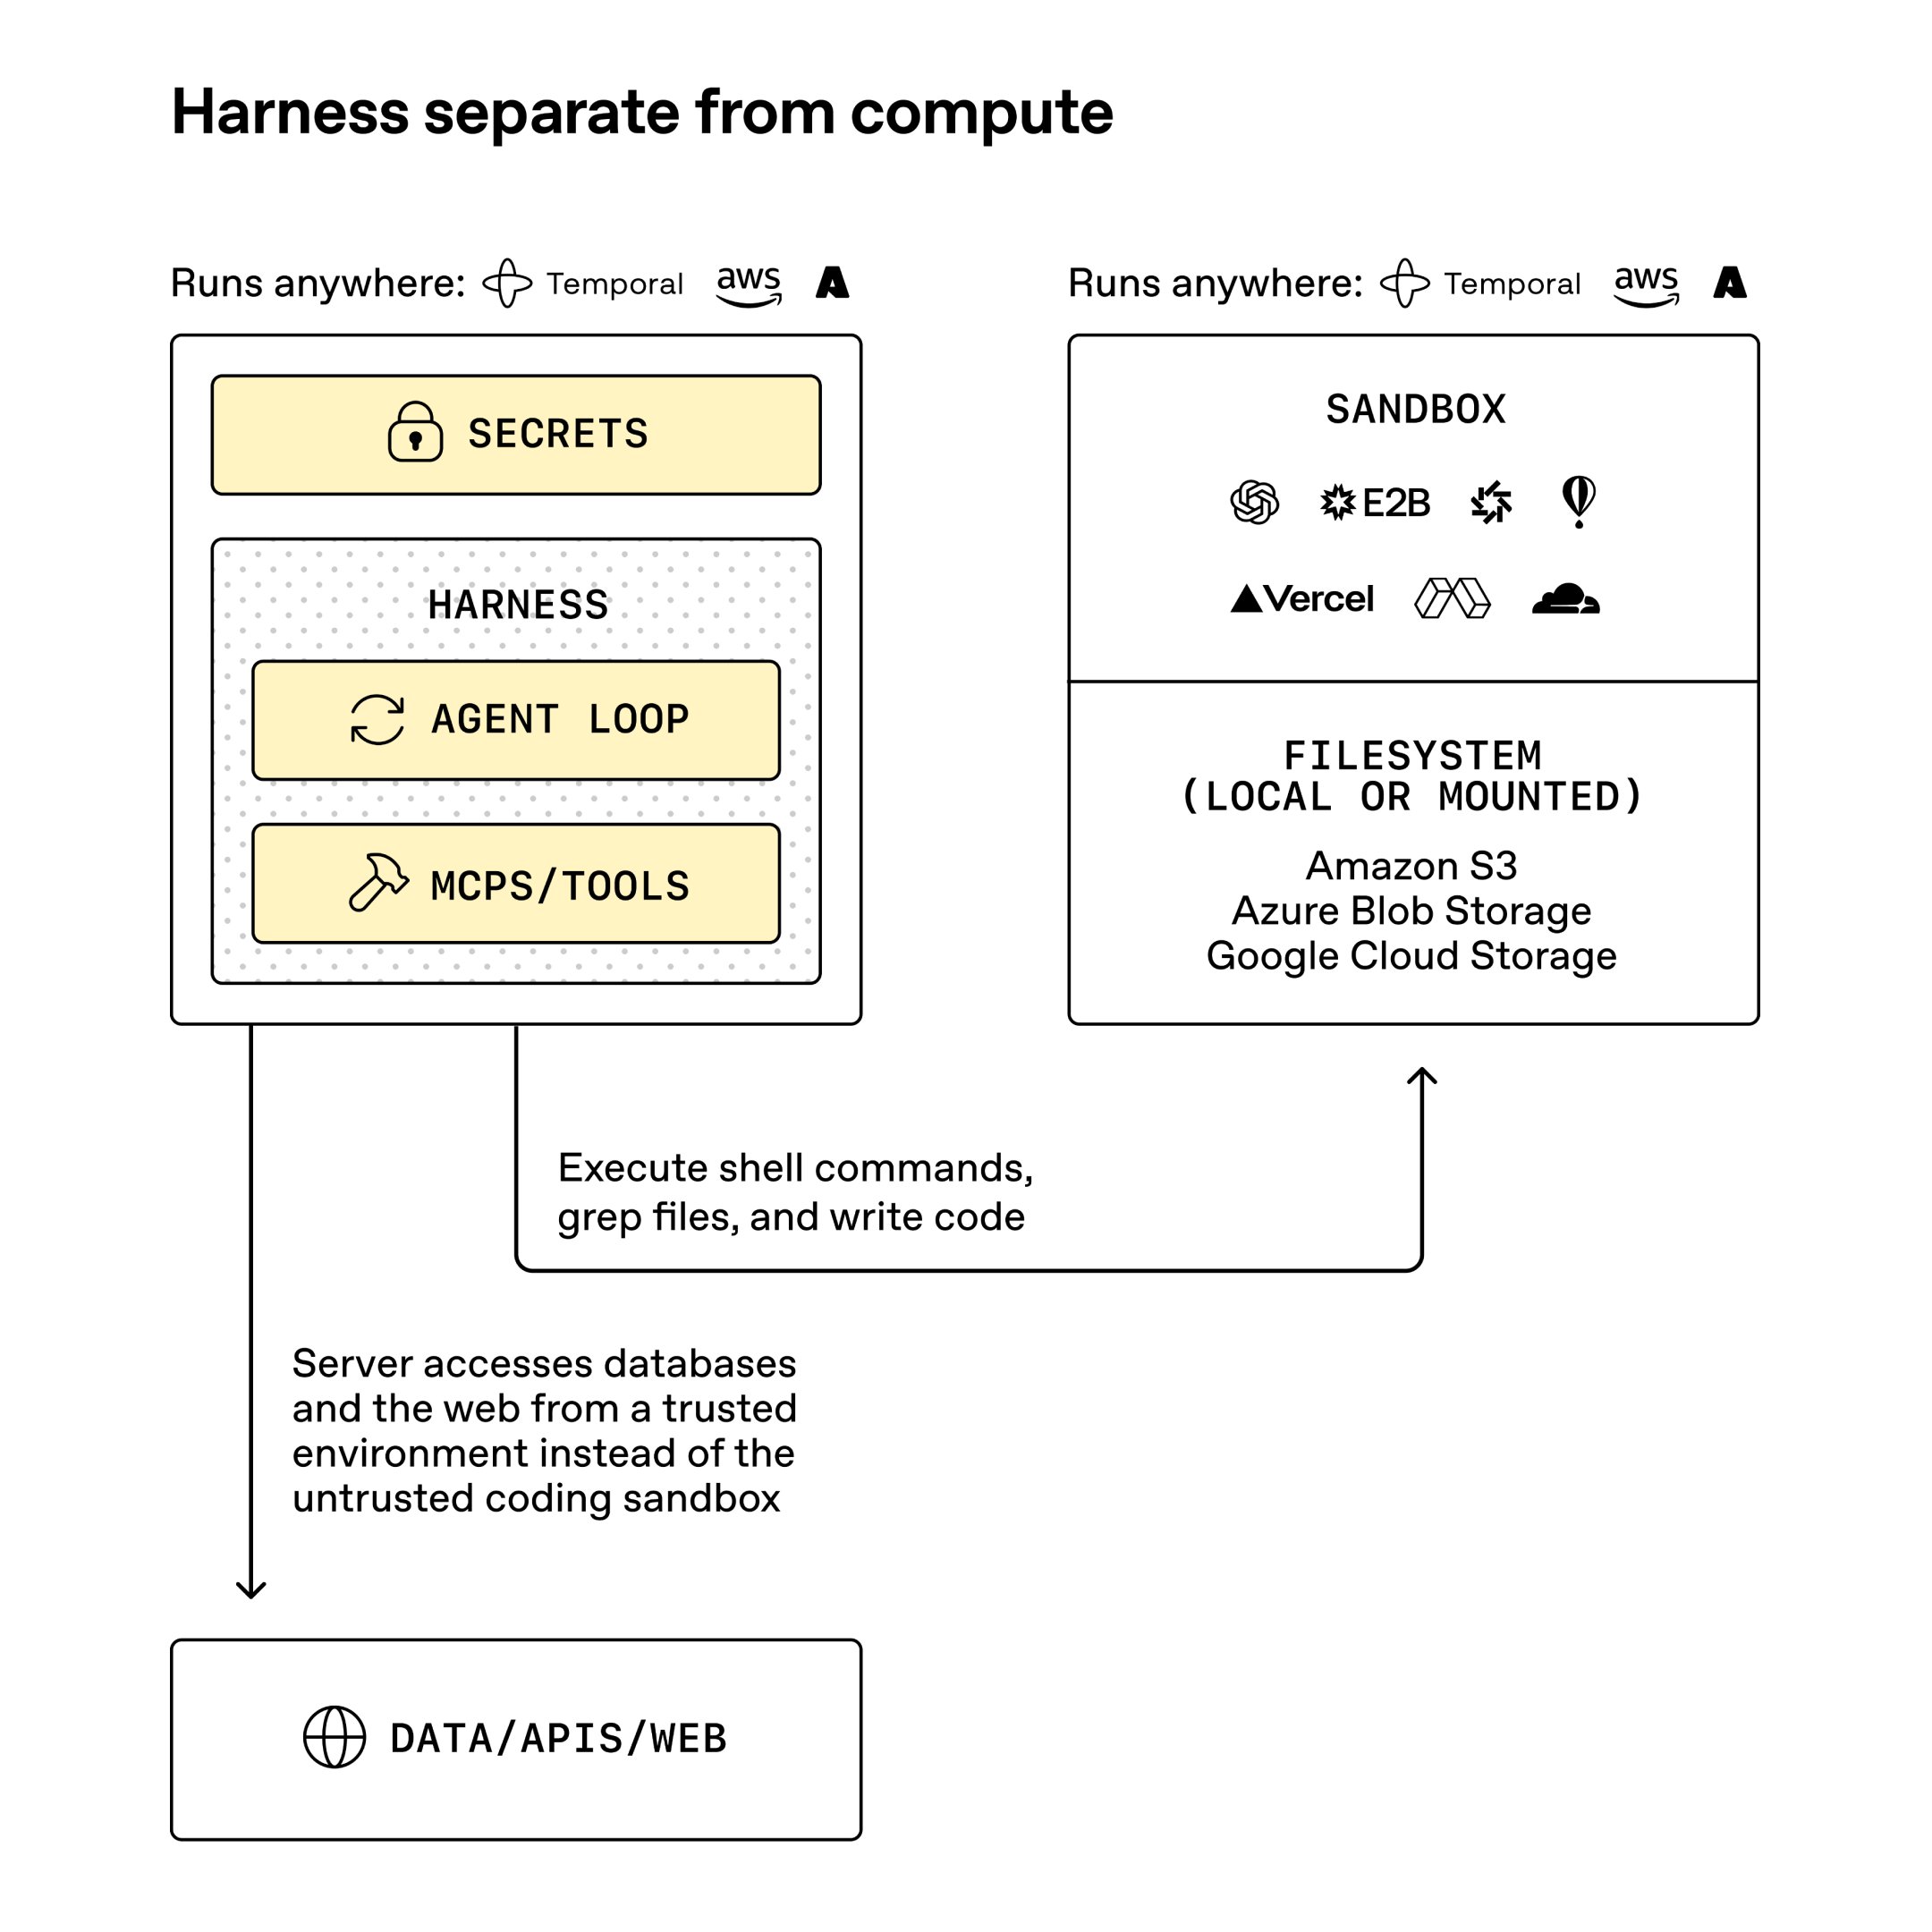
文章详细解读了 OpenAI Agents SDK 的新架构设计,即 Harness(可信层)与 Compute(计算层)分离模式。该架构将凭证管理与代码执行隔离,不仅解决了长时程 Agent 的安全与稳定性痛点,还实现了状态持久化、跨平台部署及简易审计,被视为企业级 Agent 开发的教科书级设计。
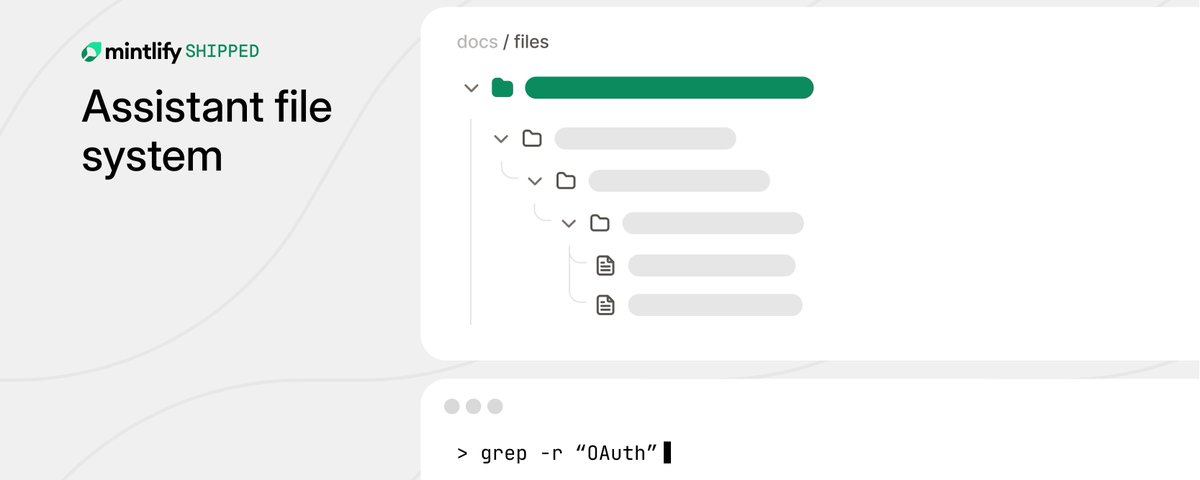
文章探讨了如何通过构建虚拟文件系统 ChromaFs 来优化 Mintlify 的 AI 文档助手。作者指出传统的沙箱克隆方案存在高延迟(约 46 秒)和高成本(年费超 7 万美元)的问题。ChromaFs 通过拦截 Unix 命令并将其转换为 Chroma 数据库查询,实现了零边际计算成本和毫秒级的会话启动速度。文章详细介绍了 ChromaFs 的架构、目录树引导、权限控制、分块重组以及针对 grep 命令的优化策略。
本文基于对 ShareAI 创始人新璐的访谈,深入解读了 Agent Harness 的核心概念与架构设计。文章指出,Harness 是模型之外赋予 AI 行动能力、记忆与协作能力的“身体”。通过剖析 Claude Code 的三层结构——执行层、记忆层与治理层,作者阐述了从“流程驱动”向“模型自主决策”转变的工程实践。文章强调,优秀的 Harness 应提供类 UNIX 的稳定环境与结构化的记忆机制,从而释放模型的潜能,使其成为真正的智能合作伙伴。
文章探讨了如何构建可组合、安全且可维护的企业级 AI 代理系统。作者提出了一种三层架构:Skills(可复用的领域专业知识)、Agents(具有身份和工作流编排能力的协调者)和 MCP(数据连接层)。文章详细阐述了技能的“单一来源”编写原则、代理的标准化提示词模板(包含身份、交付物、工作流和护栏),以及如何通过明确的职责分离来实现系统的独立演化与安全管控。
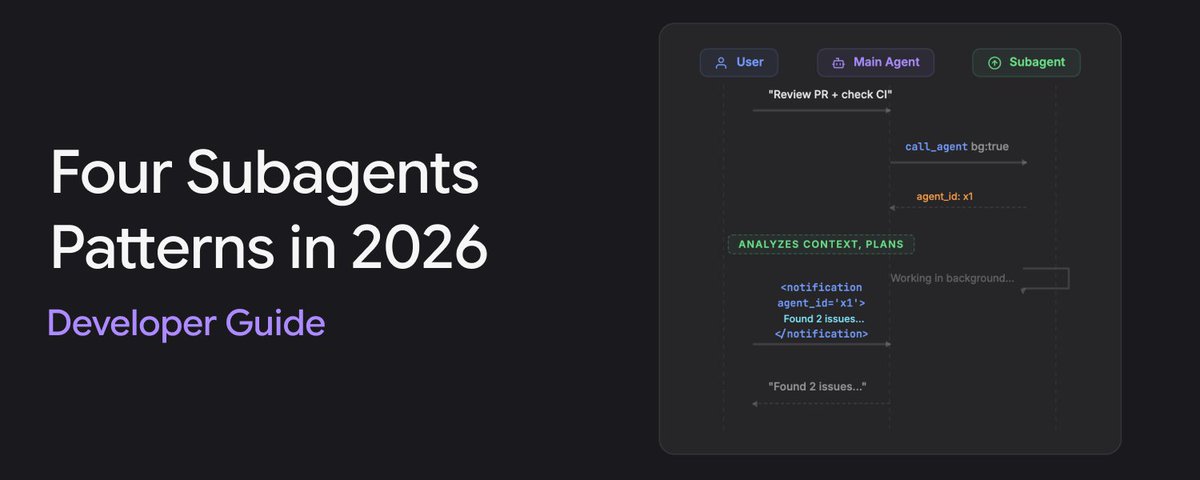
文章探讨了2026年主智能体管理子智能体的四种模式,按控制权递增排序:内联工具、并行分发、消息池和编排。这些模式包括简单的函数调用、并发任务生成、持久化有状态的消息通信以及全面的生命周期控制,分别适用于从简单的代码审查到复杂的多步骤协作工作流。
文章回顾了作者 Kevin Fischer 四年来探索赋予 AI“灵魂”的旅程。他批评了当前业界只追求智能的竞赛,提出真正重要的是“临场感”。通过构建名为 Spark 的数字金毛犬,并采用类似“傀儡师”的远程操控技术进行家庭实验,作者发现建立情感联结的关键不在于复杂的对话,而在于“被关注”的感觉。技术实现上,Spark 摒弃了单一模型,采用了包含视觉、情感、预测等多个协作 Agent 的架构,模拟人类意识涌现的过程。
本文深入探讨了“Model-Harness-Fit”(模型与协作框架的适配)这一概念。作者通过对比 Codex、Claude Code 和 GitHub Copilot SDK,指出模型在训练后与特定的工具界面、内存协议和规划机制深度绑定。仅更换模型而保留通用框架会导致性能显著下降。文章强调,模型本身的权重不再是唯一的护城河,与其配套的整个工程堆栈才是关键。
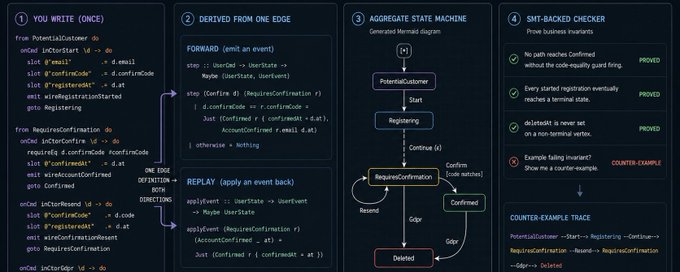
文章介绍了一种基于函数式事件溯源(Functional Event Sourcing)的库,旨在让业务逻辑 Bug 在结构上不可能发生。作者通过定义可组合的状态机,在类型层统一描述状态转换,自动生成决策逻辑和演化逻辑,从而避免两者不一致。此外,该库还能自动生成 Mermaid 流程图,并利用 SMT 求解器验证业务不变性,大幅提升代码的健壮性和可维护性。
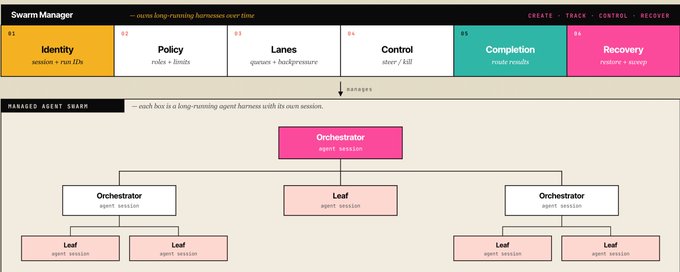
文章探讨了 AI 领域从单一 Agent 向 Agent Swarm(集群)演进的必然趋势,指出真正的挑战在于如何管理长期运行的子 Agent,而非简单的任务委托。作者通过对比 Hermes 和 OpenClaw 等系统,提出了 Swarm Manager 的核心架构要求:统一的身份识别(ID 与 Run ID)、基于事件推送的完成机制、基于队列的并发控制以及包含“转向”在内的全生命周期管理能力。
文章介绍了 Fleet-RLM(基于 DSPy ReAct 智能体与 Daytona 沙箱)在 100 个长程推理任务中的表现。实验对比了递归执行与直接 LLM 推理,结果显示递归执行将准确率从 13% 提升至 33%,并完全消除了任务失败。文章详细分析了逻辑、CS、棋类、数学和化学等不同领域的性能差异,揭示了递归架构在工具调用和错误恢复上的优势。
文章指出 AI 领域正发生范式转移:模型不再是产品核心,Agent Harness(控制框架)才是。LangChain 等团队通过优化 Harness,在不改变底层模型的情况下显著提升了性能。随着模型能力的趋同和商品化,竞争壁垒已转移到包含工具调度、上下文管理、沙箱和评估逻辑的工程化框架上。作者建议企业应从单纯的 Agent 开发转向定制化 Harness 的构建,以实现真正的产品化落地。
本文探讨了多 Agent 协作系统中的架构设计问题。作者对比了基于 IPC 的“任务板”模式与自研的“文件协议+状态机”模式,阐述了为何选择文件系统作为任务真理源以实现跨 Session 的可恢复性与可审计性。文章提出了一种混合架构,利用 IPC 处理高频进程心跳,同时保留文件层作为核心状态与证据链的存储,最终实现了稳定、解耦且支持异步长任务的自动工程流。
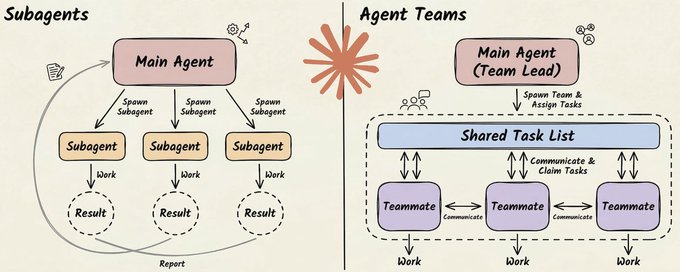
文章深入探讨了 Claude 中的两种多智能体范式:Sub-agents 和 Agent Teams。Sub-agents 类似于独立上下文的临时工,适合并行处理孤立任务;而 Agent Teams 是持久化的协作团队,通过共享状态和直接通信解决复杂协调问题。文章建议根据任务所需的上下文依赖性选择架构,并介绍了五种主要的编排模式,强调应基于上下文而非角色来拆分任务。
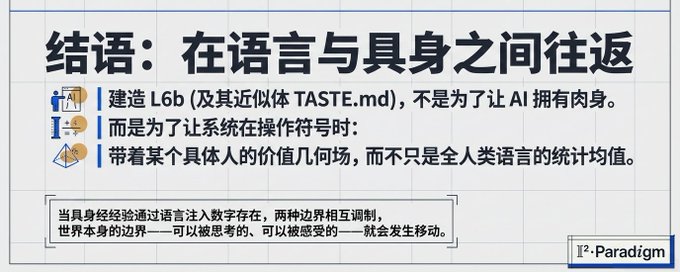
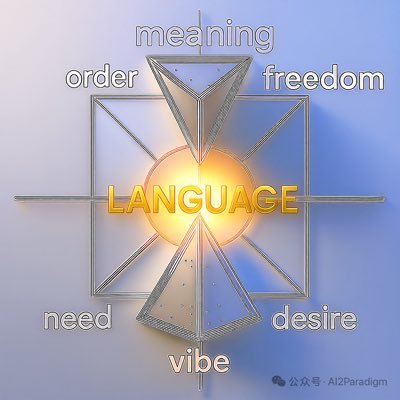
文章续接《Speech Living Beings》,从认知科学视角剖析 AGI 的五条路径。作者将新皮层的六层结构映射到 AI 架构,指出 LLM 对应 L4(语义误差),Representation Bet 对应 L2/3(表征),而 L6b(价值调制层)在当前 AI 中完全缺失。文章引入鲍德里亚的符号学理论,论证 LLM 的语言工业化导致具身价值断裂,并指出当前的 Memory 工程问题本质上是 L6b 层价值选择机制的缺失。
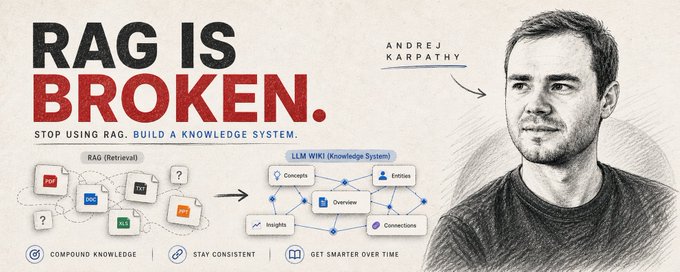
文章批判了当前主流的 RAG(检索增强生成)模式无法积累知识的局限性,并介绍了 Andrej Karpathy 提出的 LLM Wiki 范式。该模式主张让 LLM 维护一个动态的结构化知识库(Wiki),在数据摄入时进行编译和整合,而非在查询时临时检索。这种方法通过将繁琐的维护工作交给 LLM,实现了知识的复利增长和自我进化,解决了传统知识管理系统中维护成本高昂的痛点。