Wiki 知识库

全部文档 / 标签: LLM 推理

13 篇
清除

手把手带你解锁 N 卡隐藏算力(Linux|RTX 30 系部分型号、4090、4070 Ti SUPER)

作者分享了 Linux 下使用 gpu-unlock 项目解锁 NVIDIA 显卡 Tensor Core 算力限制的实践。该项目通过在驱动加载前修改控制运算速度的寄存器,解除 FP16/BF16 输入、FP32 累加运算的限速。作者在 RTX 4070 Ti SUPER 上用 Codex 辅助完成兼容性检查、编译模块、创建实验启动项和断电重启等步骤,实测 8192×8192 矩阵 FP16 乘法耗时从 12.15ms 降至 6.49ms,吞吐接近翻倍至约 190 TFLOPS,且数值校验通过。社区反馈该解锁可使本地大模型 prefill 提速 30%–50%,decode 速度基本不变。

技术 › 工具与效率 铁锤人 2026-10-259.3 KB 57.9K 105 83

Karpathy的本地LLM加速技巧终于有了完整解决方案:Uzu推理引擎

文章回顾了Karpathy在2023年指出的本地LLM推理瓶颈:解码阶段受限于内存带宽,每次前向传播只生成一个token,使得推理速度存在硬上限。以M5芯片和4-bit Qwen3.5 9B为例,理论极限约29 token/s,llama.cpp和MLX接近该上限。开源推理引擎Uzu通过组合优化突破瓶颈:采用4-bit/8-bit整数量化降低内存流量,利用M5的int8硬件加速路径,在量化前应用块对角随机Hadamard变换抑制离群值误差,并通过推测解码一次性验证多达16个草稿token。实测Uzu在M5上达到92-117 token/s,显著超越llama.cpp和MLX。

技术 › LLM Akshay 2026-10-0928.4 KB 115.2K 257 78

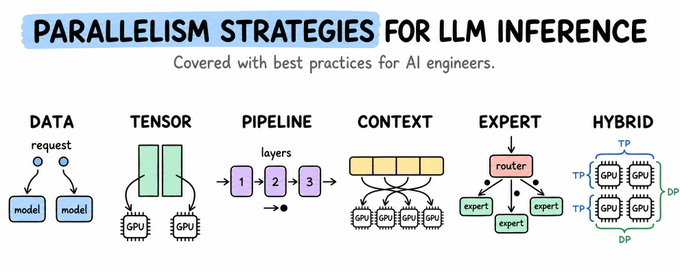
Parallelism strategies for LLM inference, clearly explained

本文系统讲解了 LLM 推理的多 GPU 并行策略。首先介绍推理的两个阶段(Prefill 影响 TTFT,Decode 影响 TPOT)以及部署中的四大资源限制(参数内存、KV-cache、计算、通信),然后通过五个关键问题框架分析各类并行策略:数据并行(复制完整模型、分区请求)、张量并行、流水线并行、上下文并行和专家并行。文章强调选择布局需权衡内存容量、请求延迟和吞吐量,避免通信开销超过硬件承受能力,并给出部署检查规则,帮助读者根据模型、硬件拓扑和工作负载选出合适的布局。

技术 › LLM Avi Chawla 2026-10-0629.4 KB 29.4K 178 82

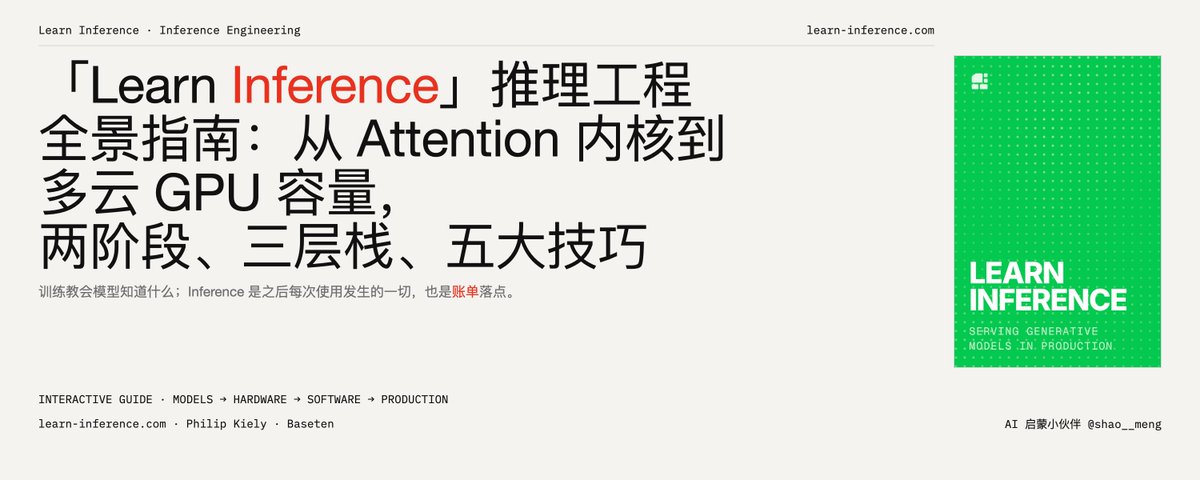
「Learn Inference」LLM 推理工程全景指南:从 Attention 内核到多云 GPU 容量,两阶段、三层栈、五大技巧

本文是 Philip Kiely 所著《Inference Engineering》的交互式伴读站点介绍,系统梳理 LLM 推理工程全貌。文章以 prefill/decode 两阶段为原子结构,按运行时、基础设施、工具链三层展开,逐章讲解模型结构(Attention、KV 缓存、MoE)、GPU 硬件选型(带宽 vs 算力)、软件栈(vLLM、SGLang、TensorRT-LLM)、五大优化技巧(量化、投机解码、缓存、并行、解耦)以及多模态与生产实践(扩缩容、路由、成本、可观测性)。核心思想是:先诊断瓶颈再优化,一切优化皆是权衡,具体知识会过期而底层约束移动缓慢。

技术 › LLM meng shao 2026-09-2918.6 KB 3.4K 11 86

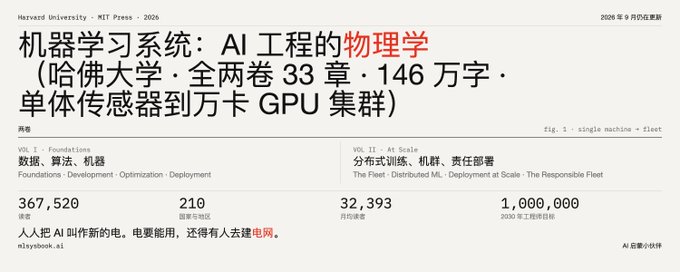
机器学习系统:AI 工程的物理学(哈佛大学开源教材解读)

文章介绍了哈佛大学 Vijay Janapa Reddi 教授的开源教材《Machine Learning Systems: The Physics of AI Engineering》,两卷 33 章,旨在像 Hennessy & Patterson 的体系结构经典一样,将 ML 系统工程变为有定量定律的学科。全书以铁律、屋顶线模型、能耗阶梯、Amdahl 定律、漂移方程等核心定律组织内容:第一卷讲单机 ML 系统栈(数据、训练、压缩、硬件、服务、MLOps),第二卷讲集群规模化(分布式训练、3D 并行、容错、推理经济学、可持续 AI)。文章总结了书中'约束驱动''一切皆有价格''静默失败是默认模式'等核心世界观,并给出不同读者群体的阅读建议。

技术 › 后端 meng shao 2026-09-2817.0 KB 13.5K 125 84

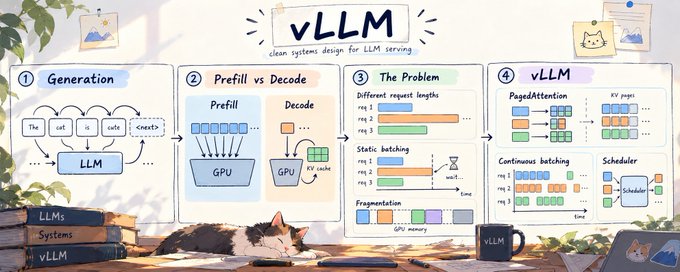
vLLM 架构之美:PagedAttention 与 Continuous Batching 解析

作者赞颂 vLLM 的软件设计之美。文章首先介绍 LLM 自回归生成的基本原理,以及推理的两个阶段:计算密集的 Prefill 和带宽受限的 Decode,指出 KV Cache 动态增长与静态批处理带来的内存浪费问题。vLLM 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并维护逻辑到物理的块表(PagedAttention),将内存浪费降至约 3%;配合 Continuous Batching 和动态调度,避免已完成的请求阻塞整个批次,让 GPU 始终保持高效。作者认为 vLLM 的成功源于借鉴已被大规模验证的成熟系统概念。

技术 › LLM Atharva 2026-09-275.1 KB 21K 401 56

LLM Inference Handbook 精读:Prefill、Decode、KV Cache,与一切皆权衡的推理工程

本文深度解读 Modular 公司开源维护的《LLM Inference Handbook》,系统梳理 LLM 推理工程的知识体系。文章提炼三大核心框架:prefill(算力受限)与 decode(带宽受限)的两阶段二分法;KV cache 作为系统中心约束的地位,围绕它的 PagedAttention、prefix caching、PD 分离等技术网络;以及“一切皆 trade-off,唯一方法论是 benchmark”的工程哲学。内容还涵盖 continuous batching、speculative decoding、GPU 内存金字塔、FlashAttention、量化与蒸馏三部曲、Agent 生态与部署运维等主题,强调推理优化的本质是围绕有状态 KV cache 做内存管理与调度。

技术 › LLM meng shao 2026-09-2218.3 KB 14.6K 139 84

CMP 170HX矿卡软件解锁:8GB显存解锁到64GB,价格涨三十倍的背后

NVIDIA专为挖矿打造的CMP 170HX矿卡,采用与A100相同的GA100芯片,但出厂通过OTP熔丝、寄存器和PCIe限制被锁死显存、算力和接口。2026年8月,研究员Jon Pry利用Falcon安全协处理器的固件校验时间窗口漏洞,通过ROP链获取执行权并修改PLM寄存器,实现纯软件解锁,开源工具CMPUnlocker可将8GB显存解锁至64GB HBM2e。解锁后带宽媲美RTX 5090,跑LLM推理性能反超4090。MiniMax H3开源引发大显存需求暴涨,卡价从三五百涨至1.4万。但文章也提醒风险:无FP8、无NVLink、驱动受限、HBM颗粒不可维修、价格窗口已关闭。

技术 › LLM huangserva 2026-09-159.2 KB 20.3K 38 81

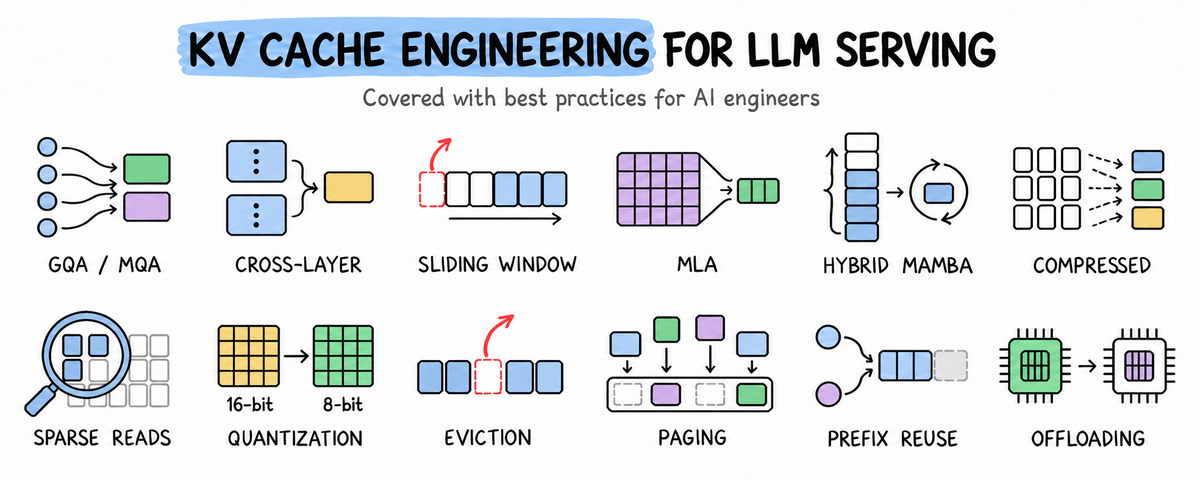
KV Cache Engineering for LLM Serving, clearly explained

文章系统讲解了LLM推理中KV缓存的工程优化。KV缓存随序列长度增长,Llama 3.1 70B单条128K序列的BF16缓存约需40GB,成为GPU内存和注意力计算的双重瓶颈。作者将12种优化技术按减少的对象分类:GQA/MQA减少KV头数量,跨层注意力减少缓存层数,滑动窗口与淘汰减少保留token数,MLA减少表示宽度,量化减少字节数,混合循环层用固定状态替代增长缓存,分页与前缀复用减少分配浪费。文章配有可运行代码示例,并分析各技术的适用场景与权衡。

技术 › LLM Avi Chawla 2026-09-0640.4 KB 206.5K 557 82

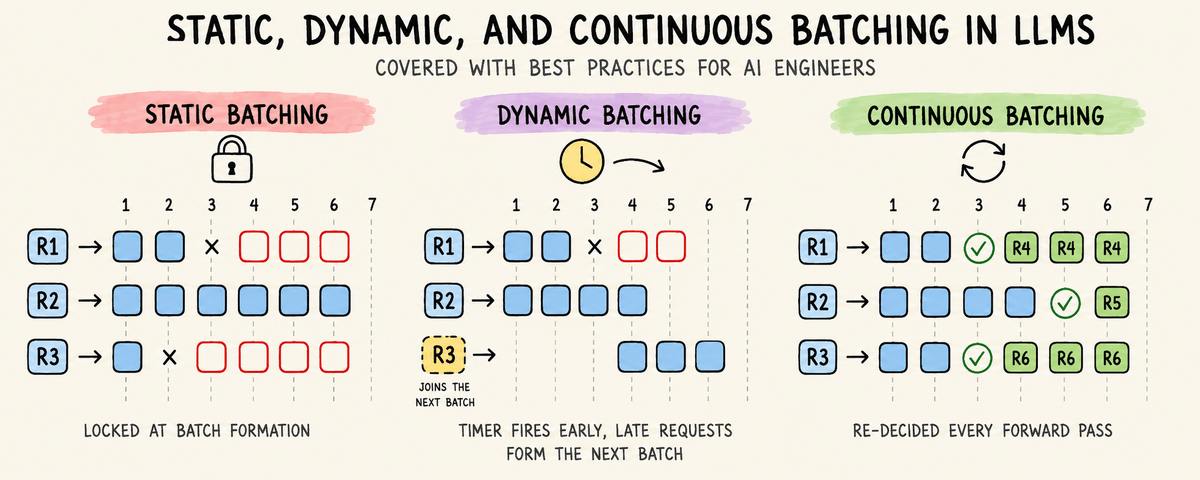
Static vs. Dynamic vs. Continuous Batching in LLMs, clearly explained

文章从第一性原理剖析了 LLM 推理服务中三种批处理策略。现代 GPU 在 LLM 解码时受显存带宽限制,计算单元大量空闲,批处理可将权重读取成本分摊到多个序列以提升吞吐。由于自回归解码的输出长度不可知、序列间相互依赖,传统批处理存在短板:静态批处理在批开始时一次决定,受最慢成员拖累;动态批处理加入定时器,缓解入批等待但仍整批绑定;连续批处理(iteration-level scheduling)在每次前向传播后重新调度,完成的序列立即让位给排队请求,是现代推理引擎高吞吐的关键。文章还讨论了固定输出场景下静态批处理的适用性,并给出 vLLM 和 Triton 的配置示例。

技术 › LLM Akshay 2026-09-0112.8 KB 57.2K 285 78

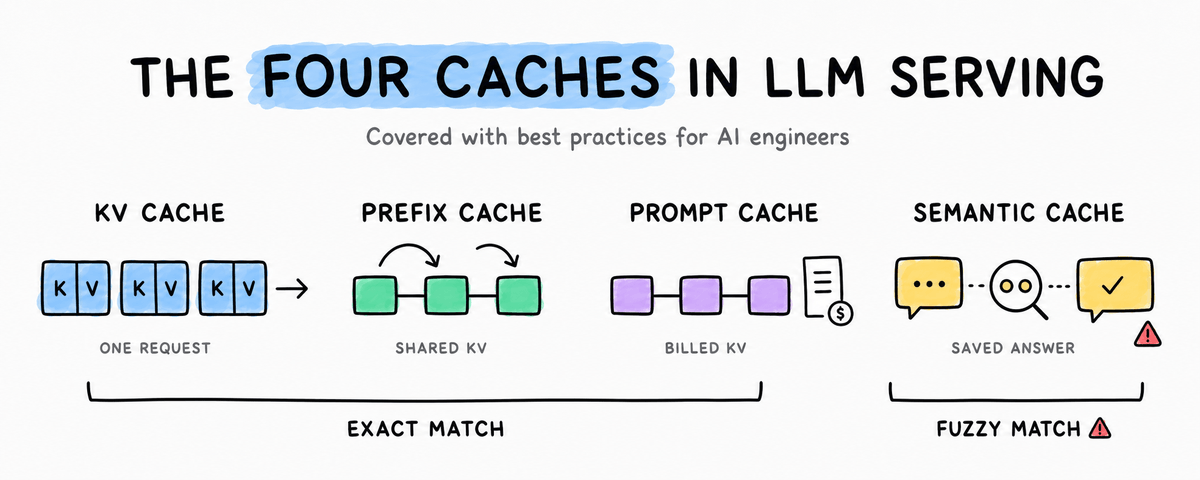
LLM 中的 KV Cache、Prefix Cache、Prompt Cache 与 Semantic Cache 详解

文章系统讲解了 LLM 推理中四层常被混淆的缓存机制:KV cache 存储单次请求的注意力张量;Prefix caching 在服务端以 token ID 哈希链为键复用这些张量;Prompt caching 是服务商对该查找的计费版本;Semantic cache 则以嵌入向量的余弦相似度为键存储完整响应。前三层为精确匹配、不影响正确性,未命中只损失延迟和费用;第四层为模糊匹配,可能返回错误答案。文章基于 transformers v5 提供可运行代码示例,涵盖缓存增长、内存带宽瓶颈、GQA/MLA/量化等优化手段,以及阻碍缓存复用的五类常见问题。

技术 › LLM Avi Chawla 2026-08-2833.6 KB 1.7M 1.4K 85

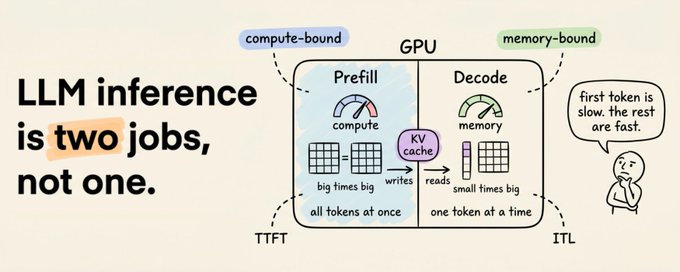
LLM 推理原理:从 Prompt 到流式响应的全流程解析

文章深入剖析了大语言模型(LLM)的推理过程。首先介绍了文本如何通过分词和嵌入转换为向量,接着详细解释了 Transformer 层中的自注意力机制与前馈网络如何协同工作。文章重点揭示了推理过程的两个不同阶段:处理输入时的“预填充”阶段受算力限制,而生成输出时的“解码”阶段受内存带宽限制,这种性能差异导致了首个token与后续token生成速度的不同。

技术 › LLM Akshay 2026-05-0313.8 KB 352.5K 849 71

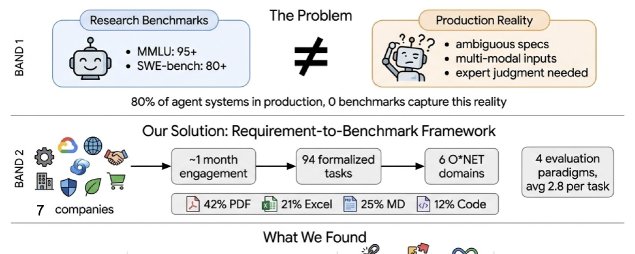
本周顶级 AI 论文选读:自动化研究员、长周期 Agent 评估与 Nemotron 模型

本周重点关注四大 AI 进展:Anthropic 展示 Claude 可进行全自动化对齐研究,成本仅 1.8 万美元且表现接近完美;AiScientist 提出基于文件系统的长周期工程架构;AlphaEval 揭露了 Agent 从研究到生产环境的巨大鸿沟;NVIDIA 发布开源 120B 参数模型 Nemotron 3 Super,采用混合 MoE 架构优化推理吞吐。

技术 › LLM DAIR.AI 2026-04-2033.8 KB 57.2K 168 82