Wiki 知识库

全部文档 / 作者: 实践哥MinLi

22 篇
清除

自己动手做LoRA 从 0 到 1 实战

作者详细记录了从零开始训练一个专属人物 LoRA 的完整实战流程。他使用 GPT Image 2 生成 56 张虚构人物训练数据,基于开源模型 MOSS-Image(5B 参数 Diffusion Transformer)进行微调,仅用一张 RTX 4090 训练约 65 分钟即获得稳定的人物形象生成能力。文章涵盖数据准备、Caption 标注、Checkpoint 选择、效果验收等关键环节,并指出了过拟合等常见问题。作者将整个流程开源到 GitHub,提供运行环境镜像、Jupyter Notebook 和 ComfyUI 工作流,建议初学者亲手跑一遍以真正理解 LoRA 训练原理,一通百通。

技术 › LLM 实践哥 Li 2026-10-2613.5 KB 3.3K 32 81

Open-Science 实战:从个人 Bot 到科研 Agent

作者使用 AIPOCH Open-Science 科研工作台,基于 HHMI Janelia 与 Google Research 开放的果蝇中枢神经系统连接组数据(16.7 万神经元、0.12B 突触),尝试训练生物大脑模型解三阶魔方。文章详述了搭建实验环境、定义信号传递规则、设计输入输出(324 个颜色开关与 93 个前腿运动神经元)、多卡并行训练的全过程。单步动作准确率从 6.39% 提升至 64.86%,结合 Beam Search 后未见状态还原率大幅提高。作者展示了从找论文、追数据、训练到评测的完整科研流程均在 Open-Science 中完成,倡导 Vibe Research 时代的到来。

技术 › Agent 实践哥 Li 2026-10-1612.3 KB 99.3K 108 85

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍了如何借助Strata框架和Agent自动化流程,在12GB消费级显卡上部署125B参数的MoE模型Qwen3.8-Flash-Next。文章解释了MoE稀疏激活(每token仅激活6B)与Strata让GPU、CPU、RAM、SSD协同工作的原理,对比了不同量化方案(UD-IQ4_XS与UD-Q4_K_XL)在专家缓存命中率上的速度差异。作者全程使用蚂蚁的Ling-3.1-flash Agent完成从读文档、检查硬件、安装、排错到测速验收的部署流程,并成功将本地模型接入pi。该方法可复用于部署Ling、GLM、Kimi、DeepSeek等其他本地模型。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 159.4K 454 79

12G显存部署125B Qwen3.8-Flash-Next 全攻略

本文介绍如何在12GB显存上部署125B参数的Qwen3.8-Flash-Next模型。核心是Strata技术让GPU、CPU、RAM和SSD协同工作:常用专家留GPU,其余放RAM,CPU处理cache miss。RTX 5070 12GB + 64GB RAM在Q2_0量化下短对话可达94 tok/s。文章还讲解了量化选择策略——显存占用相同时速度可差1.72倍,关键在于专家命中率。作者全程使用蚂蚁的Ling-3.1-flash Agent自动完成从检查机器、选权重、下载安装到排错验收的完整部署流程,跑通了一套用Agent自动部署本地模型的可复用方法。

技术 › LLM 实践哥 Li 2026-10-087.4 KB 79

猎奇 Qwen-Image-2.1 NSFW 详细测试

作者对 Qwen-Image-2.1 模型的 NSFW 能力进行了 375 张生成与编辑测试,发现该模型没有稳定的拒绝机制,几乎能生成任何风格的敏感内容。但细节质量差,易出现多肢体、末端粘连和关键区域糊掉等肢体幻觉问题。更意外的是,外部 NSFW 检测器漏检率高,且挑画风、挑主体,评估器比模型更容易翻车。作者总结了上线此类模型需要做提示词拦截、输出隔离、人工复核和持续回归测试等系统性安全措施,强调安全部署是多环节问题,单一指标无法代表模型是否被管住。

技术 › LLM 实践哥 Li 2026-09-288.4 KB 1.1M 809 79

万字长文:通宵评测Qwen-Image-2.1

作者在48GB的4090上对Qwen-Image-2.1进行了13组实验、196张图的深度评测。模型视觉生成为7B DiT架构,配Qwen3-VL编码指令与参考图,支持原生RGBA透明。评测发现其强项为中文排版、原生透明通道和多图身份保持,弱项是「替换」语义常退化为「添加」、编辑具有非局部性、缺乏时间维度建模。文章详细测试了文字渲染阈值、透明度真实性、指令遵循、编辑精度、多图参考及性能表现,并给出KV cache与显存的权衡策略。最后作者通过360°转台动画实验,揭示了条件图下seed敏感性等反直觉发现,定位其为关键帧生成器而非视频模型。

技术 › LLM 实践哥 Li 2026-09-2118.2 KB 525.6K 599 90

1分钟,开源模型原生支持移动端

作者分享通过UU远程的最新升级,让本地运行的开源大模型(如Qwen 27B)拥有了手机端入口。相比Codex远程控制只支持自家模型、Claude Code远程有封号风险,本地模型不花钱、不封号且速度快。UU远程基于tmux实现,支持完整TUI渲染、多终端会话、跨端接管和语音输入,且免费。作者还开源了uu-term-bridge工具,让iTerm2中的所有会话自动出现在手机列表,实现桌面与手机双向无缝切换,补齐了与Codex远程体验的差距。

技术 › 移动端 实践哥 Li 2026-09-067.0 KB 231.2K 110 74

最新Claude 防封号与申请虚拟卡订阅全指南

作者分享了一年多未被封号的Claude账号维护经验:核心原则是订阅区、节点、账单地址、银行卡保持同一国家(新加坡)。文中详解Claude Code与桌面客户端的代理配置差异,包括settings.json环境变量设置与TUN模式兜底方案。同时推荐新加坡支付平台Starryblu(MAS持牌机构WoTransfer旗下产品),介绍其注册、身份认证、选卡、入金(推荐香港FPS转数快)、出金全流程,并说明OCBC账户实为资金托管而非银行储户。最后讲解订阅Claude的正确顺序:先切新加坡节点验证IP,用无痕窗口登录,建议先开Pro再升级Max。文章提醒注意资金托管不含存款保险等风险。

技术 › Claude 实践哥MinLi 2026-08-3018.6 KB 112.3K 286 82

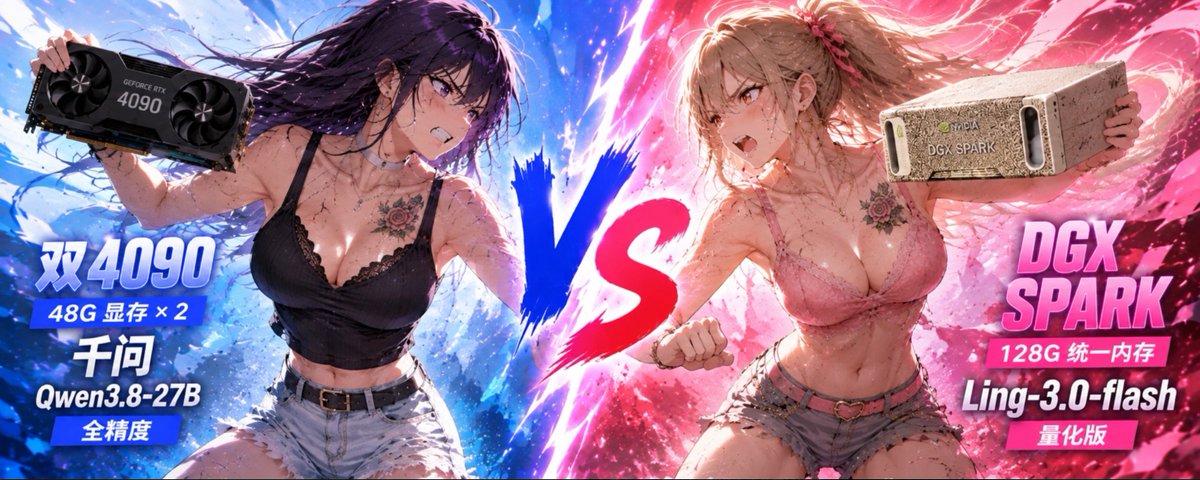
最强的矛与盾:本地部署大模型到底该买什么

本文对比 NVIDIA DGX Spark 与双 48G 魔改 RTX 4090 两台偏科硬件,测试 Qwen3.8-27B(Dense)与 Ling-3.0-flash(稀疏 MoE)四个组合的推理表现。作者详细讲解 Dense/MoE 区别、显存带宽与算力的关系、投机解码与 MTP 原理,并给出单会话速度、并发吞吐的实测数据。结论是 Spark 适合跑 MoE 或量化模型,双 4090 借助高带宽速度更快,Ling 在并发服务上吞吐约为 Qwen 的 2.4 倍,并给出选购建议。

技术 › LLM 实践哥MinLi 2026-08-1830.4 KB 298.1K 264 89

从 0 搭建口播视频(2):从数字人到营销视频,豆包飞书来帮你

本文是系列第二篇,详细介绍了从数字人到营销视频的搭建过程。作者先拆解了数字人视频的五个要素(形象、声音、口型、内容、环境),并对比了全本地链路(自拍素材、Qwen TTS、MuseTalk)与云端音画同出方案(Seedance)。文章重点展示了如何利用飞书多维表格和豆包工作任务,实现选题采集、主播库管理、脚本生成和视频出片的自动化工作流,并讨论了效果与可控性的取舍。最后,作者总结了核心经验:拆解要素、权衡效果与可控、沉淀资产表以实现复利。

技术 › 工具与效率 实践哥MinLi 2026-08-1215.2 KB 155.5K 212 83

Claude Code 动态工作流解析与实战指南

文章详细介绍了 Claude Code 的动态工作流功能,通过编写编排脚本运行数十到数百个并行 subagents,解决智能体偷懒、自我偏好和目标漂移问题。内容涵盖原理、与静态工作流的区别、分类执行、对抗验证等六种实用模式,以及在迁移重构、深度研究、代码审查等九类场景的落地应用。

技术 › Claude 实践哥MinLi 2026-06-0411.6 KB 222.5K 306 88

1 个 Skill 自动添加字幕,ByeBye 剪映会员

文章介绍了一种利用 Claude/Codex Skill 技术结合 Whisper 和 ffmpeg 实现本地化视频自动加字幕的方法。该方法通过将听写、校对翻译和烧录三个步骤拆分,利用 LLM 的纠错能力解决了传统软件(如剪映)识别不准和需手动修改的痛点,实现了免费、高准确率和全自动化的字幕制作流程。

技术 › Skill 实践哥MinLi 2026-05-309.3 KB 94.8K 313 92

一文看懂怎么在 X 持续写作涨粉

文章将写作视为工程问题,拆解为一套可重复的流程。核心方法论包括:选题应从个人爱好与工作中挖掘,并利用热点关键词叠加;受众定位应选择前1%的专业认知服务99%的泛人群;写作要符合X平台的移动端与转发逻辑;最重要的技巧是“写完不马上发”,通过冷却期降低后悔率,并利用AI Skill辅助审稿润色。

技术 › 工具与效率 实践哥MinLi 2026-04-299.5 KB 60.9K 344 76

用好NotebookLM立省80%Token

文章介绍了一种通过结合 NotebookLM 与 Claude 来大幅降低 Token 消耗的工作流。作者指出直接将海量数据(如 50 篇论文)塞进 Claude 对话极其昂贵且效率低下,而利用 NotebookLM 作为免费的“老师”进行语料存储和检索,让 Claude 仅负责推理与编排,可实现 17 倍以上的成本节省。文中详细解析了 RAG 与 Context 的成本差异、Prompt Cache 的局限性,并提供了针对学术论文、招股书阅读及个人知识库的具体操作指南。

技术 › 工具与效率 实践哥MinLi 2026-04-2117.4 KB 817.8K 1.6K 88

搞懂缓存机制,从Gemma4到Claude Code省80%Token

本文通过本地实验与源码分析,深入解析了大模型的 KV 缓存机制。作者从 Transformer 注意力机制讲起,解释了为何多轮对话会出现 100 倍的加速差异。通过逆向 Claude Code,揭示了 Anthropic 精密的缓存工程策略(前缀匹配、TTL 机制)。最后,给出了具体的 Claude Code 使用姿势(如保护缓存前缀、避免切换模型),帮助用户将 Token 消耗降低 80%,实现同样的套餐多干 3-5 倍的活。

技术 › Claude 实践哥MinLi 2026-04-2011.6 KB 656K 1.6K 93

用好NotebookLM立省80%Token

文章指出直接将大量语料塞入Claude对话会导致Token消耗巨大且缓存利用率低。作者提出了一种优化方案:利用NotebookLM作为“老师”进行免费的知识库检索和带引用问答,仅将检索结果提供给Claude进行推理和编排。实测表明,该方案在研究、打新和知识库场景下可节省大量成本,但响应速度会降低。

技术 › 工具与效率 实践哥MinLi 2026-04-2017.1 KB 87

搞懂缓存机制,从Gemma4到Claude Code省80%Token

文章通过本地 Gemma4 实验发现大模型对话中存在 100 倍加速的现象,深入剖析了 Transformer 的 KV 缓存原理,并逆向分析了 Claude Code 的精密缓存工程。文章解释了为何连续对话比频繁开启新 Session 更省钱,指出破坏缓存的关键行为(如切换模型、修改 System Prompt),并提供了保护缓存以节省 80% Token 的具体使用姿势。

技术 › LLM 实践哥MinLi 2026-04-0711.3 KB 93

8 个 Claude Code Hooks 实战:从防误删到自动提交

文章介绍了通过 Claude Code Hooks 来解决 AI 辅助编程中的痛点。作者分享了 8 个实用 Hook,涵盖代码格式化、危险命令拦截、敏感文件保护、自动化测试、Lint 检查及审计日志等。这些配置能将被动检查转为自动化流程,显著提升代码质量与安全性。

技术 › Claude Code 实践哥MinLi 2026-04-057.7 KB 54.1K 181 83

你搭的 Claude Skills,还能提升10倍效果——使用Karpathy 的 autoresearch 方法

本文介绍了基于 Andrej Karpathy 的 autoresearch 方法,通过建立评估 Checklist 和自动迭代循环,让 AI Agent 自动优化 Claude Skills。作者分享了将落地页文案 skill 通过率从 56% 提升至 92% 的实战案例,该方法同样适用于网站优化、邮件撰写等任何可量化的工作流。

技术 › Agent 实践哥MinLi 2026-03-2112.1 KB 508.2K 774 83

零代码克隆纳瓦尔数字分身保姆级教程

本文是一份详尽的零代码教程,指导如何利用 NotebookLM 和 Gemini 构建纳瓦尔的 AI 数字分身。全流程无需编程,涵盖了使用 Deep Research 寻找数据源、通过网页源码提取链接、利用 NotebookLM 搭建静态知识库(RAG),以及通过 Gemini 注入个性化灵魂并设置 System Prompt 的完整步骤。文末还提供了具体的验证测试用例及现成的资源包。

技术 › Agent 实践哥MinLi 2026-02-198.1 KB 356.7K 1K 90

保姆教程:用 Gemini + NotebookLM 打造你的24h首席AI顾问

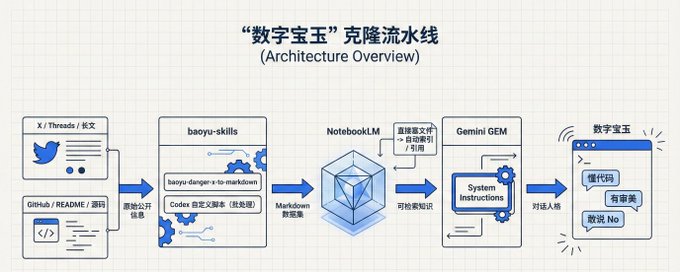
文章介绍了一种利用 AI 工具克隆特定人物数字分身的“保姆级”教程。作者以克隆技术大 V“宝玉”为例,展示了如何使用 baoyu-skills 抓取公开数据,利用 NotebookLM 进行 RAG(检索增强生成)以构建知识库,最后通过 Gemini 创建 GEM 并注入特定的 System Instructions。测试表明,该数字分身成功复刻了原作者的工程审美与批判性思维。

技术 › Agent 实践哥MinLi 2026-02-144.3 KB 232.8K 742 81