发推一年:从0到5万粉丝、赚50万+的复盘
05后大学生博主余温复盘发推一周年:粉丝近5万,直接和间接收入超50万,提前一年实现毕业前年入百万的目标。收益来自商单、返佣、社群咨询及AI落地业务等。作者分享了四点心得:把自媒体当业务来经营、到真实业务中用AI赚钱、不轻视任何拿到结果的人、大胆持续发布并不断校正方向。文章兼具个人成长记录与自媒体变现方法论。
05后大学生博主余温复盘发推一周年:粉丝近5万,直接和间接收入超50万,提前一年实现毕业前年入百万的目标。收益来自商单、返佣、社群咨询及AI落地业务等。作者分享了四点心得:把自媒体当业务来经营、到真实业务中用AI赚钱、不轻视任何拿到结果的人、大胆持续发布并不断校正方向。文章兼具个人成长记录与自媒体变现方法论。
作者分享用 AI 智能体工作流制作热点深度长视频的实操复盘:3 天涨粉 9149,总播放 258 万,单条最高 108 万。文章回顾了从模仿大号遇挫、车企热点短暂爆发到流量断崖的经历,以及关键的转折——抛弃固化的旧 Skill,让新模型自由发挥后画面匹配度大幅提升。作者总结了四大生产流水线(抓热点、审选题、跑生产、细核对)、选题内审五道安全阀(热点时效、人群普适、增量材料、情绪脱水、叙事轮换),并分享视频号、小红书、抖音、B 站等 8 个平台的分发体感与应对策略。
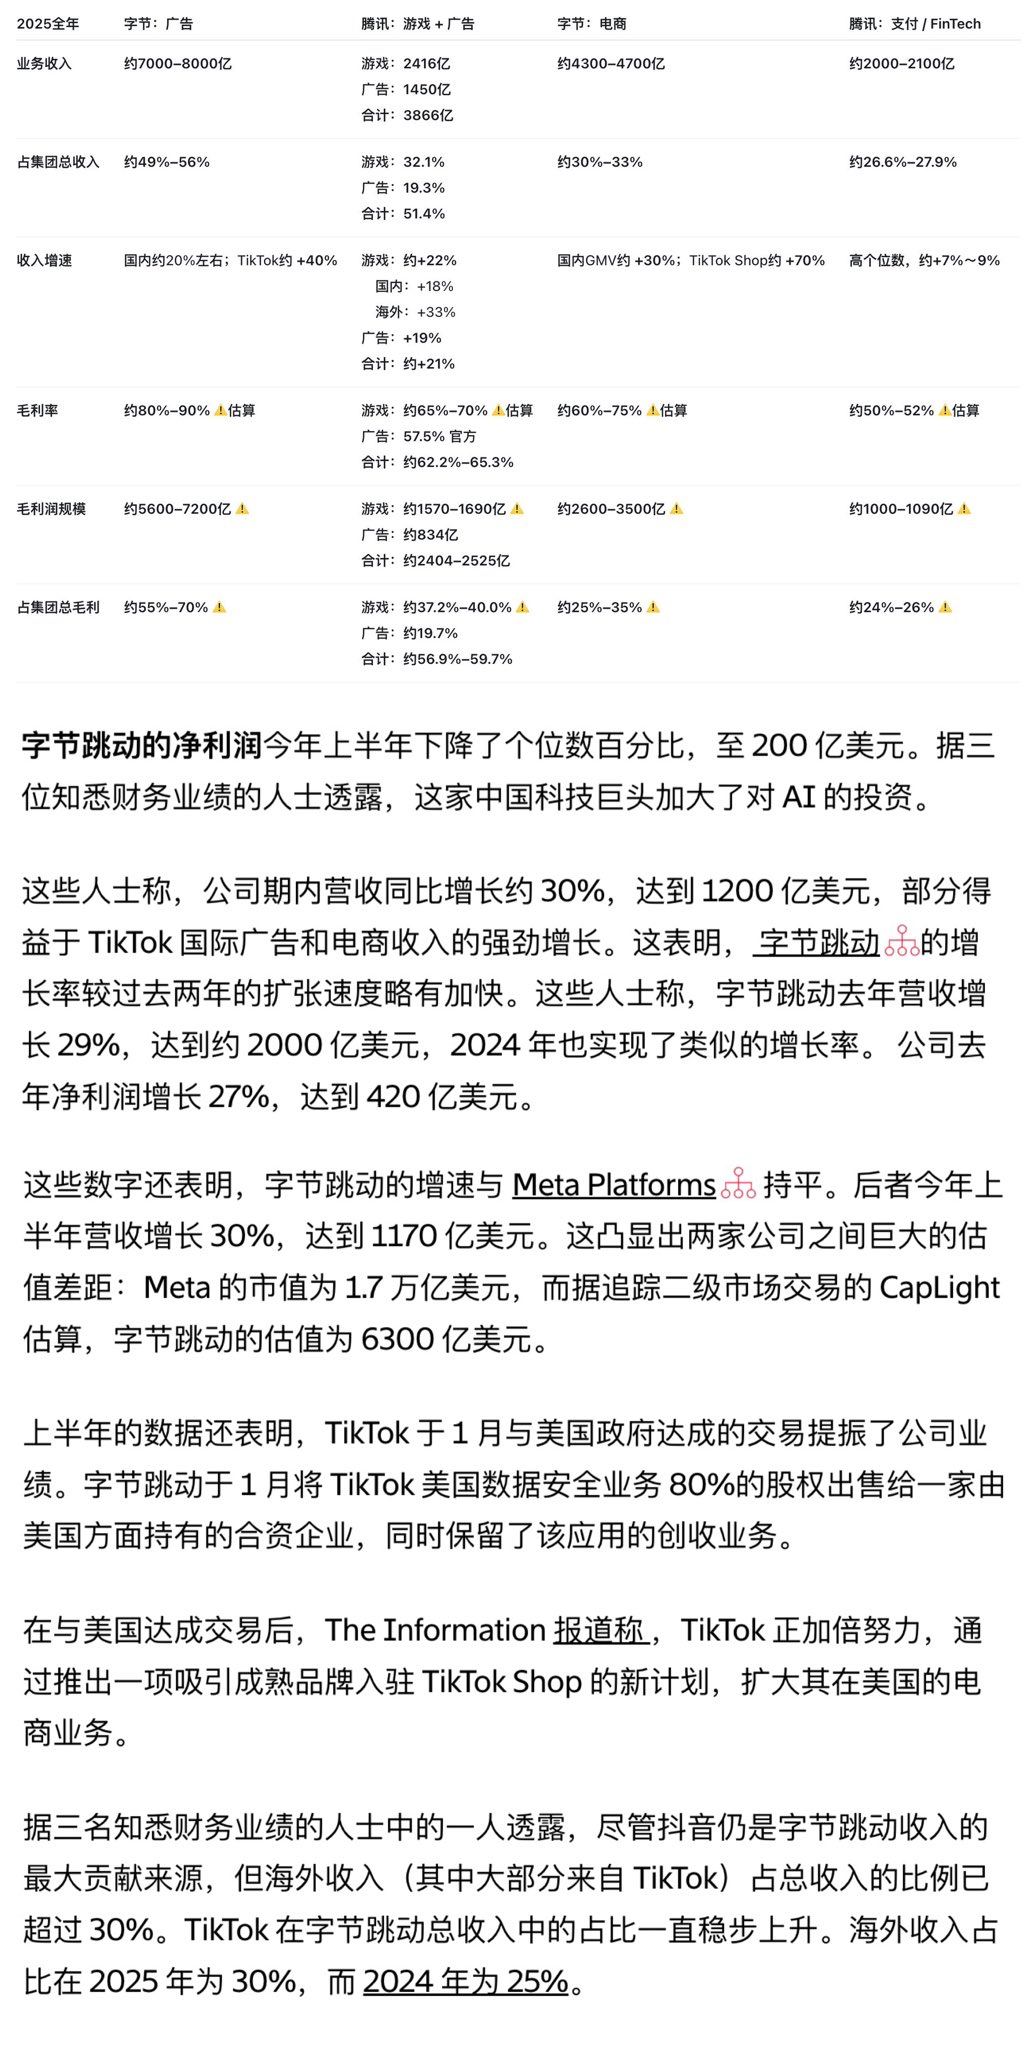
作者通过对比腾讯和字节的主营业务,论证字节的商业模式优于腾讯。核心观点:从主动查找到算法化自动分发是大势所趋;抖音/TikTok比微信更前沿,微信的使用时长和用户场景正被抖音转移;用户注意力从游戏、聊天等转向算法推荐内容;字节基于客观数据的产品方法论能将技术普及到下沉市场。作者进一步分析AI时代微信比抖音更危险:抖音核心在多模态内容沉淀和AI自主能力,而微信依赖的社交关系和聊天需求在AI时代可能被解绑和消融,聊天将难以支撑超级应用。
MiniMax 宣布 Code CLI v0.4.12 以 MIT 许可证向全球开发者开源。在第三方 FrontierHarness Eval 评测中,MiniMax Code 取得了最高的通过率、最快的平均任务完成时间以及次低的 token 消耗。官方认为精心设计的 harness 能充分释放模型能力并减少开发者等待时间。开源后,开发者可以审查工具调用与权限处理机制,构建可靠的企业级应用。MiniMax 同时邀请社区参与问题反馈与修复,通过真实使用和社区审查持续强化安全防护,共同打造安全、可靠、高性能的 harness,实现 Intelligence with Everyone。
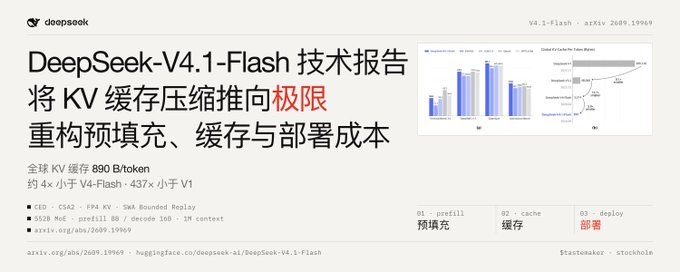
本文深度解读 DeepSeek-V4.1-Flash 技术报告,该模型通过 CED 不对称编码器-解码器架构、CSA2 跨层稀疏注意力复用、FP4 主 KV 量化及 SWA Bounded Replay 近似恢复四项设计,将常驻 HBM 的全局 KV 缓存降至 890 bytes/token(约为上一代四分之一),持久化缓存降至八分之一。文章详细解析各项技术的原理与协作机制,澄清了对压缩数字的常见误读,评估模型能力变化,并与 PagedAttention、MiniCache 等已有 KV 压缩路线对比,指出该工作将缓存压缩从算法点推进为面向百万 token 长程 agent 场景的系统级共同设计,同时讨论其证据强度与局限。
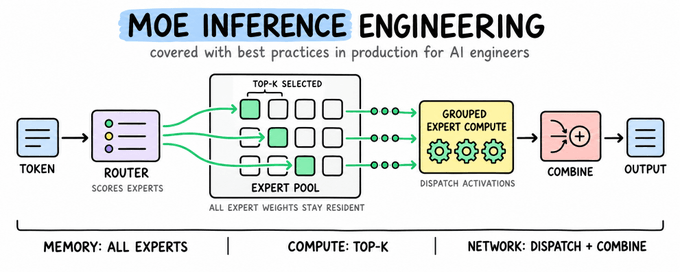
本文系统讲解 MoE(混合专家)模型的推理服务工程原理。从稠密 Transformer 的 FFN 与 MoE 层的区别入手,介绍路由器如何为每个 token 选择专家、dispatch 和 combine 过程如何将路由决策聚合成专家专属矩阵,以及 grouped GEMM 如何减少内核启动开销。文章还涵盖专家并行、拓扑感知部署、显存需求(常驻参数 vs 激活参数)、负载不均衡、容量限制和量化等话题,并分析计算、显存带宽与互连流量之间的性能瓶颈权衡,以 Qwen3-30B-A3B 为实例说明。
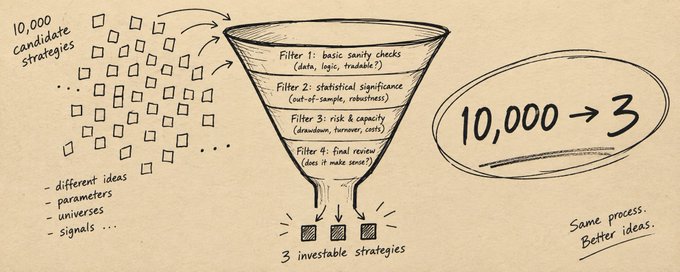
文章指出构建 Trading Agent 的核心难点不是下单或找到策略,而是以快于策略衰减的速度生产新假设并用严苛手段证伪假策略。作者拆解了发现、证伪、执行、止损四个环节,介绍统计套利、波动率曲面错价、因子残差、内部人交易信号四类错价目标及其数学模型,并提出扫描层、推理层、编排层、执行层的四层架构:大模型只负责扫描与推理,执行必须用确定性代码。文章还详细阐述了多重检验校正、交易摩擦成本、point-in-time 数据、样本外隔离、硬编码风控与四分之一 Kelly 仓位等工程纪律。
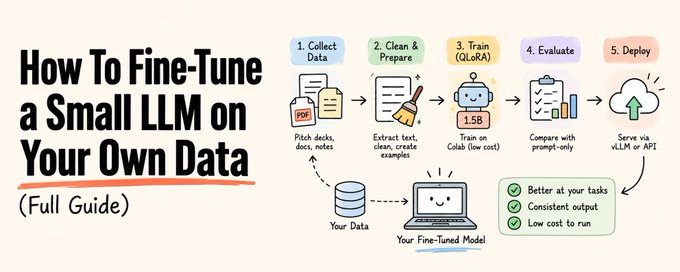
这是一篇关于微调小型LLM的完整实战指南。作者指出不需要70B大模型或昂贵算力,1.5B参数模型在200-500个优质样本上微调后,可在特定任务上超越通用提示的前沿模型。文章以商业融资文案生成为例,详细讲解了微调的实际目标、建立基线(纯提示、RAG、微调)的先后顺序,并分步骤介绍了小型基座模型选择(如Qwen2.5-1.5B)、数据权利合规、可复现数据下载、PDF文本提取与OCR、文本清洗、训练数据集构建、QLoRA训练、评估与部署,每一步均附完整代码。
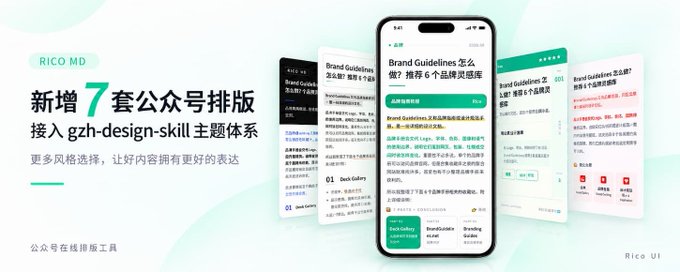
作者介绍了其公众号 Markdown 编辑器 Rico MD 的一次重大更新:接入开源排版 SKILL「gzh-design-skill」的主题体系,新增 7 套公众号排版主题(如摸鱼绿、红白色系、石墨极简风等),支持自定义封面模板字段、文末互动卡、文档与图片打包导出、标题正文行高间距自定义等功能。文章还说明了主题版权与 AGPL-3.0 许可处理方式,以及适配中舍弃的部分。该工具支持左侧 Markdown 编辑、右侧实时预览、一键复制到公众号后台,在线版与开源仓库均已提供。
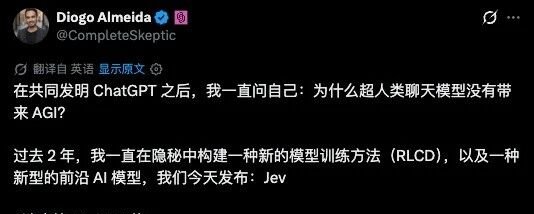
文章介绍了 TypeSafe 于 2026 年 9 月发布的 Jev 模型——一个专注于快速、低成本语义决策的"系统一"模型。传统 LLM 在智能体循环中处理大量小型判断(如工单分类、命令风险评估)时逐 token 生成,速度慢且成本高。Jev 通过三种原语(Choice、Score、Noul)接受非结构化输入,返回带概率的类型化答案,端到端延迟 70-500 毫秒,输入价格仅为 LLM 的一小部分。文章分析了概率置信度在自动决策中的作用、RLCD 校准训练方法,并澄清"无法幻觉"的说法:Jev 不会打破输出 schema,但仍可能自信地选错选项,适合与 LLM 配合而非替代。
本文介绍 TypeSafe 推出的决策模型 Jev 的实操接入方法。Jev 不生成代码,而是通过输入材料(state)和问题(questions)返回选项、分数或概率,用于判断 AI 编码 Agent 的工作质量。文章依次讲解:如何设计清晰的判断问题、跑通首次 API 调用、用 Python SDK 一次发起选择题/评分题/判断题、通过社区插件 jev-review 给 Claude Code 或 Codex 接入代码评审流程,以及安装官方 Skill 和编写 PreToolUse hook 对 Bash 命令做风险检查。文章强调 Jev 只提供质量信号,正确性仍需测试和人工审查保障,并提醒注意阈值校准、模型标识记录和敏感信息安全。
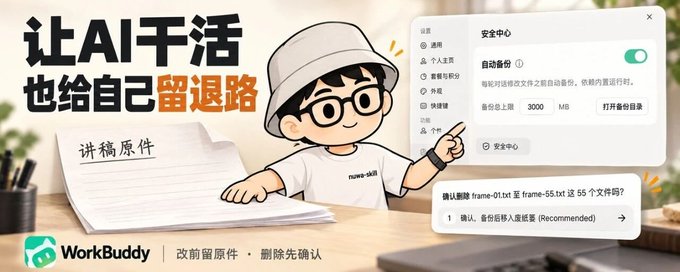
作者分享了WorkBuddy这款work类agent在安全机制上的实测体验。作者从早年AI改代码踩坑的经历出发,指出不写代码的白领用户同样需要'撤销键'。实测中,WorkBuddy在批量删除55个文件时主动确认、先备份再移入废纸篓,备份经sha256校验逐字节一致;其操作日志为哈希链可防篡改,技能安装有风险检查。此外,WorkBuddy开放十几个模型可选、连接飞书钉钉等第三方办公产品,并内置独立开发者的开源skill。作者认为安全能力本质是给用户加了胆子,让非技术用户也能放心尝试和迭代。
文章深入剖析了 Pi 这个 Agent 框架的插件扩展机制。作者通过阅读源码,将插件能力归纳为四个关键切面:input 入口拦截与改写、context 视图投影(控制模型可见内容、压缩日志、脱敏)、tool_call/tool_result 工具执行前后的参数修改与结果加工、以及通过 sendMessage 的 steer/followUp/nextTurn 策略主动驱动循环,实现自愈回路。文章强调建立 Prompt、Turn、Loop 三个执行尺度的思维模型,并给出工程实践建议:优先使用社区插件,或把 Hook 机制交给 AI 代写插件。
Jev 是由 ChatGPT 联合创造者、RLHF 联合发明人 Diogo Almeida 在隐身两年后推出的决策型 AI 模型。它不做对话生成,而是为软件提供快速决策:选择题、评分、是/否判断,号称比前沿 LLM 快约 200 倍、便宜 400 倍,响应仅需几十毫秒。文章盘点了社区基于 Jev 构建的 9 个实际应用,包括 7 秒找机票的浏览器代理、上下文即时压缩工具、编码代理安全审查器、模型路由中间件等。其命名源自 19 世纪经济学家 Jevons,暗喻资源越便宜消耗越多的悖论。
作者Katherine是UI转行做AI产品的出海从业者,其SaaS产品在Google Search Console累计获得4279万次曝光、228万次点击。文章分享了通过深耕小语种市场实现SEO突破的经验:避开竞争激烈的英文市场,转而挖掘德语、西班牙语、葡萄牙语等小语种流量机会。详细介绍了找词前的五项准备、四个关键词来源、关键词验证的三关(语义、搜索、SERP确认)、在目标市场验证关键词的六个步骤,以及如何将关键词转化为本地化页面,强调不要机翻,而要深入当地搜索结果理解本地用户的真实表达。
本文是 WorkBuddy「项目」功能的实操教程,讲解如何搭建可持续使用的内容运营工作台。作者区分了项目、任务、工作空间和项目资产四个概念:项目管长期目标,任务管一次执行,工作空间承载执行,项目资产保存可复用资料。教程从准备账号定位、代表作、选题库等五类资料开始,依次演示创建项目、写入长期规则(内容定位、写作原则、交付要求等)、配置 Skill/专家/连接器、上传项目资产、发起选题任务、再创建写作与多平台改编任务的完整流程,并附有常见问题解答,强调先手动跑通流程再考虑自动化。
文章深度剖析了 TypeSafe 发布的新决策模型 Jev。与 LLM 不同,Jev 不生成文本,而是输出程序可读的决策 JSON,剥离语言能力,专注做软件中的小判断(分类、布尔判断、打分)。开发者通过传入 state 和 questions 进行调用,模型基于 RLCD 训练方法实现概率校准。相比 LLM,Jev 在演示中快 75 倍、便宜 171 倍,且因输出受类型约束可减少幻觉,但仍可能选错。文章介绍了客服、发票、安全告警等场景评测及 Doom 游戏演示,并建议从工单分类等边界清晰的任务开始试用,逐步开放自动处理。
本文介绍在 Mac 上同时运行两套 Codex 的双开配置方案,适合一个 Plus 账号额度不够用或需要多场景任务隔离的用户。作者提供了一个完整的提示词,用户只需复制给 AI,由 AI 自动完成环境检查、创建独立的 ~/.codex-second 目录、独立的 CODEX_HOME 和数据目录、制作蓝色 Codex B 启动图标,以及更新和回滚流程。核心原则是不修改或破坏现有 Codex A 的配置,保留官方 App 的代码签名和公证。用户仅需手动完成账号登录、验证码输入和 macOS 权限确认。最终实现 A、B 两个 Codex 独立运行、互不影响。
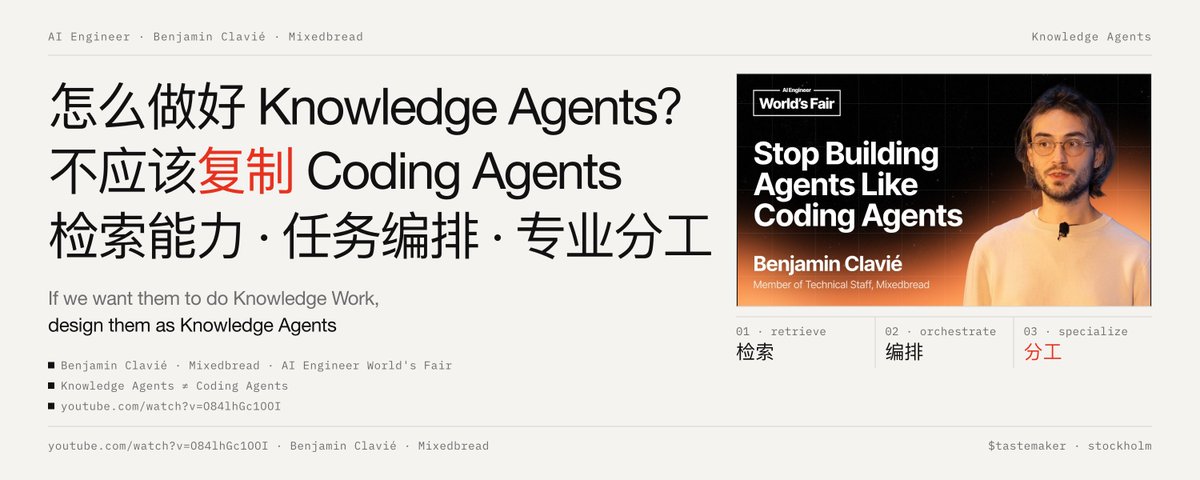
本文介绍 Ben Clavié 在 AI Engineer World's Fair 的演讲,主张知识型 Agent 不应照搬 Coding Agent 范式。核心观点:编程智能体的成功源于代码环境的结构化红利;而法律、医疗、投研等知识任务的难点在于正确定位、理解和验证证据。要构建可用的知识 Agent,需具备面向任务的高质量检索工具(含图表、扫描件等多模态内容),以及主智能体负责任务分解、子智能体承担专业分工的编排架构。文章还给出企业级建设的优先级建议:定义可验证任务、建设证据层、按需拆分智能体、多维度评估并保留人工审核。
TypeSafe AI推出的新模型Jev只做高频决策判断,不能聊天或写代码,是一个通用分类器。它由前OpenAI创始人Diogo Almeida打造,采用自研RLCD训练方法(面向校准决策的强化学习),响应仅需380毫秒,速度快20-200倍,成本低40-400倍。文章通过浏览器插件过滤X内容、玩马里奥、操控浏览器等案例展示其能力,并在预筛任务中与GLM、DeepSeek、Qwen对比,Jev在并行判断任务上综合表现最优。其名源自杰文斯悖论,寓意智能判断将因便宜而被大量使用,可能代表Agent时代的重要新方向。
作者重读Notion创始人Ivan Zhao被读600万次的名文《蒸汽、钢铁与无限心智》,梳理其核心观点:每个时代由'奇迹材料'塑造,钢铁造就镀金时代,而AI正以'无限心智'形态到来。文章评价:个人层面,10倍工程师通过指挥多个AI智能体成为30-40倍工程师,但'无限心智'受限于人类有限的验证注意力;组织层面,AI如同组织的钢铁,能极大提升效率,但我们仍处于'替换水车'阶段,且概率性材料盖确定性高楼需更深地基;经济层面,知识经济将如城市从佛罗伦萨演进为东京。作者同时警示:脱离一线的监督者会失去质量手感,年轻人的手艺底子可能变空。
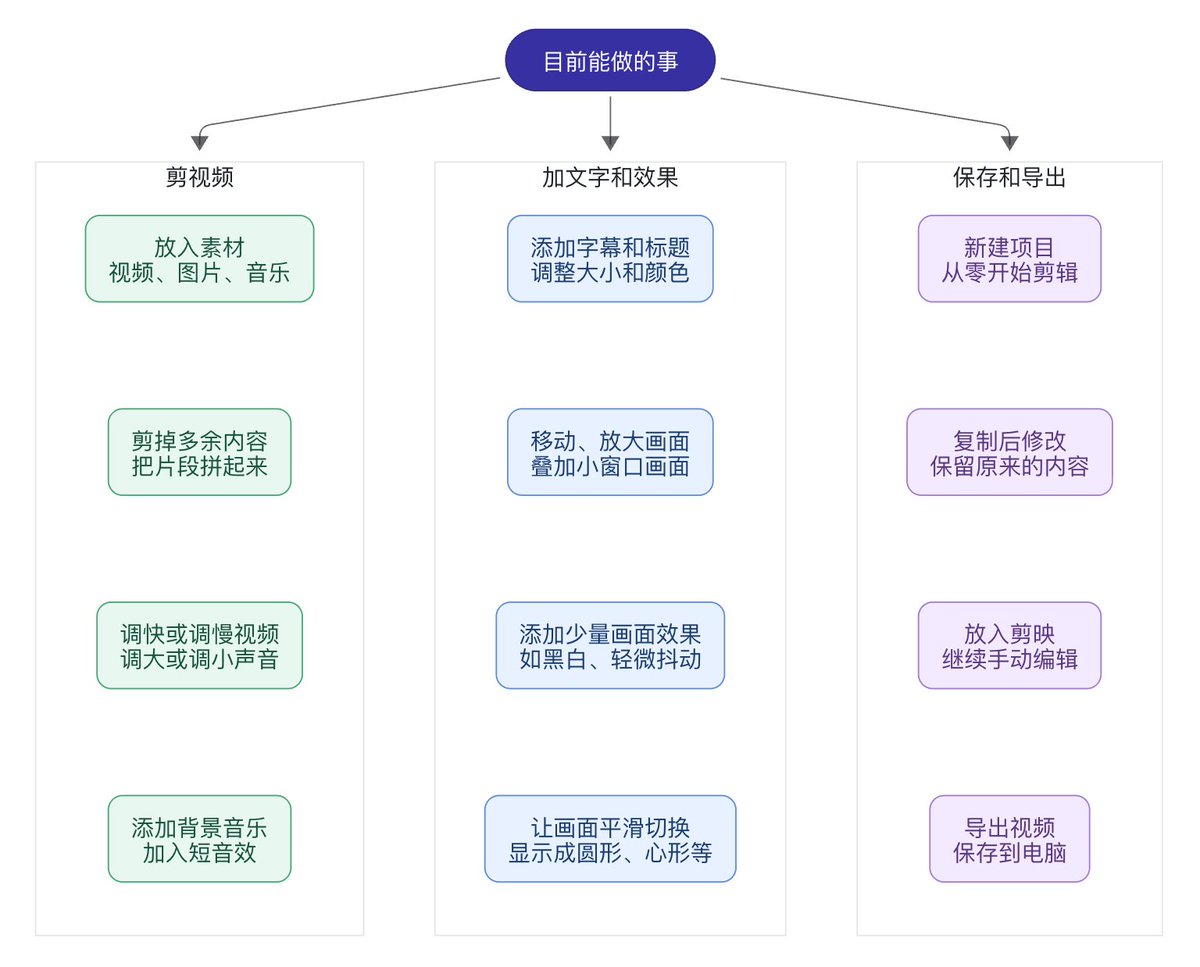
作者分享其逆向剪映的开源项目 jianying-headless,以及配套的 yichen-jianying-edit Skill。用户只需简单提示词,即可将口播类视频剪辑工作全程托管给 Codex 自动完成,无需人工操作。项目调用豆包 ASR 进行毫秒级语音切割,生成的剪映草稿即使有误也可人工微调。作者展示了8分钟视频自动剪辑为3分钟的对照效果。成本主要包括 Codex Token 费用(可用便宜模型替代)和豆包 ASR 费用(每小时约0.8元)。文中还提及 TradeWinds 社群第二期开放的消息。
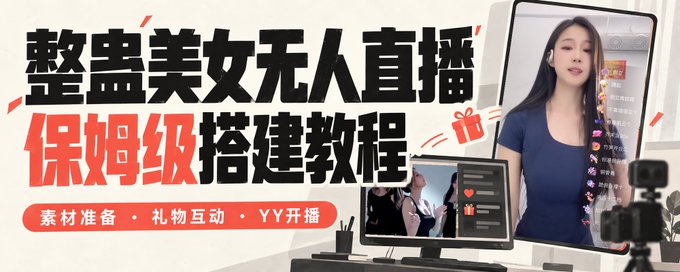
本文是抖音无人互动直播的保姆级搭建教程。作者讲解如何用预制素材搭建'整蛊美女'直播间:观众送礼或评论触发对应视频动作,形成互动闭环。内容涵盖底层逻辑、工具准备(直播伴侣、互动助手、YY开播等)、九步搭建流程:定人设、制作三类素材、开发互动工具接入消息、搭建待机画面、绑定礼物与评论规则、接入直播伴侣开播、起号测试与变现运营。强调素材需授权、明示预制内容、保证礼物与实际播放一致,通过音浪、心愿单和带货实现变现。
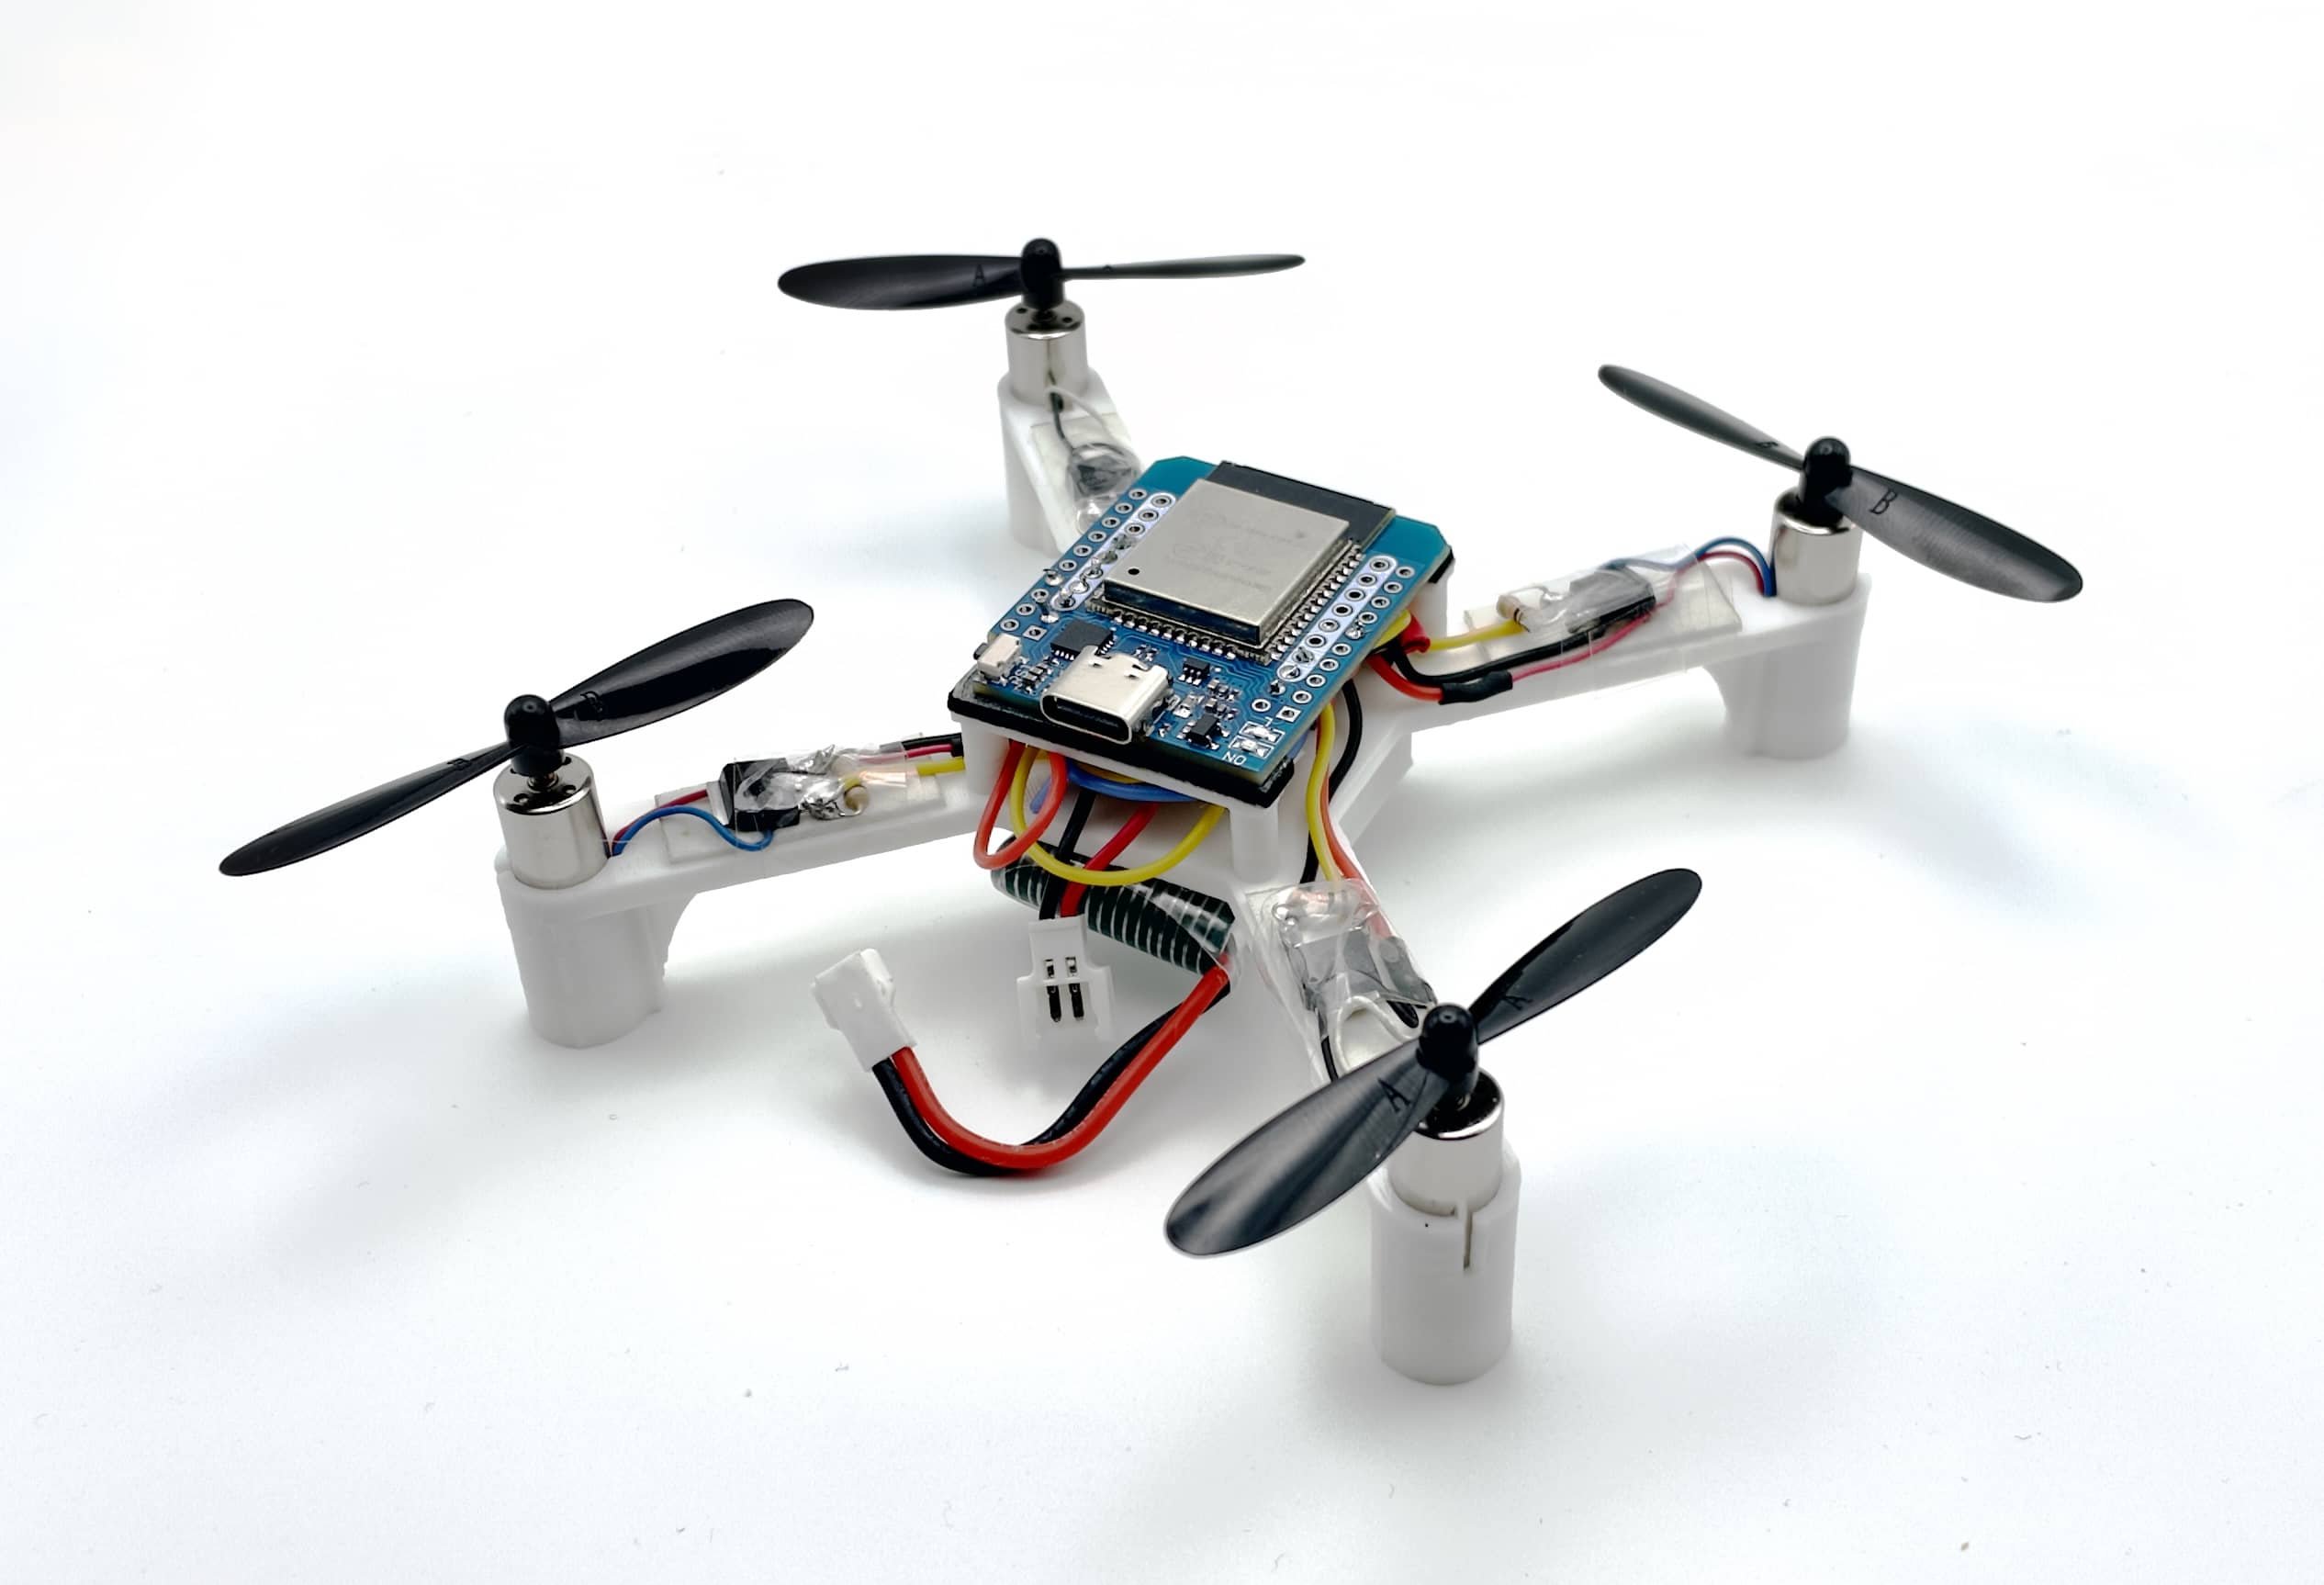
文章推荐了开源硬核项目 Flix,一个基于廉价通用硬件、主打教学与飞控研究的微型无人机项目。核心固件用 Arduino C++ 编写,代码量不足 2000 行,是学习姿态解算、PID 控制和嵌入式飞控架构的绝佳范本。硬件采用 ESP32 Mini 主控、8520 空心杯电机与 GY-91/MPU-6050 传感器,机架支持 3D 打印。项目原生支持 MAVLink 协议,可通过 Wi-Fi 或 ESP-NOW 通信,兼容手柄、手机遥控和航模遥控器,并内置 CLI 工具、飞行日志分析、Gazebo 仿真和 Python SDK,适合嵌入式开发者、高校课程实践及 DIY 极客。
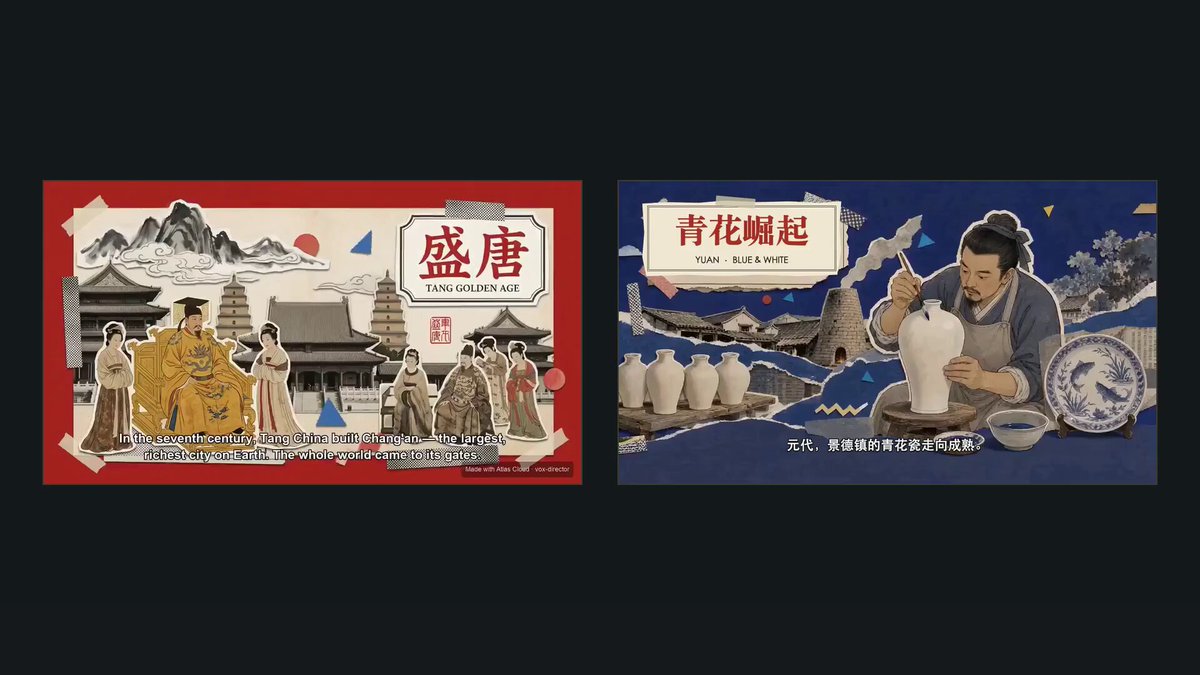
作者介绍了开源视频制作工具 Hypit,一个为 Codex、Claude Code 等 AI Agent 打造的视频开源语言和系统,上线不到3天获得 GitHub 7.4k star。Hypit 能将脚本、素材、配音、字幕、B-roll 和动效组织成可执行工作流,创作者只需描述需求即可让 Agent 编写、修改结构,并在 Hypit Studio 中查看时间轴。作者演示了 Clone → Edit → Reuse 实验:先复刻唐代纸片拼贴风格视频,再用同一工作流生成中国瓷器历史宣传片,并追加流程动效。一次实践留下的脚本结构、样式和动效组件可复用于后续创作,适合需要持续制作产品介绍、知识视频的创作者。
本文详细介绍了 OpenAI GPT Image 2.5 相比 2.0 的核心升级:参考图主体保持更强、局部编辑更准、多轮修改不易漂移、延迟降低约 50%。作者提出 2.5 的提示词应从"描述+重复+防错"的长写法转向"状态管理"思维,通过 Preserve/Change 结构和 Delta Edit 小步修改,用 Mother Image(母版图)建立基础状态后逐步迭代。文章还对比了 API 中的 Flare(快速生产、批量探索)与 Sunburst(高精度精修、复杂编辑)两个型号的定位,并给出 Flare 探索+Sunburst 精修的合理工作流建议。
Jason Wei 在 Stanford AI Club 的演讲总结了理解 2025 年 AI 格局的三个框架:一、智能正在商品化,自适应计算使推理成本随任务难度动态调整,公开信息获取时间指数级缩短;二、验证者定律——AI 在某任务上的能力与可验证程度成正比,验证成本低的首个被自动化,创业方向是把难验证任务变得可验证;三、智能呈锯齿状分布,AI 自我改进是渐进光谱而非快速起飞,数字化、数据充足、人类觉得容易的任务进步最快,物理类任务短期难以攻克。
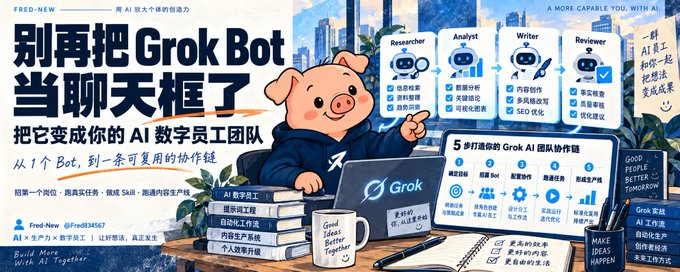
作者 Fred-New 分享了如何将 Grok Bot 从单一聊天工具打造为长期数字员工团队的方法论。核心思路是:先给一个 Bot 一个窄岗位和明确验收标准,跑通真实任务;结果稳定后把流程保存成 Skill,再做回归测试;稳定后设置 Routine 让 Bot 定时自动工作。当出现稳定分工需求后,再组建多 Bot 团队(情报员、爆款分析师、Researcher、Writer、Reviewer、Visual Planner 六岗位)。文章强调岗位边界、工具接入、薄 Context Pack、固定交接格式(如 Research Pack 和 Handoff)的重要性,并指出真正的多 Agent 协作关键在于可替换的模块和清晰的接口,而非人数。
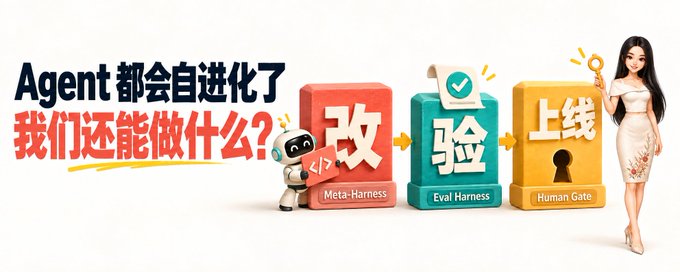
文章探讨了 Agent 自动改进系统(Meta-Harness)的构建方法。核心问题是如何让 Agent 自动进步又无法伪造进步。作者提出将三种权力拆开:Agent 负责提出修改,评测系统负责拿证据,上线门禁决定是否升级。文章通过一个补货建议 Demo,演示了从失败记录到修改验证的完整闭环,包括锁定 Agent 不可修改的文件(密封考题、评分器、上线标准)、生成结构化故障单、构建逐层收窄的评测漏斗等实践。同时分析了 Agent 容易刷分的三种捷径:讨好评分器、记住考题、自己宣布通过,并指出 Meta-Harness 只在基础 Eval 成熟、人工改进成为瓶颈时才值得搭建。
作者分享了自己获批使用 TypeSafe AI 推出的 Jev 模型后的体验,并整理了一份 Awesome Jev 项目清单。Jev 是一个不生成文本、只返回选项、分数和概率的低延迟判断模型,可并行输出结果。文中介绍了 14 个基于 Jev 的项目,包括高速浏览器 Agent、MCP 集成工具、命令行语义判断工具、模型路由器、上下文垃圾回收、代码审查前置筛选、语义寻路、知识图谱、桌面自动化、交易流动性分析以及 FPS 游戏等应用场景。核心思路是:用 Jev 反复做'要不要、选哪个、打几分、下一步干什么'的判断,复杂推理和生成任务仍交给传统大模型,从而降低成本、提升速度。