爆款复刻|拆透「古风武侠英语剧」的长青打法与搞钱闭环
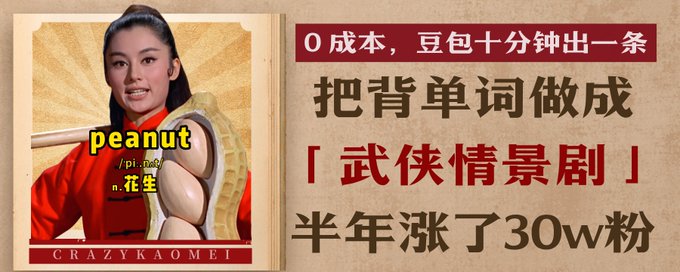
文章拆解了「武侠情景微短剧教英语单词」这一自媒体赛道:以80年代港片武侠风格拍摄10秒短视频拆解英语合成词,半年涨粉27万。作者分析了其抗周期优势(教育刚需、无违规风险、高完播率),提供了从豆包智能体生成脚本、Seedance生成视频到剪映精修的完整SOP,并介绍四条变现路径:虚拟单词卡、图书分销、私域训练营和反向出海教中文。最后强调AI时代要结合自身优势区深耕,避免样样通样样松。
文章拆解了「武侠情景微短剧教英语单词」这一自媒体赛道:以80年代港片武侠风格拍摄10秒短视频拆解英语合成词,半年涨粉27万。作者分析了其抗周期优势(教育刚需、无违规风险、高完播率),提供了从豆包智能体生成脚本、Seedance生成视频到剪映精修的完整SOP,并介绍四条变现路径:虚拟单词卡、图书分销、私域训练营和反向出海教中文。最后强调AI时代要结合自身优势区深耕,避免样样通样样松。
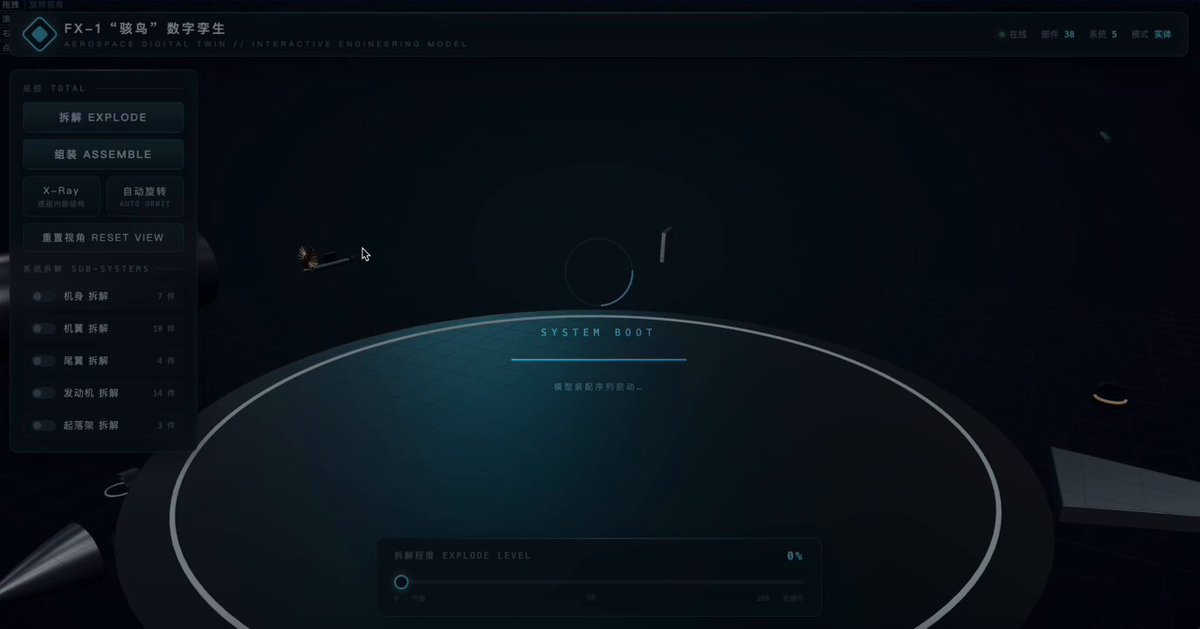
上海 AI 实验室与多所高校联合开源了智能体基础模型 Atria Dawn Preview,面向科研工作者、开发者和专业知识工作者。该模型能自主查找资料、调用工具并运行测试,直接产出研究报告、可运行程序、文档表格、3D 模型和小游戏等可验证成果。作者实测用其纯靠代码生成精准美观的 3D 飞机模型,效果出色。该模型各项评分位居国产模型第一梯队,研发团队非常年轻,约三分之二为来自复旦、北大、上交大等高校的在校学生。
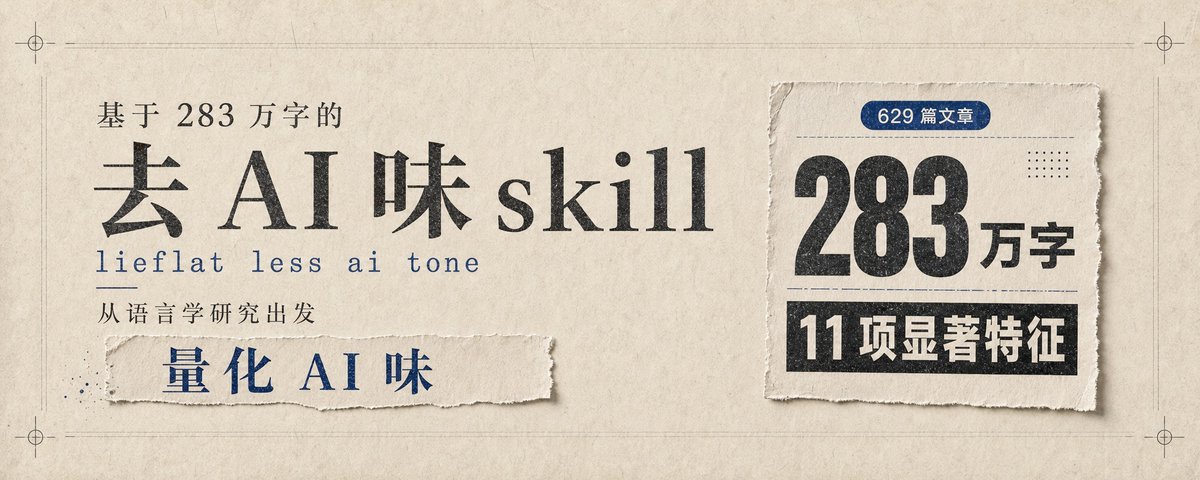
作者基于283万字语料(329篇人类文章+5个主流AI模型生成的300篇文章),用语言学对照实验和统计方法量化“AI 味”,制作并开源了一个去 AI 味 skill。实验发现11项显著特征集中在篇章结构层面,如段首零回指评论(4.4倍)、拟人化比喻(7.3倍)、空转冒号(9.4倍)等;而流行认知中的设问句、句长均匀度等特征实测并不显著。研究还发现不同模型写作偏好差异巨大,不存在统一的“AI 文风”。作者认为去 AI 味本质是预训练层面应解决的问题。
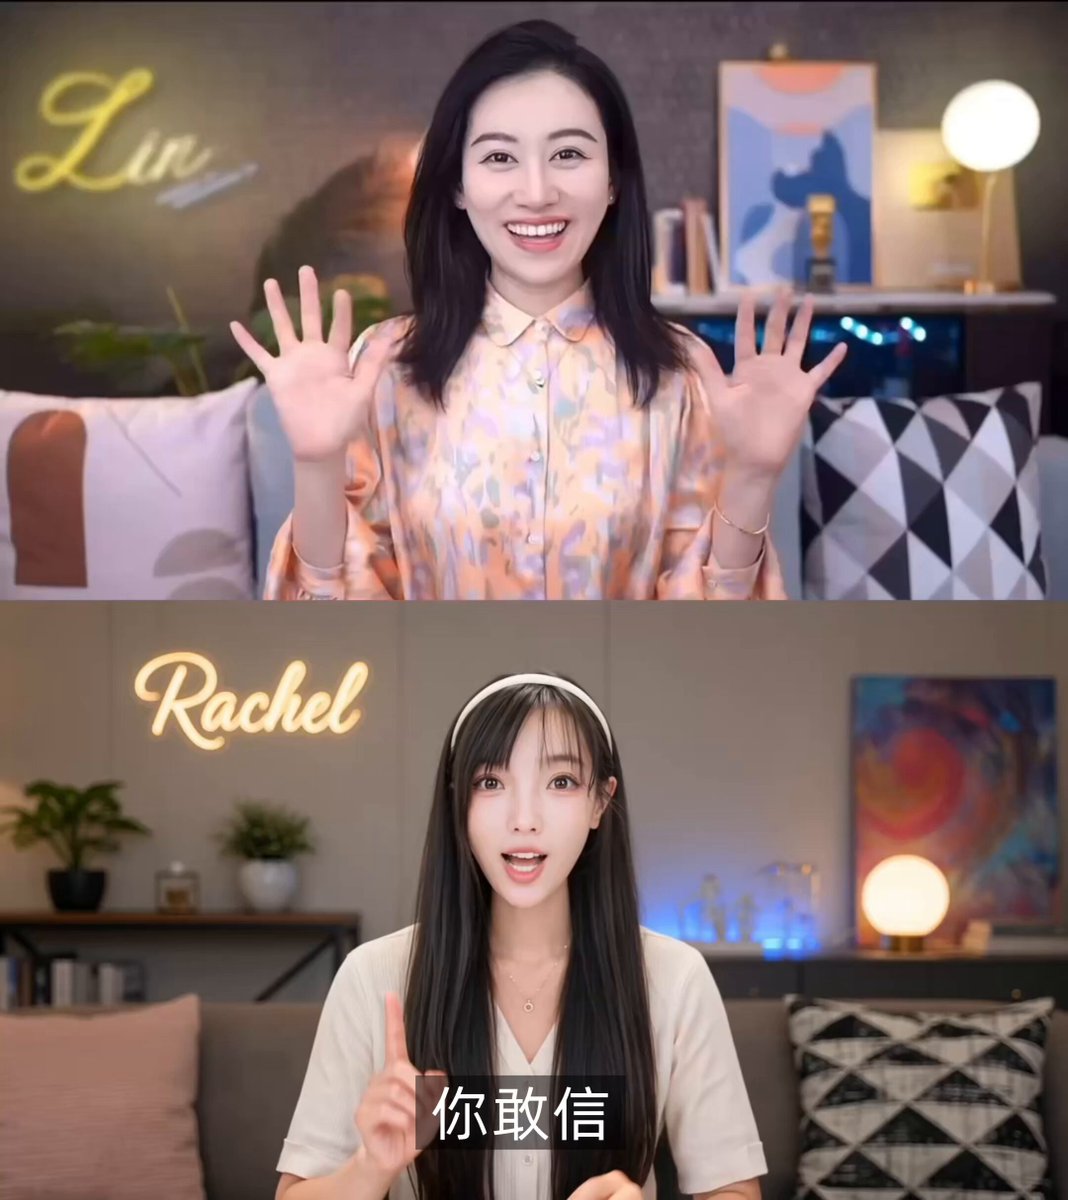
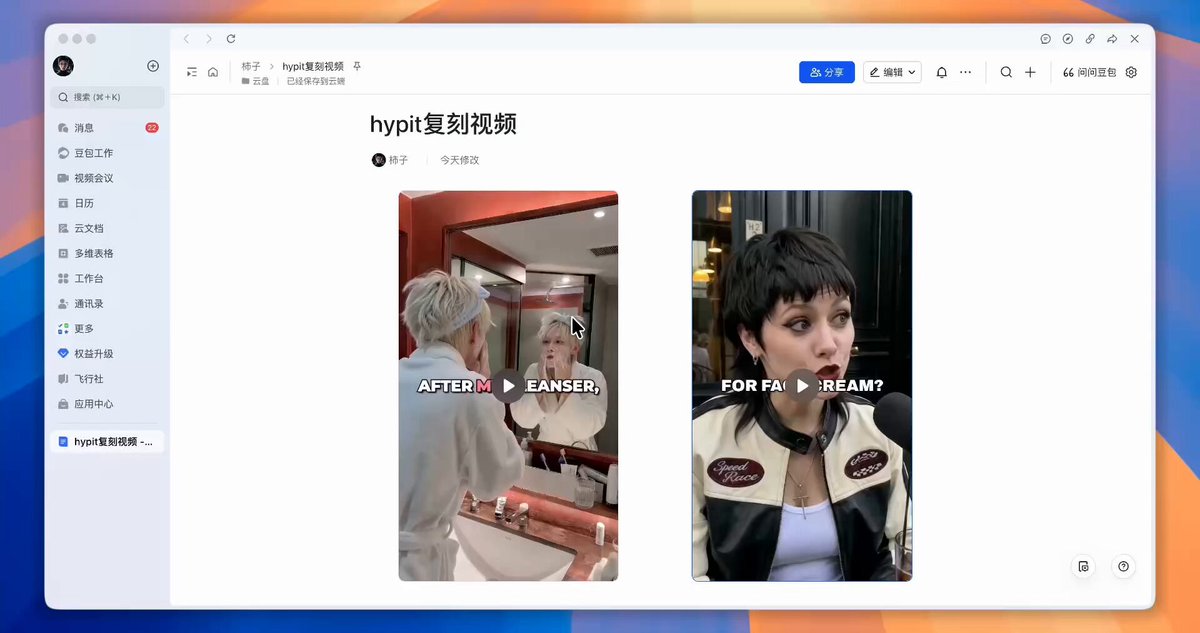
作者尝试用 Codex 结合开源工具 Hypit 复刻千万粉博主'小Lin说'的口播视频,发现 AI 生成的不仅是一条成片,而是一套可修改、可复用的视频 Workflow。Hypit 是面向 Claude Code、Codex 等 Agent 的开源视频语言和系统,人物、台词、字幕、B-roll 和特效跟随文字与叙事事件组织,而非固定在时间线上。修改主持人、图表或背景时只需重新生成相关组件,还能批量生成不同人物、内容、语言版本。作者认为这大大降低了复刻爆款视频、沉淀个人工作流的门槛。
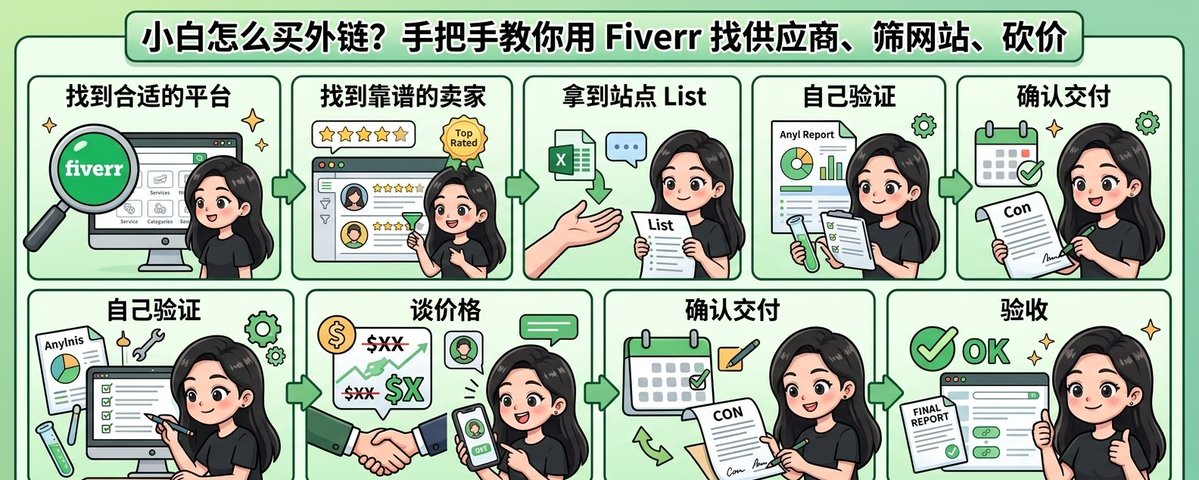
作者基于两年出海增长经验,分享了海外 SEO 付费外链采购的实操指南。文章对比了 Adsy、FatJoe、BacklinksRocket、LinksManagement、Fiverr 等常见平台的特点与适用场景,并重点讲解新手如何从 Fiverr 入手:先明确采购标准(DoFollow、DR 要求、主题相关性等),优先看卖家订单量与评分,让卖家提供站点列表并用 Semrush/Ahrefs 验证质量,再合理砍价并在付款前确认交付与退款条件。最后建议小批量测试跑通流程后再扩大规模,强调自己会筛站比找便宜供应商更重要。
作者提出了一套注意力边界判断法则——'本体,内与外'。核心观点是:我们总是想决定那些无法决定的事,却把本能决定的事拱手相让。作者认为'本体'比'主体'更能体现原创性与向外辐射的自由生长状态。注意力管理只需关注两点:一是'本体内',即筛选能促进思考的信息、建立专注点并通过表达向外迭代;二是'本体外',即照顾好身体,因为身体是精神的载体,'身弱怎谈心强'。做好这两点后,便有能力向外辐射,吸引想接近的人和事,无关的人和事则会自然散去。文章最后以'向外求求之不得,向内求生生不息'作结。
作者是 SpaceXAI 中国区大使 Kin,面向想做自媒体的 AI 产品开发者与内容创作者,讲解如何用 Grok Bot 降低自媒体运营成本。文章先指出 AI 时代做产品的门槛已大幅降低,瓶颈转移到推广获客,而自媒体是性价比最高的方式。作者提出 HKRR(快乐、知识、共鸣、节奏感)等传播底层规律,并给出两个实战案例:一是推特运营专家 Bot 的搭建流程(身份卡、方法论沉淀、选题库、Notion 状态流转、每日复盘);二是视频爆款选题库的搭建方法(找对标账号、IP 定位、建选题表、按 HKRR 拆爆款)。最后强调速度第一,先做到高频产出再谈精修。
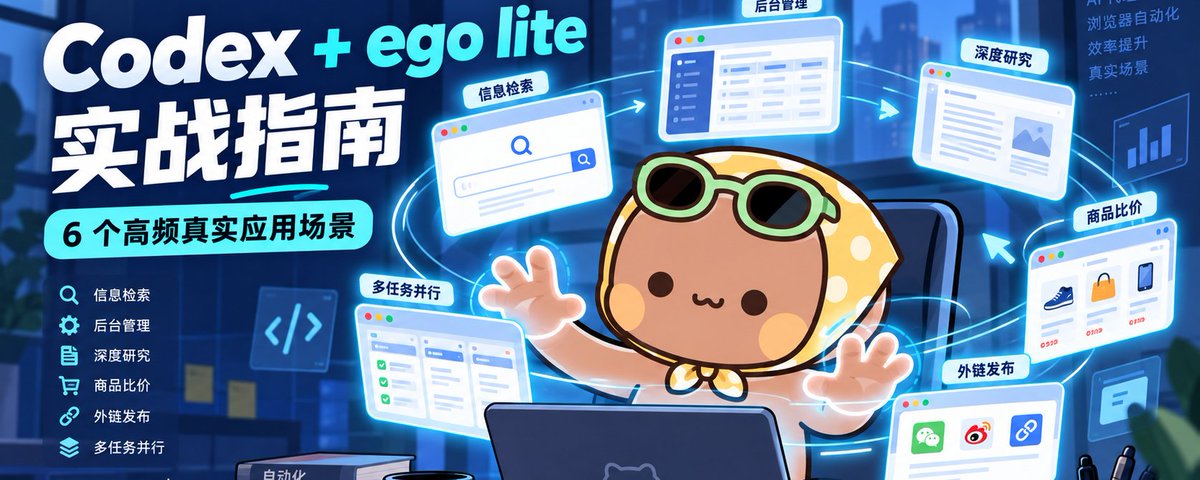
本文介绍 Codex 结合 ego-lite 浏览器工具的 6 个实战场景:登录态复用免去重复登录;自动外链发布使 SEO 发帖从 3-5 分钟缩至 30 秒;多 Space 并行实现单浏览器多任务隔离运行;搜索+结构化提取让 AI 直接交付答案而非链接;跨平台电商比价自动采集整理价格数据;多轮深度研究保持上下文连续生成综合简报。文章展示了 AI 操控专属浏览器替代人工重复操作的效率变革,各场景均附实拍效果与效率提升数据。
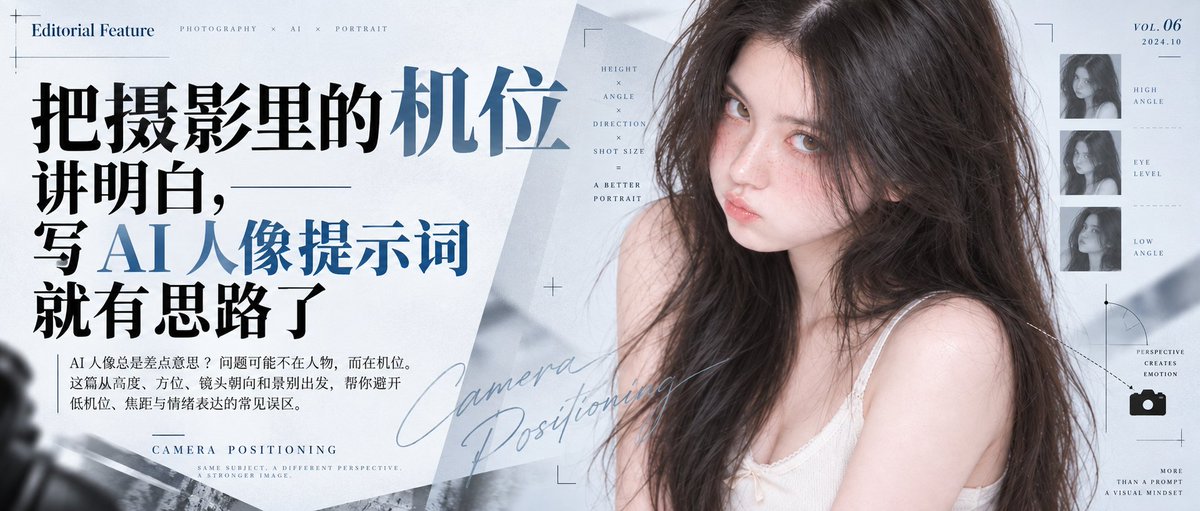
文章讲解如何用摄影机位知识写好 AI 人像提示词。作者把机位拆解为相机高度、拍摄方位、镜头朝向和景别四个检查项,指出"换个角度"这类描述信息量几乎为零,"低机位"等模糊标签会让 AI 乱猜。核心观点包括:相机贴地不等于低机位,应以拍摄目标中心为锚点判断平视;距离需与焦距、景别结合描述;景别决定观众第一眼看什么。文末给出可复用的机位提示词模板,帮助写出生成效果可控的人像提示词。
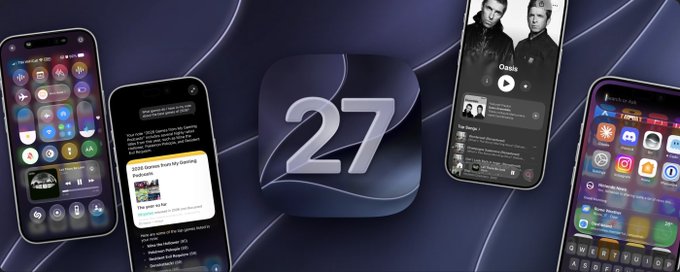
作者Federico Viticci整理了iOS 27和iPadOS 27的50多个隐藏功能和实用技巧,涵盖照片应用(相机胶卷过滤、视频帧保存、证件集合、关键词、星级评分)、主屏幕与锁屏(液态玻璃自定义、超大小组件、迷你时钟)以及Siri AI(全局搜索合并、文字输入、屏幕感知、新语音)等新特性。iOS 27主要聚焦性能改进,但这些细节功能大幅提升了系统体验,完整评测可在MacStories查阅。
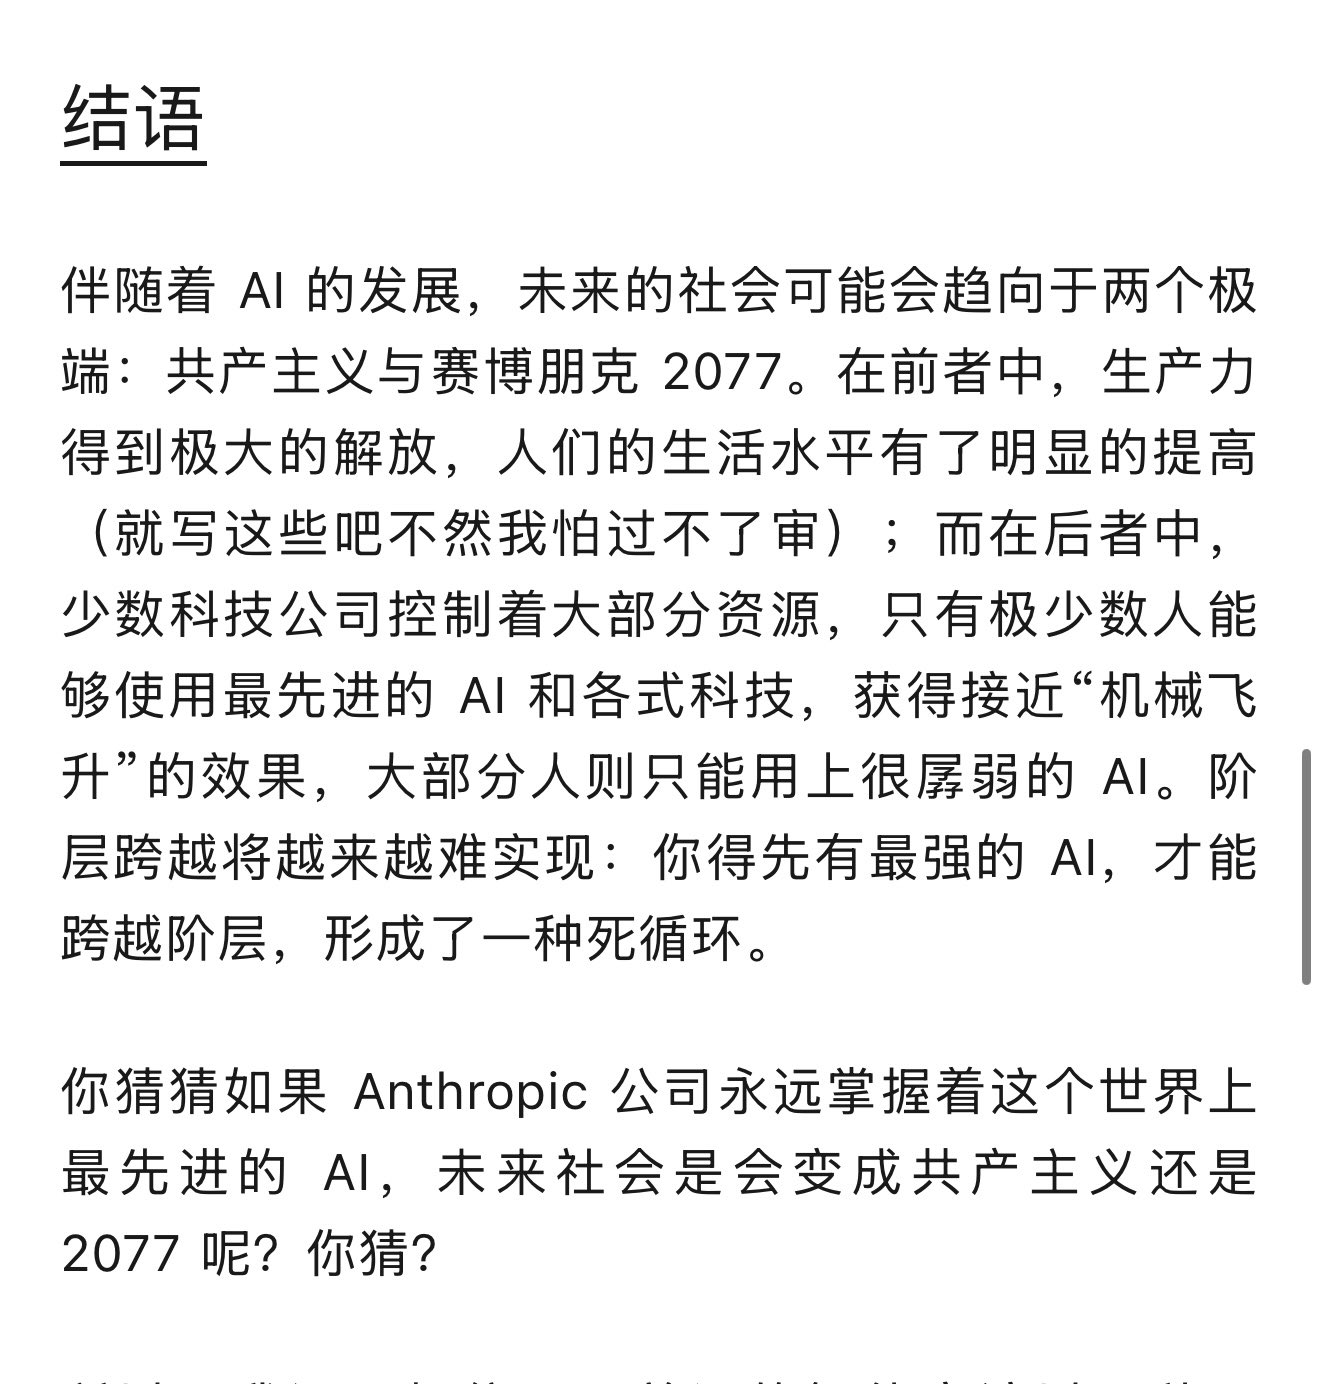
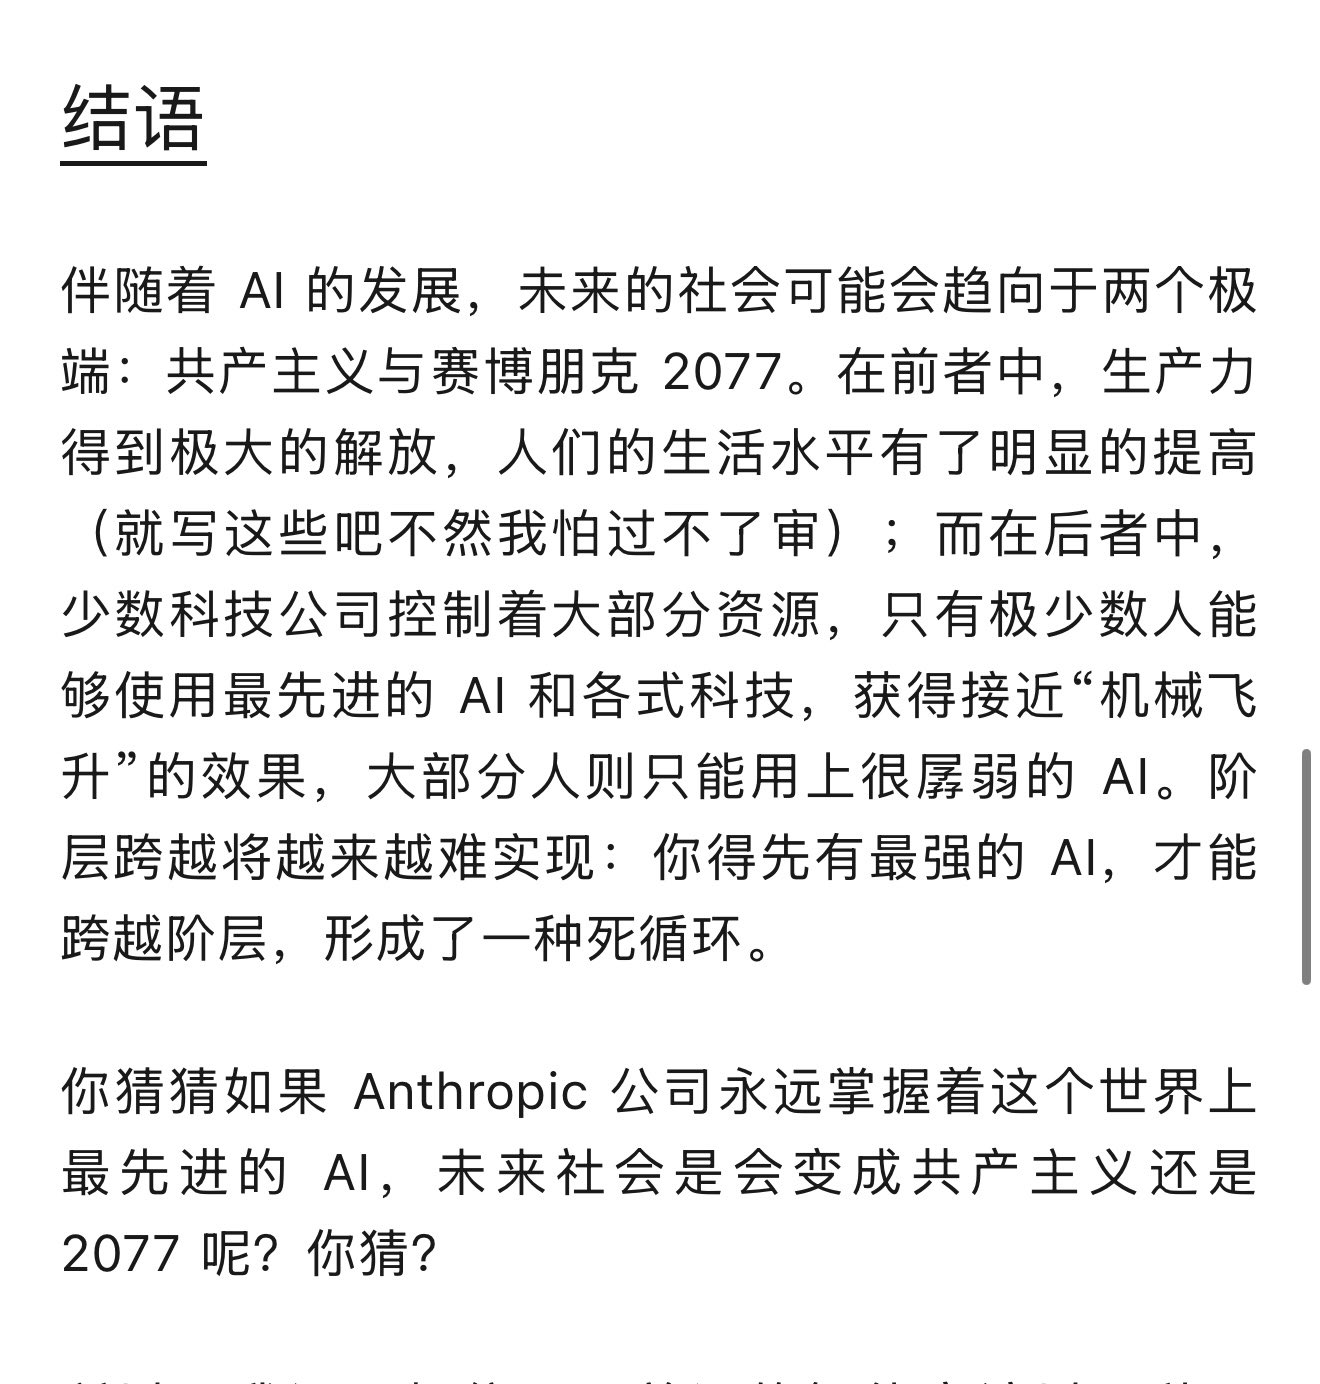
文章包含两条内容:一是 DeepSeek kernel 工程师 Shengyu Liu 的长文,讲述 AI 已能自主分析 CUDA/PTX/SASS 并优化 kernel,他预判半年到一年内 AI 写的 kernel 可能超过自己,工作将从亲手写代码变为驾驶 Agent,并担忧未来社会走向共产主义或赛博朋克两极,因此选择留在 DeepSeek 推动开源 AI。二是微信团队开源的 WeKnora 框架,已从 RAG 系统进化为企业 Agent 基础设施,提供知识处理、ReAct Agent、Sandbox 执行环境、长期记忆和 Auto-Wiki 能力,代表 RAG 向企业 Agent Context + Runtime 的迁移趋势。
作者分享参加外滩大会的见闻,重点记录了关于 Agent 上下文管理和记忆的讨论。文章提到 OpenAI 新发布的 Agents API 把 Codex 背后的 Harness 做成托管 API,并围绕"记忆是新时代的个人网盘"的观点,畅想云端记忆、跨设备共享和知识交接的可能性。作者还引出圆桌上"妈生感"的有趣概念,期待 AI 通过记忆积累与自进化形成默契,强调验证、纠正和用户掌控权的重要性,最后期待 AI 的主动性与分寸感。
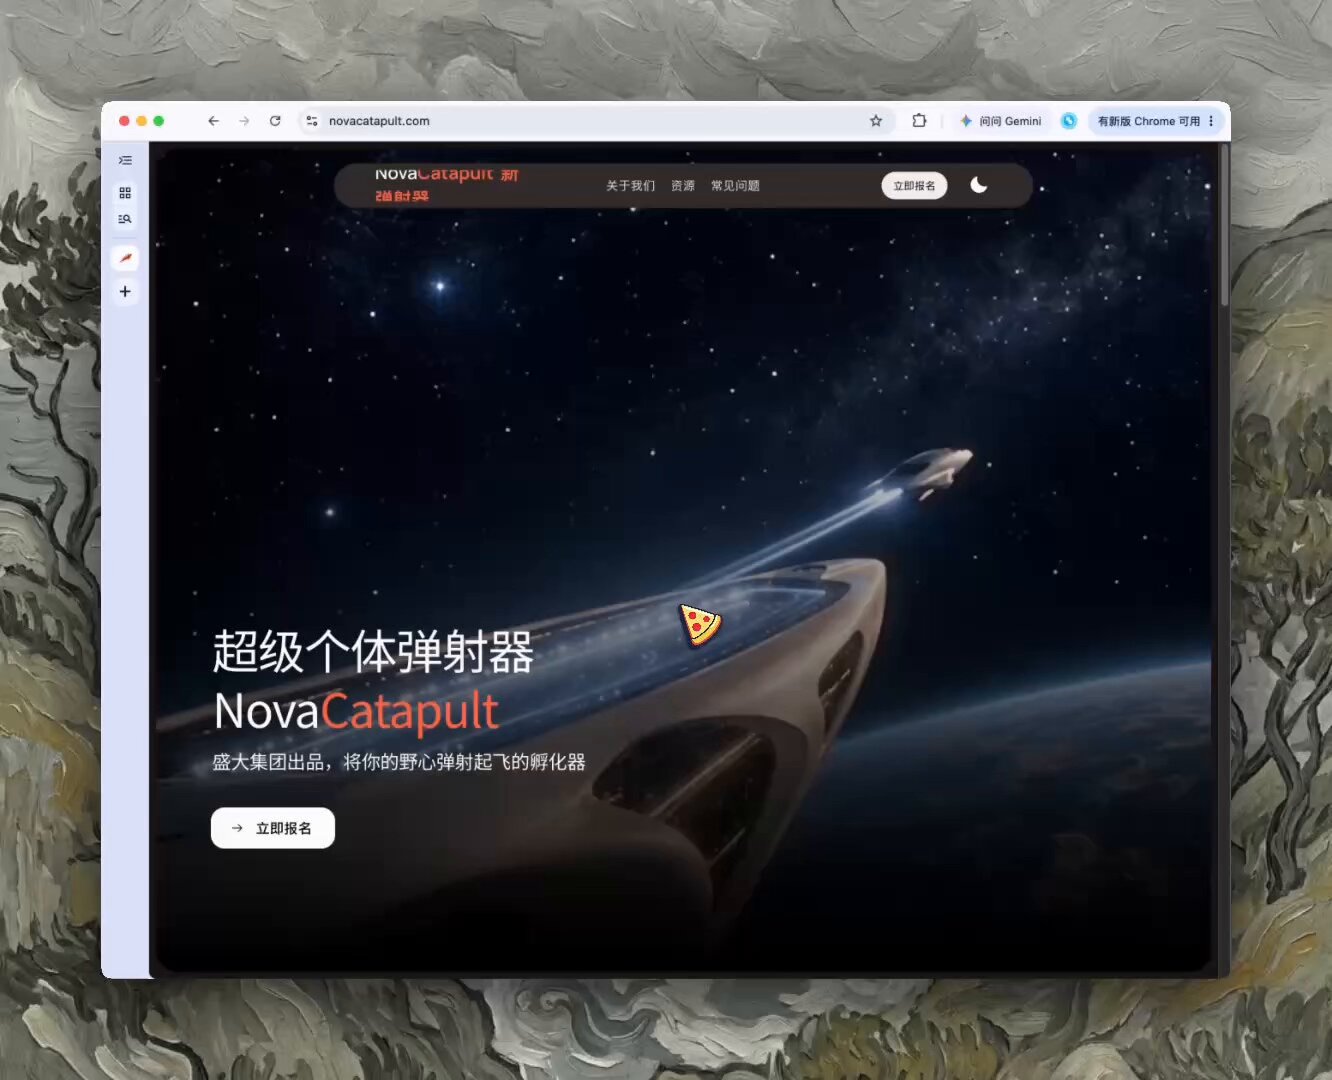
盛大集团推出 NovaCatapult「超级个体弹射器」计划,面向独立开发者和小创业团队招募项目,提供人民币100万起投的资金支持(50万现金+50万算力资源)。除资金外,还提供内部算力集群调用、资深工程师架构评审、增长团队获客协助及生态渠道对接,以及法务、HR、财税等后台支持。该计划为投资孵化性质,涉及股权条款,要求核心创始人全职到岗,目前以上海、北京为主。作者还提供内部推荐渠道,欢迎有Demo和进展的团队报名。
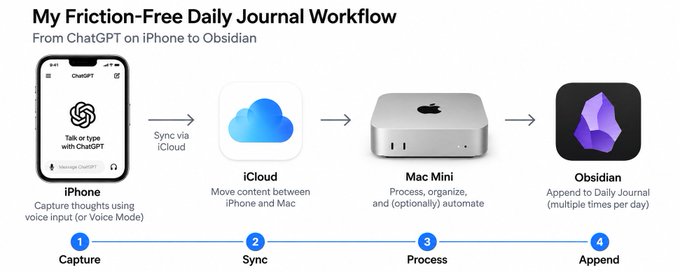
作者分享了一套用 ChatGPT 语音输入替代传统日记的低摩擦记录流程:在 iPhone 上通过 ChatGPT 随时语音捕捉灵光一闪的念头,用约定的三层结构(原始记录、结构化整理、AI评论分离)让 AI 整理成 Markdown,再通过 iPhone Shortcut「Save The Journal」把内容存入 iCloud Drive 的 DiaryInbox 文件夹,最后由 Mac 上自动运行的 watcher 脚本(用 Codex 搭建)按时间戳排序、去重、追加到 Obsidian 的 Daily Journal 对应日期文件中。整套系统全部基于已有 Apple 生态工具,强调零摩擦、不覆盖、幂等处理。
2026年《Nature》研究基于英国生物银行近50万人数据,将睡眠时间与23种生物衰老时钟关联,发现睡眠与生物衰老呈U形关系:睡得太少或太多都会加速衰老。最佳睡眠区间约为6.4—7.8小时,研究覆盖大脑、肺、肝脏、免疫系统、皮肤等17个器官系统。与6—8小时组相比,短睡眠和长睡眠组全因死亡风险均更高(风险比分别为1.50和1.40)。作者强调这是观察性研究,核心不是追求精确数字,而是建立稳定规律的睡眠节奏,避免长期偏短或偏长。中年以后更应守住睡眠,把睡眠作为健康管理的底层系统。
飞书与豆包工作联合发布全新功能“豆包工作伙伴”,这是国内首个面向团队的共享Agent。它可以拥有独立人设和组织身份,被拉入企业群聊,参加会议、阅读文档与代码、主动推进工作,并可接入GitHub、多维表格、知识库等系统。文章对比了Anthropic发布的Claude Tag(被Karpathy称为AI用户体验的第三次范式),指出两者本质都是给Agent一个独立身份,让它安全可控地为整个组织服务,从而大幅降低协作成本。作者因深度体验后决定将公司沟通从微信全面迁移到飞书,认为企业拥抱AI的未来将从飞书开始。
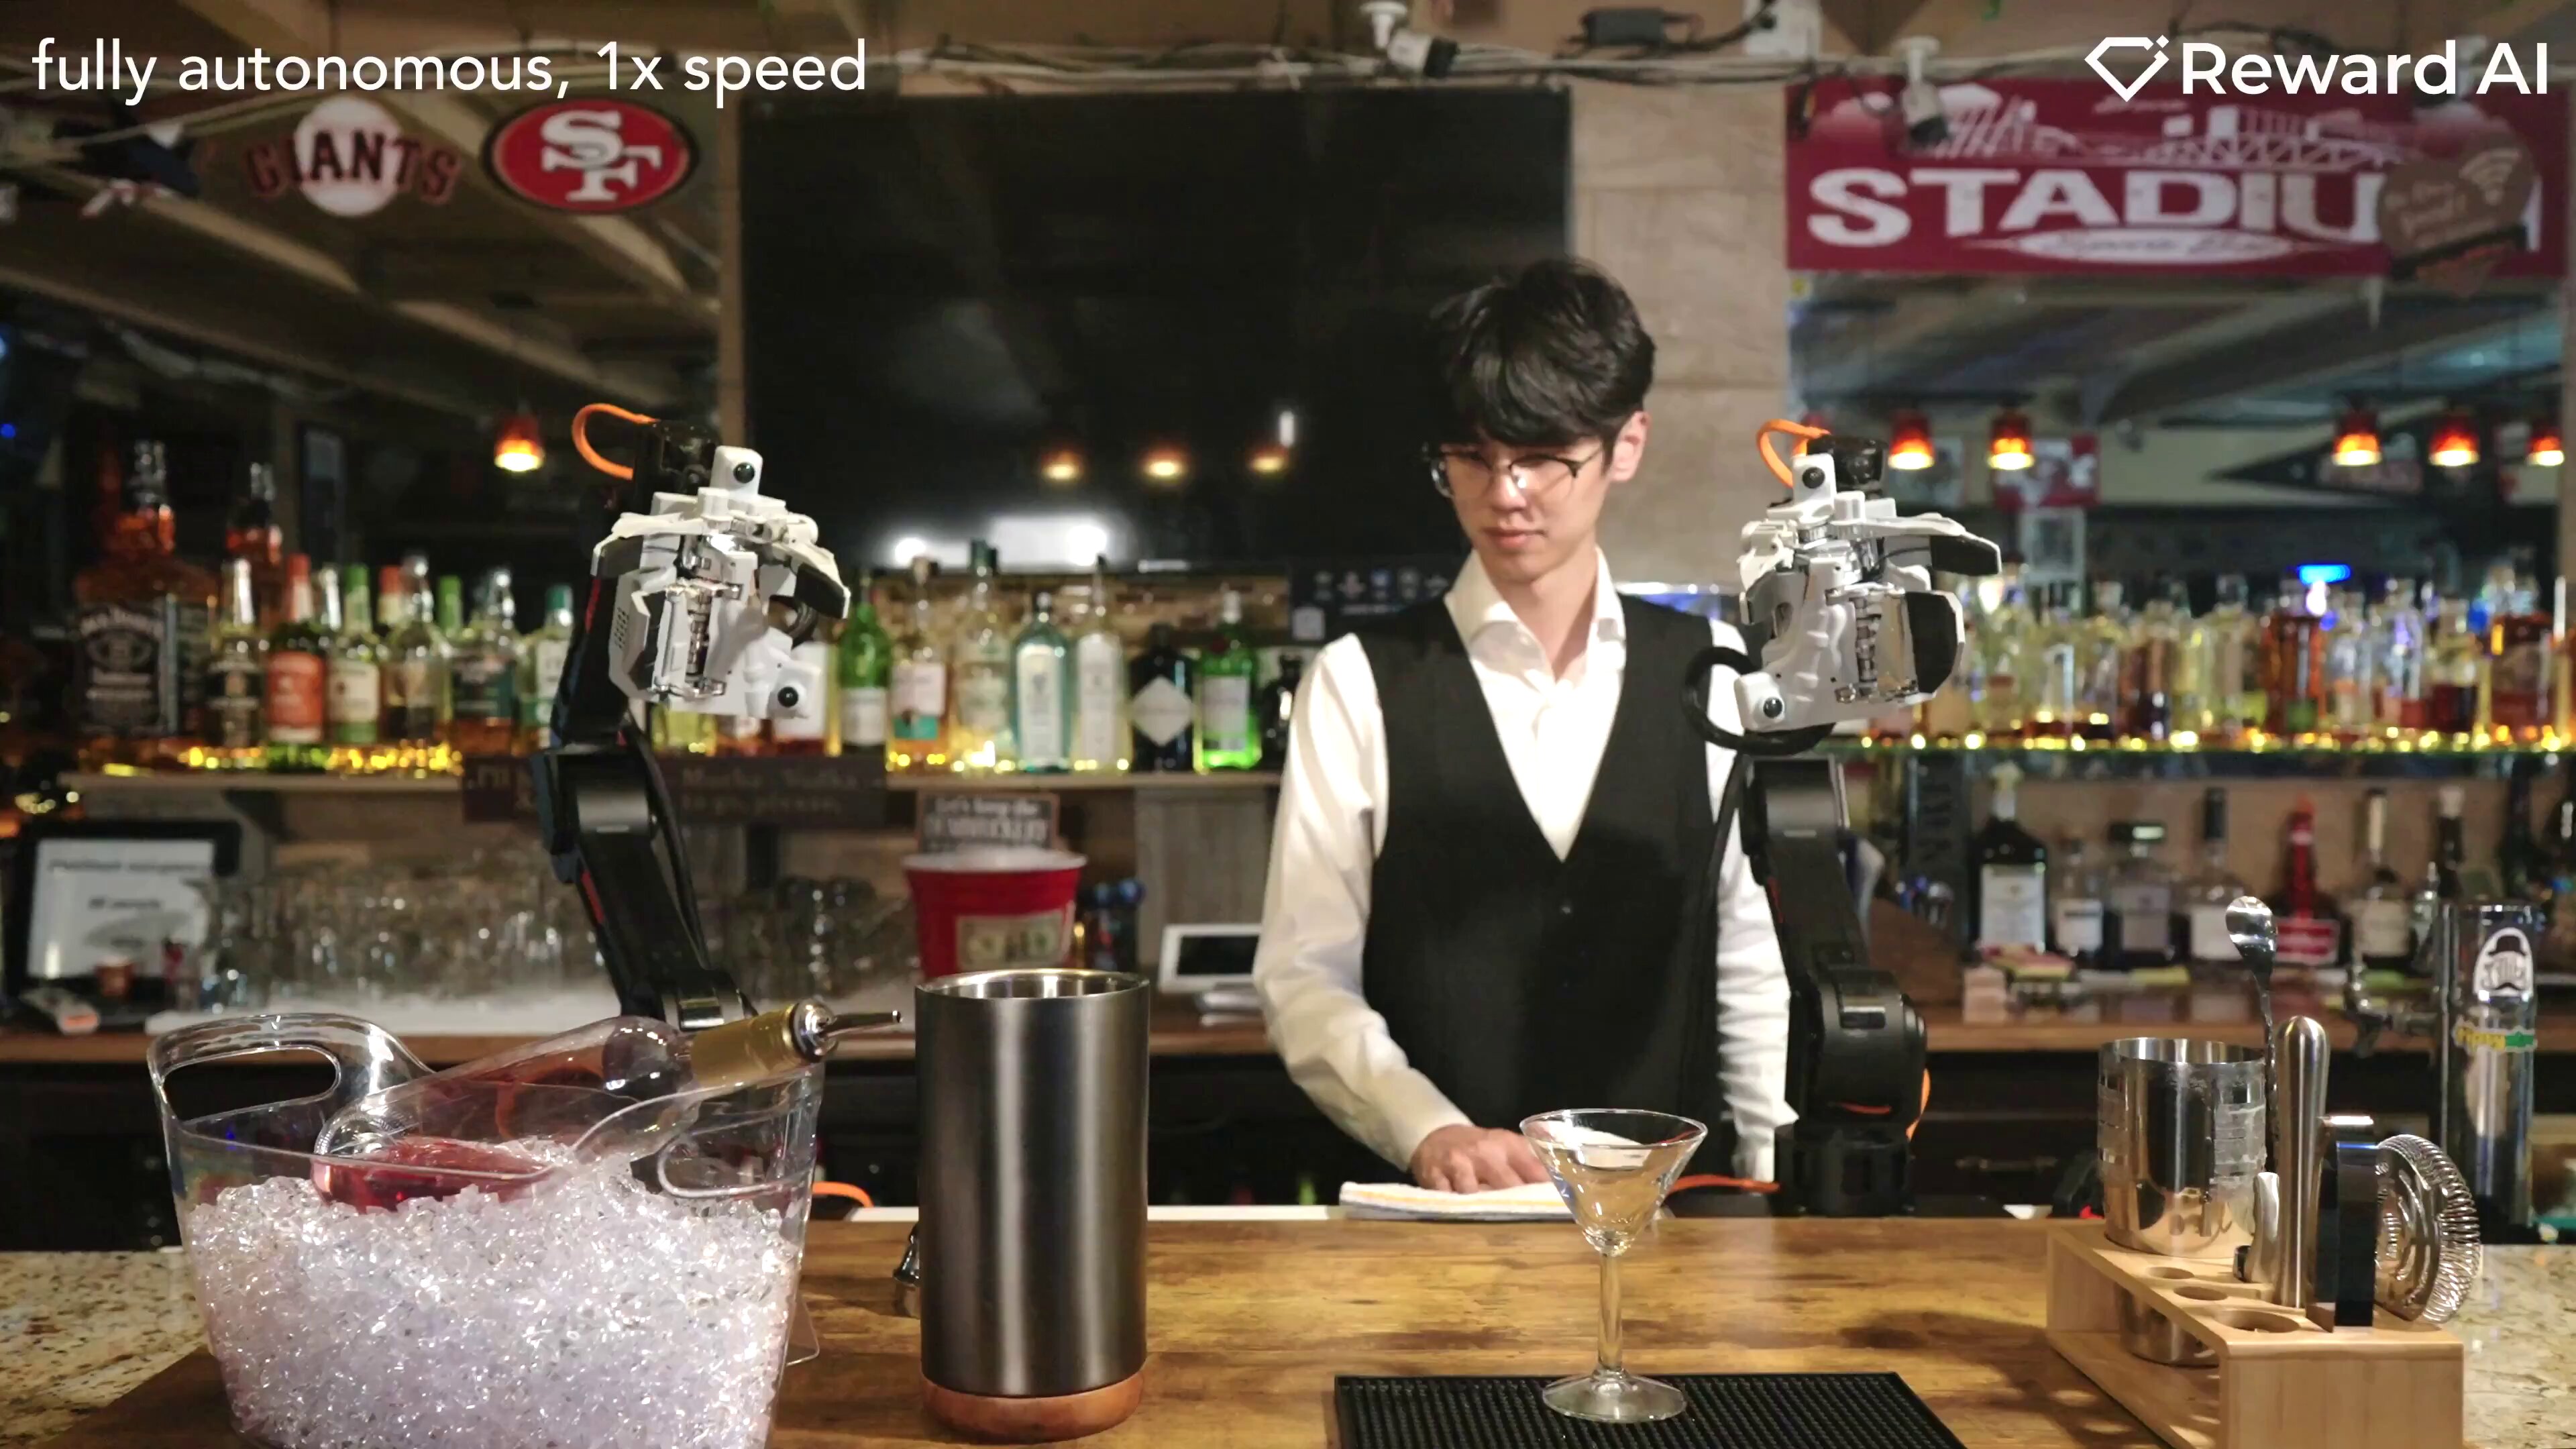
Reward AI(脱胎于斯坦福 DexCap 项目)发布机器人基础模型 OM-1,核心创新是仅从人类操作数据中学习,无需遥操作和机器人专属数据。通过 7 自由度可穿戴设备 Omnibody Hand 采集视觉、触觉、力度等多模态数据,训练后可直接部署到桌面机械臂、工业机械臂和人形机器人,无需针对硬件微调。这与 π0、Helix 等依赖遥操作数据的主流方案路线不同,大幅降低数据采集成本。演示显示 OM-1 能完成四臂协作包装手机、调酒、叠衣、拔网线等精细任务,学习新任务仅需不到 30 分钟人类演示数据,并展现自发补偿与重试行为。目前处于研发展示阶段。
文章介绍开源项目 Hypit,称其为'AI 时代的合法印钞机'。Hypit 让 Coding Agent(如 Claude Code、Codex)学会完整地制作视频——包括脚本、配音、字幕、B-roll、特效和渲染。核心能力是'克隆'爆款视频:自动拆解视频的镜头切换、台词、字幕风格、节奏等结构,变成可编辑组件,然后像换皮一样批量生成变体,把过去 3-5 天的剪辑工作压缩到十几分钟。作者实测一条命令即可复刻广告片并快速换人物出新片,认为这将重构内容生产线,适用于短视频、MCN、知识付费和广告制作等场景。
一位工业设计师结合字节Seedance2.0引发的视频制作变革,反思AI对工业设计行业的冲击:AI已能生成草图、3D模型、自动分件和渲染,传统设计链条中的执行型工作正被吞噬。作者认为这不是泡沫而是生产力重构,行业将出现分层——执行能力被替代,判断力和产品嗅觉被放大。AI砸低门槛的同时抬高上限,普通设计会泛滥,真正有洞察的设计更贵。未来一个人加AI可成为微型设计公司,设计师的定义正被改写,要么学会冲浪,要么被淹没。
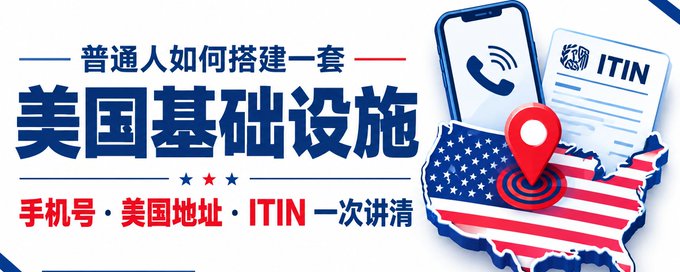
文章系统讲解搭建美国金融基础设施的三个基础要素:美国手机号、美国地址和ITIN。作者澄清了常见误区,指出这三者不等于美国身份。手机号方面建议选择T-Mobile、Ultra Mobile等正规运营商号码,避免虚拟号码的坑;地址方面强调收件地址、虚拟地址、住宅地址用途各异,不可混用于KYC;ITIN是美国IRS签发的纳税识别号码,仅用于税务目的,不能替代SSN,也不赋予移民身份。作者建议缺什么补什么,不必为伪装美国用户而堆砌配置,KYC和税务记录应从一开始就走正道。
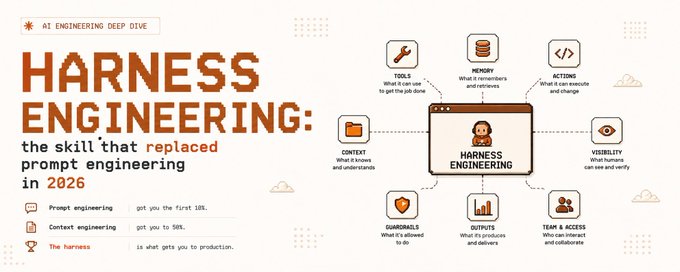
文章指出,2024年的核心技能是提示词工程,2025年是上下文工程,而2026年两者已被吸收进Harness Engineering。88%的企业AI Agent项目无法上线,问题几乎不在模型,而在模型外围的执行层。作者详细阐述了生产级Harness的七层架构:工具编排(草稿-提交模式防止危险操作)、验证循环(制作者与检查者分离)、上下文与记忆管理、护栏(行为/数据/工具/运营四类控制)、可观测性等。并以Anthropic Claude Code质量退化为案例,说明问题源于Harness层而非模型本身,强调Harness设计才是AI Agent产品质量的决定性因素。
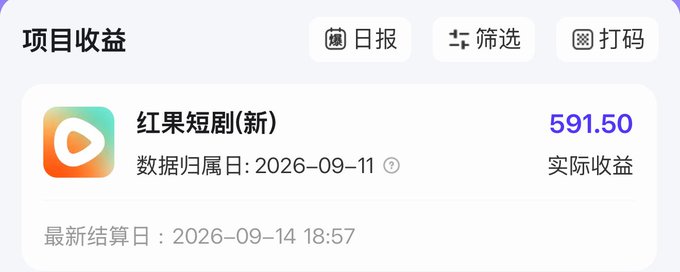
作者凯迪分享红果短剧拉新项目,称其为新上的小风口。该项目操作简单,学员中一条作品收益500+的不少。操作流程分两步:一是通过公众号'达人服务助手'输入邀请码k8888入驻平台;二是在神图君平台找到红果短剧项目开通推广权限,目前拉新一单9.5元,促活一单4元,T+2结算。作者还提到此前分享的豆包PC版和剪映PC版拉新项目收益不错,自己可获团队收益5%的分成。免费教程可在公众号'凯迪创业笔记'后台发送口令'红果短剧拉新'领取,并可加入项目社群获得官方客服解答。
文章以'读长文档只要三条结论为何很慢,写两千字演讲稿反而很快开口'为切入点,讲解 LLM 推理的 prefill 与 decode 两个阶段。Prefill 并行处理全部输入 token 并保存 KV cache,决定首 token 延迟(TTFT);decode 自回归地逐个生成 token,受内存带宽影响,影响 token 间隔(ITL)。文章进一步介绍 chunked prefill、prefill/decode disaggregation 和 prefix caching 三种优化手段,并以 EXO 用 DGX Spark 做 prefill、Mac 做 decode 的演示说明跨设备分工的可能性,帮助读者具体分析 AI 响应慢的原因。
DeepSeek kernel 工程师 shengyu Liu(interestingLSY)撰文讲述 AI 对自身职业的冲击。他负责 DeepSeek V4.1 Main Attention kernel 优化,但一年内 AI 已能自己读 CUDA、PTX、SASS 并优化 kernel,他判断半年到一年后 AI 写的 kernel 可能超过自己。他真正难受的不是失业,而是工作从亲手写 kernel 变成驾驶 Agent 写 kernel,多年练就的手艺不再重要。他还担忧社会将走向两个极端:生产力极大释放的共产主义式未来,或极少数公司垄断最强 AI 的赛博朋克式未来。他选择留在 DeepSeek 开源更强的 AI,把世界往好的一端拉。
作者图南分享处理40万字行业调研资料的AI提炼方法论。指出直接让AI总结长文本会导致废话输出,原因包括'迷失在中间'的注意力规律、提问过于宽泛等。他提出'四步漏斗提炼法':认知骨架扫描、逆向审讯抽脂、红蓝对抗挑刺、知识资产封装,并附上4套实测可用的即插即用Prompt,强调用户需自己掌控提问节奏,用结构化认知建立AI时代的护城河。
本文深度拆解 Lauren 的 pstack 第二篇,探讨如何让 AI Coding Agent 在写代码前正确理解问题。文章介绍了 /how、/why、/teach、/recall 等上下文工具的用法,强调用代码而非文档来规划:先写使用教程倒推架构,通过低成本原型比较不同方案,用 /architect 让多模型并行设计并交叉评审,以及在多阶段计划中要求每一步都以可复查的证据结束。作者认为,Agent 可能比人更快更强,但最终是否接受方案仍需人来判断,验证应从开发前就开始参与决策。
作者 Jeremy Xu 分享了面向小白的 AI 产品思维提升方法。文章强调产品思维无法速通但可通过正确方法在三个月内见效,提出核心观点:产品最重要的是满足用户需求而非获取流量;AI 时代的创新都踩在巨人肩膀上而非灵机一动;产品 taste 是可复制的方法论,包含交互体验(组件化最佳实践)和效果体验(benchmark 思维)。作者建议通过餐厅排队、摆盘等生活实例训练『系统二』主动思考,将产品思维锻炼成本能习惯,并给出 24 小时内可开始的三问练习法。
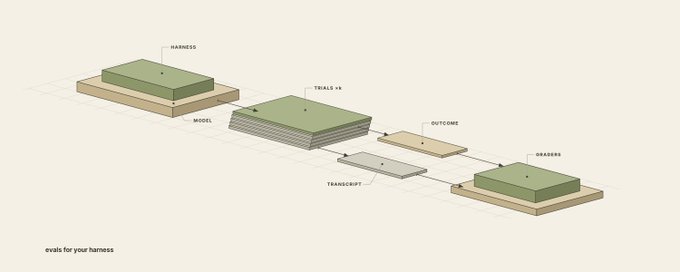
文章探讨了 Agent 评估(evals)的重要性与实践方法。作者将 Agent 定义为模型加 Harness 的组合,区分了模型评估与 Harness 评估,并对比了 SDLC 中的测试与 ADLC 中的评估差异。文章澄清了评估的核心概念(task、trial、outcome、grader 等),指出评估的冷启动门槛比想象中低,从真实失败案例中提取 20-50 个任务即可起步。作者强调应只构建任务完成率和正确性两个基础指标,主张评估结果而非路径,并建议纳入负向用例、部分得分机制,坚持阅读轨迹记录,关注分心、token 消耗、延迟、上下文膨胀和一致性等信号。
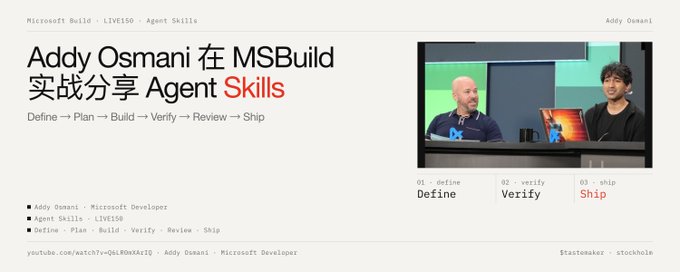
Microsoft Build 2026 现场访谈中,Addy Osmani 介绍了 Agent Skills 的概念:将专业判断打包成 AI Agent 可执行工作流的标准化方式,类比新时代的 dotfiles。他展示了围绕软件研发生命周期(Define→Plan→Build→Verify→Review→Ship)组织的 Skill 仓库,统一遵循 Overview/Rationale/Red flags/Verification 设计模式,并现场演示 45 分钟从模糊想法到完整应用的全流程。访谈还探讨了人在回路中的代价、尽责程度与风险成正比、安全审查的非确定性困境、MCP 与 Skill 的对比及多模型分工等观点。
本文整理了 Pi Agent 作者(也是 Flask 作者)Armin Ronacher 关于 AI Agent 的九条反直觉判断:极简 harness 因 bash 管道省上下文而胜出;当前 agent 仍处 DOS 时代,缺持久性与 Web 原生体验;许多 AI 问题实为系统架构问题;人类不会退场,可问责性与可内省性是刚需;开源等于进入训练数据的门票;企业 AI 编码投入的成本显现快于收益;他个人工作流保守;担心 AI 重蹈社交媒体覆辙;欧洲因碎片化而掉队。