Eval Engineering: the step that turns a $200 model into a $200,000 system
文章探讨了 Eval Engineering 的重要性,指出通过构建评估层,可以将基础模型转化为高价值系统。作者介绍了一种利用现有工具(如 LangChain、AWS 等)搭建评估引擎的方法,强调通过自动化的评估反馈机制来提升 Agent 的准确性和可靠性。
文章探讨了 Eval Engineering 的重要性,指出通过构建评估层,可以将基础模型转化为高价值系统。作者介绍了一种利用现有工具(如 LangChain、AWS 等)搭建评估引擎的方法,强调通过自动化的评估反馈机制来提升 Agent 的准确性和可靠性。
文章介绍了如何使用 Agent-Native 框架构建 Agent First 应用。通过统一的前端动作与 Agent 工具,实现 UI 与 Agent 的双向同步。应用支持通过聊天交互、集成外部 Agent、A2A 通信及自动化任务,且完全开源。
本文讲述了camelAI团队如何将Agent从虚拟机迁移到Cloudflare Durable Object中。通过利用SQLite和R2作为文件系统,并用JavaScript替代bash,团队解决了高昂的基础设施成本问题。尽管限制了Agent只能使用预定义的方法,但这提高了性能和安全性,并优化了产品体验。
文章介绍了如何利用Supermemory快速构建一个“公司大脑”,即基于知识库和Agent的综合系统。通过邀请机器人加入Slack、连接工具、自动化任务等步骤,企业可以拥有一个具备全公司知识的高级AI员工,用于销售、工程、研发等多种场景。
本文复盘了一个企业级售后工单 AI 工作台的开发全流程。项目经历业务定义、产品设计、技术选型、开发实现及验收部署六个阶段,最终交付包含权限管理、知识检索、审计等功能的完整 Agent。文章总结了“AI 执行,人做选择”的协作模式,强调证据留存与工程边界,提供了一套可复用的 AI 辅助开发方法论。
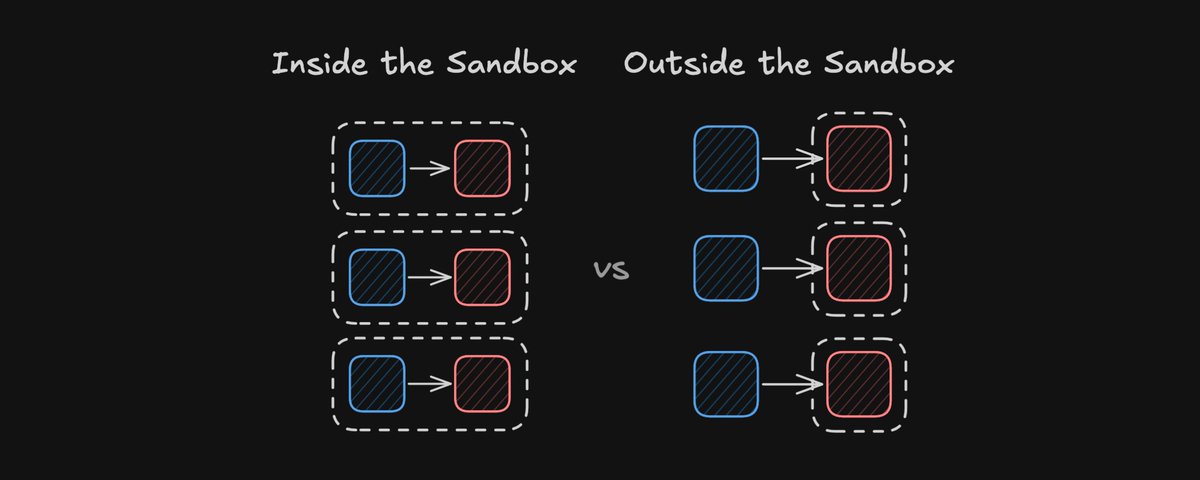
本文探讨了2026年以来关于Agent运行位置的争论,指出行业趋势是将Agent运行在沙箱之外。作者详细解释了沙箱内运行的三个主要问题:爆炸半径、信任边界和沙箱的间歇性运行,并提出了将沙箱作为工具暴露的正确架构,最后提供了基于Vercel AI SDK的实现示例和生产环境中的挑战。
作者分享了使用 Orca 进行 Graph Engineering 的实践经验,通过拆分任务给 Agent 执行,结合编排调度和真机验收,解决了长任务拆解、动态调整依赖和防止假成功的问题,强调了 Graph、Eval 和权限控制三者结合的重要性。
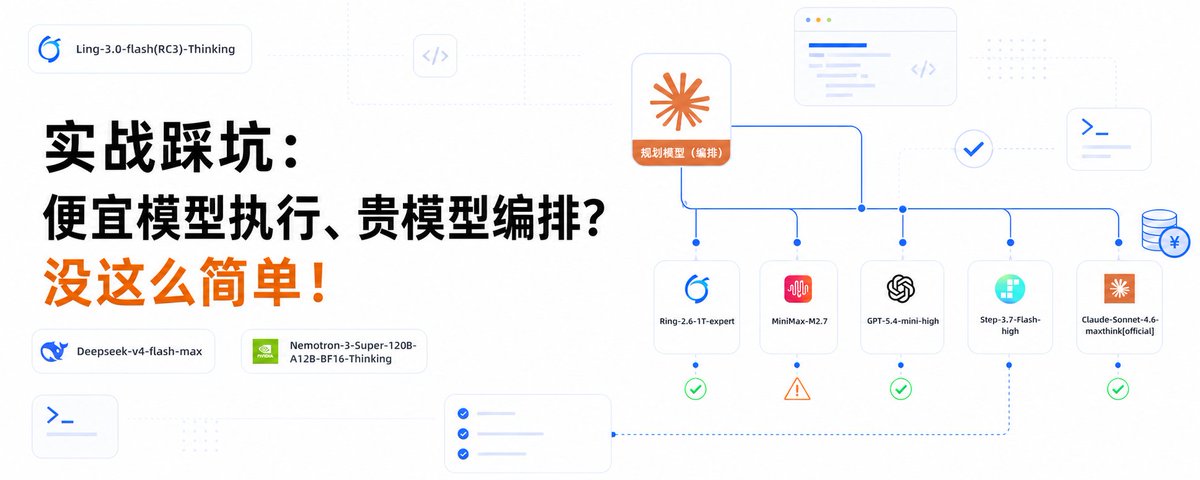
文章通过三个真实案例,验证了“贵模型编排、便宜模型执行”这一省钱策略。作者发现,虽然便宜模型在文本判定等任务上能打平顶尖模型,但在高复杂度代码和开放式视觉任务上存在局限。关键在于控制模型能力代差和任务可验证性,否则返工成本将抵消节省的 token 费用。
本文探讨了如何构建自动化营销智能体来解决获客难题。文章详细介绍了营销智能体的定义、基于WordPress的AI商业化场景,以及利用Facebook和Google广告API进行自动化投放的五步流程。通过数据闭环和持续优化,该系统旨在替代传统昂贵的代理服务,实现高效的市场测试与转化。
作者将 TikTok 运营工作流封装成 Codex Agent Skill,结合达人精灵 MCP 数据,实现选品、账号诊断、类目研究和增长规划的自动化。文章详细介绍了四个核心技能的安装、配置及具体 Prompt 使用方法,解决了 AI 运营中的幻觉与流程混乱问题。
作者讲述侄子利用暑假开发两个健康类 Agent Skill 的经历。从“养生谣言粉碎机”到“体检行动助手”,解决了大模型幻觉、信息检索权威性及流程设计等难点。文章重点介绍了如何利用豆包搜索 API 的结构化数据与权威过滤功能来增强 Agent 能力,并分享了 Skill 开发优于独立 Agent 的实践经验和建议。
文章通过对比人脑的双速学习机制(海马体与皮层),指出当前 AI Agent 仅依赖大模型权重的局限性。真正的长周期智能需要将预测模型与经验状态结合。现有的外部记忆存储实则是模拟海马体的快速捕获功能,未来的关键在于实现高效的记忆筛选机制。
文章对比了 Serper(Google 封装)与豆包搜索在 Agent 应用中的表现。豆包在 Query 改写、结构化数据(汇率/股价)、跨语言检索、时效性过滤及信源权威度分级上优势明显,更适合处理中文口语化及实时信息需求;而 Google 在英文学术检索上仍占优。文章指出高质量搜索 API 对提升 Agent 推理能力至关重要。
本文基于 Daniel Miessler 的 PAI 框架,阐述了如何构建个人 AI 基础设施。核心观点包括从自我定义而非工具开始、利用 TELOS 身份系统构建画像、建立三层记忆架构、遵循代码优于 Prompt 的确定性原则,并提供了一个分阶段的实践路线图,旨在将 AI 升级为持续学习的数字助理。
文章介绍了作者使用 Herdr 和 Hermes Agent 构建的多智能体工作流。Herdr 作为类似 tmux 的多路复用器统一管理多个 AI 编程代理,Hermes 则作为开源的总部代理负责驱动其他代理。作者分享了三个实用技巧:基础编排、技能创建以及状态检查汇报,从而将混乱的终端窗口转化为高效的系统。
本文介绍了如何通过 MCP 协议将百度网盘与闲鱼连接,利用 AI Agent 自动化完成从网盘选取资料、生成文案到闲鱼发布商品的流程。文章详细讲解了环境配置、接口接入及常见坑点,帮助读者建立自动变现系统。
文章通过27个真实案例,分析了如何利用WorkBuddy的5个核心功能(定时自动化、多Agent并行、Skill技能包、MCP连接器、记忆系统)实现自动化赚钱。作者指出,赚钱的人将AI当作员工用,构建自动化工作流,而不赚钱的人仅将其视为聊天工具。
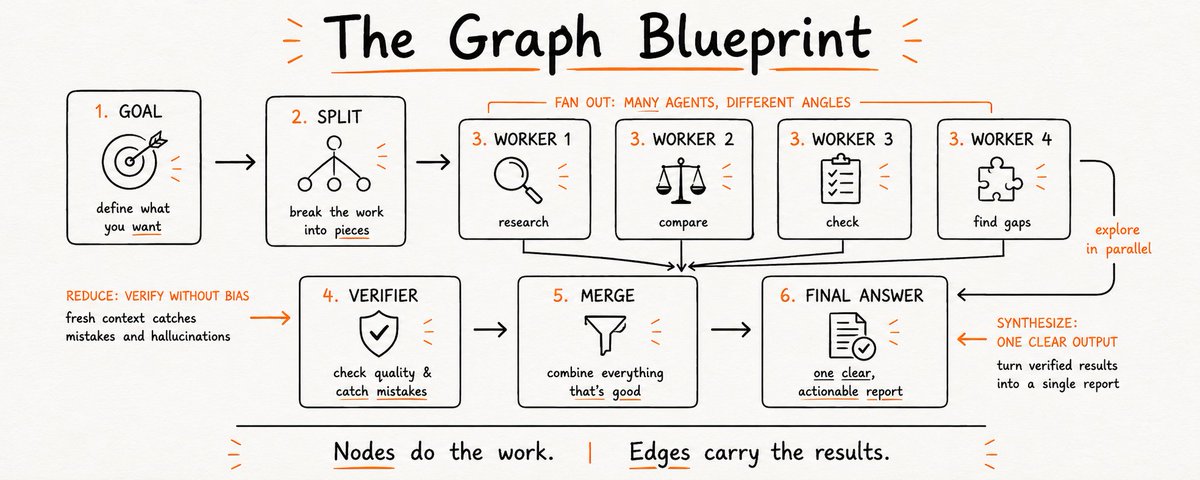
文章介绍了 Graph Engineering,一种通过流程图协调多个 AI 协作完成复杂任务的方法。它将复杂任务拆解为节点、边和状态,解决了单 Loop 应对复杂任务时的局限性。文章详细解析了 Graph 的核心概念、与 Loop 的关系、四个核心模块及具体实践模板,并提供了新手学习路径。
作者分享了重构 Hermes 多代理系统的经验,批评了当前将角色扮演误认为真正多代理系统的现象。文章提出了三种架构模式:一次性子代理、永久专家配置和群体,并强调了编排者的重要性。作者以 Wu-Tang Clan 成员命名不同职责的代理,展示了严格的权限边界和清晰的职责分配。
本文介绍了通过一张模特图和一段提示词生成电商模特换装视频的技术,解决了跨境电商聘请外模成本高的问题。提示词详细描述了生成竖屏变装视频的步骤和约束条件,包括固定机位、旋转转场、同步换装等。
本文对比分析了开源命令行编程工具 Pi 与 Claude Code、Codex 的性能。Databricks 的评测显示,Pi 在真实代码库上的 token 消耗显著更低,性价比极高,甚至压过了官方工具。文章探讨了 Pi 高性价比的原因,如精简的系统提示词,并指出了其在高强度思考下的局限性及功能缺失。
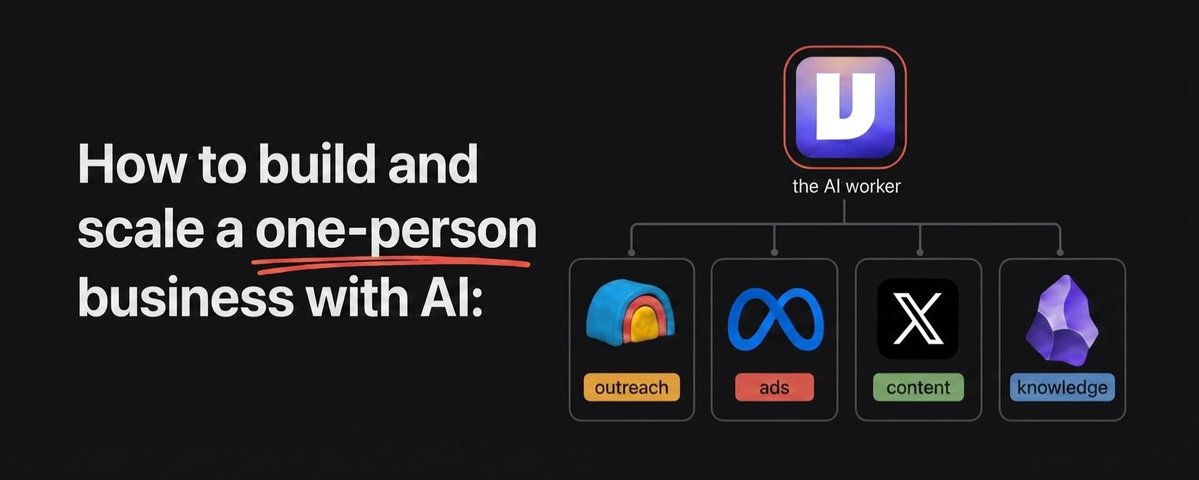
文章介绍了利用AI构建和扩展单人企业的完整蓝图。通过使用AI员工(如Viktor)在内容、项目、拓展、财务和广告五个领域实现自动化,只需保留决策环节。文章探讨了两种构建方式:快速路径和自定义构建,强调业务知识库和操作规则的重要性。
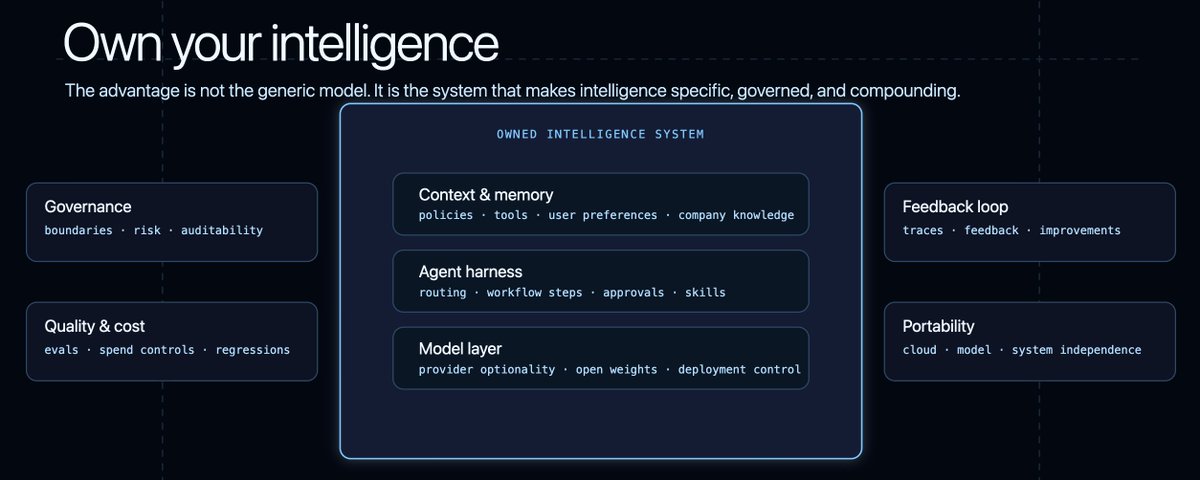
文章探讨了企业如何在通用 AI 基础上构建差异化优势。作者指出,未来五年公司需掌控智能的运作方式、管理与复利,而非仅依赖现成模型。掌控智能包括控制 Agent 系统(模型、调度逻辑、上下文)、掌控质量与风险,以及通过反馈循环积累智能,从而实现业务的深度集成与持续优化。
本文探讨了金融领域中Agent图的设计与实现。文章指出,Agent图解决了脚本在等待、重启和并行分支上的缺陷,并通过状态图而非DAG来实现条件路由和循环。重点讨论了状态管理、并行拓扑模式(如Fan-out、Supervisor)以及在金融任务中的实际应用。
文章介绍了图工程的概念及其在AI工作流优化中的应用。图是由节点和边组成的计划,通过识别和消除伪依赖,可以显著提高工作流的并行性和效率。文章重点介绍了“钻石模式”,即扇出、归约和合成的模式,这是提升AI系统性能的关键技巧。
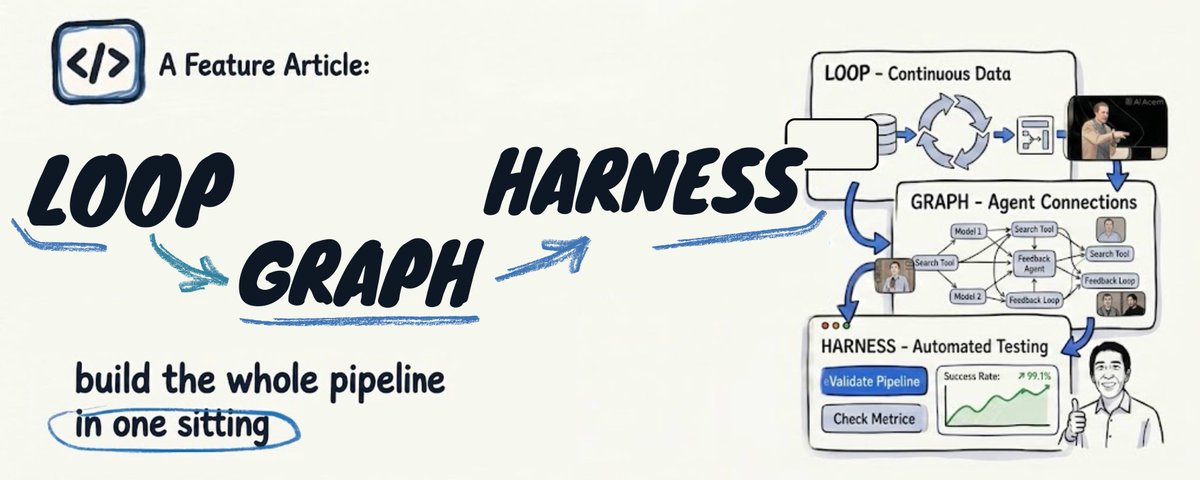
本文提出解决Agent重复读取数据和Token浪费的三层架构方案:Loop负责单元工作的收集-行动-验证闭环;Graph通过分发和并行管理复杂任务;Harness作为运行时环境提供工具和上下文隔离。文中提供了具体的代码实现思路和实战演示。
Ryan Carson 分享了如何作为唯一员工,通过管理云端 AI Agent 团队日处理 40 个 Pull Request 的经验。文章详细介绍了将工作迁移至云端、建立工作节奏、将重复检查自动化以及控制 Token 成本四个关键步骤,强调在 AI 时代,优秀的工程管理能力比以往任何时候都重要。
本文介绍如何利用 Claude 结合特定技能实现 SEO 自动化。42 家 SaaS 公司通过 Claude 学习业务、分析 GSC、筛选高转化关键词、撰写优质内容并交换外链,最终获得 130 万次自然点击。文章详细拆解了从关键词规划到内容发布的完整工作流。
文章介绍了 Trajectory,一个开源的数据格式标准化工具,旨在统一不同编码代理会话(如 Claude Code、Codex 等)的数据格式。该格式注重令牌效率,便于代理从过去的经验中学习,解决跨平台数据碎片化问题。
文章介绍了一个由多个专业 Agent 组成的图系统,用于自动化商业机会扫描、分析和验证。该系统通过并行处理和独立验证机制,解决了人工研究效率低的问题,仅在发现高质量机会时唤醒用户。