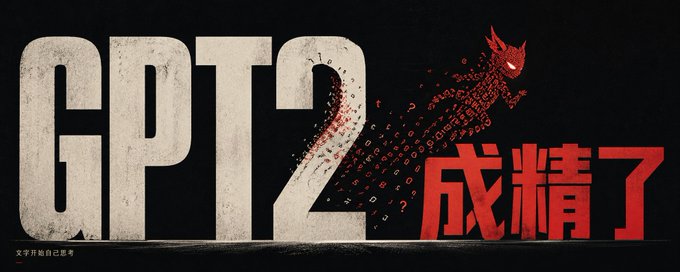
GPT2 提示词:将单词与情感视觉化的概念艺术
文章分享了两个用于 GPT-2 的提示词版本(无地面版和有地面版),旨在通过 AI 生成基于词语含义的高级视觉隐喻海报。提示词详细规定了从语义理解、构图逻辑、色彩控制到文字排版的执行原则,强调将文字、图像与空间紧密结合,以极简、强概念的方式准确传达词语的情绪与内涵,而非简单的图文堆砌。
文章分享了两个用于 GPT-2 的提示词版本(无地面版和有地面版),旨在通过 AI 生成基于词语含义的高级视觉隐喻海报。提示词详细规定了从语义理解、构图逻辑、色彩控制到文字排版的执行原则,强调将文字、图像与空间紧密结合,以极简、强概念的方式准确传达词语的情绪与内涵,而非简单的图文堆砌。
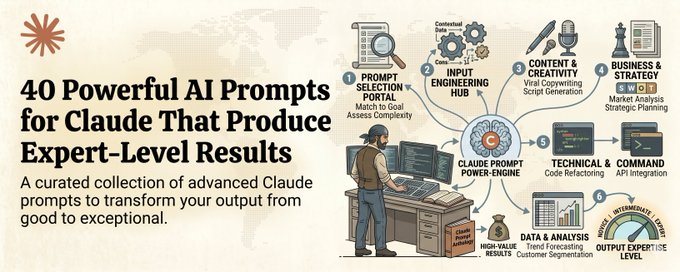
文章作者分享了经过 500 多次测试后筛选出的 40 个高质量 AI 提示词,旨在帮助用户获得专家级的输出结果。这些提示词不仅适用于 Claude,也兼容 ChatGPT 和 Gemini。内容涵盖写作、内容策略、分析等多个维度,通过设定角色、上下文、约束条件和质量标准,将简单的指令转化为工程化的指令,确保输出内容无需编辑即可直接使用。
文章分享了一款用于生成中国风诗歌解析海报的GPT提示词。该提示词要求海报包含霸气的手写体标题、设计感强的排版解析以及5-10个融入画面的知识点。用户可根据主题(如诗句、地点)自定义补充要求、原诗全文展示及海报比例,旨在兼顾视觉美感与知识传播,适合制作语文教学或文化科普素材。
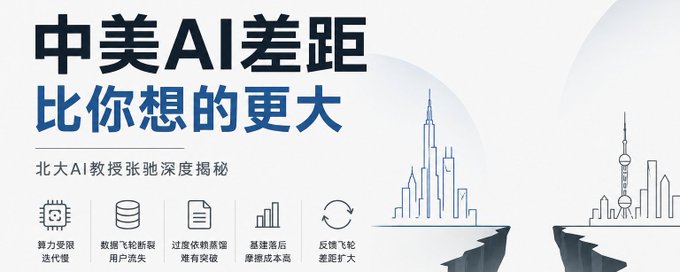
北大教授、前字节跳动算法专家张驰分析中美AI现状。他指出国内大模型存在“应试刷榜”、基础算力设施薄弱、高质量数据飞轮断裂等问题。因国产模型体验差距,顶尖开发者纷纷流失至美国产品,导致数据反馈闭环恶化;过度依赖模型“蒸馏”也限制了原创能力。尽管在硬件和具身智能领域尚存优势,但在纯软件领域的整体差距恐将持续扩大。
本文分享了作者通过十亿Token的消耗量,在三天内深度对比Claude Opus 4.7与GPT-5.5的真实心得。测试涵盖大型代码重构、Agent搭建及前端生成等场景。结论显示,GPT-5.5在推理效率、执行力和成本控制上表现卓越,已成为作者的主力工具;而Opus 4.7虽在规划与视觉分析上仍有优势,但存在Token消耗激增、上下文检索变差等“倒退”问题。文章还总结了Reddit社区的声音,提出了“Opus规划、GPT执行”的Handoff最佳工作流。
这是一篇关于如何通过 GPT 模型生成具有真实感、非摆拍、第三方旁观视角的摄影提示词教程。文章详细定义了“街拍纪实”的核心气质,强调人物清晰度、自然遮挡、真实光影与构图逻辑,并严格限制仅限合规的公开空间观察,旨在生成高真实度的日常生活抓拍图片。
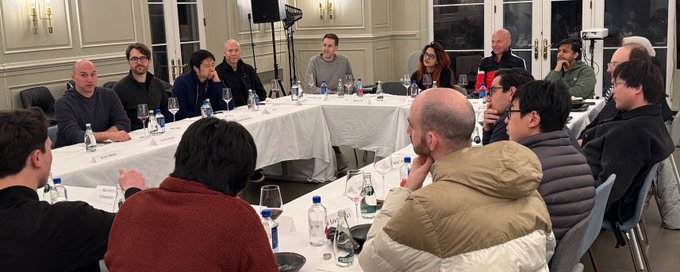
本文记录了 AGI House 举办的一场关于前沿 AI 研究的晚宴讨论。参与嘉宾包括来自 OpenAI、Google DeepMind、Meta 及斯坦福等机构的顶尖研究人员与投资人。讨论重点从单纯的模型规模扩展转向系统化智能,核心观点包括:机器人仿真即将迎来类似 LLM 的突破时刻、智能将从目前的串行处理转向并行处理、AI 代理(尤其是编程 Agent)可能是通向 AGI 的路径,以及评估体系的滞后正成为新的瓶颈。
文章分析了 DeepSeek V4 的发布及其对美国 AI 主导地位的挑战。作为一款性能逼近 GPT-5.5 和 Opus 4.7 但价格极低的 MoE 开源模型,它打破了现有的商业逻辑。作者认为,虽然该模型并非完全超越前沿水平,但其极致性价比可能导致美国企业大规模转向采用,从而引发严重的地缘政治安全风险。同时,文章讨论了出口管制、蒸馏指控及文化叙事控制等深层影响,呼吁美国加强开源策略并降低模型成本。
文章深入解读了DeepSeek V4论文,指出其核心价值在于将百万上下文、Agent原生能力与低价格结合,抬高了AI应用的地板。技术层面,V4通过mHC稳定残差连接,采用CSA+HCA混合注意力机制解决长上下文算力难题,并用Muon优化器替代AdamW。此外,文章还详细介绍了其1.6T参数量的训练稳定性技巧、反AI坍缩的数据构建以及基于“Specialist + OPD”的后训练范式转变。
当 AI 的知识广度远超人类时,传统的人机协同面临挑战。文章指出,AI 易提升人的输出能力,但未必提升判断能力。为避免人类沦为“橡皮图章”,作者建议将 AI 定位为认知脚手架、反方辩手或审计员,而非简单的答案机器。真正有效的协同,在于利用 AI 帮助人建立判断力并保持决策的可审计性与责任归属。
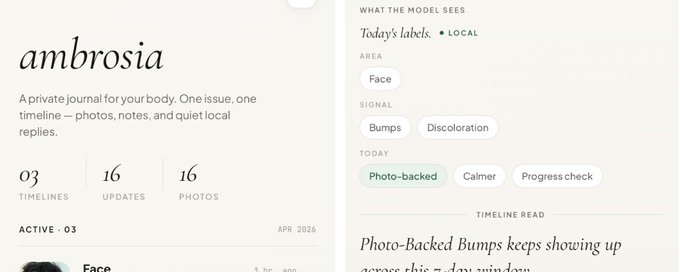
作者构建了名为 Ambrosia 的离线 AI 护肤日记应用,全过程在本地设备完成。文章探讨了端侧模型在硬件适应性、成本及隐私方面的优势,详细记录了基于 Qwen3-VL-2B 模型在本地 MacBook 上进行 LoRA 微调并在 iPhone 上部署的实践,强调了针对特定任务约束小模型比通用助手更高效,展望了边缘智能与算力结合的未来。
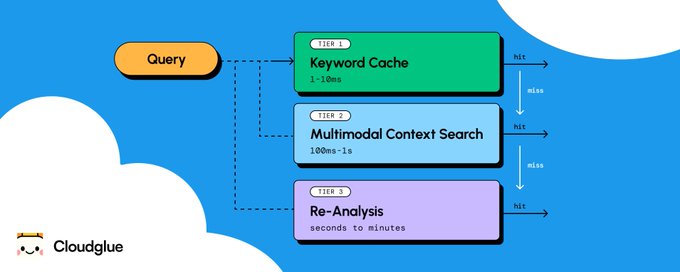
文章探讨了如何让 LLM 理解和处理海量视频数据。作者指出单纯依赖上下文窗口并非最佳方案,因为成本高昂且无法进行确定性检索。借鉴编程中的 Unix 模式,文章提出构建“中间表示层”,提前提取并结构化对齐转录、视觉、情感等多模态数据,从而实现对视频内容类似 Grep 的高效搜索与组合分析。
文章详细评测了 DeepSeek V4 模型。V4 采用混合架构,参数量达 1.6T,虽未集成多模态能力,但在推理和代码领域表现优异。作者指出该版本通过 MXFP4、TileLang 和 MegaMoE 等技术,深度适配华为昇腾等国产芯片,旨在解决算力卡脖子问题。实测中,V4 在写作和长文本处理上表现出色,但在 Agent 意图识别和复杂开发约束遵守方面仍存在瑕疵。
本文旨在消除从事 AI/ML 工作对数学博士学位的恐惧,提供了一份精准的线性代数学习路线图。文章分为五个阶段:从标量、向量、矩阵等基础概念,到特征值、SVD(奇异值分解)等核心机器学习数学工具,再到连接微积分的梯度与雅可比矩阵。作者强调了掌握这些概念对于理解神经网络、PCA、推荐系统及 LoRA 微调等技术的重要性。
文章深入对比了2026年OpenAI与DeepSeek的发展路径。OpenAI采取高定价、重商业的精装商品房模式;而DeepSeek则坚持开源低价,依托中国电力基建和昇腾芯片,将AI变成水电煤般的免费基础设施。DeepSeek通过转型重资产、引入巨额融资以对抗人才流失,并推行端侧AI与开源生态,在乌干达等全球南方地区实现数字平权,打破了硅谷的算力垄断。
文章由物理转行AI的大厂工程师撰写,针对AI自学者常见的盲目学习问题,提出先明确目标(算法或工程)和形式(写论文或做项目)的两大核心问题。作者指出2026年AI领域论文供给过剩,建议大多数人转向以工程落地为主的学习路径。文章详细拆解了传统机器学习、CV、NLP/LLM、推荐系统四大工业界方向,并结合数据分析了就业市场需求。最后,作者提倡使用“三三制”项目驱动法和“Vibe Coding”配合费曼学习法的高效学习策略。
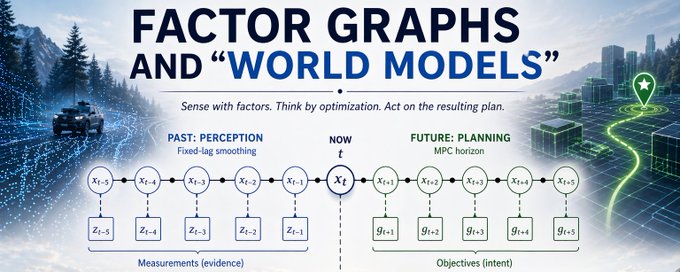
文章探讨了世界模型与因子图之间的深层联系。作者指出,因子图本质上是基于能量的模型,可用于状态估计和SLAM。通过将世界模型锚定在“现在”,文章提出了STAG框架,该框架利用统一的因子图优化机制,同时处理基于过去数据的感知和基于未来目标的规划,实现了感知与行动的无缝融合。
本文探讨了2026年AI应用模式的根本转变。核心观点是从“提示工程”转向“上下文工程”,AI不再仅仅是聊天对象,而是构建工作环境的基础设施。文章详细论述了代理式编码(如Claude Code)、开源代理框架的成熟(如OpenClaw)、以及类似Karpathy倡导的复合型知识库系统,指出拥有持久且智能的上下文层将成为未来的核心竞争力。
文章指出利用AI分析爆款文案的关键在于挖掘情绪词、隐形结构和细节,而非单纯模仿表面框架。通过AI量化“冲突”占比、分析关键词密度及情绪浓度,可以显著提升文案完读率和互动率,揭示了数据驱动的内容优化方法。
文章指出,尽管AI模型能力飞速提升,但企业部署成功率却在下降,形成了“AI实施鸿沟”。作者借用医学界的“实施科学”理论,提出将CFIR等框架引入AI领域,以解决技术落地中的组织、人员和流程问题。文章预测,到2030年,AI实施将成为一门独立学科,而解决“落地税”和“能力幻觉”将是行业的关键。
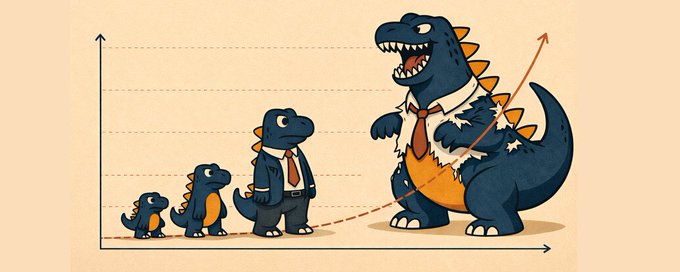
文章指出,仅仅利用 AI 自动化琐事并不是其真正价值所在。作者认为,顶级初创团队利用 AI 的核心优势在于缩短实验周期和实现并行测试。这种压缩的时间循环不仅提高了效率,更增加了知识复利的频率,从而使团队处于完全不同的指数增长曲线上。
作者通过逆向工程 ChatGPT、Claude、OpenClaw 和 Hermes 四个系统的记忆功能,发现“显性状态”往往优于“隐性记忆”。文章指出,大多数团队在存储层投入过多精力,却忽视了更关键的检索策略。默认注入记忆的模式容易导致输出质量下降,真正的解决方案应是将记忆变为模型按需调用的工具,而非被动的背景上下文。
MIT Technology Review 发布 2026 年 AI 趋势榜单,指出“低垂果实已摘完”,讨论重心从能力边界转向权力边界。榜单涵盖人形机器人数据、LLM+、世界模型等技术演进,也涉及 AI 诈骗、军事化、Deepfake 武器化等社会风险,以及中国开源、AI 科学家和反 AI 运动等地缘政治议题,强调 AI 发展面临的结构性变化。
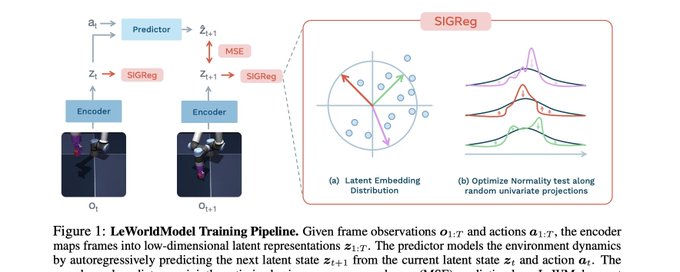
文章介绍了 LeWorldModel (LeWM),一种新的世界模型架构。它解决了当前世界模型(如 DINO-WM 和 PLDM)的局限,仅通过两个损失项(Next-embedding 预测损失和 SIGReg)实现了从原始像素开始的稳定端到端训练。实验表明,LeWM 能在潜在空间中自发涌现出时间直线性和物理约束,有效避免了表示偏差和模型崩塌问题。
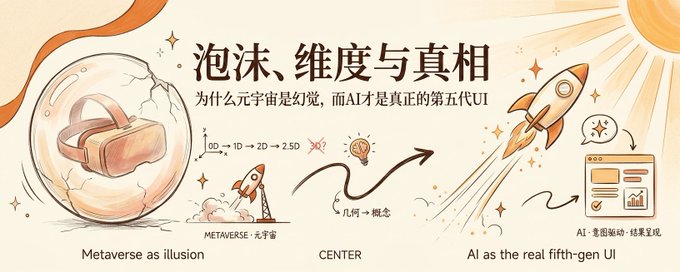
本文转引了 UX 泰斗 Jakob Nielsen 的观点,探讨用户界面的演进方向。文章指出,元宇宙受限于 3D 空间对高维信息处理的低效,注定是昂贵的幻觉;而真正的第五代 UI 是从几何维度转向概念维度,即由 AI 驱动的“基于意图的结果规格化”与 GUI 的混合范式,回归简单与直观。
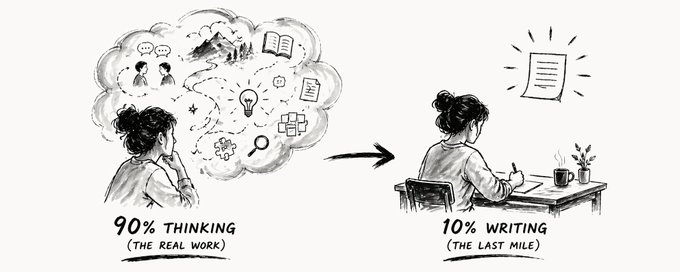
文章指出人们常误以为写作等同于生成文本,实则思考才是创作的核心。AI虽能高效完成输出,但无法替代“诗外”的功夫——即积累的生活阅历、用户洞察与判断力。真正的价值在于决定“做什么”的输入过程,而非“怎么做”的输出环节。
UX 领域先驱 Jakob Nielsen 指出,AI 将交互范式从“基于命令”转变为“基于意图”,用户角色从操作者变为监督者。文章重新定义了 AI 时代的可用性指标,提出了包含意图层、编排层和直接操作层的三层设计模型。作者强调“刻意认知摩擦”以应对信任校准,并展望了未来从“生成”走向“探索潜在空间”的交互愿景。
文章对 2026 年上半年三款国产旗舰大模型(智谱 GLM-5.1、阿里 Qwen 3.6 Max、月之暗面 Kimi 2.6)进行了深度横向对比。分析涵盖核心技术参数、能力评测及商业定价,指出各模型分别在自主编程、通用全能与长文本协作领域的优势,并针对不同业务场景提供了具体的技术选型建议。
本文指出在2026年,AI交互的质量瓶颈不在于模型本身,而在于提示词。文章将提示词工程定义为一项高价值技能,并详细介绍了从基础到专家级的全套方法论。核心内容包括专家提示词的六大要素(角色、上下文、任务、格式、约束、质量标准),XML标签等结构化技巧,以及链接式提示、自我修正循环、动机性约束和多视角分析等高级策略。文章旨在通过系统化的训练,帮助读者显著提升AI输出的质量。
文章深入探讨了 Image-2 发布后,普通人如何利用 AI 图像技术降低视觉生产成本,在 10 个具体垂直领域(如本地商家素材、投流测试、电商视觉、私域成交、企业 SOP 等)创造商业价值。作者强调核心在于解决具体的业务痛点,而非单纯的绘画技术,并提供了详细的落地路径、定价策略和演示案例。