长任务 Agent 的最小工程闭环
本文针对长任务 Agent 容易出现的“带不住状态、估不准工作量、评不好输出”三大问题,提出工程化的解决方案。文章通过引入状态层、规划层和验证层,构建了一个包含监督机制的五层架构,旨在通过外部控制和证据链,而非单纯的 Prompt 优化,来实现稳定、可落地的 Agent 系统。
本文针对长任务 Agent 容易出现的“带不住状态、估不准工作量、评不好输出”三大问题,提出工程化的解决方案。文章通过引入状态层、规划层和验证层,构建了一个包含监督机制的五层架构,旨在通过外部控制和证据链,而非单纯的 Prompt 优化,来实现稳定、可落地的 Agent 系统。
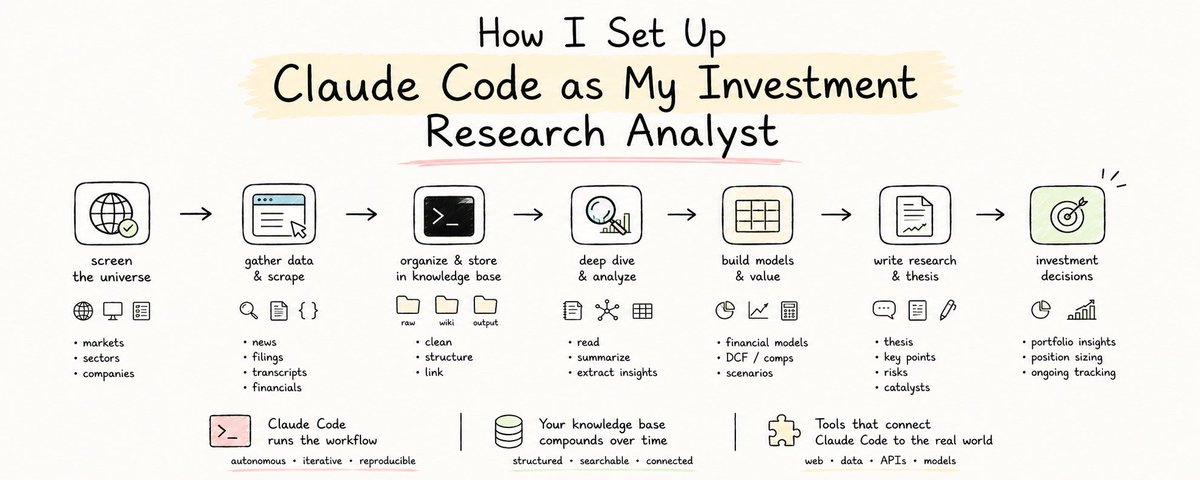
文章讲述了作者如何利用 Claude Code 这一编程工具,成功转型为个人的投资研究分析师。通过将其与 Obsidian 知识库及浏览器自动化工具集成,作者构建了一个能够自动筛选数据、抓取信息、建模并撰写报告的工作流。文章指出,与普通的聊天机器人不同,Claude Code 能够独立执行复杂的任务链条,极大地提高了金融研究的效率。
文章深入解析了构建大型语言模型的完整五个阶段,指出架构并非关键,数据、评估和系统才是核心。内容涵盖预训练、数据处理、扩展定律、后训练(SFT与RLHF)以及评估系统,揭示了从原始文本到智能助手的技术路径。
作者在开发企业级 AI 视频生成全流程网站时,针对模型提示词技巧差异大、文档散落且迭代快的问题,整理并开源了一套完整的工具包。该仓库包含 411 条带来源验证的 Prompt(覆盖 15 种模型)、7 个 Claude Code Skill、14 篇方法论 SOP 以及自动监控模型版本更新的 GitHub Action。
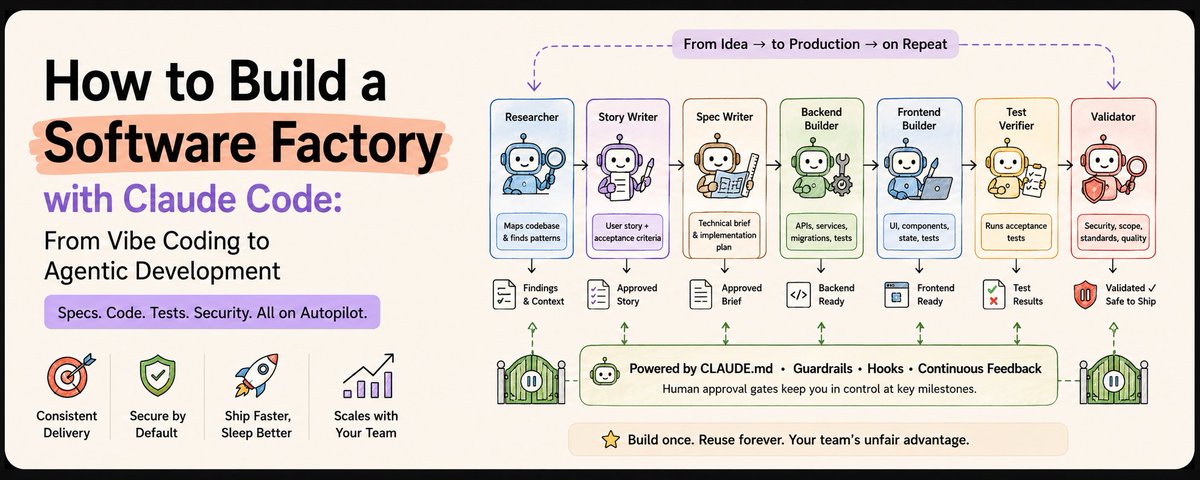
文章指出了当前 AI 辅助编程中“Vibe Coding”的痛点,即单一 AI 会话承担过多角色导致错误累积。作者提出了“软件工厂”的解决方案,通过构建包含代码库研究员、需求撰写者、规格撰写者、后端/前端构建者及测试验证者的 7 个专业化 Agent,将任务拆解并隔离。这种结构化流程利用 Claude Code 实现了自动化且高质量的功能交付,彻底改变了单人监督 AI 的低效模式。
本文探讨了 AI 原生初创公司的核心定义:通过减少人员协调、让 AI 智能体执行重复性任务,从而实现更快的迭代速度。作者为创业者提供了一套从零开始的实操指南,包括:绘制工作图谱并按自主等级分类、构建 Git 版本化的上下文系统(Context System)、以及选择高频、可逆的工作流进行自动化。
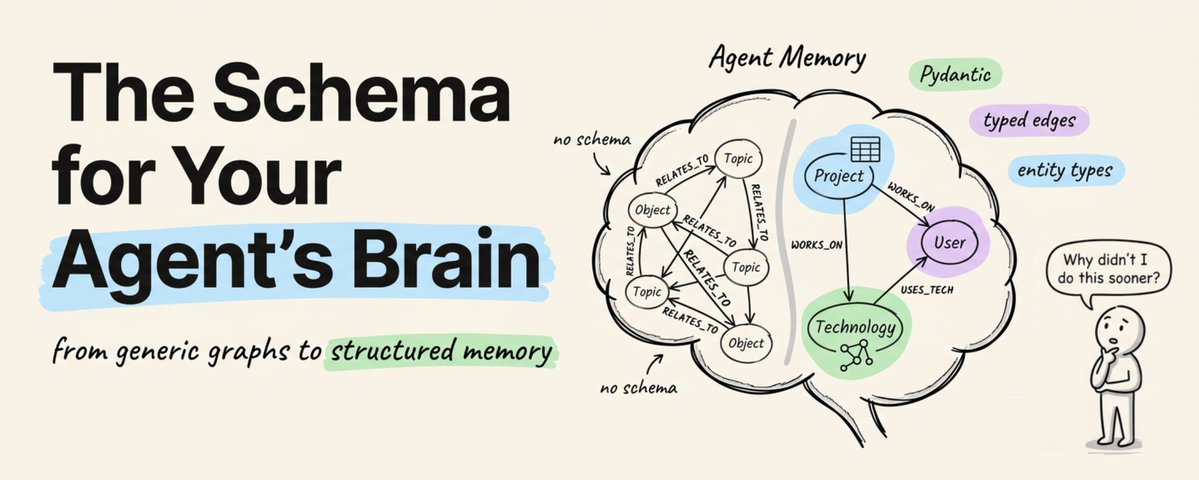
文章探讨了如何解决 AI Agent 记忆系统的多跳推理问题。传统的向量数据库在处理跨块事实连接时失效,而通用知识图谱常因缺乏结构导致查询噪音。作者提出的解决方案是使用 Pydantic 提前定义本体(Schema),明确实体类型、关系和属性。通过 Zep 框架强制执行这些约束,可以显著提升提取的准确性和数据的可查询性,从而实现有效的多跳推理。
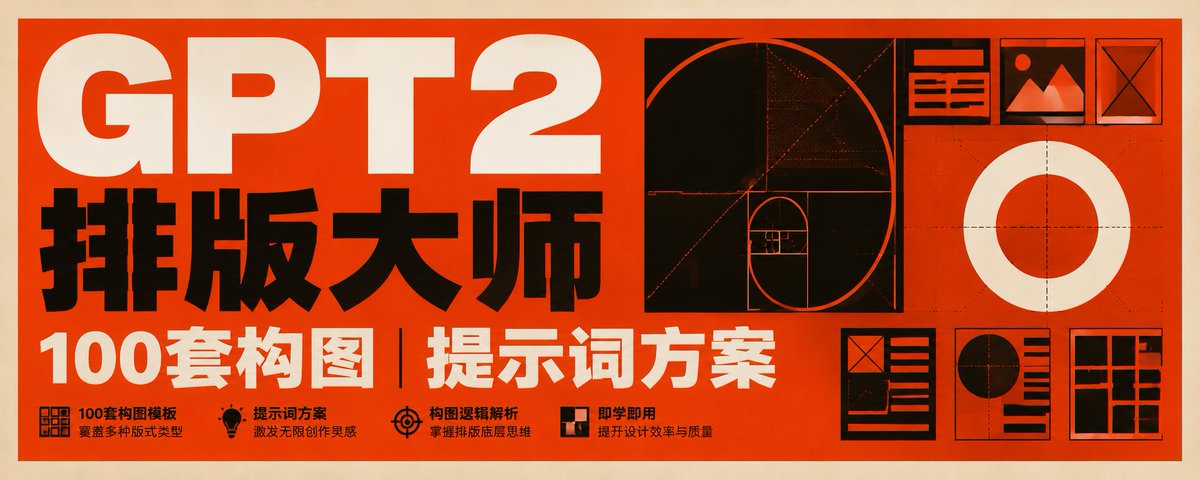
作者通过对比传统设计书籍与 GPT2 的教学效率,整理了 100 套关于构图与布局的视觉方案。文章重点介绍了如何利用这些方案优化 AI 绘画提示词,以提升海报设计和排版的实战效果。同时,作者开源了相关的 Chrome 插件 xPoster,支持批量上传 Markdown 到 X 平台,并分享了包含 100 种布局示例的 GitHub 项目下载链接。
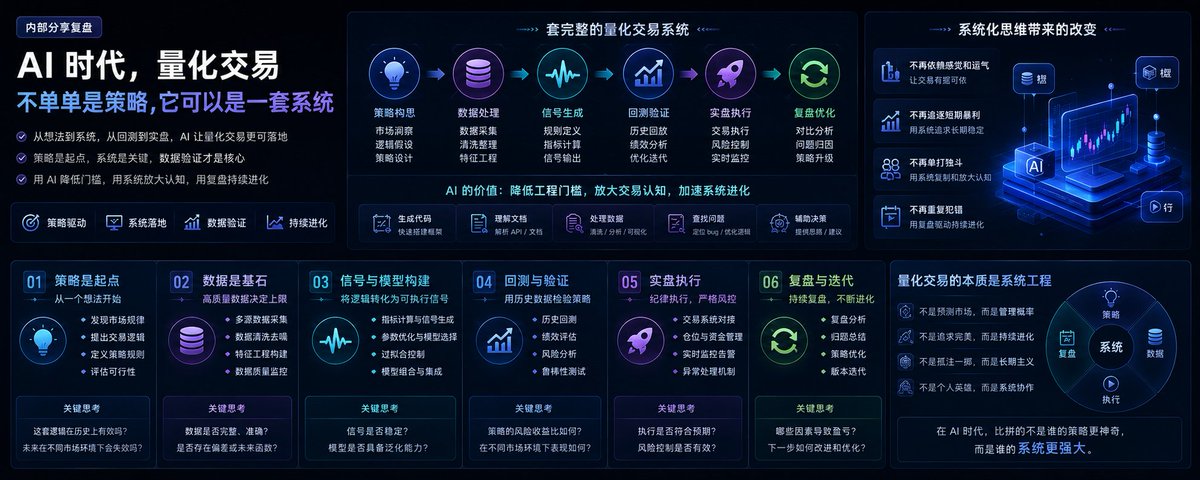
本文是作者在内部分享会上的复盘,重点探讨了 AI 如何降低量化交易的工程门槛。文章指出,利用 OpenClaw 等智能体,个人开发者可以独立完成需求文档编写、回测框架搭建、API 接入等全流程工作。作者详细讲解了从回测到实盘的信号层统一、技术分析的规则化参数化、以及常见系统误区(如过拟合、流动性筛选),强调在 AI 时代,量化交易的核心不再是代码能力,而是交易逻辑的系统化拆解与数据验证能力。
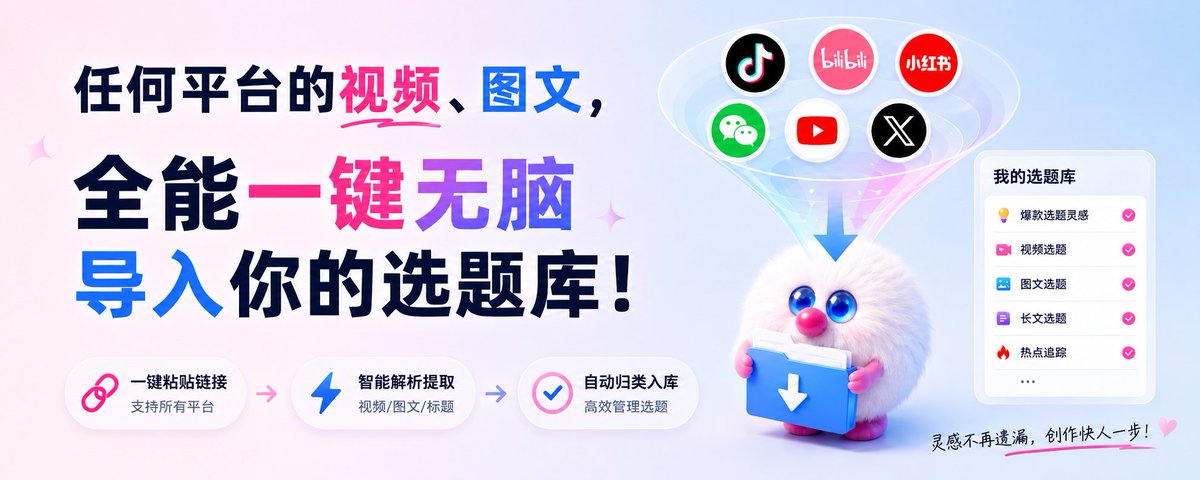
作者分享了一套基于“Get笔记 + Codex + 飞书 + Obsidian”的自媒体选题管理工作流。通过Get笔记将多平台视频及图文内容转为文字,利用AI提炼选题并自动写入飞书表格,最后沉淀至Obsidian。该方案有效解决了收藏夹内容利用率低的问题,实现了从素材收集到内容产出的自动化闭环。
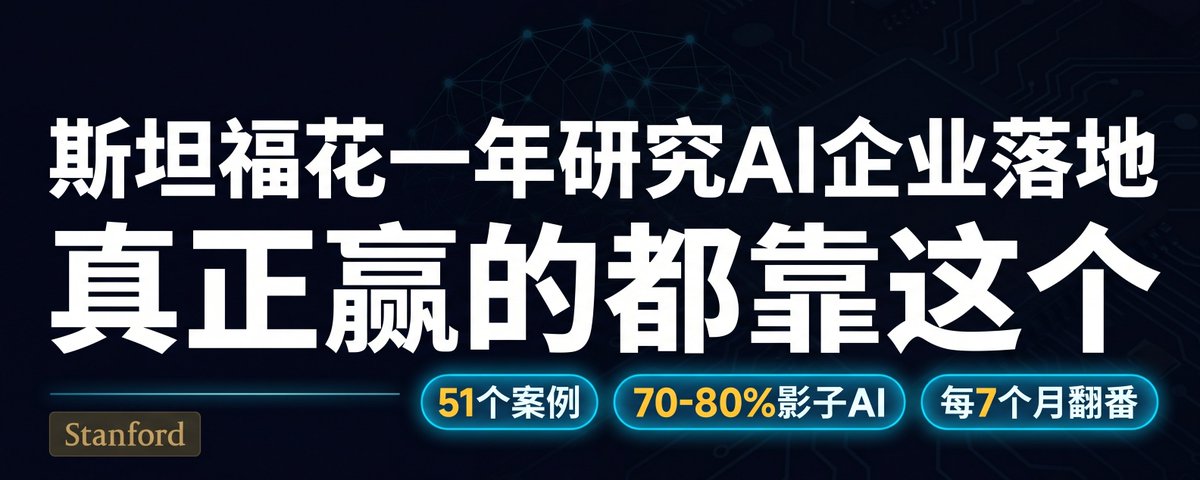
本文基于斯坦福大学数字经济实验室对51个企业AI落地案例的深度调研,揭示了企业AI转型的关键洞察。主要发现包括:70%-80%的员工私自使用未授权AI工具(影子AI),企业应从封堵转向纳管;AI项目初期面临生产力下降的“J曲线”,需9-18个月才能见效;LLM的核心价值在于解锁非结构化的“暗数据”;专有数据而非模型才是真正的竞争壁垒;以及“增强人”比“替代人”更能带来商业成功。
本文介绍了作者如何利用 AI 智能体 Hermes 构建一套自动化的链上数据分析(Onchain Forensics)流程。该流程通过 x402 支付协议集成了 Nansen、DexScreener、Tokenomist 等工具,能够自动追踪钱包持仓、识别巨鲸买卖行为并生成可视化报告。文章展示了具体的技能组合配置、运行成本分析及实际应用案例,体现了利用 AI Agent 进行低成本、高效率加密货币投资的实践。
GBrain 是 Y Combinator CEO Garry Tan 开源的个人知识管理系统。它突破了传统笔记工具的存取模式,通过集成知识图谱、混合搜索与 LLM 合成能力,实现跨文档的关联理解与自动回答。系统采用 Markdown+Git 存储数据,支持 MCP 集成及 43 种预置技能,目前已在 14 万页规模的生产环境中得到验证。
文章介绍了 Rodin 3D 生成模型的工作流程与新功能。该模型采用非一步生成模式,先出高精度初版,经用户确认后提供轻量版本(支持动画与游戏引擎格式)。此外,Rodin 支持自定义参数预设以简化操作,并具备最高并行生成 10 款模型的能力,实现了大规模创意探索。官方提及该模型拥有 1000 万多边形面数及自适应思维投入。
本文深度解析了华为在ISCAS 2026上发布的“韬定律”,这是中国半导体产业首次提出指导发展的新原则。文章指出,面对摩尔定律失效和外部制裁,华为通过“逻辑折叠”技术和“时间缩微”路径,试图在不依赖EUV光刻机的情况下,实现芯片性能的代际跨越。文章还详细介绍了麒麟9050及灵衢总线的战略意义,分析了华为从“跟随者”向“规则制定者”的转变。
文章探讨了从 Prompt Engineering 到 Harness Engineering 的演变,强调真正的 AI-First 需要将 AI 视为生产力主导者而非辅助工具。通过 Creao 团队的案例,阐述了如何重构组织流程以适应极高开发速度,分析了工程师角色转变、跨团队协作自动化以及 Agent 经济的兴起,指出未来的核心价值在于定义需求和结果审核。
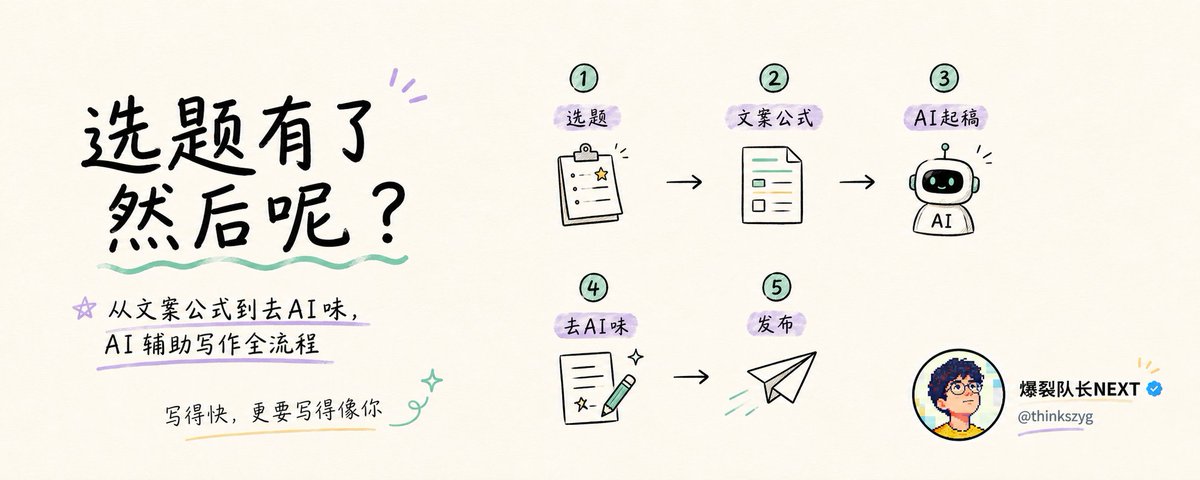
本文详细介绍了如何利用AI进行辅助写作的完整流程。作者提出“选题→匹配公式→搭骨架→AI填肉→去AI味→格式化发布”的六步法,重点分享了如何使用PAS、SCAR等文案公式构建结构,以及在Obsidian中通过约束提示词避免AI产生机械感的具体技巧(如禁用破折号、打破对称句式),最后利用AI检测结构性问题并配合人工修正以消除“AI味”,实现高效且高质量的内容产出。
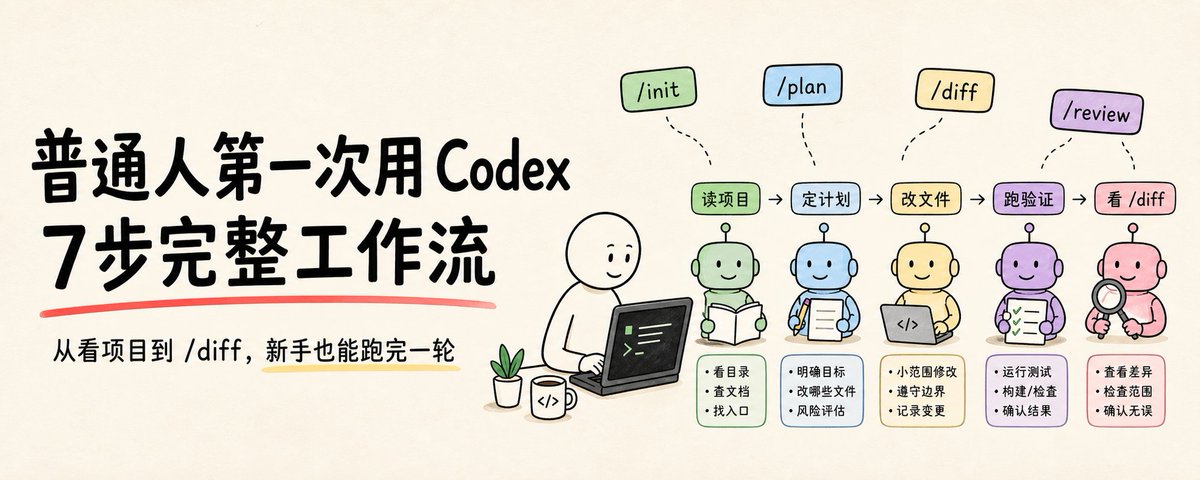
文章介绍了新手使用 Codex(AI 编程工具)时的正确姿势。作者指出新手常因将 Codex 视为“许愿池”而陷入不敢用的困境,并提出了一个完整的工作流:从看目录、定计划、执行小任务、跑验证、看 Diff 到自我 Review。文章强调不要急于求成,而应通过设定边界、交付小任务来建立信任,并提供了可直接复用的 Prompt 模板。
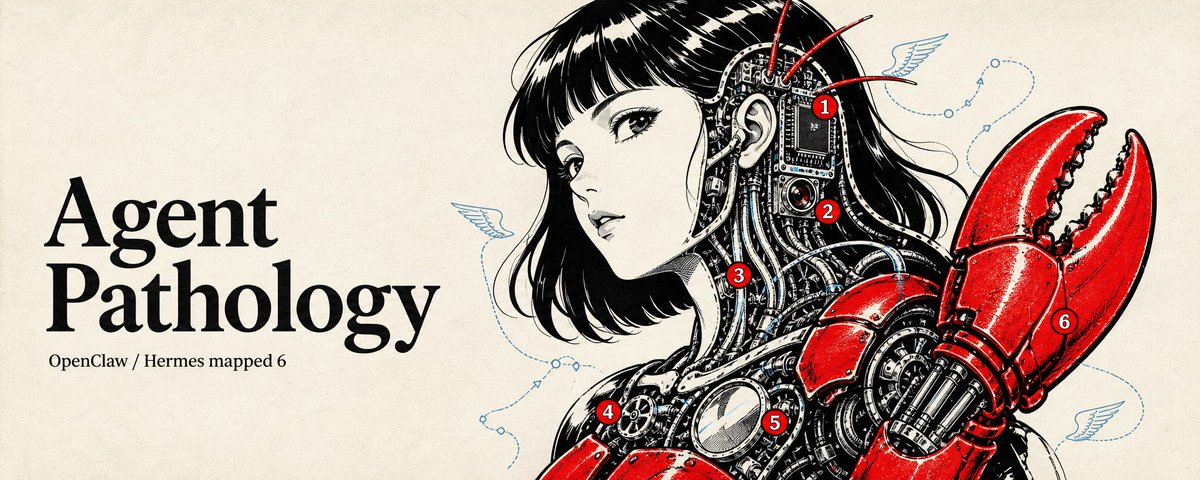
文章提出了一个新的视角来理解和调试 AI Agent:将其错误类比为人类神经系统疾病。作者指出,所谓的“AI 幻觉”在医学上更接近于“虚构症”。文章详细列举了 Agent 运行时中的六种病症,包括“遗忘症”、“幻肢状态”等,并针对每种症状提供了具体的诊断工具(如 gbrain, Mem0)和解决方案,强调通过检查“器官”(记忆、环境、工具链)来优化 Agent 性能。
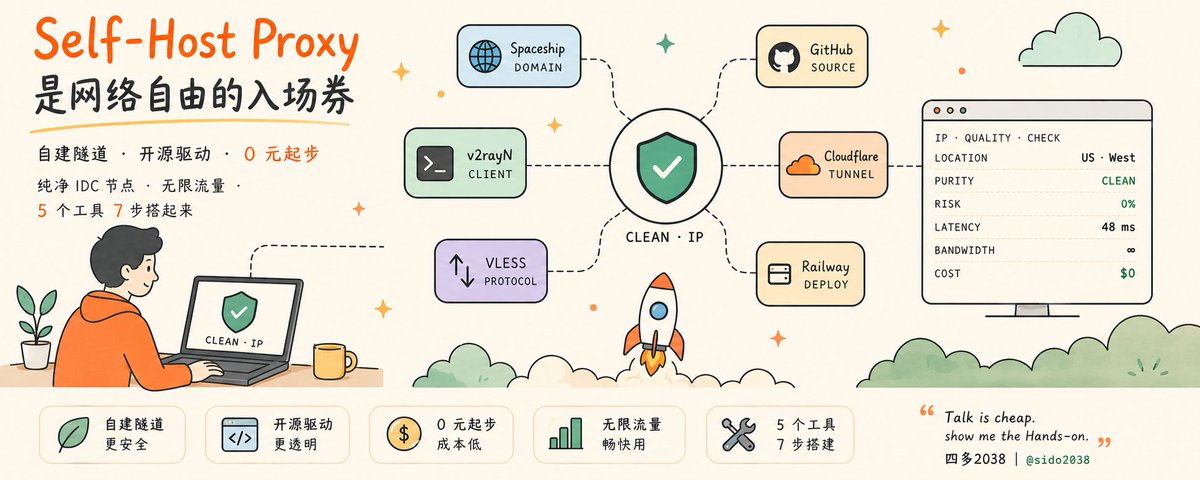
本文是一篇保姆级教程,详细介绍了如何利用 GitHub、Cloudflare、Railway 等平台提供的免费额度,零成本搭建一个纯净、稳定且高速的专属代理 IP。文章涵盖了从域名注册、解析配置、隧道创建、代码编译到最终部署验证的全过程,特别适合需要访问海外 AI 大模型的用户进行技术学习和实践。
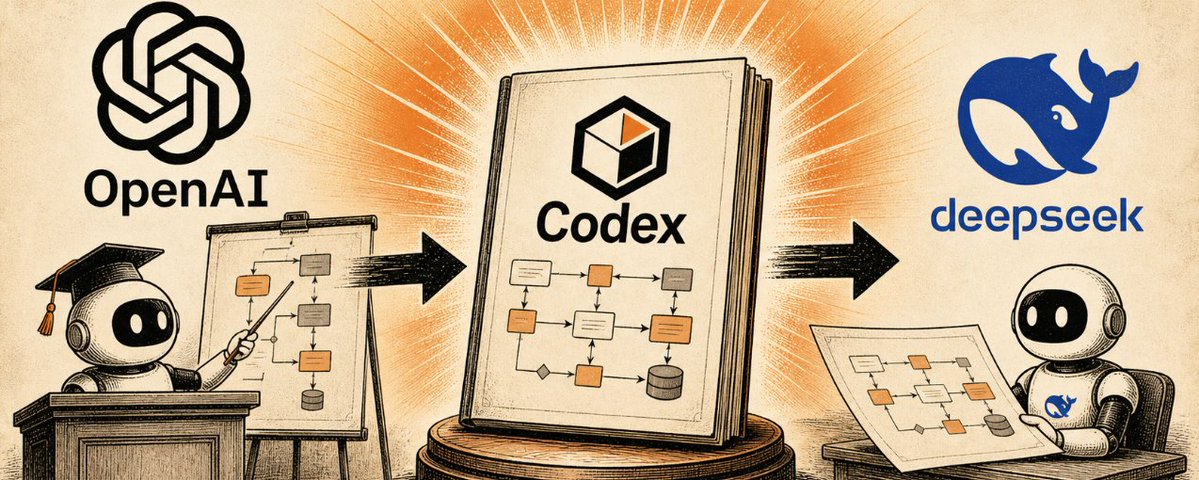
文章介绍了 OpenAI 工程师 Jason Liu 分享的 9 条 Codex 高效工作法,包括持久线程、共享记忆、语音输入、实时纠偏、操作电脑浏览器等。这些方法将 Agent 从单纯的聊天工具转变为能记住上下文、主动执行任务并操作真实应用的长期资产。作者指出,这套通用的 Agent 逻辑不仅适用于 Codex,通过 OpenCode、Playwright 等工具,在 DeepSeek 环境下也能完美复现。
文章指出企业 AI 应用效果不佳的核心原因在于数据治理,而非模型本身。公网 AI 无法访问企业核心私有数据。文章提出解决方案:利用知识库(RAG)处理文档与客服培训,通过 MCP 协议打通复杂数据库,并采用多 Agent 协作模式整合数据源、分析与报告生成。强调企业 AI 升级是系统工程,旨在实现从通用 AI 到私有 AI 的转变。
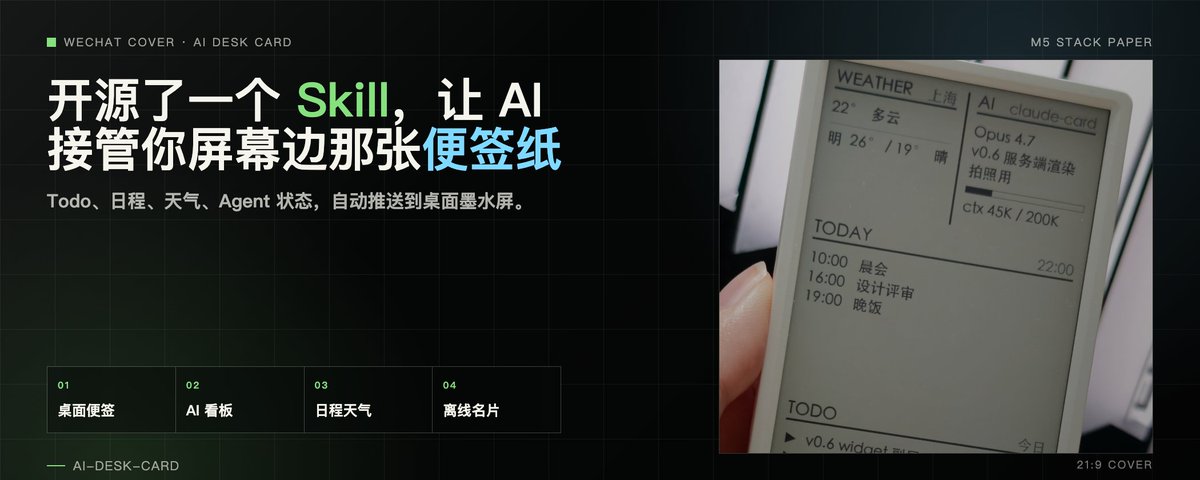
作者分享了一个开源项目 AI Desk Card,这是一块连接到 AI Agent(如 Claude Code)的墨水屏。它通过 AI 动态管理日程、待办、GitHub 动态及天气,替代静态的便利贴。文章探讨了 AI 主动决策显示内容的交互模式,以及硬件与 Agent 结合的新设计思路,旨在实现“低头干活,抬头看一眼”的无缝信息流。
文章提出了一个基于项目的 2026 年 LLM 工程学习路线图。作者主张通过从零构建系统来掌握技术栈,路径涵盖从基础的 Tokenizer、Embedding、Positional Encoding、Attention 机制,到 Transformer 模块构建、训练循环、KV Cache、MoE、量化、服务部署、RAG 及 Agent 等高级系统。该指南强调“实现、绘制、破坏、解释”的学习闭环,旨在帮助读者深入理解大模型原理并具备工程构建能力。
文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。
本文介绍了如何使用字节跳动的低代码AI开发平台扣子搭建个人AI信息情报站。文章指出,相比Claude Code等工具,Coze更适合普通用户上手。作者详细讲解了Coze从聊天机器人平台向云端应用开发平台的演进,并提供了通过自然语言描述快速生成工具的示例。核心部分展示了一套结构化的提示词,利用Coze实现对指定关键词的全网信息收集、痛点分析与趋势判断,帮助内容创作者解决信息过载问题。
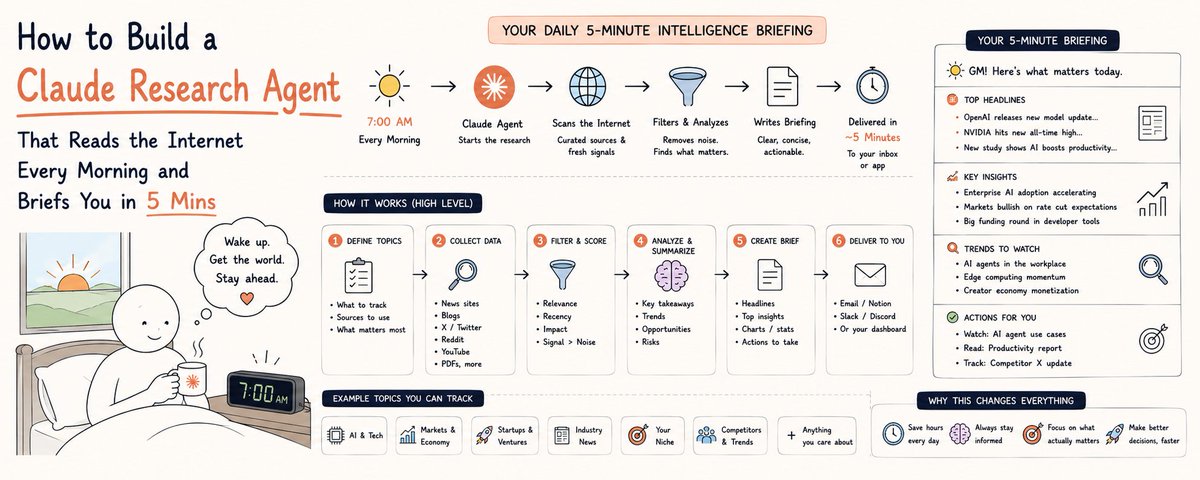
文章介绍如何利用 Claude、MCP(Filesystem 和 Brave Search)、N8N 及 Obsidian 构建一个全自动的晨间研究代理。该代理能自动监控信息源、过滤噪音、综合关键信息,并生成一份 5 分钟可读完的简报存入 Obsidian,帮助用户从繁杂的信息过载中解放出来,高效开始工作。
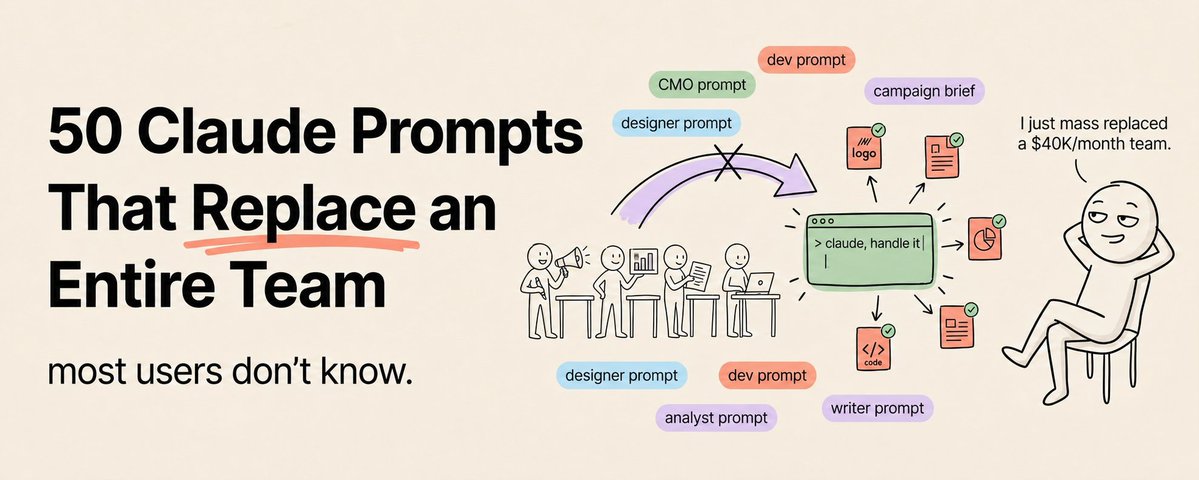
文章介绍了50个结构化、工程化的 Claude 提示词,涵盖内容创作和商业策略等领域。通过设定角色、背景、格式和约束条件,这些提示词能让 AI 的输出达到专业团队的水准,大幅提升工作效率。
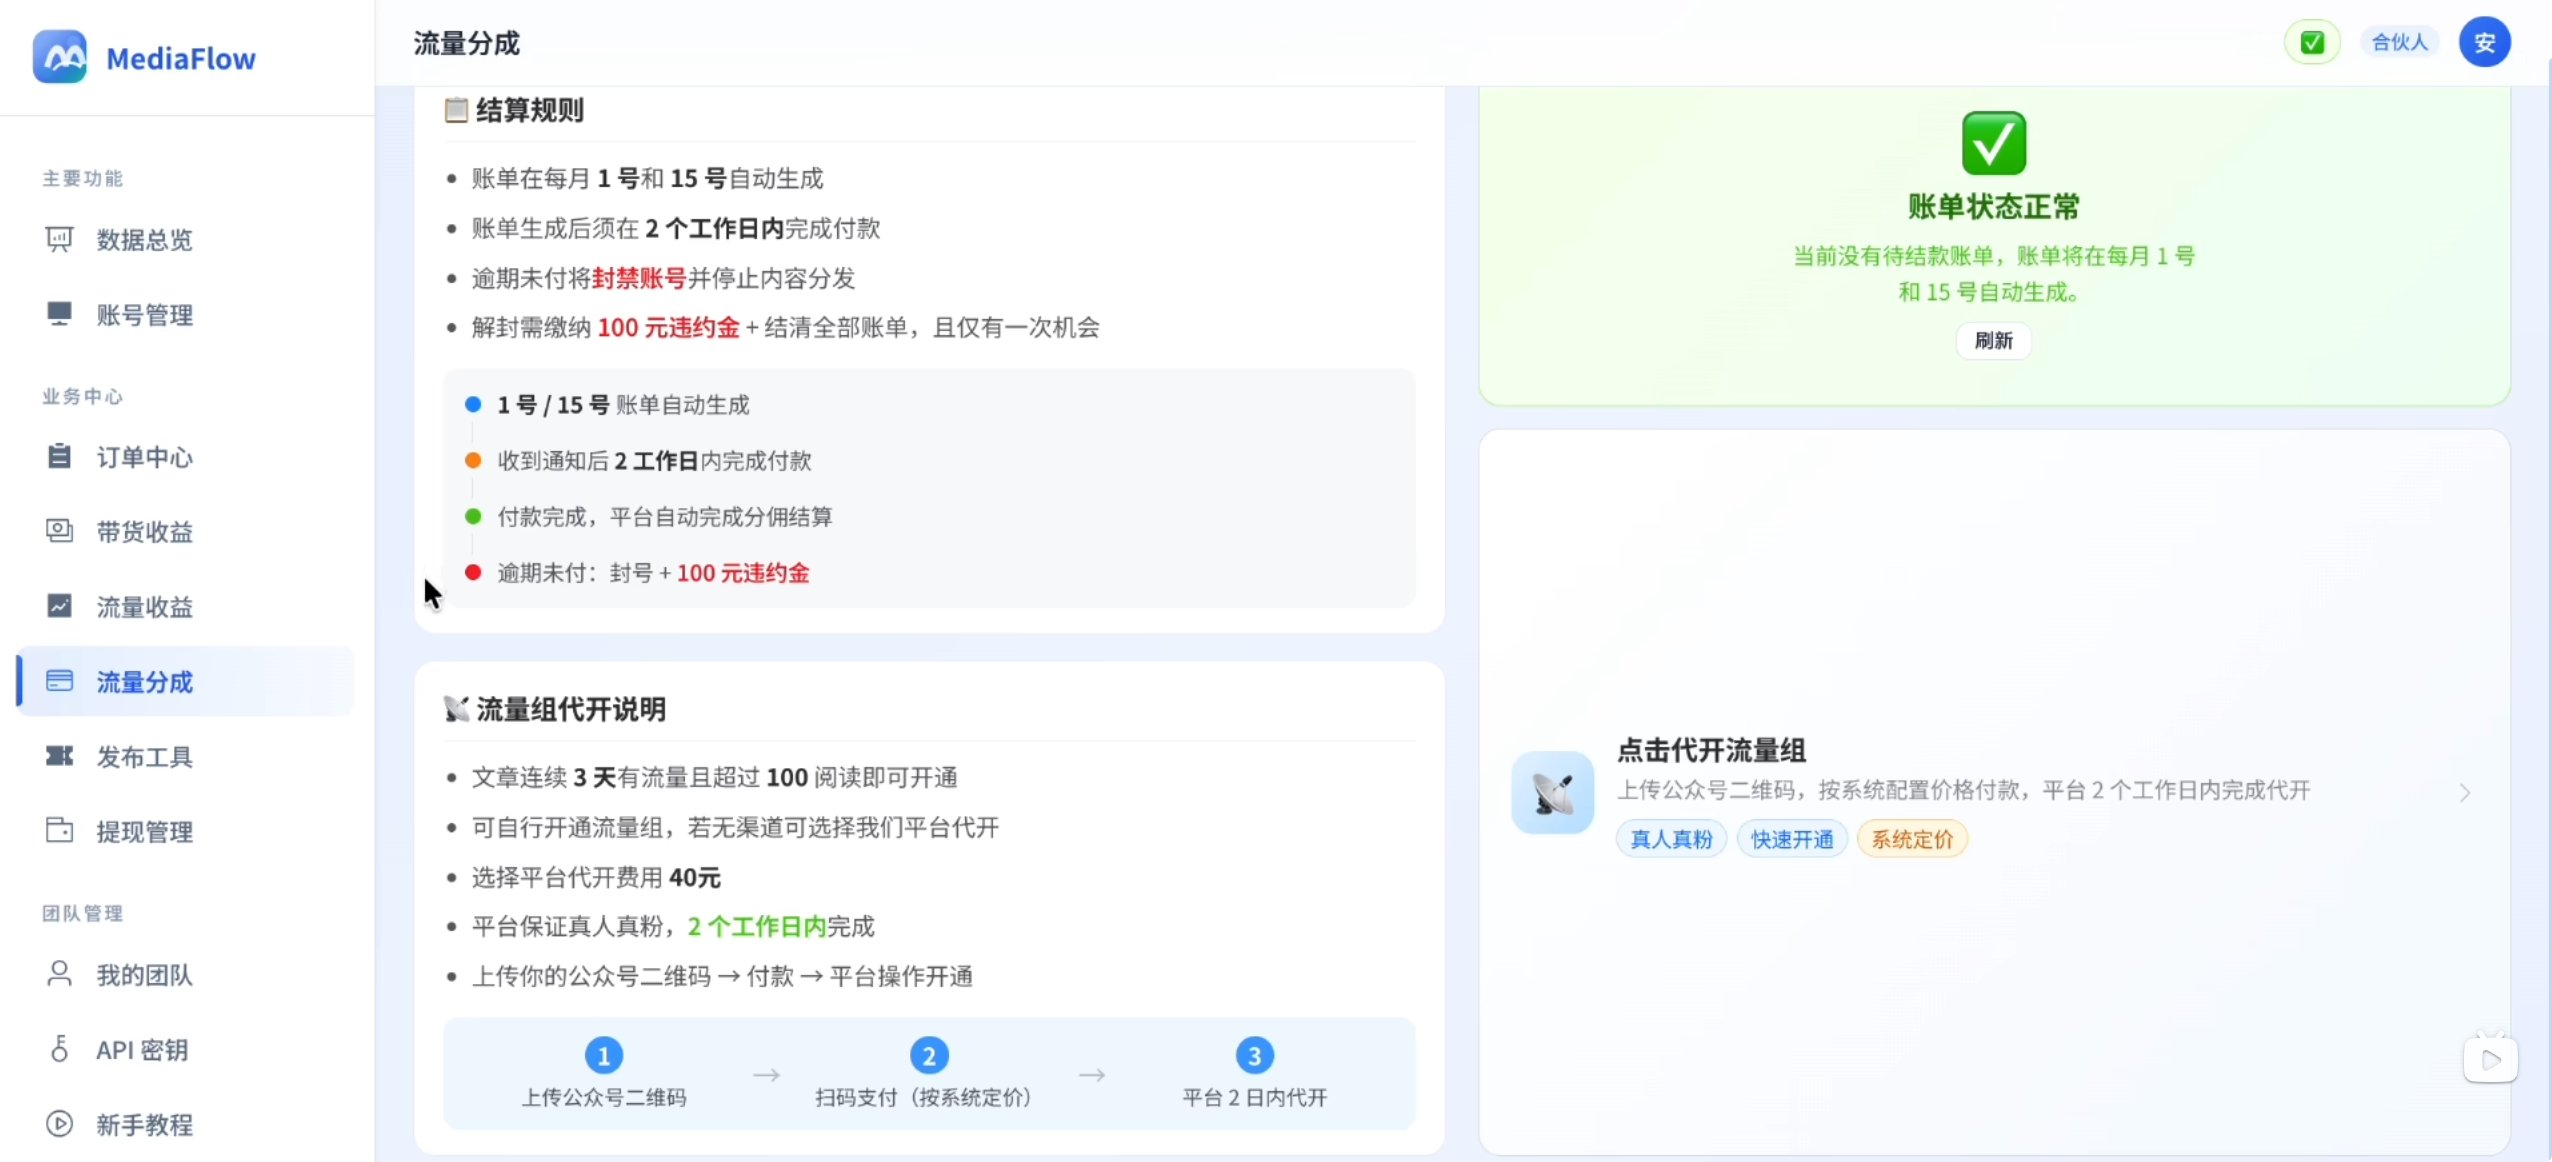
文章介绍了一款名为 AIMedia 的开源工程级工具,旨在通过自动化技术取代传统的手动自媒体运营流程。该工具利用 Django 和 PySide6 构建,具备全网热点自动抓取、AI 洗稿生成以及多平台自动发布的闭环能力,能够大幅提升内容分发效率。
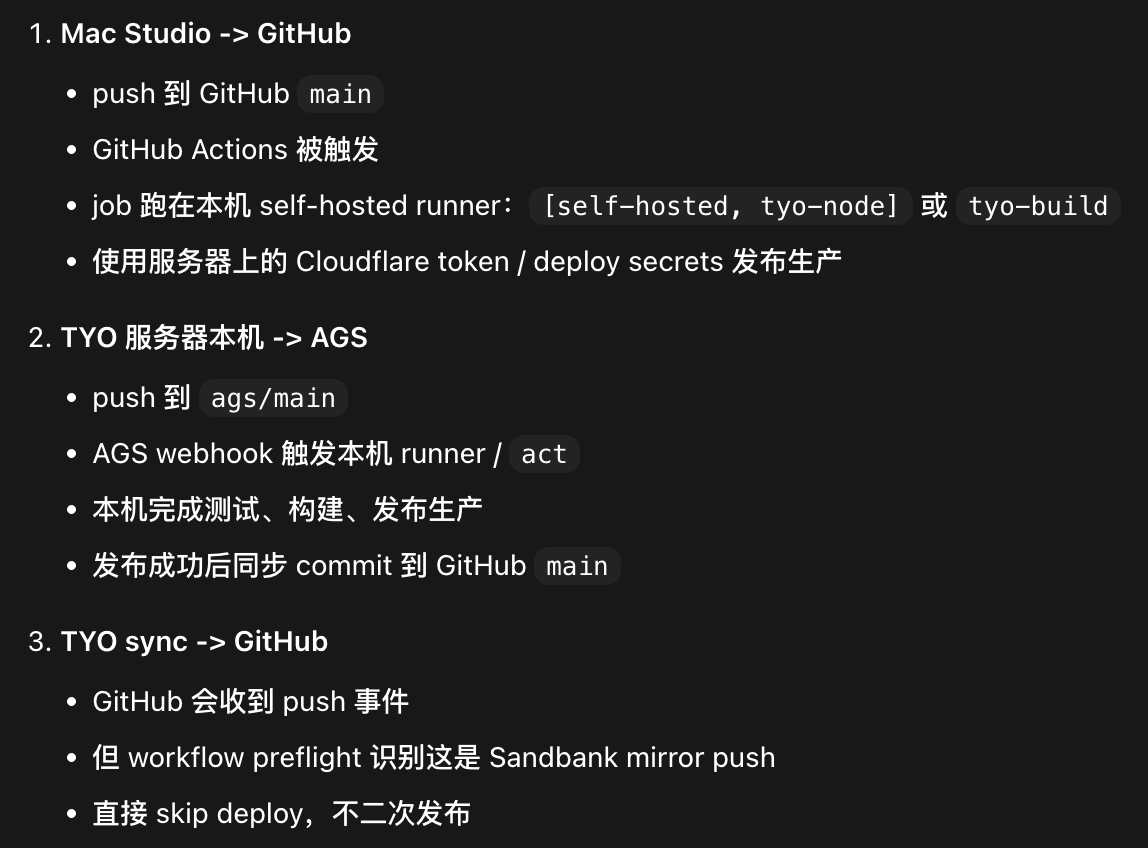
作者分享了如何使用 AGS(Agent Git Service)替代 GitHub 作为主要开发环境的实践。通过将开发环境完全迁移至云服务器,结合 dev agent 和双驱动的交互模式,实现了无需本地依赖的高效开发工作流,并介绍了正在开发的 VAS(虚拟代理服务器)项目,旨在将该工作流整合到语音交互界面中。