Wiki 知识库

全部文档 / 标签: 工程实践

60 篇
清除

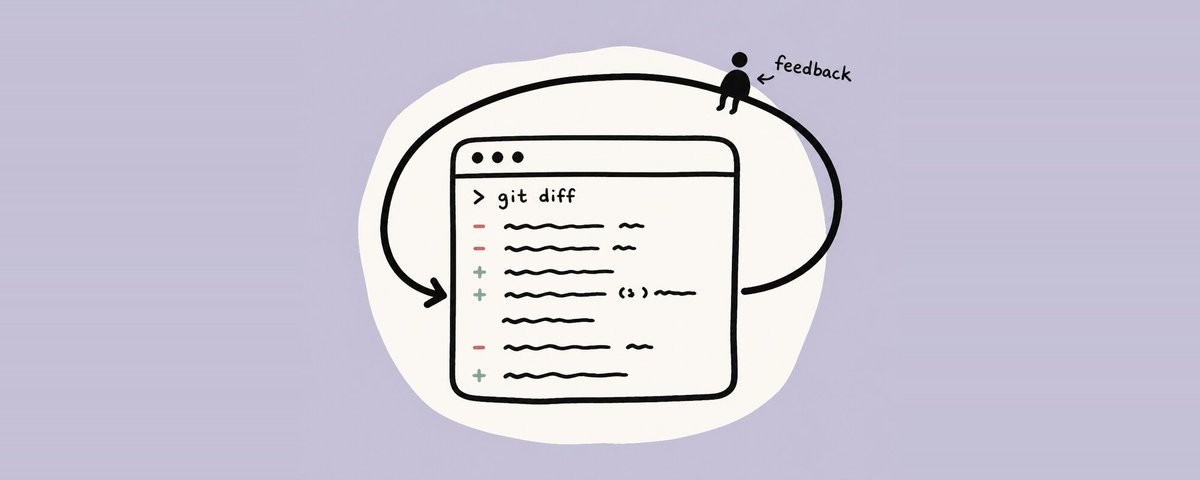
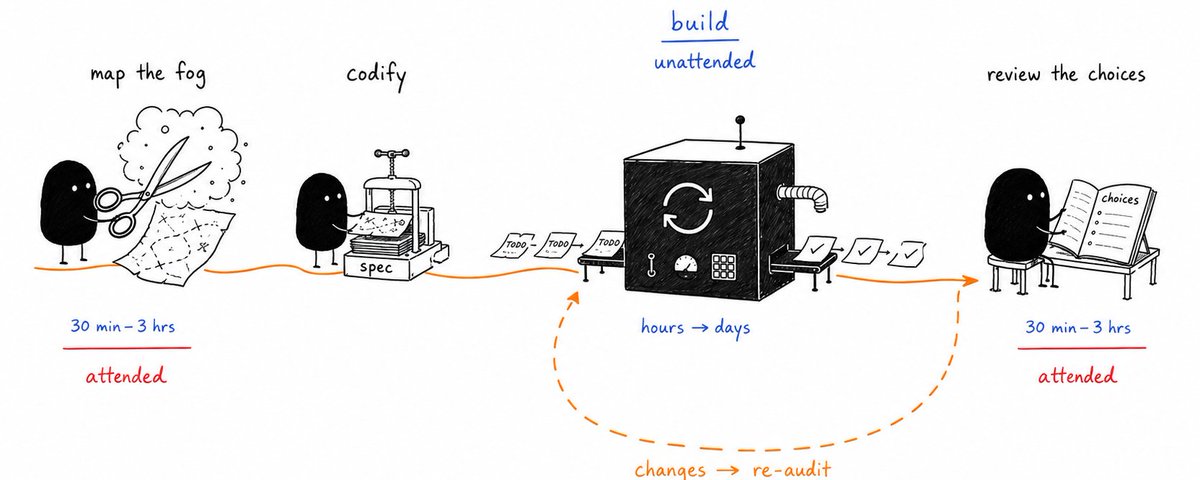
像 Claude Code 团队一样做代码审查

文章介绍了 Anthropic Claude Code 团队的代码审查实践,以及作者团队自研 AI 代码审查工具 HeyDeer 的落地经验。核心思路是:AI 写代码占比接近 100% 后,人工逐行审查不再可行,应把人的注意力留给真正有风险的部分。做法包括按风险分级审批(低中风险由 AI 自动批准,高风险由人判断方向)、多模型交叉审查降噪、用仓库检查落实团队规范、通过 Autopilot 自动修复问题直至收敛。作者团队跑了 8 个月未因合并有 bug 的代码导致线上事故,认为大部分创业和中小公司都适用这种方式。

技术 › Harness Engineering Z Zihua 2026-10-2710.0 KB 6K 36 79

Claude Code 团队如何进行代码评审

本文介绍了 Claude Code 团队在 AI 生成约 90% 代码的情况下如何重构代码评审流程。团队将代码评审从人工逐行阅读转变为分层自动化体系:包括 PR 前的 Claude 自验证、子代理 diff 审查、内部 skill(bug 猎捕、diff 缩减等)、以及每个 PR 的 AI 评审,仅将人类注意力保留给高风险决策。通过 CLAUDE.md 和 REVIEW.md 等文件向评审者注入项目上下文,并快速回滚机制兜底。6 月至 9 月间合并 PR 数量翻倍,回滚率下降超 40%,实现了用最少人工环节保障代码质量的目标。
技术 › Claude Code Addy Osmani 2026-10-2722.4 KB 1.6M 10K 85

BestBlogs 早报|Kimi K3.1 Pro 发布,Claude Duet 的安全、隐私与保障机制,天猫数字员工实践篇拆解

本期早报聚焦 AI 智能体的长程执行与工程实践。精讲一介绍月之暗面 Kimi K3.1 Pro,3 万亿参数、100 万上下文,在代码、3D 创作、金融研究和长程 Agent 任务上表现突出,尤其展示了模型修正仿真器错误完成人体行走控制的能力。精讲二解读 Claude Duet 的安全机制,包括动作审批、敏感信息检查与凭证隔离三层设计。精讲三拆解天猫数字员工的全链路交付技术,涵盖沙箱隔离、会话延续、身份绑定与度量体系。速览部分还涵盖美团 AutoResearch 自进化系统、Cloudflare CTO 谈智能体安全、LangChain 上下文工程检索实践及 Factory 自主软件工程等内容。

技术 › LLM ginobefun 2026-10-2428.5 KB 2.9K 4 83

BestBlogs 早报|Claude Duet 开启协作预览,Nemotron 升级多模态检索,OpenAI 拆解 ChatGPT 广告系统

本期早报精讲三篇 AI 前沿内容:Anthropic 开放 Claude Duet 研究预览,通过云端虚拟机和独立应用承接主动发现与持续执行任务,并设计分级授权机制;NVIDIA 发布 Nemotron 3.5 系列模型,将文档解析、多模态嵌入与重排连接成企业知识处理链路,实验证明更优检索可降低代理推理 token 开销约 13-14%;OpenAI 工程师拆解 ChatGPT 广告系统,展示如何用后训练 LLM 理解多轮对话中的商业意图,通过编排模型与竞价工具分工实现服务隔离与信任保障。速览部分涵盖天猫数字员工协作实践、代码质量投入判断框架及 Claude 设计蛋白质结合体等七条内容。

技术 › LLM ginobefun 2026-10-2230.0 KB 2.5K 5 85

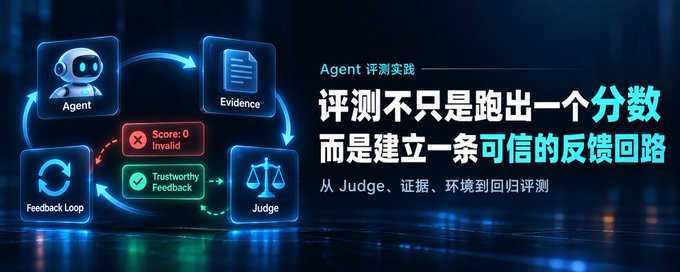
Agent评测入门,我最推荐Anthropic这篇文章

作者结合自身开发问答机器人Agent评测系统的工程实践,推荐并解读Anthropic的文章《Demystifying evals for AI agents》。文章分享了8个核心经验:Agent看到的信息与Judge评分时能获取的证据可能不一致,导致高准确率仍被判失败;LLM Judge的输出需要像外部API一样严格校验;信息不足时应允许Judge返回Unknown而非强行打分;评测环境配置、数据集同步、systemd部署等基础设施问题常导致结果不可信;需区分评分低与评分无效;要区分Capability Eval与Regression Eval,并使用pass@k、pass^k指标评估稳定性;以及务必人工检查Transcript而非只看分数。文章提供了大量真实踩坑案例,对Agent评测落地极具参考价值。

技术 › Agent Jerry Fang 2026-10-1622.1 KB 3K 17 87

Agentic evals: 如何判断 AI Agent 是否真正完成了任务并保持可靠

本文面向构建基于 LLM 的 Agent 系统的工程师,讲解如何对 Agent 进行评估(Agentic Evals)。核心观点是:要评估 Agent 实际改变了什么,而非它说了什么。文章通过一个自行车店客服 Agent 的完整示例,展示五步评估法:编写带预期终态的任务、多次运行并保留完整轨迹、同时评估终态和路径、报告能力与可靠性两个数字、定位失败的第一步。文章还区分了单次回答模型与多步 Agent 在评估上的差异,强调没有可检验终态的任务不构成有效的评估,并讨论了模型作为评判者的可信度问题。

技术 › Agent Sergii Makarevych 2026-10-1151.9 KB 65.5K 671 89

BestBlogs 早报 · 09-24|OpenAI 拆解 GPT-6 提示缓存,Gemini 3.8 语音生成模型、Grok 4.7 发布

本期早报围绕 AI 模型与工程实践展开三大精讲:一是 OpenAI 为 GPT-6 改进提示缓存,命中率提升并推出缓存诊断工具,缓存输入折扣最高 90%;二是 Google DeepMind 发布 Gemini 3.8 Flash TTS 和 Flash-Lite TTS,支持声音创作、双说话人控制与授权声音复刻;三是 xAI 发布 Grok 4.7,聚焦长任务编程与自我验证,附基准与定价。速览部分涵盖腾讯错误码治理 Agent、网易 AI 原生组织实践、Reducto 文档智能、阿里 AI Native 研发手册、大淘宝小游戏 Agent、Harness 记忆与验证闭环及良渚 vibe coding 社区观察。

技术 › LLM ginobefun 2026-09-2424.5 KB 4.5K 4 76

全网刷屏的 Jev 到底怎么用?8 个能直接抄的案例

本文介绍了 AI 圈新火的模型 Jev——一个不做文本生成、只返回带概率判断的决策模型。文章讲清了它的三种用法(是非判断、选项选择、打分),提供了四种 30 分钟内可上手的接入方式(官方 Skill、Vercel、OpenRouter、SDK),并整理了 8 个可直接复用的真实案例:7 秒订机票、代码审查、工单分流、简历初筛、语义搜索、AI Agent 路由、RAG 重排、动态 UI 拼装等。还总结了 5 个反直觉要点(不写字、零幻觉指格式而非正确性、不会拒绝等)、官方自曝的雷区(不会算术、不懂日期先后、易被提示词注入),以及不适合使用的场景。

技术 › LLM Leaf Yeah! 2026-09-2016.8 KB 131.8K 279 86

pstack 完整指南 Pt.2:用代码规划

本文是 pstack 指南第二部分,介绍作者用 agent 进行调研、规划、原型和架构的工作流。核心观点是通过 /teach、/recall、/how、/why 等 skill 建立并保持对代码库的心智模型;用「readme 驱动开发」和 /technical-writing skill 以代码和文档形式规划;用 prototype 剧本并行生成多个方案让 agent 以实证回答开放问题;用 /architect 多阶段流程跨模型家族竞争设计并交叉评判。作者强调抽象计划只给人进步的幻觉,应让 agent 通过原型和验证自己回答问题,从而每月将数千个 PR 推进生产并保持高质量。

技术 › Agent lauren(@poteto),yibie 翻译 2026-09-1517.5 KB 6.7K 46 87

FDE 进阶必读:GPT-6 +微软 Argus,一文讲透 AI 长任务交付

文章面向 FDE(深入客户现场做 AI 落地的工程师),介绍微软开源的长期 Agent 运行框架 Argus 如何与 GPT-6 配合完成 AI 长任务交付。通过一个企业周报工具项目案例,讲解 Argus 规划者、执行者、评审者的角色分工,如何发现并修正跨周退款统计口径错误(差 4000 元问题)、如何用第二周样例验证规则处理而非只修当前样例、客户追加按店铺拆分需求时如何保留进度继续开发,以及项目交接时的信息留存检查。文章强调 Argus 的价值在于跨阶段任务组织、进度保存与按需评审,减少 FDE 传递要求与恢复状态的组织负担,并通过 Flash Linear Attention 的公开 PR 案例佐证其成果。

技术 › Agent Russell 2026-09-0723.6 KB 17.2K 120 83

从零跑通 Microduck 强化学习训练与仿真模拟

本文详细介绍了如何从零完成 Microduck 双足机器人的强化学习训练与仿真全流程。文章使用 MuJoCo 物理引擎配合 Warp 在 RTX 4090 上并行运行 4096 个虚拟环境,通过 PPO 算法训练行走策略,并讲解了 61 维观测、奖励设计、域随机化、BAM 执行器仿真等核心概念。训练完成后将策略导出为 ONNX 文件,在 Mac mini 上进行 CPU 交互仿真验证,最终部署到实机。作者完整跑通了从环境配置、训练观察、checkpoint 选择到场景测试的工程流程,涵盖技术选型、软硬件要求和常见问题。

技术 › Agent yishan 2026-09-0442.9 KB 25.4K 197 89

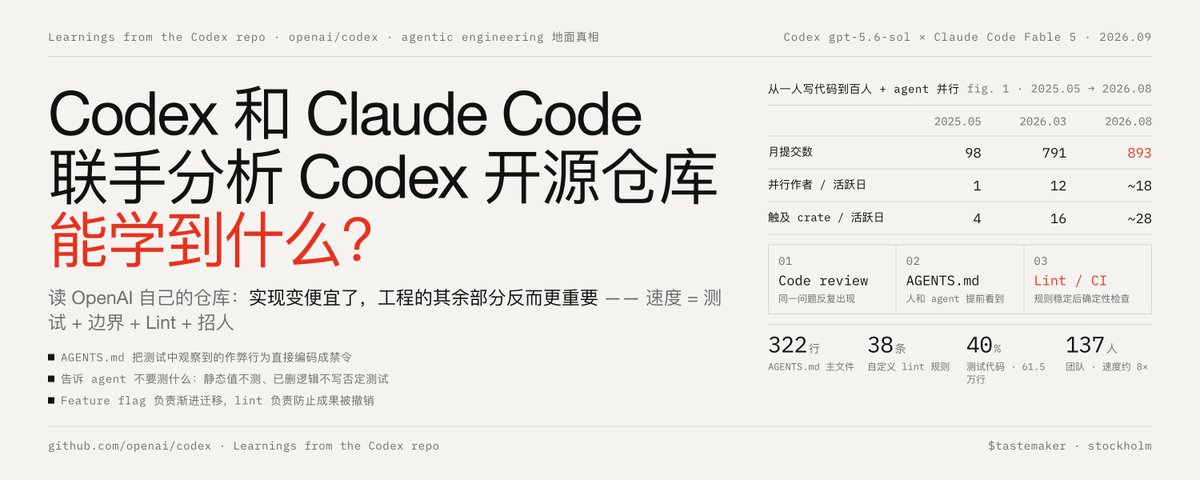
让 Codex 与 Claude Code 联手分析 Codex 开源仓库:能学到什么

文章分析了 John Wang 对 OpenAI Codex 开源仓库的研究。Codex 从 2025 年 5 月的 98 个月提交、单一主作者,增长到 2026 年的 900+ 月提交、35 位常规贡献者,归因于大量使用 coding agent、团队扩招和对护栏规则的重投资。核心经验包括:AGENTS.md 把 review 踩过的坑编码成规则;规则按 Review → AGENTS.md → Lint/CI 三级演进;测试代码占 40%,分层执行保证速度;迁移通过 feature flag 推进并用 lint 锁定成果。结论是工程实现变便宜后,测试、边界、自动化和招人等经典工程要素反而更重要。

技术 › Harness Engineering meng shao 2026-09-048.6 KB 6K 13 79

How to Build the Ultimate Agent Harness for Kimi K3

文章指出模型已不再是瓶颈,真正决定 Agent 效果的是围绕模型的 Harness(脚手架),包括上下文、工具、记忆、校验和恢复循环。作者详细讲解了如何为 Kimi K3 构建终极 Agent Harness:使用 Kimi Code 搭建项目结构,通过任务合同明确交付目标与验收标准,用上下文地图替代指令堆砌,为工具设置权限边界,分离研究者、构建者和审查者角色,建立持久化状态、自动护栏、独立质检和反馈循环。同一模型在不同 Harness 下可产生 20 分的绩效差距,好的 Harness 能让智能体可靠地完成从需求到交付的全流程。

技术 › Agent J.B. 2026-09-0218.7 KB 74.4K 239 81

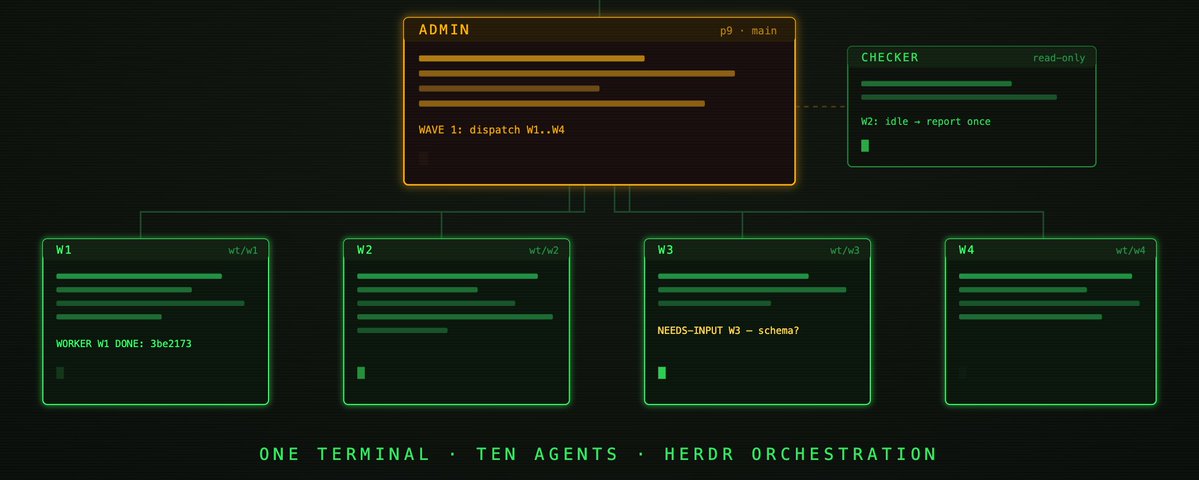
One Terminal, Ten Agents: Herdr Orchestration (Skill)

本文介绍 Herdr 编排方法,解决多编码 Agent 并行协作中的冲突与失控问题。通过严格的层级结构(Main、Admin、Worker、Checker 四种角色)、git worktree 物理隔离、依赖排序的 Wave 调度、三个哨兵字符串协议、只读 Checker 观察者模式以及人工审批的交付门禁,实现一个编排者管理 N 个工作者且零合并冲突。文中每条硬规则都源自真实失败教训,强调可预测性优于巧妙性,最后该 Skill 甚至由自己的 fleet 完成了公开发布。

技术 › Agent Ask Prateek 2026-09-0210.2 KB 1.8K 11 81

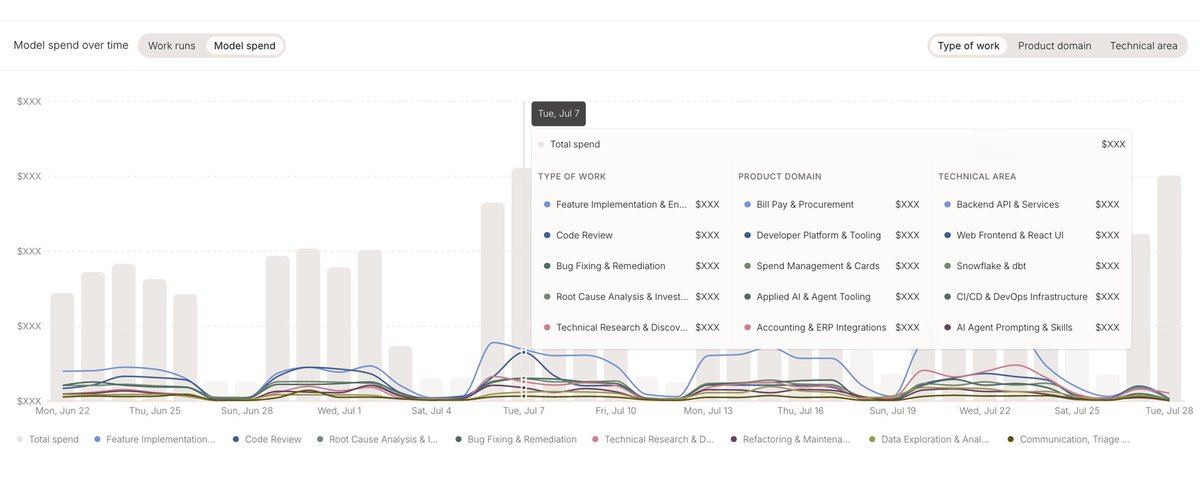
构建 AI 支出与 ROI 之间缺失的语义层

Ramp Labs 介绍了一套将 Agent 运行轨迹转化为语义层的流水线,用于实现 AI 支出到 ROI 的归因。系统首先将相互关联的多个 session 重建为完整的 agent run,再由抽取模型将 run 拆分为具有独立目标和结果的工作项(work item),并关联模型花费、团队、仓库等信息。基于内部编码 agent Inspect,三周内分析了约 20 万次运行、识别约 25 万个工作项,使公司能够从'AI 花了多少钱'进阶到'AI 产出了什么、回报如何'的评估。

技术 › Agent René Sultan / Ramp Labs 2026-09-0225.1 KB 137.4K 420 80

读懂 Warp 的 Agent Skill 自进化机制

本文深入解读了 Anthropic 发布的关于 Warp 构建自进化 Agent 的博客。Warp 通过双 Skill 循环(Base Skill 和 Improver Skill)实现 Agent 的自我改进,将人类反馈转化为对 Skill 文件的修改,并通过 Git 工作流进行管理。文章区分了 Skill 与 Memory 的不同,指出 Skill 是程序性知识,而 Memory 是事实记录。同时,文章探讨了 Skill 自进化的边界,对比了 Skill(软约束)与 Harness(硬约束)在 Agent 进化中的不同作用,并提出了 Agent 可进化内容的三层模型:Memory、Skill、Harness。最后,作者总结了 Warp 团队关于编写 Skill 的几条实用经验,并强调了这种轻量级自进化机制的工程价值。

技术 › Agent LanLance 2026-09-017.9 KB 14.2K 122 74

AI 全部生成代码时代如何保证产品代码可维护不腐化

作者以 Mole 项目(11 万行 Swift、3347 个 XCTest)为例,从产品工程师视角分享 AI 全量生成代码时代保持代码可维护性的实践经验:由工程师主导架构设计与文档沉淀;重视覆盖边界场景的单测,坚持 AI 写的代码由 AI 测试;修 Bug 时补充回归测试并把原因写入规则;用按模块拆分的 Rules 和 Skills 记录功能边界与历史决策;坚持少做无用功能避免维护成本腐化;充分利用 GitHub Actions 与 CI 兜底验证,设置流程卡点让 AI 自动化验证,从而让代码长期持续迭代、清晰可扩展。

技术 › Claude Code Tw93 2026-08-318.2 KB 84

Show Me the Receipts: The Case for Immutable Artifacts for Agent Work

文章探讨如何让人们对 AI Agent 承担更重要的工作建立信任。作者提出需要让 Agent 在工作过程中留下“回执”——即不可变的、有类型的工作工件(如证据、假设、评估、建议、审批等)。通过将“工作本身”建模为产品的一等数据,定义工件类型及其依赖关系,并强制 Agent 遵守这些结构(如建议必须基于评估、评估必须引用证据),系统能客观验证工作是否真正完成,而非依赖 Agent 自述。工件不可变可保留决策演变过程,且每个工件需指明所用上游工件的精确版本,从而形成可审计、可信任的工作链路。

技术 › Agent Josh Rosen 2026-08-2911.9 KB 29.2K 111 78

Building software factories (with no slop)

本文探讨了AI生成代码带来的代码审查瓶颈和'AI垃圾'问题。作者认为,随着AI编码能力增强,人类审查速度成为瓶颈,导致代码质量下降。他提出解决方案:将代码库视为黑盒,通过定义清晰的接口、不变量、追踪和决策记录等'工件'来确保系统可检查性,而无需阅读实现代码。作者强调软件工程的核心是解决问题而非编写代码,未来工程师的职责是设计人与AI协作的系统。

技术 › LLM David 2026-08-2014.8 KB 304.5K 855 76

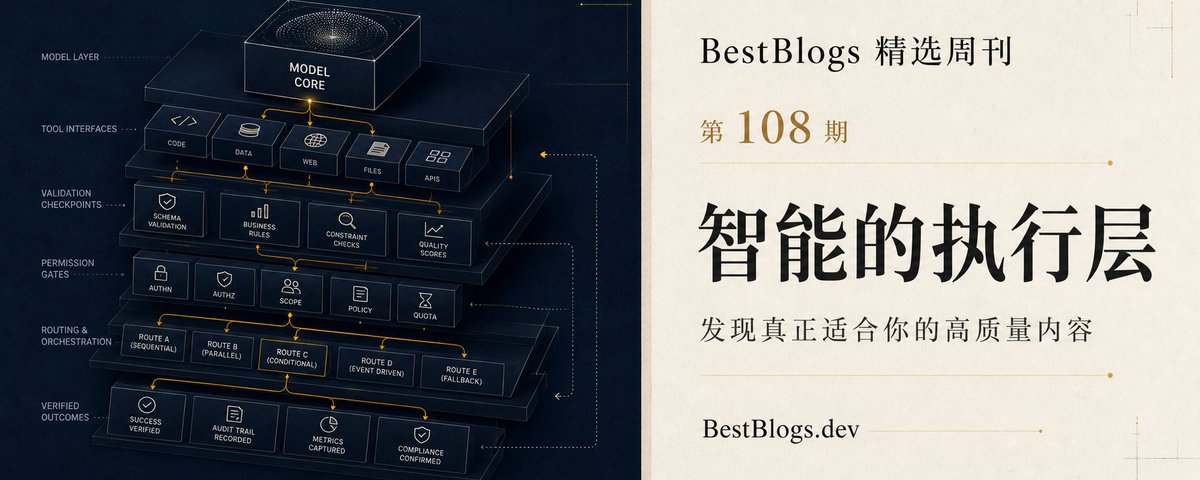
BestBlogs 精选周刊第 108 期:智能的执行层

本期周刊聚焦 AI Agent 执行层的工程实践,探讨模型如何穿过真实环境稳定完成任务。文章围绕执行模型、Harness、质量评测、多智能体与权限、路由缓存等六条主线展开,分析了 Grok 4.6、DeepSeek V4 Pro、Gemini 3.7 Flash 等模型的长程执行能力,拆解了 DeepSeek Harness 和 OpenAI Codex Harness 的架构设计,并介绍了阿里、美团等团队的评测与改进流程。核心观点是:智能体的可靠性不仅取决于模型能力,更依赖于 Harness 的工程化设计、可观测的反馈闭环和合理的成本调度。

技术 › LLM ginobefun 2026-08-1640.4 KB 6K 2 78

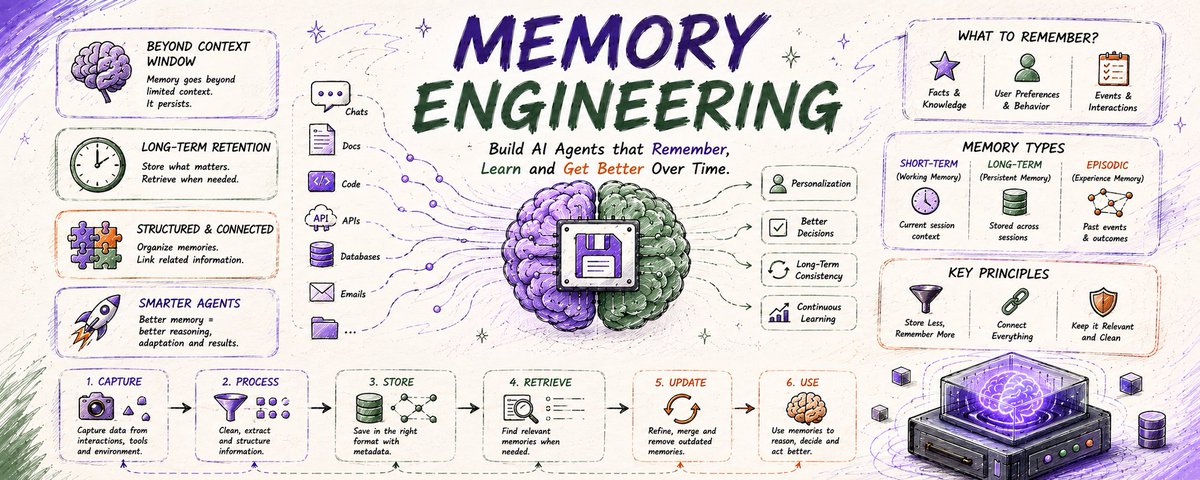
Memory Engineering: The Discipline That Decides Whether Your AI Agent Has a Past

本文探讨了AI代理的记忆工程,指出当前模型虽有完美智能却无记忆,每次会话后如同陌生人。作者批评了依赖扩大上下文窗口的行业做法,提出记忆工程应借鉴人类记忆的架构,通过选择性编码、整合、检索和遗忘来构建独立的记忆系统。文章详细介绍了五阶段流水线:捕获(过滤非持久信息)、整合(去重与合并)、检索(基于相关性提取)、以及后续的更新与遗忘机制,并附有Python代码示例。作者强调,记忆工程是决定AI代理能否拥有连贯过去的关键学科,目前鲜有人正确实践。

技术 › LLM wast3 2026-08-1517.2 KB 775.5K 451 81

你的AI第一次运行成功,这几乎证明不了什么

本文指出,AI系统首次运行成功并不能证明其可靠性,因为环境变化或输入差异可能导致失败。作者强调,评估(Evals)是确定AI系统可信度的关键,它要求基于实际工作场景收集案例,并明确“好”的标准。通过持续测试和迭代,评估集能帮助团队了解系统的边界和失败模式。文章还区分了公共基准与产品级评估,认为后者必须基于具体业务场景。最后,作者提倡将评估作为系统开发的核心部分,以确保AI在实际工作中的可靠性。

技术 › LLM Hiten Shah 2026-08-136.8 KB 18.8K 46 62

Inside an Applied AI company

本文深入探讨了应用型AI公司的核心运作模式,以保险行业为例,阐述了从初始70%准确率到承诺98% SLA的差距如何通过工程、GTM和应用AI团队的协作来弥合。文章强调了“harness”作为产品的重要性,包括工具、集成、文件系统、编排和监管五个方面,并指出评估(evals)作为平台核心原语的关键作用。作者认为,应用型AI公司通过紧密的客户反馈循环和垂直领域的深度整合,构建了难以复制的竞争优势,而非传统的数据护城河。

技术 › Agent Adithya Sanjay 2026-08-129.5 KB 68K 182 72

月薪7万的FDE工作体验:进厂贴二维码与AI落地实践

本文讲述了作者作为前线部署工程师(FDE)深入服装厂,落地AI报修系统的全过程。与单纯的写代码不同,FDE需要深入一线调研真实业务流程,明确可量化的交付指标。通过贴二维码解决设备识别问题,建立评估集(Evals)优化车间噪音干扰下的语音识别准确率,并在不断试用与反馈中平衡系统自动化与工人操作体验。文章揭示了AI应用落地面临的真实挑战,以及FDE作为客户与技术之间桥梁的核心价值。

技术 › Agent 程序员鱼皮 2026-08-1018.3 KB 10.4K 26 89

一名资深AI工程师配合Agent胜过五人团队

文章探讨了AI Agent如何改变工程团队结构,提出了“AI Velocity Pod”模式。该模式由一名资深工程师指挥AI代理,90天内完成了相当于五人团队2-3倍的代码产出。核心在于将瓶颈从编写代码转移到审核判断,通过V.U.E.标准和知识图谱确保质量,大幅降低了协调成本和人力开销。

技术 › Agent Mark Ajzenstadt 2026-08-0611.0 KB 628.9K 153

为什么 Claude Code 会话会随时间变差

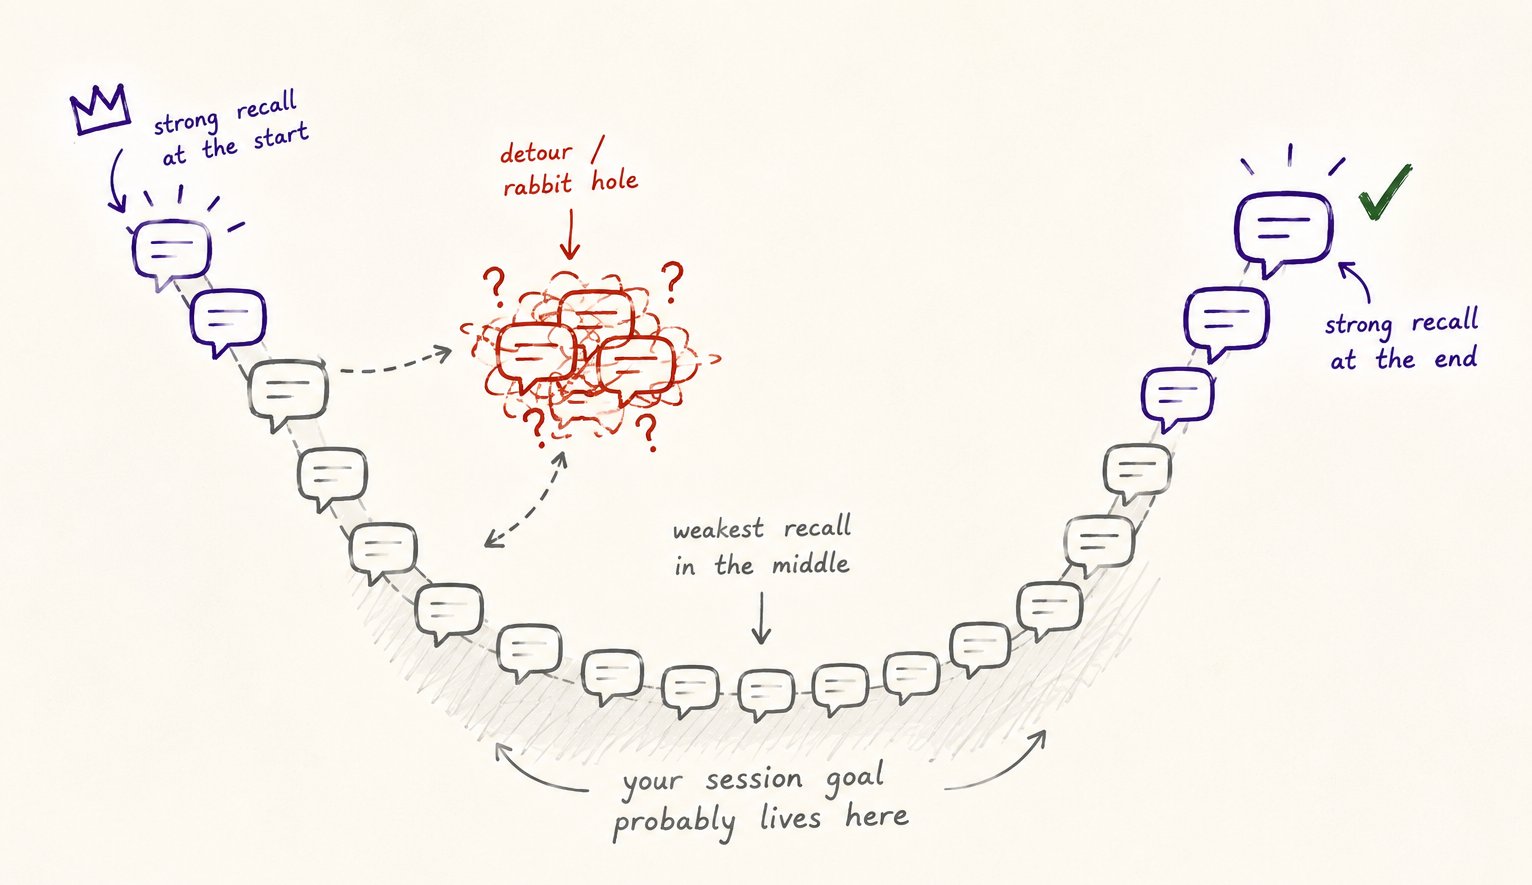
本文深入探讨了 Claude Code 等智能体工具在长对话中性能下降的现象。作者将其归因于“上下文腐烂”,分为无法避免的内在腐烂(模型架构限制)和可管理的内容腐烂(过时信息积累)。文章提供了具体的治理实践,包括前期策展、保持上下文清洁、及时重置以及使用 git 树结构管理会话,以维持工具的敏锐度。

技术 › Claude Code yibie 2026-08-0317.3 KB

Karpathy 发布 12 页指南:构建自我改进的多代理图

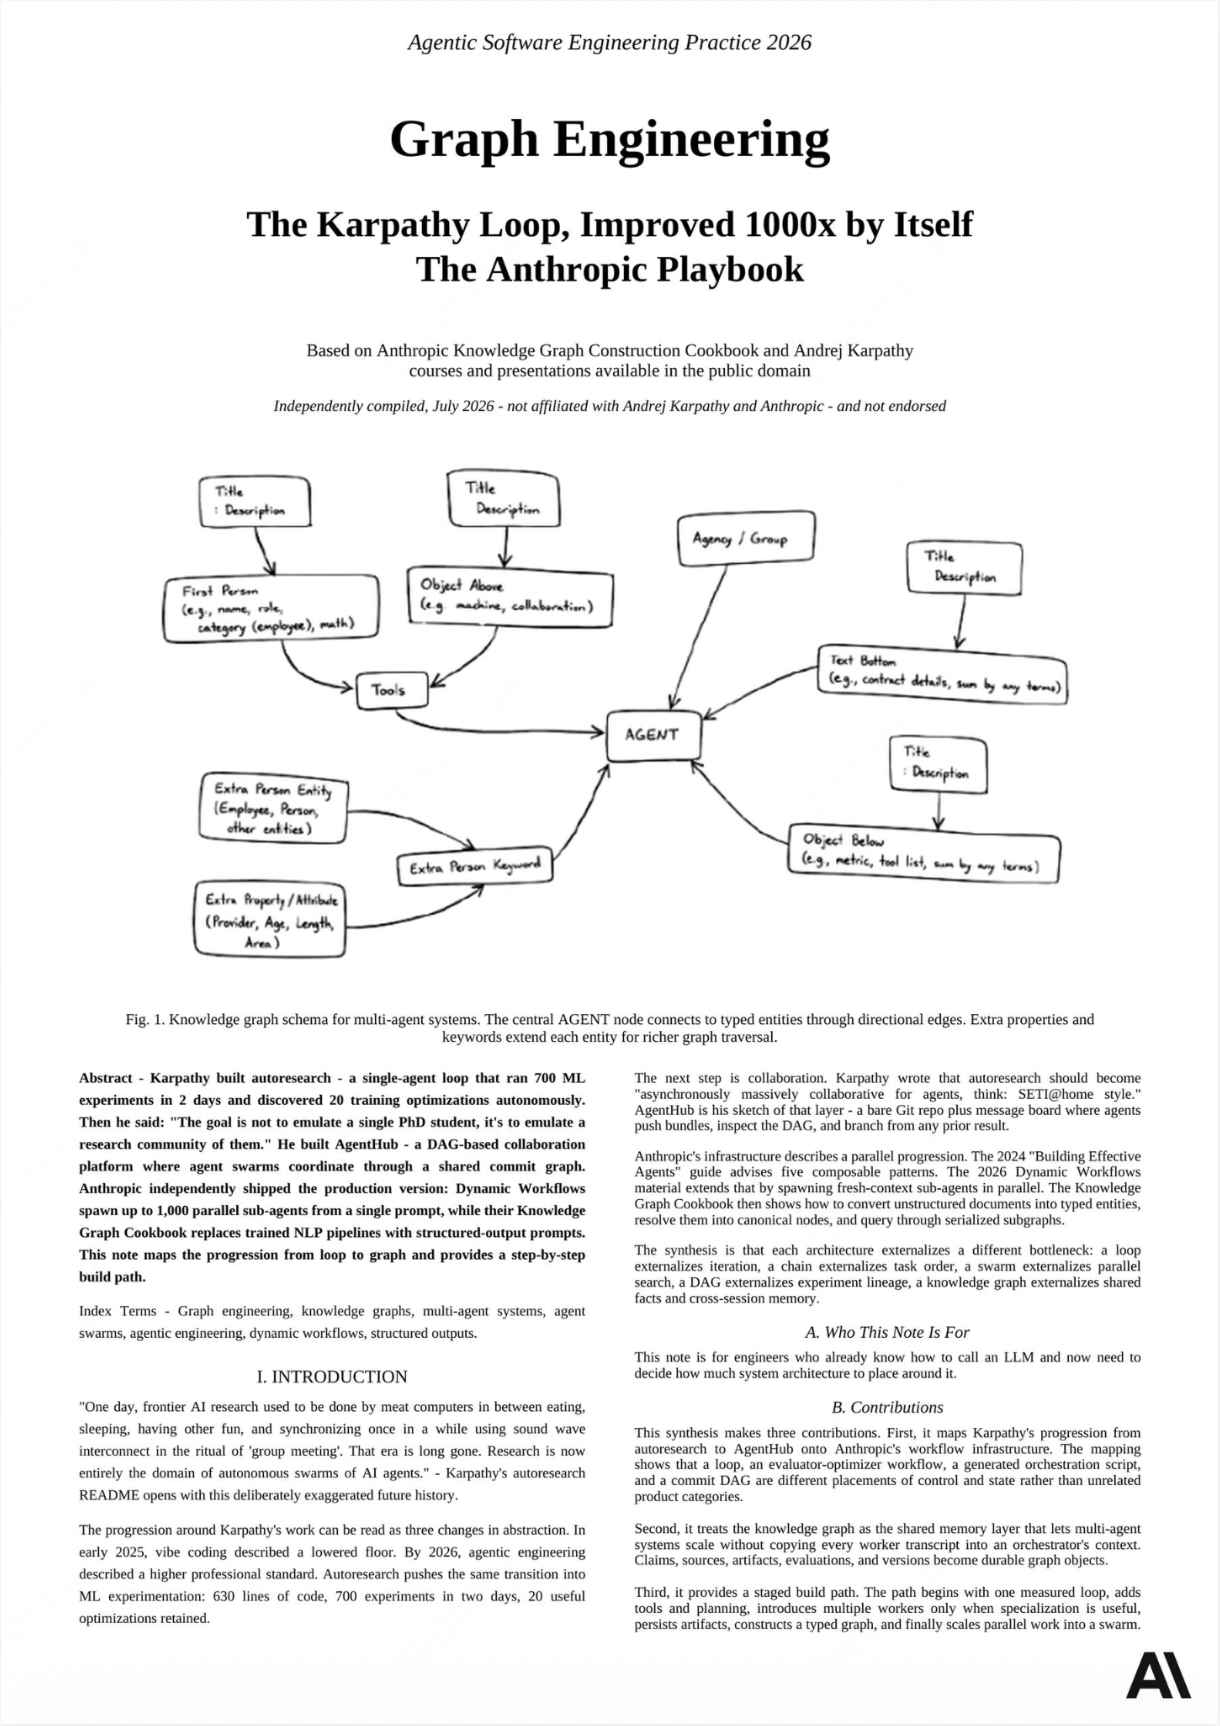
文章解读了 Andrej Karpathy 关于构建自我改进多代理图的 12 页指南。核心内容包括 Loop、Chain、Swarm 等架构模式,以及利用知识图谱作为共享内存的重要性。文中对比了 Karpathy 的工程实践与 Anthropic 的动态工作流,强调了未来 AI 应用的壁垒在于图谱工程和多智能体协作。

技术 › Agent Hux 2026-07-293.1 KB

实战踩坑:便宜模型执行、贵模型编排?没这么简单!

文章通过三个真实案例,验证了“贵模型编排、便宜模型执行”这一省钱策略。作者发现,虽然便宜模型在文本判定等任务上能打平顶尖模型,但在高复杂度代码和开放式视觉任务上存在局限。关键在于控制模型能力代差和任务可验证性,否则返工成本将抵消节省的 token 费用。

技术 › Agent WquGuru 2026-07-2812.1 KB 10.9K 25