Wiki 知识库

全部文档 / 标签: 成本优化

73 篇
清除

LLM 路由可能比不路由成本更高

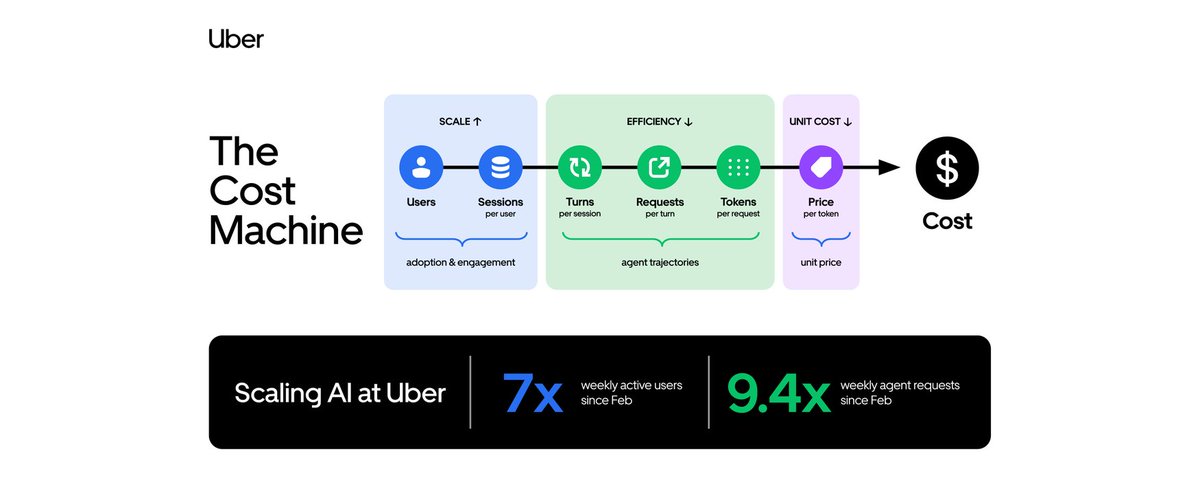
文章探讨 LLM 路由(LLM Routing)的成本悖论:理论上将简单任务分配给廉价模型可节省大量成本(如 RouteLLM 实现约 85% 降本),Uber 因给 5000 名工程师统一部署 Claude Code 导致年度 AI 预算提前耗尽的案例也说明单一模型定价的问题。但传统路由方案在生产中会因四大失败模式而失效:分类调用额外计费、通用模型意图识别能力差、路由逻辑缺乏评估易腐化、以及模型切换破坏 KV 缓存导致全价重算。文章随后介绍 DigitalOcean 基于开源代理 Plano 的基础设施级路由方案:使用 1.5B 参数的专用路由模型(Arch-Router / Plano-Orchestrator)在代理内完成意图解析,准确率超越前沿大模型且更快,再结合成本与延迟数据对候选模型池按策略排序,实现成本与质量兼顾的动态路由。

技术 › LLM Akshay 2026-09-0715.7 KB 49.9K 475 75

BestBlogs 早报 · 09-03|Gemini 3.8 升级,Claude 构建电商智能体,GitHub 降本

本期早报聚焦 AI 成本与智能体工程实践。精讲一:Google 发布 Gemini 3.8 Flash 系列与面向漏洞修复的 Cyber 变体,提示模型单价与任务总成本需分开评估。精讲二:Anthropic 电商智能体指南,讲解会话状态、技能加载、缓存组织、业务规则执行与评测快照等生产实践。精讲三:GitHub 通过选择性压缩输出、移除行号、批量通知等手段降低 Copilot 推理成本,并强调提示词压缩需配合行为回归测试。速览涵盖 Claude Fable/Mythos 5.1 缓存价格变化、大淘宝 AI 研发体系、Claude Code 团队开发流程及 AI 组织与责任等话题。
技术 › LLM ginobefun 2026-09-0324.9 KB 3.3K 3 85

How to slash token costs with context caching in agent harnesses

本文介绍如何利用 Google Gemini Enterprise Agent Platform 的上下文缓存(Context Caching)大幅降低 Agent Harness 的 token 成本。文章指出无状态 LLM 在多轮编码循环中会重复传输静态代码库导致 token 累积和成本暴涨,并剖析了前缀破坏陷阱——缓存要求提示词从第 0 个 token 起字节级匹配,动态变量必须放在提示词末尾。作者展示了服务端缓存的工作原理及双重节省模型(带宽节省与缓存 token 0.25 倍计费),并通过 CachePayloadBuilder 和 ContextCacheManager 实现缓存流水线。实测三个场景显示传输 token 减少 74%-79%。最后给出决策树:上下文小于 32768 token 或少于三轮时不应缓存。

技术 › Harness Engineering Balaji Subramaniam 2026-09-0310.3 KB 46.4K 366 82

Gemini 推出 Agentic 视频理解能力

Google 在 Gemini 3.7 Flash、3.6 Flash 和 3.5 Flash-Lite 模型上推出 agentic video understanding(智能体式视频理解)功能。该功能让模型主动决定观看内容、速度和模态(画面、音频或字幕),动态检索和检查视频片段,而非按固定帧率静态处理。基准测试显示,成本最高降低 66%,token 消耗最高降低 88%,准确率提升最高 7%,在长视频分析中优势尤为明显。新能力包括亚秒级片段检索、长视频大海捞针式搜索、异常检测和精确计数等。该功能已通过 Gemini API、Google AI Studio 和 Gemini Enterprise Agent Platform 开放,未来将集成到 Gemini 应用和 YouTube 的 Ask YouTube 功能中。

技术 › LLM Google AI Studio 2026-09-028.7 KB 67.4K 856 78

AI 原生思维——像训练大模型一样训练自己

本文整理自宝玉在腾讯的内部分享,围绕 AI 原生思维展开两部分内容:一是 AI 产品方法论,以他自制三年的字幕翻译 App BaoCut 为案例,系统讲解找需求、判边界、最小验证、重设计与落地交付的完整过程。他提出判断 AI 需求的三问(痛点、用户、能力边界)、AI 产品的三条边界(能力、成本、价值),以及'产品三问'等实操规则;二是探讨个体如何与 AI 共同进化,提出'像训练大模型一样训练自己',通过建立反馈循环、费曼学习法持续进化,并敢于推翻旧认知。文章还总结了让 Agent 操作擅长格式、给规范不给模板、把 App 做成 Agent 插件等设计准则,兼具产品思维与个人成长视角。

技术 › Agent 宝玉 2026-09-0125.4 KB 544.9K 1.2K 90

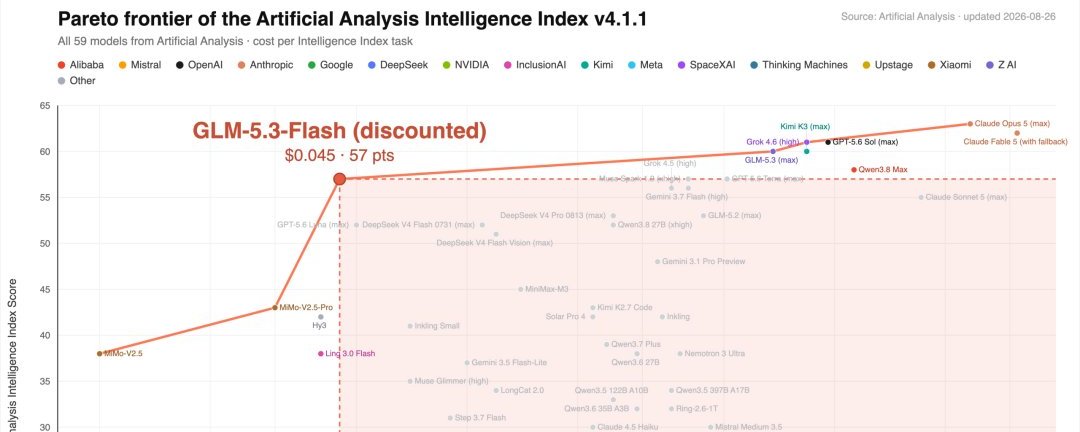
实测智谱 GLM-5.3-Flash,我称之为能稳稳把 DeepSeek 纳入斩杀线

作者实测智谱新发布的 GLM-5.3-Flash 模型,对比 DeepSeek V4 Flash 的价格与性能。该模型每百万 Token 输入 0.8 元、输出 2.8 元,在 Artificial Analysis 榜单上以 $0.045 成本获得 57 智力分,14 项 benchmark 中赢 DeepSeek 11 项,视觉端六项全胜,与 Opus 4.8 对比 13 项赢 9 项。实际测试中,模型可通过一句话从截图、视频、链接复刻网站(如 GitHub、3D 游戏 Krunker),前端与视觉能力极强。作者计划将日常 coding 和 agent 任务分流给它以节省成本。

技术 › LLM 卡尔的AI沃茨 2026-08-3111.6 KB 1.9K 1 71

Running a Software Factory Efficiently at Uber Scale

本文介绍 Uber 如何在软件开发生命周期中高效运行 AI 软件工厂。目前 Uber 超过 70% 的 PR 由本地或云端 agent 完成,工程师构建了 3600+ 个 agent 技能,每天执行超 3 万次。文章提出软件工厂的四层 agent 使用架构,并将成本分解为六个可独立测量和优化的因子。通过基于真实工作构建的基准测试进行 Pareto 最优的模型选择、将子 agent 默认路由到更经济的模型、自动上下文压缩等优化手段,Uber 在模型不变的情况下将每千次请求成本降低约 34%,单会话成本较峰值下降 52%,实现了规模化的 AI 工程效率与成本控制。

技术 › Agent Uber Engineering 2026-08-2921.3 KB 2.7M 4.8K 84

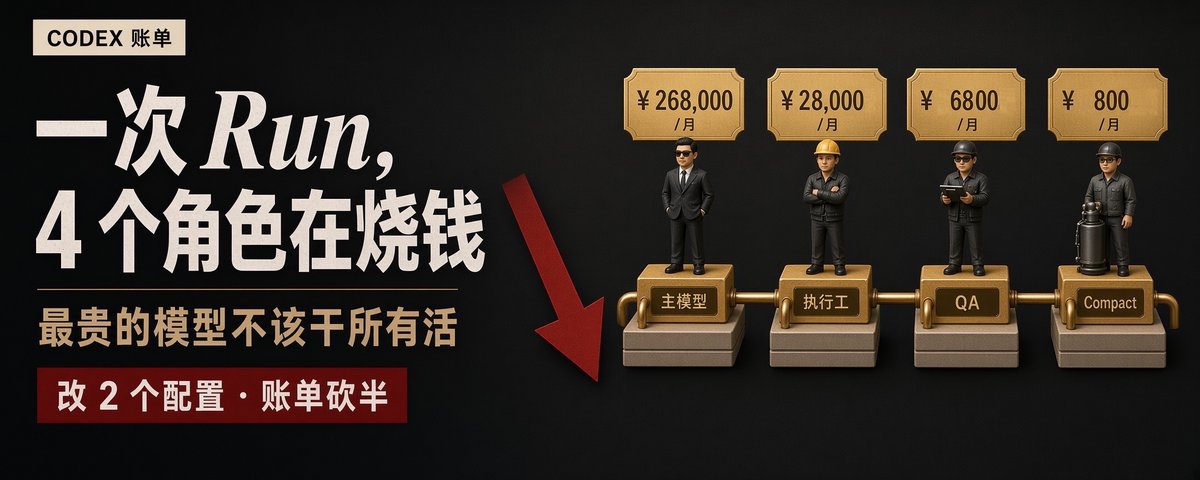
Codex 省钱教程:用分级模型架构砍掉 70% 开发成本

文章解析了 Codex 内部的四角色模型调用链(主模型、子 Agent、Review 模型、Compact),指出默认所有角色都用最贵模型导致成本过高。作者提出分级配置方案:主模型保留顶配负责规划决策,Review 和子 Agent 换用轻量平价模型,只需修改 config.toml 和 worker.toml 两个配置文件即可永久生效。文章还给出国产火山方舟的配置示例及其他省钱思路(Terra Max、Spark 高速模型等),强调好模型想清楚、便宜模型干活的分工思维可推广至未来 Multi-Agent 系统。

技术 › Codex 疯狂的烤妹儿 2026-08-276.3 KB 17K 15 81

说一句收到,我花了20341个token——Agent成本的过路费与省钱三刀

作者发现验证Agent成员是否存活时,一句简单的「收到」竟消耗两万个token,原因是每次对话都要重新装配成员的身份、记忆、技能清单等。文章剖析了Agent成本的三层「过路费」结构:身份装配、上下文搬运和格式开销,指出七成token花在空驶而非思考上。作者提出三刀止损法:利用前缀缓存把不变内容前置、健康探针直连绕过人格装配、协作转手只传摘要。实施后成本降了一半以上,但同时也暴露出便宜诱发滥用、缓存惩罚变动等新问题,并引出本地化部署的机会成本与主权优势思考。

技术 › Agent AI最严厉的父亲 2026-08-2529.5 KB 8.6K 5 85

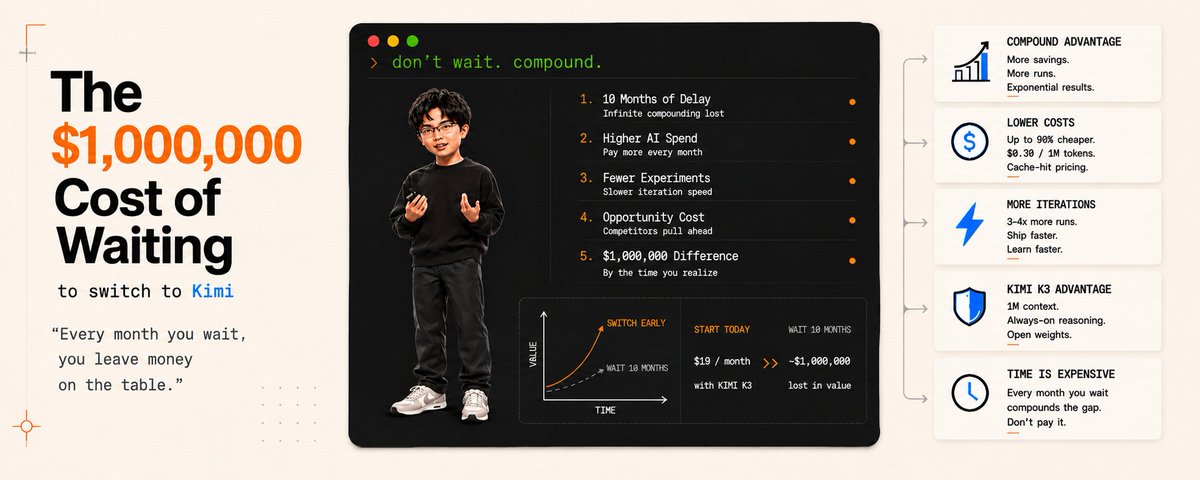
等待切换到 Kimi 的百万美元代价

文章以复利投资为类比,论述延迟切换到更便宜的 AI 模型(如 Kimi)的隐性成本。通过 Emma 和 James 两位投资者的对比说明时间复利的威力,指出 AI 开发中省下的推理成本可转化为更多实验、更快学习,形成复利式优势。昂贵推理就像投资中的管理费,悄无声息地拖累长期发展。建议按任务匹配模型,尽早利用低成本推理加速产品迭代,因为错过的实验时间无法事后弥补。

技术 › LLM leopardracer 2026-08-249.8 KB 406.1K 150 52

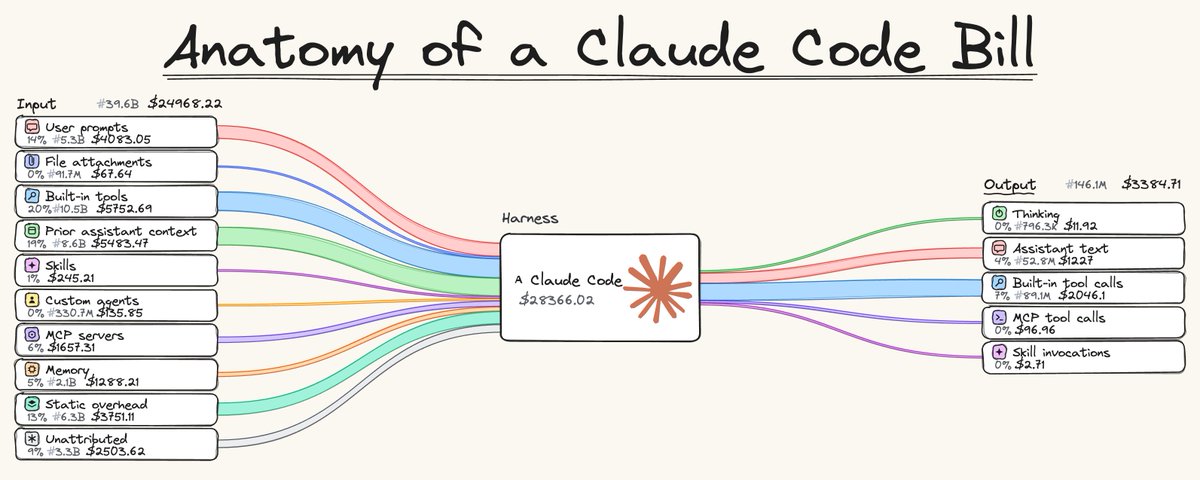
The Anatomy of a Claude Code Bill

本文基于对45人工程团队30天的Claude Code使用追踪,剖析了其账单构成:真实用户提示仅占输入token的14%,其余为静态系统开销、CLAUDE.md与Skills、MCP服务器schema、工具结果回放及历史上下文等配置性开销。文章指出Uber等大规模部署中人均月支出高达500-2000美元,并介绍了Comet在Opik中推出的Cost Intelligence代理插件,通过token级可观测性帮助团队识别浪费,15分钟审计可削减20-40%账单。

技术 › Claude Code Akshay 2026-08-2412.8 KB 18.1K 139 75

靠这10个优化点,我们把Multi-Agent工作流成本降了50%以上

作者团队用 AI Agent 驱动前后端全流程开发(1个TL+6个子Agent),token成本高昂。通过AgentLens度量发现系统提示词、工具返回信息、历史消息是消耗大头。围绕'只看当前需要的上下文、减少无关上下文、减少重复上下文'三原则,实施了渐进式披露、CLI替代MCP、MCP子Agent化、长期记忆索引加载、多Agent拆分、工具白名单等10项优化,全流程降本50%~65%。

技术 › Agent l lemonye 2026-08-2228.5 KB 86

Token工程的四大实用支柱:超越提示压缩的成本优化

本文介绍了在大规模AI应用中优化token成本的四大实用支柱:一是上下文缓存与Agent循环修剪,通过裁剪中间工具输出和总结历史步骤保持提示精简,利用缓存可获最高75%的输入折扣;二是实时与批量推理,将非紧急任务如工单汇总、报告生成等打包为异步批处理,可享50%折扣;三是设置思考预算,避免推理模型在简单任务上消耗数千隐藏思考token;四是模型合理选型与持续评估,90%的任务应使用最小最便宜的模型,并通过自动化评估及时更换高效模型,配合Apigee AI Gateway等企业网关实现智能路由与安全防护。

技术 › LLM Google Cloud Tech 2026-08-227.4 KB 36.7K 345 77

Spend Less Tokens:如何削减90%以上的AI Token开销

文章指出企业AI token开销可削减90%以上,关键在于改变自动化设计思路。多数企业工作流本质上是确定性的,大部分步骤可用普通代码完成,仅在需要判断的环节才需要模型。作者提出不应以整个工作流为自动化单位,而应拆分为单个任务,分别评估智能需求,采用最小可用模型,并利用缓存复用已知输出。其团队采用90/9/1模型分配策略(90%非前沿模型、9%近前沿、1%前沿),实现以最低token成本获取最大效率提升,强调应衡量智能的ROI而非原始开销。

技术 › Agent vas 2026-08-1811.0 KB 148.7K 541 77

BestBlogs 早报 · 08-17|设计师焦虑、RAG 持久化与 Kalanick 实体自动化方法论

本期早报包含三个核心话题:Lenny 调研显示设计师焦虑源于角色期望不清,OpenAI 产品负责人提出双速节奏与 Do Less 策略;技术方面探讨 RAG 系统设计持久化知识层以解决推理成果丢弃问题;商业部分复盘 Travis Kalanick 的实体自动化方法论及滴滴补贴战经验。此外涵盖 Qwen 3.8 过度思考问题、Agent 优化陷阱及 API 降本策略等速览内容。

技术 › LLM ginobefun 2026-08-1734.5 KB 17.7K 4 81

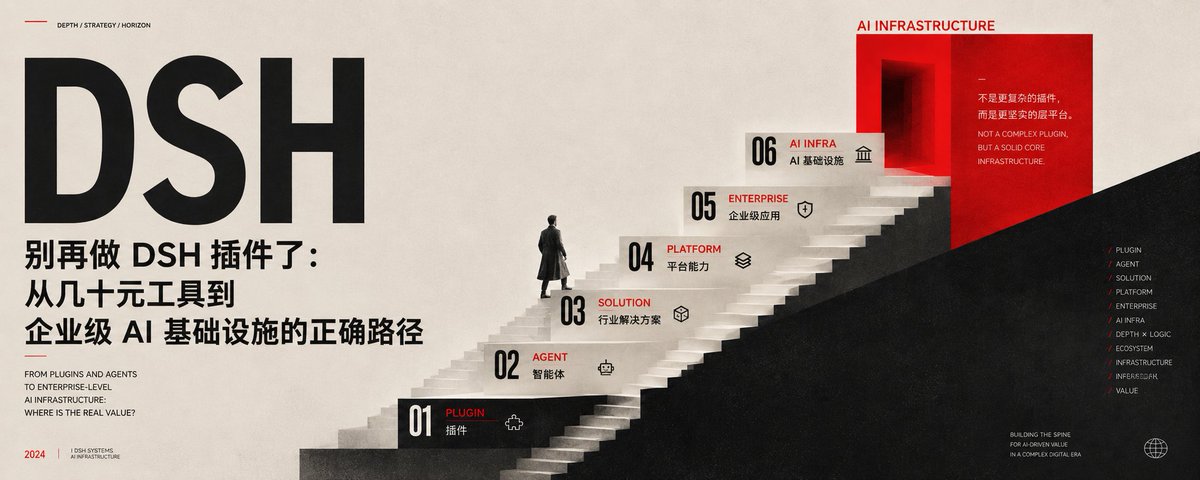
别再做 DSH 插件了:从几十元工具到企业级 AI 基础设施的正确路径

本文探讨了 DSH 生态的商业化路径,指出竞争焦点正从模型智能转向 AI 执行系统。文章提出商业化应遵循“插件→Skill→Profile→Workflow→Agent→行业解决方案→企业 AI 基础设施”的升级路线,并分析了垂直 Agent、付费插件、成本优化、企业私有化、Workflow 自动化等六个方向,强调以业务结果为导向,构建真正的商业壁垒。

技术 › Agent 知识猫AI实验室 2026-08-1625.0 KB 15.1K 59 82

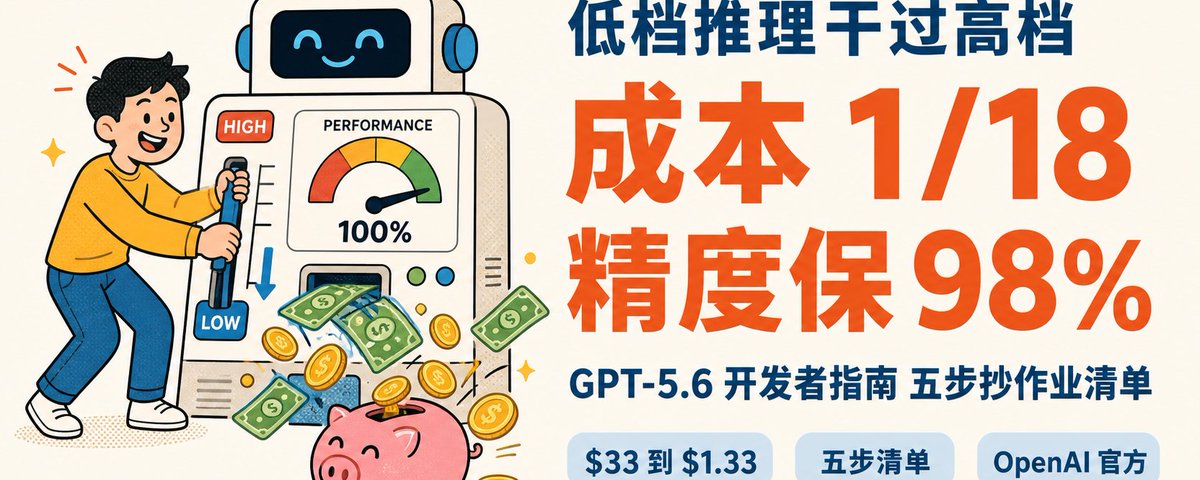
低档推理干过高档、成本 1 18 精度保 98%:GPT-5.6 开发者指南里的五步抄作业清单

OpenAI 发布 GPT-5.6 开发者指南,通过多个案例展示 agent 成本优化的巨大潜力。指南指出,通过降低推理档位、分层使用模型、利用推理持久化与压缩、Programmatic Tool Calling 及缓存优化等策略,可在保持甚至提升性能的同时大幅降低成本。文章提供了五步实操清单,帮助开发者有效控制 API 成本,并强调架构优化比单纯追求更强模型更具经济价值。

技术 › LLM Jason Zhu 2026-08-156.6 KB 1.5K 2 83

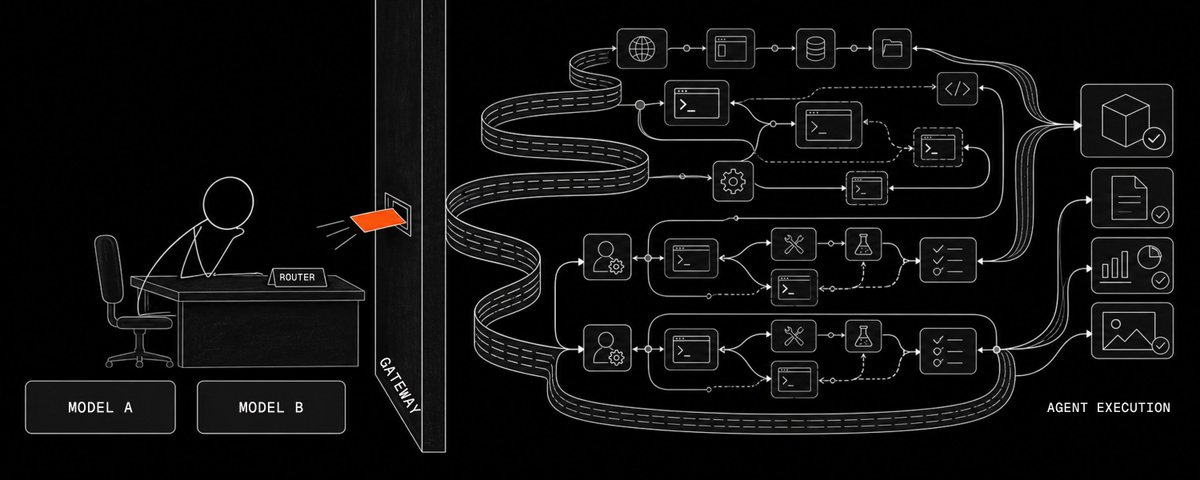
Why model routing must be in the harness

本文探讨了模型路由为何应置于代理的harness中而非网关层。随着代理部署扩大,推理成本上升,模型路由成为控制成本的关键。作者基于生产数据指出,harness层路由可降低58%成本且不损质量,因为harness能结合会话缓存、任务状态和结果来动态选择模型,而网关缺乏这些上下文。文章强调,模型切换需权衡缓存失效成本,只有harness能判断何时切换最经济。

技术 › LLM Abhay Singhal 2026-08-1514.0 KB 173.3K 349 75

DeepSeek Harness + OpenCode Go:完整指南

本文是DeepSeek Harness(dsh)与OpenCode Go订阅制模型网关的集成指南。作者详细介绍了为何选择该组合、安装步骤、配置方法,并通过一次真实的生产巡检案例展示了其成本效益。文章强调dsh的插件化架构与OpenCode Go的OpenAI兼容端点天然匹配,仅需两个环境变量即可切换推理流量。通过实测数据,作者分析了agent循环的输入放大效应、96.5%的缓存命中率以及订阅制在成本控制上的优势。最终,文章提供了完整的配置步骤和实战复盘,帮助开发者快速上手并高效利用该组合。

技术 › LLM WquGuru 2026-08-1413.6 KB 11.2K 42 83

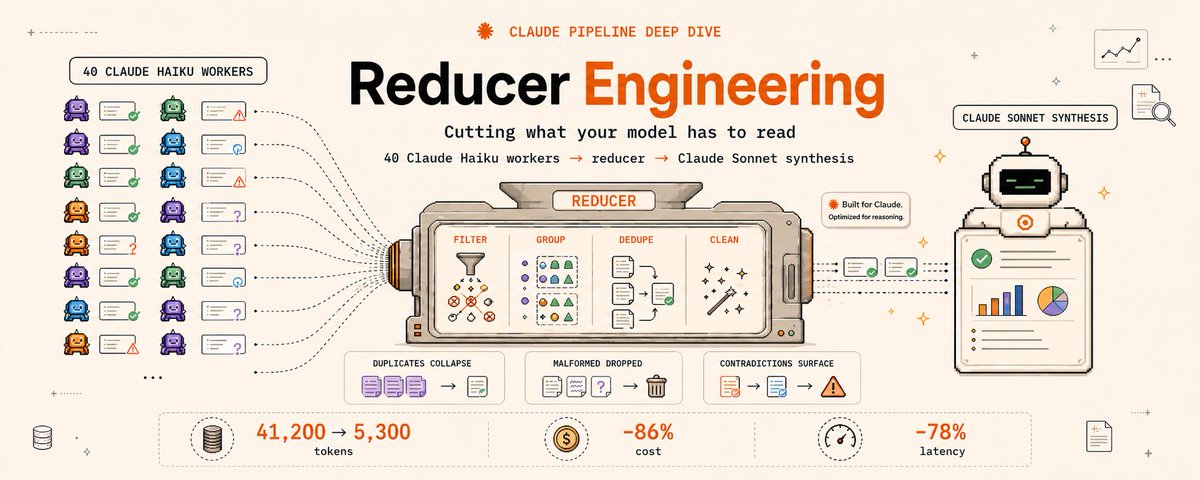
Reducer Engineering: Cutting What Your Model Has To Read (Full Guide)

本文介绍了在多智能体流水线中,通过引入确定性Reducer层来优化成本与延迟的实践。作者以40个Claude Haiku worker并行处理、Claude Sonnet汇总的架构为例,指出原始输出包含大量重复、格式错误和冗余信息,导致昂贵的合成模型浪费在数据清洗上。通过代码实现去重、过滤和分组,成本降低86%,延迟降低78%,并意外发现23处矛盾。文章强调结构化归约不仅是成本优化,更是质量保障,并提供了代码示例、防护措施和操作指南。

技术 › LLM Gipp 2026-08-119.1 KB 330.8K 323 82

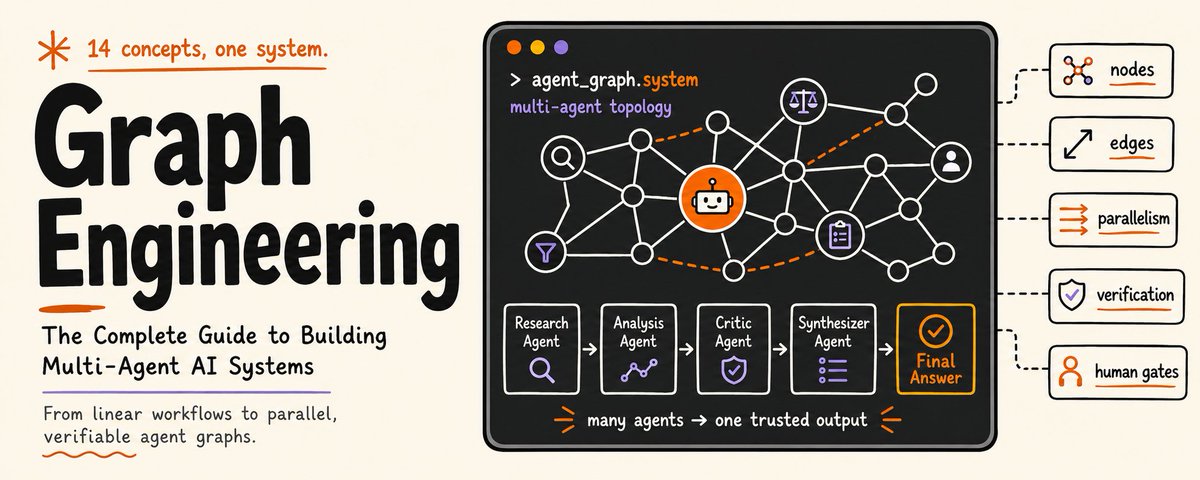
图工程:构建多智能体系统的完全指南

构建多智能体系统的核心挑战不在于提升单个智能体的能力,而在于如何协调工作流,这被称为“图工程”。文章指出,应将系统视为依赖图,区分真实依赖与虚假顺序,并引入结构化状态。同时强调要控制并行宽度以优化成本,关注关键路径以降低延迟。此外,建议在最终推理前使用代码进行确定性的数据压缩与归约,并采用非对称验证机制,从而打造高效、易调试的AI系统。

技术 › Agent Lunar 2026-08-0917.8 KB 2M 571 88

Codex成本直降16倍!一键接入DeepSeek V4 Flash

本文介绍了如何将DeepSeek最新推出的V4 Flash模型接入Codex工具。通过官方脚本一键配置,用户可以在保持Codex强大编程工作流的同时,大幅降低AI编程成本。文章详细讲解了DeepSeek V4 Flash的更新特性、API申请流程以及在不同终端中的配置与使用方法。

技术 › 工具与效率 比特小师妹|KiKi 2026-08-067.3 KB 3.4K 10

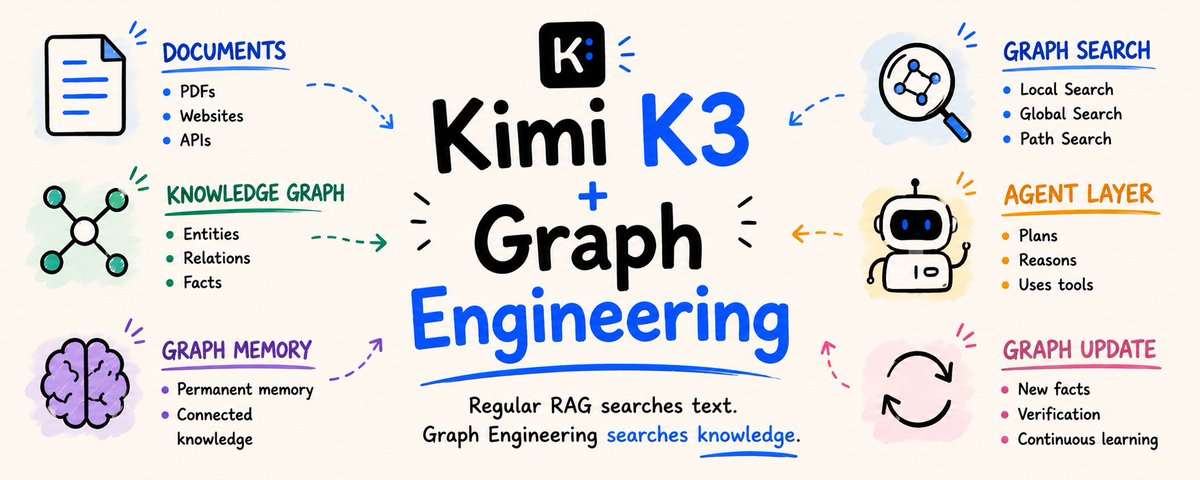
如何使用 Opus 5 进行图工程

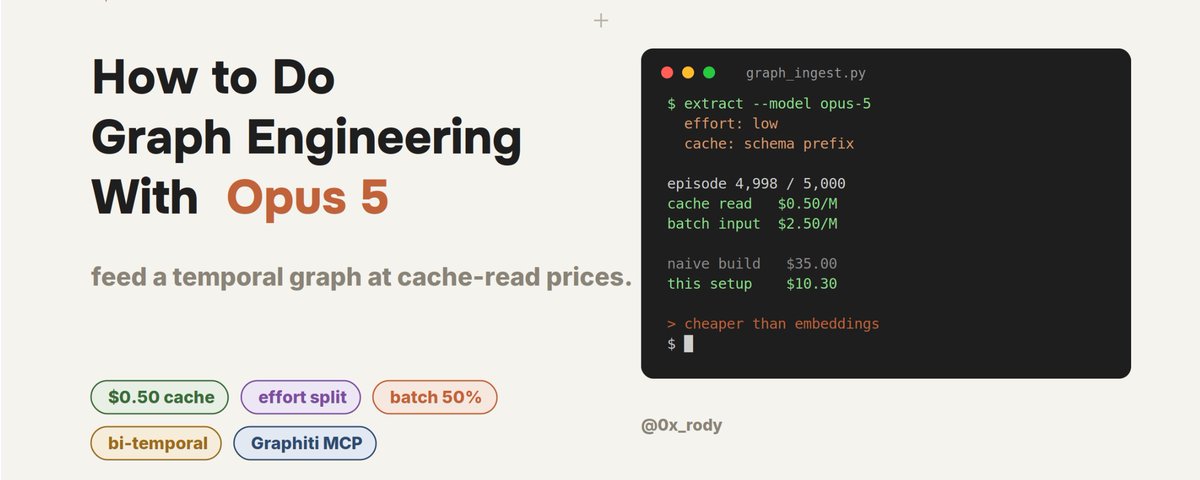
文章介绍了如何利用 Opus 5 的新特性(如缓存控制和低 effort 模式)低成本构建图记忆。核心在于将提取和遍历分离:提取使用低 effort 和缓存前缀以降低成本,遍历使用高 effort 以保证推理质量。通过优化配置,图工程的成本可降至原本的三分之一,甚至低于向量存储。

技术 › Hermes rody 2026-08-068.7 KB 1.9M 633

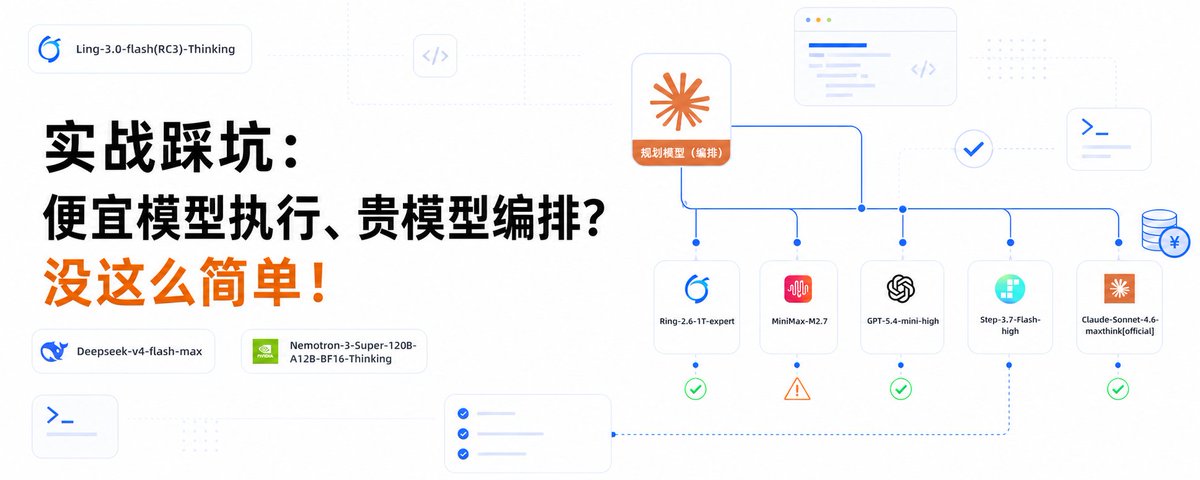
实战踩坑:便宜模型执行、贵模型编排?没这么简单!

文章通过三个真实案例,验证了“贵模型编排、便宜模型执行”这一省钱策略。作者发现,虽然便宜模型在文本判定等任务上能打平顶尖模型,但在高复杂度代码和开放式视觉任务上存在局限。关键在于控制模型能力代差和任务可验证性,否则返工成本将抵消节省的 token 费用。

技术 › Agent WquGuru 2026-07-2812.1 KB 10.9K 25

Getting the most out of GPT-5.6: Sol, Terra, and Luna

文章介绍了GPT-5.6系列的三种模型Sol、Terra和Luna的特点与适用场景,详细分析了它们在速度、成本和智能方面的差异。此外,文章还讨论了如何通过推理级别调整、缓存读取和多代理工作流来优化使用体验,并提供了选择最佳模型的策略。

技术 › Codex Cerebras 2026-07-289.4 KB 660.8K 1.7K

如何使用 Kimi K3 构建你的第一个 AI Agent 循环

本文介绍了如何利用 Kimi K3 模型的高性价比缓存机制构建 AI Agent 循环,包含原理图解、Claude Code 配置及原生 API 代码示例。文章详细阐述了目标设定、自动化检查、成本控制(低至 $0.39/轮)及常见避坑指南,帮助开发者实现自动化代码修复任务。

技术 › Agent darkzodchi 2026-07-207.3 KB 172.6K 80

Agents Need a New Kind of Web Search

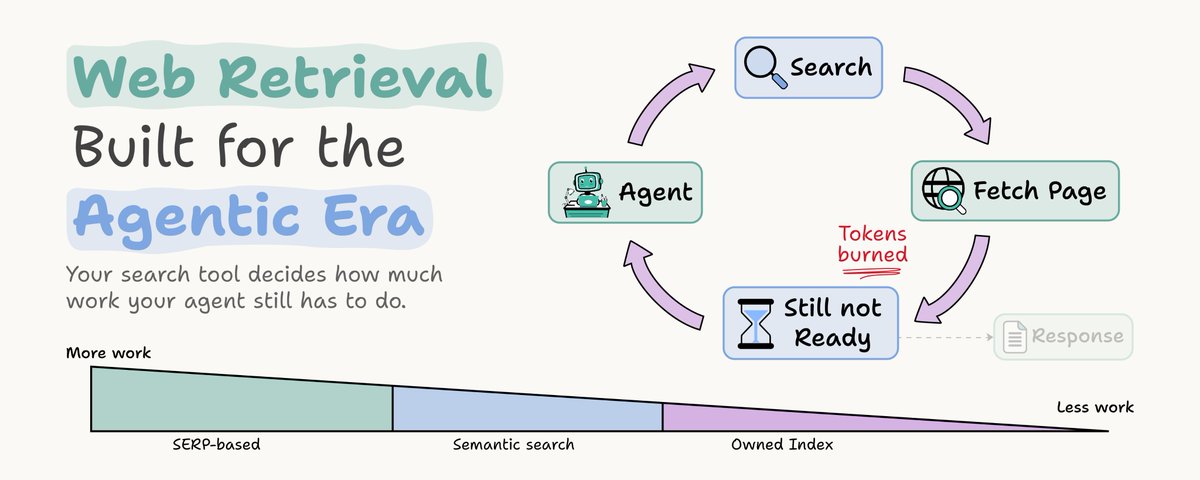
文章探讨了当前 AI Agent 在使用传统网页搜索时面临的“检索税”问题。传统搜索 API 仅返回链接和摘要,迫使 Agent 耗费大量 Token 去抓取和清洗内容。作者通过对比实验指出,使用预先爬取并结构化处理的索引(如 Seltz)能显著降低成本并提升效率,这种返回完整文档而非指针的方式是 Agent 搜索的未来。

技术 › Agent Akshay 2026-07-179.7 KB 72.1K 152

魔搭每天 2000 次免费 API,我把它接进了 Agent 工作流

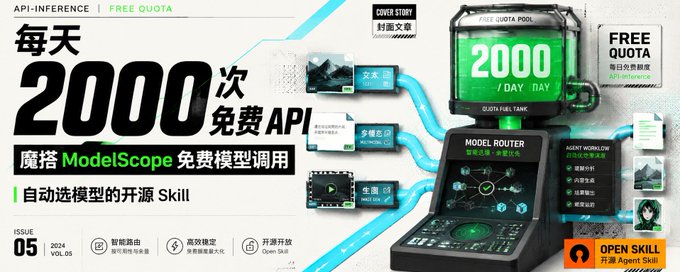
文章介绍了如何利用阿里云魔搭 ModelScope 每日 2000 次的免费 API 额度,将其接入 Agent 工作流以降低 AI 创作成本。作者详细讲解了账号注册、API Key 获取、模型筛选与调用的全过程,并开源了一个名为 `tiezhu-modelscope-api-inference` 的 Skill,实现了自动额度管理和多模态任务处理。

技术 › Agent 铁柱AGI 2026-06-2914.3 KB 3.3K 16

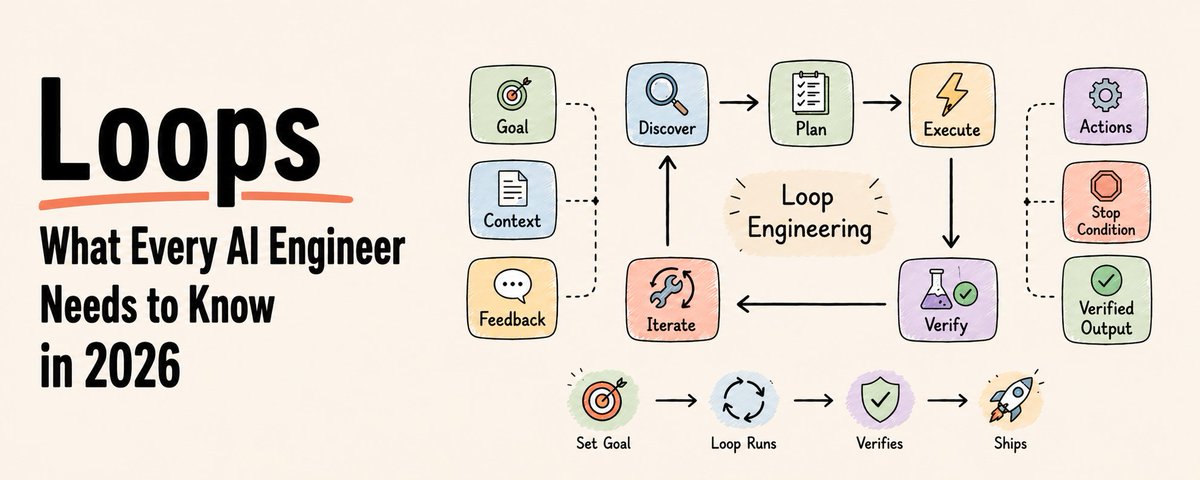
2026年AI工程师的核心技能:Loop(循环)工程

文章探讨了2026年AI工程范式的转变:从单纯的“提示词工程”转向设计自动化的“循环系统”。OpenAI与Anthropic的专家指出,工程师的角色已变为编写控制Agent的循环。文章深入解析了循环工程的定义、单体Agent与编队模式的区别,以及开放式与封闭式循环的差异。此外,文章重点讨论了循环模式带来的高昂Token成本问题,指出DeepSeek等低成本、大上下文的中国大模型是解决这一经济瓶颈的关键。

技术 › Agent Rahul 2026-06-1036.0 KB 4.8M 3K