从 CoT 到 ReAct:用 Python 搭建 LLM Agent 实战指南
本文通过 Python 演示了如何搭建一个具备规划、工具调用、验证和复盘能力的完整 LLM Agent。教程详细拆解了 Plan-and-Solve、ReAct、Verification、Self-Refine 和 Reflexion 五个核心模块,强调了结构化数据控制流程的重要性,并提供了工程落地的具体代码实现与原则。
本文通过 Python 演示了如何搭建一个具备规划、工具调用、验证和复盘能力的完整 LLM Agent。教程详细拆解了 Plan-and-Solve、ReAct、Verification、Self-Refine 和 Reflexion 五个核心模块,强调了结构化数据控制流程的重要性,并提供了工程落地的具体代码实现与原则。
文章提出了一种结构化的 Agent 沟通协议“Spec”,包含目标、完成标准、约束等 8 项必填清单。通过明确协议而非单纯依赖 Prompt 技巧,可显著降低 Token 消耗,提升任务一次性完成率,避免 Agent 猜测与无效返工。
作者利用Kimi K3模型,在不到一天时间内开发出一款对标ScreenStudio的免费macOS原生录屏App HuaStudio。文章详细记录了从需求分析、分阶段开发到解决系统级Bug的全过程,肯定了K3在长程规划、代码执行和Debug方面的能力,认为其体验接近Opus 4.8。
文章介绍了 Anthropic 推出的 Claude Skills 功能,通过文件夹和 YAML 配置实现渐进式披露,显著减少 Token 消耗和重复解释。详细说明了技能的构建规则、命名规范、测试方法及分发策略,帮助用户将聊天机器人转化为高效的专业工程团队。
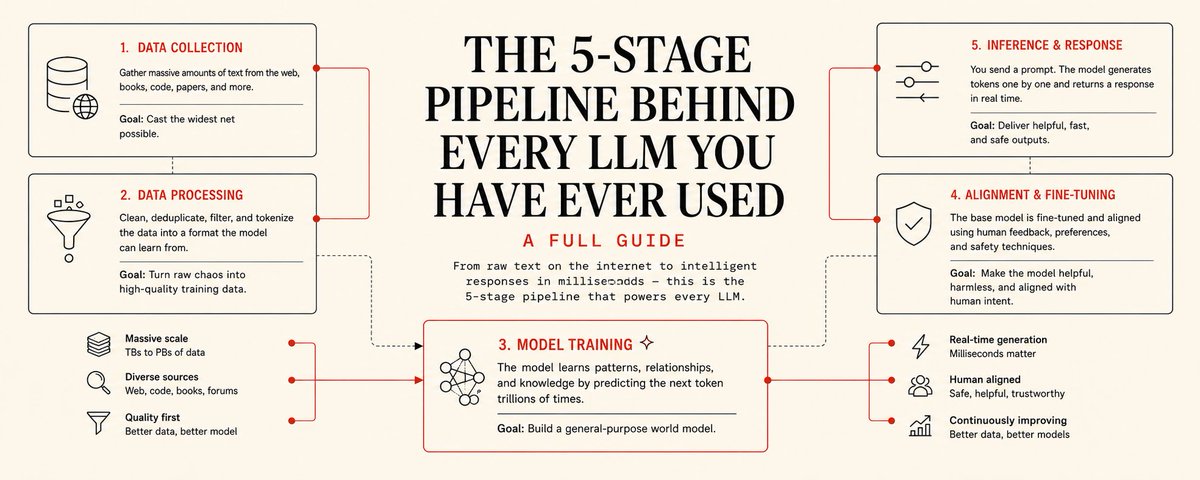
文章详细解析了构建大型语言模型的五个关键阶段:数据收集与预处理、预训练、及后续阶段。作者指出,大多数误解源于将“训练”视为单一步骤,实际上每个阶段解决不同问题。理解这一流程有助于识别模型行为根源及局限性,如幻觉或拒绝回答,并指导优化策略。
本期早报聚焦 AI 工程落地,精讲 Bun 用 64 个智能体 11 天重写 53.5 万行代码、腾讯 DECO 用 Hook 治理 LLM 偷懒越权、NVIDIA Nemotron 登顶检索榜。此外涵盖 Kimi K3、Inkling 模型、全双工语音等速览,强调竞争焦点从模型参数向工程实践迁移。
文章介绍了如何使用 Telnyx AI Assistant Builder 构建生产级客户支持语音代理。教程涵盖了低延迟音频流、中断处理等工程挑战,并演示了通过 FastAPI Webhook 注入实时业务上下文(如排队时间、系统状态)的方法,无需自行搭建 STT、LLM 和 TTS 管道。
文章探讨了向前沿AI实验室出售训练数据这一暴利行业的现状。虽然部分公司单季营收可达数千万美元,但该业务缺乏持续性,本质是出售专家判断力、模拟环境等。由于模型能力迭代极快,数据供应商面临订单随时消失的风险,是一场巨大的淘金游戏。
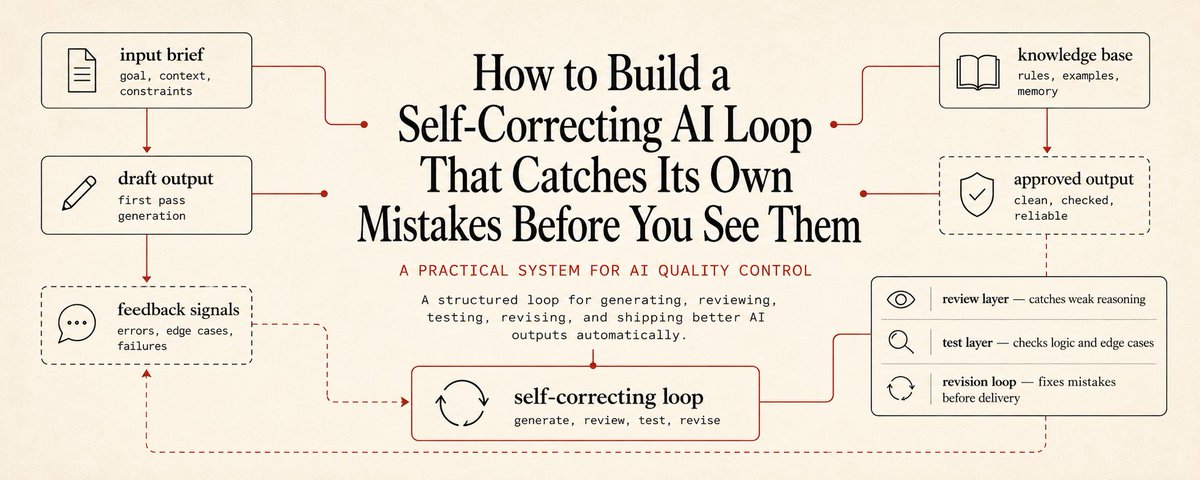
文章介绍如何构建一个 AI 自我纠错系统,通过分离生成、判断和管理三个角色,避免人工介入验证。关键在于利用独立的标准(如测试套件)进行结构化验证,而非简单的重复提问,从而实现自动化错误捕捉与修复。
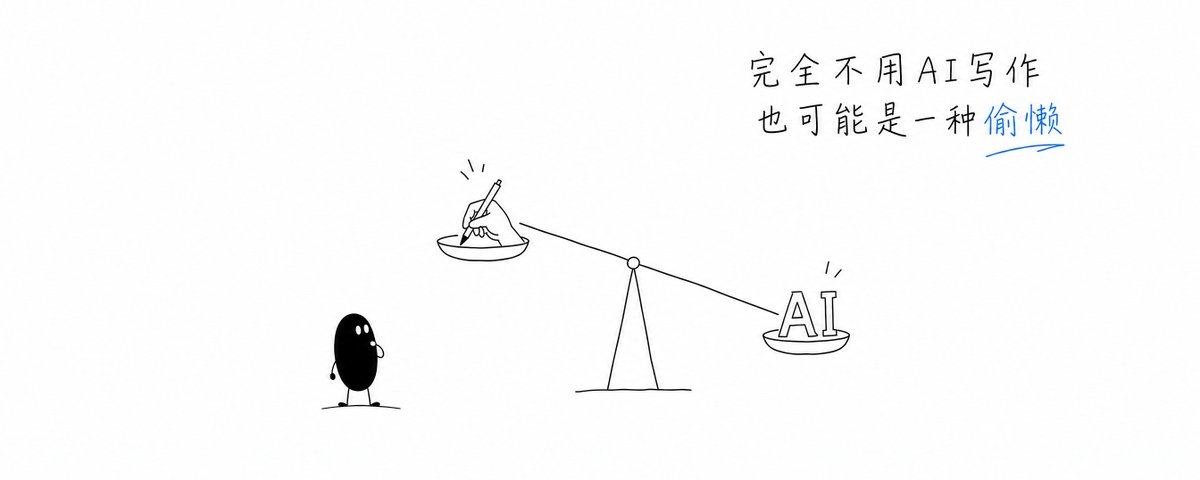
文章探讨了在写作中使用 AI 的态度。作者指出,完全不用 AI 可能是逃避将模糊直觉转化为清晰判断的思考过程。真正的关键不在于工具本身,而在于作者是否能承担选择和责任,确保作品反映真实的思考。
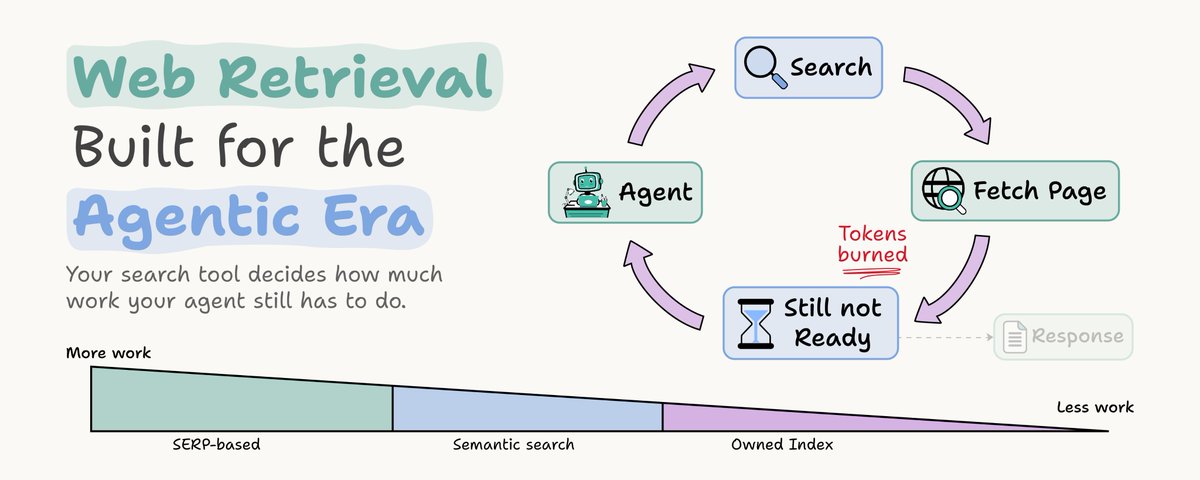
文章探讨了当前 AI Agent 在使用传统网页搜索时面临的“检索税”问题。传统搜索 API 仅返回链接和摘要,迫使 Agent 耗费大量 Token 去抓取和清洗内容。作者通过对比实验指出,使用预先爬取并结构化处理的索引(如 Seltz)能显著降低成本并提升效率,这种返回完整文档而非指针的方式是 Agent 搜索的未来。
本文是“AI时代的知识编排”系列收官之作。作者回顾了利用AI与结构化知识库高效产出技术博客的实践,发现写作过程本身遵循着“文档驱动”(SDD)的逻辑。文章通过信息论、认知科学及实证数据论证了结构化输入的重要性,并指出知识编排已成为AI时代内容生产的生存必需,强调了核查与人工判断不可替代。
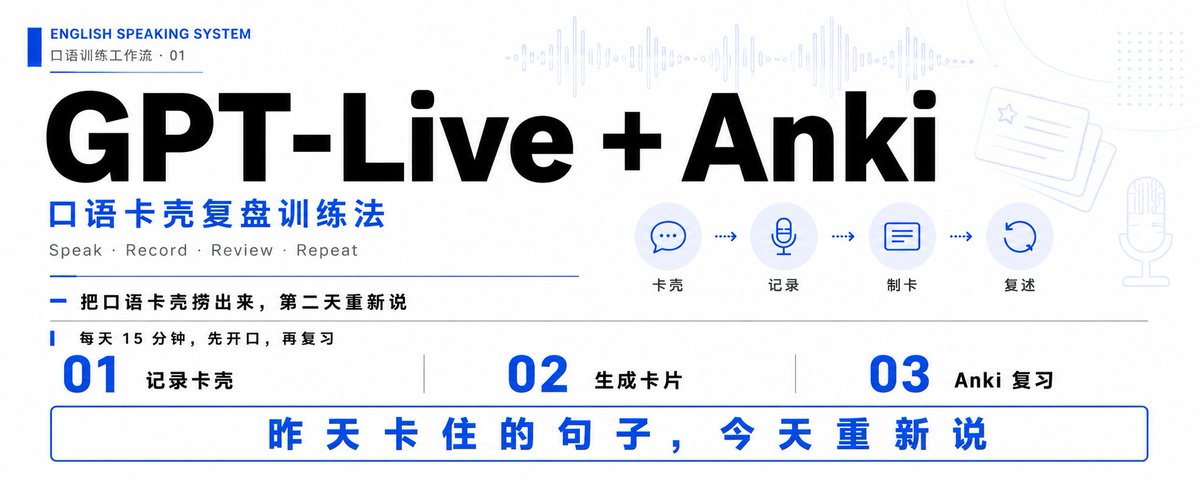
文章介绍了如何结合 GPT-Live 和 Anki 进行系统的英语口语练习。通过 Prompt 让 GPT-Live 记录练习中的卡壳和停顿,生成包含中文意思和英文表达的清单,再将其导入 Anki 制成间隔重复卡片。这种方法解决了“开口难”到“有进步”的转化问题,确保昨天的难点在明天得到复习。
本文深入解析了Claude Code的“harness”架构,解释了为何简单的模型调用不足以构建可靠的代码代理。作者通过CrewAI框架逐步重建了包括核心循环、工具管理、规划机制在内的关键组件,揭示了通过工程化手段弥补模型差距的方法。
文章介绍了Deel如何构建自我改进的AI系统。通过Bug Hunter和Deel Code两个Agent,系统自动在真实客户环境中发现漏洞、编写修复代码并验证结果。人只负责最终审批,将工程师移至决策环节,实现软件闭环自我进化。
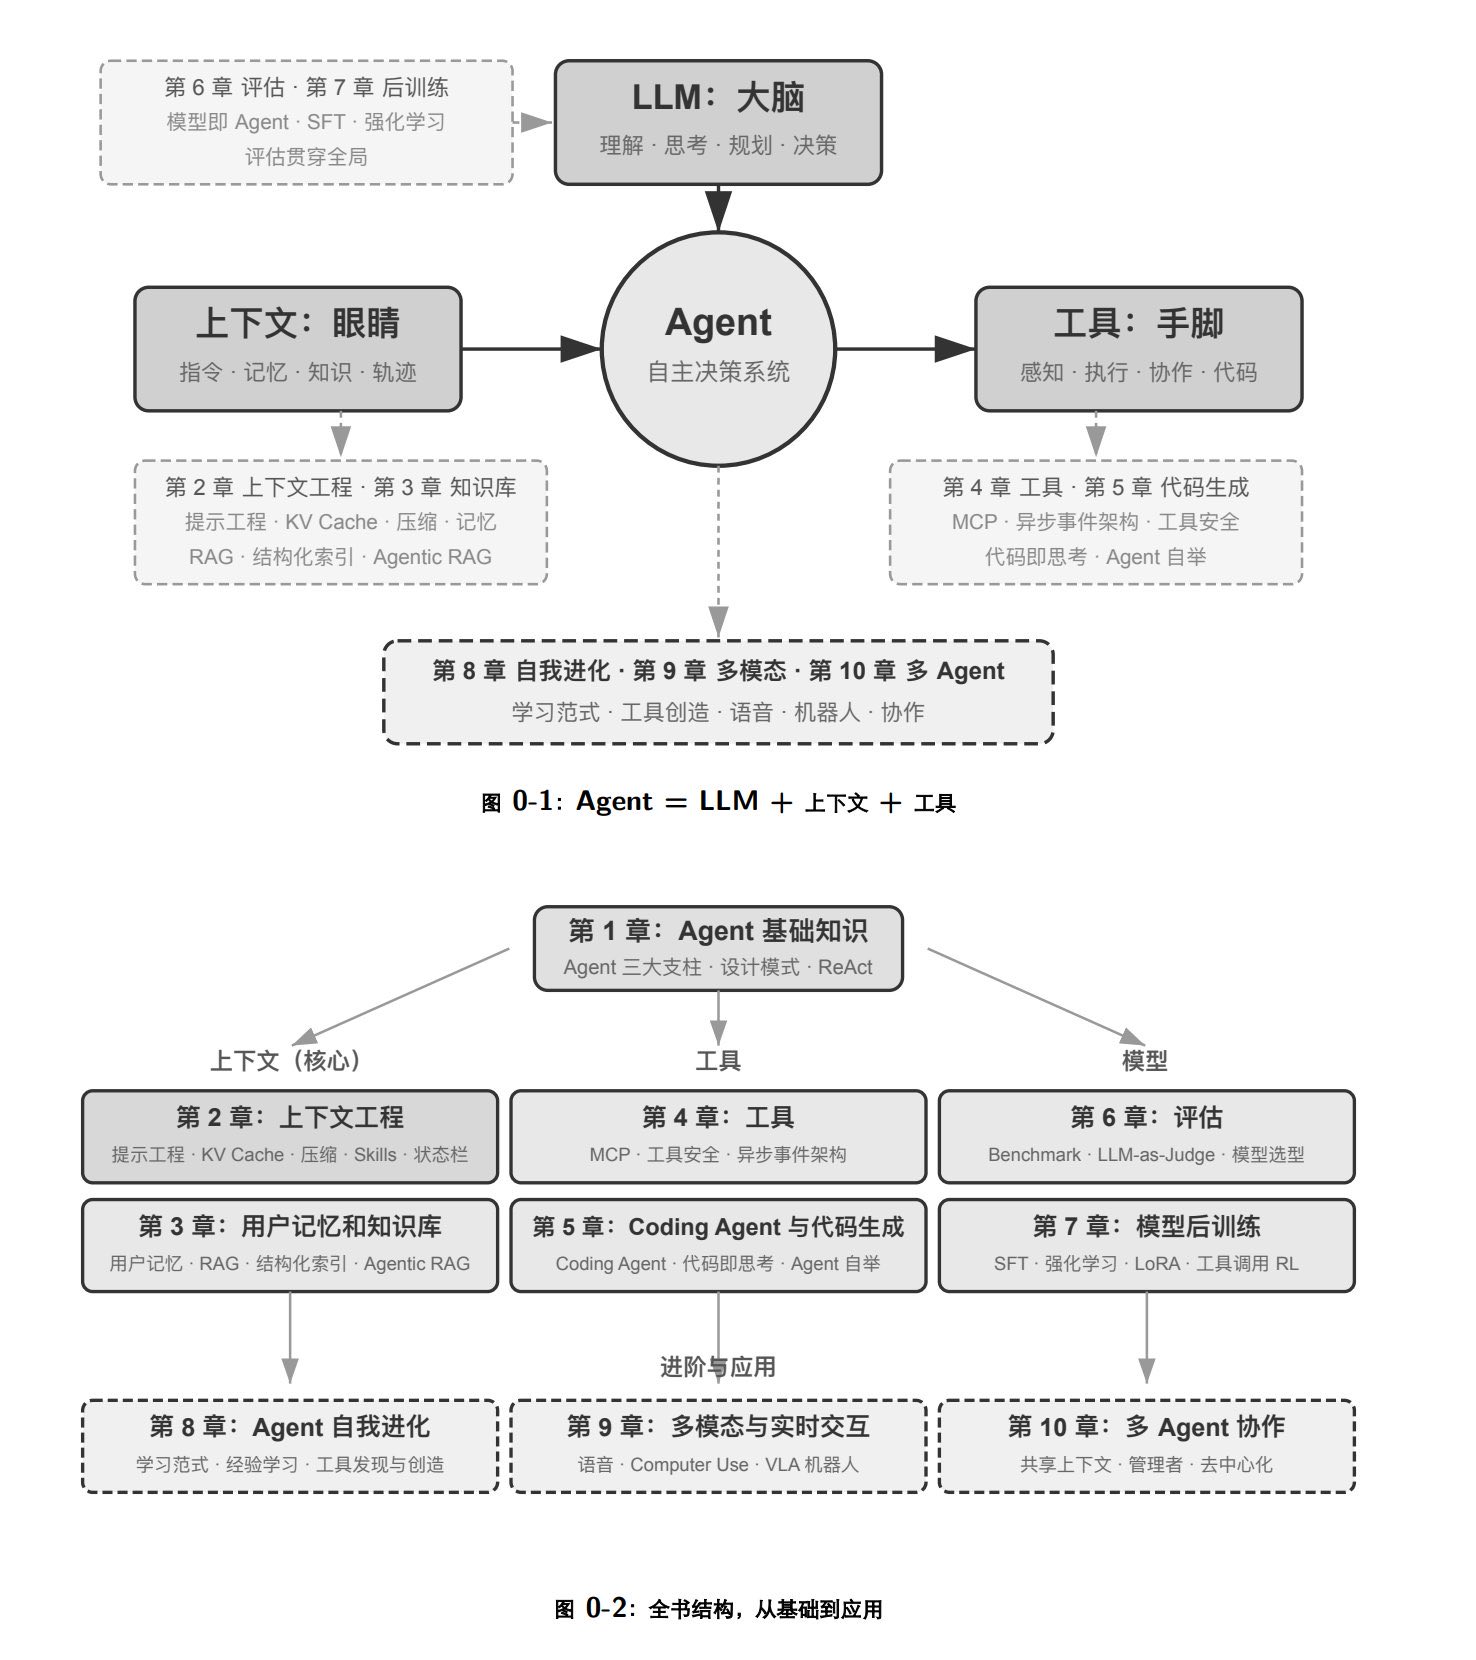
李博杰新书《深入理解 AI Agent:设计原理与工程实践》开源,涵盖从0到1构建生产级AI Agent的原理与代码,包括RAG、工具调用、多Agent协作等实战内容。
文章探讨了如何从简单的提示词升级为高效的技能,将技能视为harness的扩展而非静态提示。作者分享了九种‘黑魔法’技术,包括使用对抗性子代理、强制发散、智能路由等,以克服模型默认行为并提升技能的稳定性和效果。
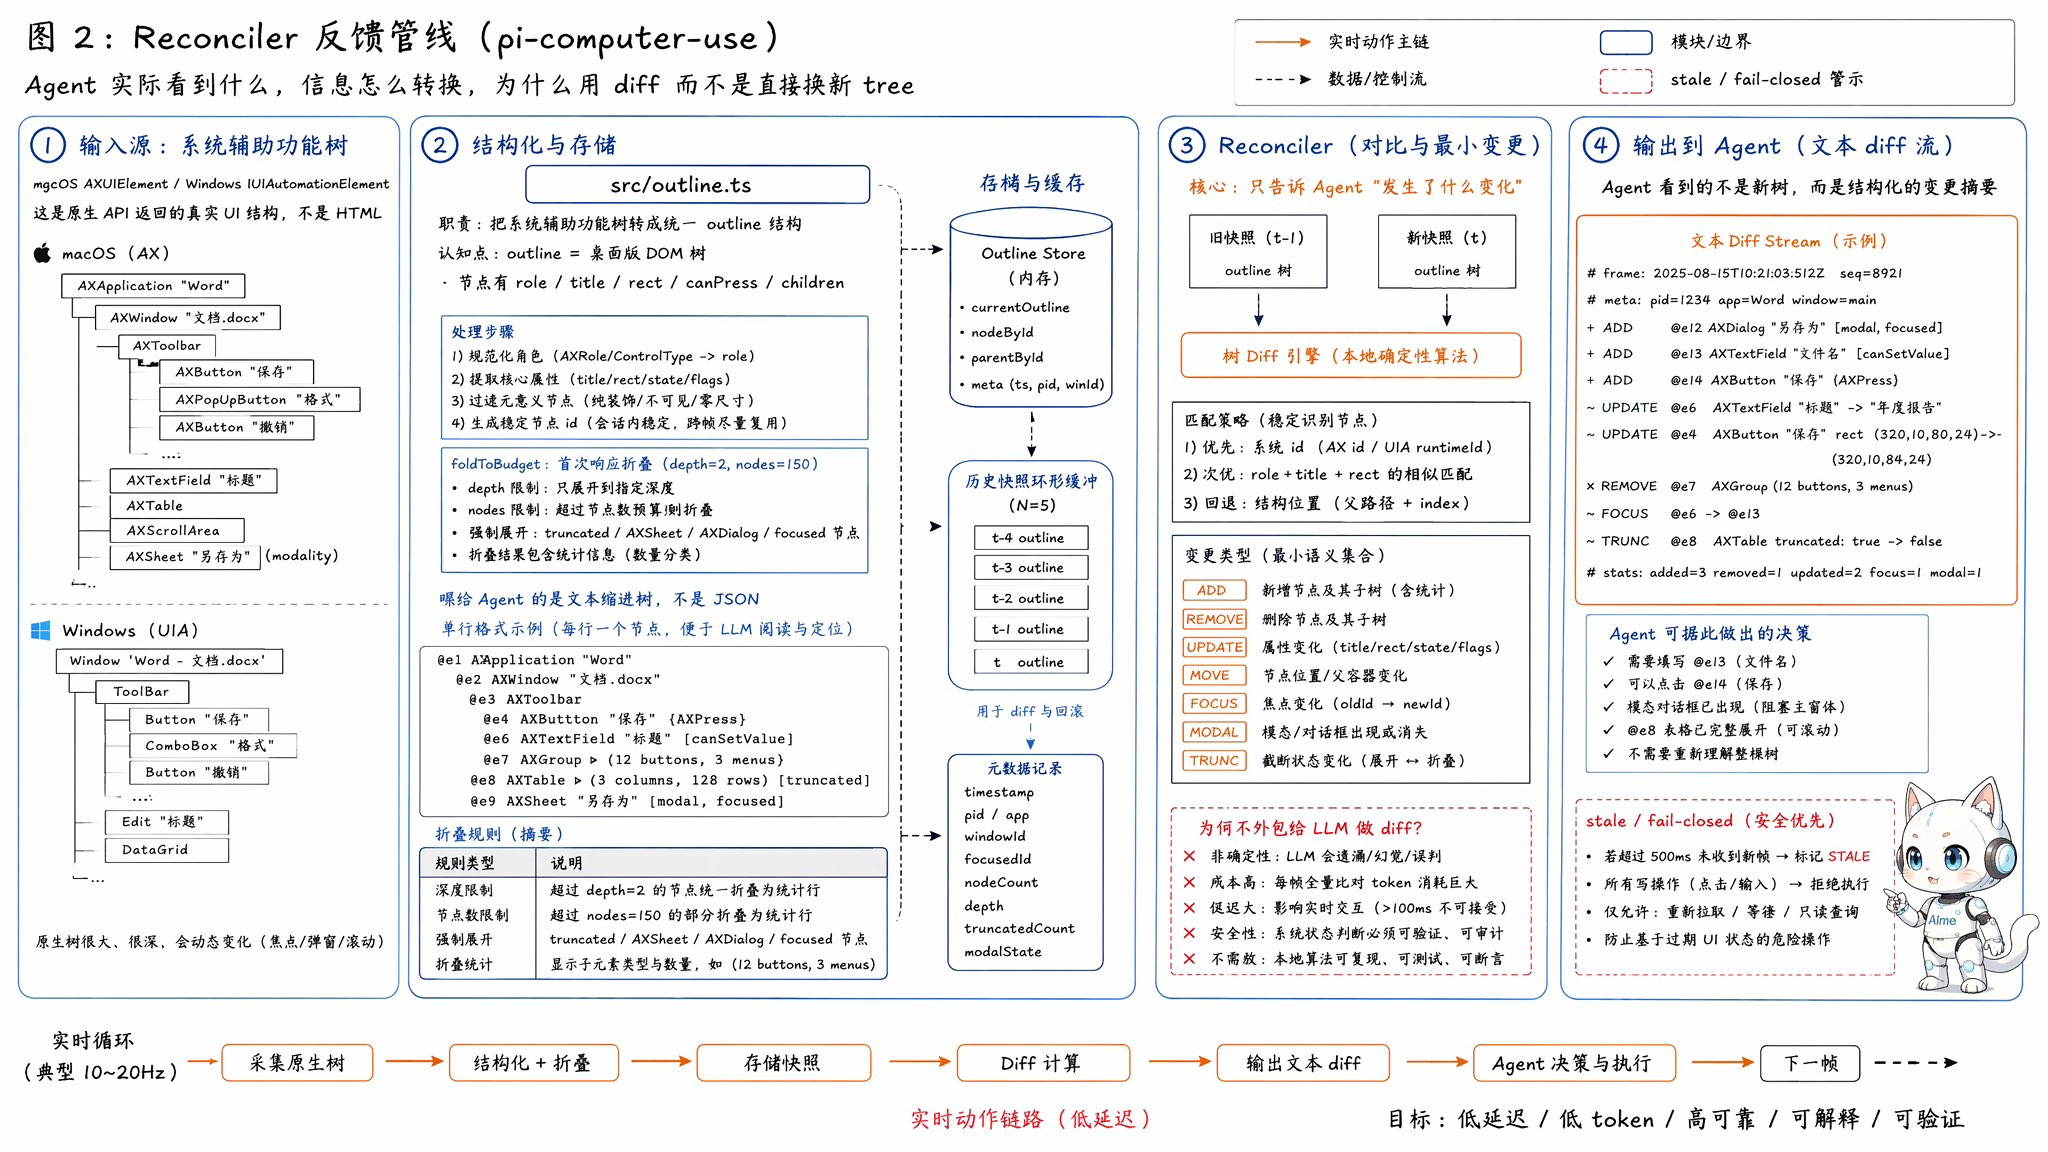
Pi社区开源了OpenAI Codex未开源的computer-use实现,该工具支持模型无关的MacOS计算机操作,采用ax-first导航和视觉回退功能。作者还分享了资源预算类比,并提及定制内部研发Agent IP的经验。
文章探讨了上下文工程在外拓代理中的应用,强调通过精心设计上下文窗口(包含角色、案例、证据和规则四层),解决模型幻觉和生成内容泛化的问题。文章介绍了组装、撰写和优化三个核心技能,以提升个性化消息的质量和响应率。
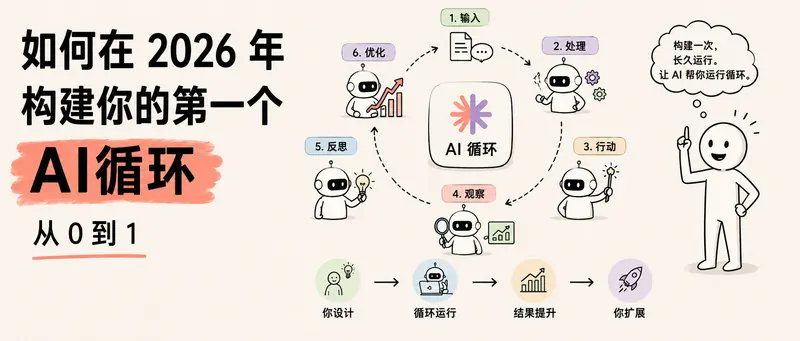
文章指出 AI 工程的杠杆点已从手动写提示词转向设计自动循环。通过引入 Slate 工具,文章详细演示了如何构建包含发现、执行、验证和迭代步骤的 AI 编程循环。涵盖了环境配置、技能定义、状态管理及队列文件的使用,旨在通过自动化闭环大幅减少人工干预,实现持续验证的任务完成机制。
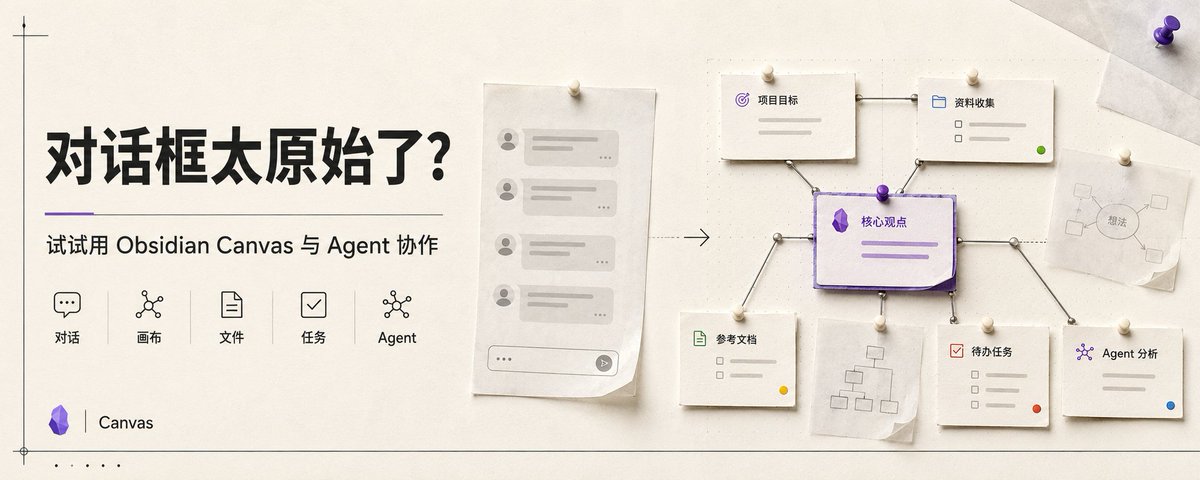
本文探讨了传统线性对话框在处理复杂 AI 任务时的局限性,提出了基于 Obsidian Canvas 的非线性协作模式。文章结合学术研究(如 Sensecape、CanvasConvo)和商业产品(如 Copilot Pages、Cursor),展示了如何利用 Canvas 画布作为持久化工作台,让 Agent 理解项目结构而非仅保存聊天记录。作者还介绍了 Obsidian 社区中的 Canvas LLM 和 Cannoli 插件,并总结了如何通过定义颜色、空间和连线规则,实现人与 Agent 在知识库层面的高效协同。
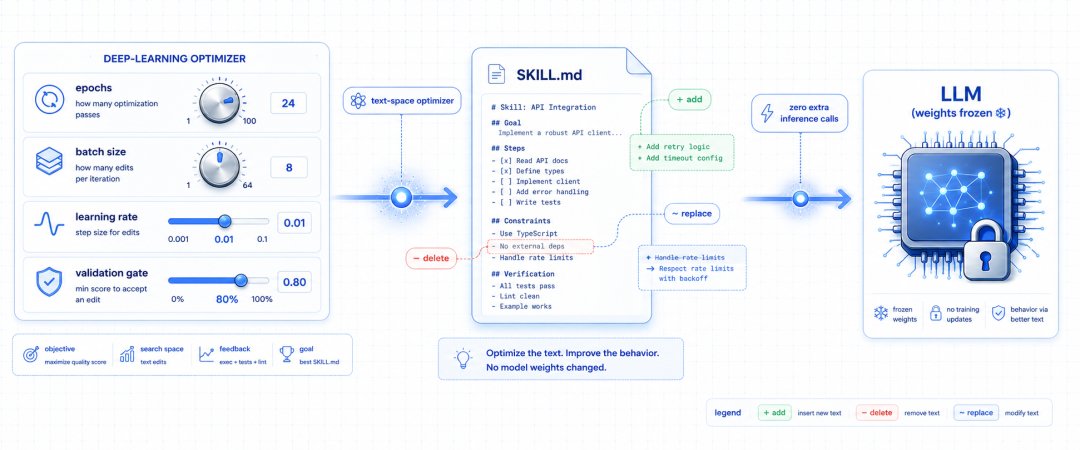
微软开源了 SkillOpt 项目,引入了“训练 Prompt”的新思路。与传统的 Agent Skill 开发不同,SkillOpt 在不改变模型权重的情况下,将神经网络训练方法(如 epoch、验证集)应用于优化 SKILL.md 文本。系统通过执行任务、打分、反思和筛选修改建议,实现技能文档的自动化迭代。论文表明,该方法在多模型环境下均有显著提升,且优化后的技能具备跨模型迁移能力。
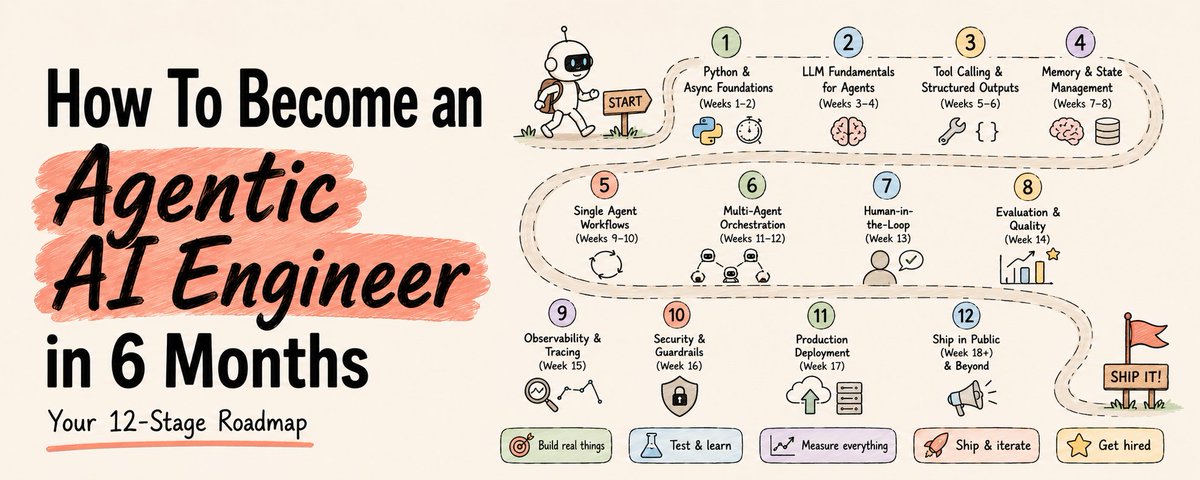
本文提供了一个为期6个月的12阶段AI工程师学习路线图。文章首先阐述了代理工程师的核心是构建能自主决策的系统,而非编写固定逻辑。前两个阶段重点介绍了Python异步编程的基础(解决API调用阻塞问题)和LLM的基本原理(如上下文限制、成本控制和模型路由)。随后详细讲解了工具调用与结构化输出的实现方法,强调使用Pydantic验证数据及构建可恢复的Agent循环。
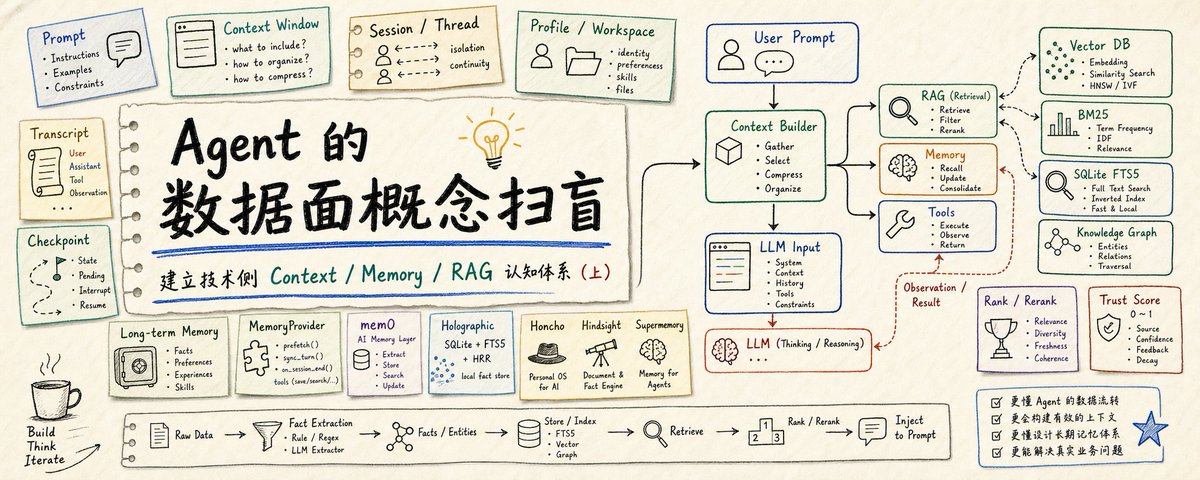
本文深入解析了 Agent 数据面的核心概念,将其比作操作系统的内存管理单元。文章详细阐述了 Context Engineering 的演变、Session/Thread/Profile 的架构差异,以及 Session Memory 与 Long-term Memory 的区别。作者还重点介绍了 Hermes 中的 Memory 设计方案、SQLite FTS5 与 BM25 算法原理,以及向量检索与关键词检索在 RAG 中的混合应用,旨在为开发者建立一套完整的 Agent 数据面技术认知体系。
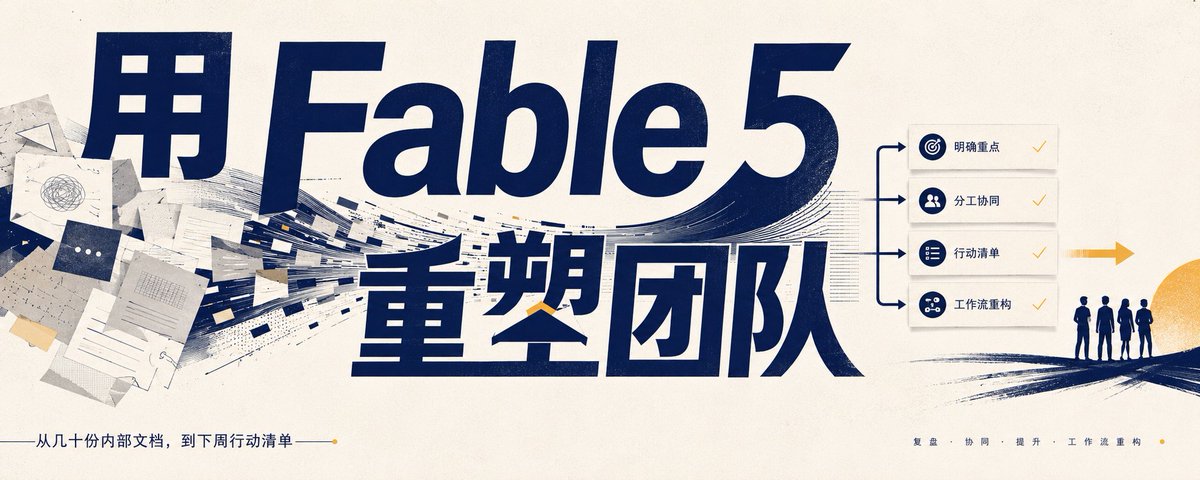
本文详细介绍了如何利用 Fable5(Claude Opus 级别模型)对销售团队的周报、会议纪要等几十份杂乱文档进行深度复盘。作者分享了从数据喂料、Prompt 设计到结果验证的全流程技巧,强调了设置角色、分步诊断、数据脱敏及反向逼问证据的重要性,指出长上下文模型可作为团队军师提供具体可落地的改进行动方案。
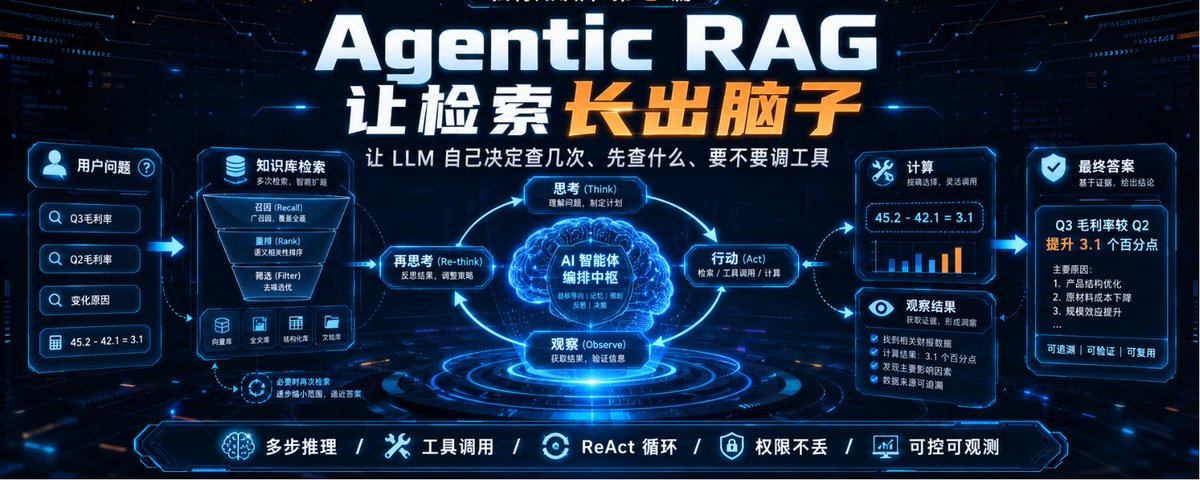
文章指出传统单轮 RAG 在处理复合问题时存在检索不足或幻觉的缺陷,提出通过 Agentic RAG(多步推理)来解决。核心思路是将 LLM 从被动应答升级为主动调度的指挥官,利用 ReAct(推理-行动循环)机制,自主决定检索次数和工具调用。文中详细展示了如何封装检索工具、执行函数(含权限过滤、混合检索)以及编写多步推理循环代码,实现复杂问题的精准回答。
本文详细解读了 Karpathy 提出的基于 LLM 的个人知识库管理方案 'llm-wiki'。文章核心在于将传统的 RAG 检索模式转变为 '编译' 模式:人负责收集原始资料,LLM 负责将资料编译成互相链接的维基页面。文中深入剖析了系统的三层架构、Schema 设计的重要性,并提供了从 0 到 1 的动手搭建指南及进阶的 '防坑' 建议,旨在帮助读者构建一个具备持续复利能力的个人知识库。
文章通过解读 Anthropic、吴恩达和微软 CEO 纳德拉关于“Loop(循环)”的不同视角,构建了一个三层模型:一楼关注技术执行效率,二楼关注人机分工与方向,三楼关注“Token 资本”与组织复利。作者指出,完整的 AI 工作流应融合这三层,并针对独立开发者提出了具体建议,强调沉淀判断力而非工具用法,以构建可跨模型迁移的专属资产。
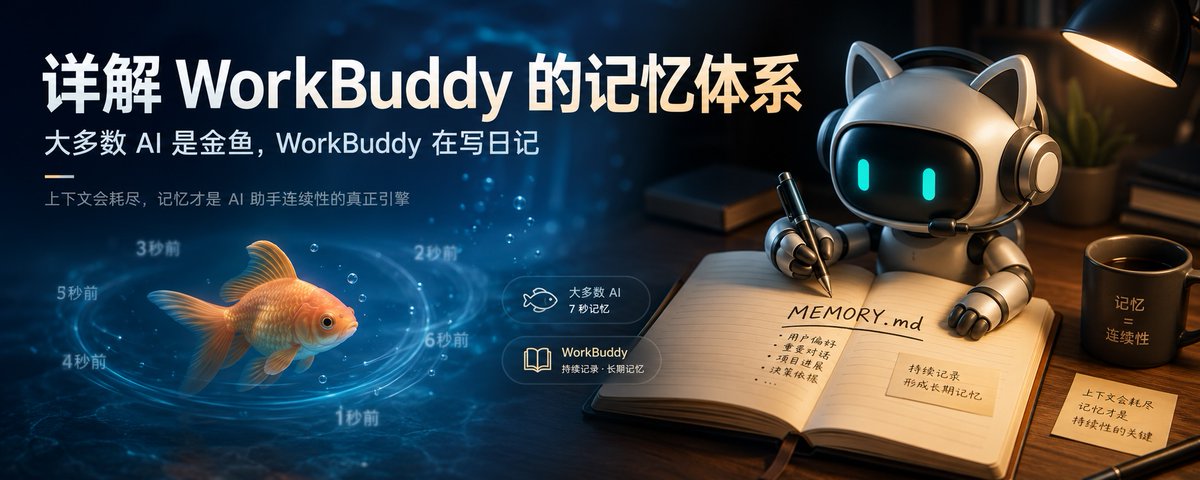
文章以「好记性不如烂笔头」为喻,深入剖析了 AI 助手 WorkBuddy 的三层记忆架构(云端画像、本地长期记忆、工作区日志)。通过对比传统 AI 的「金鱼式」失忆,阐述了长程任务中「读写外部文件」优于单纯依赖上下文窗口的原理。同时,文章探讨了记忆与身份层如何赋予 AI 连续性,并与 OpenClaw 进行了横向对比。
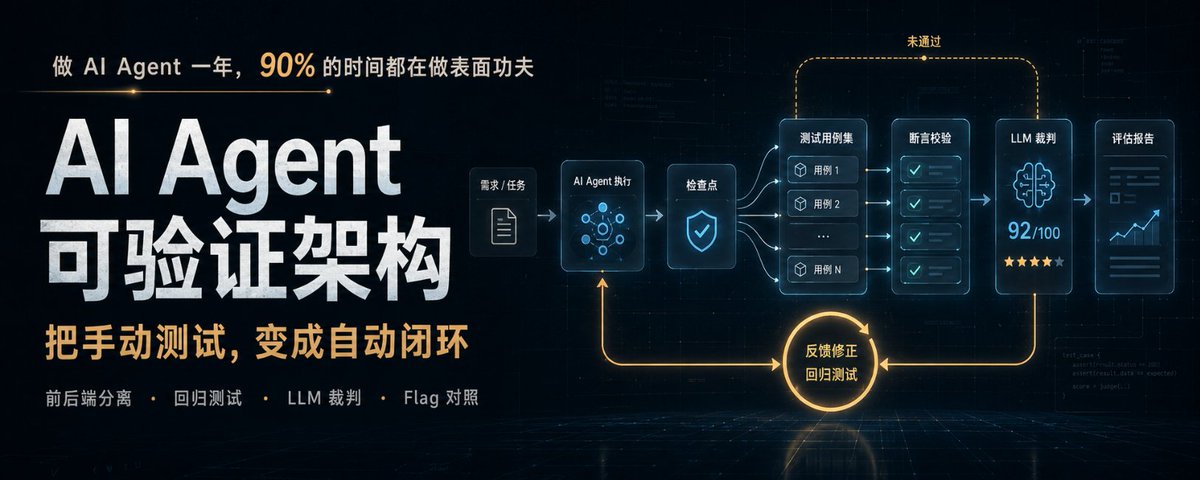
作者通过一年的 AI Agent 开发实践,发现 90% 的时间浪费在手动测试上。受芯片“验证不对称”理念启发,作者提出构建可验证的架构:通过前后端分离(ACI)使系统对 AI 友好,并引入“确定性断言”和“LLM 裁判”两级回归测试体系。最终实现了由 Coding Agent 自动运行的闭环开发,将开发者从繁琐的手工验证中解放出来,重塑了 AI 时代的开发效率。