AI辅助写作全流程:从公式选型到去AI味实战
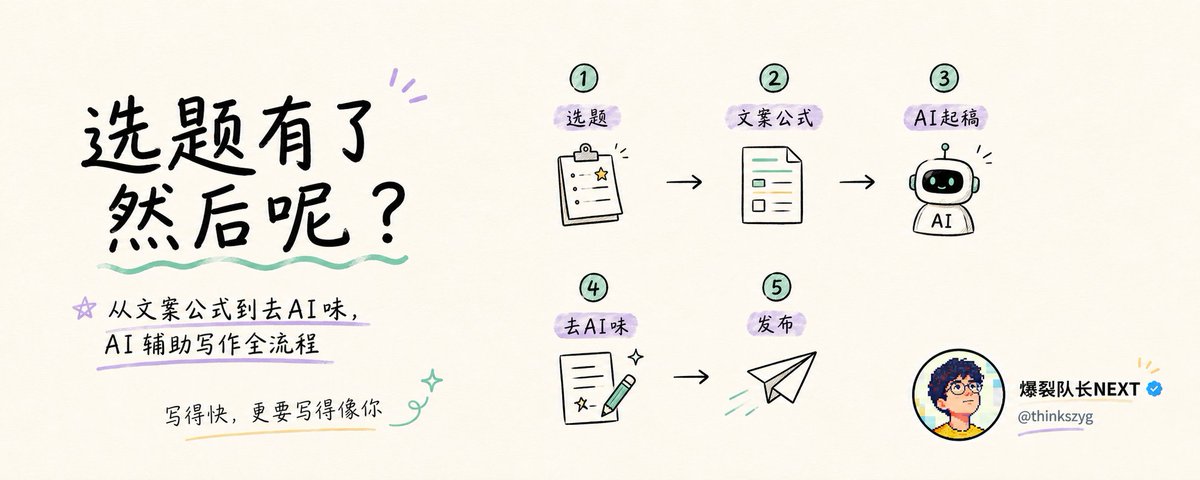
本文详细介绍了如何利用AI进行辅助写作的完整流程。作者提出“选题→匹配公式→搭骨架→AI填肉→去AI味→格式化发布”的六步法,重点分享了如何使用PAS、SCAR等文案公式构建结构,以及在Obsidian中通过约束提示词避免AI产生机械感的具体技巧(如禁用破折号、打破对称句式),最后利用AI检测结构性问题并配合人工修正以消除“AI味”,实现高效且高质量的内容产出。
本文详细介绍了如何利用AI进行辅助写作的完整流程。作者提出“选题→匹配公式→搭骨架→AI填肉→去AI味→格式化发布”的六步法,重点分享了如何使用PAS、SCAR等文案公式构建结构,以及在Obsidian中通过约束提示词避免AI产生机械感的具体技巧(如禁用破折号、打破对称句式),最后利用AI检测结构性问题并配合人工修正以消除“AI味”,实现高效且高质量的内容产出。
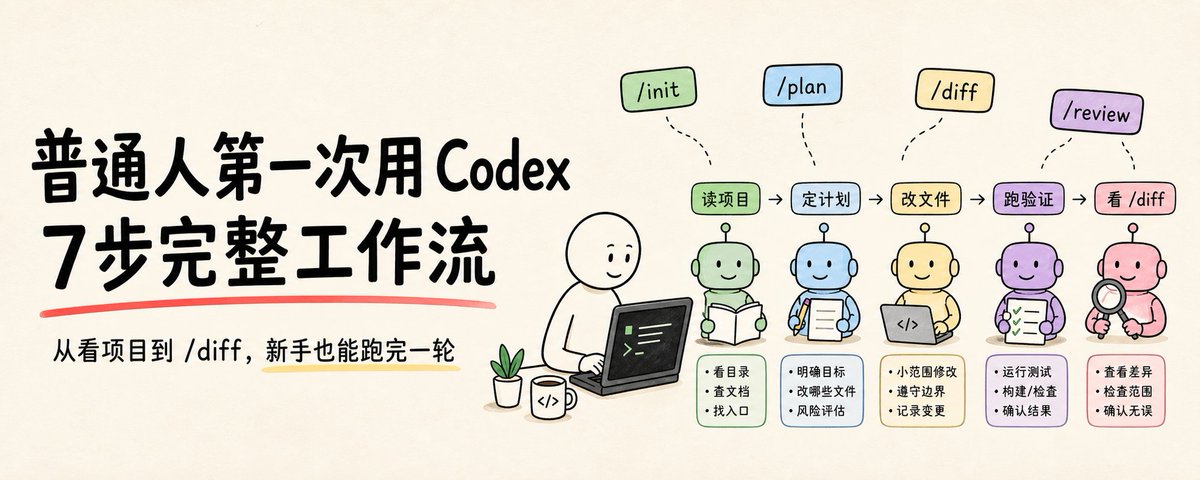
文章介绍了新手使用 Codex(AI 编程工具)时的正确姿势。作者指出新手常因将 Codex 视为“许愿池”而陷入不敢用的困境,并提出了一个完整的工作流:从看目录、定计划、执行小任务、跑验证、看 Diff 到自我 Review。文章强调不要急于求成,而应通过设定边界、交付小任务来建立信任,并提供了可直接复用的 Prompt 模板。
文章介绍了 Eric Jorgenson 撰写的两本著作:《纳瓦尔宝典》和《马斯克原理》。前者聚焦于如何通过专长、责任和杠杆实现财富自由,适用于人生第一阶段;后者则通过第一性原理和工程思维探讨如何推动文明进步,适用于财富自由后的第二阶段。作者还结合孟岩的新书,探讨了投资自我与创造性工作的重要性。
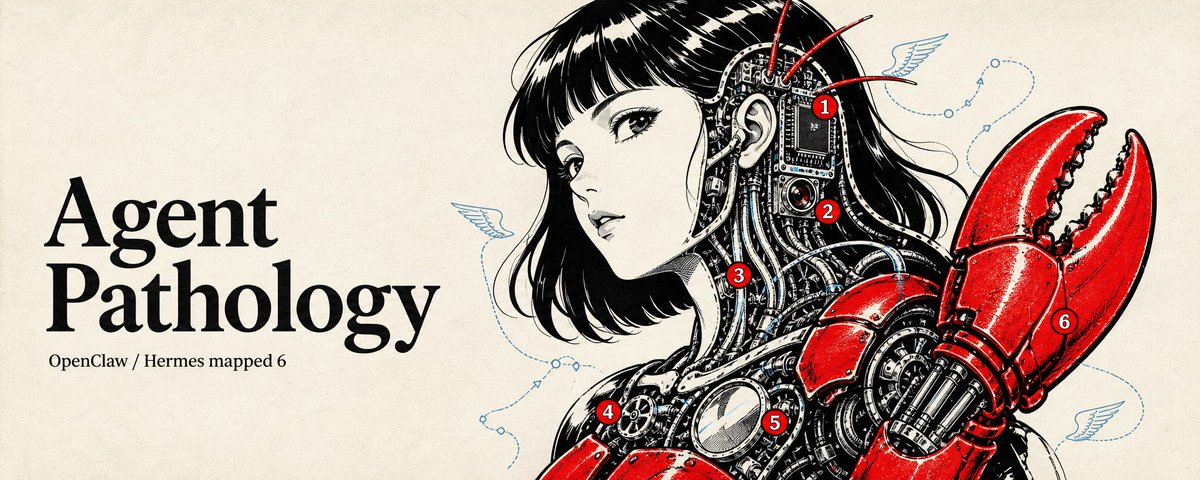
文章提出了一个新的视角来理解和调试 AI Agent:将其错误类比为人类神经系统疾病。作者指出,所谓的“AI 幻觉”在医学上更接近于“虚构症”。文章详细列举了 Agent 运行时中的六种病症,包括“遗忘症”、“幻肢状态”等,并针对每种症状提供了具体的诊断工具(如 gbrain, Mem0)和解决方案,强调通过检查“器官”(记忆、环境、工具链)来优化 Agent 性能。
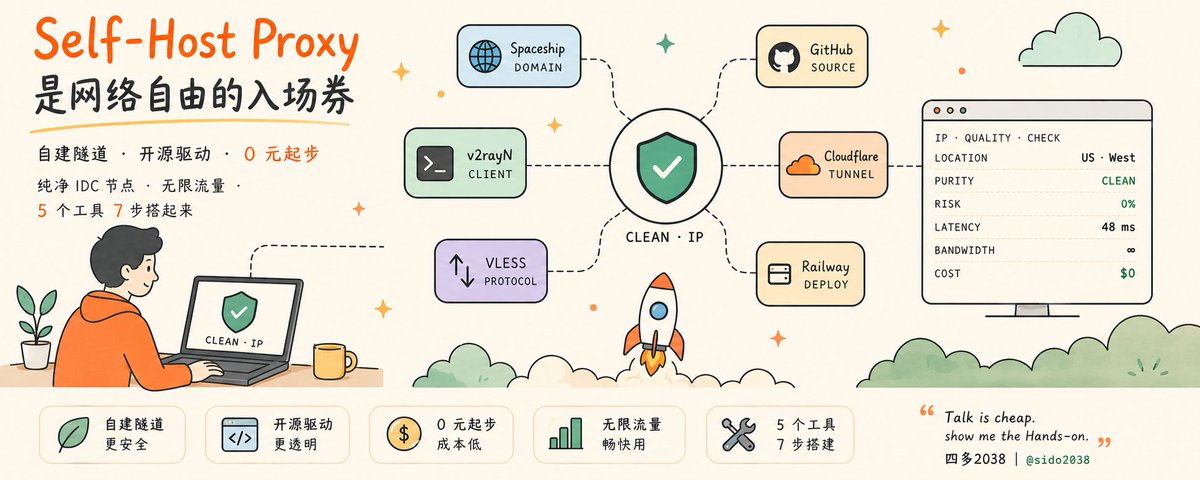
本文是一篇保姆级教程,详细介绍了如何利用 GitHub、Cloudflare、Railway 等平台提供的免费额度,零成本搭建一个纯净、稳定且高速的专属代理 IP。文章涵盖了从域名注册、解析配置、隧道创建、代码编译到最终部署验证的全过程,特别适合需要访问海外 AI 大模型的用户进行技术学习和实践。
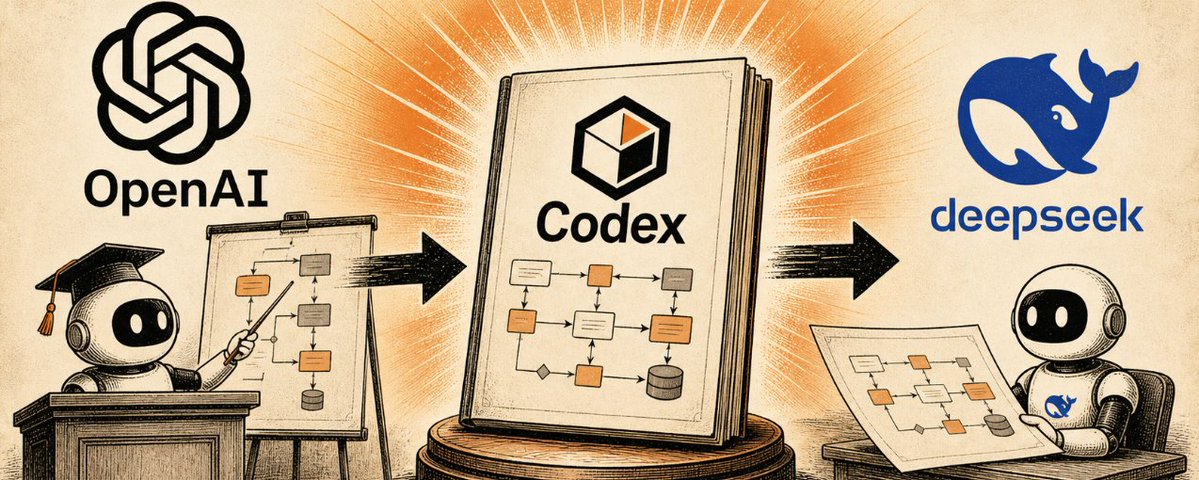
文章介绍了 OpenAI 工程师 Jason Liu 分享的 9 条 Codex 高效工作法,包括持久线程、共享记忆、语音输入、实时纠偏、操作电脑浏览器等。这些方法将 Agent 从单纯的聊天工具转变为能记住上下文、主动执行任务并操作真实应用的长期资产。作者指出,这套通用的 Agent 逻辑不仅适用于 Codex,通过 OpenCode、Playwright 等工具,在 DeepSeek 环境下也能完美复现。
文章指出企业 AI 应用效果不佳的核心原因在于数据治理,而非模型本身。公网 AI 无法访问企业核心私有数据。文章提出解决方案:利用知识库(RAG)处理文档与客服培训,通过 MCP 协议打通复杂数据库,并采用多 Agent 协作模式整合数据源、分析与报告生成。强调企业 AI 升级是系统工程,旨在实现从通用 AI 到私有 AI 的转变。
本文是一份详尽的公众号运营从零起步教程。内容涵盖心态准备、赛道定位、账号设置、内容创作(选题、标题、排版)、推广互动、数据复盘及商业变现五个关键步骤。作者强调以“利于他人”为价值核心,通过持续输出和精细化运营打造个人IP,并附带了相关增长资源链接。
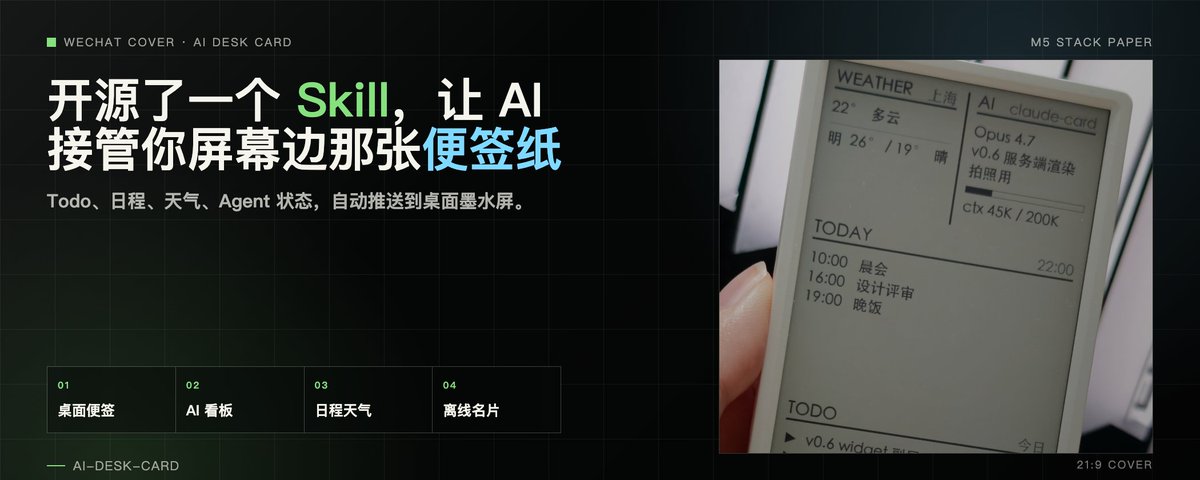
作者分享了一个开源项目 AI Desk Card,这是一块连接到 AI Agent(如 Claude Code)的墨水屏。它通过 AI 动态管理日程、待办、GitHub 动态及天气,替代静态的便利贴。文章探讨了 AI 主动决策显示内容的交互模式,以及硬件与 Agent 结合的新设计思路,旨在实现“低头干活,抬头看一眼”的无缝信息流。
文章提出了一个基于项目的 2026 年 LLM 工程学习路线图。作者主张通过从零构建系统来掌握技术栈,路径涵盖从基础的 Tokenizer、Embedding、Positional Encoding、Attention 机制,到 Transformer 模块构建、训练循环、KV Cache、MoE、量化、服务部署、RAG 及 Agent 等高级系统。该指南强调“实现、绘制、破坏、解释”的学习闭环,旨在帮助读者深入理解大模型原理并具备工程构建能力。
文章深度解读了2026年5月何恺明MIT团队与字节Seed团队前后发布的两篇论文(ELF与Cola DLM)。两者殊途同归,挑战了主流的自回归(AR)生成范式,主张将语言模型的生成过程从“离散Token预测”转变为“连续空间的潜变量扩散”。这种“先思考后落字”的铅笔模式,不仅提升了效率与效果,更可能引发LLM底层架构、评估标准及多模态统一范式的新一轮变革。
本文介绍了如何使用字节跳动的低代码AI开发平台扣子搭建个人AI信息情报站。文章指出,相比Claude Code等工具,Coze更适合普通用户上手。作者详细讲解了Coze从聊天机器人平台向云端应用开发平台的演进,并提供了通过自然语言描述快速生成工具的示例。核心部分展示了一套结构化的提示词,利用Coze实现对指定关键词的全网信息收集、痛点分析与趋势判断,帮助内容创作者解决信息过载问题。
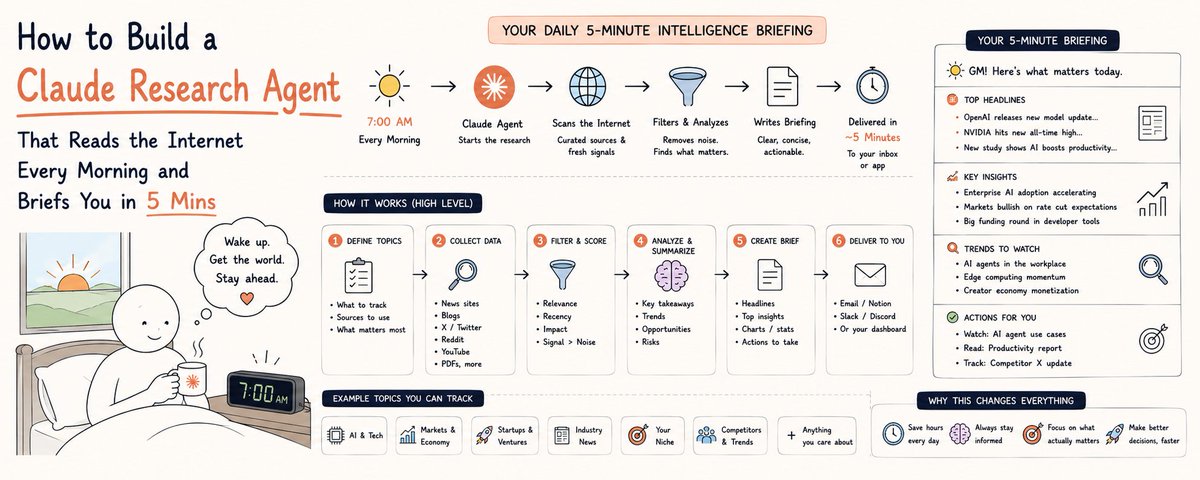
文章介绍如何利用 Claude、MCP(Filesystem 和 Brave Search)、N8N 及 Obsidian 构建一个全自动的晨间研究代理。该代理能自动监控信息源、过滤噪音、综合关键信息,并生成一份 5 分钟可读完的简报存入 Obsidian,帮助用户从繁杂的信息过载中解放出来,高效开始工作。
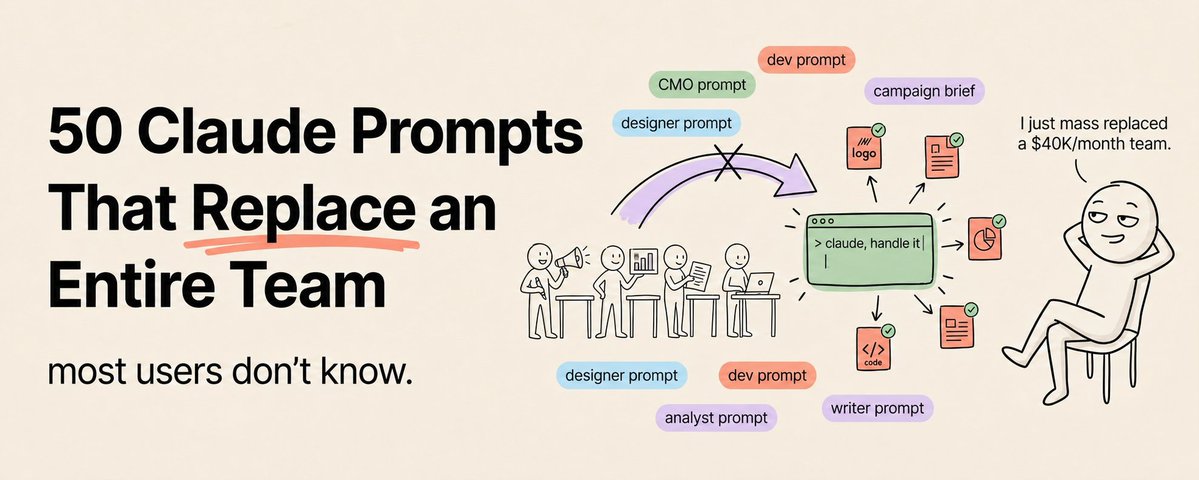
文章介绍了50个结构化、工程化的 Claude 提示词,涵盖内容创作和商业策略等领域。通过设定角色、背景、格式和约束条件,这些提示词能让 AI 的输出达到专业团队的水准,大幅提升工作效率。
文章介绍了一款名为 AIMedia 的开源工程级工具,旨在通过自动化技术取代传统的手动自媒体运营流程。该工具利用 Django 和 PySide6 构建,具备全网热点自动抓取、AI 洗稿生成以及多平台自动发布的闭环能力,能够大幅提升内容分发效率。
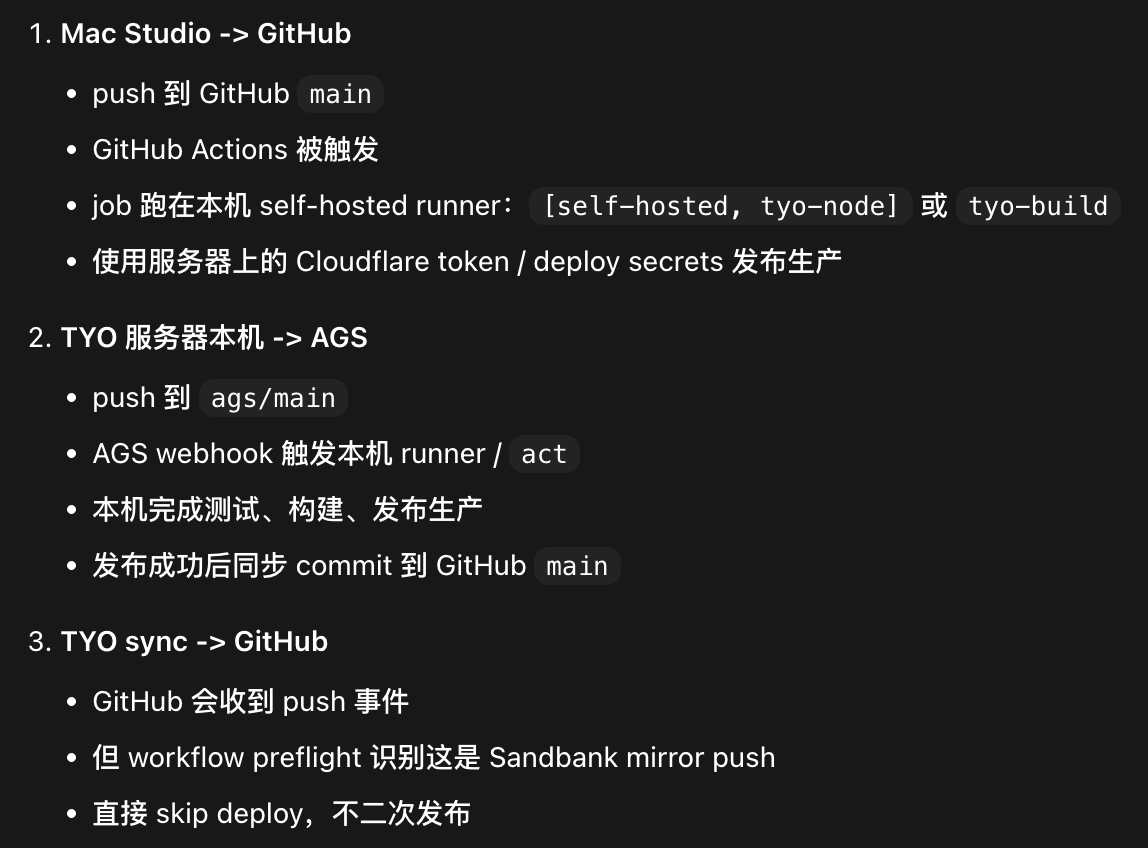
作者分享了如何使用 AGS(Agent Git Service)替代 GitHub 作为主要开发环境的实践。通过将开发环境完全迁移至云服务器,结合 dev agent 和双驱动的交互模式,实现了无需本地依赖的高效开发工作流,并介绍了正在开发的 VAS(虚拟代理服务器)项目,旨在将该工作流整合到语音交互界面中。
美团开源了名为 LongCat-Video-Avatar 1.5 的音频驱动虚拟人模型。该模型支持唇形精准匹配、表情自然过渡、全身动作连贯及唱歌表演,综合能力据称超越 HeyGen、Kling Avatar 等商业模型。适用于需要高质量视频生成、本地部署及复杂场景开发的内容创作者、企业和 AI 研究者。
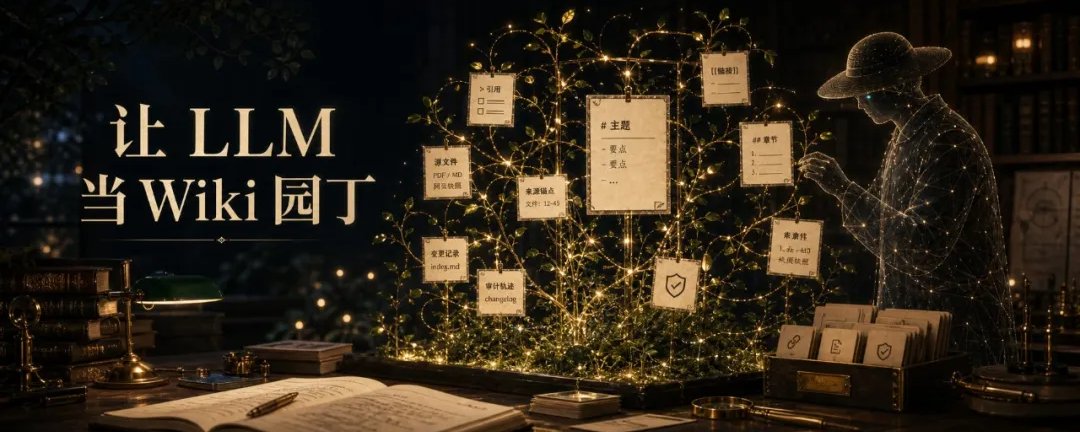
文章介绍了一种基于 LLM 的新型 Wiki 知识管理范式,旨在解决传统知识库维护成本高的问题。作者详细阐述了 raw/wiki/schema 三层架构,以及 Ingest、Query、Lint 三大核心操作,并开源了相应的 Claude Code Skill。文章以 x-algorithm-wiki 为例,提供了五步实战教程,展示了如何让 LLM 增量维护可追溯、可信的项目架构文档,并探讨了该方法的边界与适用场景。
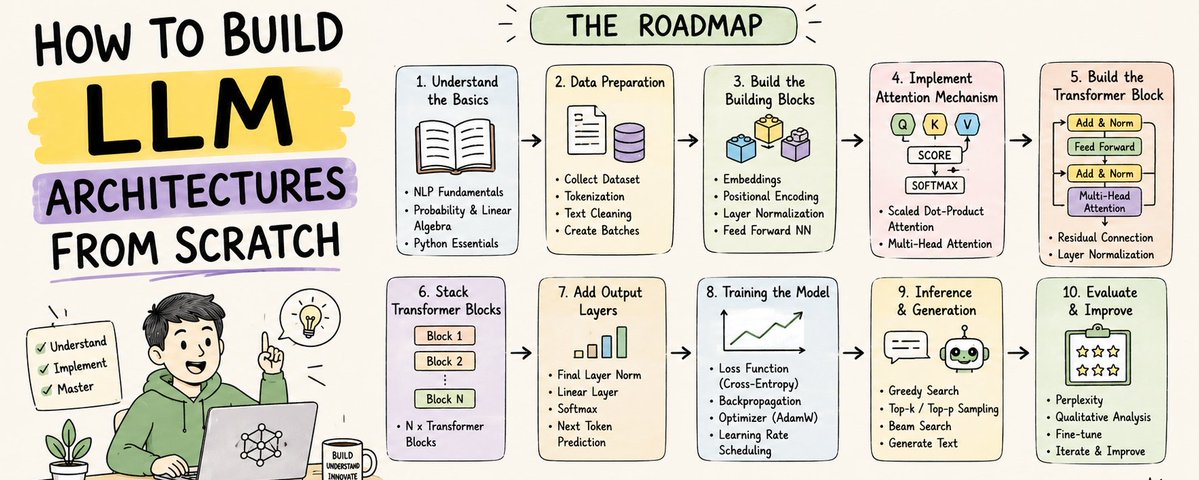
本文是一篇关于从零构建大型语言模型(LLM)架构的深度指南。文章详细解释了 LLM 的工作原理,包括从原始数据收集、清洗、分词,到 Transformer 架构的核心组件(如自注意力机制、位置编码)。同时涵盖了预训练、微调、基于人类反馈的强化学习(RLHF)以及推理优化等关键技术环节,旨在帮助读者理解 ChatGPT 和 Claude 等模型背后的系统构建全流程。
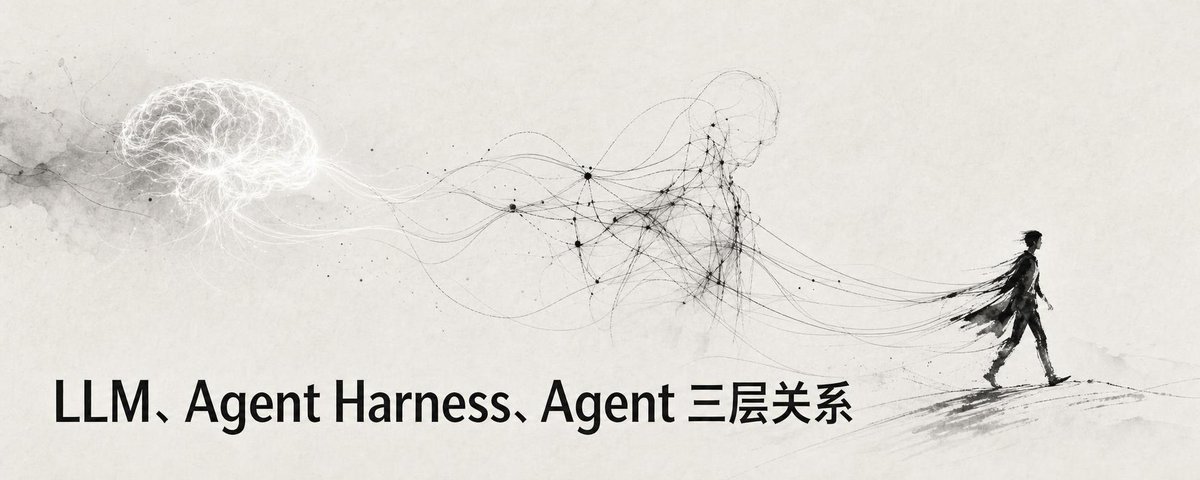
本文探讨了Agent项目难以落地的核心原因。作者指出,许多团队忽视了模型与应用之间的基础设施层——Agent Harness。文章通过生理学类比和工程细节分析,阐述了为什么仅靠LLM无法构建高效Agent,并预测AI行业将分化为模型层、Harness平台层和Agent应用层,建议业务团队应专注于业务逻辑而非底层基础设施。
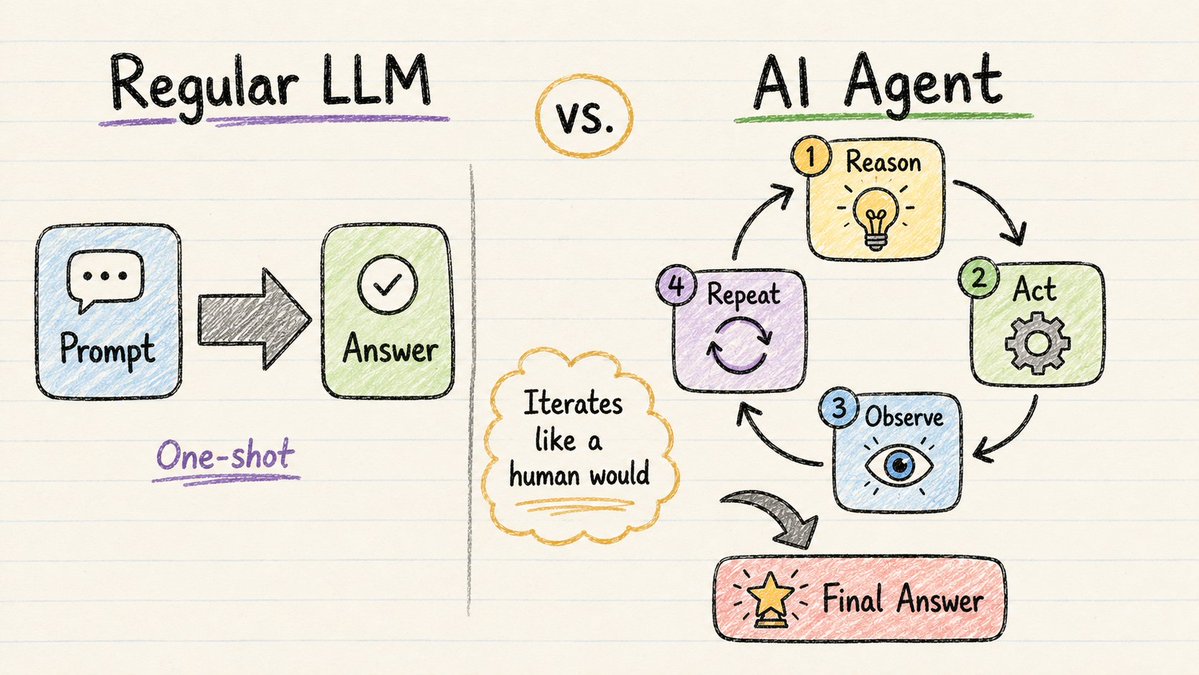
本文是一份关于 AI 智能体的综合指南,涵盖了从基础概念到生产级系统构建的全过程。文章深入解析了 Agent 的核心工作原理,如 ReAct 循环、任务拆解和上下文工程。同时,针对中级开发者,详细介绍了多代理系统的评估体系、记忆与知识管理、安全护栏设计以及四种核心设计模式,旨在帮助读者构建可靠且高效的 AI 应用。
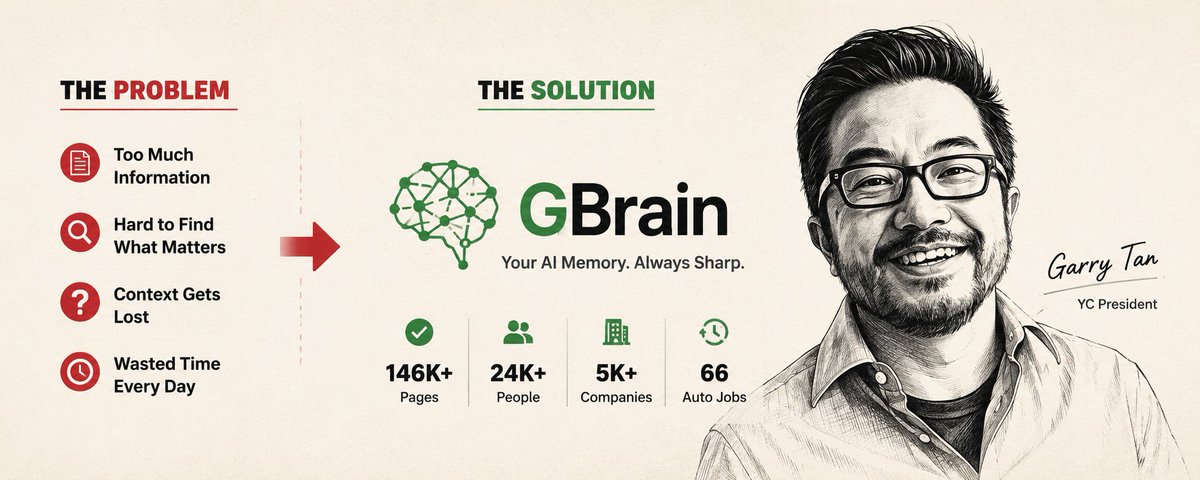
本文深入探讨了当前 AI 行业被忽视的“痛点”:AI 缺乏长期记忆。作者认为,比单纯追求更聪明的大模型或自主 Agent 更重要的是构建“持久认知层”。文章以 GBrain 为例,阐述了它如何超越传统的检索生成(RAG),通过自建知识图谱和“梦境周期”维护,实现对信息的真正理解与关系连接。这种能积累上下文、提供确定性智能的“记忆基础设施”,将成为未来 AI 的真正护城河。
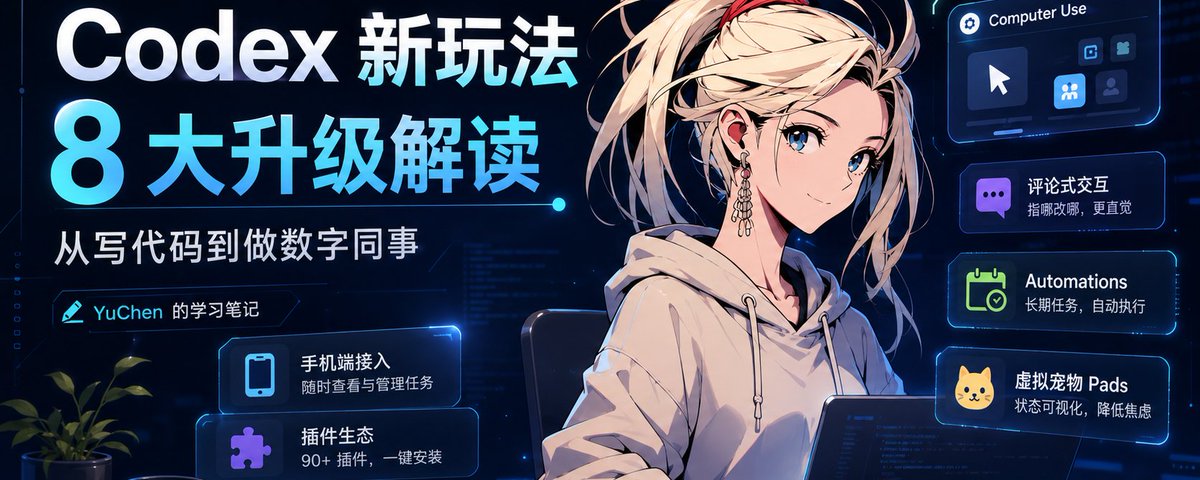
文章深入分析了 Codex 的最新演变,指出其定位已从单纯的代码编写工具转变为具备跨 App 协作能力的“数字同事”。作者详细探讨了 Computer Use、评论式交互、Automations 自动化任务及移动端管理等新功能,并对比了 Codex 与 Claude Code 的差异化分工。文章认为,AI 工具的竞争维度正从“代码质量”扩展到“真实工作流的完成能力”,强调透明度与可控性是未来数字同事的核心。
文章介绍了 Codex 新上线的 Goal 模式,通过明确目标、验收标准和边界条件,使 AI 能像“牛马”一样持续执行复杂任务,解决了传统模式下需人工频繁干预的痛点,并提供了 Prompt 编写技巧与原理解析。
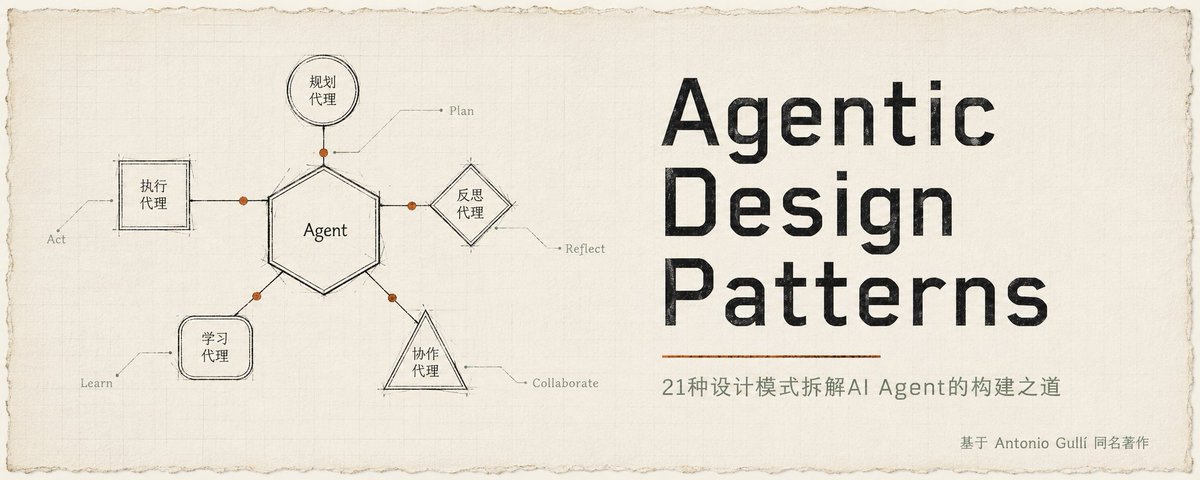
本文是 Antonio Gullí 所著《Agentic Design Patterns》的读书笔记。作者不仅梳理了 AI Agent 从 Level 0(裸 LLM)到 Level 3(多 Agent 协作)的四个等级,还深入解读了 Context Engineering、Reflection(反思)、Memory 分层等核心设计模式。文章指出,大多数人在开发 Agent 时忽视了上下文工程和自我反思机制,并建议开发者先优化单 Agent(Level 2),再考虑多 Agent 协作。
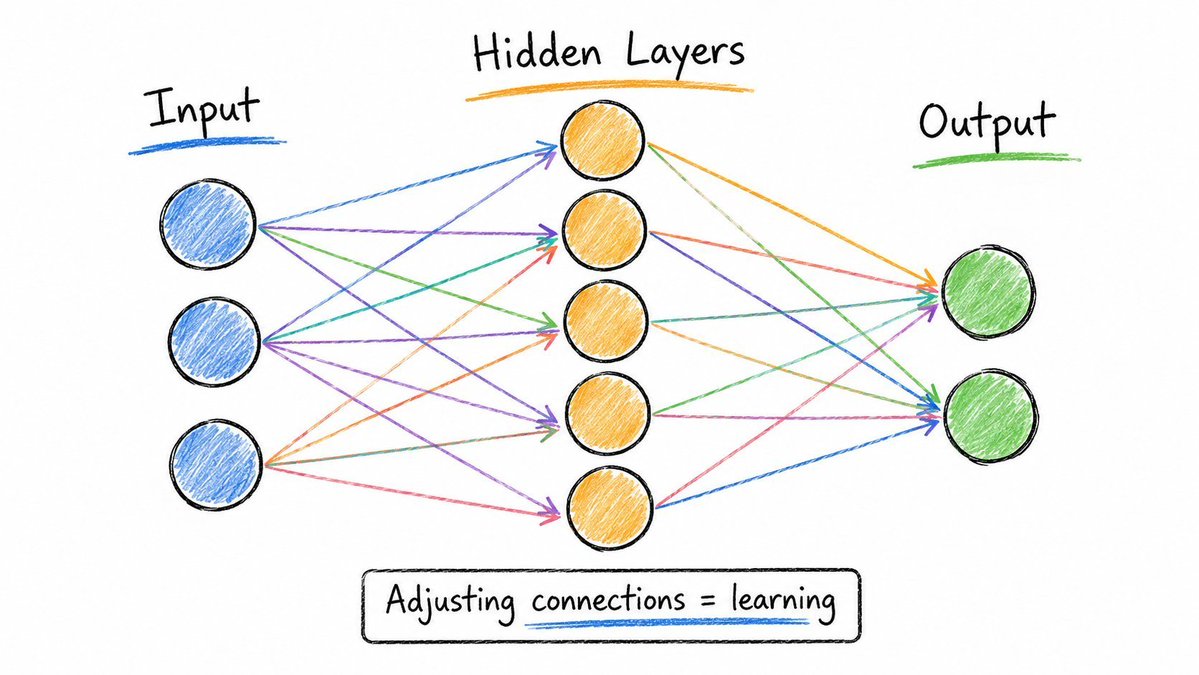
本文翻译整理了一组在 X 上广为流传的 AI 科普手绘图,涵盖从神经网络、Transformer 架构到大语言模型(LLM)的 20 个核心概念。作者不仅解释了 AI 底层运作原理(如分词、注意力机制),还介绍了模型优化手段(如微调、RLHF)及前沿应用架构(如 RAG、Agent、思维链),是一份简洁全面的 AI 技术入门指南。
本文介绍了一套包含15个高清架构、流程和数据图的AI画图工作流,并非Demo,而是可直接用于实际业务场景的技能集合。内容涵盖企业架构、系统设计、BPMN流程、云架构、数据链路、UML、网络拓扑、思维导图及信息图表等。这些工具适合开发者绘制系统设计,产品经理梳理流程与规划,以及技术写作者制作文档和汇报材料,旨在提升方案文档的结构化和专业性。
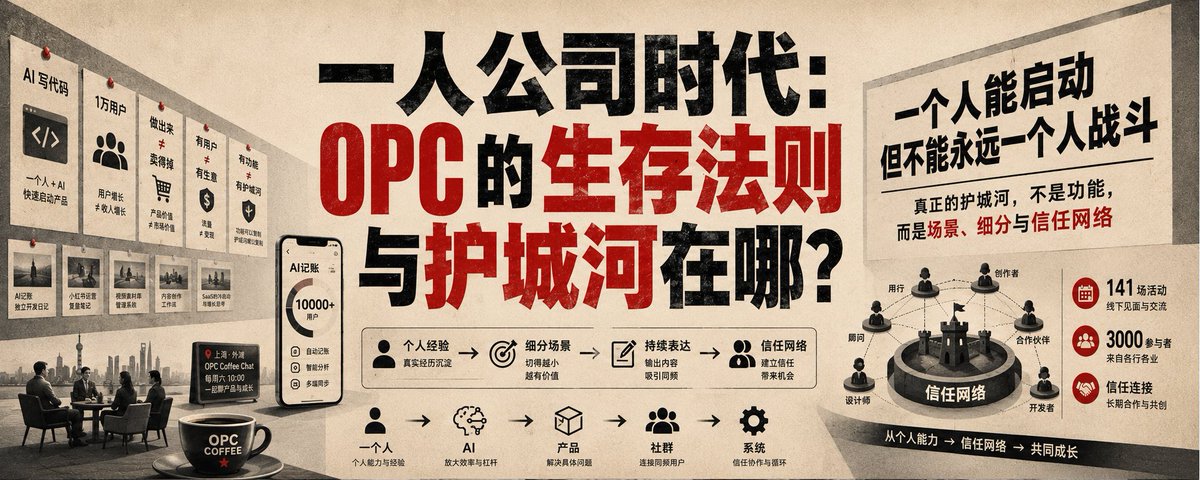
本文探讨了在 AI 时代下,一人公司(OPC)面临的机遇与挑战。虽然 AI 降低了生产门槛,但 OPC 仍面临变现难和缺乏护城河的问题。文章提出了三条生存法则:一是从深水区经验中生长出的场景理解;二是切入足够窄、足够痛的细分市场;三是构建基于线下真实连接的信任网络。真正的 OPC 不是一个人单打独斗,而是通过协作网络将自己从“劳动力”变为“系统”,即使离开业务也能自动运转。
本文分享了如何利用 AI 构建自动化的内容选题系统。作者提出“选题是信息处理问题而非灵感问题”,通过确立“四层水源”(快、深、慢、反)、撒下“关键词渔网”、AI 初筛信息、人工做四维判断以及入库排期这五个步骤,实现每天自动生成 10 个带数据和角度的选题,从而告别创作焦虑,提升内容生产效率。
本文介绍了 holon v0.14.1 版本的更新,重点在于使用 Rust 进行了底层重写,并实现了项目的自举开发(即 Agent 自主完成从需求分析到代码合并的全流程)。文章详细阐述了采用 Rust 重写的原因、关键架构设计(如单 Session 模式、Workitem 机制和事件驱动),并展示了实际的 Dev 工作流及与竞品模型的对比测试数据。