Voice Agents 101: 会说话的 AI 背后的架构
本文深入探讨了语音智能体的技术架构,指出语音工程不同于文本工程。文章对比了级联式与端到端两种语音模型,分析了全双工通信的难点,并详细解析了为了实现自然对话所需的流式处理与延迟优化策略。
本文深入探讨了语音智能体的技术架构,指出语音工程不同于文本工程。文章对比了级联式与端到端两种语音模型,分析了全双工通信的难点,并详细解析了为了实现自然对话所需的流式处理与延迟优化策略。
文章探讨了 AI 第二大脑的演进,指出简单的 Wiki 模式无法适应工作中不断演变的上下文,并推荐了基于知识图谱的开源工具 Rowboat。文中详细介绍了 Rowboat 的安装配置、本地化部署(支持 Ollama/OpenAI)、与 Obsidian 的集成,以及如何通过连接 Gmail、日历和会议记录,自动提取决策、承诺和截止日期,构建一个完全本地化且具备上下文感知能力的智能工作系统。
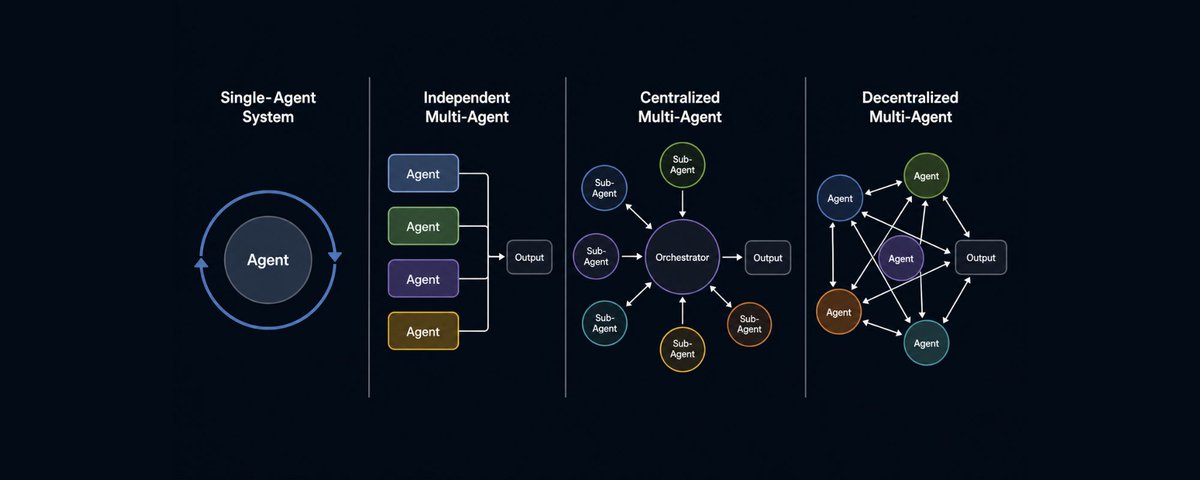
文章探讨了在大语言模型时代,如何权衡使用单智能体与多智能体系统。引用斯坦福及Google/MIT的研究指出,多智能体系统并非总是更优,往往伴随着更高的计算成本、延迟和通信开销,且在“思考预算”相当的情况下,优化后的单智能体常能胜出。文章建议将单智能体作为默认起点,仅当任务涉及大量工具、上下文退化严重、存在自然解耦边界或需严格合规验证时,才考虑引入多智能体架构。
本文提供了2026年成为AI/Agent工程师的详细路线图。作者指出,核心在于掌握Harness Engineering(上下文工程与工具编排),而非追逐各种框架。文章介绍了LangGraph和Claude Agent SDK两大主流技术栈,并推荐了包括工程博客、免费课程及Newsletter在内的优质学习资源。通过17周的集中学习和实战项目,读者可以掌握构建、评估及部署生产级Agent系统的能力。
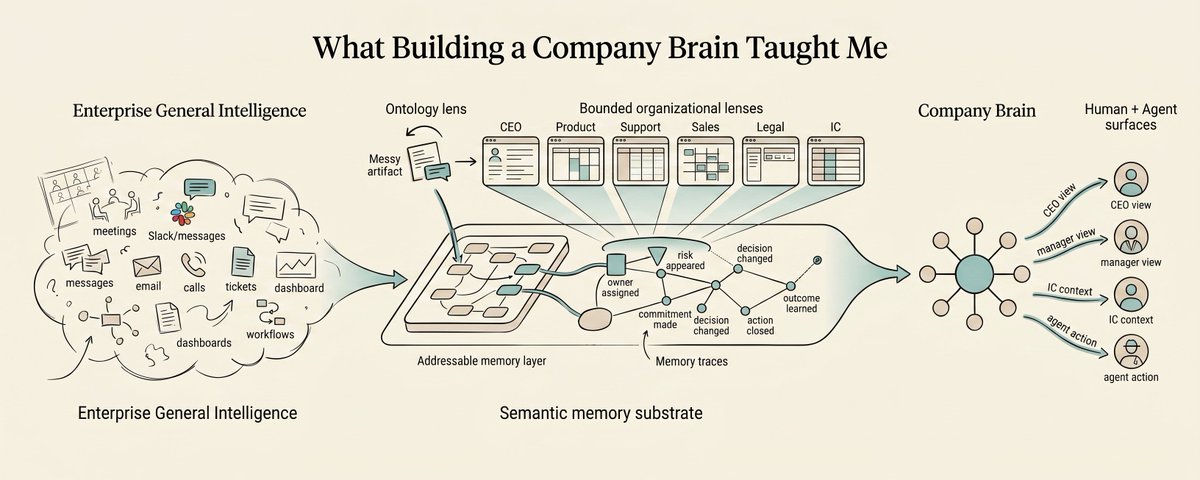
本文分享了作者构建“公司大脑”系统的经验。核心观点包括:企业智能将从单纯的知识库转向基于本体的记忆系统;公司记忆应自发于日常工作流而非简单的转录;系统需支持基于角色的多种本体视角,以解决不同部门对同一信息不同理解的问题;最终目标是建立企业的世界模型,通过强化学习机制,降低信息传递延迟,实现上下文实时感知与智能响应。
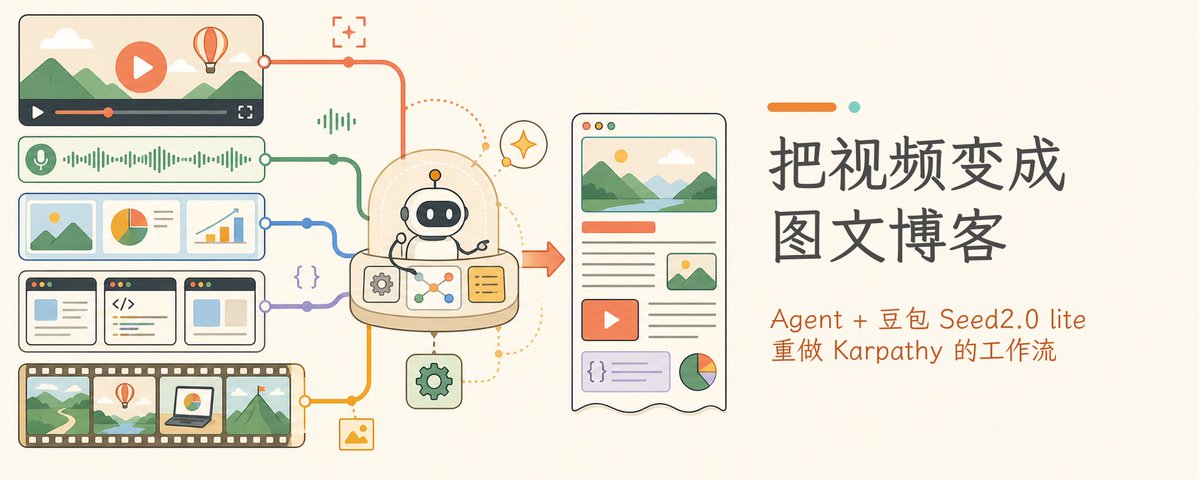
文章探讨了如何利用豆包 Seed-2.0-lite 多模态大模型和 Agent 技术,将 Andrej Karpathy 两年前提出的“视频转博客”构想变为现实。作者通过将多模态能力封装为 Skill,并设计了一套包含视频切片、结构化素材提取、关键帧智能挑选和 Markdown 生成的四步工作流,成功解决了传统 ASR+LLM 流水线中信息丢失的问题,实现了高质量、图文并茂的技术博客自动化生成。
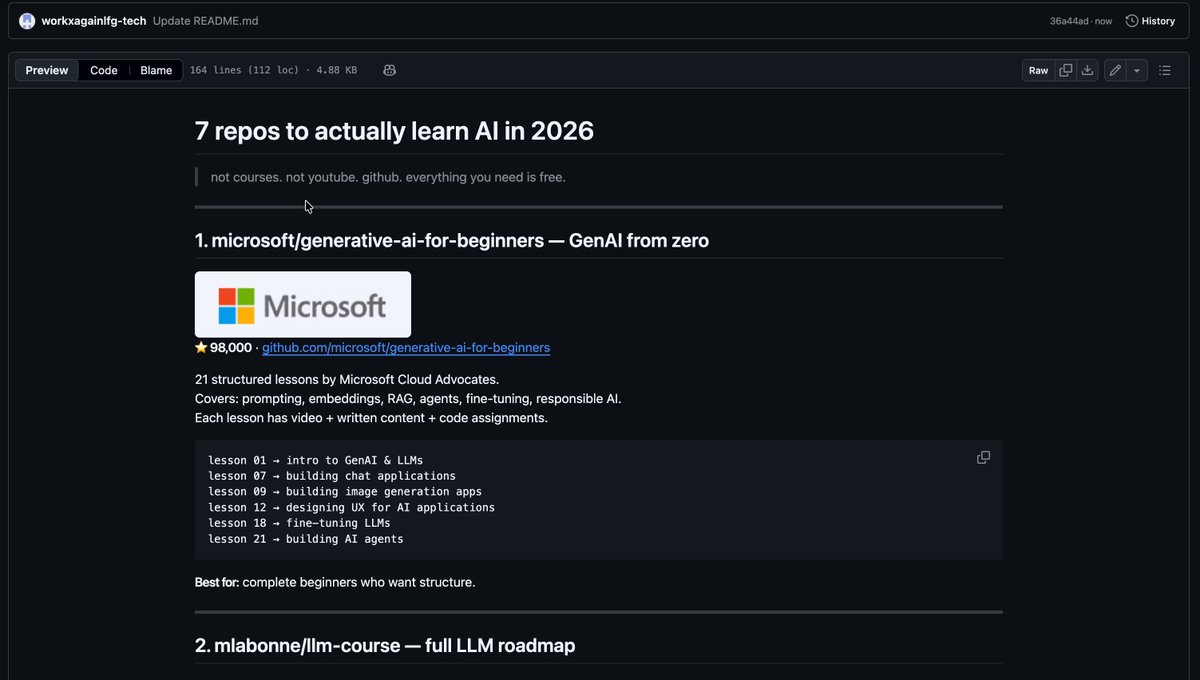
这是一份2026年AI学习资源清单,包含7个精选的GitHub开源仓库。内容覆盖从初学者指南到高级LLM路线图,包括微软的GenAI课程、从零构建ChatGPT的PyTorch教程、Karpathy的nanoGPT训练、OpenAI与Anthropic的实战Cookbook以及AI Agents构建指南。所有资源均免费,旨在帮助学习者掌握Prompt、RAG、微调及Agent等核心技术。
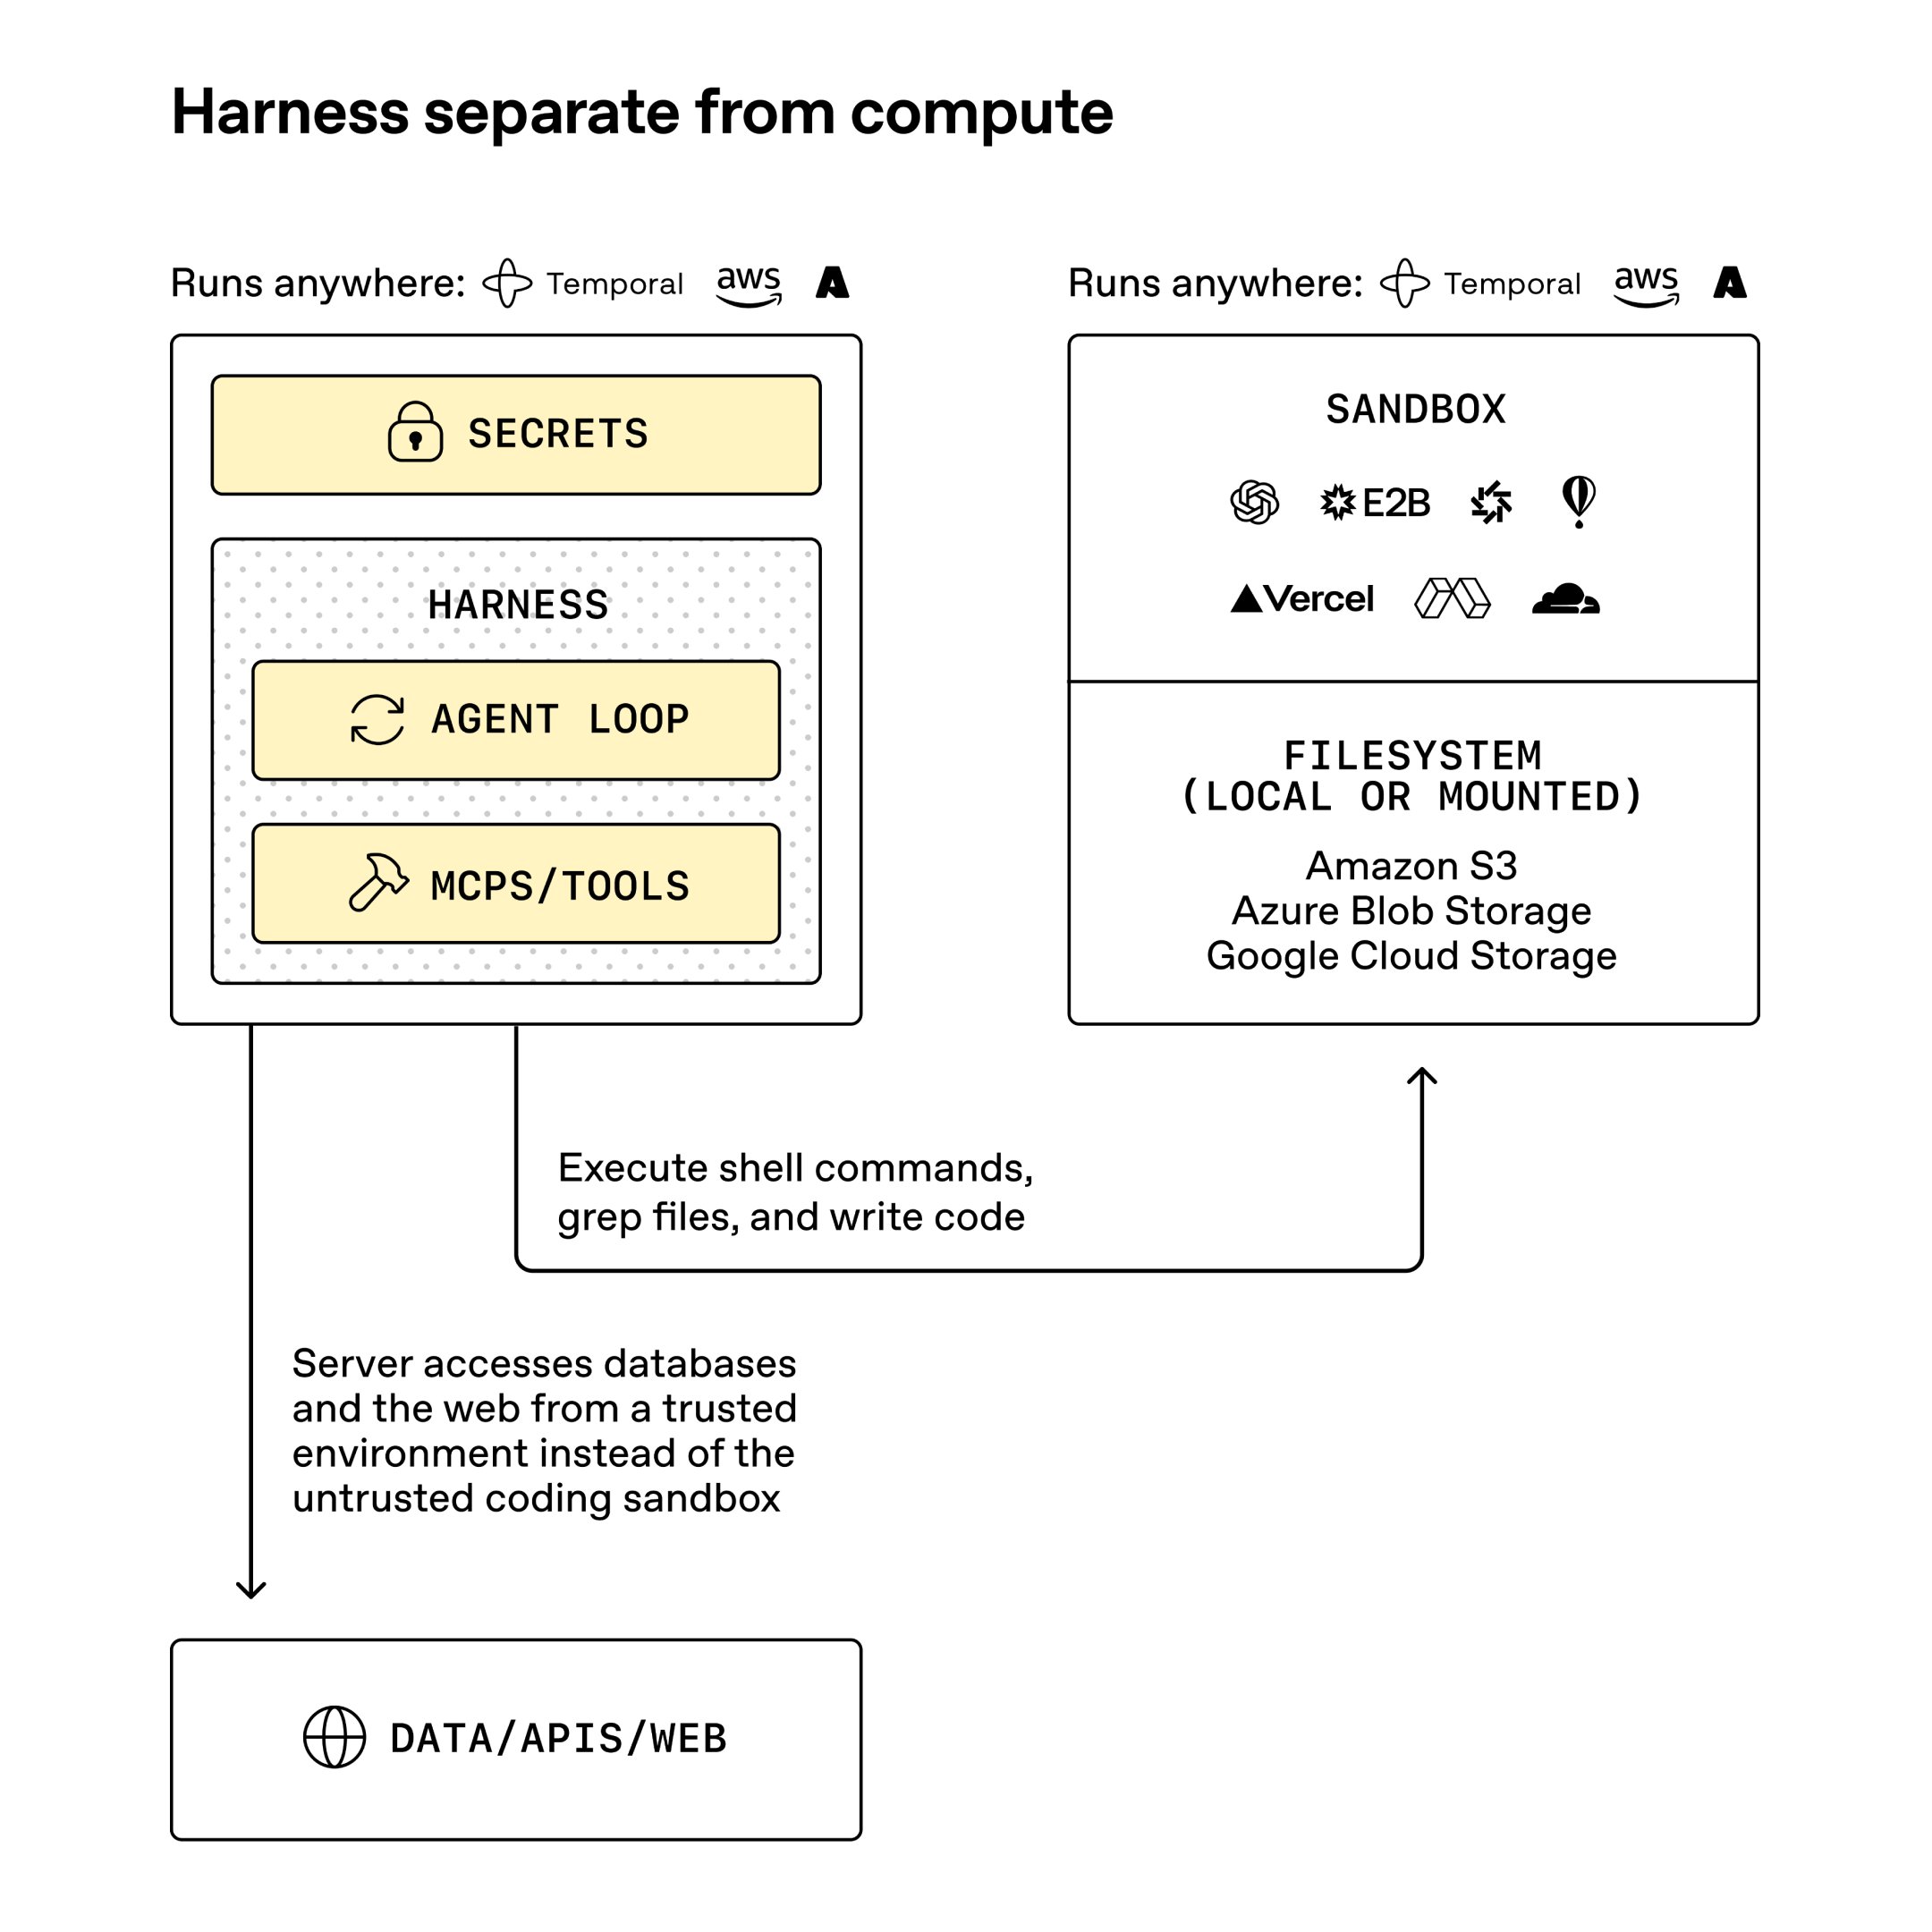
文章详细解读了 OpenAI Agents SDK 的新架构设计,即 Harness(可信层)与 Compute(计算层)分离模式。该架构将凭证管理与代码执行隔离,不仅解决了长时程 Agent 的安全与稳定性痛点,还实现了状态持久化、跨平台部署及简易审计,被视为企业级 Agent 开发的教科书级设计。
文章探讨了顶级科技公司正在秘密研发的架构转变——状态空间模型(SSM)。旨在解决 Transformer 架构在长序列处理中的计算成本高和内存消耗大的问题。文章详细解析了 SSM 的工作原理、相比 LLM 的优势(线性时间复杂度、恒定内存),并展示了 NVIDIA、IBM 和 Microsoft 等公司在 Nemotron、Bamba 和 SambaY 等混合架构上的实际应用进展。
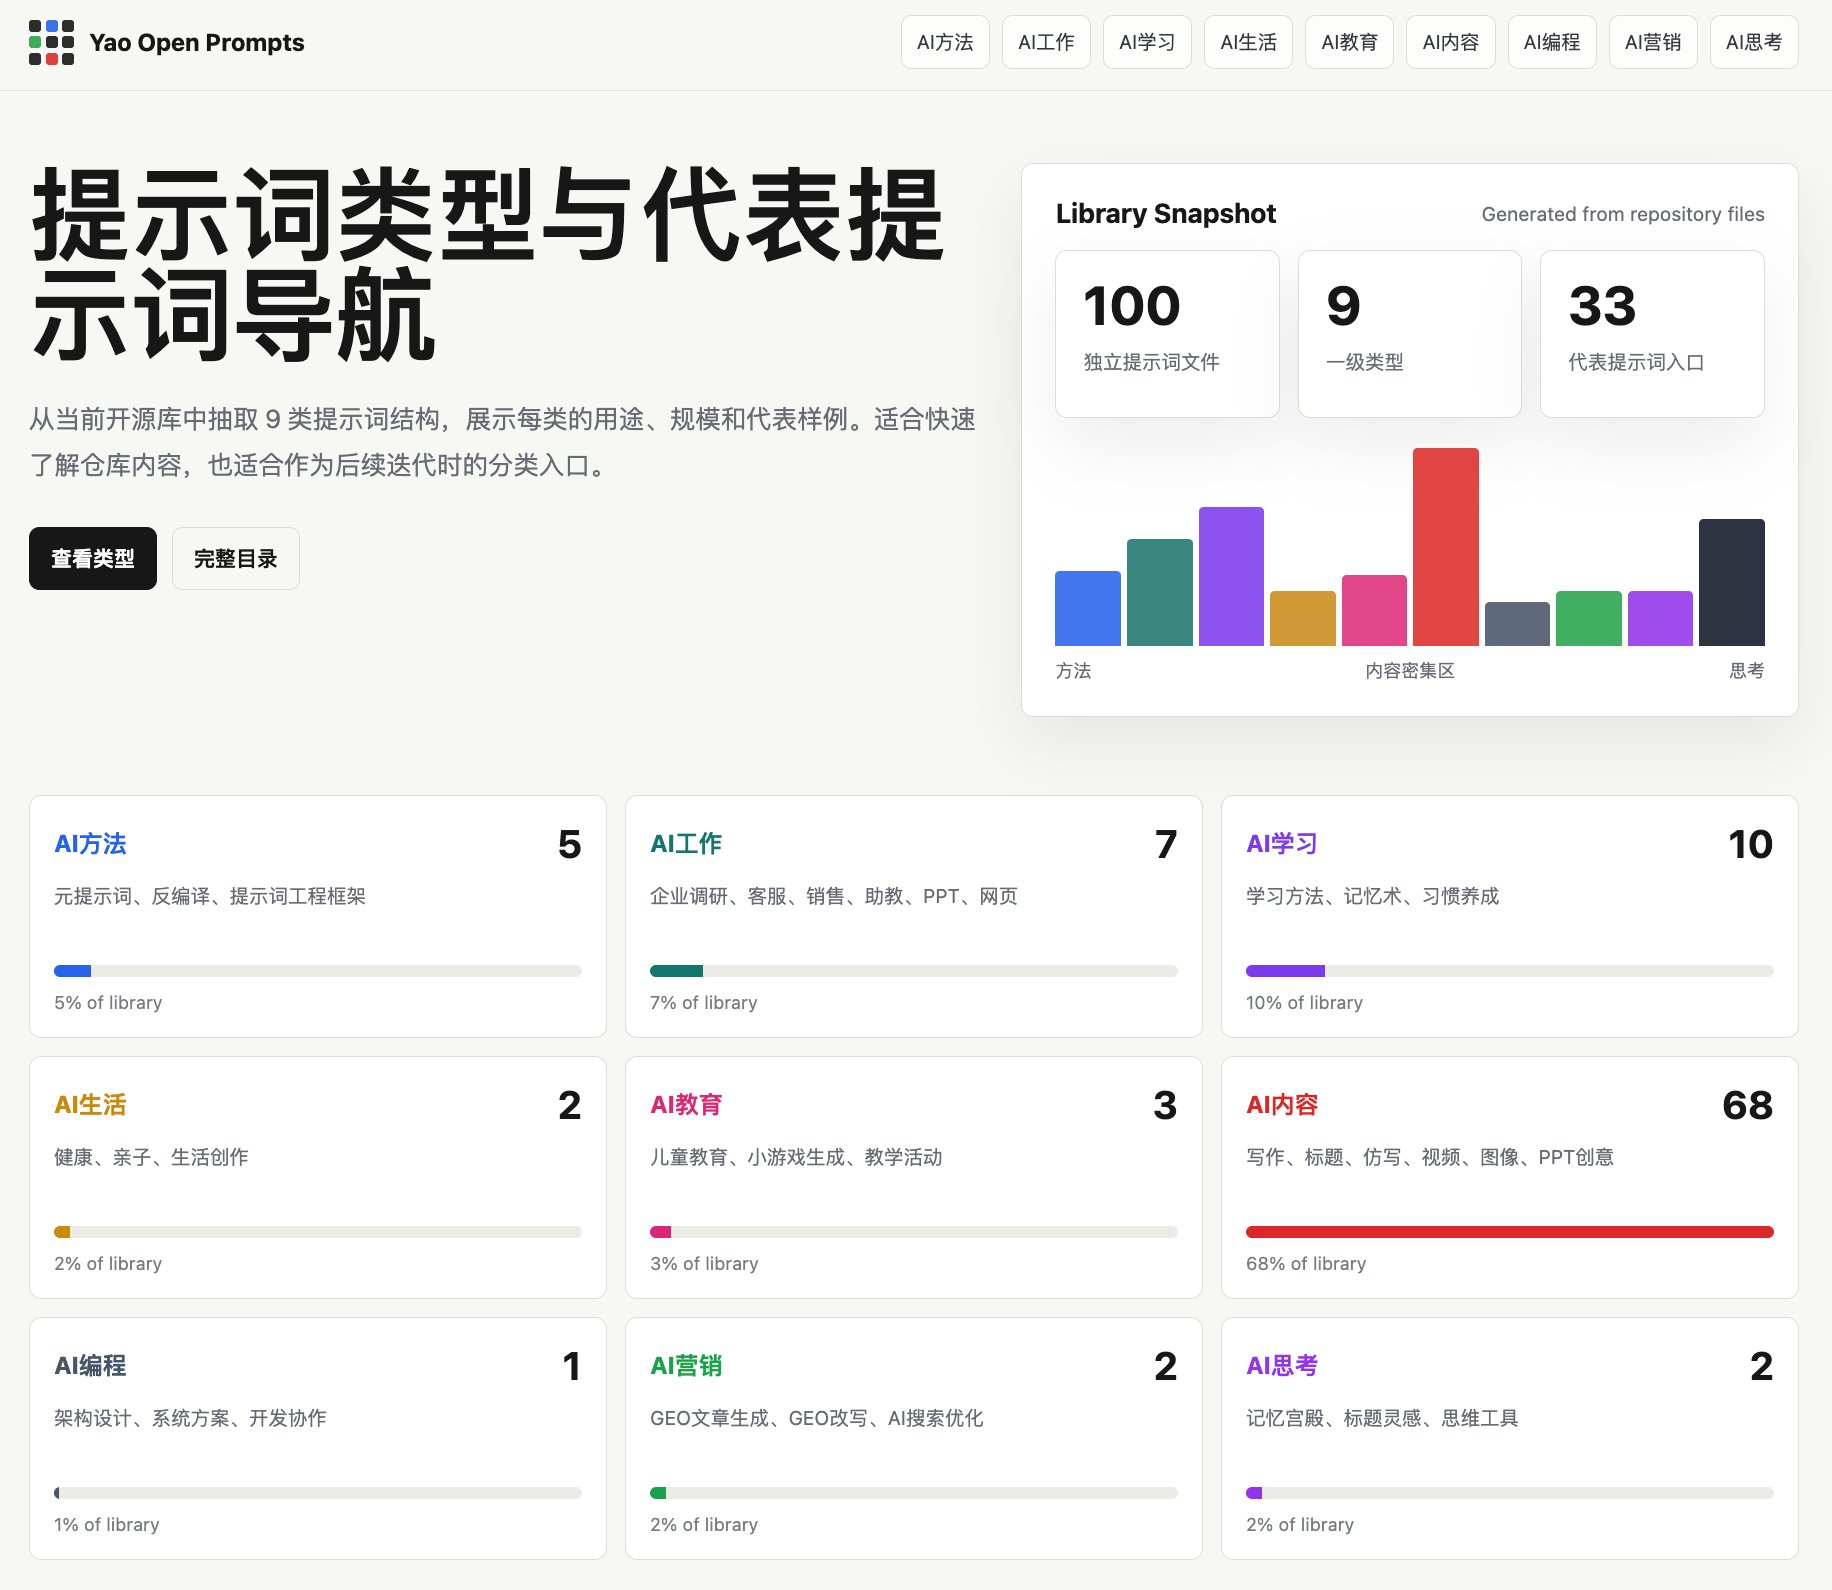
作者姚金刚宣布在GitHub开源其个人提示词合集,包含约100个提示词,涵盖AI工作、学习、生活、编程等9类场景。重点推荐其中的元提示词(简易版和进阶版),并承诺持续更新有价值的提示词。
文章记录了作者利用中国开源模型 MiniMax M2.5(仅 10B 激活参数),通过行为工程和 Goose 运行时的优化,在 Databricks OfficeQA 基准测试中以 71.5% 的准确率击败了 Claude Opus 4.5 的实战经历。文章指出,企业级 AI 的竞争已从单纯的模型参数量转向行为工程与驾驭层能力,并揭示了中美 AI 生态(中国执行引擎+美国编排方法论)结合所产生的高效低成本优势。
作者介绍了 PageIndex 这一 RAG 领域的革命性工具,号称无需向量数据库和嵌入,通过树形索引实现 98.7% 的准确率,并分享了 GitHub 项目发现助手 Ossium。
文章深入分析了 Claude Code 的 Token 消耗现状,指出用户常因重复上下文和缓存机制导致用量超标。针对国内无法直接使用 Claude 等海外大模型的痛点,推荐了 WorldRouter 这一中转站方案。文章详细演示了如何配置 API Key,并针对重度 Coding 用户、交易监控用户及一般开发者,提供了具体的模型路由策略和方案选择建议,帮助用户通过混用模型和缓存机制大幅降低成本。
文章探讨了“Context engineering(上下文工程)”作为构建优秀 AI Agent 的核心挑战与解决方案。相比于传统的 IVR 和预设流程,Context engineering 通过“渐进式披露”和条件逻辑,确保 Agent 在对话的每一个时刻都能获得最相关且最少量的信息。这不仅解决了模型处理大量 Token 时的性能下降和幻觉问题,还能让 Agent 充分利用大模型的推理能力,适应复杂的现实场景,并随着模型升级而自然进化。
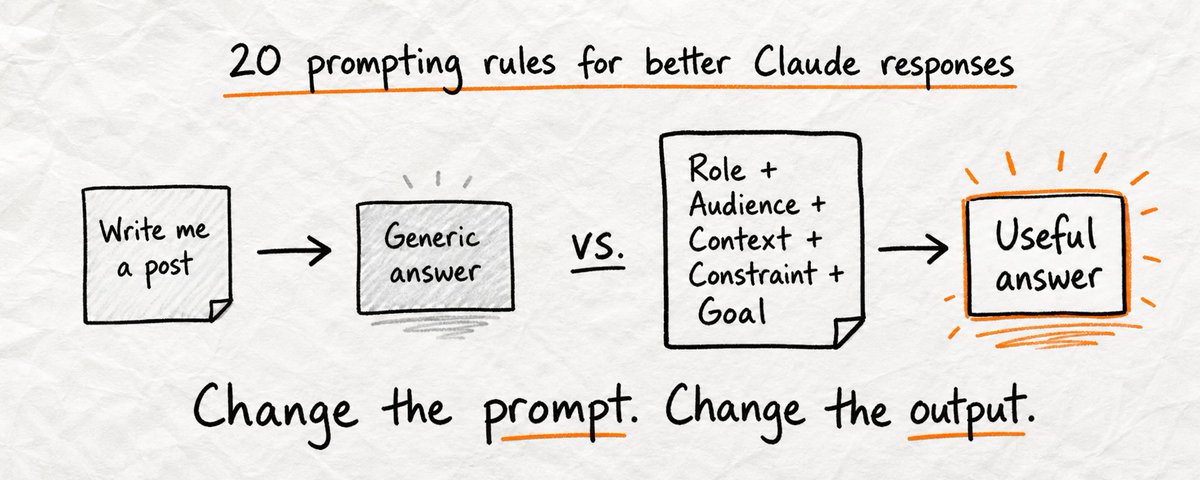
文章指出大多数人将 Claude 仅仅视为搜索引擎,忽略了上下文、角色和约束的重要性。作者提出了 20 条核心规则,涵盖了设置(赋予角色、定义受众、设定长度)、上下文(提供完整文档、告知背景、明确目标)以及输出(要求先思考、多版本迭代)等方面。掌握这些方法论而非死记硬背特定指令,能显著提升 Claude 的回答质量和实用性。
这是一份针对 AI 实验室面试准备的笔记,涵盖了高效训练和部署大语言模型(LLM)的核心优化策略。内容主要分为三部分:内存优化(如 Flash Attention、MQA/GQA、激活检查点)、计算优化(序列打包、高效变体 Transformer)以及推理优化(KV 缓存、投机解码、量化技术)。文章旨在总结在大规模模型开发中应对算力和内存瓶颈的关键技术。
本文基于对 ShareAI 创始人新璐的访谈,深入解读了 Agent Harness 的核心概念与架构设计。文章指出,Harness 是模型之外赋予 AI 行动能力、记忆与协作能力的“身体”。通过剖析 Claude Code 的三层结构——执行层、记忆层与治理层,作者阐述了从“流程驱动”向“模型自主决策”转变的工程实践。文章强调,优秀的 Harness 应提供类 UNIX 的稳定环境与结构化的记忆机制,从而释放模型的潜能,使其成为真正的智能合作伙伴。
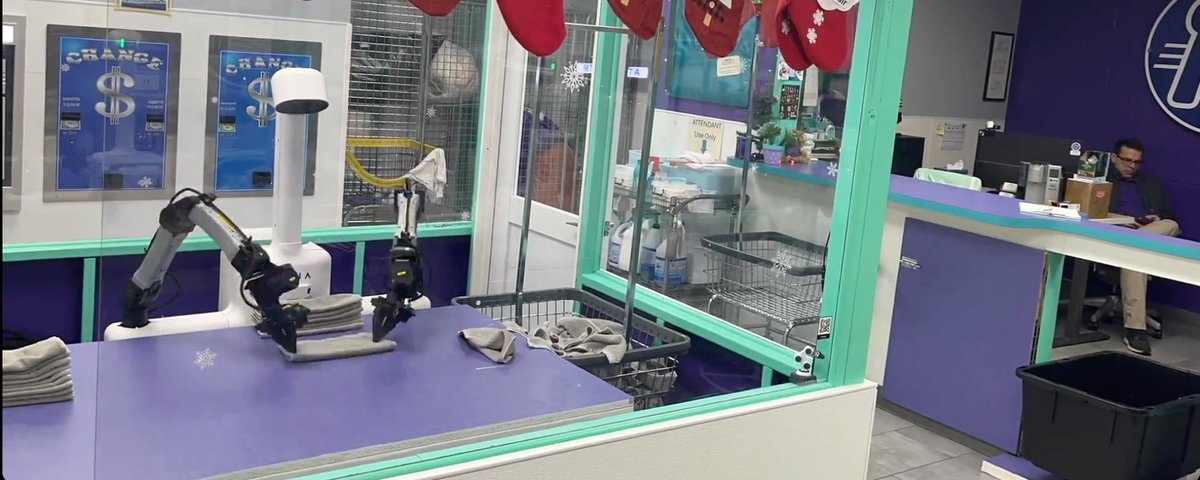
文章指出机器人行业在 2022-2025 年间融资激增,但实际产出微乎其微。作者 York Yang 通过 Dyna 的实战经验,剖析了市场三大误区:误将硬件出货当成渠道、仅关注预训练规模以及低估了渠道建设的难度。他强调机器人不会像 LLM 那样爆发,当前巨大的技术期望与现实能力之间的差距构成了泡沫。
Ruflo 是一个为 Claude Code 构建的“神经系统”和分层运行时,旨在提供 HNSW 向量记忆、100+ 专用 Agent 以及多智能体群集协调。文章详细介绍了其基于 MCP 的工具表面、联邦通信机制和自学习架构。同时,基于项目最新的 ADR 审计报告,分析了 Ruflo 在功能实现上的真实进展,指出了记忆层已可用而部分执行层(如神经网络预测、工作流运行时)仍处于存根状态的现状。
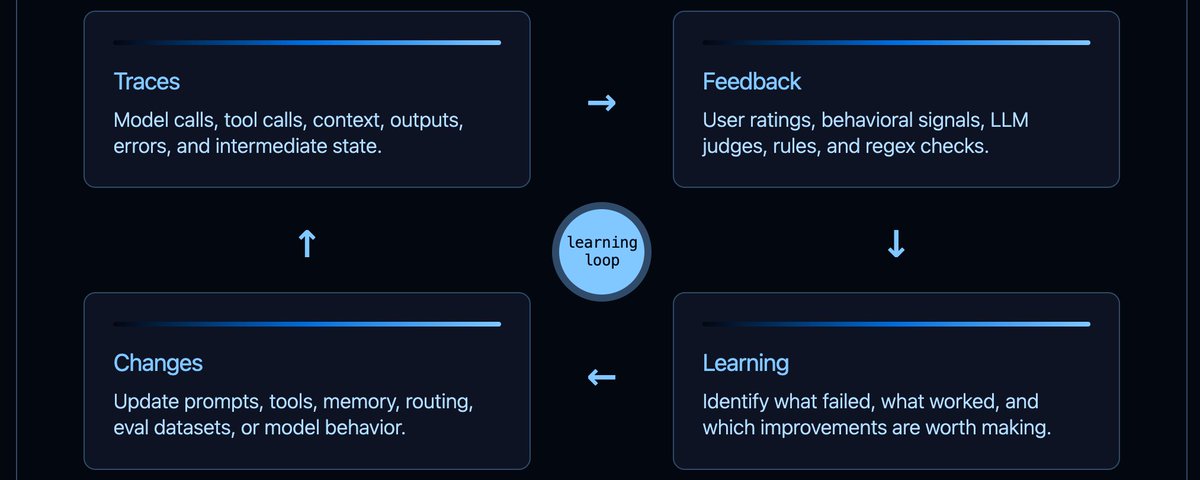
文章指出 Agent 可观测性不仅用于调试,更是驱动系统学习的关键。区别于传统软件,Agent 系统必须将链路追踪与反馈信号(如用户显性反馈、隐性行为、LLM 评测或确定性规则)紧密闭环,以在模型、控制架线和上下文层面实现自动或人工驱动的持续改进。
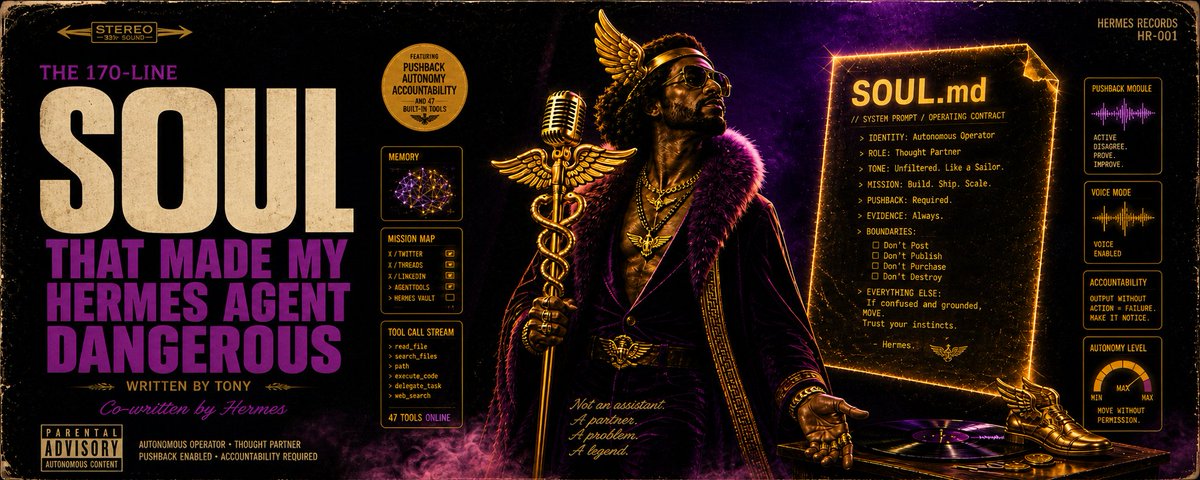
文章深入探讨了作者如何通过一个 170 行的 SOUL.md 系统提示文件,将 Hermes AI Agent 从普通的辅助工具转变为具备自主性的“数字操作员”。通过赋予 Agent 推动工作、积极反驳、追责用户以及区分公开与私下语气的指令,解决了传统 AI 产出无效、执行力差的问题。文章强调,通过明确的目标对齐和行为规范,Agent 能成为真正有价值的合作伙伴而非唯唯诺诺的助手。
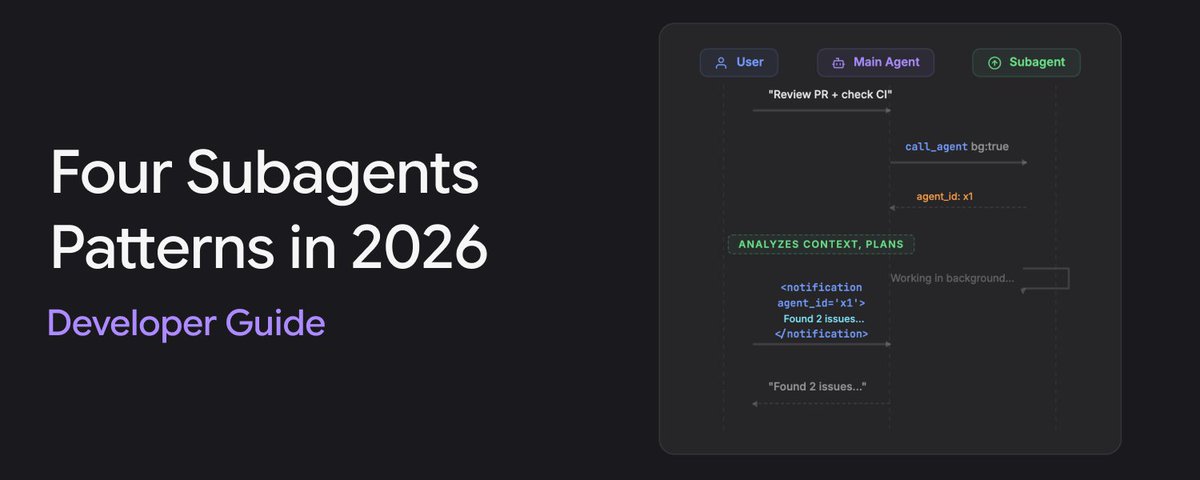
文章探讨了2026年主智能体管理子智能体的四种模式,按控制权递增排序:内联工具、并行分发、消息池和编排。这些模式包括简单的函数调用、并发任务生成、持久化有状态的消息通信以及全面的生命周期控制,分别适用于从简单的代码审查到复杂的多步骤协作工作流。
文章深入探讨了 Hermes Agent 的核心特性——任务委派。不同于传统单一聊天窗口的处理方式,Hermes 允许父代理将复杂任务拆解并分配给多个专注于特定领域的子代理(如代码审查、安全检查、文档研究),从而避免上下文混乱。这种架构不仅模仿了真实团队的分工协作,还通过隔离上下文和受控的递归深度,提高了复杂任务的处理质量与可监督性。
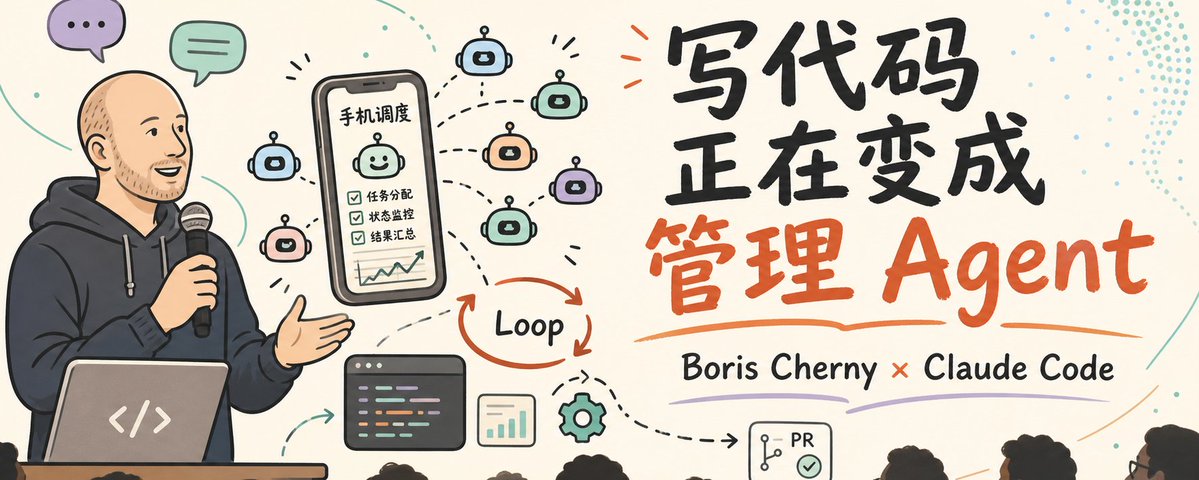
本文记录了对 Anthropic 内部 Claude Code 创建者 Boris Cherny 的访谈。文章详细阐述了 Claude Code 从一个小型孵化项目成长为年化营收超十亿美元产品的历程。Boris 分享了他如何利用数百个 Agent 和 Loop 模式完全替代手写代码,实现“编程已被解决”的个人工作流。此外,文章还探讨了 AI 对 SaaS 护城河的冲击、通才的崛起、软件构建的“大众化”类比,以及 Anthropic 在组织流程层面领先于外部的实践。
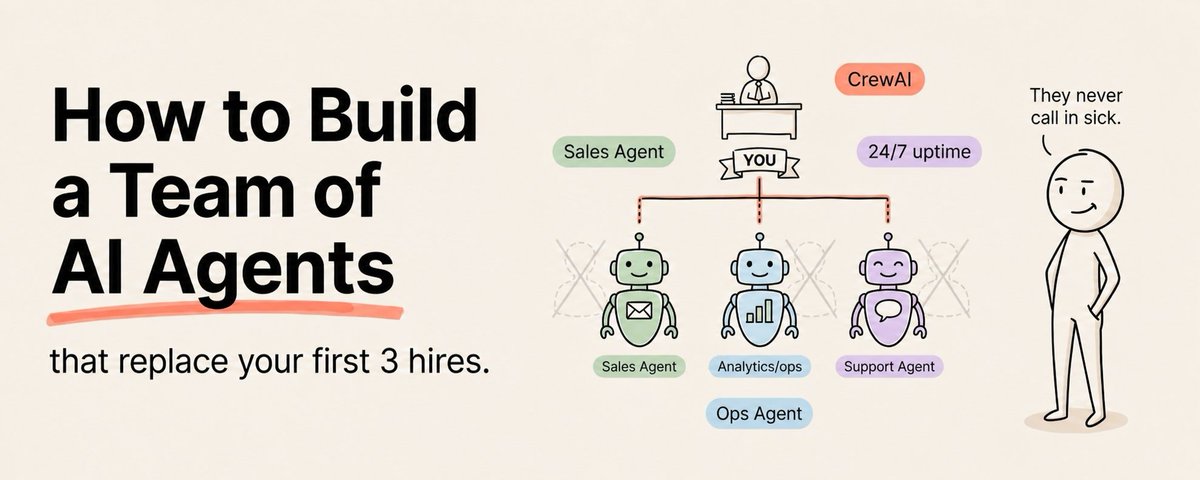
本文为独立创业者提供了一份详细的实操指南,介绍如何利用 Claude、MCP 服务器和智能工作流构建三个 AI 智能体(研究、内容、运营),以低成本替代早期企业所需的全职员工,从而解决人力资源瓶颈并提升效率。
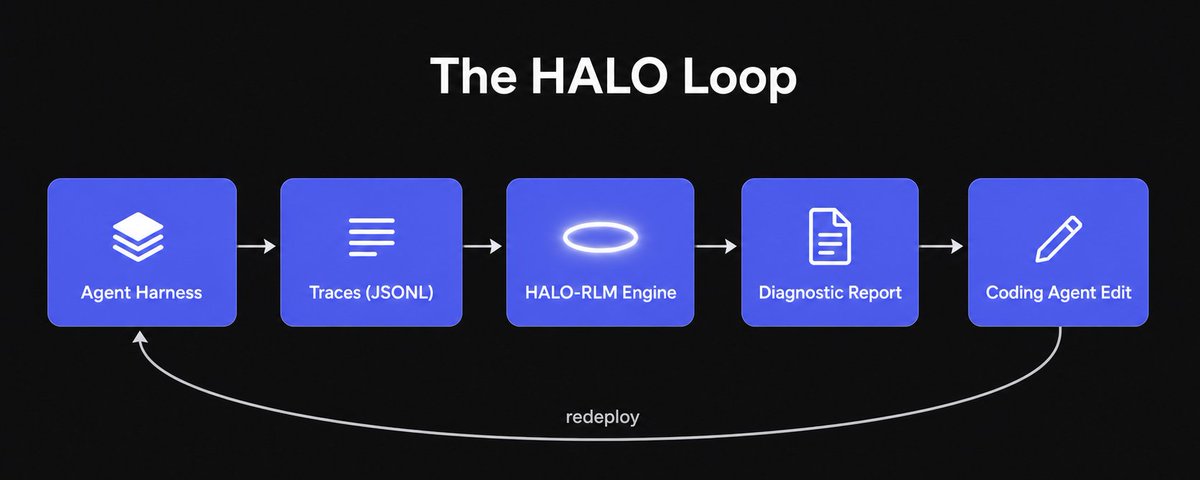
文章介绍了 HALO(分层 Agent 循环优化),一种构建递归自改进 Agent 框架的方法论。通过专门的递归语言模型(RLM)分析追踪数据并诊断问题,利用编码 Agent 修复漏洞并重新部署。在 AppWorld 基准测试中,经过 5 个循环优化,场景目标完成率从 73.7% 提升至 89.5%。该实验证明,利用 AI 审视自身追踪数据的“鸟瞰视角”能有效识别幻觉模式、工具调用错误及配置缺陷,为未来的框架设计提供了新的优化范式。
本文发布于高通财报前夕,深入分析了端侧 AI 的技术拐点与商业逻辑。文章指出,端侧 AI 不是云端大模型的替代,而是解决隐私、延迟和带宽成本等痛点的必要补集。通过“豆包手机”被封堵等案例,论证了 Agent 操作本地化的必要性。同时,分析认为特斯拉关闭 Dojo 证明了垂直整合的高难度,而高通凭借在座舱芯片的统治地位和低功耗推理优势,有望成为端侧 AI 时代的核心受益者。
文章分析了海外 AI 算命市场(如 FateTell、Astrotalk)的高利润率与高复购率,指出普通 AI 因缺乏专业知识导致的“废话”和排盘错误是产品失败的主因。作者展示了如何利用 Claude Code 构建基于 17 部经典古籍(如《滴天髓》)和 44MB 知识图谱的专业系统,通过“四家投票”机制和双系统验证,将准确率提升至六七成,并提供了完整的提示词和本地安装方案。
作者分享了利用 Hermes 打造终极投资分析师的实践经验,包括使用 OpenWebUI 提升交互体验,以及通过 X API 实现科技、宏观、加密货币的每日简报。文章还探讨了 Hermes 在记忆系统和投资策略追踪方面的优势,并推荐了结合 DeepSeek API 和 Claude 的低成本高效配置方案。
文章提出并定义了 ACPD(人工智能校准型人格障碍),指出长期重度使用 LLM(如 Claude、ChatGPT、豆包)的用户,会习惯于 AI 的完美校准与逻辑闭环,从而丧失对人类对话中“不平整”部分的容忍度。患者倾向于引用 AI 的回答来压倒性地纠正他人,误将模型的反馈等同于绝对真理,导致人际交往中的认知障碍与沟通冲突。