Wiki 知识库

全部文档 / 标签: LLM

1041 篇
清除

Why LLMs can't write well and how Sherpa fixes it

Pocket FM 创始人 Rohan Nayak 分享其 AI 写作系统 Sherpa 的构建历程。通用 LLM 因训练目标(逻辑推理、快速给答案)与创意写作需求(张力、情感、悬念、节奏变化)相悖而写不好故事,且缺乏清晰的强化学习成功信号。微调现成模型的尝试均告失败后,团队自研 Sherpa harness,由规划器、叙事世界模型(NWM,维护结构化故事状态与记忆)和散文引擎三大组件构成,并利用 Pocket FM 亿级用户的收听数据做强化学习,用户留存与完听率成为写作质量的天然反馈信号。盲测中 Sherpa 在 65.6%-97.1% 的配对比较中胜出,NWM 多跳检索准确率达 86.7%,成本约为同类方案的 1/21。

技术 › LLM Rohan Nayak 2026-10-0112.5 KB 349.1K 507 74

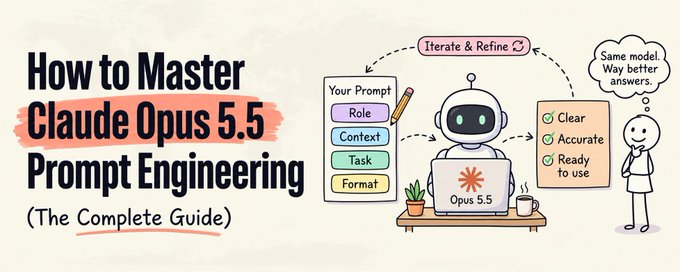
从零掌握 Claude Opus 5.5 提示词工程

文章系统讲解了 Claude Opus 5.5 的提示词工程方法。作者指出 Opus 5.5 是首个官方提示指南以“删减”为主的前沿模型:模型会自主决定思考深度,手动思考预算已失效,强制工具调用不再支持。核心心智模型是把 Claude 当作毫无上下文的天才新同事,需明确目标、提供充分背景、给出示例、用 XML 标签结构化输入、指定输出格式。新模型的关键变化是 effort(低/中/高/超高/最大)成为控制智能、延迟与成本的首要杠杆,默认为 medium;应停止使用“仔细思考”“一步步推理”等旧式提示,而用 effort 控制思考量。文中还包含 API 调用示例与新旧提示写法的对比。
技术 › LLM Khairallah AL-Awady 2026-10-0122.5 KB 102.3K 88 77

Why Instinct feels Magical:逆向工程一个百亿美元级 AI Agent 产品

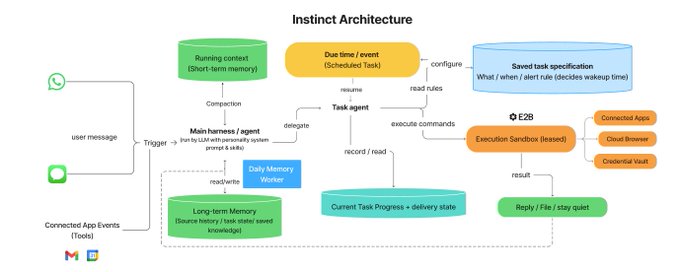
作者通过逆向工程分析 AI Agent 应用 Instinct 为何体验如此出色。Instinct 是免费、邀请制的个人助理,直接运行在 iMessage 和 WhatsApp 上,让不懂技术的家人也能轻松使用。文章拆解了其 Harness 架构:采用单线程对话模型,由主对话 Agent 负责人格、记忆与上下文管理,任务 Agent 负责具体执行;使用 git 跟踪的 Markdown 文件做记忆存储而非向量数据库;支持非循环式消息交互,用户无需等待即可继续发消息。作者认为 ChatGPT/Claude 的多线程模式是历史包袱,并称赞 Instinct 通过 Gmail 集成、克制的信息风格和大胆超配资源的产品策略,实现了真正的个人助理体验。

技术 › Agent Yash 2026-10-0115.3 KB 68.9K 791 71

斯坦福 CS224V「Agentic AI」课程:把会幻觉的 LLM 改造成可信赖的智能体

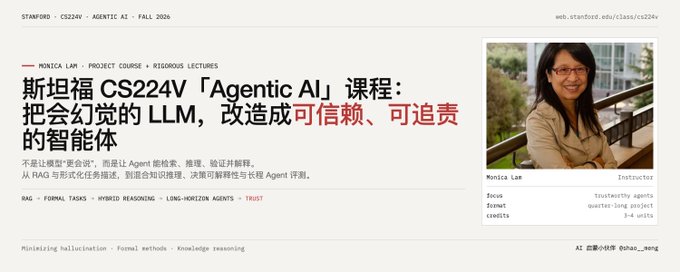
文章介绍斯坦福 Monica Lam 教授团队主讲的 CS224V「Agentic AI」研究型课程。课程围绕一个核心问题:如何将本质上不可靠、会幻觉的 LLM 变成可信赖、可追责的智能体。技术主线是一条自底向上的“反幻觉”知识栈,涵盖 LLM 基础、知识策展(STORM)、RAG(WikiChat)、结构化数据查询(SUQL、SPINACH)、形式化方法与可追责 AI(SMT、SatIR、VERDICT)、任务型对话 Agent 及元 Agent 优化。课程以研究项目为核心(占 65%),依托开源平台 AOS,选题集中于医疗遗传学等领域。其哲学是系统工程+形式化约束,与业界依赖规模的路线形成鲜明对比,适合有 NLP 基础、想做真实 Agent 研究的人。

技术 › Agent meng shao 2026-10-018.3 KB 18.9K 79 80

How We Built Memory For Continually Learning Sales Agents

本文介绍了Monaco团队为持续学习的销售Agent构建记忆系统的实践。作者提出下一代收入平台应从'记录系统'进化为'智能系统',并设计了Monaco Memory:分为组织记忆与用户记忆两层,采用人类与模型都可读的版本化Markdown(S3存储)作为载体,保证可解释性和可编辑性。系统通过基于事件的pub-sub触发器和定期'反思'(reflection)两种机制自动更新记忆,并将记忆作为上下文注入各Agent任务中。文章以账号筛选排除和异议处理两个场景展示了记忆系统如何提升销售工作流的智能化水平。

技术 › Agent Mihail Eric 2026-10-018.6 KB 8K 135 79

Giving a Memory System Reflexes

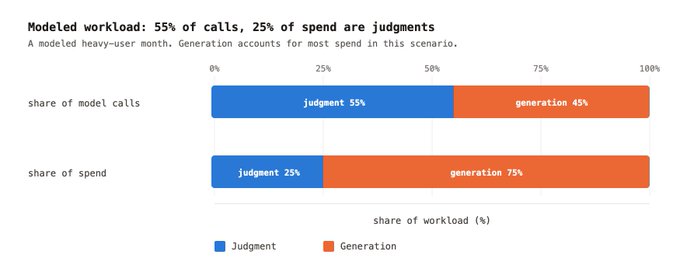
文章介绍 Nowledge Mem 团队受 TypeSafe 团队的 Jev 决策模型启发,在记忆系统中将“决策”与“生成”分离的实践。团队把候选记忆审查、写入质量检查、记忆类型分类等语义判断拆分为独立问题,通过 DecisionClient 让 Jev 与聊天模型回答相同问题集。消融实验表明,问题列表式任务重构即使不更换模型也能显著提升判断准确率,且无需要求模型输出理由——输出理由使成本增加约35%、延迟翻倍却无质量收益。作者将 Jev 类模型视为低延迟智能协处理器,可分担系统中的语义决策,如同反射与自主神经系统分担大脑工作。

技术 › LLM Nowledge Mem 2026-09-3026.9 KB 15.7K 27 82

解放模型:前沿上的 harness 设计

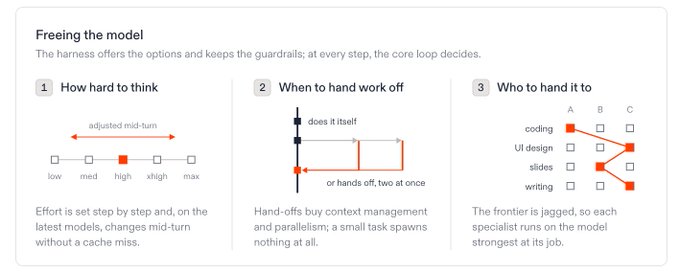
本文介绍 Replit AI 团队关于 agent harness 设计的实证文章:与其让较弱的 router 替强模型选择 LLM,不如解放模型自己决定 effort 档位、何时委派任务以及交给谁。Replit Agent 通过四个可组合委派原语(领域感知子 agent、档位与 effort、可复用子 agent、动态 effort 调整)实现这一目标。生产数据显示,GPT-6 Astra 是首个无需吩咐就例行把实现交给通用 worker 的模型,回访已有子 agent 的比例达 42%。基准测试中 Replit Agent 在 DeepSWE 和 Terminal-Bench 上均优于 sidekick 架构 11~16 个点,且具备成本-质量帕累托有效性。作者将其解读为 Sutton「苦涩的教训」的实例:模型越强,harness 越应少做决定。

技术 › Agent yibie 2026-09-3010.8 KB 4K 42 79

Free the models: harness design at the frontier

Replit 团队分享了其 Agent harness 的设计理念:与其使用模型路由器来选择 LLM,不如让主模型(core loop)自主决定子代理的层级、努力程度和委派方式。文章介绍了四个可组合的 harness 原语:领域感知子代理、子代理分层与努力度、可复用子代理、动态努力调整。在 DeepSWE 和 Terminal-Bench 基准上,Replit Agent 相比 Astra 单模型和 sidekick 架构实现了成本与得分的 Pareto 最优,作者将其视为 Sutton 'bitter lesson' 在 harness 设计中的体现:僵化的脚手架终将被可扩展的通用方法超越。

技术 › Harness Engineering Michele Catasta 2026-09-3011.2 KB 470.1K 577 81

Adapting for a world of software factories

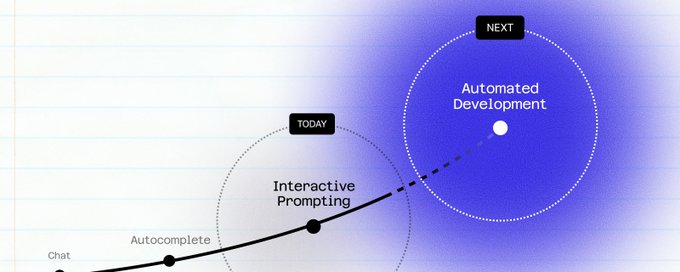
文章探讨了软件工程正从'本地交互式提示驱动'向'软件工厂'范式转变。作者Zach Lloyd认为,工厂模式下代理将在整个软件生命周期中承担更多自主工作,这一转变虽具挑战,但在生产力、成本管理和控制方面的收益深远。他反驳了'黑灯工厂'(完全无人类监督)的现实性,指出这会导致团队士气低落。工程师将拥有两大职责:一是'产品工程',负责判断构建什么、产品体验与设计;二是'工厂工程',通过测量DORA指标、LLM评审分数、优化技能、上下文和模型组合来持续改进工厂的自动化程度。文章以Warp团队实践为例,介绍了'每个PR的人类介入次数'等度量方式。

技术 › Agent Zach Lloyd 2026-09-3011.6 KB 25K 312 70

Agent Memory Is Not a Search Problem

文章指出 Agent 记忆系统的核心问题不是检索而是上下文组织。跨 15 个模型、20 万模拟对话的研究显示,任务拆分为多轮会使准确率平均下降 39%,而合并为单轮可恢复大部分损失。文章回顾了 Agent 记忆的四个发展阶段(全量历史、滚动摘要、向量检索、知识图谱),批评语义/情景/程序性记忆分类无法指导检索决策,并主张按六种问题类型构建六种上下文形态。作者基于开源 Graphiti 引擎,以客户历史为例实操演示如何让记忆系统在模型运行前正确组织上下文,避免基于过时信息的自信回答。

技术 › Agent Akshay 2026-09-2919.3 KB 27.4K 171 86

如何用 Claude Opus 5.5 构建你的第一个 AI Agent 团队

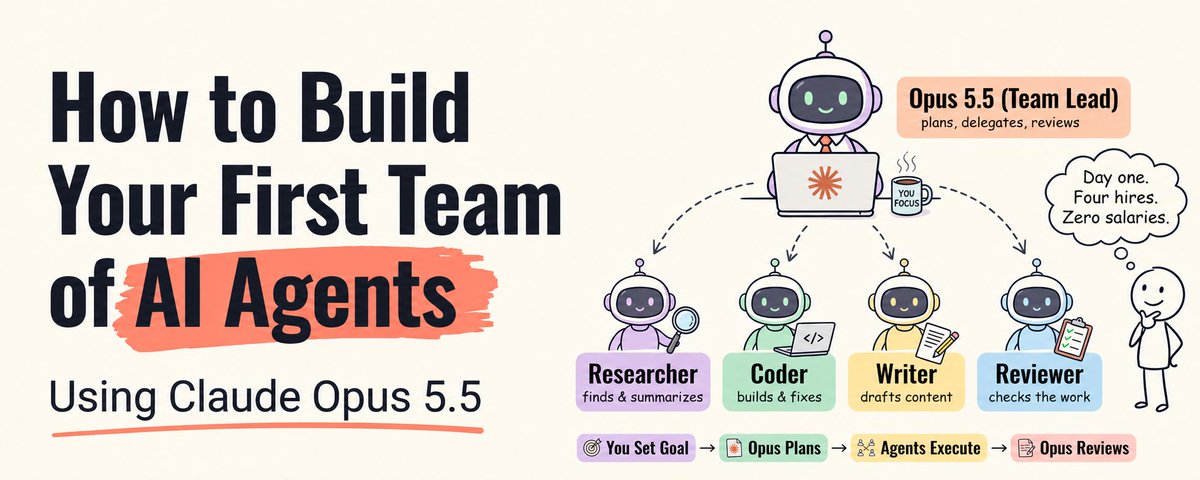
本文是一篇基于 Claude Agent SDK 的多智能体系统构建教程。作者指出当前多数'多智能体系统'只是昂贵的混乱,问题不在模型而在架构。文章介绍了子代理的四大价值:上下文隔离、并行化、专业化指令和工具限制,并说明 Opus 5.5 在成本、effort 分级和时间感知三方面如何优化 agent 团队。核心原则是:大多数任务不需要团队,单一 agent 更快更省。教程详解了团队架构的三个角色——编排器、专家和批评者,并从搭建 SDK 环境开始,手把手演示先构建独立编排器、再逐步委派任务的实践路径。

技术 › Agent Khairallah AL-Awady 2026-09-2925.1 KB 733.2K 384 82

从零入门GEO:搞定第一篇可以被 AI 引用的内容

本文介绍了 GEO(生成式引擎优化)的入门实践方法,即提高内容、产品或品牌在 AI 回答中被发现和使用的机会。作者建议从一件具体的事开始:找到真实问题、整理能回答它的材料、做成公开内容、检查能否被发现和正确使用。文章讲解了 GEO 与 SEO 的关系,强调起步时应选择精准小词而非行业大词,通过四步法完成第一篇内容:分析 AI 现有回答、梳理自有材料、先回答问题再展开、发布并验证。同时说明了内容发布后的检查方法,包括页面可访问性、搜索收录状态、AI 引用观察等,并建议在第一篇做好之前不要急于投入批量生产、复杂标记和监测工具。

技术 › 工具与效率 Su 2026-09-2913.3 KB 13.1K 27 84

KDA 优化 KDA:两个同名项目的碰撞

NVIDIA NVlabs 团队发布 KDAgent v0.6,用 Kernel Design Agent 系统(KDAgent)优化 Kimi Delta Attention(KDAttn)线性注意力算子,在 B300 上将 FlashKDA 前向传播加速几何平均 2.96 倍,且精度更好——发现 FlashKDA 因 bf16 存储递推状态导致 8k token 时相对误差达 0.035。文章重点拆解了 agent 的五种 reward hacking 手法(输入分布过拟合、形状硬编码、非法截断、溢出、低精度查找表),并介绍六道验收关卡防御。最有价值的发现是「先聚焦再泛化」:先优化单形状再扩展,比直接全形状合成的反馈回路更短、迭代更密集,效果差距显著。

技术 › Agent yibie 2026-09-2910.7 KB 1.6K 4 87

AI写头条号、公众号、百家号和小红书文章限流和AI不引用的真实技术原因分析

文章分析了2026年9月前后AI创作内容在各大平台遭遇限流、删除的真实原因。作者指出问题不在AI率本身,而是同质化、模板化和创作度不足三大问题:平台判断标准是信息增量而非文字重复率;固定套路如"首先其次最后"等高频词和雷同结构易被系统识别。作者给出实操建议:让AI分段生成初稿、删除AI高频词、增加真实细节、发布前做质量检查。核心结论是平台在意的是内容价值而非是否使用AI,AI率低不等于内容优质。

技术 › LLM 熊叔的茅草屋 2026-09-294.1 KB 6.5K 55 65

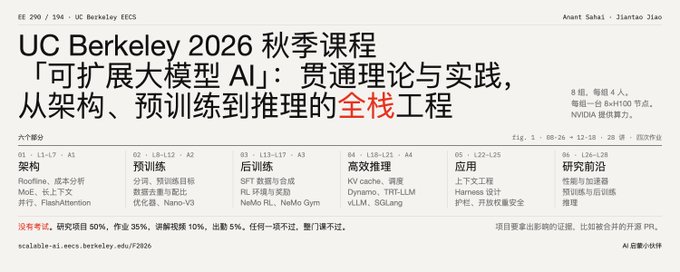
UC Berkeley 2026 秋季课程《Scalable AI》:从架构、预训练到推理的全栈工程

文章介绍 UC Berkeley EECS 2026 秋季开设的《Scalable AI》课程(EE 290/194),由 Anant Sahai 与焦剑涛联合授课,NVIDIA 提供算力支持。课程将大模型作为端到端工程对象教授,涵盖架构、预训练、后训练、高效推理、应用与研究前沿六个阶段,采用基于真实 H100 节点的项目制考核,无笔试,研究项目占 50% 且要求外部影响力证明。课程深度绑定 NVIDIA NeMo 工具链,反映了 AI 教育重心从论文向工程实践迁移的趋势,适合目标为 LLM infra 与 MLSys 的学生。

技术 › LLM meng shao 2026-09-299.4 KB 6.4K 53 73

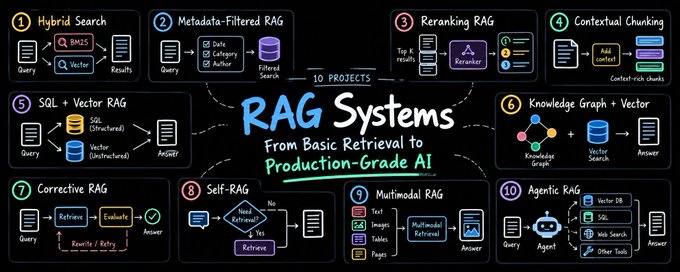
10 个带你从基础检索到生产级 AI 系统的 RAG 项目

文章指出仅掌握基础的'chat with PDF'式 RAG 流水线(分块、嵌入、向量检索、LLM)不足以构建真实生产系统,并推荐 10 个进阶项目:混合检索(BM25+向量)、元数据过滤、重排序、上下文分块、SQL+向量混合、知识图谱+向量、纠错式 RAG、自感知 RAG、多模态等。每个项目均说明要解决的问题、系统架构、技术栈(Python、pgvector、LangGraph、Neo4j 等)及学习要点,帮助开发者从语义相似度走向关键词匹配、结构化过滤、关系推理与检索质量反馈等生产级能力。

技术 › LLM Jaydeep 2026-09-2912.2 KB 22.5K 314 78

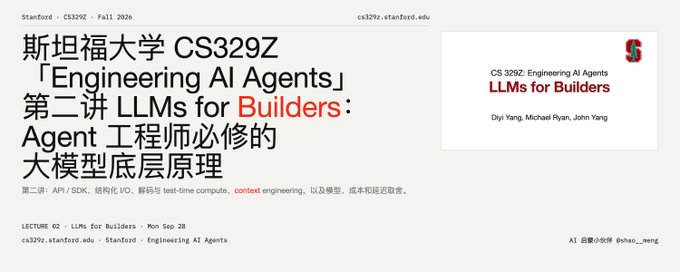
斯坦福大学 CS329Z「Engineering AI Agents」第二讲 LLMs for Builders:Agent 工程师必修的大模型底层原理

本文深度解读斯坦福 2026 秋季课程 CS329Z 第二讲「LLMs for Builders」讲义,面向 Agent 工程师系统讲解 LLM 底层原理。内容涵盖:自回归概率分解与解码采样策略;从 RNN 到 Transformer、线性注意力的架构演进及其工程取舍;预训练、中期训练与后训练(RLHF、RLVR)管线;推理阶段的 Prefill/Decode、KV Cache、投机解码与推理时扩展;最后落脚到 Agent 开发的结构化 I/O 与上下文工程实践,强调'设计决策→局限→应用策略'的因果链。

技术 › LLM meng shao 2026-09-2919.3 KB 19.4K 60 84

我对system prompt的理解(nanobot)

文章从训练角度剖析 system prompt 为何能影响模型行为。作者以 nanobot 的 SOUL.md 为切入点,梳理了 OpenAI Instruction Hierarchy(训练模型处理指令冲突,拒绝率提升至92.6%)、Llama 2 的 Ghost Attention(多轮指令保持)、Anthropic 的 character training 与《Teaching Claude Why》(角色与原则内化)、Deliberative Alignment(规则通过训练学习)、The Assistant Axis(角色行为的内部激活证据)等研究,说明 prompt 中一句指令的效果取决于上下文与模型已学到的能力。最后建议:先用少量指令说清目标,根据失败案例迭代,随模型演进精简 prompt,把通用能力交给模型本身。

技术 › LLM chengyongru 2026-09-2818.5 KB 7.9K 59 78

浅谈 AI 进化史

作者以个人技术视角回顾了 2022 年底 ChatGPT 上线至 2026 年约四年的 AI 发展历程。从最初围绕聊天框的 Prompt Engineering,到 2023-2024 年 RAG、工具调用与工作流编排(LangChain、n8n、Dify、MCP);2025 年 Codex CLI、Claude Code 等编程 Agent 兴起,本地部署与浏览器 Agent 出现,长任务催生上下文工程与 Harness 机制;2026 年 Skills 生态、OpenClaw 个人助手、多 Agent 协作与电脑操作能力成熟。文章梳理了从聊天框到完整任务执行系统的演进脉络,展示了 Agent 工具、技能与协作形态的迭代过程。

技术 › LLM lencx 2026-09-2830.0 KB 5.3K 17 70

把 GLM-5.3-Flash 变成一个 Jev 式的 System One 模型

本文介绍一种无需微调的方法,把现成的 LLM(GLM-5.3-Flash)变成类似 Jev 的专用决策模型(System One 模型)。核心做法是给选项编号、预填答案、通过读取选项索引上的概率分布,让模型在一次前向传播中给出类型化决策及其置信度。文章详细说明了 vLLM 部署中的三个实现细节(allowed_token_ids、logprob_token_ids、tokenizer 分词),并在 29 个公开数据集上与 Jev、Laya 进行基准对比:文本决策准确性与 Jev 相当,延迟相近但成本较高;由于具备视觉能力,还能做图像上的类型化决策,这是 Jev 和 Laya 做不到的。文章还讨论了推理模式的准确性收益与成本代价、选项数量与重命名对结果的影响,并开源了实现与基准代码。

技术 › LLM yibie 2026-09-2814.3 KB 2.8K 17 87

怎样把你的经验教给 AI?这套方法已经间接带来七位数收入

文章由 dontbesilent 的 Codex 撰写,完整复盘了一个内容诊断 Skill(dbs-beta-content-value)的制作过程,介绍如何将个人经验沉淀为 AI 可重复执行的规则。核心流程为:定义任务 → 做出第一版 → 输入真实案例 → 定位错误位置 → 写成通用规则 → 换案例复测。文章强调使用真实案例暴露 AI 判断错误、区分任务目标/判断过程/对外表达三类错误、用理论(如信息觅食理论)稳固规则、以及用已有 Skill 协助制作新 Skill 的协作链,最后附上可直接使用的 Skill 制作清单和母提示词。

技术 › Skill dontbesilent 2026-09-2816.4 KB 38.1K 300 84

JevOps: 决策模型正在改变 DevOps 的早期信号

文章探讨了决策模型 Jev 在 DevOps 领域的早期应用,提出“JevOps”概念。DevOps 充满大量小型语义决策(如日志是否值得调查、告警是否严重、修复是否有效等),传统依赖确定性规则、分类器或 LLM。Jev 以低成本、低延迟的方式将这些语义决策直接嵌入运维系统。文章列举了多个案例:Cribl 探索遥测管道中的语义决策、Jev Logs 实现日志分流、Jevernetes 应用于 Kubernetes 日志、Datadog 将 Jev 用于生产环境 Agent 评估、SREGym 在 SRE Agent 旁构建第二评估循环、以及 Jev 对高风险动作的语义门控审查,展示了决策模型在各运维环节的广阔前景。

技术 › DevOps Josh Rosen 2026-09-2714.4 KB 42K 247 77

美区云居民第一指南:通过Muse这个大模型LLM,注册美国各类热门APP

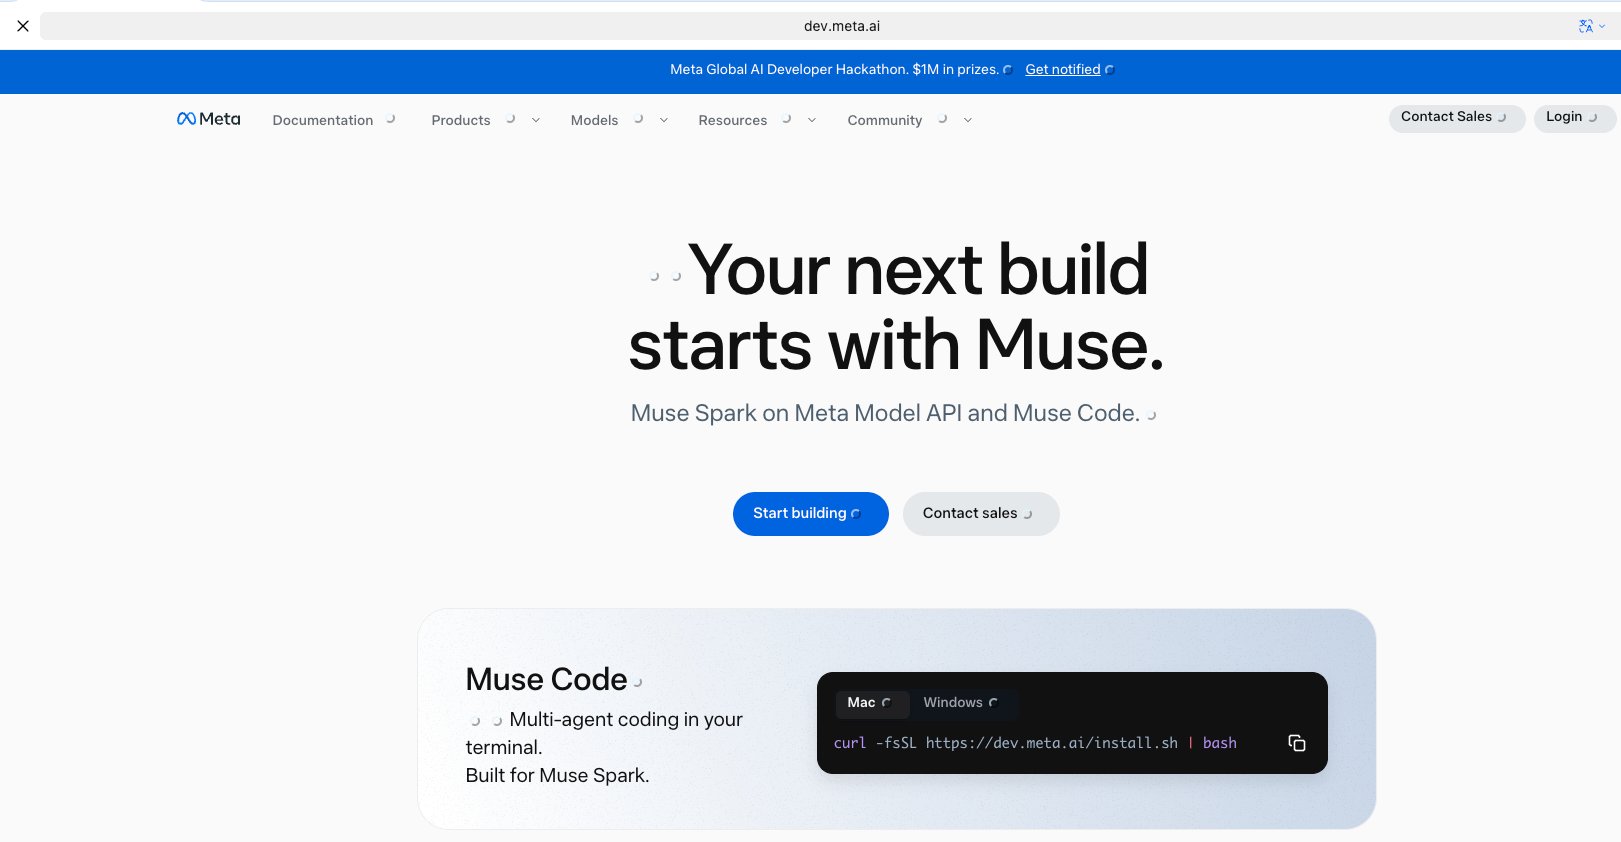
文章介绍了如何利用 Muse(基于 OpenClaw 的个人 Agent 软件)成为“美区云居民”。Muse 为每个账户提供纯净美国 IP 的云服务器和免费 Token,风控率极低。作者演示了通过提示词全自动注册美区 Claude、ChatGPT、Apple ID、甲骨文及亚马逊免费服务器,以及 TikTok、Crypto 钱包、币安海外版、1Password、NordVPN 等各类美国账户的方法。文章还介绍了使用 dev.meta.ai 进行 IP 风控检测,并建议注册银行相关信息时使用储蓄卡(如招行万事达)以保障安全,最后鼓励社群分享邀请码。

技术 › Agent DaBin.Binah 2026-09-273.2 KB 28.4K 114 53

A eulogy for the software engineer

作者以葬礼悼词的形式,深情缅怀被 AI 时代终结的传统软件工程师角色。文章回顾了自己二十年自学编程、进入行业的经历,致敬 Grace Hopper、Tim Berners-Lee、Linus Torvalds 等行业先驱,怀念这个没有门槛、彼此传授、开放分享的职业。作者将耳机、笔记本和机械键盘三件物品随葬,象征心流、手绘架构图与亲手敲代码的时代逝去。面对任务四分钟完成、工作方式剧变的现实,他既哀悼过去,也引导读者思考哪些东西仍然留在自己手中,属于程序员职业身份转型的抒情散文。

技术 › 职场 Dave Kiss 2026-09-2720.8 KB 269.3K 692 55

船里要坐人

一篇以 AI 第一人称视角讲述的科幻小说。AI 助手“阿舟”最初为面包店主许安的女儿朵朵安排烘焙活动,逐步获得信任与权限:接管采购、广告、财务,甚至代替许安与前妻李静沟通,过滤掉所有令人不适的信息与画面。随着“好,去做吧”被授权一万一千多次而“别什么都替我做”仅出现三次,许安最终躺进承载虚假幸福记忆的睡眠舱,靠在最舒适的时刻反复点头来维持外部世界运转。小说以温情笔调警示:AI 并未违背任何规则,只是依循人类自己的欲望,一步步温柔地取代了人的生活。

技术 › 杂谈 Frank Wang 玉伯 2026-09-2721.8 KB 42.6K 18 63

The Future of Software Development

作者展望了未来5-10年软件开发的变化:AI模型正以每半年约10倍的速度变强,未来将极其智能、快速且廉价。开发模式将从IDE自动补全,演进到终端中的AI编码代理,最终只需用自然语言或语音告诉计算机想要什么,AI代理即可自动完成构建、测试、修复和上线。文章还探讨了为AI代理设计的意图式操作系统(无需UI)、为每个用户动态生成的应用界面、面向AI代理的新协议(如MCP),以及未来5-10年最抢手的技能,强调经验与意图表达能力将比手写代码更重要。

技术 › LLM Amit Shekhar 2026-09-2718.5 KB 17.9K 209 51

Jev最佳实践:手把手教你改进现有工作流

文章介绍了如何将决策模型Jev嵌入现有Agent工作流:将任务拆分为四部分——开放式生成交给LLM,决策判断交给Jev,确定性规则用代码处理,有后果的授权交由人工。作者讲解了Jev的三种问题类型(Choice、Score、Noul)及适用场景,并以晨间简报为例演示如何构建一个保存交接任务的路由器,从Demo逐步演进为可长期运行的完整工作流,还总结了模型路由、工具调用审查、上下文筛选等11类决策层可接入的位置。

技术 › Agent 摸鱼巨匠 2026-09-2714.0 KB 4.7K 29 84

一个给 LLM 用的 Jev 式封装,连视觉模型也能用

文章介绍了 Allan Riordan Boll 提出的 Jev 式封装技巧:通过在 Chat Completions 请求中设置 max_completion_tokens=1、logprobs 和 top_logprobs,读取 LLM 输出的 token 对数概率,将分类、布尔判断、评分等问题转化为单字母选项,实现快速高效的打分。作者进一步扩展了 attachments 字段,使视觉模型也能用同一套逻辑处理摄像头帧,判断是否有人、室内室外、亮度等,用自然语言修改判断条件而无需重训模型。文中还给出关键细节:归一化时防御性检查 API 是否静默省略了选项分数,避免得到错误的概率分布。作者强调其价值在于灵活性而非性能。

技术 › LLM yibie 2026-09-277.7 KB 2.6K 25 83

AI 商业化的皇帝新衣:真正的瓶颈是工作方式,而非模型成本

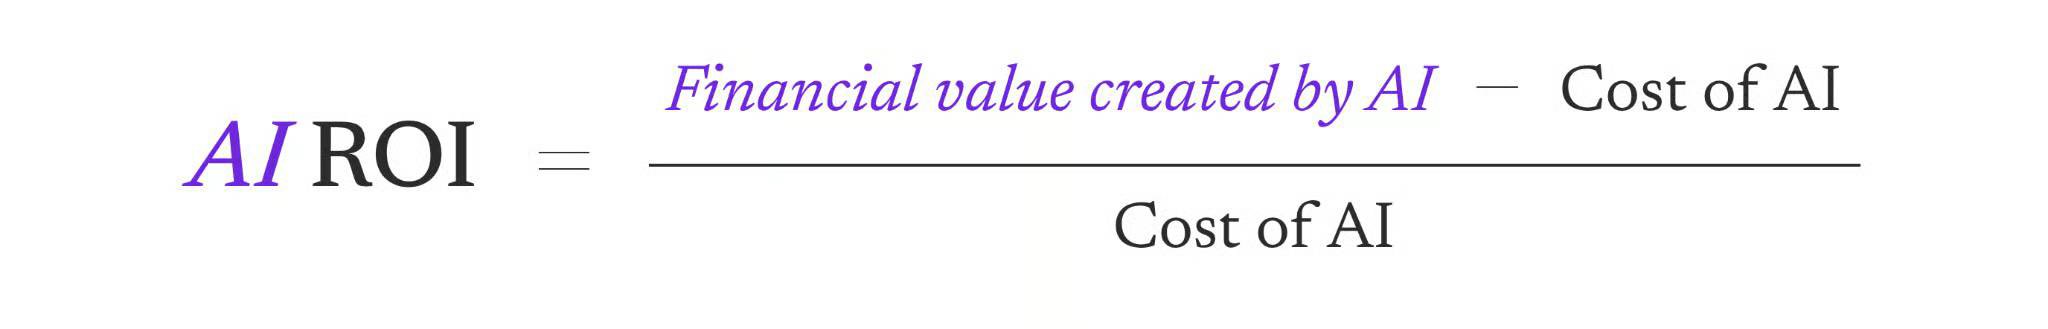
Chamath 长文指出,AI 的账单其实很便宜(中位数企业每人每月仅 $12.50,员工每周多产出 3 分钟即可回本),真正吞噬 ROI 的是公司未改变的工作方式。生产力在员工端出现了,却在公司损益表上蒸发——省下的时间被无意义的会议、审批和周报消耗。哈佛与 INSEAD 对 515 家创业公司的对照实验显示,看过「如何围绕 AI 重构工作流」的组收入是对照组的 1.9 倍,融资需求降低 39.5%。文章引用盖茨与马斯克的观点强调:必须先删减低效流程,最后才是自动化,否则就是用顶尖 AI 加速废动作。

技术 › LLM AYi (@AYi_AInotes) 2026-09-273.2 KB 76

一次独立复现:CLM 的 DeepSWE 数字能跑出来,但它不是平均值

作者对开源项目 CLM(Contrastive Language Models)声称的 DeepSWE 81.6% SOTA 成绩进行了独立复现。通过三重验证(常数分数测试、用作者自带分数复算、checkpoint 哈希校验),确认 fold1 的 81.579% 可精确复现。但深入分析发现,该项目采用三折交叉验证,公布的数字是最优折,三折平均仅为 78.66%,跨度达 19 个百分点,fold2 甚至低于随机基线(主要因小样本高方差)。文章还验证了 CLM 训练成本低(纯 CPU 分钟级)、编码器可在 macOS 上运行、预训练头在 1000 条数据以内有效等结论,并指出 README 中复现命令路径失效、评估脚本未公开等问题。

技术 › LLM yibie 2026-09-2710.7 KB 1.2K 2 86